把地点明天的客流写成一句话,语言模型报得过专门的数值模型吗?
论文名片|Hao Xue、Bhanu Prakash Voutharoja、Flora D. Salim,Leveraging Language Foundation Models for Human Mobility Forecasting,The 30th International Conference on Advances in Geographic Information Systems(SIGSPATIAL ’22),2022年11月1–4日,美国西雅图。ACM,纽约,9页。DOI:10.1145/3557915.3561026。Hao Xue 与 Bhanu Prakash Voutharoja 为同等贡献。本文依据这一会议版本解读。
一家店如果想知道明天大概来多少人,常见做法是把过去十几天的人数排成数列,交给循环网络或 Transformer,让它吐出一个数。这篇论文把入口换掉:次数、日期和星期先写成英语句子,再交给已经读过大量普通英语的语言模型,让它把句子续完。续完之后读出的那个数,就是下一天的到访人数。
实验用的是地点上的汇总人数。2020年6月15日至11月8日,SafeGraph 周模式数据记录纽约、达拉斯、迈阿密三座城市中每个兴趣点的逐日到访次数和类别。兴趣点(Place-of-Interest,POI)在这里指一个有类别、并被逐日计数的地点。发布数据已经按地点汇总并匿名化,所以模型面对的是地点—日期上的人数,读不出某一个人第二天去了哪里。
方向先说清楚:公开的语言基础模型经过客流句子微调之后,可以在三座城市的简单平均误差上接近、并在达拉斯上低于文中最强的数值预报基线。这个差距主要由达拉斯贡献。换编码器、关掉类别任务,或者把在一座城市上学到的模型直接拿到另一座城市上测试,优势都会变窄,测试城是迈阿密时数值模型更低。
先说结论
- 历史长度固定为连续 15 天,预测目标只有下一天的到访人数。除线性回归外,误差是 5 个随机种子的均值 ± 标准差。三城平均是三座城市误差的算术平均,每座城市权重相同,没有按地点数 479、1,374、1,007 加权。
- 启用地点类别辅助分类、以 BERT 为编码器时,三城平均 RMSE 为 10.641、MAE 为 4.695。数值基线里表现最好的 Informer 对应为 11.289 和 4.799。达拉斯 RMSE 从 Informer 的 18.061 降到 15.304;以 18.061 为分母,降幅约 15.3%。纽约与迈阿密的 RMSE 没有同步下降。
- 同样打开辅助分类时,BERT 在达拉斯的 RMSE 15.304,比 RoBERTa 的 16.902 低 9.5%。论文给出的 9.5% 以 16.902 为分母。RoBERTa 的三城平均 MAE 4.665 略低于 BERT 的 4.695,平均 RMSE 则是 11.307,没有低于 Informer。
- 从句子里去掉日期后,BERT 的三城平均 RMSE 由 10.641 升到 11.471,MAE 由 4.695 升到 5.114。XLNet 升得更多,RMSE 由 11.945 升到 13.895,MAE 由 4.889 升到 6.452。
- 在一座城市上训练、到另一座城市的测试集上评估,共 6 个城市对。按测试集 RMSE 的最低值计,语言管线占 4 对;测试城为迈阿密的两对里,Autoformer 或 Informer 更低。
预报的单位,是地点的下一天
人类移动性预报在这篇论文里收成一个很窄的任务:给定某地点连续 n 天的到访次数,预测第 n+1 天的次数。实验取 n=15。每个地点还有一个语义类别,例如鞋店、邮局、酒店或商业银行。
三座城市来自同一数据源,时间窗口相同,规模不同。
| 城市 | 地点数 | 类别数 |
|---|---|---|
| 纽约 | 479 | 39 |
| 达拉斯 | 1,374 | 65 |
| 迈阿密 | 1,007 | 51 |
每座城市再切成训练集 70%、验证集 10%、测试集 20%。论文没有写明这一刀是按日期、按地点,还是按滑动窗口后的样本来切。因此读者知道比例,还不知道测试日是否严格落在训练日之后。
评价指标是 RMSE 和 MAE,比较的是预测人数与记录人数。RMSE 先平方、再平均、再开方,大偏差拉得更重;MAE 是绝对误差的平均。论文没有公布测试集里有多少个地点—日期,所以下文的误差单位是人数,分母是该设置下论文所报告的测试误差,三城平均则是三座城市各算一票。
人数进模型之前,句子多写了什么?
语言基础模型(language foundation model)指已经在大规模文本上预训练、再拿到下游任务微调的模型。BERT、RoBERTa、XLNet、GPT-2 都属于这一类。它们的预训练语料是普通英语,里面没有客流表。直接把一列数字送进去,和这些权重当初学习的句子对不上。
移动提示(mobility prompting)就是中间这一层翻译:把历史人数、日期和地点信息写成句子,让现成的预训练权重能够接着微调。图 1 把两条通路并排放在一起。图里的 4 天和输出 6 是示意,正式实验用的是 15 天历史,评估时再把生成的文字还原成一个人数。
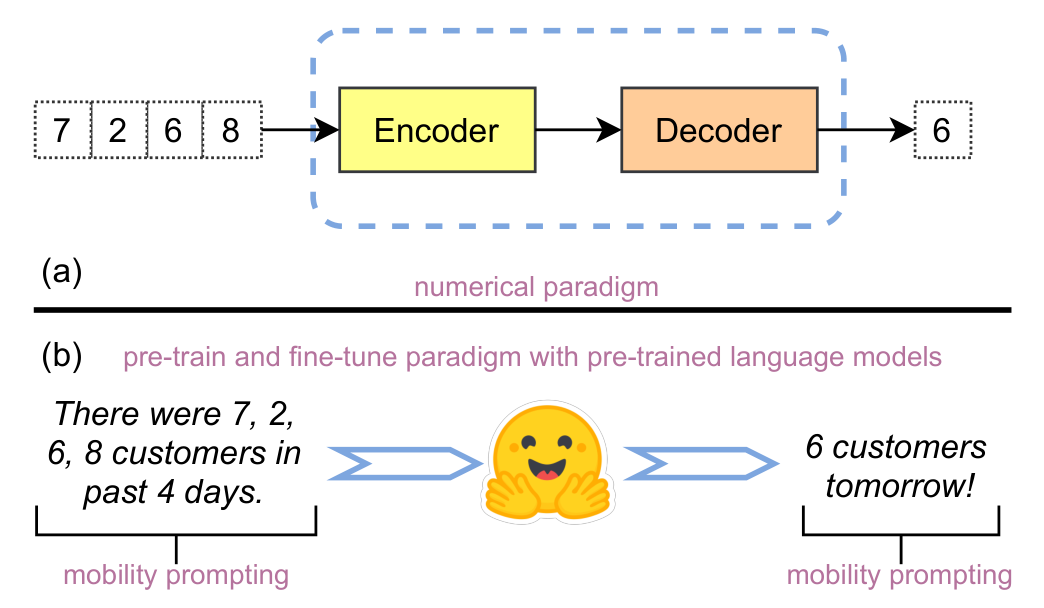
图 1|数字序列和英语句子,哪一种入口在预报下一天的人数?
(a)数值范式。过去 4 天的人数 7、2、6、8 进入编码器—解码器,输出一个数 6。黄色块是编码器,橙色块是解码器,蓝色虚线框出这条数值通路。
(b)预训练再微调。同一串人数写成 There were 7, 2, 6, 8 customers in past 4 days,再生成 6 customers tomorrow。两侧括号下的 mobility prompting 表示写句和读回人数。这张图回答的是输入形式,不包含三座城市的测试误差。来源:原论文 Fig. 1。
句子比纯数字多出来的,主要是日期和类别这些词。数值模型那边,Transformer、Reformer、Informer、Autoformer 也可以把日、星期、月份做成时间嵌入。没有这层嵌入时,普通 Transformer 的三城平均 RMSE 是 12.176、MAE 是 4.858;加上时间嵌入后变为 11.751 和 4.880。日期信息对数值模型已经有用。后面和句子模型比较时,对照取带时间嵌入的数值基线。
三句提示,差在地点编号和类别放在哪
论文准备了三种句子,表 1 用同一个例子说明。例子的历史窗口是 2020年6月17日星期三到7月1日星期三,共 15 天,人数依次为 11、11、10、12、9、12、6、13、10、15、16、8、8、13、19。要预测的是 7月2日星期四,例子里的真实人数是 11。地点编号写成 POI 385,类别是 Limited-Service Restaurant。这是提示模板里的一个地点,用来展示句子里放了哪些字段。
提示 A 把地点编号和类别都写进输入,目标句是 there will be 11 people visiting POI 385。提示 B 删掉编号,类别名称仍留在句子里,目标句缩短为 there will be 11 people。提示 C 的输入里不再写类别,输出拆成两段:类别目标 Limited-Service Restaurant,以及人数目标 11。
作者保留类别,是因为不同类别的星期形态可以差很多。去掉具体地点编号,则是为了在应用里少暴露一个地点索引。提示 A 和提示 B 的预报误差非常接近。用普通 Transformer 做编码器—解码器时,提示 A 的三城平均 RMSE 为 11.514、MAE 为 4.785;提示 B 为 11.467 和 4.784。后文的 AuxMobLCast 使用提示 C,因为类别要单独交给辅助分类,主任务只生成人数。
类别任务为什么不改编码器?
AuxMobLCast 是 Auxiliary Mobility Language Forecasting 的缩写,意思是带辅助任务的移动语言预报。整体仍是编码器读句子、解码器生成下一句。解码器固定为 12 层的 GPT-2。编码器轮流换成 BERT、RoBERTa 或 XLNet 的公开 base 权重:三者都是 12 层、隐层 768、12 个注意力头,参数量分别约为 1.10 亿、1.25 亿和 1.10 亿。微调从这些现成权重开始,总轮数上限 50,并带早停;学习率和损失系数按验证集选定。
辅助任务不改编码器内部结构。句子经过编码器后,取句首的 [CLS] 记号,接一个全连接层和 softmax,用来判断地点类别。[CLS] 会看过输入里的全部记号,所以类别判断用的是整句,而不只是某一个人数。主任务用交叉熵让解码器生成人数文字,辅助任务用分类损失。两者加权求和,系数之和为 1。纽约和迈阿密是 0.8 与 0.2,达拉斯是 0.9 与 0.1。
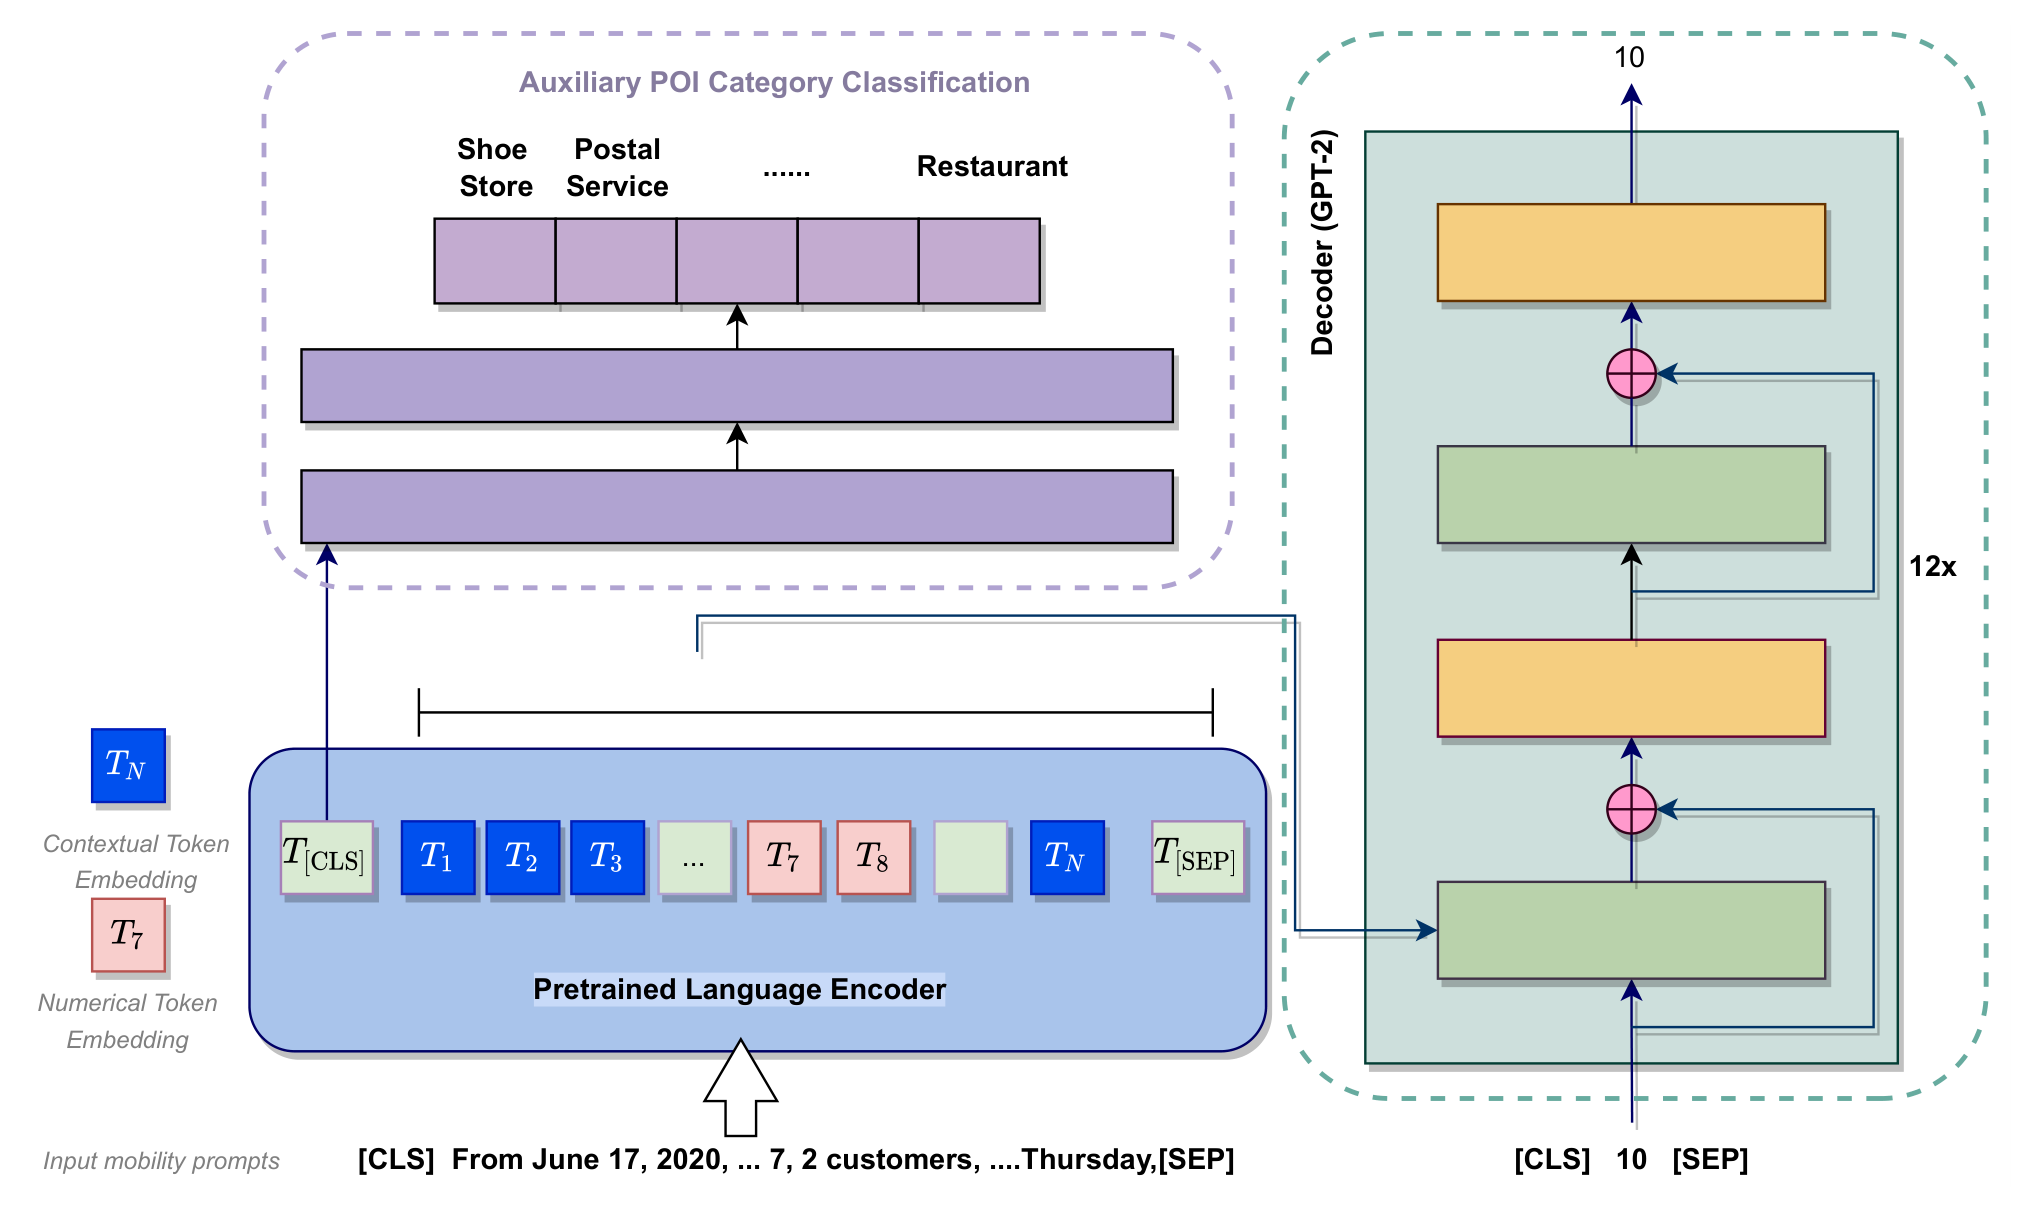
图 2|句子进编码器之后,类别判断和人数生成怎样接在一起?
无字母子图。底部输入是一条移动提示,示例写着 [CLS] From June 17, 2020, … 7, 2 customers, ….Thursday,[SEP]。蓝色块是上下文记号,红色块是人数记号,左右图例分别标出 Contextual Token Embedding 与 Numerical Token Embedding。蓝色大框是预训练语言编码器。左上紫色虚线框是辅助地点类别分类,可见类别包括 Shoe Store、Postal Service 和 Restaurant。右侧绿色虚线框是 GPT-2 解码器,旁注 12x,输出示例为 [CLS] 10 [SEP]。图中的 10 与表 1 例子里的 11 都是画法示意。来源:原论文 Fig. 2。
自注意力在这里同时接触两种关系:不同时间步上的人数记号彼此如何相关,人数记号又如何和日期词相关。这是结构上做得到的事。星期词是否真的降低误差,要看后面拿掉日期的对照。
类别值得单列成任务,论文用迈阿密两个地点的星期曲线作动机。一个地点属于酒店,另一个属于商业银行,曲线是整个采集期内按星期几取的平均到访次数。
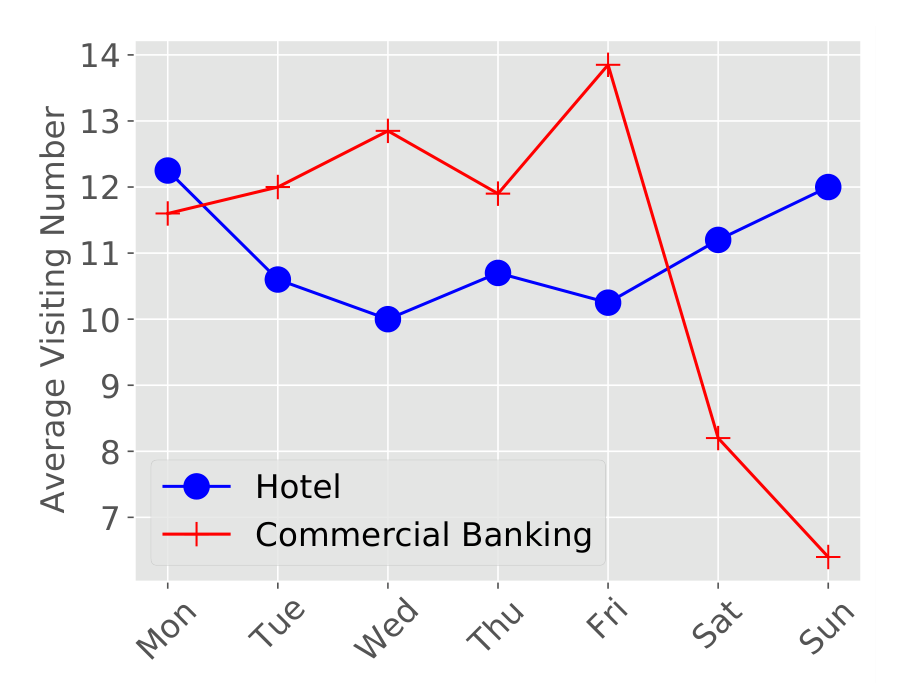
图 3|同一座城市里,两个不同类别的地点,星期形态差在哪里?
无字母子图。横轴为星期一到星期日,纵轴为平均到访次数,刻度从 7 到 14。蓝点是酒店,红十字是商业银行。酒店在周末高于周中几个工作日;商业银行到周六、周日明显落到更低的刻度。图上没有逐日数值标签,读的是形状。这两个地点不能代表迈阿密全部酒店或全部银行。来源:原论文 Fig. 3。
三城平均变好,是哪一座城市拉下来的?
数值基线包括线性回归、GRU、带注意力的 GRU、普通 Transformer,以及带时间嵌入的 Transformer、Reformer、Informer 和 Autoformer。线性回归没有做 5 次重复,三城平均 RMSE 15.585、MAE 6.107,是这组里最弱的一档。带时间嵌入的数值方法里,Informer 的三城平均最好:RMSE 11.289,MAE 4.799。分城市看,它在纽约是 6.279±0.140 与 4.134±0.074,达拉斯是 18.061±0.205 与 5.441±0.052,迈阿密是 9.526±0.098 与 4.823±0.043。
把句子交给普通的语言编码器—解码器,已经能靠近这一档。提示 B 配 Transformer 的三城平均 RMSE 为 11.467、MAE 为 4.784:平均 RMSE 仍高于 Informer 的 11.289,平均 MAE 略低于 4.799。同骨架的数值 GRUAtt 三城平均 RMSE 是 13.910,提示 B 的 GRUAtt 降到 12.232。这里要留一句口径:表中前一组 GRU 与 GRUAtt 没有像 Informer 那样单列时间嵌入,而提示句里本来就写着日期,所以这一对对照同时换了输入形式和日期信息。
AuxMobLCast 在提示 C 上继续比。BERT 编码器加上辅助分类后,三城平均 RMSE 10.641、MAE 4.695,两项都低于 Informer,也低于提示 B 的 Transformer。把三座城市拆开,画面就不再均匀。
| 设置 | 纽约 RMSE | 达拉斯 RMSE | 迈阿密 RMSE | 三城平均 RMSE | 三城平均 MAE |
|---|---|---|---|---|---|
| Informer,含时间嵌入 | 6.279 | 18.061 | 9.526 | 11.289 | 4.799 |
| Transformer,提示 B | 6.648 | 18.189 | 9.563 | 11.467 | 4.784 |
| BERT,辅助分类开 | 6.312 | 15.304 | 10.307 | 10.641 | 4.695 |
| BERT,辅助分类关 | 6.291 | 18.125 | 12.197 | 12.204 | 4.708 |
| RoBERTa,辅助分类开 | 6.277 | 16.902 | 10.744 | 11.307 | 4.665 |
| XLNet,辅助分类开 | 6.586 | 16.566 | 12.683 | 11.945 | 4.889 |
纽约上,BERT 开辅助分类的 RMSE 6.312±0.253 与 Informer 的 6.279±0.140 只差 0.033,小于两边的标准差;MAE 4.114±0.038 对 4.134±0.074,同样落在波动里面。迈阿密上,Informer 的 RMSE 9.526±0.098 低于 BERT 的 10.307±1.698,而且 BERT 这 5 次的标准差很大,1.698 已经盖过两者均值之差。达拉斯才是平均分被拉下来的地方:BERT 15.304±0.835,Informer 18.061±0.205,差值 2.757,大于两边各自的标准差。
论文把达拉斯更难归因于它的地点数和类别数都最多。这个解释和表里的排序一致,但论文没有给出各城市到访次数的均值或中位数。绝对 RMSE 更大,可能来自更难的规律,也可能来自客流规模本身更大。在缺少规模统计时,三座城市的 RMSE 不宜直接比成同一套难度分数。
辅助分类和日期,各自贡献了多少误差?
辅助分类对 BERT 最清楚,而且主要出现在达拉斯和迈阿密的 RMSE 上。关掉它,BERT 的达拉斯 RMSE 从 15.304±0.835 升到 18.125±1.509,迈阿密从 10.307±1.698 升到 12.197±1.057,三城平均 RMSE 从 10.641 升到 12.204。纽约几乎不动:关掉时 RMSE 是 6.291±0.010,打开时是 6.312±0.253。迈阿密打开辅助分类后的标准差大于均值降幅,所以这座城市上的改善不如达拉斯稳。
RoBERTa 和 XLNet 对不上同一种“打开就更好”。达拉斯上,RoBERTa 打开辅助分类后 RMSE 从 15.821±1.114 升到 16.902±1.621,MAE 却从 5.294±0.193 降到 4.964±0.062。XLNet 在达拉斯两项都变差,RMSE 从 15.602±0.285 到 16.566±0.998,MAE 从 5.202±0.123 到 5.305±0.094;它在迈阿密两项变好,RMSE 从 13.071±2.561 到 12.683±1.127。于是三城平均上,辅助分类改善了 BERT,没有让 XLNet 的平均 RMSE 下降(11.759 对打开后的 11.945)。论文因此把 BERT 当作这条管线里更合适的编码器,依据是平均 RMSE 和达拉斯上的降幅。RoBERTa 打开辅助分类后的三城平均 MAE 4.665,仍低于 BERT 的 4.695。
日期词的对照更一致。表 5 里保留日期的每一行,与表 4 中打开辅助分类的对应行逐项相同,所以这组实验是在辅助分类打开的前提下,只从句子里删掉日期。删掉之后三种编码器都变差。BERT 的三城平均 RMSE 从 10.641 到 11.471,MAE 从 4.695 到 5.114。RoBERTa 从 11.307 / 4.665 到 11.873 / 4.996,升幅小于 BERT。XLNet 从 11.945 / 4.889 到 13.895 / 6.452,MAE 的升幅为 1.563,分母是保留日期时的 4.889。没有日期词,模型就失去了把人数和星期对齐的文字线索,周中与周末的差别只能勉强从人数序列本身去猜。
在一座城市上学到的句子,换城还灵吗?
论文把另一项实验称为 zero-shot:在一座城市的数据上训练,再到另外两座城市的测试集上计算误差。数值方法仍然打开时间嵌入。这里的零样本指:模型已经在源城市的客流句子上微调,评估时不再使用目标城市的训练样本。
6 个城市对里,按测试 RMSE 谁更低来数,语言管线占 4 对,和论文所说的 4 组领先一致。测试城换成迈阿密时,两对都是数值模型更低。
| 训练城 | 测试城 | 该格 RMSE 更低的一方 | RMSE | MAE |
|---|---|---|---|---|
| 纽约 | 迈阿密 | Autoformer | 9.445±0.095 | 5.020±0.049 |
| 纽约 | 达拉斯 | BERT | 17.396±0.995 | 5.472±0.027 |
| 迈阿密 | 纽约 | RoBERTa 的 RMSE 略低 | 6.289±0.061 | 4.209±0.032 |
| 迈阿密 | 达拉斯 | BERT | 15.546±0.241 | 5.723±0.224 |
| 达拉斯 | 纽约 | BERT | 6.231±0.066 | 4.162±0.017 |
| 达拉斯 | 迈阿密 | Informer | 9.657±0.422 | 5.076±0.043 |
纽约训练、迈阿密测试时,语言模型里较低的 RoBERTa 仍有 RMSE 17.834±0.284,远高于 Autoformer 的 9.445±0.095。达拉斯训练、迈阿密测试时,BERT 的 14.014±0.741 也高于 Informer 的 9.657±0.422。反向则不同:迈阿密或达拉斯训练后再测纽约,BERT 的 RMSE 分别是 6.295±0.066 和 6.231±0.066,低于同格的 Informer(6.429±0.074 与 6.766±0.078)。迈阿密训练、纽约测试这一格里,RoBERTa 的 RMSE 比 BERT 低 0.006,差距小于两者的标准差 0.061 和 0.066;BERT 的 MAE 4.204±0.019 略低于 RoBERTa 的 4.209±0.032。
跨城结果说明句子模型有一部分可以带走,尤其是在预测纽约这种绝对误差本来就小的城市时。它也说明这种可带走的部分盖不住迈阿密测试集上的差距。论文没有报告三座城市的类别有多少不重叠,因此看不出迈阿密的落后有多少来自没见过的类别词。
误差下降能支持到哪一步
能支持的是:在这三座美国城市、2020年6月15日至11月8日、提前一天的地点到访人数上,把 15 天历史和日期写成句子,再用公开语言基础模型微调,可以得到与强数值基线同一量级的测试误差;BERT 配上类别辅助分类后,三城简单平均和达拉斯的 RMSE 低于 Informer。作者在讨论里也写明,文中看到的提升幅度并不很大,并把这项工作定位为打开一条研究方向的探索。
这些误差比较的是提前一天的人数。它还没有说明人为什么出门。图 3 只包含两个地点的星期曲线,辅助分类的收益又随编码器和城市改变。模型先生成文字,再还原成人数;论文没有单独报告还原失败的比例。70/10/20 的切分单位没有写明。若相邻日期的窗口同时进入训练和测试,这个测试会比“只见过去、预报明天”更容易。采集期位于 2020 年下半年,论文没有换成其他年份,也没有把防疫限制写成变量。
提示句本身仍是手写模板。作者把自动生成提示、以及把方法扩展到多变量时间序列,列为本项工作之后的方向。那些实验不在这 9 页里。
一句话总结
把地点过去 15 天的到访人数和日期写成句子后,预训练语言模型能够预报下一天的人数,并在三城简单平均上接近或优于文中最强的数值基线;优势集中在达拉斯,换到迈阿密的测试集上则不再成立。
核心来源
- SIGSPATIAL ’22 会议论文,题目、作者、页数与 DOI 以论文首页为准。正文图 1–3,表 1–6。
- 论文第 4.2 节给出的代码地址:github.com/cruiseresearchgroup/AuxMobLCast。
- 数据说明见论文脚注中的 SafeGraph Weekly Patterns 与 SafeGraph Data for Academics。文中使用的是按地点汇总并匿名化后的逐日到访次数。
作者介绍
以下只写论文署名、同等贡献说明,以及本篇参考文献里能够核对到的相关工作。
- Hao Xue:与 Bhanu Prakash Voutharoja 同等贡献,署名新南威尔士大学,悉尼。参考文献中,他与 Flora Salim 等人在 2021 年发表 MobTCast,并与 Flora D. Salim 发表 TERMCast,两项都处理人类移动或城市人流预报。
- Bhanu Prakash Voutharoja:同等贡献,署名伍伦贡大学与新南威尔士大学。论文没有另列其既往职务或个人主页。
- Flora D. Salim:署名新南威尔士大学,悉尼。致谢写明工作受澳大利亚研究理事会发现项目 DP190101485 支持,并作为 IEA EBC Annex 79 的一项贡献。她也是上述 MobTCast 与 TERMCast 的作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
三座城市的 RMSE 不在一个量级上:纽约大约为 6,达拉斯大约为 15。MAE 却靠近得多,BERT 打开辅助分类后纽约是 4.114、达拉斯是 5.168。RMSE 会被少数很大的偏差拉高,所以两城的差距主要堆在平方误差上。句子里写的仍是原始人数。若达拉斯的地点客流规模更大,模型可能主要在适应数字尺度。把每个地点的人数先除以它在训练期的中位数,再写成句子,然后重做那 6 个跨城测试,才能分开尺度差异和星期形态。论文没有做这种归一化,也没有给出各城市的人数均值,所以这个猜测仍待检验。
图 3 的酒店与商业银行只是两个地点。辅助分类若把预测往“该类别的典型星期”上拉,那么周六仍开门的银行、或因一场会议而周三爆满的酒店,就会成为辅助损失帮倒忙的日子。可以按“当天人数偏离同类别星期曲线的程度”把测试日分组,看打开辅助分类之后,这些偏离日的 RMSE 是下降还是上升。现有消融只按城市和编码器汇总,回答不了这个分组。
句子已经写明目标日是星期几。一个直接的朴素对照,是用该地点以往同一个星期几的人数均值来预报明天。文中的线性回归使用的是另一套拟合。如果这个星期几均值的三城平均 RMSE 已经接近 10.641,语言微调的增量就要重估;如果它明显高于 10.641,句子模型才更像是学到了类别与跨日人数的组合。这组数字论文没有报告,但是它决定前面那些误差下降该被看成多厚的一层新信息。