通话次数变多,联系人名单为什么不会同比变长?
论文名片|Chaoming Song、Dashun Wang、Albert-László Barabási,Connections between Human Dynamics and Network Science,arXiv:1209.1411v2 [physics.soc-ph],2013年4月8日。arXiv:1209.1411v2。本文依据这一版预印本正文解读。页面未印 DOI。作者称本文为 Letter:用标度关系把人类动力学和网络科学连起来,再用四套通信记录检验,不是随机对照实验。
两个人一周都打出大约同样多次电话。一个人几乎总打给固定的几个号码,另一个人的号码却不断更新。到周末,两个人的通话次数可以差不多,通讯录的长度却差一截。网络科学习惯统计每个人联系过多少人,人类动力学习惯统计同一个人两次行动隔了多久。两套统计经常各画各的图,尽管用的常常是同一批通信记录。
这篇论文给出的方向是:联系人数量的分布、联系重复次数的分布,可以用活动量、社交性,以及回到旧联系人的间隔指数写出来。四套数据都支持这个方向。公式约束的是分布之间的标度;表 I 里的群体平均值并没有逐项闭合成恒等式,具体通信机制仍要按系统设计。
先说结论
- 联系人数随本人发起的通信次数次线性增长。表 I 的平均社交性为:手机 0.58±0.01,邮件 0.68±0.02,推特 0.78±0.01,在线消息 0.70±0.01。分母是各数据集中的用户。固定队长的排队参照给出 1.0,可变队长给出 0.5;四套实测都落在两者之间。
- 对单个用户,社交性与链路间隔指数相加为 1:更频繁地回到旧联系人,新联系人就增加得更慢。四套系统里,个人间隔指数的分布用各自平均值缩放后落到同一条曲线附近,小端用 σ=6.6 的指数上升描述。
- 邮件、推特和在线消息的度分布胖尾,主要由“谁发出的通信多”主导。手机则主要由社交性的差别主导:观察拉长后,度指数从 4.19±0.01 降到 3.205±0.007,对应平均活动量的自然对数从 3.4 增到 5.9。
- 同一个人把通信分给联系人时,近似齐夫定律,名次指数与社交性互为倒数。权重指数的一阶写法是 2 减间隔指数。它与表 I 同向;手机、邮件较接近,推特和在线消息偏差更大。
这四套记录,各自在数什么?
比较的是数字通信,不是一个人线下遇见的全部人。度 kᵢ 是时间窗内联系过的不同人数,熟人和强联系都算在内。活动量 Cᵢ 是这个人在同一时间窗里发起的通信次数。权重 wᵢ→ⱼ 是 i 发给 j 的次数,对所有联系人求和就回到 Cᵢ。因此度是“名单有多长”,活动量是“一共发出多少次”,权重是“这几次如何分给名单上的人”。
| 数据 | 用户 | 事件 | 时间跨度 | 论文给出的人群口径 |
|---|---|---|---|---|
| 手机 | 约 400 万匿名欧洲用户 | 超过 12 亿次 | 一年 | 某个欧洲国家人口的约 25%,引自 Onnela 等,2007 |
| 邮件 | 约 3,000 名大学用户 | 超过 200 万封 | 83 天 | 另一个欧洲国家的大学职员 |
| 推特 | 约 70 万用户 | 超过 800 万条 | 2009 年 8 月至 2010 年 3 月 | 以美国用户为主 |
| 在线消息 | 约 3 万活跃用户 | 超过 50 万条 | 492 天 | 瑞典交友网站,论文称主要为青少年 |
这些“约”“超过”都来自正文,分母是用户或通信事件,不是受访者问卷。推特在主文里被放进同一套度和权重定义,一条边究竟是提及、回复还是其他关系,主文没有展开,细节指向补充材料第 1 节。邮件允许一封信多个收件人,正文说公式 (8) 为此做了调整,调整后的式子写在补充材料第 2 节。
度分布 Pₖ(k) 的分母是用户数 N,表示有多大比例的用户拥有 k 个联系人。活动量分布同样按用户归一。权重分布统计的是有向联系上的重复次数。正文把四条分布都近似写成幂律:度是 k 的 −γₖ 次方,权重是 w 的 −γ_w 次方,活动量是 C 的 −(1+β_C) 次方。幂律指数越小,极端大值越常见。
下文的数字以表 I 为准。正文开头的口头范围更粗,而且有的对象和表对不上:度指数被说成推特约 1.0、手机约 4.8,表中是推特 1.241±0.001,手机从 4.19±0.01 到 3.205±0.007;权重指数被说成邮件约 1.9,表中邮件是 1.637±0.003,1.930±0.002 属于在线消息;间隔指数被说成在线消息约 0.2,表中在线消息是 0.360±0.002,四套里最小的是推特 0.3162±0.0001。活动量指数的口头范围,推特约 0.1、手机约 3.38,与表中 0.147±0.001 和 3.39±0.01 只差在四舍五入。
| 量 | 手机 | 邮件 | 推特 | 在线消息 | 固定队长排队 | 可变队长排队 |
|---|---|---|---|---|---|---|
| 度指数 γₖ | 4.19±0.01 ~ 3.205±0.007 | 2.27±0.01 | 1.241±0.001 | 1.624±0.003 | — | — |
| 权重指数 γ_w | 1.51335±0.00006 | 1.637±0.003 | 1.8483±0.0006 | 1.930±0.002 | — | — |
| 间隔指数 β̄_τ | 0.53823±0.00001 | 0.431±0.002 | 0.3162±0.0001 | 0.360±0.002 | 0 | 0.5 |
| 活动量指数 β_C | 3.39±0.01 | 0.82±0.01 | 0.147±0.001 | 0.430±0.002 | — | — |
| 平均社交性 ᾱ | 0.58±0.01 | 0.68±0.02 | 0.78±0.01 | 0.70±0.01 | 1.0 | 0.5 |
| σ | 6.6±0.1 | 6.8±0.2 | 6.6±0.1 | 6.6±0.1 | — | — |
| ln C̄ | 3.4 ~ 5.9 | 4.8 | 5.4 | 3.0 | — | — |
表中手机的 γₖ 和 ln C̄ 用 ÷ 连接两个数,表示从较短观察到较长观察的两端,不是两数相除。误差条很小,论文写明是因为人数多。拟合好不好,正文指向补充材料第 6 节,主文没有给出卡方或决定系数。
电话打得越多,联系人为什么不会同比变多?
若通信完全随机,同一个人连续两次行动的间隔会像泊松过程那样集中在一个典型尺度附近。已有研究发现,真实间隔有胖尾。本文另外定义一条链路自己的间隔 τ:在两次联系同一个人之间,发起者还插入了多少次通信。图 1a 里,用户 A 的序列中相邻两次联系 C 被标成 3、4、5。这里的单位是事件个数,用来消掉一天之内通信量的起伏;论文指出它和真实钟表间隔有相同的渐近标度。钟表间隔本身近似随 Δt 的 −1 次方衰减,该结果写在补充材料第 3.1 节,主文没有再给一条新的拟合指数。
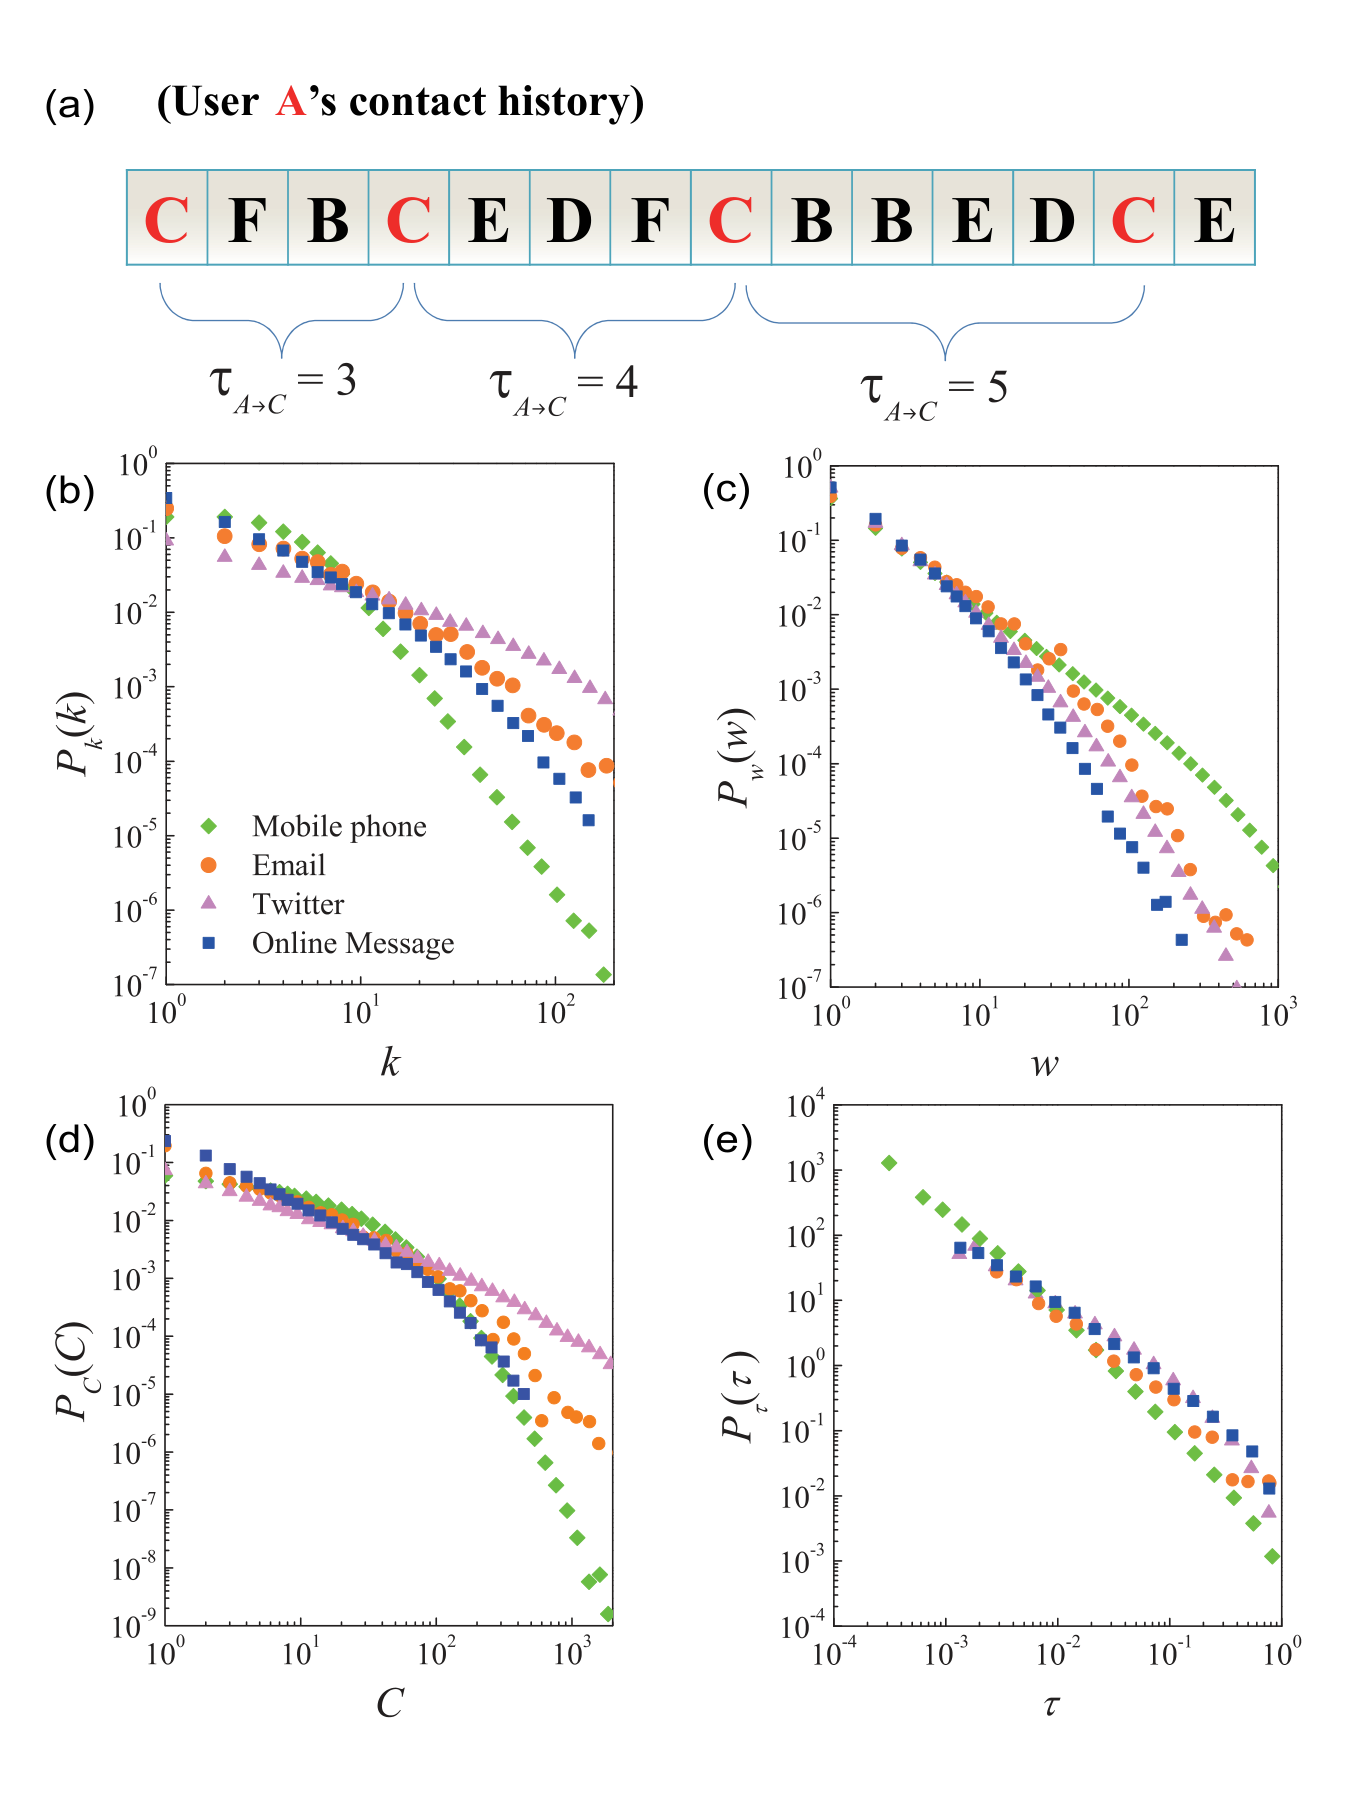
图 1|网络的名单、重复次数,和人的活动、间隔,各长什么样?
(a)示意图:用户 A 的联系序列,红字 C 是同一个人;括号下的 3、4、5 是相邻两次联系 C 之间的事件个数。(b)度分布,横轴联系人数 k,纵轴用户比例 Pₖ(k)。绿菱形为手机,橙圆为邮件,粉三角为推特,蓝方块为在线消息;手机下降最快,推特最缓,与表 I 中手机度指数最大、推特最小相一致。(c)权重分布,横轴重复次数 w。手机的尾更重,对应表中最小的权重指数 1.51335。(d)活动量分布,横轴发起次数 C。手机最陡,推特最缓,对应 β_C 从 3.39 到 0.147。(e)用每个人的活动量 C 缩放后的链路间隔分布,四套数据在双对数坐标上大体沿直线下降。来源:原论文 Fig. 1。
活动量高的人,联系人通常更多,但两套分布并不相同。对每个用户,论文把度写成活动量的幂:
kᵢ ∼ Cᵢ 的 αᵢ 次方,且每个用户的 αᵢ < 1。
αᵢ 小于 1 意味着通信次数增加时,新联系人增加得更慢。文本越长、新词增加越慢,称为希普斯定律;这里的“新词”是新联系人。昼夜节律会改变 k 和 C 随钟表时间的起伏,这条幂关系本身不随观察窗口改变。
αᵢ 被论文称为社交性(sociability):在给定的发起次数下,有多容易把下一次通信变成一个新联系人。它是这条幂的指数,不是心理量表。
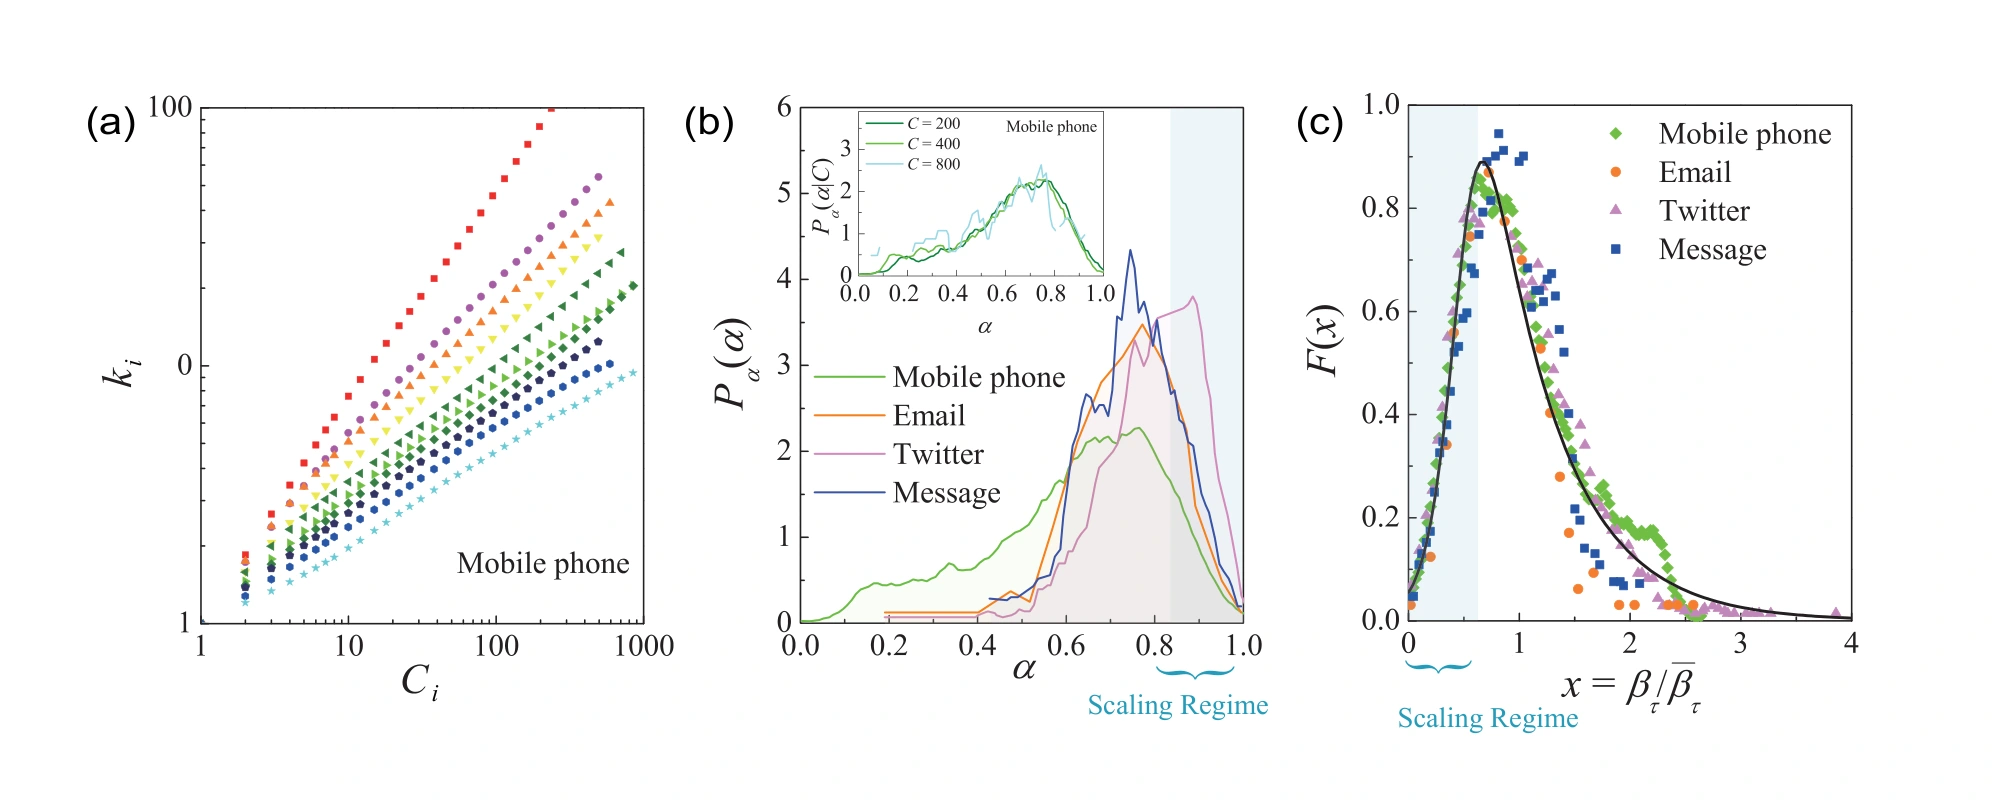
图 2|同样多的通信,为什么有人名单更长?
(a)十位手机用户。每个点是一个时间窗里的 (Cᵢ, kᵢ),双对数坐标上大致成直线,斜率彼此不同,且都低于 1。另外三套数据的同类曲线放在补充图 S3,主文未再画出。(b)四套数据的社交性分布。图注写 three studied datasets,图例实际有手机、邮件、推特、在线消息四条。右侧阴影标出用于后续标度的尾部。内图是手机用户在不同活动量下的条件分布;图例为 C=200、400、800,图注写成 200、300、800。三条曲线的峰落在同一区域,形状接近而不是逐点重合。(c)把每个系统的间隔指数除以该系统的平均值后再看分布,横轴 x=βᵢ/β̄_τ。四套数据叠在黑色 Burr II 型曲线附近;左侧阴影对应小 x,论文用 F(x)∼exp(6.6x) 描述这一段的上升。来源:原论文 Fig. 2。
内图只覆盖手机,而且只显示三个活动量档。论文据此认为社交性大体不随活动量改变,更像个人自身的一项属性。这是条件分布重叠之后的解释,不是独立测得的性格分数,也还没有在主文图里对另外三套数据做同样的条件分布。
回到旧联系人的快慢,怎样决定新名单?
间隔指数大,表示很短的间隔很多,通信反复落到旧联系人身上,名单就长得慢。论文由此得到,对每个用户
αᵢ + β_{τ,i} = 1。
推导放在补充材料第 6.1 节。表 I 报告的是两种不同的群体摘要:ᾱ 是个人指数的平均,β̄_τ 是把所有人的间隔合在一起之后、按 τ 的 −(1+β) 次方做的一阶拟合。两者相加为 0.58+0.53823=1.118(手机)、0.68+0.431=1.111(邮件)、0.78+0.3162=1.096(推特)、0.70+0.360=1.060(在线消息)。表上的两个平均数并不精确等于 1。逐人等式和这两列平均数是两件事。
尽管平均值不同,个人间隔指数的分布在除以各自平均值后会叠到一起。论文把这看成通信方式之外的人口特征:通话、邮件、推文和交友网站消息,时间跨度、国家和人群都不一样,缩放后的形状仍接近。邮件的 σ 为 6.8±0.2,其余三套为 6.6±0.1;图 2c 的曲线采用 6.6。Burr 分布里还有两个未给出数值的参数,主文只明确写出 σ=6.6。
排队模型在表里是参照,不是这四套数据的拟合结果。固定队长对应 βτ=0、α=1,也就是活动量几乎全部变成新联系人;可变队长对应 βτ=0.5、α=0.5。手机的 0.54 和 0.58 靠近可变队长一侧,推特的 0.78 离 1 和 0.5 都有一段距离。论文说这条相加关系与已有模型相容,主文没有宣布哪一个排队模型生成了这些记录。
度分布的胖尾,来自活动量还是社交性?
若社交性和活动量在统计上独立,度分布就是两者合成的结果:从活动量分布和社交性分布里抽出 C 和 α,令 k=C 的 α 次方,再看 k 的分布。这个关系不要求度和活动量必须是幂律,对数正态或拉伸指数也可以放进同一个积分。图 3a–d 比较的就是这条积分,以及“所有人共用一个平均社交性”的简化式。
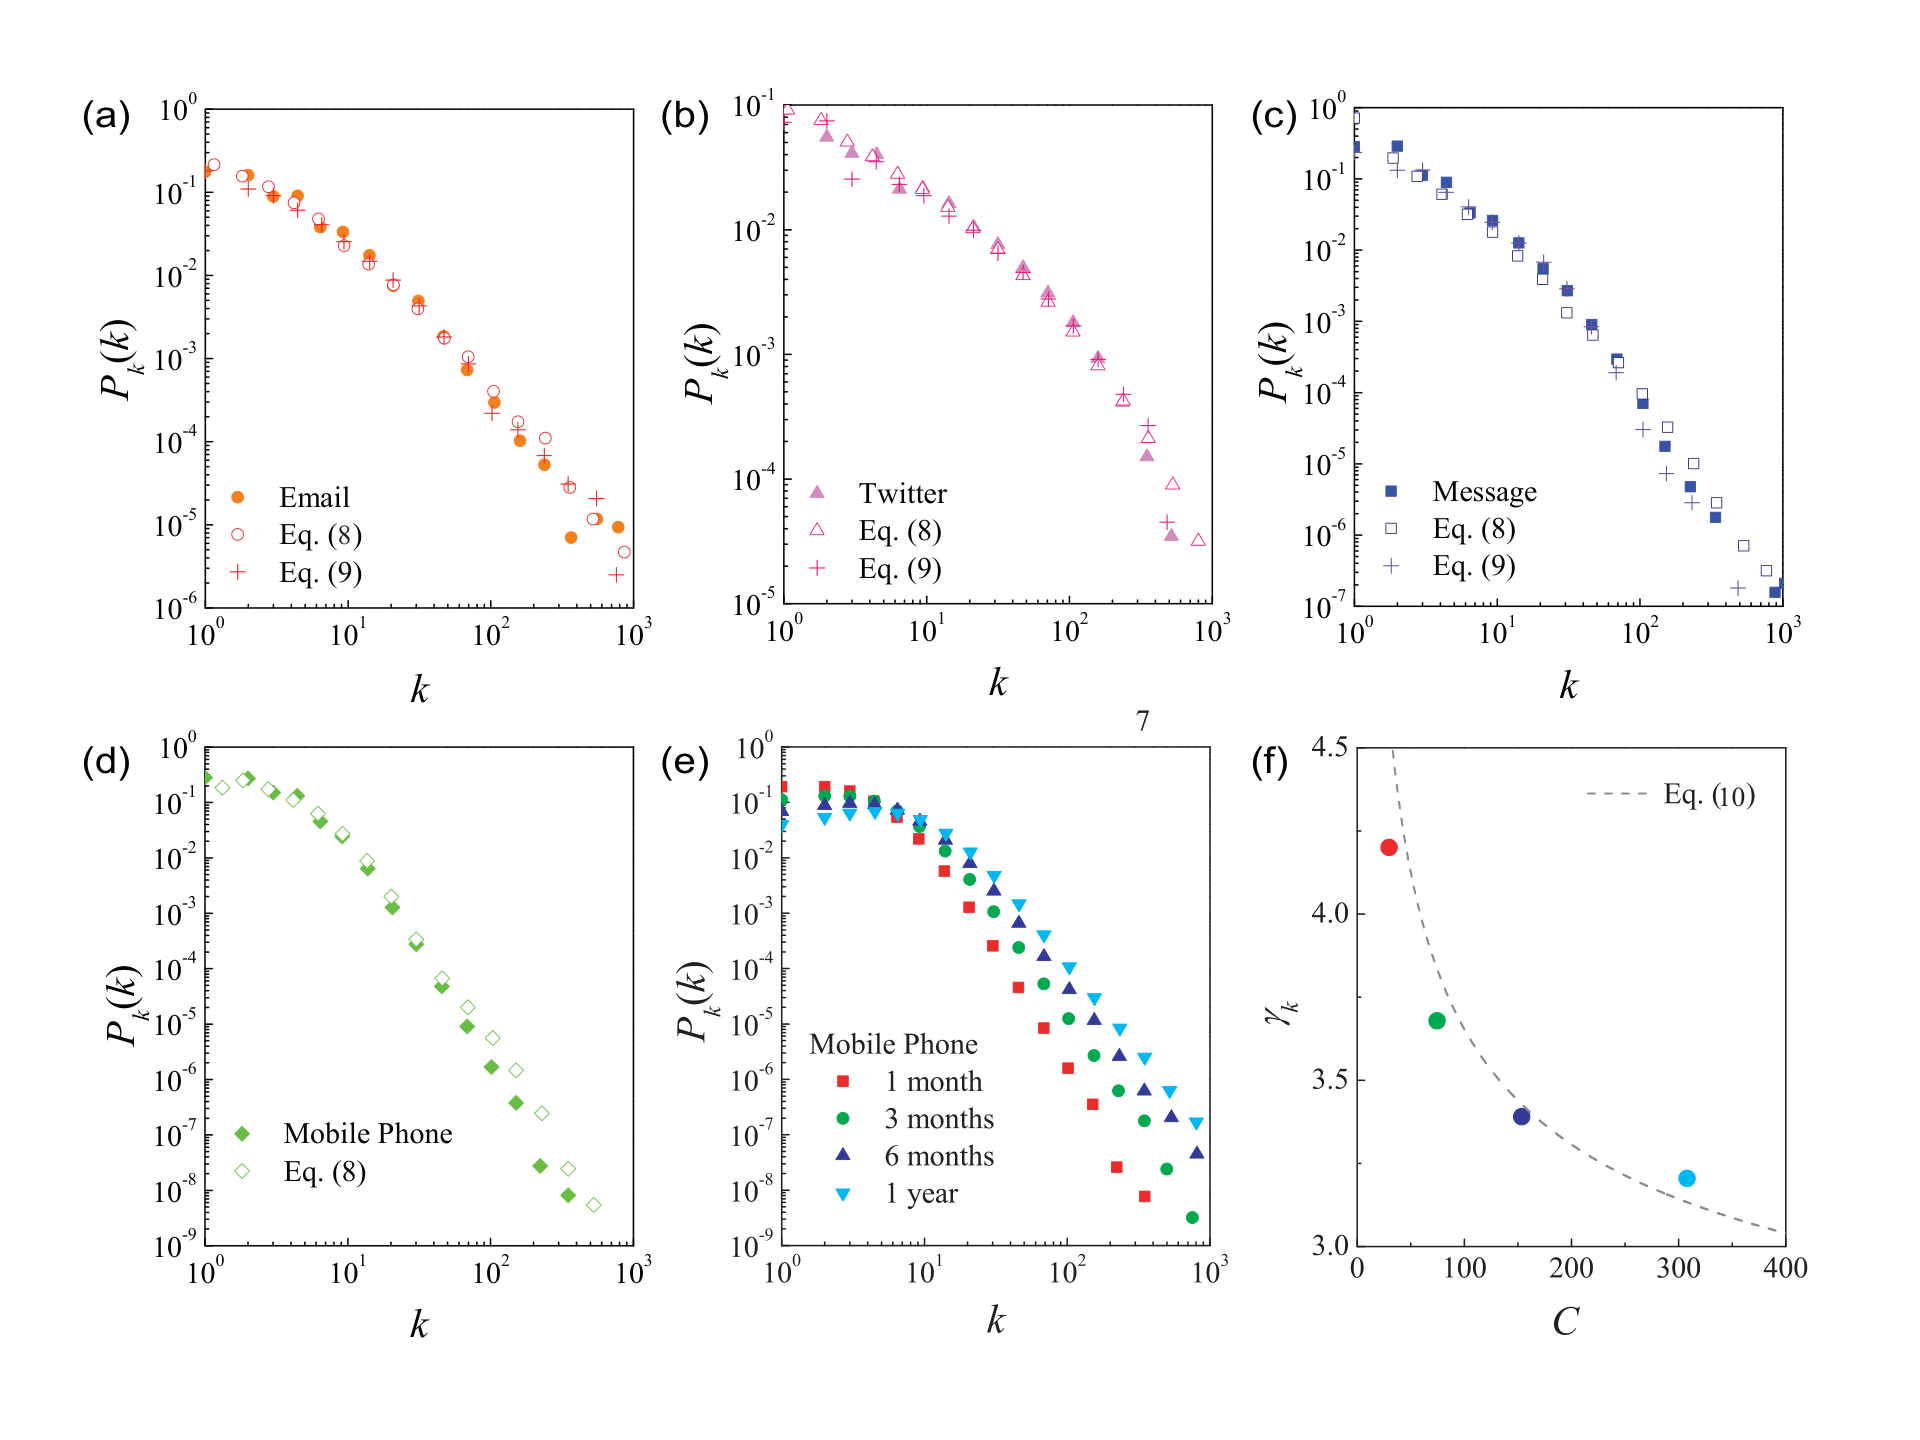
图 3|度分布能不能由活动量和社交性算出来?
(a)邮件,(b)推特,(c)在线消息:实心点为实测度分布,空心点为同时保留活动量和社交性差异的公式 (8),加号为只用平均社交性的公式 (9)。两条预测都贴着实测走。(d)手机只画了公式 (8),空心点仍贴着绿点;图注没有把公式 (9) 算作手机的成功情形。(e)手机在 1 个月(红方块)、3 个月(绿圆)、6 个月(蓝上三角)和 1 年(青下三角)的度分布。窗口越长,大 k 处下降越慢。(f)度指数 γₖ 对平均活动量 C̄。四个点的颜色与(e)一致,虚线是公式 (10)。图注没有逐点标出 C 的读数,两端的数值以表 I 为准。来源:原论文 Fig. 3。
公式 (8) 与整条分布的贴合,是正文称为“很好的一致”的那一项证据。它比后面的指数公式更直接。指数公式是再假定幂律、并用一个代表值代替整个分布之后的摘要。
情形 1:活动量的差别主导。把每个人的社交性换成平均值之后,度分布只是活动量分布经过 k=C^α 的拉伸。若活动量本身是幂律,度指数可写成
γₖ = 1 + βC / (1 − βτ)。
这里用 1−βτ 代替 α,因为逐人关系里二者相等。代入表 I:邮件 1+0.82/(1−0.431)=2.441,推特 1+0.147/(1−0.3162)=1.215,在线消息 1+0.430/(1−0.360)=1.672。实测是 2.27±0.01、1.241±0.001、1.624±0.003。若改用表中的 ᾱ 做分母,三个预测变成 1+0.82/0.68=2.206、1+0.147/0.78=1.188、1+0.430/0.70=1.614,离实测更近。差别就来自前面那四个 1.06 到 1.12 的平均数之和。图 3a–c 里公式 (9) 贴合实测,说明这三套数据属于情形 1。用 1−β̄τ 作分母时,邮件的预测比实测高约 0.17,推特低约 0.026,在线消息高约 0.05。这是用一个代表指数代替整条分布之后的余量。
情形 2:社交性的差别主导。把活动量换成平均值 C̄ 后,社交性分布的指数尾会变成度的幂律,指数里出现 ln C̄:
γₖ = 1 + σ / (β_τ ln C̄)。
平均活动量越大,度指数越小,极端联系人越常见。论文指出,这个指数依赖于一个会随观察变长而增大的量。把两项合在一起,预测的度指数是
γₖ = 1 + min[ βC/(1−βτ) , σ/(β_τ ln C̄) ]。
对手机,第一项是 3.39/(1−0.53823)=7.34,对应 γₖ 约 8.34。第二项在 ln C̄=3.4 时为 6.6/(0.53823×3.4)=3.61,在 5.9 时为 6.6/(0.53823×5.9)=2.08,对应 γₖ 约 4.61 和 3.08。较小的是第二项,所以手机落入情形 2。实测两端是 4.19±0.01 和 3.205±0.007。方向相同:窗口变长、平均活动量上升,度指数下降。4.61 对 4.19、3.08 对 3.205,差距大于表上 ±0.01 的拟合误差。误差条只反映人数很大时指数估计有多稳,没有把 σ、β_τ 和尾部近似的不确定性算进去。
ln C̄ 从 3.4 到 5.9,是表上印刷的自然对数。换算成平均每人发起的通信次数,约为 e^3.4≈30 和 e^5.9≈365。这是换算,不是表里另印的整数。图 3f 的横轴画到 400,与上端大约三百多的量级相符;各点的精确横坐标图注没有给出。
论文还写,邮件、推特和在线消息的度指数不随观察时间改变,分时间窗的图在补充材料第 7 节。正文图 3e 只展示手机。手机用户个人活动在时间上大体平稳,论文指向补充图 S8a。因此,图 3f 里度指数的下降,被解释成平均活动量上升之后社交性尾部的结果。主文直接画出来的是 γₖ 随 C̄ 下降,并与公式 (10) 同向。
强联系和弱联系,能不能从同一个指数推出来?
一个人发出的通信不是均匀分给所有联系人。把联系人按通信次数从多到少排名,第 r 名分到的比例 p_r=w/C 近似服从齐夫定律:p_r ∼ r 的 −ζᵢ 次方。直觉上,活动量相同的人会有相同的 ζ。图 4a 显示不是这样。
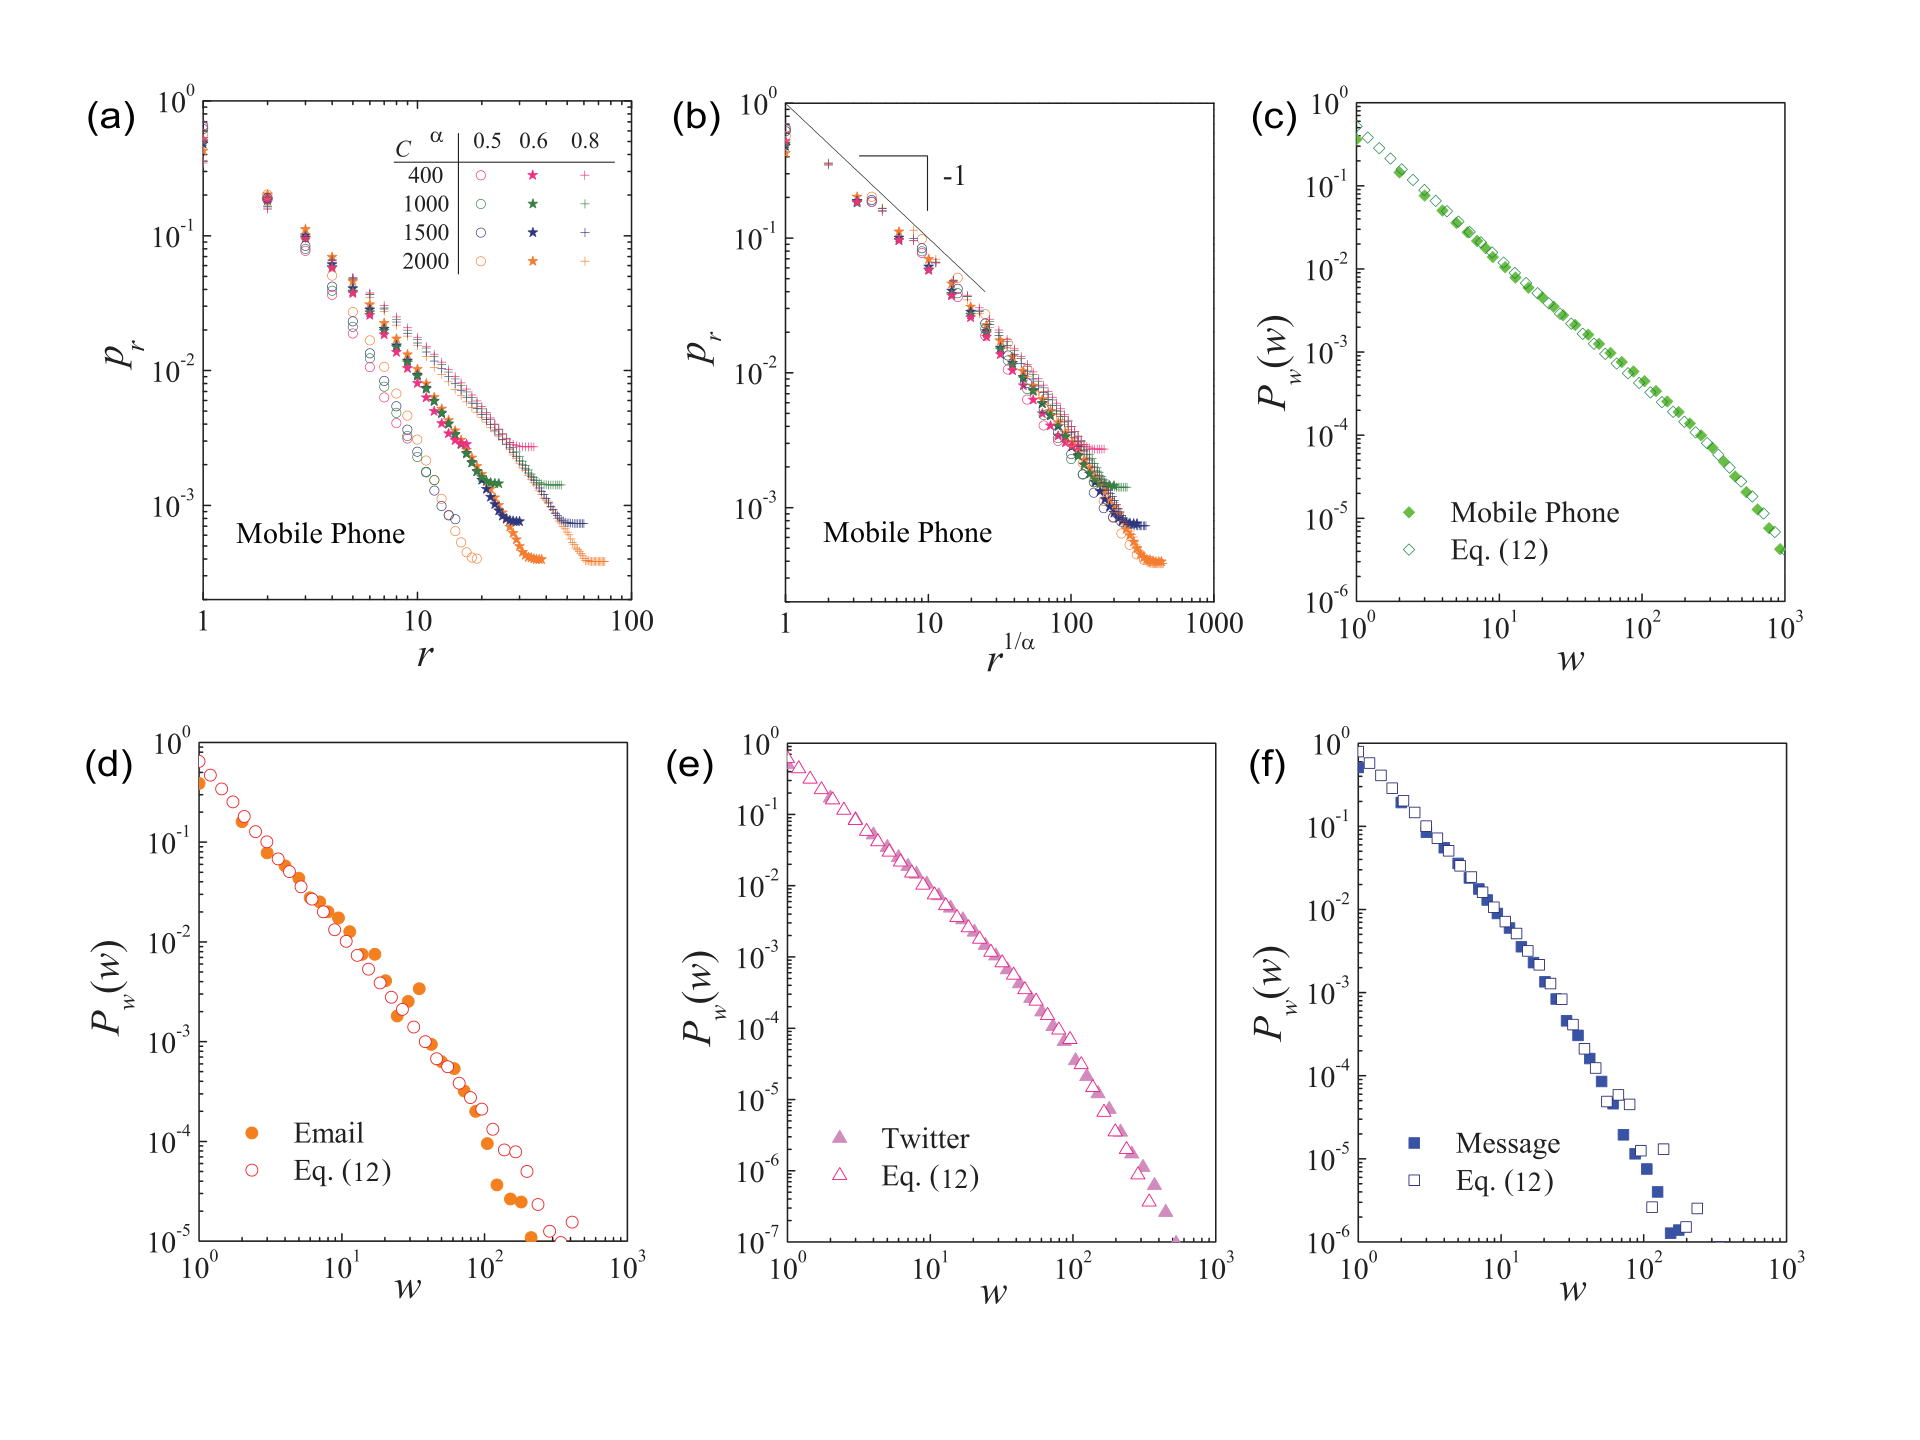
图 4|重复次数的分布,能否从社交性推出来?
(a)手机用户的齐夫图。横轴名次 r,纵轴分给该联系人的通信比例。图例中活动量 C 取 400、1000、1500、2000,社交性 α 取 0.5、0.6、0.8。同一 α、不同 C 的斜率接近;同一 C、不同 α 则分开。正文另举了三个活动量都是 400 的用户作为例子。(b)横轴改成 r 的 1/α 次方后,不同社交性的曲线叠在一起,靠前名次对准斜率 −1 的参照线,对应 αζ=1。(c)手机,(d)邮件,(e)推特,(f)在线消息:实心点为实测权重分布,空心点为公式 (12)。四套都沿同一趋势下降;在线消息在大 w 处更散。原图注把 P_w 写成 degree distribution,坐标轴是权重 w。来源:原论文 Fig. 4。
论文用最不受偏好的那个联系人来连接 ζ 和 α:无论这个人总共发出多少次通信,留给名单末位的次数都只有大约常数次,不随 C 成比例增加。于是 αᵢζᵢ=1。图 4b 的塌缩和靠前名次的 −1 斜率与此相符。这是标度论证加上图上的塌缩,不是逐人清点后得到的“末位联系人恰好只有 1 次通信”。其他数据集的齐夫图在补充图 S4 和补充材料第 3.3 节。
有了 αζ=1,群体的权重分布可以由活动量和社交性的分布积分出来,即公式 (12)。一阶近似下,权重指数等于 1 加平均社交性;再用 α+β_τ=1,就写成
γw = 2 − βτ。
用表 I 的 β̄τ 代入:手机 2−0.53823=1.462,实测 1.51335±0.00006;邮件 2−0.431=1.569,实测 1.637±0.003;推特 2−0.3162=1.684,实测 1.8483±0.0006;在线消息 2−0.360=1.640,实测 1.930±0.002。若直接用 1+ᾱ:手机 1.58、邮件 1.68、推特 1.78、在线消息 1.70。手机和邮件两种算法都离实测较近,在线消息两种都差到 0.2 以上。论文说表 I 支持 γ_w=2−βτ。从表上能核对的是方向和数量级;在线消息与推特说明它停在一阶近似,没有变成逐套数据的恒等。
这些等式约束了什么?
公式 (8) 到 (13) 把度分布和联系强度分布写成人类活动的指数。它们不依赖某一种通信渠道的细节,所以后来针对某一系统同时解释动力学和网络的模型,需要满足这些关系。指数本身从哪来,论文写明仍要做针对该通信过程的机制模型。图上的贴合表示这些关系能够重新组织表 I 里的一串指数,不表示排队、偏好或某种心理动机已被证明是唯一原因。
能推广到的范围也停在这四套记录的口径上。手机大约覆盖某个欧洲国家人口的 25%,邮件是一所大学在 83 天里的往来,推特以美国用户为主,在线消息是瑞典青少年在交友网站上的 492 天。度是留下数字记录的通信对象数。平均社交性在 0.58 到 0.78 之间变动,间隔指数的平均值也随系统变化;跨系统稳定下来的是缩放之后的分布形状,以及 α 与 β_τ、ζ 之间的关系,不是一个放之四海的单一指数。
一句话总结
联系人名单为什么不会随通话次数同比变长,是因为新联系人按小于 1 的指数增长,而这个指数又和回到旧联系人的快慢绑在一起;四套通信记录里,度分布和权重大体能由活动量与社交性写出来,写出的是带余量的标度关系。
核心来源
- arXiv:1209.1411v2,2013年4月8日预印本。页面未印 DOI。正文另引用补充材料第 1–7 节及图 S2、S3、S4、S6、S8;这些图的具体数值没有写进主文。
- 手机数据的人群比例指向 Onnela 等,Proceedings of the National Academy of Sciences,2007。邮件数据指向 Eckmann、Moses 与 Sergi,Proceedings of the National Academy of Sciences,2004。在线消息指向 Holme、Edling 与 Liljeros,Social Networks,2004。
作者介绍
三位作者的单位以论文首页署名为准。
- Chaoming Song:署名美国东北大学复杂网络研究中心,物理、生物与计算机科学系,以及 Dana-Farber 癌症研究所癌症系统生物学中心。本文由他与合作者把活动量、社交性和网络的度、权重写成一组标度关系。
- Dashun Wang:首页署名与 Song 相同的两个机构,是上述标度关系和四套数据比较的共同作者。
- Albert-László Barabási:除上述两个机构外,还署名为哈佛医学院布列根和妇女医院医学系。本文参考文献中,他参与的工作包括无标度网络(Science,1999;Reviews of Modern Physics,2002)和人类活动间隔偏离泊松过程(Nature,2005)。本文讨论这些指数如何互相约束。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同一批手机用户,观察窗口从 1 个月拉到 1 年,度指数下降,极端联系人变得更常见。若另一项研究只保留两周,即使用同一批人,超级联络人也应显得更少。比较两座城市“谁的通信网络更不均衡”时,可以先看平均活动量的自然对数是否已经对齐。论文只在这一套欧洲手机数据上给出了 γₖ 随 C̄ 下降;换国家或换平台之后是否仍服从公式 (10),正文没有检验。
邮件、推特和在线消息的度尾主要由活动量主导,手机的度尾主要由社交性主导。因此,限制每个人能发出的消息数,对前三类系统的度尾会更直接,对手机则未必按同样比例削平联系人数量的差别。这是从两类情形推出来的差别,论文没有做限制发送量的实验。
最弱联系只占大约常数次通信,是推出 αζ=1 时用的标度假设,图 4b 与它相容。若一个产品持续把很久没有说话的人送回对话列表,末位联系上的次数会跟着总活动量上升,这个假设就会偏离,权重指数也难以再只靠间隔指数写成。那会是对假设的一次检验,不是这篇论文已经观察到的结果。