一座大城市的兴趣点人流,能迁到另一座城市吗?
论文名片|Hongrong Yang、Markus Schläpfer,UrbanPulse: A Cross-City Deep Learning Framework for Ultra-Fine-Grained Population Transfer Prediction,arXiv:2507.17924v1[cs.LG],2025年7月23日。arXiv:2507.17924。本文依据这一版预印本解读。
早上七点,商场、地铁口和学校之间,未来三个小时会有多少人过去?洛杉矶若已有一整月记录,旧金山的标注少得多,直接沿用大城市的模型很省事。城市结构不同时,这种沿用可能只在大流量边上失手,也可能一换方向就失效。
这里要预测的人口转移,是兴趣点之间短时段的起讫人数。居住地迁移、以及认出某个行人的下一步,属于另一类问题。模型先在洛杉矶预训练,再以冷启动和强化学习迁到旧金山;反向试验则用更小的弗雷斯诺去预测洛杉矶。向下迁时,两种误差都低于在目标城市从零训练;向上迁时,均方误差升到表中最高,平均绝对误差却是表中最低。单张图上可以有 99% 以上的边被标成判对,这个比例的分母是该时段被评估的边,和表里的误差不是同一个数。
先说结论
- 分析单位是兴趣点之间、每 15 分钟的有向转移人数。2023 年 3 月,CITYDATA.ai 的原始定位约 11.0 亿个点,清理后为 1.0307 亿个,覆盖洛杉矶、旧金山和弗雷斯诺。洛杉矶网络有 38,628 个兴趣点,旧金山有 28,580 个;弗雷斯诺的兴趣点数量没有给出。
- 洛杉矶测试集上,UrbanPulse 的均方误差为 1.79×10⁻²,平均绝对误差为 2.08×10⁻²。相对 Graph WaveNet 的 2.37×10⁻²,均方误差低 24.47%。表 1 能核对数值的基线只有三种。
- 2023 年 3 月 29 日早上 7:00 这一刻,洛杉矶被评估的 4,267 条边里有 4,258 条判对,占 99.79%。论文没有写出“判对”相差多少人仍算对。
- 洛杉矶模型迁到旧金山后,冷启动加强化学习的均方误差为 0.64×10⁻²、平均绝对误差为 1.08×10⁻²,两项都低于从零监督训练(1.05×10⁻² 和 2.74×10⁻²),也低于不做微调的零样本(0.72×10⁻² 和 2.03×10⁻²)。
- 弗雷斯诺模型直接预测洛杉矶时,均方误差为 3.07×10⁻²,是该表监督训练 1.79×10⁻² 的 1.72 倍;平均绝对误差却是 1.43×10⁻²,为该表最低。向上迁移在两个指标上不是同一种失败。
这 15 分钟里,数的是兴趣点之间的人数
旧的引力模型让两地流量随人口增加、随距离下降;辐射模型再把两地之间的人口当作插入的机会。它们形式简单,也把空间分区和均衡关系写死了。引言认为,这种写法难跟上不对称、随时间变化的城市流动,也难在不损失精度的情况下细到每一个兴趣点。按网格做卷积,边界和分辨率又会限制到兴趣点。图神经网络若靠一张固定的邻接表,换一座城市往往要整网重训。引言还提到大语言模型计算贵,并且把流动看成没有空间结构的序列;后面的实验表没有给出任何大语言模型的误差。
UrbanPulse 把城市写成一串随时间变化的有向图。点是 OpenStreetMap 上的兴趣点,用 OSMnx 取出,在同一座城市里保持为固定节点。每 15 分钟一张图。边上的权重是该时段内从起点兴趣点到终点兴趣点的转移人数;该时段至少发生一次转移,才建立这条边。节点特征共 7 维:兴趣点类型、经纬度、该点人数,以及 2 米气温、降水量和风速。天气来自哥白尼气候数据存储的 ERA5 再分析,风速由向东和向北的 10 米风分量合成。降水量先截断在每小时 50 毫米,再取对数。连续特征按训练集的最小—最大缩放压到 0 到 1,兴趣点类型另做可学习的嵌入。
数据是 2023 年 3 月的匿名 GPS。原始约 11.0 亿个点,清理后 1.0307 亿个;建图时还有一次基于速度的异常点剔除,正文没有给出速度或距离阈值。洛杉矶用于预训练,训练、验证、测试大约按 70%、15%、15% 划分。旧金山按大约 2:4:1 分成冷启动微调、强化学习适应和最终评估。弗雷斯诺的划分比例没有报告。因此后文的误差都是这一个月、这三座加州都市区、这一套兴趣点图上的比较,不能直接换成其他月份或其他国家的人数。
预测要输出的是边的人数,并且用 Softplus 保证不为负。结果部分把任务写成:从固定起点一次给出连续 12 个 15 分钟,也就是 3 小时,不把上一步预测再喂回下一步。方法部分又写,滑动窗口的标签是窗口最后一个时间步的边流量。两处没有互相解释。下面图中的数字,是 2023 年 3 月 29 日三个 3 小时窗口里、每个 15 分钟片段上的预测结果。
预训练的损失,按步和按轮差着一个数量级
洛杉矶预训练用均方误差训练全部层,并选验证损失最低的检查点。图 1 把同一次训练拆成逐步和按轮两种看法。
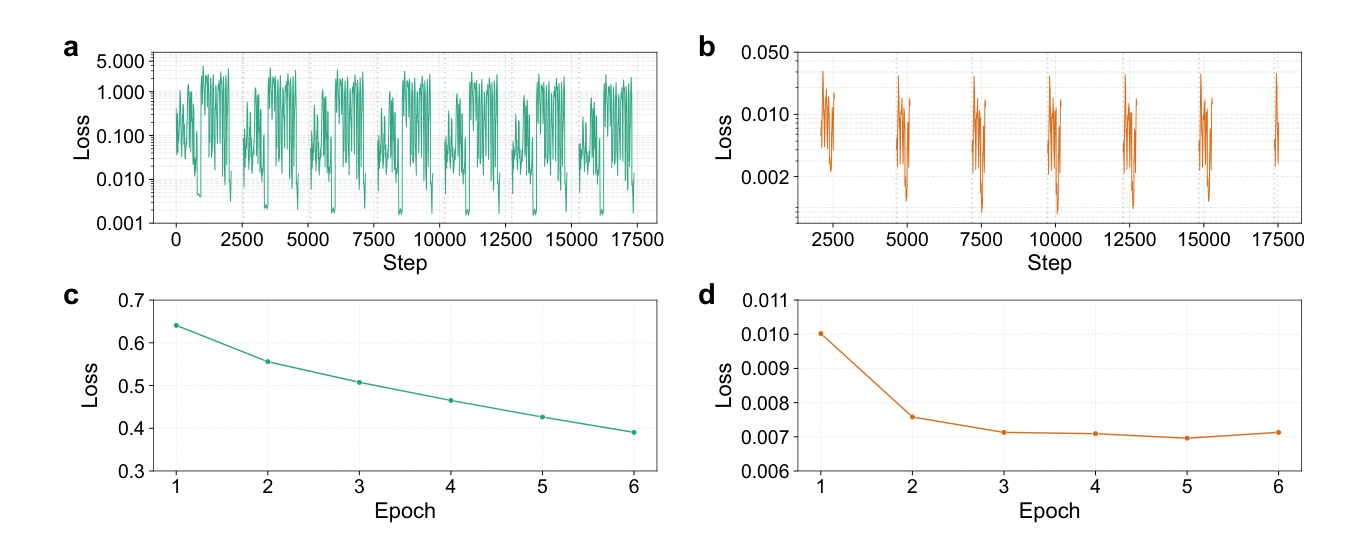
图 1|预训练损失是平稳下降,还是只在按轮平均后才下降?
(a)逐步训练损失,纵轴为对数,范围从 0.001 到 5,横轴步数标到 17,500。曲线在整个范围内大幅跳动。(b)逐步验证损失,纵轴从 0.002 到 0.050,反复出现尖峰。(c)6 个 epoch 的训练损失逐轮下降,第 1 轮在 0.6 与 0.7 之间,第 6 轮落到 0.4 刻度下方。(d)按轮验证损失先降后在第 6 轮略升,第 5 轮略低于 0.007 刻度。图注写验证损失最低为 0.0104,与(d)的最低点不在同一位置;0.0104 也没有标在(b)的某一步上。来源:原论文 Fig. 1。
(c)和(d)的纵轴相差一个数量级以上。论文没有说明按轮损失怎样从逐步损失汇总而来,所以不能用 0.4 减去 0.007,说成验证比训练好了多少倍。后文比较模型时,以测试集上的均方误差和平均绝对误差为准,不把图 1 的最低点当成测试误差。
在洛杉矶,三种有数值的基线高了多少?
表 1 比较的是洛杉矶测试集。正文写五种最新基线,表中写出数值的是 Graph WaveNet、EGAT 和 DCRNN。另外两种没有出现,这里不补。
| 指标 | UrbanPulse | Graph WaveNet | EGAT | DCRNN |
|---|---|---|---|---|
| 均方误差 | 1.79 | 2.37 | 2.46 | 3.50 |
| 平均绝对误差 | 2.08 | 2.44 | 2.63 | 3.89 |
表中数字是论文为阅读方便乘以 10⁻² 之后的值,所以 1.79 表示 1.79×10⁻²。表头把模型写成 Urban Pulse。论文没有说明这些误差是对原始人数,还是对缩放后的流量计算。它们可以排序,不能直接读成平均差了多少人。百分比不受这个共同倍率影响。
以 Graph WaveNet 为分母,均方误差低 (2.37−1.79)/2.37=24.47%,平均绝对误差低 (2.44−2.08)/2.44=14.75%。相对 EGAT 的均方误差 2.46×10⁻²,低 27.23%;相对它的平均绝对误差 2.63×10⁻²,低 20.91%。相对 DCRNN 的均方误差 3.50×10⁻²,低 48.86%。Graph WaveNet 是表中次低的一项,也是最接近的对照。20.91% 是完整模型对 EGAT 的差距;作者把它联系到正弦时间编码和时间卷积,模块各自的贡献要看后面的消融,不能把这一百分比只记在某一个模块上。
这三项基线只出现在洛杉矶测试集。旧金山和弗雷斯诺的表比较的是迁移方式,没有再报告 Graph WaveNet、EGAT 或 DCRNN。
99% 判对,分母是这一时段的边
图 2 是洛杉矶测试数据里单独一个 15 分钟:2023 年 3 月 29 日 7:00。节点仍是全部 38,628 个兴趣点,但被计数的不是所有兴趣点对。38,628 个点之间的有向点对远多于图上的边;图上只画了这一时刻的预测流动。
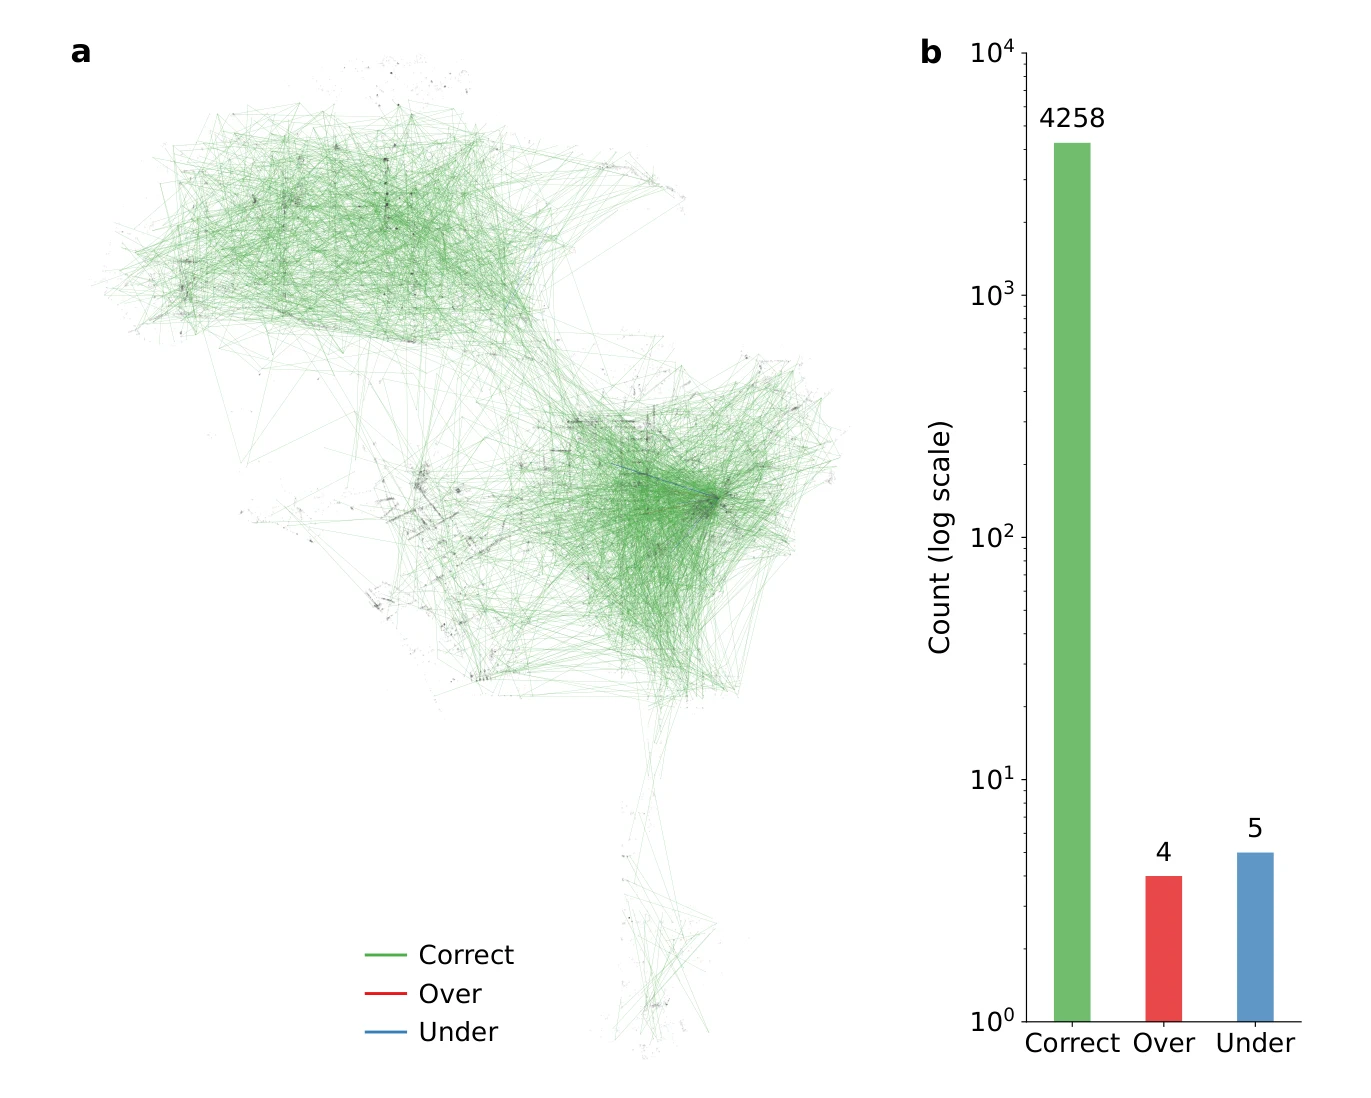
图 2|早上 7 点这一刻,判对的边占被评估边的多少?
(a)洛杉矶兴趣点网络。绿为判对,红为高估,蓝为低估。密集绿色连线覆盖主要建成区,红蓝边很少,图例没有给出误差的人数阈值。(b)同一时刻的边数,纵轴为对数。判对 4,258,高估 4,低估 5,合计 4,267。4,258/4,267=99.79%。对数轴让 4 和 5 仍然可见,二者合计 9 条,占 4,267 的 0.21%。来源:原论文 Fig. 2。
99.79% 的分母是这 4,267 条边,不是 38,628 个兴趣点,也不是全部可能的点对。论文只说明颜色表示相对真实值的判对、高估或低估,没有写出相差几个人以内仍算判对。因此这个百分比不能换成表 1 的 1.79×10⁻²,也不能理解成每个兴趣点对的人数都已经测准。
三个 3 小时窗口把这一天拆开。每个窗口 12 个连续的 15 分钟。早晨 7:00–10:00 的合计是另一套分母。
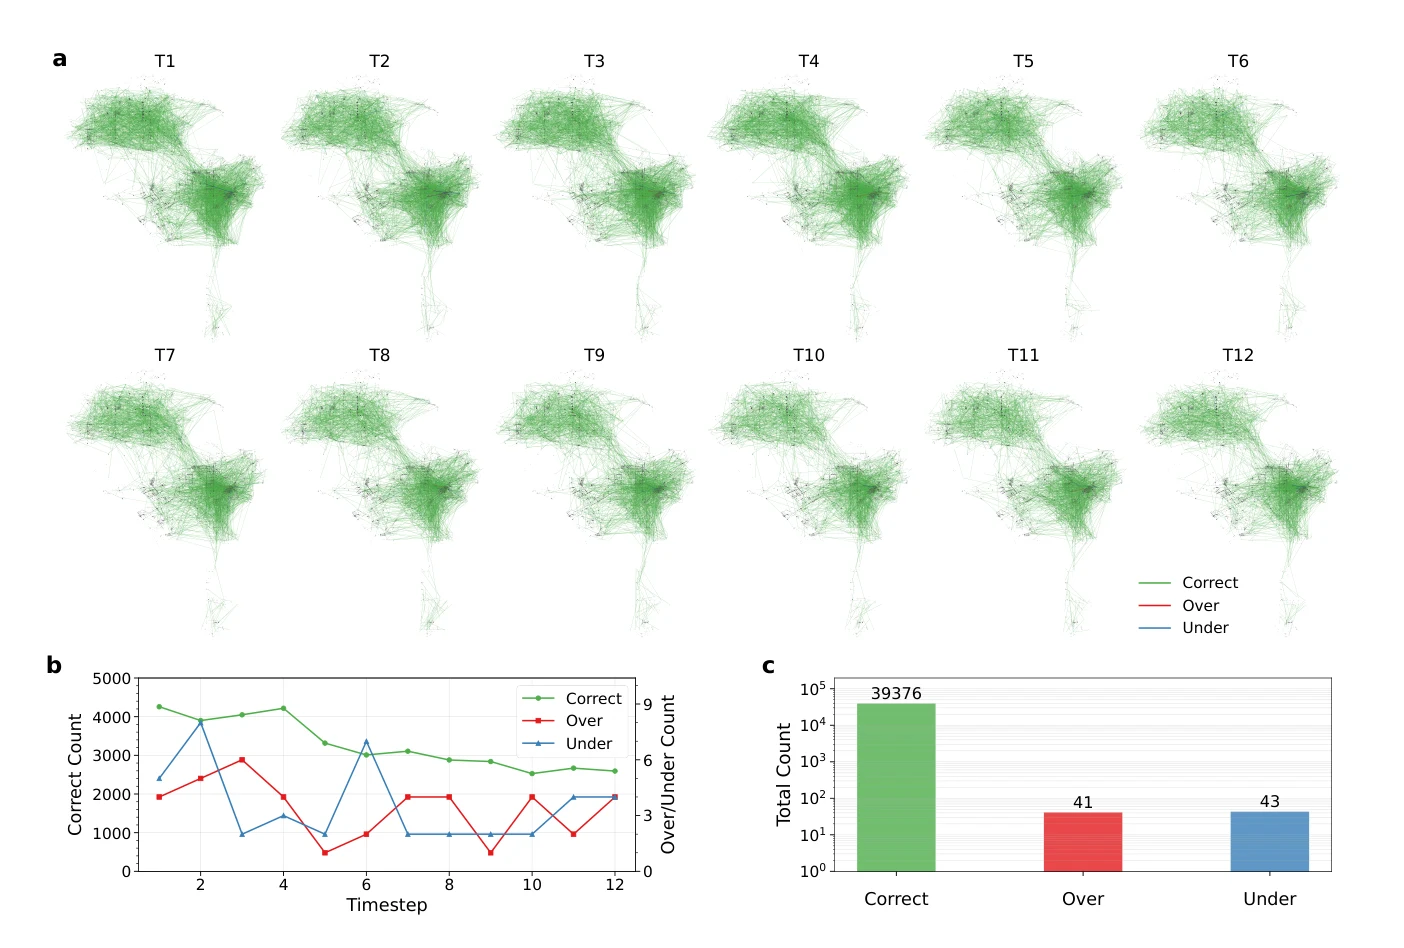
图 5|洛杉矶早晨 3 小时的 99.79%,和 7 点那一张是不是同一批边?
(a)T1 到 T12 共 12 张空间子图,颜色仍是判对、高估、低估;节点规模在图注中为 38,628。(b)每个 15 分钟的三条计数,左轴是判对数量,右轴是高估和低估数量。(c)3 小时合计,纵轴为对数:判对 39,376,高估 41,低估 43,合计 39,460。39,376/39,460=99.79%。来源:原论文 Extended Data Fig. 1。
早晨 3 小时与单独的 7:00 都四舍五入到 99.79%,分母分别是 39,460 和 4,267。7:00 的 4,267 条边是早晨的一部分,不是早晨的十二分之一;39,460 不能被 12 整除,各时段的边数本来就不相等。高估 41 与低估 43 接近,早晨的误差没有明显偏向某一侧。
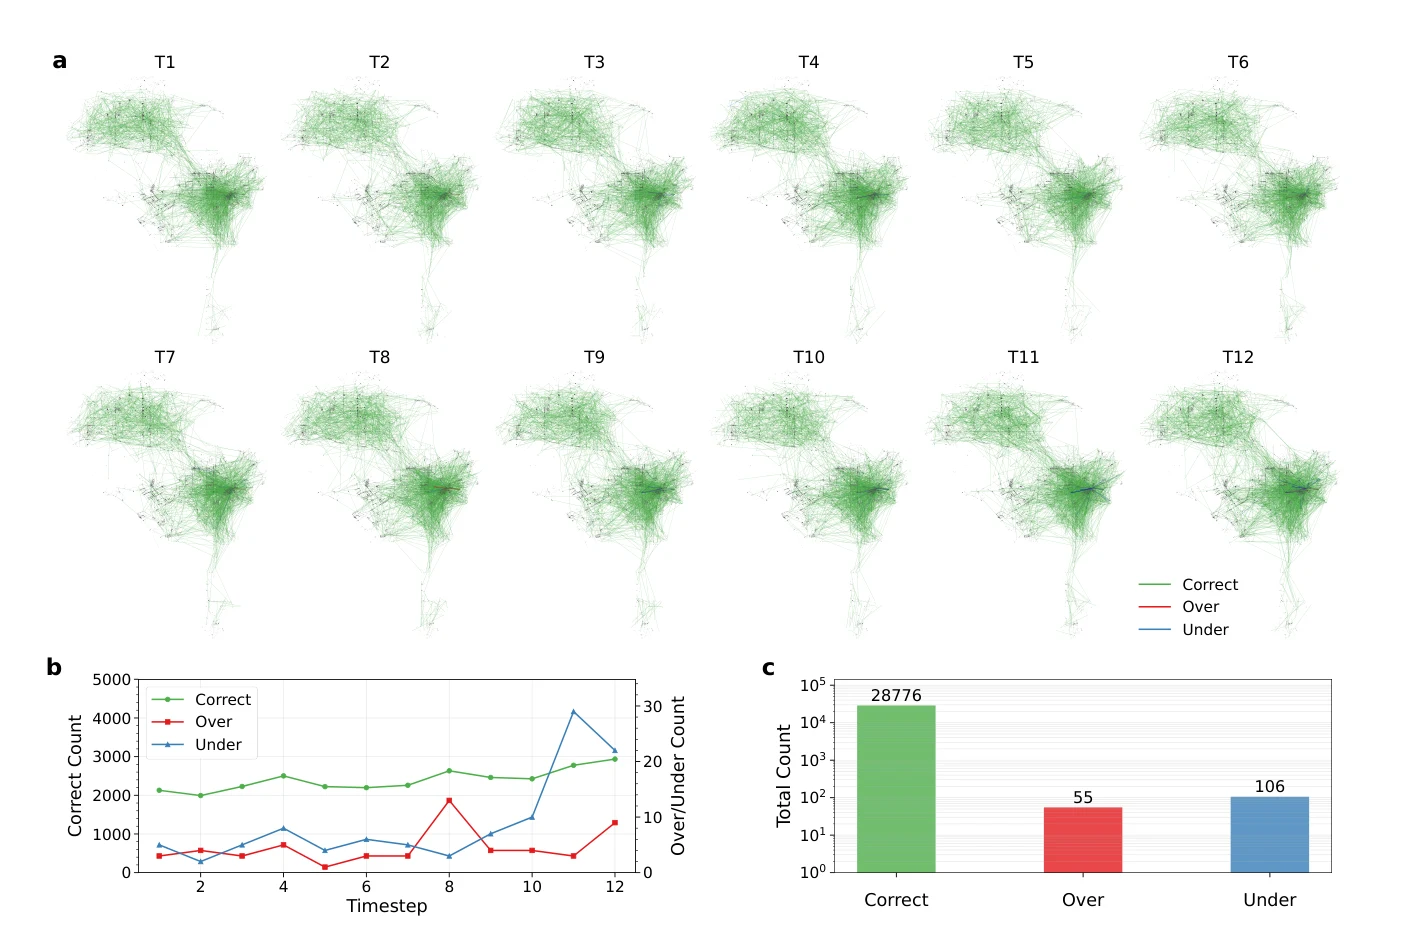
图 6|中午的误差是否更偏向低估?
(a)12:00–15:00 的 12 张子图,颜色含义与图 5 相同。(b)逐时段计数。低估在后几个时段升高。(c)合计:判对 28,776,高估 55,低估 106,合计 28,937。28,776/28,937=99.44%。来源:原论文 Extended Data Fig. 2。
中午低估比高估多,106 对 55。误差条数是 161,占 28,937 的 0.56%,高于早晨的 84/39,460=0.21%。论文把中午描述为波动较低的时段,同时指出模型更倾向保守的低估。
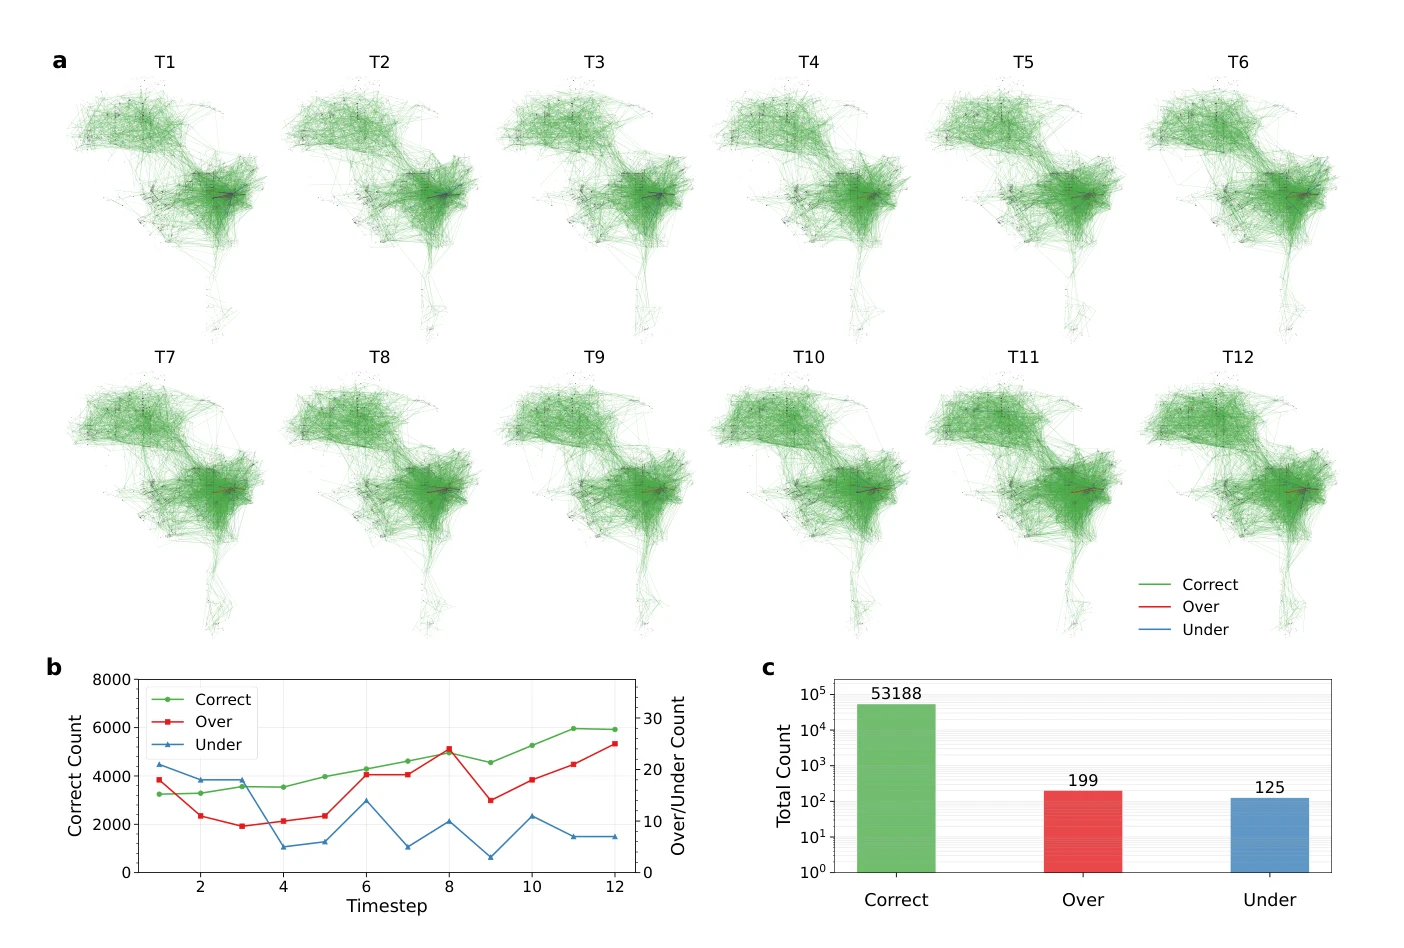
图 7|傍晚是否是洛杉矶这三窗里最难的一段?
(a)17:00–20:00 的 12 张子图。图注写误差在兴趣点密集处反复出现;单张缩略图只能看出少量红蓝边,看不出具体是哪些兴趣点。(b)逐时段计数,判对数量高于早晨和中午的纵轴范围,右轴仍是误差条数。(c)合计:判对 53,188,高估 199,低估 125,合计 53,512。53,188/53,512=99.39%。来源:原论文 Extended Data Fig. 3。
傍晚的误差是 324 条,占 53,512 的 0.61%,是三个窗口里最高的错误比例。这里高估多于低估,199 对 125,方向与中午相反。边也更多:53,512 高于早晨的 39,460 和中午的 28,937。错误比例升高,不单是因为傍晚画出来的边更多。
三张图支持的是同一天、三个时段上的边级对错计数。它们不包含置信区间,也没有和其他日期对照。讨论提到,均方误差改善之后,平均绝对误差的优势更窄,稀少或极端流量仍然难。表 1 里相对 Graph WaveNet 的 24.47% 与 14.75% 就是这种宽窄差别;图 5 到图 7 没有按流量大小把误差拆开。
迁到旧金山时,从零训练和沿用预训练差在哪?
旧金山有 28,580 个兴趣点。试验用洛杉矶代表大都市,看大都市的模式能否迁到规模较小、仍属沿海都市的旧金山。论文提到两城人口密度不同,但没有给出人口密度数值。
冷启动冻结时间卷积、图卷积和 Transformer 解码器的浅层,只更新这些模块的深层和最后的输出投影。这样做是为了留下预训练里较通用的时间和拓扑特征,避免用少量旧金山数据改写全部参数。强化学习不重训整张图。它用 PPO 在每个 episode 结束时给一次奖励,奖励是加权均方误差与平均绝对误差的相反数。加权项是 1 加上该边真实人数除以本批次最大真实人数,所以大流量边的平方误差罚得更重。动作只按比例缩放解码器输出层的权重组,缩放被限制在 −2 到 2。奖励公式里的全局系数和平均绝对误差的相对权重没有给出具体数值。
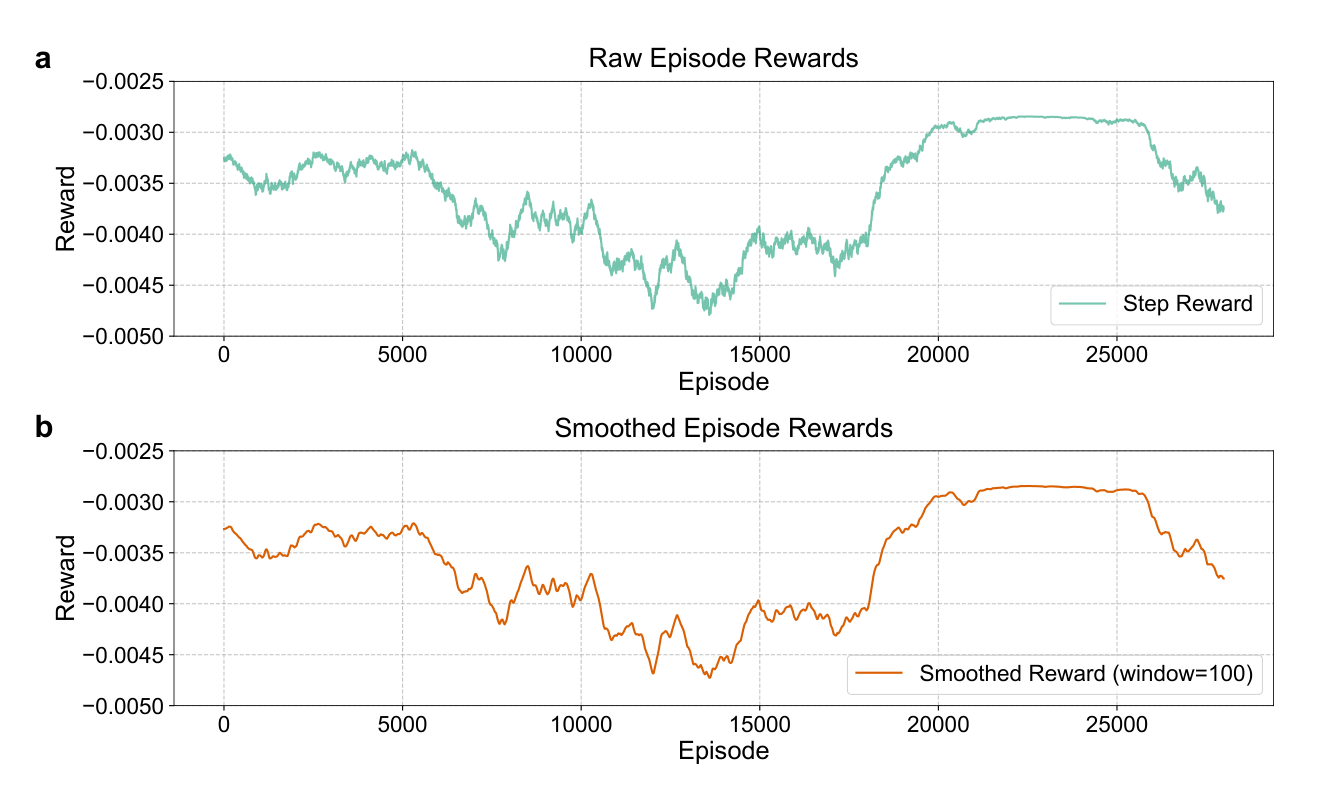
图 3|强化学习的训练奖励后来稳定了吗?
(a)原始奖励。纵轴为负,刻度从 −0.0050 到 −0.0025;越靠近零,加权误差越小。横轴是 episode,刻度标到 25,000。图例写 Step Reward。(b)窗口为 100 个 episode 的滑动平均。大约 21,000 个 episode 之后曲线升到较不负的一段,右端又下降。来源:原论文 Fig. 3。
论文写奖励在约 21,000 个 episode 后稳定。图的右端下降说明,训练末段并没有停在这段曲线的最好位置。奖励曲线是微调过程,旧金山测试集的误差在表 2。
| 指标 | 强化学习且冷启动 | 监督学习 | 冷启动 | 监督且冷启动 | 洛杉矶模型直接用于旧金山 |
|---|---|---|---|---|---|
| 均方误差 | 0.64 | 1.05 | 0.68 | 1.32 | 0.72 |
| 平均绝对误差 | 1.08 | 2.74 | 1.13 | 1.39 | 2.03 |
数值同样已乘以 10⁻²。强化学习且冷启动在两项上都最低。
相对冷启动,它的均方误差低 (0.68−0.64)/0.68=5.88%,平均绝对误差低 (1.13−1.08)/1.13=4.42%。相对零样本的洛杉矶模型,均方误差低 (0.72−0.64)/0.72=11.11%,平均绝对误差低 (2.03−1.08)/2.03=46.80%。相对从零开始的监督学习,均方误差低 (1.05−0.64)/1.05=39.0%,平均绝对误差低 (2.74−1.08)/2.74=60.6%。零样本的均方误差 0.72×10⁻² 低于从零监督的 1.05×10⁻²,也低于监督加冷启动的 1.32×10⁻²;它的平均绝对误差 2.03×10⁻² 却高于监督加冷启动的 1.39×10⁻²。冷启动两项都低于监督、也低于监督加冷启动。正文有一处把预训练模型写成同时优于监督和冷启动;按表 2,它优于从零监督,但两项都不如单独的冷启动。这里以表为准。
监督加冷启动的均方误差最高。作者把这解释为全量微调改写了预训练表示,也就是灾难性遗忘。表证明的是这种设置误差更高;遗忘是对这一差距的解释。监督学习的均方误差低于监督加冷启动,平均绝对误差却更高:1.05×10⁻² 对 1.32×10⁻²,2.74×10⁻² 对 1.39×10⁻²。均方误差更重地惩罚少数大偏差,两个指标排序不同,说明小误差的多少和大偏差的大小没有一起变好。
图 4 是旧金山同一天 7:00 的一张快照。
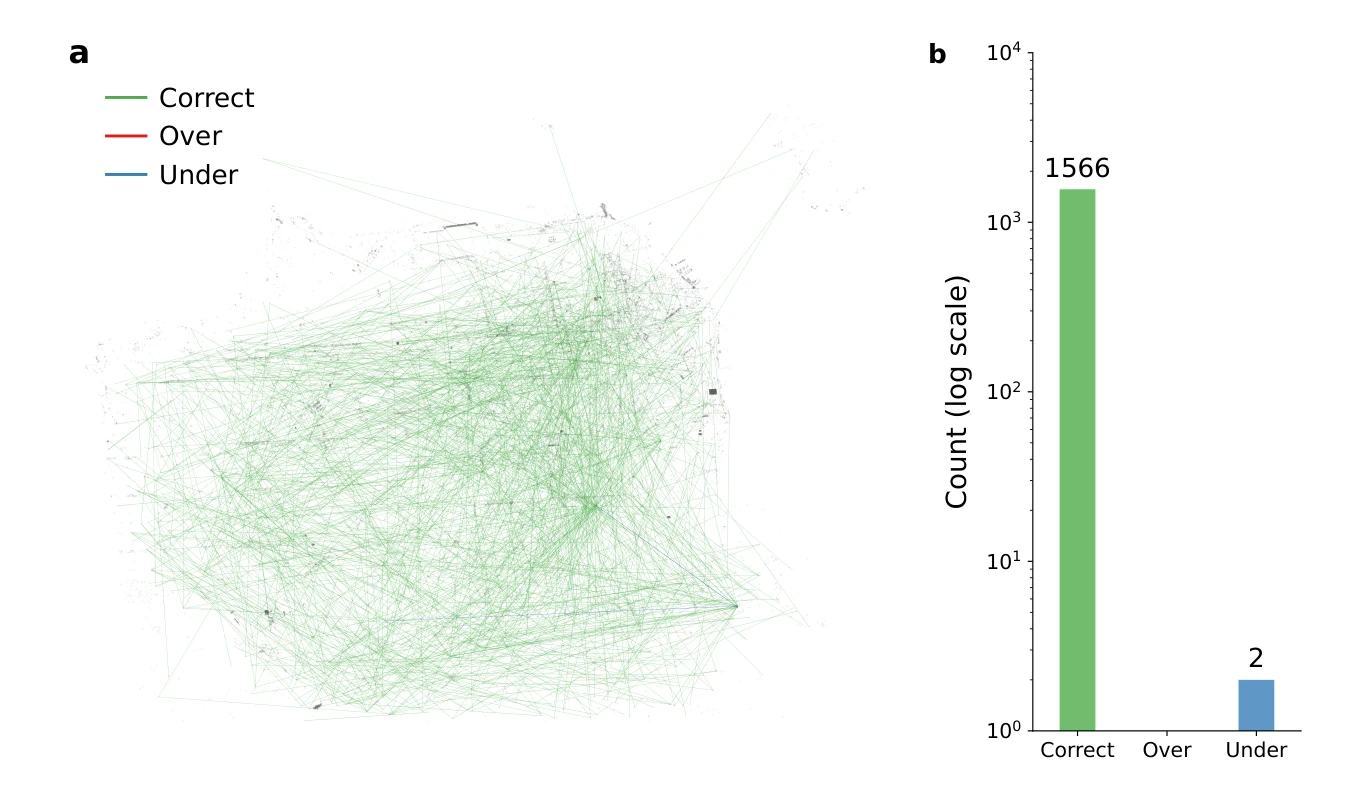
图 4|旧金山 7 点的高比例,分母有多大?
(a)28,580 个兴趣点上的预测网络,颜色同样表示判对、高估和低估。连线比洛杉矶更集中在一小块区域。(b)对数纵轴。判对标为 1,566,低估标为 2,高估没有画出柱。若高估为 0,分母是 1,568,1,566/1,568=99.87%,与正文的 99.87% 一致。来源:原论文 Fig. 4。
这个 99.87% 仍是一条 15 分钟、一批被评估边上的对错比例,容差同样没有写出。它不是表 2 的 0.64×10⁻²。
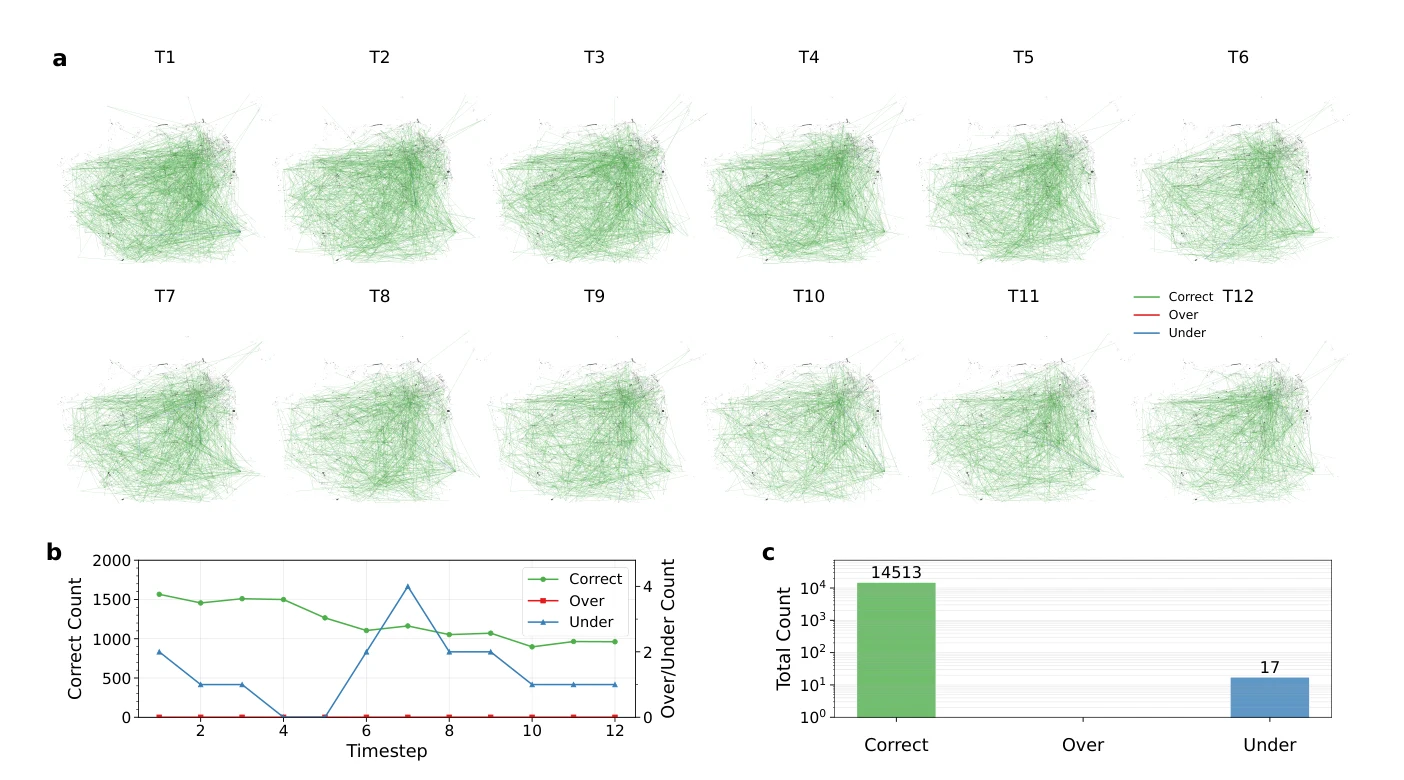
图 8|旧金山早晨的误差是高估还是低估?
(a)7:00–10:00 的 12 张子图。图注中的节点数为 28,580。右侧图例紧贴 T12。(b)判对数量大多在 1,000 到 1,500 之间;红色高估线贴在 0 上。(c)合计:判对 14,513,低估 17,高估没有柱。14,513/(14,513+17)=14,513/14,530=99.88%。来源:原论文 Extended Data Fig. 4。
7:00 那一条的 2 次低估,是这 17 次里的一部分。早晨 3 小时的高估计数为 0。正文把早晨精度和 7:00–8:00 的误差增加记到另一组扩展图编号上;与图题、日期相符的是这一张。
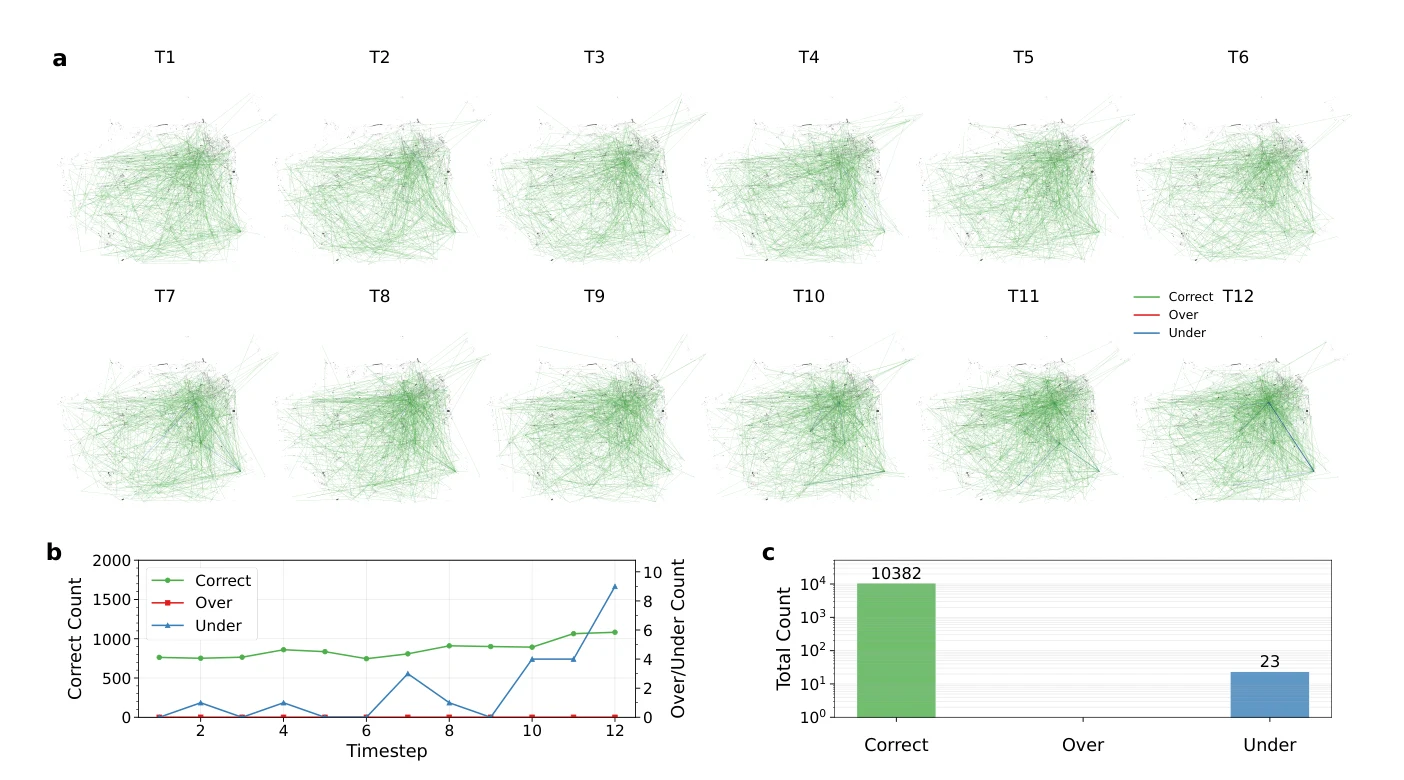
图 9|中午相对早晨,多出来的是哪一种误差?
(a)12:00–15:00 的 12 张子图,T12 附近能看到一条蓝色低估边。(b)红色高估线仍贴在 0,蓝色低估在最后几个时段上升。(c)判对 10,382,低估 23,高估没有柱。10,382/10,405=99.78%。来源:原论文 Extended Data Fig. 5。
中午低估从早晨的 17 增到 23,高估仍是 0。被评估的边从 14,530 减到 10,405。错误比例上升来自边数减少,以及低估条数增加。
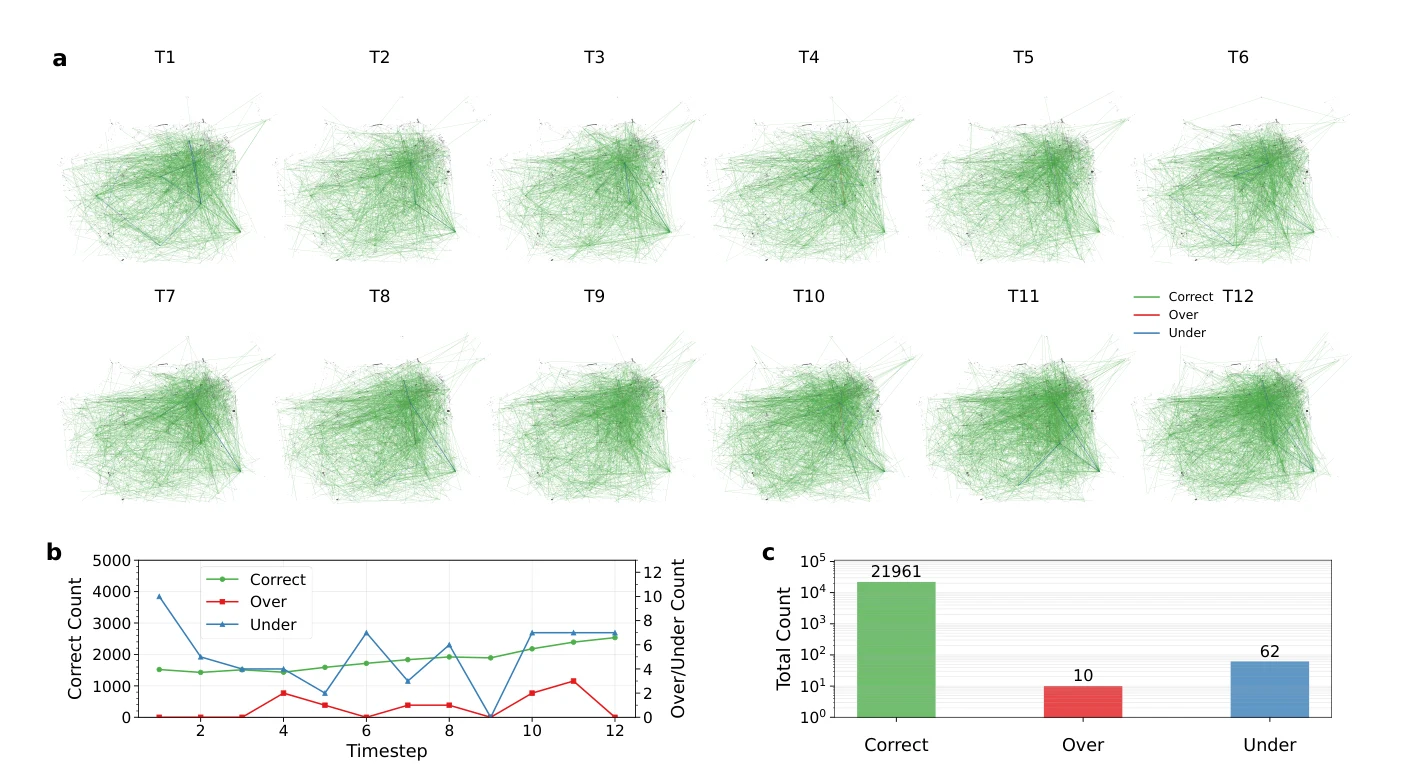
图 10|傍晚是否集中了这一天的高估?
(a)17:00–20:00 的 12 张子图,网络比中午更密。(b)判对数量约在 1,500 到 2,500;高估不再全是 0,低估多次高于高估。(c)判对 21,961,高估 10,低估 62,合计 22,033。21,961/22,033=99.67%。来源:原论文 Extended Data Fig. 6。
三个旧金山窗口的高估合计为 0+0+10=10,全部落在傍晚,与正文“10 条高估都在傍晚”一致。低估合计为 17+23+62=102,傍晚占 62/102=60.8%。正文写傍晚占低估的 77.4%,与这三张合计对不上,这里用图上的计数。
傍晚边数是中午的 22,033/10,405=2.12 倍,正文约为 2.1 倍。误差条数是 72 对 23,为 3.13 倍,正文约为 3.1 倍。边数和误差都增加,误差增加的倍数更高。这仍是同一天三个窗口的计数,没有推广成旧金山每个傍晚都如此。
文中用轮渡和高速公路举例,说明两城的时间结构可能不同。实验没有单独统计轮渡或高速公路上的流量,这个例子停留在解释,不是表 2 的一项结果。
从小城市往上迁,两个指标为什么排序相反?
反向试验用弗雷斯诺预训练,再预测洛杉矶。论文把弗雷斯诺写成流动更稀疏的农业城市,把洛杉矶写成结构更复杂的大都市,用来考察从小城市往大城市扩展。弗雷斯诺的兴趣点数量和数据划分都没有给出,稀疏是定性描述。
| 指标 | 强化学习且冷启动 | 监督学习 | 冷启动 | 监督且冷启动 | 弗雷斯诺模型直接用于洛杉矶 |
|---|---|---|---|---|---|
| 均方误差 | 1.86 | 1.79 | 1.87 | 1.94 | 3.07 |
| 平均绝对误差 | 1.70 | 2.08 | 1.79 | 2.08 | 1.43 |
数值已乘以 10⁻²。均方误差最低的是监督学习 1.79×10⁻²,不是强化学习。平均绝对误差最低的是零样本 1.43×10⁻²。
零样本均方误差 3.07×10⁻² 是监督学习 1.79×10⁻² 的 1.72 倍,也高于所有微调设置。论文把向上迁移的零样本称为灾难性失败。这个判断对齐了均方误差,没有同时对齐平均绝对误差:1.43×10⁻² 低于强化学习且冷启动的 1.70×10⁻²,也低于冷启动的 1.79×10⁻²。平均绝对误差对每条边的偏差一视同仁,均方误差会放大少数很大的偏差。零样本可以在典型边上更接近,同时在少数边上偏得更远。论文没有把弗雷斯诺到洛杉矶的误差按流量拆开,所以上面这句是两种指标定义允许的读法,不是已经分解出来的结果。
强化学习且冷启动相对监督学习,平均绝对误差低 (2.08−1.70)/2.08=18.27%,均方误差则是 1.86×10⁻² 对 1.79×10⁻²,高 3.9%。“大体相当”是作者对这一小幅上升的说法;表上的均方误差并没有一起下降。冷启动相对监督学习的平均绝对误差低 (2.08−1.79)/2.08=13.94%。强化学习再相对冷启动低 (1.79−1.70)/1.79=5.03%。13.94% 的分母是监督学习,5.03% 的分母是冷启动,两个百分比不能直接相加。
和旧金山的方向放在一起,预训练城市更复杂时,零样本的均方误差还能留在 0.72×10⁻²,和最好的 0.64×10⁻² 接近。预训练城市更简单时,零样本均方误差升到 3.07×10⁻²。这是两对城市、一个月数据上的不对称,还不是一条对所有城市等级都成立的定律。冷启动在向下迁时两项都优于从零监督;在向上迁时,它的均方误差 1.87×10⁻² 略高于监督学习的 1.79×10⁻²,平均绝对误差 1.79×10⁻² 则更好。它不是每个方向、每个指标上的同一最优解。
拿掉兴趣点类型、天气或时间模块,误差升在哪里?
消融在完整模型上逐项去掉兴趣点嵌入、气象特征、时间编码、时间卷积,迁移设置上再比较去掉强化学习。短横表示该设置没有做。“洛杉矶(源)”是预训练模型,“洛杉矶(目标)”是迁入之后的微调模型。弗雷斯诺这一行填了结构模块、没有填强化学习,读作在弗雷斯诺本地训练的模型,不是表中那次迁到洛杉矶的模型。
| 城市与角色 | 指标 | 完整 | 无兴趣点嵌入 | 无气象 | 无时间编码 | 无时间卷积 | 无强化学习 |
|---|---|---|---|---|---|---|---|
| 洛杉矶(源) | 均方误差 | 1.79 | 1.93 | 2.05 | 2.14 | 2.28 | — |
| 洛杉矶(源) | 平均绝对误差 | 2.08 | 2.76 | 2.24 | 3.28 | 2.64 | — |
| 旧金山 | 均方误差 | 0.64 | — | — | — | — | 0.68 |
| 旧金山 | 平均绝对误差 | 1.08 | — | — | — | — | 1.13 |
| 弗雷斯诺 | 均方误差 | 0.39 | 0.44 | 0.41 | 0.40 | 0.39 | — |
| 弗雷斯诺 | 平均绝对误差 | 0.73 | 1.97 | 1.39 | 1.23 | 0.95 | — |
| 洛杉矶(目标) | 均方误差 | 1.86 | — | — | — | — | 1.87 |
| 洛杉矶(目标) | 平均绝对误差 | 1.70 | — | — | — | — | 1.79 |
数值已乘以 10⁻²。旧金山和洛杉矶(目标)的“无强化学习”与前面的冷启动列相同。
去掉兴趣点嵌入后,弗雷斯诺的平均绝对误差从 0.73×10⁻² 升到 1.97×10⁻²,是完整模型的 2.70 倍。正文写成接近翻倍,与这个比值不一致,这里以表为准。洛杉矶源模型的平均绝对误差从 2.08×10⁻² 升到 2.76×10⁻²,升幅为 32.7%,小于弗雷斯诺。兴趣点类型对本地模型重要,尤其体现在弗雷斯诺的绝对误差上;旧金山和迁入后的洛杉矶没有做这项消融,不能把同一倍数挪到迁移任务上。
去掉时间编码,洛杉矶源模型的平均绝对误差从 2.08×10⁻² 升到 3.28×10⁻²,升 57.7%;均方误差从 1.79×10⁻² 升到 2.14×10⁻²,升 19.6%。弗雷斯诺的平均绝对误差从 0.73×10⁻² 升到 1.23×10⁻²,升 68.5%,均方误差只从 0.39×10⁻² 升到 0.40×10⁻²。时间编码对两座城市的绝对误差都明显,均方误差的升幅则是洛杉矶更大。
去掉气象后,弗雷斯诺平均绝对误差升 90.4%(1.39 相对 0.73),洛杉矶只升 7.7%(2.24 相对 2.08)。均方误差相反:洛杉矶升 14.5%(2.05 相对 1.79),弗雷斯诺升 5.1%(0.41 相对 0.39)。天气对小城市绝对误差的影响更大;对均方误差,升幅更大的是洛杉矶。
去掉时间卷积,洛杉矶均方误差升 27.4%(2.28 相对 1.79),平均绝对误差升 26.9%(2.64 相对 2.08)。弗雷斯诺的均方误差仍是 0.39×10⁻²,平均绝对误差从 0.73×10⁻² 升到 0.95×10⁻²,升 30.1%。正文说时间卷积对弗雷斯诺影响很小。按表中印出的精度,均方误差仍是 0.39×10⁻²。平均绝对误差从 0.73×10⁻² 升到 0.95×10⁻²。
旧金山去掉强化学习,就是回到冷启动的 0.68×10⁻² 和 1.13×10⁻²。洛杉矶作为迁入目标时,去掉强化学习后均方误差从 1.86×10⁻² 变为 1.87×10⁻²,平均绝对误差从 1.70×10⁻² 变为 1.79×10⁻²,后者就是上面的 5.03%。讨论认为,强化学习相对冷启动大约 5% 的绝对误差改善,不一定抵得过额外计算。这个量级与 5.03% 和旧金山的 4.42% 相符。讨论还写,奖励可能看轻流量小、但在结构上重要的边。权重写成 1 + 该边人数/批次最大人数。流量等于本批次最大值的边,权重为 2;人数远小于这个最大值的边,权重大约为 1。这是奖励公式本身的结果。
弗雷斯诺本地模型的 0.39×10⁻² 不能与洛杉矶的 1.79×10⁻² 比出“哪座城市更准”。两座城市的流量尺度和边的构成都不同,表只说明各自消融相对自己的完整模型改变了多少。
这些比较停在什么范围
可以成立的是:在这一个月的三座城市里,兴趣点级有向人数可以用“大城市预训练、目标城市只改深层、再缩放输出层”降到低于从零监督训练的误差;反向使用小城市模型时,均方误差明显变差。图上的高判对比例描述的是若干 15 分钟里被画出的边,容差未知。
边界也集中在这几处。数据只有 2023 年 3 月、一个数据源和三座加州都市区。速度与距离过滤的阈值、奖励的两个系数、网络层数都没有具体数值。正确、高估、低估没有人数阈值。扩展图只覆盖 3 月 29 日的三个时段。跨城市表没有纳入表 1 的三种基线,所以“最新水平”限定在洛杉矶测试集对这三种模型的比较。向上迁移的零样本在平均绝对误差上最好,在均方误差上最差。模型给出的是清理后转移计数的预测。
讨论建议以后补上预测区间,并提到可以用注意力变化查看极端天气或疫情期间的异常。这些都还没有结果。奖励对小流量边的权重更低,加上强化学习的绝对误差收益大约五个百分点,是作者自己标出的部署取舍。
一句话总结
兴趣点之间的短时人数可以从结构更复杂的城市往下迁,并用少量目标城市数据再压低误差;往上迁时均方误差会明显变差,而图上超过 99% 的判对比例不能代替表里的误差。
核心来源
- 预印本 v1:arXiv:2507.17924v1,2025 年 7 月 23 日。图和表都在这一份 PDF 内:正文图 1–4、表 1–4,附录为 Extended Data Fig. 1–6。这一版没有印 DOI,也没有代码或数据获取说明。
- 哥伦比亚大学城市系统工程实验室人员页,核对两位作者在实验室中的身份。
- Hongrong Yang 的实验室目录页,核对博士研究生身份及院系。
- 预印本参考文献[14]为 Markus Schläpfer 与合作者的人类移动访问规律,Nature,2021,593:522–527。参考文献[46]为流动预测不确定性研究,Transportation,2024,51:2301–2322。
作者介绍
两位作者的论文脚注都是哥伦比亚大学 Fu Foundation School of Engineering and Applied Science、土木工程与工程力学系。下面只写论文脚注和该系实验室公开页面能够核对的身份。
- Hongrong Yang:城市系统工程实验室人员页列为博士研究生。本文是他与 Markus Schläpfer 共同署名的预印本。
- Markus Schläpfer:同一实验室人员页列为负责人。本文引用了他参与的 2021 年人类移动访问规律研究,以及 2024 年关于流动预测不确定性的研究。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若调度只关心某条兴趣点连接在未来 15 分钟是否大体有人,图里 99% 以上的判对会显得已经够用。若运力要留给少数大流量边,评价就落到被平方误差放大的那些边。奖励权重是 1 加上该边人数除以批次最大人数:市中心干道可以接近 2,一条人数很少、却是某社区唯一出口的边接近 1。模型会被推向先修大流量边。若决策要保住唯一出口,就需要按流量分组报告误差。论文没有给出这种分组,因此全图一个均方误差还不能回答“安静但不可替代的连接有没有被低估”。
另一项可以直接做的区分,是向下迁移的优势来自城市结构更丰富,还是来自洛杉矶这一个月的样本量。三座城市同为 2023 年 3 月,弗雷斯诺的兴趣点数量也没有报告。若换成另一座大都市做预训练,迁到旧金山后仍然同时优于零样本和从零训练,就更能把结构复杂度和“刚好是洛杉矶”分开。若只把弗雷斯诺再延长几个月、城市结构不变,向上迁到洛杉矶的均方误差仍停留在 3.07×10⁻² 对 1.79×10⁻² 这种差距附近,则更支持缺少的是大都市里的流动结构,而不是同一座小城市的天数。