全城每小时的人口增减,能不能收成少数几条昼夜节奏?
论文名片|J.B. Sun、J. Yuan、Y. Wang、H.B. Si、X.M. Shan,Exploring space–time structure of human mobility in urban space,Physica A,2011,390:929–942。2010年5月12日收稿,2010年8月26日修回,2010年10月20日在线发表。DOI:10.1016/j.physa.2010.10.033。本文依据这一期刊版本解读。脚注说明另有一篇缩写稿收入第 6 届国际无线通信与移动计算会议论文集,该条参考文献没有印出会议论文的题目和年份。
周一早上六点,深圳很多一公里见方的格子同时在进人;到了十一点,同一套空间格局的权重可以整幅翻面。若每个商场、每条路各自讲一条互不相关的故事,两千多个格子乘上一周一百多个小时,读不出这种全城同步。论文要分开的两种解释是:城市人口的小时增减是一堆各说各话的局部波动,还是少数几条可重复的时空节奏就撑起了主要结构。
这里的人类移动性(human mobility)指人在空间中的移动。论文关心的是聚集后的城市动态(urban dynamics):一大群人在全市尺度上的整体增减,分析单位是公里格上的人数差分,不是某一个人从哪到哪。
方向先说在前面。市中心这一周的格子曲线,奇异值在大约 10 个成分之后就贴向零;把视野放到补齐后的全市矩形,大约 20 个空间模式就能勾出主要的红蓝分布。最强的模式带有以 24 小时为主的周期。用更早一周的确定性方向去逼近后来一周,时间视角的平均相对误差约为 32.7%,空间视角约为 26.4%;分母都是后来一周自身的确定性重建,不是原始人口曲线。短时尖峰和接近噪声的起伏都在,能量上排在周期之后。预报和异常检测是据此提出的用法,正文没有给出一套留出测试的预报得分。
先说结论
- 低维是读图看出来的,不是一个写好的能量百分比。市中心矩阵是 167 个小时差分 × 105 个格子,归一化奇异值在前大约 10 个成分后落入近零;全市矩阵是 4655 个格子 × 同样 167 个差分,肘部大约在前 20 个成分。两张图的纵轴都是奇异值除以最大奇异值,第一条为 1。能量与奇异值的平方成正比,正文没有报告前 10 个或前 20 个成分占全部能量的比例。
- 时间和空间两侧都把模式分成三类。确定性类要求频谱在 24 小时处有压过其他频率的主峰,空间侧的主成分还接受 12 小时主峰;尖峰类要求有一点离开均值超过 4 倍标准差;噪声类要求边缘分布接近高斯。最显著的前 5 个时间模式、前 5 个空间模式都落在确定性类。有 5 个时间模式、4 个空间模式同时满足不止一条规则。
- 方差大的格子,其小时差分的能量主要由确定性成分贡献;方差小的格子几乎由噪声成分主导。尖峰成分对各个格子的贡献比较均匀。全市多数时刻的地图也由确定性成分占能量的大头,但这三条曲线都用窗宽为 3 的移动平均平滑过。
- 结构在相邻周之间还认得出,认得出的程度就是上面两个相对误差。32.7% 是 105 个格子上相对误差的平均,26.4% 是各时刻相对误差的平均,都取间隔最大的那个比较点。这不是对原始人数差分的预报误差。
格子里的人数,是话务量摊出来的估计
数据来自深圳一套基于移动基站的动态人口分布监测系统,由一家电信运营商支持。系统 2008 年 11 月起运行。深圳在正文里是约两千平方公里、人口一千四百万以上、平均密度每平方公里七千人以上的概数。地理范围被分成 2268 个像素(pixel),空间尺度 1 公里,所以这 2268 个格子对应约 2268 平方公里,和“约两千平方公里”同量级。每个格子用中心点的经纬度标记,中心点位置误差不超过 1 米。这是坐标误差。人数误差另有口径:相对当地实际人口,90% 的格子误差不超过 5%,99% 的格子不超过 10%。
时间上每小时给出各格人数。系统在每个小时的 5 分钟内完成采集、交换、计算和输出。后文所有差分都建立在这个小时尺度上。
人数本身分两步估计,两步都在格子或小区的总人数上完成。第一步把一个访客位置寄存器里登记的移动用户,按各小区话务量占所属移动交换中心总话务量的比例摊开,再乘一个系数 α。α 表示深圳人口中移动用户所占的比例,正文没有给出它的数值。话务量以爱尔兰计。第二步用定时提前量描述小区用户离基站的距离分布,把小区人数分到覆盖范围内的公里格;定时提前量的期望越大,离基站较远的终端就越多。这一步替代的是在覆盖范围内均匀铺人。
因此,一个格子上的人数是话务份额和距离分布共同给出的估计。话务升高而人没有移动,或人在格子里但没有产生相应话务,都会进到这个估计里。5% 和 10% 是人数水平相对当地实际人口的误差,正文没有另给每个小时差分的误差。后面的曲线分析的是这些估计人数的小时差,不追踪某一台终端越过哪些格子。
同一周的小时差分,为什么排成两张不同的表?
从时间一侧看,格网人口变化(Pixel Population Variation,PPV)是单个格子在一段时间内、相邻采样时刻的人数之差,所以每个格子有一条时间序列。从空间一侧看,全局人口移动(Global Population Mobility,GPM)是某一个时刻、全市各格的人数之差,所以每个时刻有一张地图。两边用的都是相邻小时的人数差,只是把同一类差分按列排成“一格一周”或按列排成“一时全城”。
时间分析选市中心,因为那里的人口变化比其他区域更显著。范围是 15×7 共 105 个格子,编号 1 到 105。时间是周日到周六的一周。测量矩阵为 167×105:每一列是一个格子的 PPV。167 这个行数正文直接给出。按每小时一次,一周 7×24 得到 168 个时刻,相邻时刻相减正好是 167 个差分,与“小时尺度上的相邻时刻之差”一致。正文没有写明这一周的公历起止日期。
空间分析用同一段时间,但地理范围是全市。为了排成矩形,在原来 2268 个格子之外补了一些空格,得到 95×49 共 4655 个位置,编号 1 到 4655。4655−2268=2387,这是补进去的空位个数,不是新测到的城区。测量矩阵为 4655×167:每一列是一个时刻的 GPM,每一行是一个格子的 PPV。地图右侧大片浅色里,测到的低人数和这些空位混在一起,正文没有给空位清单,不能逐格判读。
主成分分析(Principal Component Analysis,PCA)在这里做一件具体的比较:在互相正交的方向里,依次找出剩余变化最大的方向。奇异值越大,对应的模式越显著。模式向量被规范成单位长度,所以图上 ±0.5 这类刻度是单位向量的分量,不是人数;人数尺度藏在奇异值里。每个格子的曲线可以写成这些模式的加权和。只保留前若干个模式,就是正文说的内在维度(intrinsic dimensionality)。这是线性分解。方差大的方向被当成重要结构,这个重要性不等于唯一的行为机制,也不等于因果。
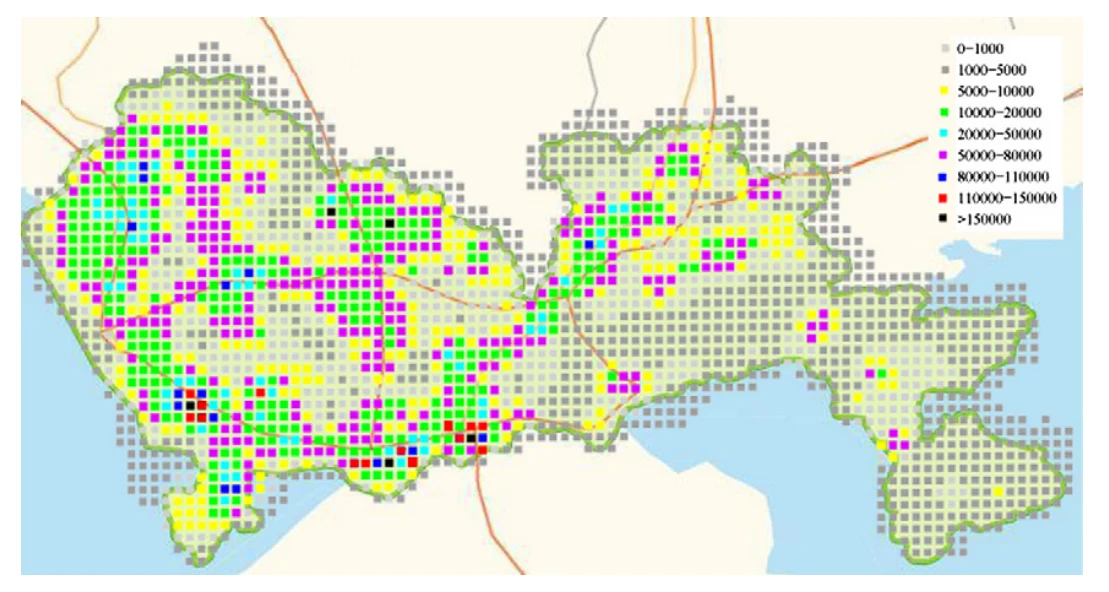
图 1|这一周的小时差分,发生在怎样一张人数底图上?
无字母子图。每个色块是一个 1 公里格,图例按格子上的人数分档:0–1000、1000–5000、5000–10000、10000–20000、20000–50000、50000–80000、80000–110000、110000–150000,以及 15 万以上。在 1 公里格上,这个人数在数值上就是每平方公里人数。图题称它为人口密度分布。高档颜色集中在一部分建成区,东部和外围有大片低档格子。图中没有各档的格子计数,也不能把某一色块读成后续第 85 格或第 72 格。来源:原论文 Fig. 1。
十条时间曲线,能把一个格子的一周描回来吗?
市中心 105 条 PPV 放进 PCA 之后,得到一组特征格网人口变化(eigenPPV)。它们是全体格子共用的时间曲线,各自长度为 167。比较它们谁更重要,看的是奇异值。
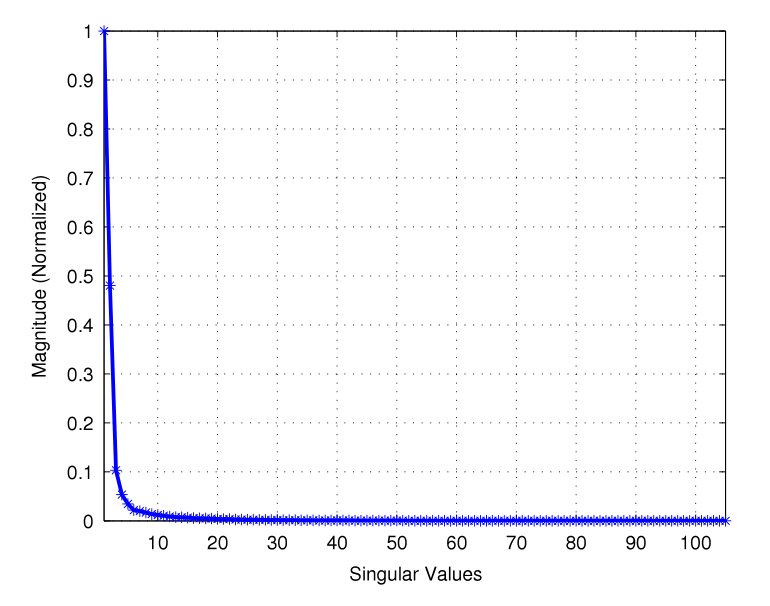
图 2|105 条格子曲线需要多少条共用节奏?
无字母子图。横轴是按从大到小排列的奇异值序号,刻度到 100,矩阵最多只有 105 个非零奇异值。纵轴是归一化幅度,最大的一条定为 1,随后很快落到接近 0 的位置,并在大约第 10 个之后保持贴零,直到横轴末端。正文据此说前大约 10 个 eigenPPV 就能抓住这组曲线的结构。纵轴不是累计能量占比。来源:原论文 Fig. 2。
这个“大约 10”还需要一条具体曲线来看丢掉其余维度之后还剩什么。正文选了一个随机格子,PPV 53,用最显著的 10 个 eigenPPV 重建。
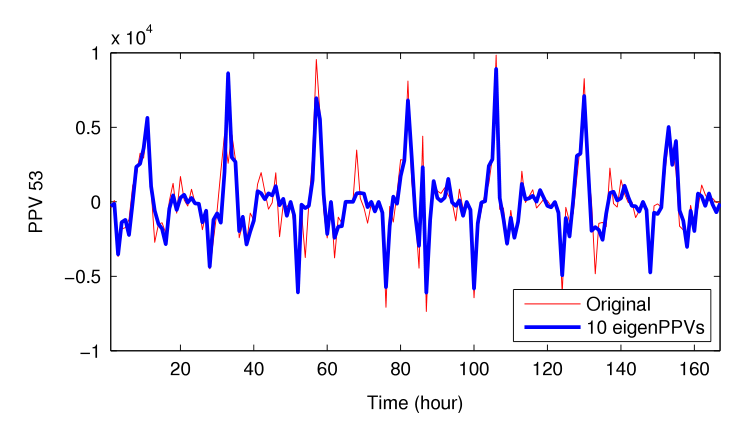
图 3|丢掉大多数维度之后,一个格子的大摆动还在吗?
无字母子图。横轴是小时,刻度到 160,对应这一周的 167 个差分。纵轴是 PPV 53,乘数为 10⁴,刻度从 −1 到 1,也就是这一格相邻两小时的人数差按万人计。红线是原始差分,蓝线是 10 个 eigenPPV 的重建。蓝线跟上了接近上端刻度的大摆动,细小的红尖刺没有逐根保留。这是 105 个格子中的一个例子。正文没有给出全部格子的平均重建误差,也没有给出这 10 个成分的能量百分比。来源:原论文 Fig. 3。
最强的那条节奏,权重落在哪一个格子?
每条 PPV 都是各 eigenPPV 的加权和,权重来自对应的主成分。第一条 eigenPPV 被正文解释为这座城市的时间签名,对应居民日常的作息时段。它的单位长度曲线本身还要乘上各格的权重,才变成该格的人数差。
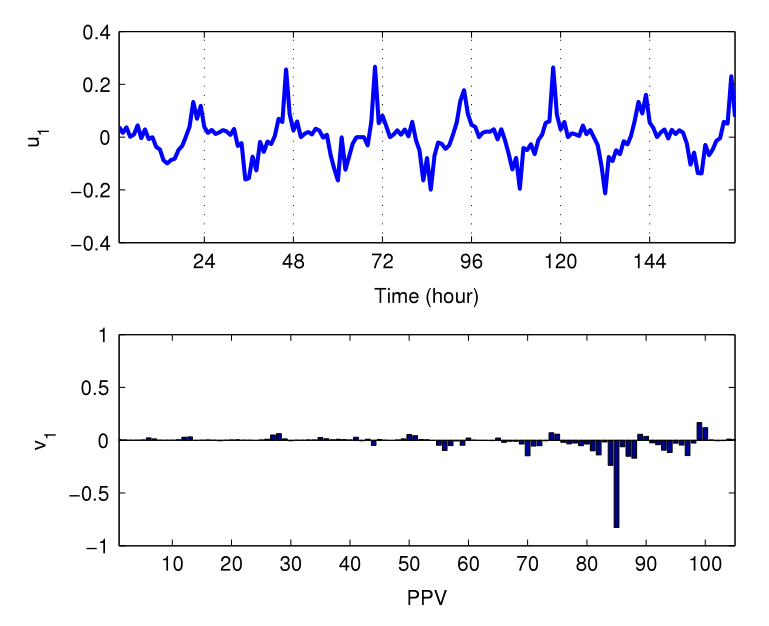
图 4|第一条时间节奏在一周里怎样重复,又主要写进哪一个格子?
无字母子图,上下两幅。上图是 eigenPPV u₁,横轴以 24、48、72、96、120、144 小时标出这一周,纵轴大约在 ±0.4 之间,是单位向量的分量。曲线按大约一天的间隔重复起伏。下图是主成分 v₁,横轴是 105 个格子的序号,刻度到 100,纵轴从 −1 到 1,同样是权重而不是人数。大多数格子的权重贴近 0,80 与 90 之间有一根突出的负尖峰。正文指出,u₁ 贡献最大的是 PPV 85,并把这个格子对应到全市最繁华的商业区。负号表示这一格使用 u₁ 时要反号,不能把尖峰直接读成该格每小时都在减少人口。来源:原论文 Fig. 4。
周期、短时爆发和噪声,靠哪三条规则分开?
eigenPPV 按时间形态分成三类。确定性特征曲线(d-eigenPPV)要在频谱的 24 小时处有一个主峰,而且这个主峰大于频谱里任何其他值。尖峰特征曲线(s-eigenPPV)要有一个点离开均值的距离超过 4 倍标准差;正文明确说“看起来像尖峰”这条描述本身并不严格,所以用这个数值规则代替。噪声特征曲线(n-eigenPPV)要求边缘分布接近高斯,检查方法是分位数—分位数图。这 14 页正文没有放分位数图,噪声类是否成立,读者只能看到作者给出的分类结果,看不到那张诊断图。
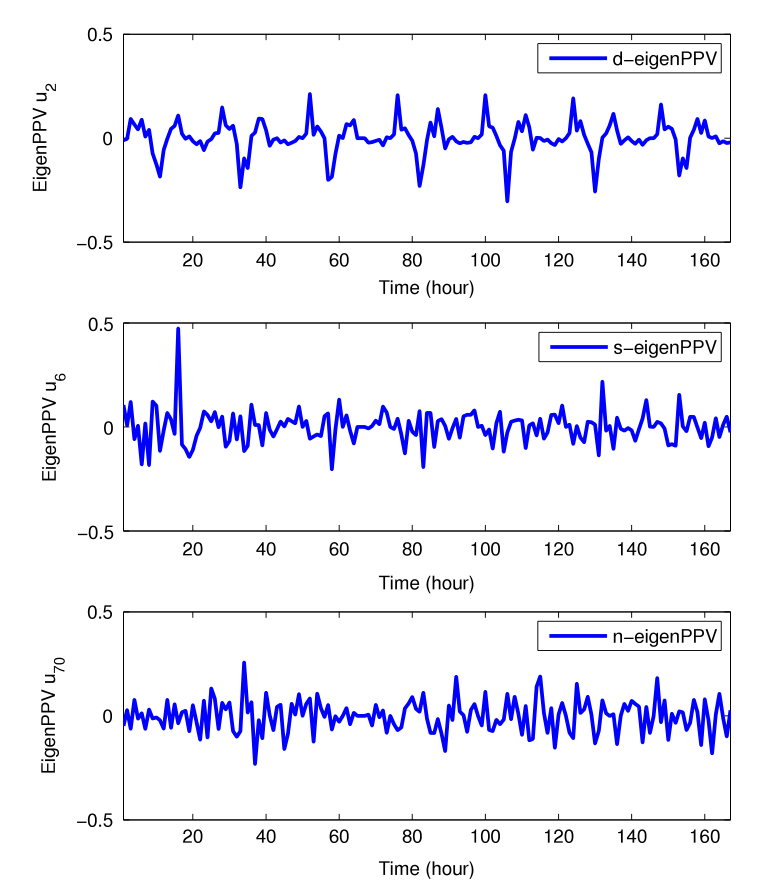
图 5|三类时间模式各长什么样?
无字母子图,上、中、下三幅,纵轴都是 ±0.5 的单位向量分量,横轴都是小时、刻度到 160。上图为 d-eigenPPV,曲线是 u₂,按大约一天的间隔反复出现正负起伏。中图为 s-eigenPPV,曲线是 u₆,前段有一次明显高于其余波动的短峰。下图为 n-eigenPPV,曲线是 u₇₀,在 0 附近持续小幅抖动,没有一条压过全周的 24 小时节奏。三幅都是例子,不是三类的平均曲线。来源:原论文 Fig. 5。
把全部 eigenPPV 逐条套进这三条规则,大多数只落入一类,有 5 条同时满足不止一条。
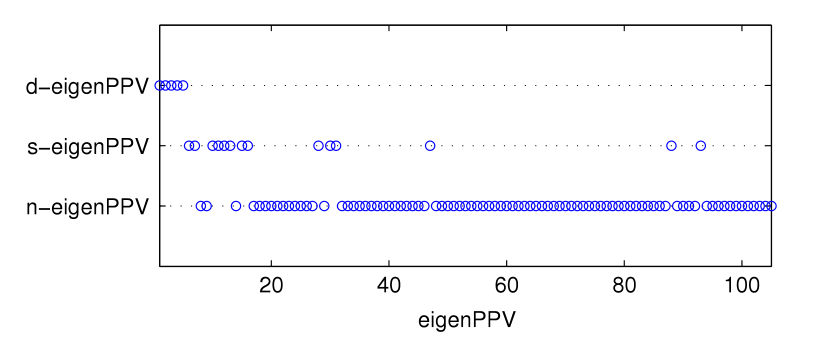
图 6|显著性从高到低,类别怎样换挡?
无字母子图。横轴是 eigenPPV 的序号,左边更显著,刻度到 100。纵轴三行分别是 d-eigenPPV、s-eigenPPV、n-eigenPPV。最显著的前 5 个落在确定性一行;其后大约 10 个里,多数落在尖峰一行;再往后几乎都落在噪声一行。因为有 5 条跨类,同一序号可以在两行上同时出现。这张图支持“周期最重要、短时爆发其次、噪声最弱”的排序,不支持三类被严格切成互不重叠的三段。来源:原论文 Fig. 6。
一个格子的一周,三部分各占多少能量?
既然每条 PPV 是全体 eigenPPV 的加权和,就可以把确定性、尖峰、噪声三类分别加总,得到该格的三个成分。正文用 PPV 69 做分解示例。这里的能量就是差分序列的方差。某一成分的能量占比,是它的方差占该格总方差的比例。
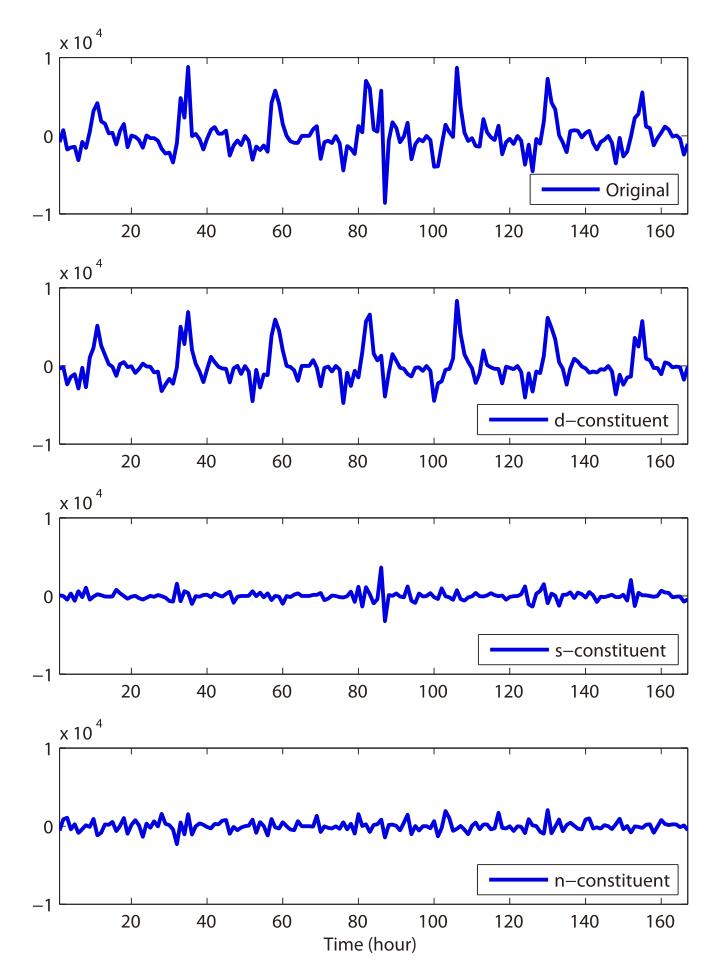
图 7|一个格子的原始曲线里,三类成分各留下什么形状?
无字母子图,四幅共用横轴小时、刻度到 160,纵轴乘数都是 10⁴,刻度从 −1 到 1,即按万人计的小时人数差。由上到下是 PPV 69 的原始序列、确定性成分、尖峰成分、噪声成分。原始序列里反复出现的大峰,在确定性成分里还在;尖峰成分只在中后段留下一次较明显的短促起伏;噪声成分整周都贴在较小的范围内。这仍是一个格子的例子。来源:原论文 Fig. 7。
把 105 个格子都按方差从大到小排开,就能看能量占比怎样随“这个格子波动有多大”变化。三条占比曲线用窗宽为 3 的移动平均平滑,相邻格子被掺在一起,读的是趋势。
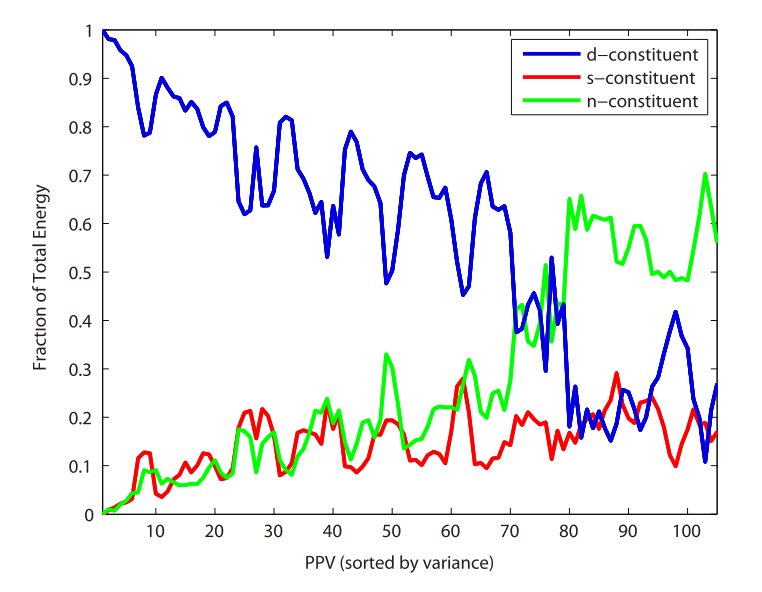
图 8|格子波动越大,是不是越由昼夜节奏主导?
无字母子图。横轴是按方差排序的 PPV,正文说明方差向右下降,刻度到 100,对应 105 个格子。纵轴是占总能量的比例,范围 0 到 1。蓝线是确定性成分,红线是尖峰成分,绿线是噪声成分。左端方差大的格子由蓝线主导,蓝线随方差下降而降低;右端方差小的格子几乎由绿线主导。红线没有跟着方差一路下降,对各格的贡献比较均匀。平滑窗宽为 3,所以不能把某一个序号上的读数当成该格未平滑的精确占比。正文没有报告交叉点的格子编号。来源:原论文 Fig. 8。
换到全市地图,二十个空间模式够不够?
空间一侧的模式叫特征全局人口移动(eigenGPM)。一个 eigenGPM 是一张空间权重图,抓住各时刻地图之间反复出现的格局。因为列数是 167,非零奇异值最多 167 个。
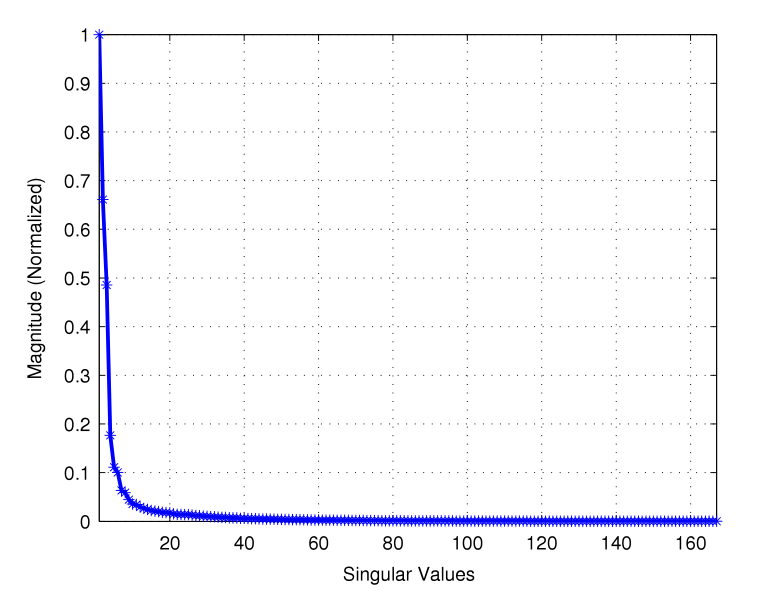
图 9|167 张全市小时地图,肘部出现在哪里?
无字母子图。横轴是奇异值序号,刻度到 160。纵轴仍是归一化幅度,第一条为 1,大约在前 20 个之内降到贴近零,之后保持平坦。正文据此说大约 20 个最显著的 eigenGPM 能抓住全部 GPM 的结构。这张图和市中心那张不是同一矩阵的两种读法:一边是 105 个市中心格子,一边是补齐后的 4655 个位置。10 和 20 不能相减。来源:原论文 Fig. 9。
正文再用随机选出的 GPM 8,看保留 20 个模式之后地图还像不像。色标对实际人数差分的约定是:红色表示人移入,蓝色表示人移出,颜色越深,这一小时的人口移动越大。
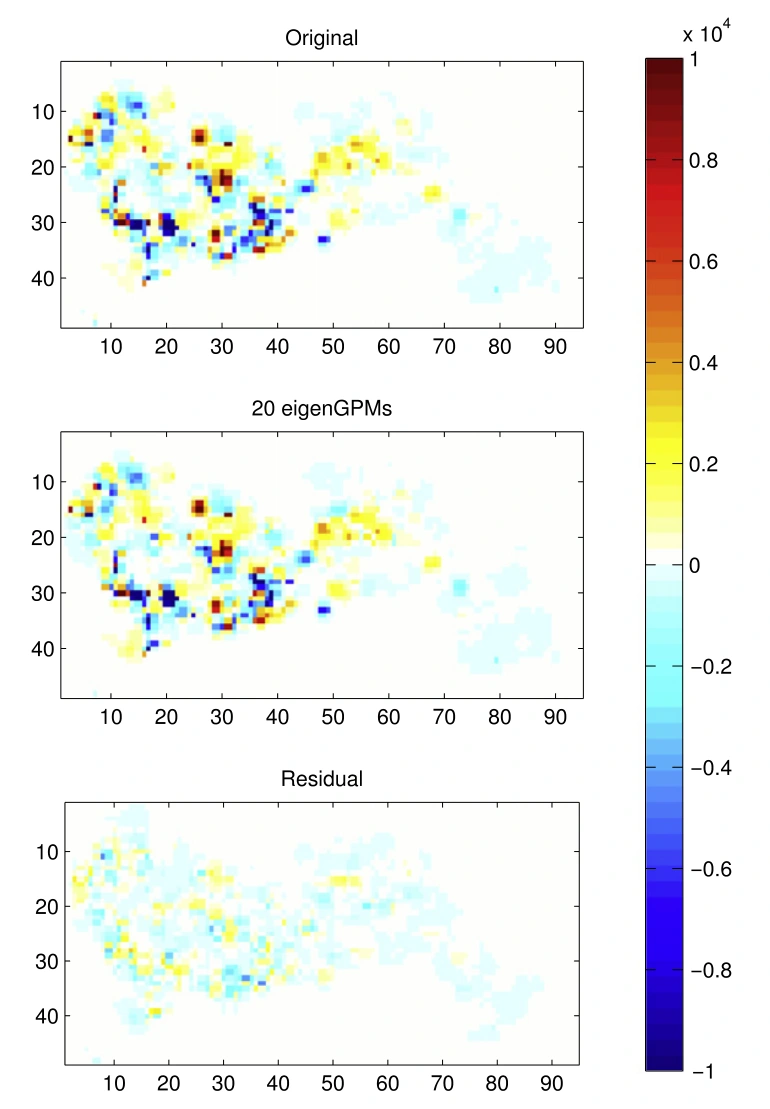
图 10|一张小时地图去掉大多数维度后,红蓝还在吗?
无字母子图,上、中、下三幅,横轴刻度到 90、纵轴刻度到 40,对应 95×49 的矩形。色标乘数为 10⁴,范围从 −1 到 1,即大约 ±1 万人的小时人数差;红为正、蓝为负。上图是原始 GPM 8,中图是 20 个 eigenGPM 的重建,下图是残差。中图保留了上图里成片的深色红蓝,下图明显更浅,但没有变成空白。正文称这个重建相当准确,同时残差面板说明被省略的维度仍留下可见的零星差异。这是一个时刻的例子,不是 167 个时刻的平均误差。来源:原论文 Fig. 10。
早六点的全市格局,到了十一点会不会翻面?
每个 GPM 同样是各 eigenGPM 的加权和。权重是一条按时刻排列的主成分,所以空间模式的“有多强”本身也是一条时间序列。第一条 eigenGPM 被解释为城市的空间签名。
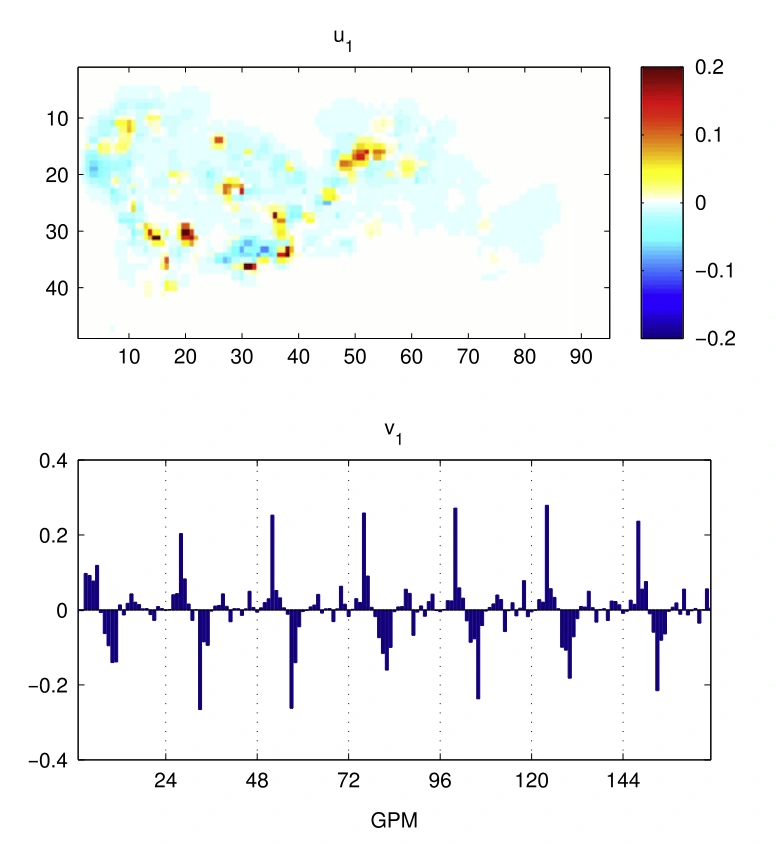
图 11|最强的空间格局在哪些格子上同号,又在一天中的哪些时刻最强?
无字母子图,上下两幅。上图是 eigenGPM u₁,横轴到 90、纵轴到 40。色标从 −0.2 到 0.2,这是单位长度空间模式的分量,不是人数;红色一侧与蓝色一侧表示这条模式里人数变化的相反方向。深色集中在矩形左侧和中部的若干小块,右侧大片接近 0。下图是主成分 v₁,横轴是 GPM 序号,以 24 小时为间隔标到 144,纵轴大约 ±0.4。每个 24 小时区间里都有向上和向下的窄峰。正文指出,正峰对应早上六点、也就是上班时段,u₁ 在这个时刻贡献最大;负峰对应十一点,此时全市移动的趋势与六点相反。十一点这个反向在实际生活中的含义,正文写明仍在调查。权重为负时,上图的红蓝要整幅对调,不能把色标直接当成十一点的人数增减。来源:原论文 Fig. 11。
空间模式的三类,和时间模式用的是同一把尺子吗?
eigenGPM 也分成确定性、尖峰和噪声三类,但分类时看的是它的主成分这条时间序列,不是地图本身。确定性的标准在空间侧更宽:主成分的频谱要在 24 小时或 12 小时处有主峰。尖峰仍是离开均值超过 4 倍标准差,噪声仍是边缘分布接近高斯。因此,即使同一套数据同时从两侧做 PCA,类别名字相同,进入确定性类的频谱条件也并不字面相同。市中心矩阵和全市矩阵还不是彼此的转置,下一节再把“同一矩阵”的情形单独说清。
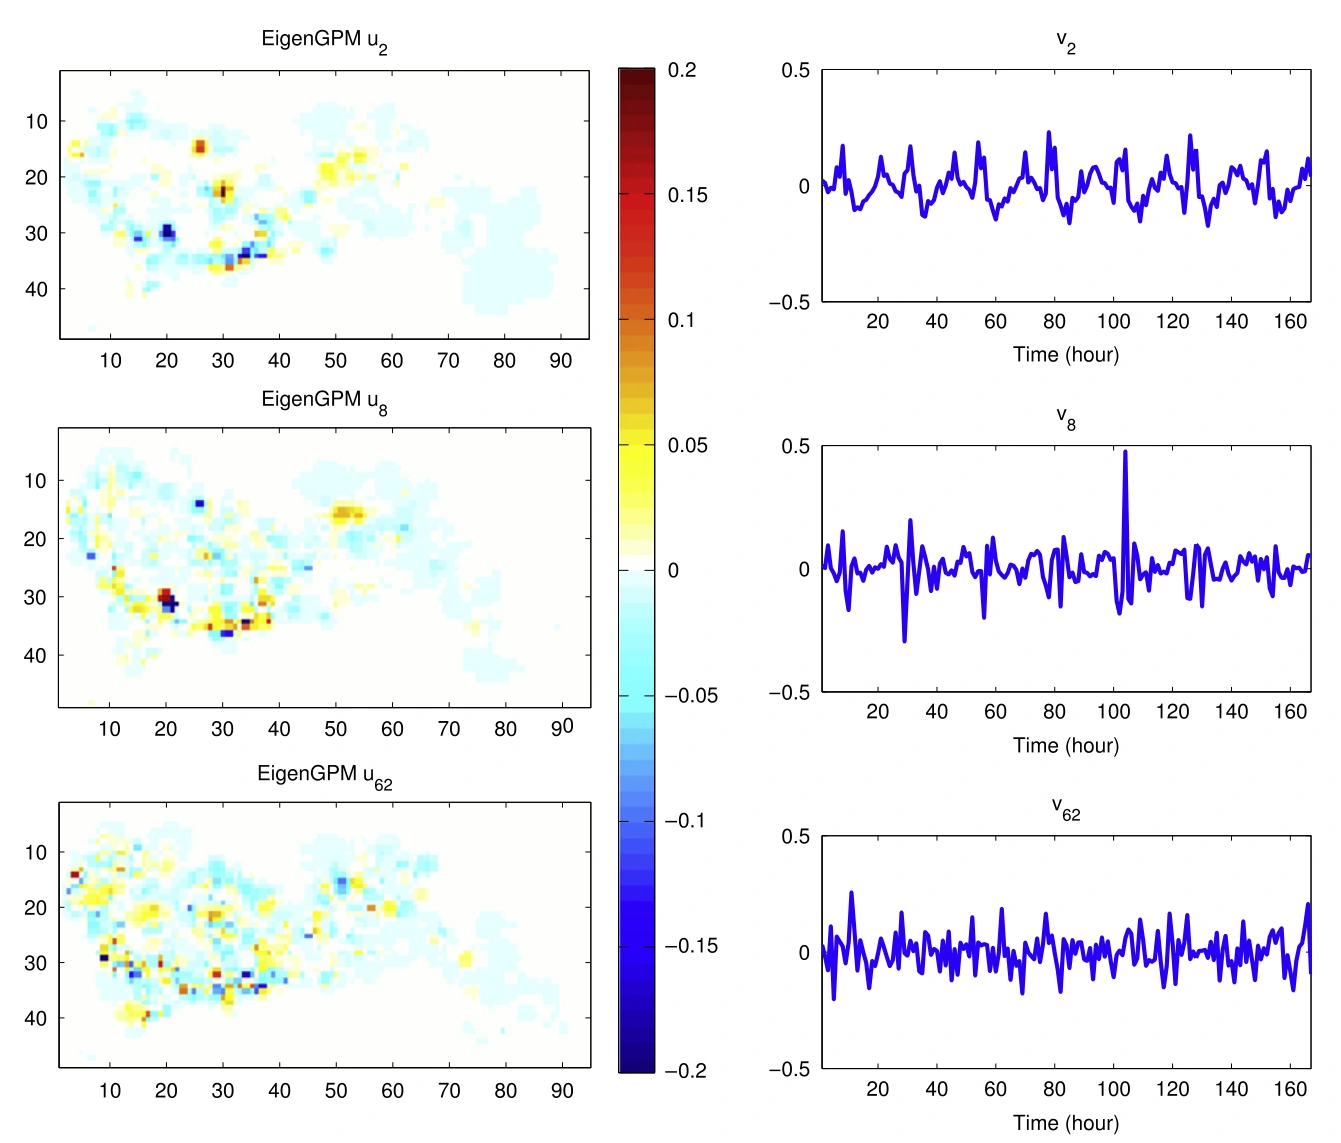
图 12|一张空间模式要配上它的时间权重,才知道属于哪一类?
无字母子图,三行。左列是空间模式,色标从 −0.2 到 0.2,轴刻度到 90 和 40;右列是对应主成分,横轴小时、刻度到 160,纵轴 ±0.5。上行为 eigenGPM u₂ 和 v₂,右图呈反复起伏,属于确定性类;正文特别说,这条模式的强度周期性变化,有时会变成自身的反面。中行为 u₈ 和 v₈,右图有一次明显高于其余波动的短峰,属于尖峰类,表示一种不常见、偶尔很强的人口移动格局。下行为 u₆₂ 和 v₆₂,右图没有主导周期,属于噪声类,表示较不重要的空间起伏。色标仍是单位向量分量。来源:原论文 Fig. 12。
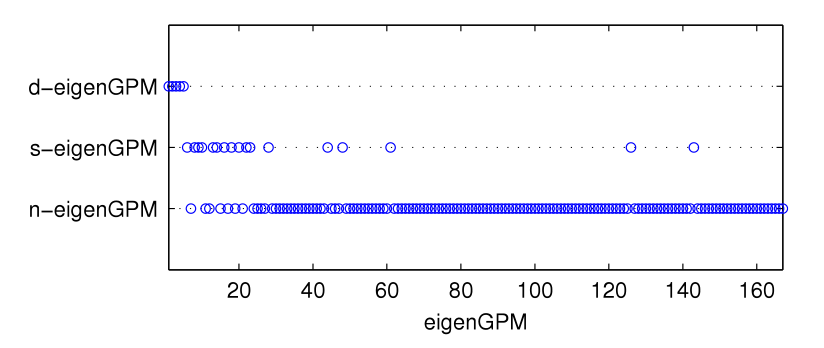
图 13|全市 167 个空间模式里,周期从哪一号开始让位?
无字母子图。横轴是 eigenGPM 序号,刻度到 160。纵轴三行是 d-eigenGPM、s-eigenGPM、n-eigenGPM。前 5 个最显著的落在确定性一行;接下来的 20 个里,超过一半落在尖峰一行;其余较不显著的几乎都在噪声一行。有 4 个模式同时属于不止一类。和市中心那张类别图一样,这是排序上的换挡,不是互斥分区。来源:原论文 Fig. 13。
把一张全市地图拆开,大多数时刻是不是都由周期占上风?
每个时刻的 GPM 也可以拆成确定性、尖峰、噪声三个空间成分。示例是 GPM 29。能量占比仍是各成分方差占总方差的比例,并且同样用窗宽为 3 的移动平均平滑。和格子那张图不同,这里的横轴是时间顺序,不是按方差排序。
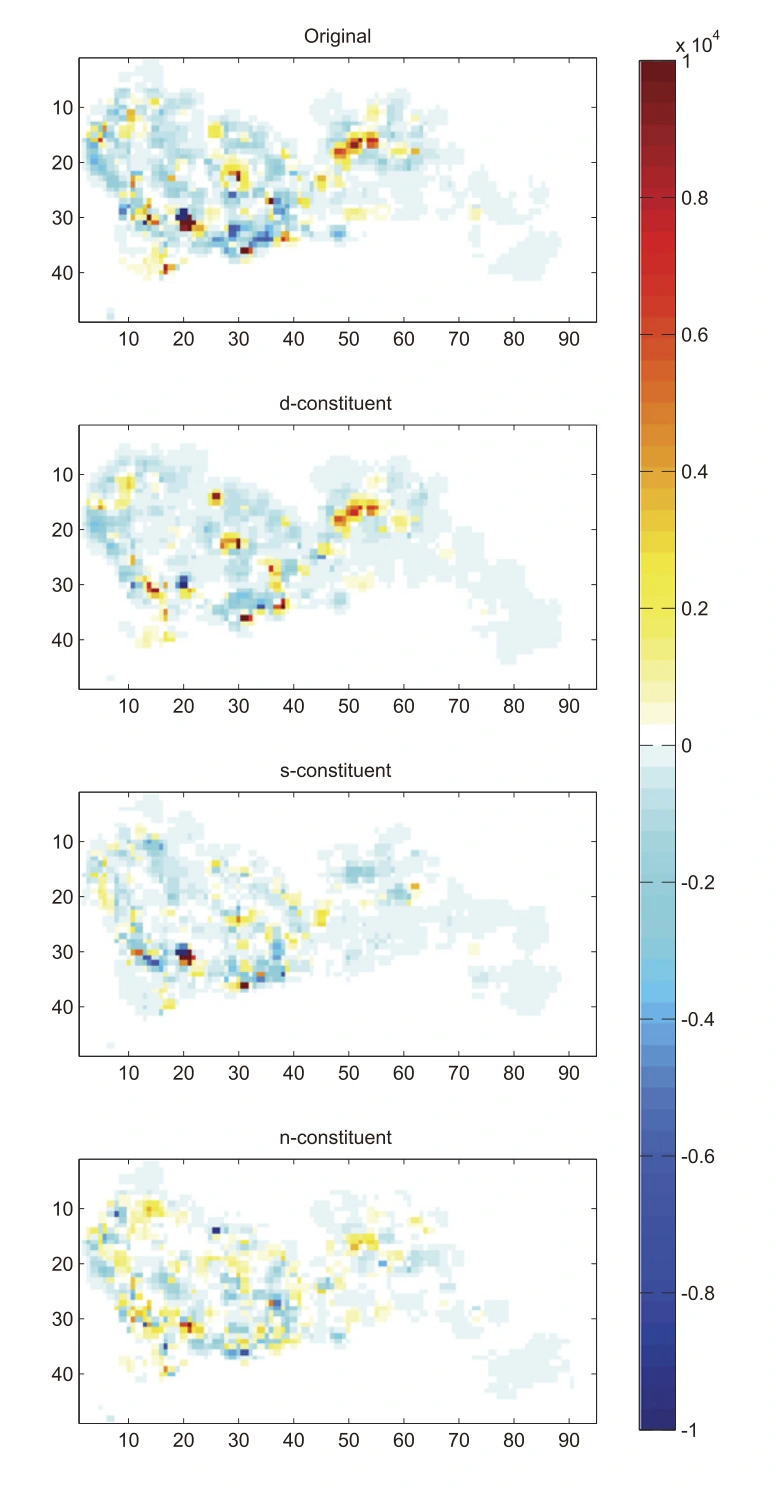
图 14|一个时刻的全市红蓝,拆开后哪一层还留着成片的深色?
无字母子图,由上到下是 GPM 29 的原始地图、确定性成分、尖峰成分、噪声成分。横轴到 90,纵轴到 40。色标乘数为 10⁴,范围 ±1,即大约 ±1 万人;红为移入,蓝为移出。确定性成分保留了原始地图里颜色较深的成片红蓝。尖峰和噪声成分的深色更碎、更浅。来源:原论文 Fig. 14。
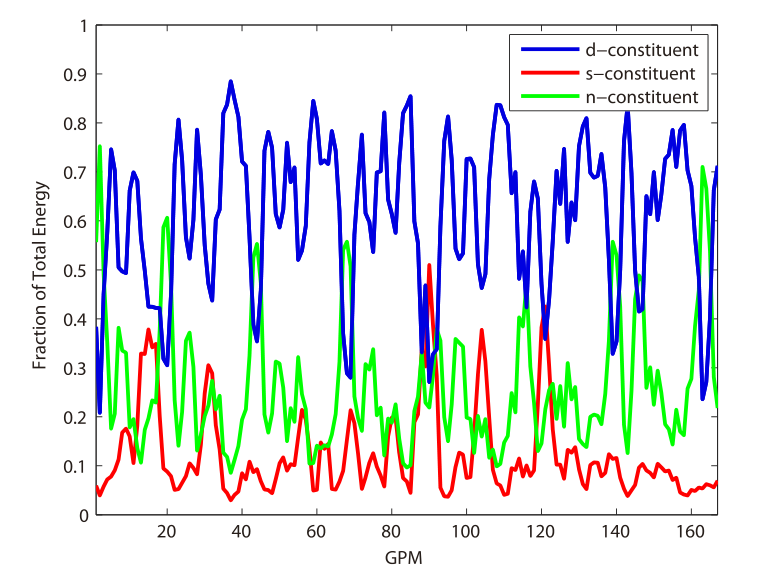
图 15|一天之内,周期成分的能量占比会跟着钟点起伏吗?
无字母子图。横轴是 GPM 序号,也就是这一周的时刻,刻度到 160。纵轴是占总能量的比例,0 到 1。蓝、红、绿仍是确定性、尖峰、噪声。多数时刻蓝线最高,但蓝线和绿线都有明显的周期性起伏;红线整体较低,中间夹着若干短促的峰。平滑窗宽为 3。正文把蓝、绿的周期起伏和昼夜活动联系起来,这是对曲线形态的解释,不是单独测量出来的出行目的。来源:原论文 Fig. 15。
上一周的确定性方向,套到下一周还差多少?
前面的 PCA 是事后对一整周做的。若要用于预报或异常检测,就得问:更早一段时间算出的确定性方向,还能不能近似后面一周。比较用的两段数据都是一周。较早的一段比前面几节分析的那一周早一周,它的起始时刻更早。图上再把两段起始时刻的间隔拉开,横轴刻度到 150 小时。
时间一侧先用目标周自己的 d-eigenPPV 做出确定性重建,记为各格子上的一条曲线。再用较早一周的主成分,去构造目标周的伪特征曲线,只保留较早一周里属于确定性类的那些方向,得到另一套重建。两套重建之差的大小,图中画成均方误差。对每一个格子,相对误差等于这两条曲线之差的二范数,除以该格自身确定性重建的二范数。分母不是原始 PPV,也不包括尖峰和噪声。105 个格子的相对误差再取平均。
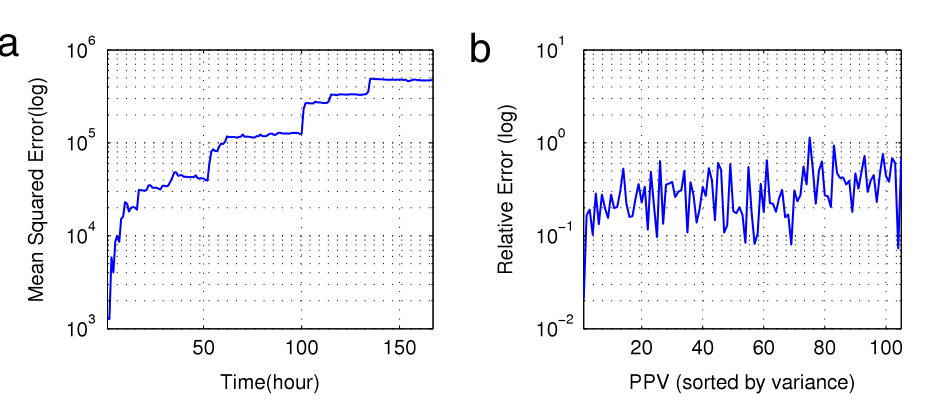
图 16|格子曲线的确定性部分,隔得越久差得越多吗?
(a)纵轴是均方误差的对数,刻度从 10³ 到 10⁶;横轴是两段一周数据的起始间隔,单位小时,刻度 50、100、150。差值随间隔变长而增大。正文把这个差值写成两套重建之差的 2-范数,图轴则标成均方误差,两套写法没有进一步换算。(b)纵轴是相对误差的对数,刻度从 10⁻² 到 10¹;横轴是按方差排序的 PPV,刻度到 100,对应市中心 105 个格子。这是间隔最大的那个比较点。各格相对误差的平均值约为 32.7%。0.327 位于 10⁻¹ 和 10⁰ 之间,所以 32.7% 是 105 个格子的平均,不是每个格子都等于 32.7%。来源:原论文 Fig. 16。
空间一侧利用的是 eigenGPM 在列顺序改变时的稳定性,并据此构造伪主成分。相对误差的定义与上一节相同,只是此时每一列是一个时刻的地图。正文对空间曲线没有写“差值随间隔单调变大”,只把末端单独拿出来算相对误差。空间公式里的指标集在排版上写成了 d-eigenPPV;这一节讨论的对象是确定性的空间模式。结论里也有一处把最显著的 eigenGPM 写成 d-eigenPPV。读图时仍以图 13 的三类空间模式为准。
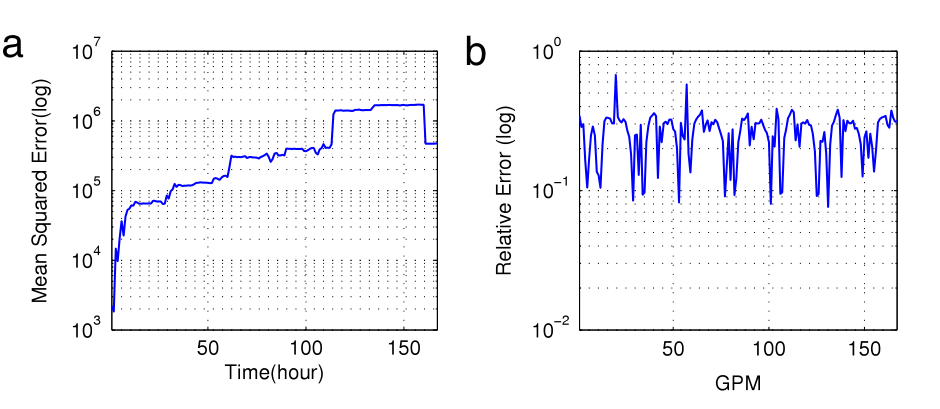
图 17|全市小时地图的确定性部分,末端的平均相对误差是多少?
(a)纵轴是均方误差的对数,刻度从 10³ 到 10⁷;横轴仍是起始间隔的小时数,刻度到 150。(b)纵轴是相对误差的对数,刻度从 10⁻² 到 10⁰;横轴是 GPM 序号,也就是时刻,刻度到 150,对应 167 个小时差分。正文报告末端这一点上、各时刻相对误差的平均值约为 26.4%。分母是该时刻自身确定性重建的二范数。0.264 同样是平均,落在 10⁻¹ 与 10⁰ 之间。来源:原论文 Fig. 17。
32.7% 和 26.4% 说明旧的确定性方向还带得走相当一部分结构,也说明两周的确定性部分并没有重合。正文用的词是 about,两个百分比都是大约值。这个比较没有把尖峰日的原始人数差算进分母。
同一张表转置之后,时间和空间为什么是一件事?
第 3 节和第 4 节的矩阵覆盖的地理范围不同,所以 10 和 20 可以同时成立。若对同一张数据表既按时间做 PCA、也按空间做 PCA,转置矩阵的奇异值集合与原矩阵相同,内在维度因此相同。原矩阵的主成分变成转置矩阵的 eigenGPM,原矩阵的 eigenPPV 变成转置矩阵的主成分。类别划分也随之相同。在这个条件下,从时间一侧做预报或异常检测,和从空间一侧做,代数上是同一套操作。这个对偶解释不了“市中心 10 个、全市 20 个”的差别,因为那是两张表。
稳定的周期,离预报和异常报警还差哪一次检验?
预报 PPV 的想法,是利用确定性模式所对应主成分的时间稳定性。先为 d-eigenPPV 建立带有周期的预报模型,正文举的例子是 ARMA,再把预报值代回只保留确定性部分的重构式,一次得到全部格子的预报差分。预报范围可以是一个时刻,也可以是一段时间。空间一侧则对 d-eigenGPM 的主成分做同样的外推,再合成各时刻的地图。
正文没有报告这些预报相对原始差分的误差,没有报告训练周和检验周怎样切开,也没有给 ARMA 的阶数。因此,上一节的 32.7% 和 26.4% 不能改写成预报准确率。它们比较的是两套确定性重建。
异常在正文里定义为显著偏离一般趋势。做法是用确定性成分把趋势拿掉,再在去趋势序列上用阈值找离群点,例子是离开均值 4 倍标准差。为了少重复做 PCA,新来的数据可以沿用最近一次的确定性方向,再对残差做同一个阈值检验。空间一侧改为检查残差矩阵的行。
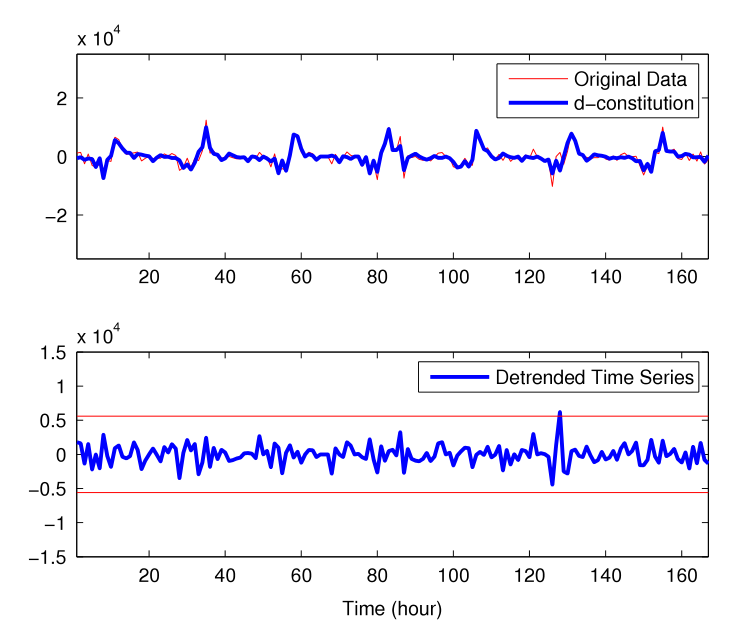
图 18|去掉昼夜节奏之后,哪一次偏离被对应到一场招聘会?
无字母子图,上下两幅,横轴都是小时、刻度到 160。上图乘数为 10⁴,能看到 ±2 的刻度,即大约 ±2 万人的小时人数差;红线是 PPV 72 的原始数据,蓝线是确定性成分,两条线在大的起伏上贴在一起,红线仍有若干偏离。下图乘数同样是 10⁴,刻度包含 ±0.5、±1 和 ±1.5;蓝线是去趋势序列,两条水平线落在 ±0.5 的刻度上,也就是大约 ±5000 人。序列有一次明显越出上侧水平线。正文把 PPV 72 的这次异常对应到 2009 年 11 月 30 日一场大型招聘会,参与者有数千人。图中没有把水平线标成四倍标准差,正文只把四倍标准差作为阈值的例子。主分析那一周的公历日期没有写明,因此不能从这张图推出第 3 到第 5 节的 167 个小时就是招聘会那一周。来源:原论文 Fig. 18。
这场招聘会说明,格子人数的短时偏离可以和一件全市知道的聚集活动对上。它没有给出求职者的个人路径,也没有报告这个阈值在其他日子的误报次数。
这些结构判断停在哪里
PCA 把方差最大的正交方向称为结构。周期成分占能量的大头,说明这一周的小时差分里,可重复的昼夜起伏强于短时爆发和残余抖动。它没有证明居民“按照这五条曲线行动”,也没有证明其他社会因素不起作用。类别规则还会重叠:5 个时间模式、4 个空间模式不止进入一类。噪声类所依赖的分位数图没有印出来。
样本是一座城市、一家运营商、主要结构分析只用一周,市中心又是因为人口变化更显著才被选来做时间分析。全市结果说明低维不只出现在这 105 个格子里,但两张矩阵不能合成一个“城市的维度就是 10 或 20”。人数来自话务分摊和定时提前量,带有正文给出的水平误差;小时差分会混入话务变化。补齐的 2387 个空位没有位置清单。十一点的空间反向没有解释。跨周比较的相对误差大约三成,分母还是确定性重建。预报和异常检测停留在方法和一个招聘会例子上。
正文把后续工作放在非线性的主成分扩展上。那一步没有在这篇里做,所以现在的低维、三类和稳定性都限于线性正交分解。
一句话总结
深圳这一周的城市人口增减,主要是少数可重复的昼夜节奏在时间曲线和全市地图上的同一类结构;相邻周还认得出这套结构,认得出不等于下一周每个格子的人数差已经知道。
核心来源
- Physica A 期刊页面,DOI:10.1016/j.physa.2010.10.033。正式题名、作者、卷期页码和首页 DOI 均按该文核对。图 1 至图 18 都在正文。
- 人口监测系统的估计步骤来自正文引用的 R. Xu、W. Feng、F. Zhou,Science and Technology Management Research,2008,7:334–335。正文没有印出这篇引文的题目。
- 缩写版本见正文参考文献 [1]:J. Sun、Y. Wang、H. Si、X. Mao、J. Yuan、X. Shan,第 6 届国际无线通信与移动计算会议论文集。会议论文的题目和年份没有印出。X. Mao 出现在这条参考文献里,不是本期刊论文的署名作者。
- 资助写在首页脚注:国家重点基础研究发展计划(973 计划)2007CB307100、2007CB307105。
作者介绍
五位作者的署名单位都是清华大学电子工程系,北京 100084。正文没有提供职务、履历或个人研究方向,下面只写论文上能核对的身份。
- J.B. Sun:通讯作者。
- J. Yuan:同单位作者,首页印有机构邮箱。
- Y. Wang:同单位作者。
- H.B. Si:同单位作者。
- X.M. Shan:同单位作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若市政只按昼夜节奏配置地铁班次和警力,招聘会那种数千人的短时聚集就会落在残差里。四倍标准差能把这种残差标出来,节日、事故和话务异常也会越过同一条线。论文只给了一个对得上的例子,没有给误报次数,所以阈值更像报警的起点,而不是已经校准的服务标准。
32.7% 还有一个容易换错的用法。它的分子是两套确定性重建之差,分母是当周自身的确定性重建。把它当成“下周人数预报平均错三成”,等于把比较对象从确定性结构换成了全部原始差分。真要检验预报,至少得另报三件事:相对原始小时差分的误差、招聘会那种尖峰日的误差,以及完全没有参与拟合的另一周的误差。这三件事正文都没有数。
十一点的权重与六点相反,只说明第一条空间模式被整幅翻面。午餐回流、商业区午间回落、学校放学,都可能产生相反的红蓝,也可能互不相干。在没有起讫或活动类型的数据时,符号相反停在“方向倒了”,到不了“人从哪一批格子走到哪一批格子”。
话务分摊还会把通信负荷写进人数字段。一次促销短信或一场线上直播,可能在人数几乎不变时抬高某些小区的爱尔兰。正文的 5% 与 10% 是人数水平相对当地实际人口的误差,覆盖 90% 和 99% 的格子,不是每个小时差分的误差。用这套差分安排应急资源时,需要先有一个独立的人数抽查,把话务冲击和真实聚集分开。