没见过的县、没见过的日期,只靠地区属性和日历,能生成出发地—目的地流量吗?
论文名片|Jie Zhao、Xianqi Dai、Jie Feng、Huandong Wang、Yong Li,DynaOD: Dynamic Origin-Destination Flow Generation with Discrete-to-Continuous Temporal Semantic Modeling,Proceedings of the Thirty-Fifth International Joint Conference on Artificial Intelligence(IJCAI-26),2026年8月,第3259–3267页,Main Track。DOI:10.24963/ijcai.2026/362。图表数值按 arXiv:2606.09086v1(2026年6月8日)核对。
设想要估计一个县在某个周一、各个普查区之间有多少人流。手头有各区的兴趣点构成和人口统计,也知道这一天是星期几、算不算假日,但生成时不再读取这个县以往的出发地—目的地流量表。DynaOD 把这件事做成条件生成:用地区属性和日历语境,合成随日期变化的流量矩阵。
在 2019 年 1 月美国 500 个县的普查区日流量上,形状模块只在见过的县、见过的日期上训练,再到没见过的县、没见过的日期上测试。默认配置的流量重叠 CPC(Common Part of Commuting,通勤公共部分)为 0.492。该指标上最强基线是预训练 NetGAN 的 0.365,论文给出的相对提升为 34.7%。这是地区到地区的流量矩阵比较。训练仍然用过其他县的真实流量,绝对成绩也仍受底下那个冻结生成器的限制。
先说结论
- 测试设定是没见过的县加上没见过的日期。DynaOD 在 CPC、逐格误差 RMSE、按真实流量经验方差归一化的 NRMSE,以及流入、流出和整矩阵三种 JS 散度(Jensen–Shannon divergence,越低表示分布越接近)上同时优于表中八个基线。每一列的相对提升都除以该列自己的最强基线,六列的分母来自不同模型。
- 方向控制拿掉之后,各指标都变差。把语言模型换成只靠下游流量监督的多层感知机后,CPC 从 0.492 降到 0.413,整矩阵 JS 散度从 0.220 升到 0.274。
- 向相似普查区检索形状,在图 4 的六个指标上都优于直接用 ShapeNet 推断。表 1 的 0.492 落在直接推断那一档的刻度带里;检索档更好,但图上没有印出精确小数,而且纵轴被截断。
- 1.5B 学生模型微调后,CPC 从 0.403 升到 0.476,教师模型 GPT-4o-mini 为 0.492。一次兴趣点方向查询平均 1.94 秒、约 0.00013 美元;一次人口属性方向查询平均 4.51 秒、约 0.00039 美元。
- 同一套调制可以接到冻结的 NetGAN 或 WeDAN 上。NetGAN 的 CPC 从 0.365 升到 0.461,WeDAN 从 0.331 升到 0.492。插件抬高了两个生成器,最终高低仍跟着底层模型走。
要生成的是普查区之间的日流量
研究对象是动态起讫流量(dynamic origin–destination flows):一天里,从普查区 i 到普查区 j 的流量组成一张矩阵。论文把美国的县当作城市实例,把普查区当作空间单元。县与县之间互相比,是跨城;县内部的格子,才是出发地和目的地。
数据把 Kang 等人 2020 年公开的美国移动流量,与 Rong 等人 2025 年通勤基准里的地区属性对齐,时间是 2019 年 1 月,覆盖 500 个县。每个普查区有 34 类兴趣点分布,以及 97 维人口与社会经济属性。每一天再配一个 8 维日历向量:星期的 7 维独热编码,加上 1 维假日指示。日流量矩阵和这些属性按同一套普查区对齐。
论文没有给出普查区总数、见过与没见过的县数、日期如何划分,也没有定义矩阵每一格的物理单位。后文的 RMSE 是这套流量数值上的逐格误差。
划分是两条轴同时切开:县分成见过和没见过,日期也分成见过和没见过。训练只用见过的县、见过的日期。报告的测试是没见过的县,并且日期也没见过。只优化 ShapeNet;预训练的流量生成器和方向控制信号在这一协议里保持固定。见过的县配没见过的日期、没见过的县配见过的日期,这两格结果正文没有单列。
生成时不读历史流量表,和训练时见过真实流量,是两件事
图 1 把两种任务并排放在一起。预测是拿历史流量矩阵,外推之后某一天的矩阵。生成是拿地区特征和日历语境,直接合成当天的矩阵。DynaOD 站在生成这一侧。
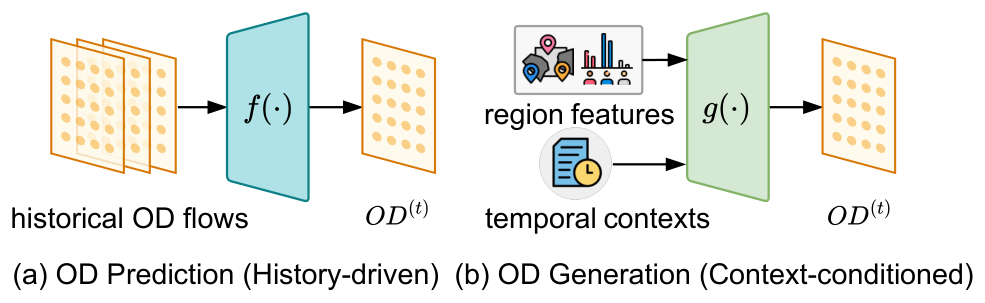
图 1|历史流量外推,和按语境生成,输入差在哪里?
(a)历史驱动的流量预测:多张历史起讫矩阵进入函数 f,输出当天矩阵。(b)语境条件的流量生成:地区特征与日历语境进入函数 g,输出当天矩阵。橙点表示矩阵格子里的流量。来源:原论文 Fig. 1。
生成阶段的输入是地区属性和日历。ShapeNet 的训练损失仍然比较生成矩阵和真实矩阵,用的是见过的县、见过的日期上的流量。因此,新县在测试时可以不提供自己的历史流量表;系统在训练阶段已经从别的县学过流量长什么样。把摘要里的 minimal supervision 理解成全世界都没有任何流量标签,会把实验协议说大。
基线也拿到了同样的 8 维日历,并在适用时拼到地区输入上,原架构不改。NetGAN 和 WeDAN 使用 Rong 等人 2025 年的预训练模型,推理时换日历,不再微调。DynaOD 额外训练了形状模块。比较的是同一套测试划分上的矩阵质量,训练中可更新的部件并不相同。
方向先分成三档,幅度再交给形状网络
日历对流量的影响往往是间接的。工作日和假日先改变活动往哪边偏,流量数字是这种偏向经过空间汇总之后的结果。DynaOD 把这种偏向写成离散方向。对每个普查区、每个日期,语言模型给出两组控制向量,每一维只取 −1、0、1,表示该特征预期下降、持平或上升。兴趣点控制有 34 维,依据地区语境和日期;人口属性控制有 97 维,还要参考已经推断出的兴趣点方向和人口属性本身。这些方向没有人工标注的标准答案。
ShapeNet 再把方向变成连续的逐日幅度。它为兴趣点和人口属性分别输出高斯分布的均值和对数方差,用重参数化采样,得到连续形状。静态地区特征只做弱条件,避免模型靠记住某个县的身份来拟合。时间平滑惩罚会压住不合理的逐日跳动;当方向控制本身是 0 时,惩罚更强。
调制是逐元素的乘法。记原始特征为 x,形状为 s,方向为 c,调制后的特征是 x ⊙ (1 + s ⊙ c)。c 为 0 时,括号里是 1,静态特征原样进入生成器。c 为 1 或 −1 时,形状决定往上或往下拨多少。拨过的特征送进冻结的预训练静态流量生成器,一天一张矩阵。默认生成器是预训练 WeDAN。为了能反传,训练时梯度只经过最后若干步 DDIM 去噪,生成器参数不动。
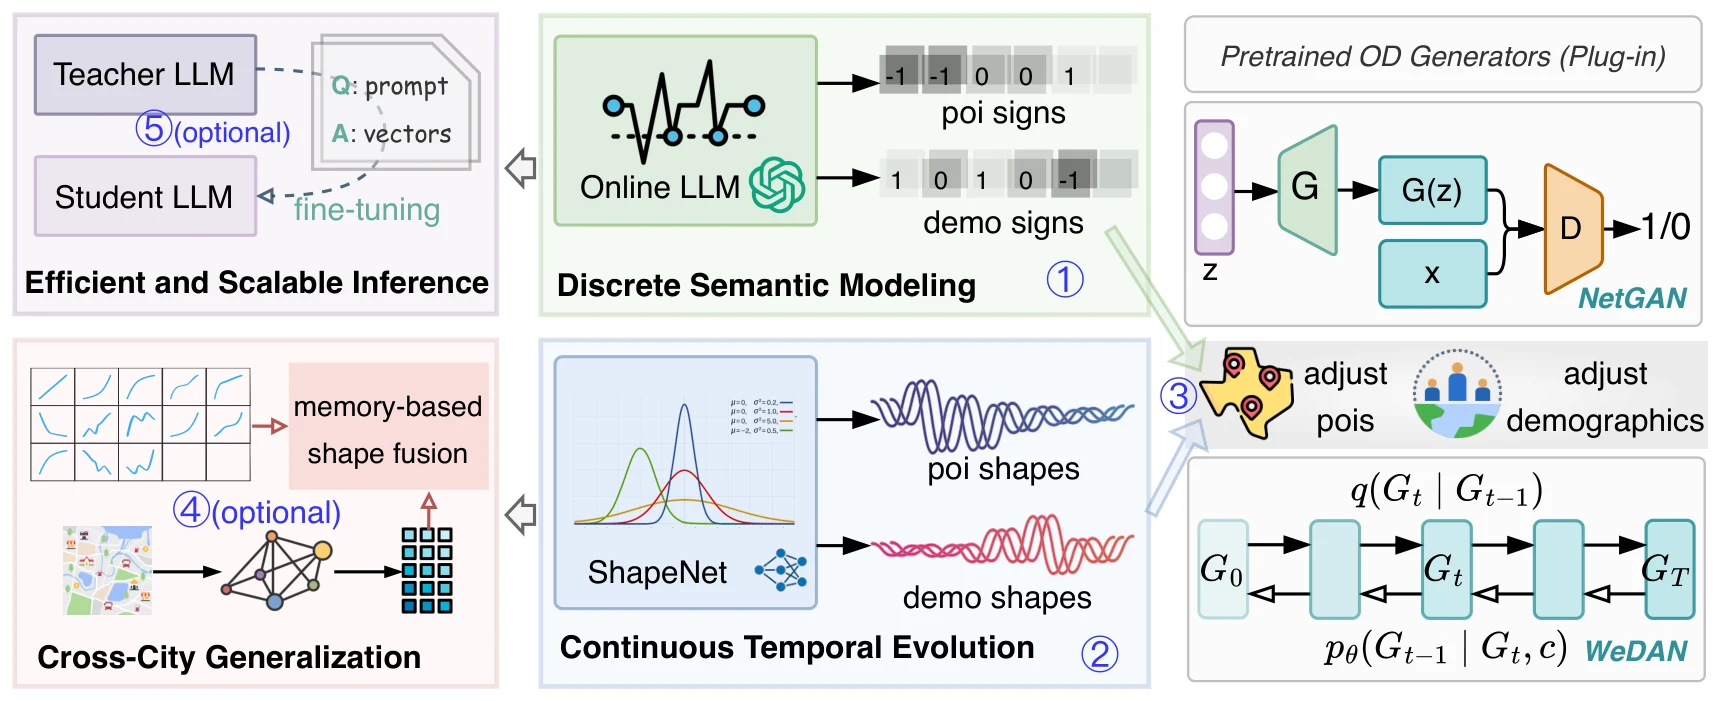
图 2|从日历语境到一张动态流量矩阵,中间经过哪些模块?
(1)在线语言模型把语境变成兴趣点和人口属性的离散正负号。(2)ShapeNet 把这些符号变成多日的连续形状。(3)形状去调整兴趣点和人口属性,再交给冻结的生成器;图中画出 NetGAN 的生成—判别结构,以及 WeDAN 的扩散式转移。(4)可选:按相似度检索记忆中的形状并加权融合,用于跨县。(5)可选:教师模型蒸馏到学生模型,换掉在线调用。图中的正负号和曲线是结构示意。来源:原论文 Fig. 2。
跨县时可以不在测试阶段运行 ShapeNet。ShapeMem 先把 ShapeNet 的高斯形状按星期几汇总成先验,再用图表示学习得到地区嵌入。推理时按余弦相似度取最相近的 5 个普查区,用归一化相似度做加权平均,得到目标普查区在该星期几的形状,然后仍走同一步特征调制。检索模块和生成器分开,所以可以更换底层生成器。
在线大模型要为很多普查区、很多天产生方向向量。论文用教师模型的离散决策作伪标签,监督学生模型。学生模型是 Qwen2.5-1.5B-Instruct,LoRA 只更新 query 和 value 投影;表 2 和图 5 把它写成 Qwen-2.5-1.5B 与 Qwen-2.5-1.5B-SFT。兴趣点和人口属性分成两种指令,输出仍是固定长度的 −1、0、1 向量。蒸馏之后,学生模型替换教师模型,ShapeNet 和流量生成器可以不动。
六个指标分别相对谁提高?
指标分三组。RMSE 是矩阵逐格误差。NRMSE 按论文的说法,用真实流量的经验方差做归一化,所以它和 RMSE 是同一批格子上的两种刻度,不能把 0.940 和 253.09 当成两种人次。CPC 衡量预测矩阵和真实矩阵的流量重叠,越高越好;论文没有写出计算公式。JS 散度分别算在流入分布、流出分布和整张流量分布上,越低越接近;论文没有给出对数底和分箱方式。
| 模型 | CPC↑ | RMSE↓ | NRMSE↓ | JSD-In↓ | JSD-Out↓ | JSD-OD↓ |
|---|---|---|---|---|---|---|
| GM-P | 0.181 | 317.11 | 1.161 | 0.722 | 0.834 | 0.662 |
| GM-E | 0.179 | 309.23 | 1.163 | 0.731 | 0.838 | 0.671 |
| RF | 0.219 | 304.35 | 1.106 | 0.691 | 0.798 | 0.513 |
| SVR | 0.206 | 312.98 | 1.143 | 0.706 | 0.780 | 0.444 |
| GBRT | 0.196 | 310.41 | 1.127 | 0.720 | 0.806 | 0.550 |
| DGM | 0.214 | 312.29 | 1.133 | 0.747 | 0.827 | 0.502 |
| NetGAN 预训练 | 0.365 | 293.42 | 1.129 | 0.657 | 0.736 | 0.574 |
| WeDAN 预训练 | 0.331 | 286.51 | 1.056 | 0.502 | 0.741 | 0.333 |
| DynaOD | 0.492 | 253.09 | 0.940 | 0.322 | 0.421 | 0.220 |
| 表中相对提升 | 34.7% | 11.7% | 11.0% | 35.9% | 42.8% | 33.9% |
表 1 的相对提升,分母是该列数值最好的基线。CPC 越高越好,最强基线是 NetGAN 的 0.365,(0.492 − 0.365) / 0.365 用表中已四舍五入的数字重算约为 34.8%,表内印的是 34.7%,差额来自展示精度。RMSE、NRMSE、JSD-In、JSD-OD 的最强基线是 WeDAN:286.51、1.056、0.502、0.333,对应降幅 11.7%、11.0%、35.9%、33.9%。JSD-Out 的最强基线是 NetGAN 的 0.736,WeDAN 是 0.741;(0.736 − 0.421) / 0.736 = 42.8%。正文说的分布差异最多降低 42.8%,指的就是这一列,分母是 0.736。
两种引力模型 GM-P、GM-E 的 CPC 只有 0.179 和 0.181,是表中重叠最低的一档。论文引用 Zipf 1946,没有在正文展开 P 和 E 两个字母。随机森林、支持向量回归、梯度提升树和深度引力模型 DGM 的 CPC 落在 0.196 到 0.219。它们收到了日历特征,仍明显低于两个预训练图生成模型。NetGAN 的重叠 0.365 高于 WeDAN 的 0.331,但 WeDAN 的 RMSE 286.51 低于 NetGAN 的 293.42,整矩阵 JS 散度 0.333 也低于 0.574。静态基线谁更强,取决于看重叠还是看误差和分布。
方向控制拿掉以后,还剩什么?
图 3 比较四种方向设置:去掉全部控制、去掉兴趣点控制、去掉人口属性控制、两种都保留。星标打在两种都保留的柱上。六个纵轴都不从 0 起,柱高差距会被放大;柱顶没有数字。
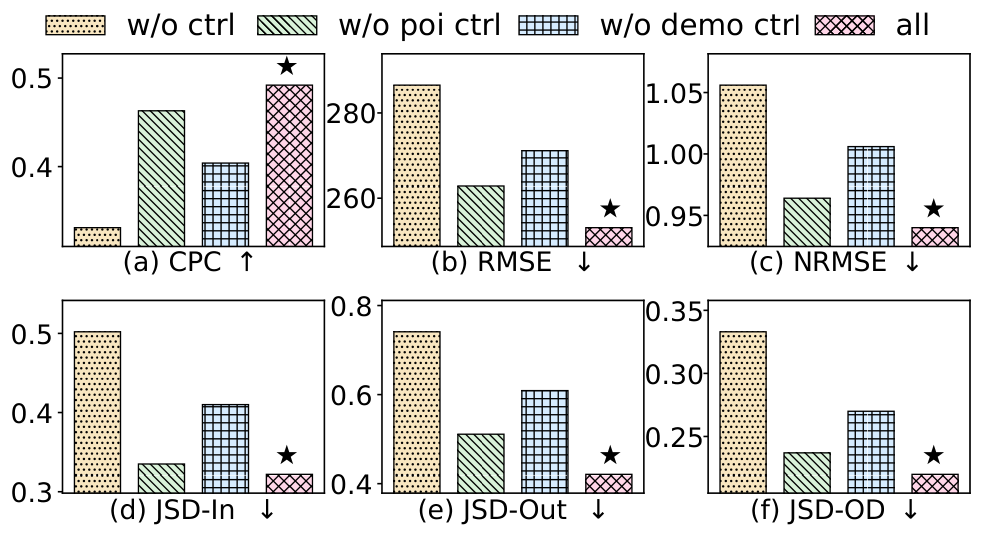
图 3|方向控制是日历真的在起作用,还是多了一组可有可无的开关?
(a)CPC,越高越好,纵轴大约从 0.3 到 0.5。(b)RMSE,越低越好,纵轴从 260 到 280 以上。(c)NRMSE,越低越好,纵轴从 0.95 到 1.05。(d)流入 JS 散度,(e)流出 JS 散度,(f)整矩阵 JS 散度,都是越低越好。黄点为去掉全部控制,绿斜线为去掉兴趣点控制,蓝格为去掉人口属性控制,粉格为两种都保留。星标在粉格上。来源:原论文 Fig. 3。
去掉全部控制后,重叠更低,误差和三种分布差异都更高。只保留一种控制时,柱子落在全无和全有之间。论文的概括是:兴趣点控制主要改善重建精度,人口属性控制更利于缩小流入和流出的分布差异,两者一起时六个指标都最好。由于柱顶没有读数,这个主次分工不能从本图复核到具体差值。
方向有用,还可能只是因为 −1、0、1 这种离散格式方便优化。论文用一个轻量多层感知机换掉语言模型,得到 DynaODCLS。CPC 从 0.492 降到 0.413,下降 0.079;整矩阵 JS 散度从 0.220 升到 0.274,上升 0.054。分类器只从下游流量监督里学方向,语言模型还带有语义先验。这一对比支持语义先验有贡献,同时说明 0.492 里有一部分来自控制模块的形式,不能全部记到语言模型上。
直接算形状,还是向相似普查区借?
图 4 比较两条得到连续形状的路:测试时直接跑 ShapeNet,以及按相似地区检索后加权。六个面板里,检索一侧都带星标。纵轴同样被截断。CPC 只显示 0.49 到 0.51,RMSE 只显示 246 到 255,流入 JS 散度挤在 0.32 附近。
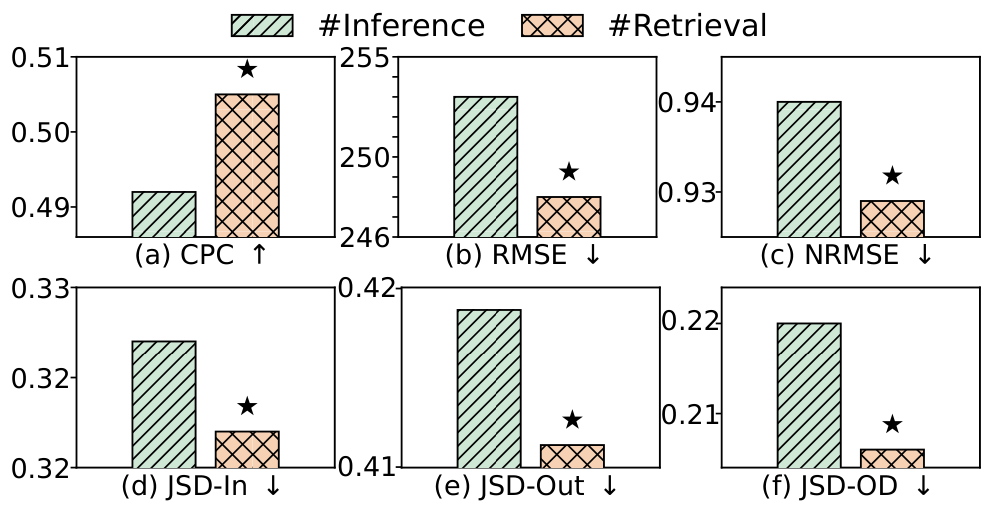
图 4|没见过的县上,现场计算形状和借用相似地区的形状,差多少?
(a)CPC,纵轴 0.49–0.51。(b)RMSE,纵轴 246–255。(c)NRMSE,纵轴 0.93–0.94。(d)流入 JS 散度,刻度集中在 0.32–0.33。(e)流出 JS 散度,纵轴 0.41–0.42。(f)整矩阵 JS 散度,纵轴 0.21–0.22。绿斜线为直接推断,橙格为检索,星标在检索一侧。来源:原论文 Fig. 4。
表 1 的 DynaOD 是 CPC 0.492、RMSE 253.09、NRMSE 0.940、流入 JS 散度 0.322、流出 0.421、整矩阵 0.220。这些数字落在图 4 直接推断那一档的刻度带里。检索在每个面板上更好,改进发生在已经较高的水平上。图上没有检索档的精确小数,不能把星标读成另一个 34.7%。检索的另一层含义是测试时不必再跑 ShapeNet,部署成本因此不同;图 4 本身只比较矩阵指标,没有给出耗时。
小模型接过方向判断后,还差教师多少?
教师模型是 GPT-4o-mini。兴趣点方向查询平均 1.94 秒,输入约 415 个 token,输出约 110 个 token,费用约 0.00013 美元。人口属性方向查询平均 4.51 秒,输入约 1436 个 token,输出约 287 个 token,费用约 0.00039 美元。这是 gpt-4o-mini 的平均开销。论文认为地区级查询可以并行;蒸馏则是为了测试时不再调用在线教师。
| 方向模型 | CPC↑ | RMSE↓ | NRMSE↓ | JSD-In↓ | JSD-Out↓ | JSD-OD↓ |
|---|---|---|---|---|---|---|
| Qwen-2.5-1.5B | 0.403 | 274.43 | 1.010 | 0.411 | 0.637 | 0.276 |
| Qwen-2.5-1.5B-SFT | 0.476 | 260.86 | 0.959 | 0.336 | 0.475 | 0.234 |
| GPT-4o-mini | 0.492 | 253.09 | 0.940 | 0.322 | 0.421 | 0.220 |
其余模块固定,只换方向控制器。未微调的 1.5B 模型 CPC 为 0.403,比教师低 0.089。监督微调后升到 0.476,与教师还差 0.016。按这三个 CPC 计算,微调补上了 (0.476 − 0.403) / (0.492 − 0.403) = 82.0% 的差距。RMSE 从 274.43 降到 260.86,教师是 253.09。整矩阵 JS 散度从 0.276 降到 0.234,教师是 0.220。流出 JS 散度从 0.637 降到 0.475,教师是 0.421。六项都向教师靠拢,单项仍留有缺口。
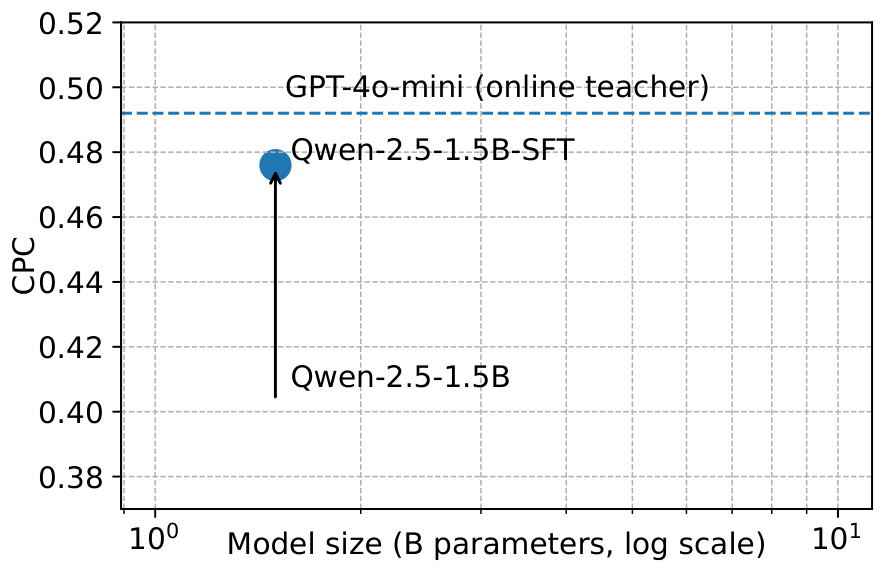
图 5|模型参数量更大,是否就等于流量重叠更高?
无字母子图。横轴是参数量的对数刻度,从 10⁰ 到 10¹。纵轴 CPC 从 0.38 到 0.52。蓝色圆点和箭头标出 Qwen-2.5-1.5B 微调后的位置,箭头起点标着未微调的 1.5B 模型。蓝色虚线是在线教师 GPT-4o-mini 的 CPC,画成水平参照,没有给出教师的参数量。来源:原论文 Fig. 5。
图 5 的纵轴位置与表 2 一致:未微调约在 0.40,微调约在 0.48,教师虚线约在 0.49。它展示的是重叠和参数量的关系,费用和秒数在正文里,不在这张图上。
换一个冻结的生成器,插件还抬得动吗?
| 模型 | CPC↑ | RMSE↓ | NRMSE↓ | JSD-In↓ | JSD-Out↓ | JSD-OD↓ |
|---|---|---|---|---|---|---|
| NetGAN 预训练 | 0.365 | 293.42 | 1.129 | 0.657 | 0.736 | 0.574 |
| DynaOD + NetGAN | 0.461 | 281.01 | 1.096 | 0.611 | 0.519 | 0.522 |
| WeDAN 预训练 | 0.331 | 286.51 | 1.056 | 0.502 | 0.741 | 0.333 |
| DynaOD + WeDAN | 0.492 | 253.09 | 0.940 | 0.322 | 0.421 | 0.220 |
两组实验都保持生成器冻结,不改原架构和原训练过程。相对 NetGAN 自己的 0.365,加上 DynaOD 后 CPC 为 0.461,增加 0.096,相当于 0.365 的 26.3%。RMSE 从 293.42 降到 281.01,降幅是 293.42 的 4.2%。整矩阵 JS 散度从 0.574 降到 0.522,降幅是 0.574 的 9.1%。流出 JS 散度从 0.736 降到 0.519,降幅是 0.736 的 29.5%。
相对 WeDAN 自己的 0.331,CPC 升到 0.492,增加 0.161,相当于 0.331 的 48.6%。48.6% 的分母是 WeDAN 自己的 0.331;表 1 的 34.7% 分母是 NetGAN 的 0.365。两个百分比来自两次不同的除法。WeDAN 版本的 RMSE 253.09 和整矩阵 JS 散度 0.220 仍是表中最好的一档。
论文把 NetGAN 称为相对较弱的生成器。按 CPC,预训练 NetGAN 的 0.365 其实高于预训练 WeDAN 的 0.331;按 RMSE 和整矩阵分布,WeDAN 更好。接上 DynaOD 之后,WeDAN 版本的 0.492 高于 NetGAN 版本的 0.461。插件改变的是时间适应,底层生成器的上限还在。
一个普查区的一周,能看出什么?
图 6 抽了一个普查区,窗口是 2019 年 1 月 25 日到 31 日。方向来自 GPT-4o-mini,形状来自 ShapeNet。原图没有子图字母。
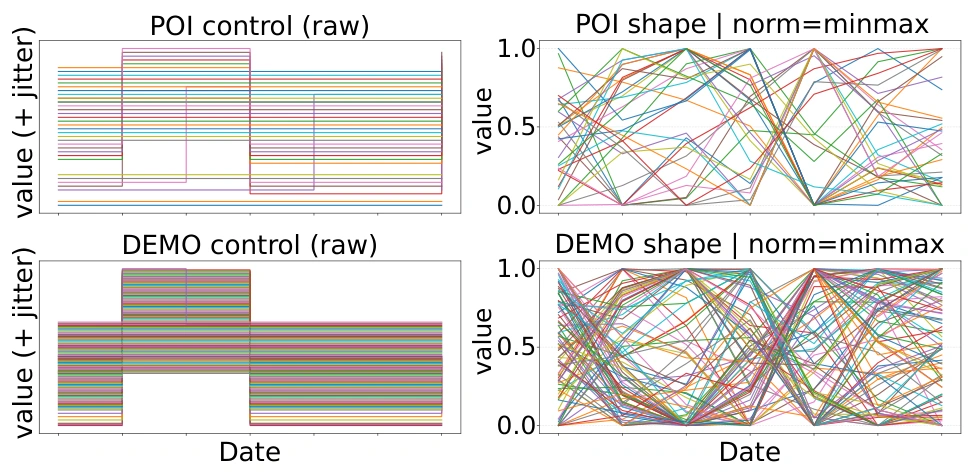
图 6|离散方向和连续形状,在同一个普查区的七天里各是什么样子?
左上是兴趣点方向的原始控制,左下是人口属性方向的原始控制,纵轴写明数值加了抖动,因此线条的上下散布来自画图,横轴只有日期、没有标出星期几。右上、右下是对应的连续形状,每一维单独做了最小—最大归一化,纵轴从 0 到 1。每条彩线是一个特征维,图中没有给出类别名称。来源:原论文 Fig. 6。
左列看起来是分段常数的横线,符合 −1、0、1 这种粗方向;右列则是随日期起伏的多条曲线。论文用这个例子说明:方向决定往哪边变,ShapeNet 决定变化怎样逐日展开,这一展示不读取该普查区的历史流量表。它是一个随机抽中的地区,归一化又抹掉了原始幅度,不能从彩线读出哪一类兴趣点在哪一天上升,也不能把这一周推广成 500 个县的平均周模式。
这些比较停在哪一步
日历语境在实验里就是星期和假日,一共 8 维。暴雨、赛事、道路封闭没有进入输入,也就没有被这张测试表检验。方向质量取决于语言模型;地区描述稀疏或含糊时,论文自己预期控制会不稳。ShapeNet 固定在日尺度,更细的小时或不等间隔时段还是未做的题目。
流量生成器保持冻结,所以 DynaOD 的上限跟着 WeDAN 或 NetGAN 走。表 3 已经给出同一个插件下 0.492 和 0.461 的差距。图 3 和图 4 的纵轴截断会让很小的绝对差看起来很大,读星标时要回到表 1 的原始刻度。
测试范围是 2019 年 1 月的美国县和普查区。文中的跨城指这 500 个县里的未见县。论文没有按流量大小分层报告误差。CPC 0.492 说明仍有相当一部分流量没有重叠到同一格上。RMSE 相对 WeDAN 的 286.51 下降 11.7%,论文没有分开大走廊和小流量格子各自的贡献。
一句话总结
只靠地区属性和星期、假日,DynaOD 能在没见过的县和日期上生成比静态基线更接近真实矩阵的普查区流量;生成时不必再喂入当地的历史流量表,训练仍用过其他县的真实流量,最终误差也仍取决于那个冻结的生成器。
核心来源
- IJCAI 2026 论文页面,正式题目、作者与会议条目。官方书目给出 DOI 10.24963/ijcai.2026/362,页码 3259–3267,2026 年 8 月,Main Track。
- arXiv:2606.09086v1,2026 年 6 月 8 日。本文图 1–6 与表中数字按这一版核对。该 PDF 首页印有 arXiv 编号,没有印 DOI。
- 作者代码仓库。论文写明代码公开。仓库说明不能代替正文里没有写出的样本划分和流量单位。
- 数据由论文指明为 Kang 等人 2020 年的美国公开移动流量,以及 Rong 等人 2025 年通勤起讫流量基准中的地区属性。本文只讨论已经汇总到普查区的出发地—目的地矩阵。
作者介绍
五位作者的单位以论文署名为准。正文没有贡献声明,下面不替他们分配实验分工。
- Jie Zhao:署名为清华大学电子工程系、北京信息科学与技术国家研究中心(BNRist)。其个人主页自述为该系博士后,2024 年于重庆大学获计算机科学博士学位,工作涉及城市移动与轨迹表示。
- Xianqi Dai:署名为清华大学深圳国际研究生院。论文没有另附个人履历。
- Jie Feng:通讯作者,署名为中关村学院,邮箱 fengjie@bza.edu.cn。本文参考文献中有他与同组作者关于交通预测和城市时空模型的工作。
- Huandong Wang:署名为清华大学电子工程系、BNRist。论文没有另附个人履历。
- Yong Li:署名为清华大学电子工程系、BNRist,邮箱 liyong07@tsinghua.edu.cn。清华大学电子系 FIB-LAB 组会页面记录,Jie Zhao 于 2026 年 1 月 24 日报告了本文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
这套日历只有星期和假日。若要生成暴雨日或大型活动日的普查区流量,需要在同一套未见县划分上增加这类语境,并检查方向向量是否真的改档、ShapeNet 的形状是否跟着移动。只把活动名称写进提示词,而测试表仍是普通星期,不能说明模型已经听懂了活动。
检索用的是嵌入空间里最相近的 5 个普查区。若相近只反映人口规模,而兴趣点构成差得很远,借来的星期形状可能把工作日的通勤骨架套到一个旅游区上。一个直接的检查是:在余弦相似度之外,再看这 5 个邻居的 34 类兴趣点是否也接近,以及加权之后的 CPC 变化有多少来自这一个约束。论文没有报告这个检查,它仍是待测的问题。
CPC 0.492 相对 NetGAN 的 0.365 是清楚的重叠提升,相对完整重合仍有距离。若规划关心的是小流量普查区对,而 RMSE 的 11.7% 主要来自大流量格子,县一级的平均改进可以和某一条联络的误差同时存在。按流量大小分层之后再报 CPC 和 RMSE,才能判断这张矩阵适合看走廊,还是也适合看单个街区之间的联系。