一个起点发出的通勤变多了,去向的份额还能按同一条规律分吗?
论文名片|Changjian Liu、Yong Gao、Yuqing Wang、Leyi Su、Honglei Guo、Zhiyang Wang、Xiaoyu Wang、Fan Zhang,OpFlow: Learning Opportunity-Conditioned Choice Potentials for Robust OD Flow Prediction,arXiv 预印本,2026年7月3日,arXiv:2607.03200v1,分类 cs.LG。arXiv:2607.03200。通讯作者为 Yong Gao。这是一项方法研究,预测空间单元之间的出发地—目的地流量,并检查环境改变后哪些部分还能沿用。
设想一个美国县里的人口普查区块。工作日早上,它送出一批通勤,终点是同一个县里的其他区块。预测表上的一个格子同时记着两件事:这个起点一共发出多少通勤,以及这些通勤在各个目的地之间怎么分。居住人口一变,第一件事就变;岗位、路网远近和沿途还有哪些地方可去一变,第二件事也变。
直接拿历史人数训练的模型,可以把这两件事一起记下来,在见过的县里误差很小。换一个岗位更集中的县,或者机会多的地方不再恰好离得更近,记下来的人数规律就对不上。OpFlow 把希望换县之后仍能使用的对象收成一条条件映射:看到起点面对的机会、阻抗、沿途替代和局部竞争,就给出各个目的地的相对选择势;起点发出多少人,由另一支单独标定。合成环境里的三类偏移,以及 3,333 个美国县的县内通勤,用来检查这条映射是否比直接拟合原始计数更稳。
这些结果比较的是模型输出与生成实验中的真实分配,或与县内通勤计数及其行份额。在这些测试里,分开规模和分配后,行 KL 和对数人数误差更低。捕获竞赛是把份额写成 softmax 的模型假设。
先说结论
- 一条出发地—目的地记录同时含有起点产出规模和目的地分配。合成实验只加大起点规模的差异时,按原始计数训练的模型行 KL 变差;按行份额训练的模型和 OpFlow 基本保持平坦。
- 目的地机会被重新分布后,最强一档上 OpFlow 的 Row-KL 比验证集选出的最佳领域泛化模型低 23.7%。这个百分比的分母是该基线自己的 Row-KL,论文没有同时印出两个原值。
- 训练时机会与可达性正相关,测试时把相关反转:BestDG-AllocMLP 的 Row-KL 从 0.265 升到 0.331,OpFlow 在最强反转处为 0.156,相当于把 0.331 降低 52.9%。
- 美国 3,333 个县的县内通勤上,OpFlow 在随机、地理和大区机会结构三种划分里,Row-KL 与 Log-RMSE 都最低。表 2 给出的平均是 0.377/0.688/1.09,顺序为 Row-KL、Row-CPC、Log-RMSE。正文把 PairMLP 的平均 Row-KL 写成 0.410,表 2 写的是 0.413。
- 机会结构划分上,ScaleMLP 的 Row-CPC 为 0.693,高于 OpFlow 的 0.670。重叠质量、概率比值和对数人数误差会给出不同排序。
原始人数里,哪一部分有机会换县继续用?
空间交互里的引力模型、介入机会模型和辐射模型,都把流量写成“起点先产生需求,再按某种空间结构分给目的地”。深度模型常常省掉这一步,直接让网络输出人数。OpFlow 认为,分布一变就容易失效的原因在监督目标:原始计数把规模和分配缠在同一个损失里。起点规模的方差通常比分配概率的方差大几个数量级,这是作者对优化为何被规模带着走的判断,文中没有给出这套美国通勤数据上的方差比。
于是期望流量被写成一行里的乘积。起点 i 在环境 e 中的期望流量等于产出规模 R 乘以分配份额 π。规模决定发出多少,份额决定去哪。份额来自一组选择势的 softmax:同一行全体加上一个常数,份额不变,所以能从份额里识别的是行内相对高低。OpFlow 预测的是减去行均值之后的选择势,再与单独预测的规模相乘,还原流量。
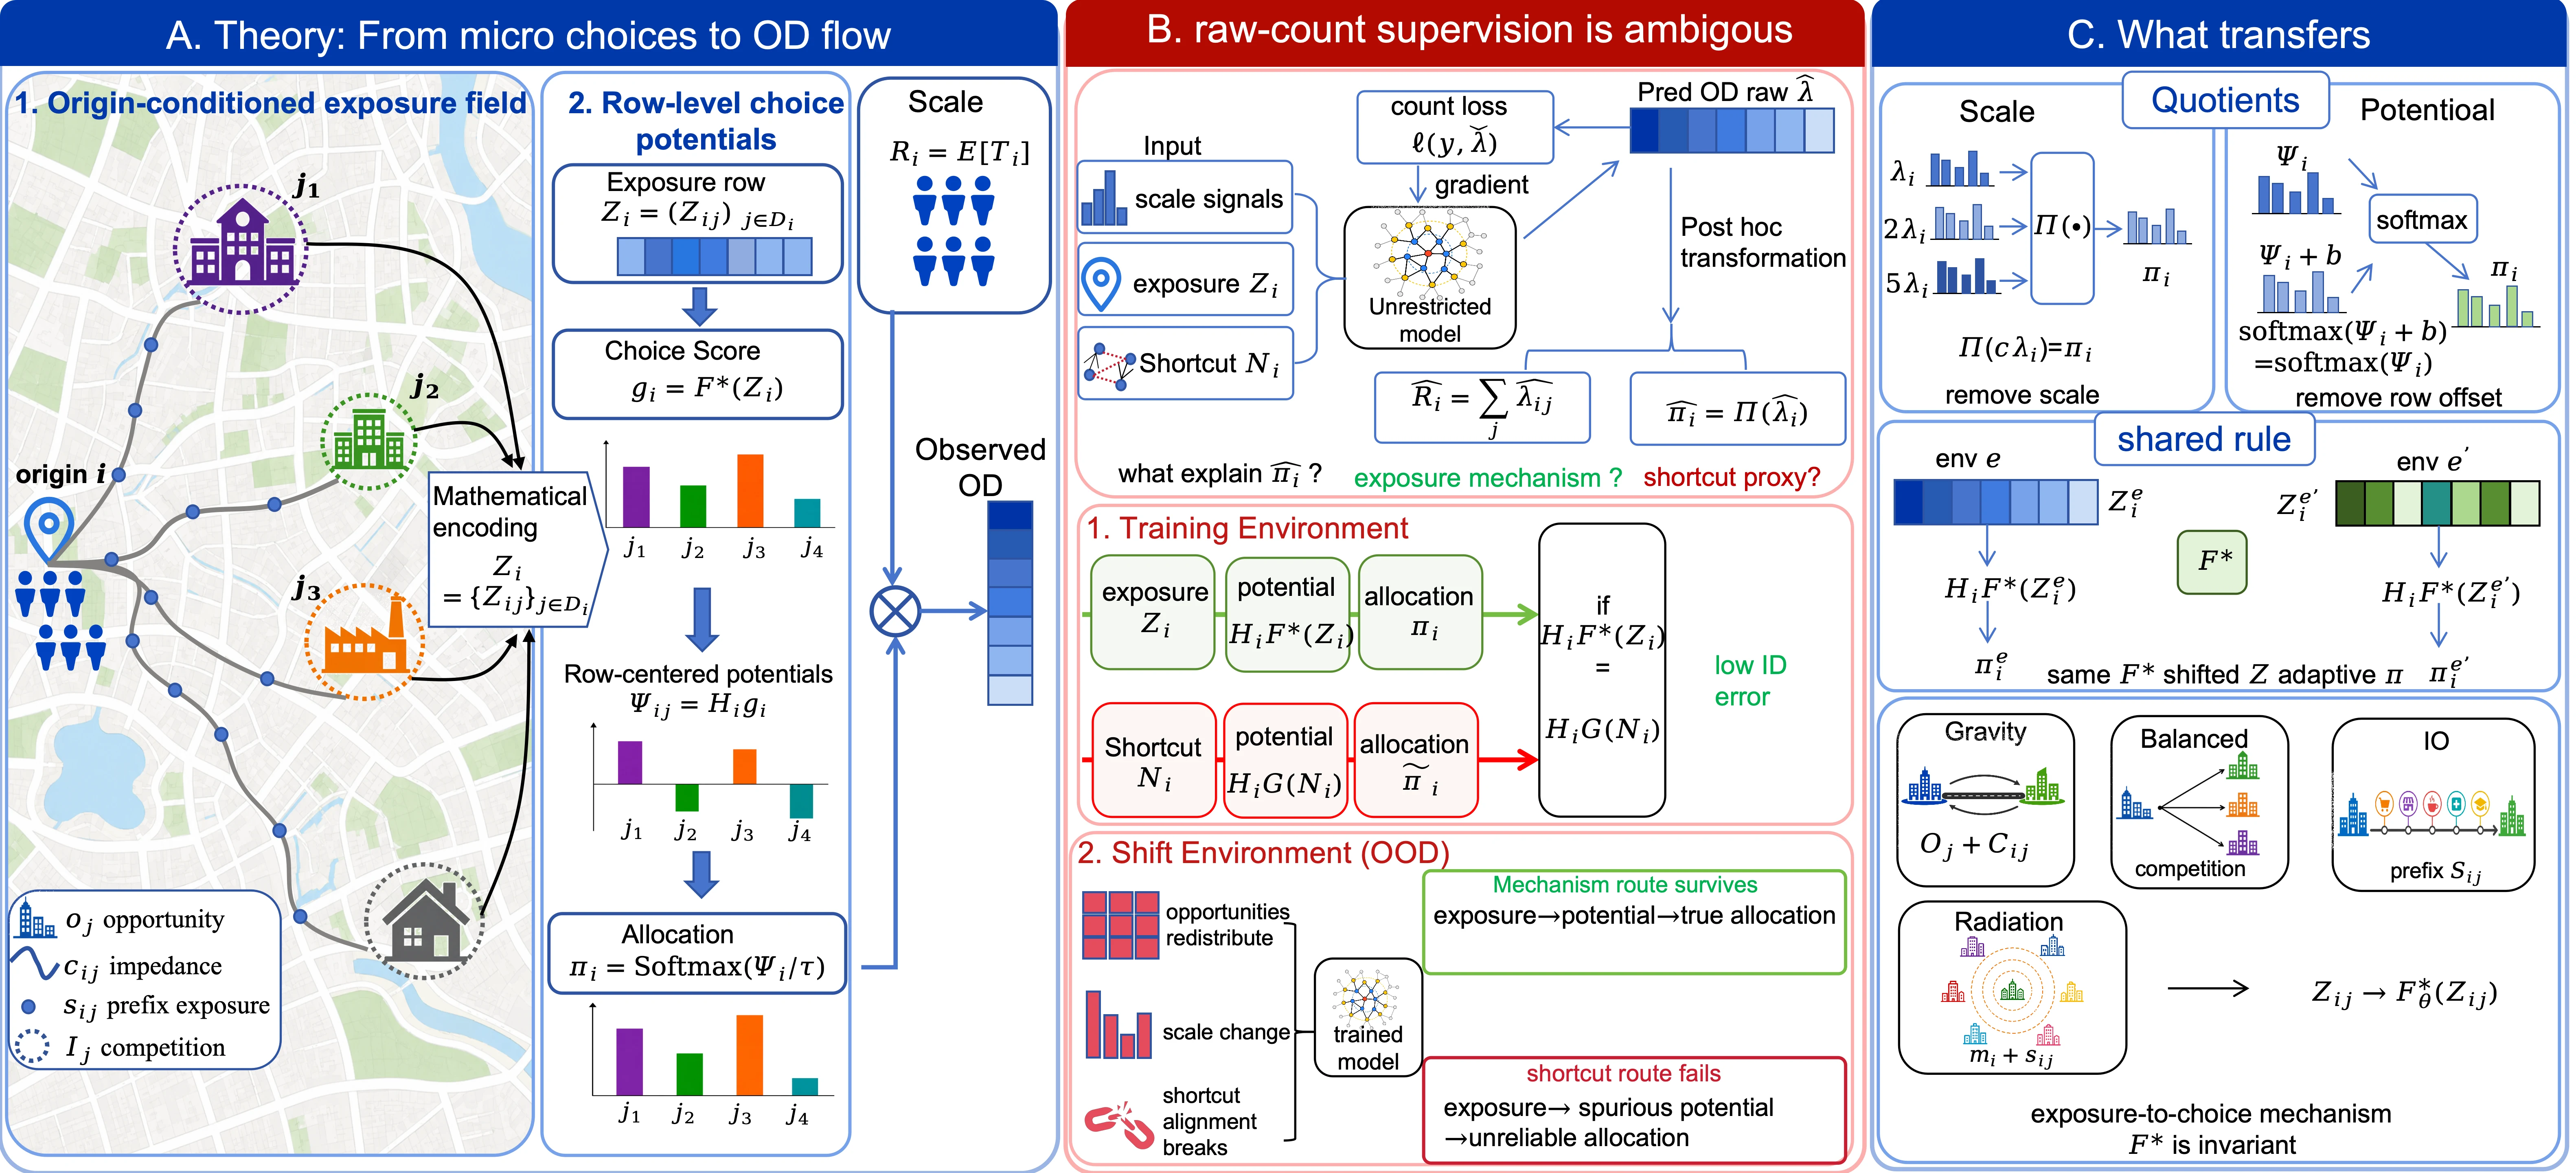
图 1|原始人数里,哪一部分被当成换环境后仍可使用的机制?
(A)左侧地图把起点面对的条件画成机会、阻抗、沿途暴露和局部竞争;右侧把一行流量拆成规模、行内选择势和 softmax 之后的份额,二者相乘得到观测流量。(B)同一组输入在训练环境里既可以走出机制路径,也可以走出捷径;两种路径都能把分布内误差做低。环境改变后,机制路径仍由暴露得到份额,捷径在规模变化或机会重新分布时对不上。(C)行中心化去掉每一行的整体偏移;重力、竞争和辐射被画成同一条暴露到选择势映射的不同形式。可以换的是这条映射,暴露和由此产生的份额允许跟着环境变。来源:原论文 Fig. 1。
图 1 是机制示意图,说明作者希望模型学习什么。误差比较在后面的合成实验和县内通勤表里。
选择势从哪些空间条件里来?
模型先把输入整理成暴露,再把暴露送进几条与经典空间交互对应的通道。起点、终点和成对协变量各自经过多层感知机。真实通勤实验的成对变量是路网距离和空间邻接。合成实验使用设计好的阻抗。
沿途替代由秩前缀层计算:同一起点的其他目的地按阻抗做软比较,阻抗更小的目的地,对当前目的地的沿途机会贡献更大。局部竞争或集聚由目的地周围的机会按距离指数核加权。起点自己的特征再生成一组有界门控,用来调节收益、阻抗、沿途暴露和局部场的强弱。未中心化的选择分数因此是这几项的加减,再加上一个剩余的起终点交互。
单调性以软惩罚进入训练:阻抗或沿途暴露上升时,对应通道的惩罚方向应使效用下降;机会上升时,收益通道应使效用上升。惩罚只鼓励这个方向,文中没有报告训练后每条通道的导数是否处处满足。
规模支路只看起点特征和选择分数的汇总,并且停止梯度,使规模损失不回去改选择势。人数校准损失使用已经断开的份额,避免为了凑总人数而改写分配。训练时在见过的环境里优化最差的分配 KL,并惩罚各环境风险的方差;挑选模型时看留出环境上的分配风险。留一环境是这种选择的特例。
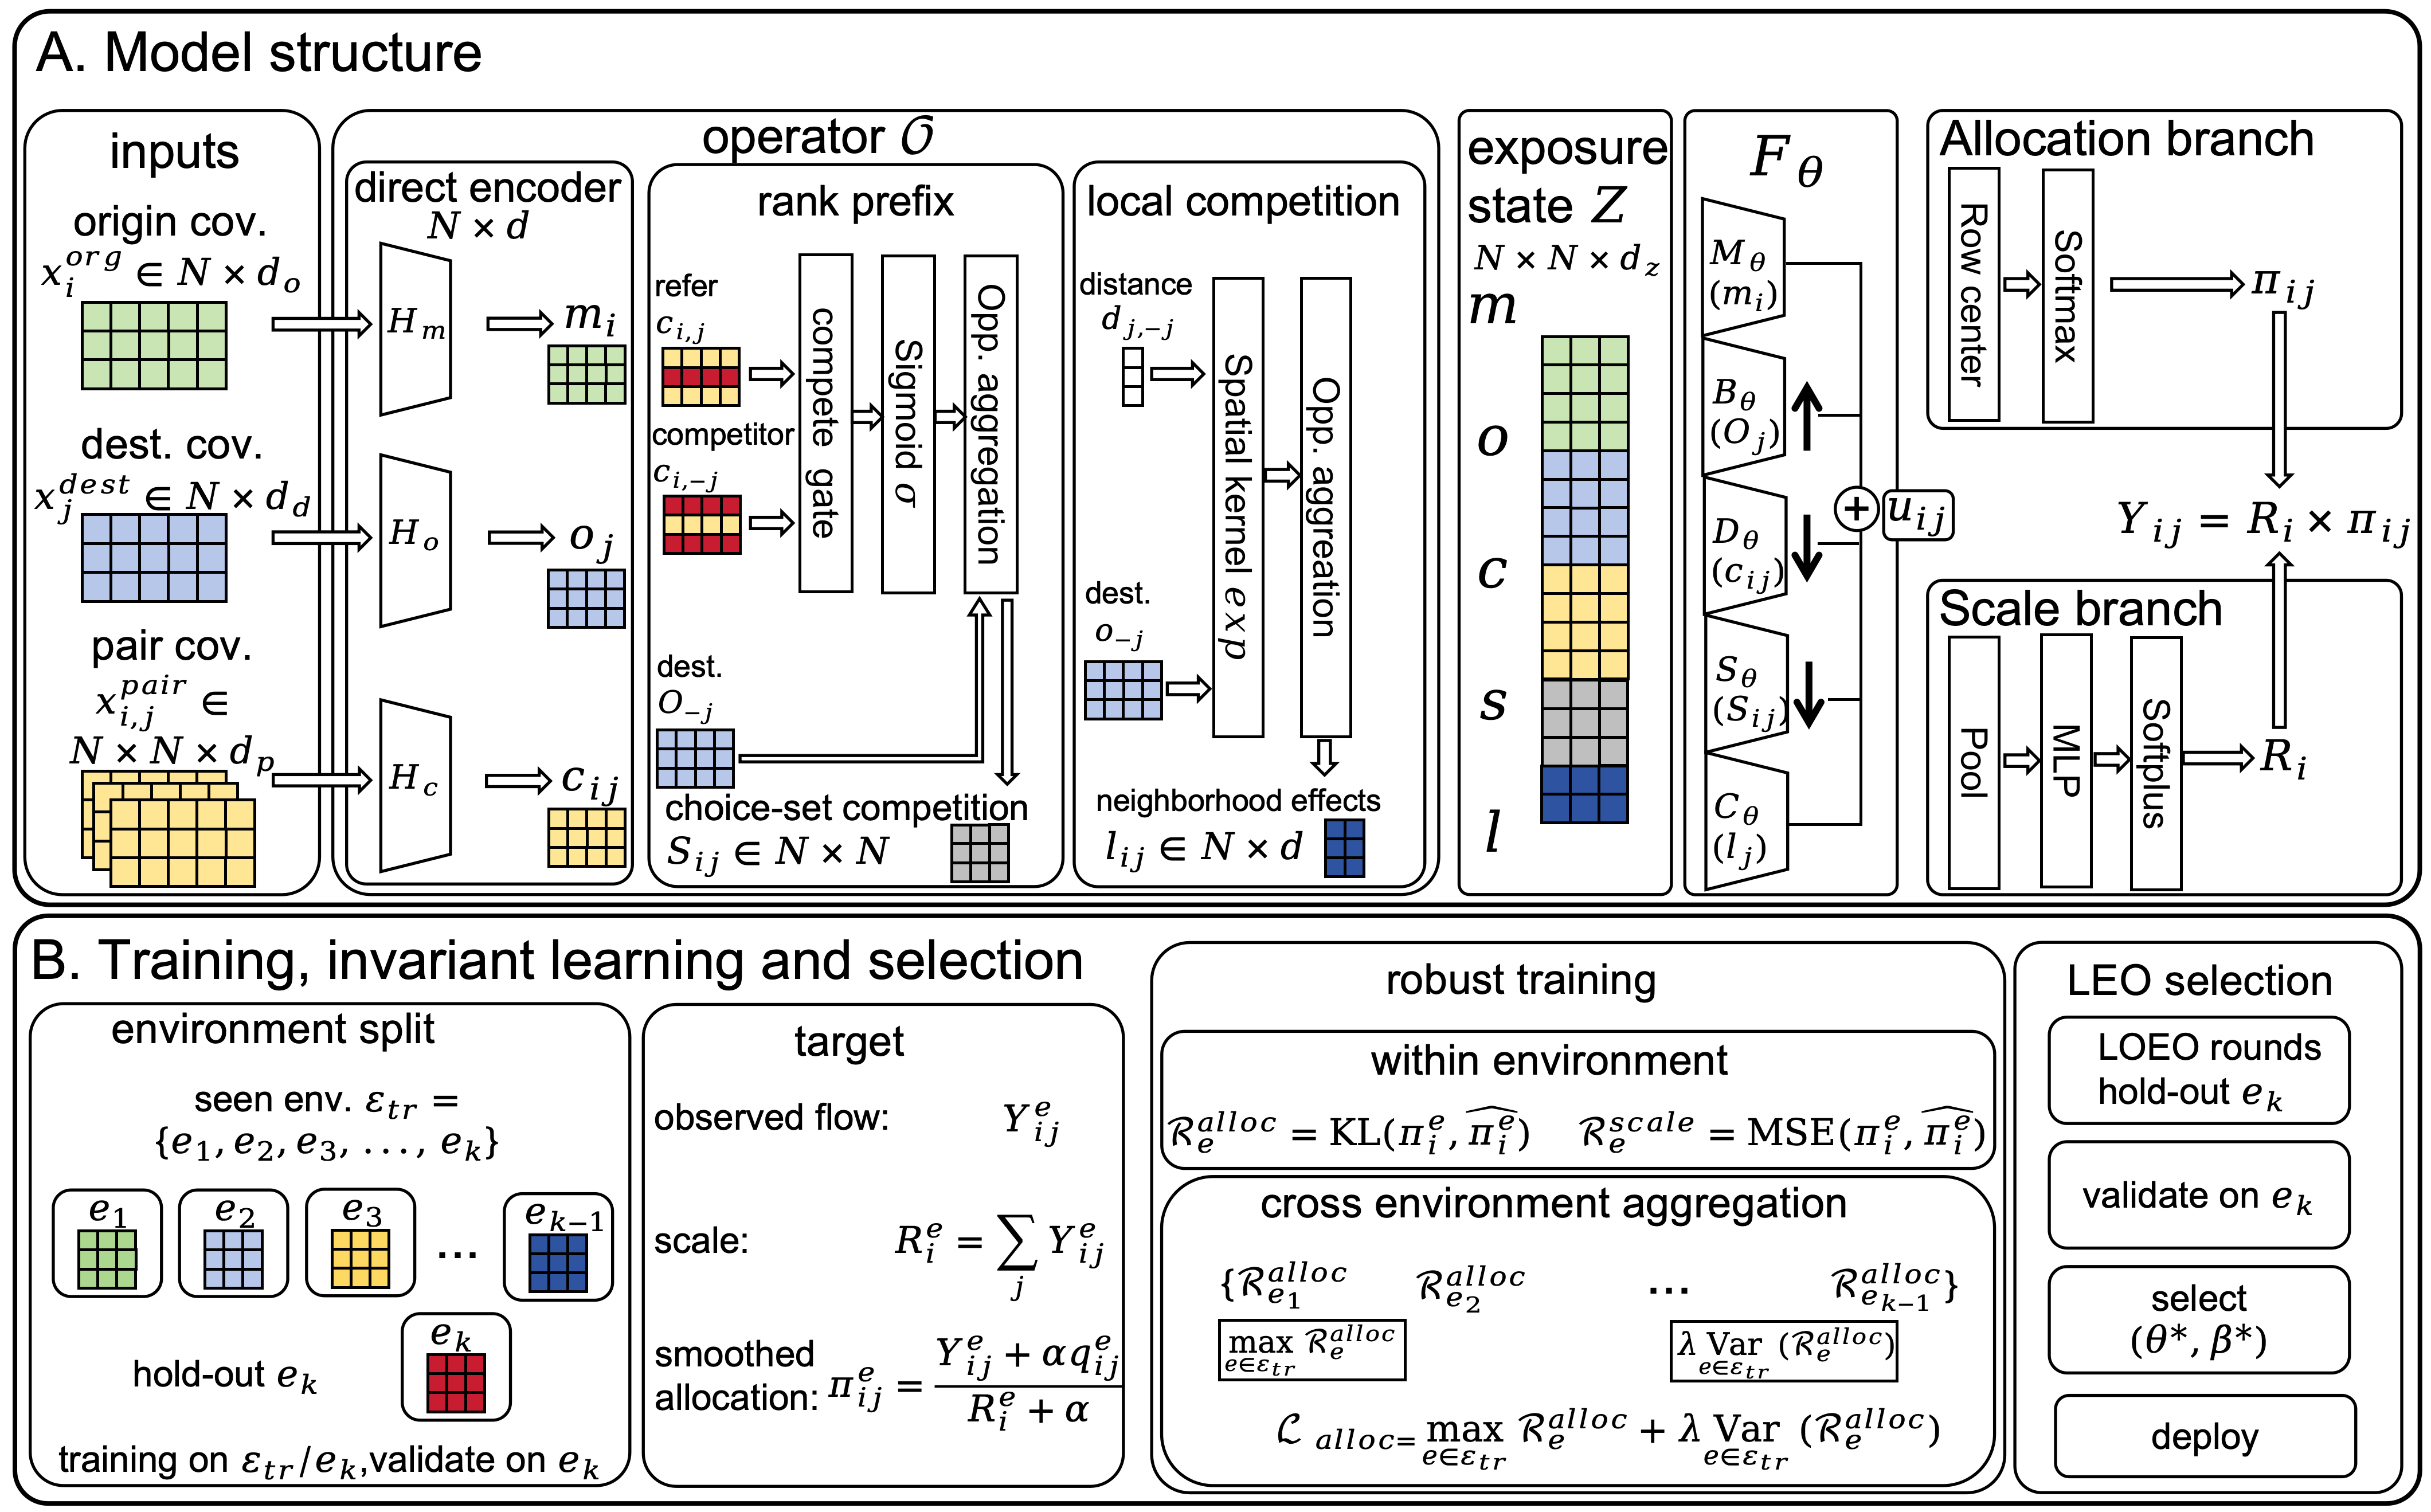
图 2|流量被拆开之后,网络的哪一支负责份额、哪一支负责规模?
(A)输入分成起点、终点和成对协变量;暴露算子包含直接编码、秩前缀和局部竞争,再进入收益、阻抗、沿途和局部场几条通道。分配支路做行中心化和 softmax,规模支路单独得到起点产出,二者相乘还原流量。(B)环境被分成已见与留出;分配目标由观测流量平滑后得到。训练取各环境最差的分配风险并加入方差惩罚,最后按留出环境上的分配风险选择并部署。来源:原论文 Fig. 2。
经典模型在这套写法里是对数势的受限情形。限制通道的函数形式之后,温度缩放前的对数势变成表 1 里的式子。引力模型是目的地机会的对数减去阻抗;竞争目的地模型再加一项局部场;介入机会模型让自身机会提高强度、沿途机会降低强度;辐射模型同时依赖目的地机会、起点侧机会和沿途累积机会。这些式子说明,限制通道的函数之后,OpFlow 的对数势可以退回经典模型。美国通勤上谁的误差更低,由表 2 给出。
| 模型 | 被限制后的对数势 |
|---|---|
| 引力 | α log(目的地机会) − β × 阻抗 |
| 竞争目的地 | 引力式再加 γ × 局部场 |
| 介入机会 | log(1 − exp(−η × 目的地机会)) − η × 沿途暴露 |
| 辐射 | log(目的地机会) − log(起点侧机会 + 沿途) − log(起点侧机会 + 沿途 + 目的地机会) |
规模、机会和相关被故意打乱后,谁还稳?
合成系统把 80 个空间单元放在边长为 1 的正方形上。每个起点只连接距离最近的 Kᵢ 个目的地,论文写作 Kᵢ ∼ N(25, 5),没有说明 5 是标准差还是方差。每个随机种子生成 14 个环境,8 个训练、2 个验证、4 个测试。环境共用空间骨架,机会场、规模、分配和计数不同。机会场来自高斯混合。计数按泊松分布抽取,均值等于规模乘以真实份额,因此一次观测人数同时受规模和分配影响。模型看到的是这些量的噪声代理,需要自己把暴露重建出来。
指标分三层。分配用按行计算的 KL 和 CPC。机制恢复用选择势的均方误差。人数用 RMSE 和 MAE。正文写明全部指标是 30 个种子的平均,并带 95% 置信区间,完整数值在附录。这份论文的附录给出了公式和基线分组,没有列出势误差、RMSE 和 MAE 的数值表,所以下面只讨论正文写明、并能在图 4 里对上方向的 Row-KL。
Row-KL 的算法是:每个起点上,用真实分配(合成实验)或观测流量归一化后的份额(真实通勤)作为 π,用模型份额作为 π̂,计算 Σ π log(π/π̂),再对起点平均。分母是被评估的起点数。它惩罚份额比值,对很小的目的地概率敏感。Row-CPC 是每个起点上 Σ min(π, π̂),再对起点平均。两边都是概率时,它等于 1 减去一半的 L1 距离,表示重叠的概率质量。分母是起点。重叠的是行份额。
四组基线把监督目标和模型结构拆开。原始计数多层感知机直接拟合人数。配对分配模型用同一类网络去拟合行份额。规模感知模型把规模和分配分开预测,但没有结构化的暴露通道。固定份额基线假定各环境的去向比例不变。领域泛化方法接在配对分配模型上,报告验证集 KL 选出的最佳一个。经典模型在引力、介入机会和辐射中按验证集 Row-KL 选最佳。
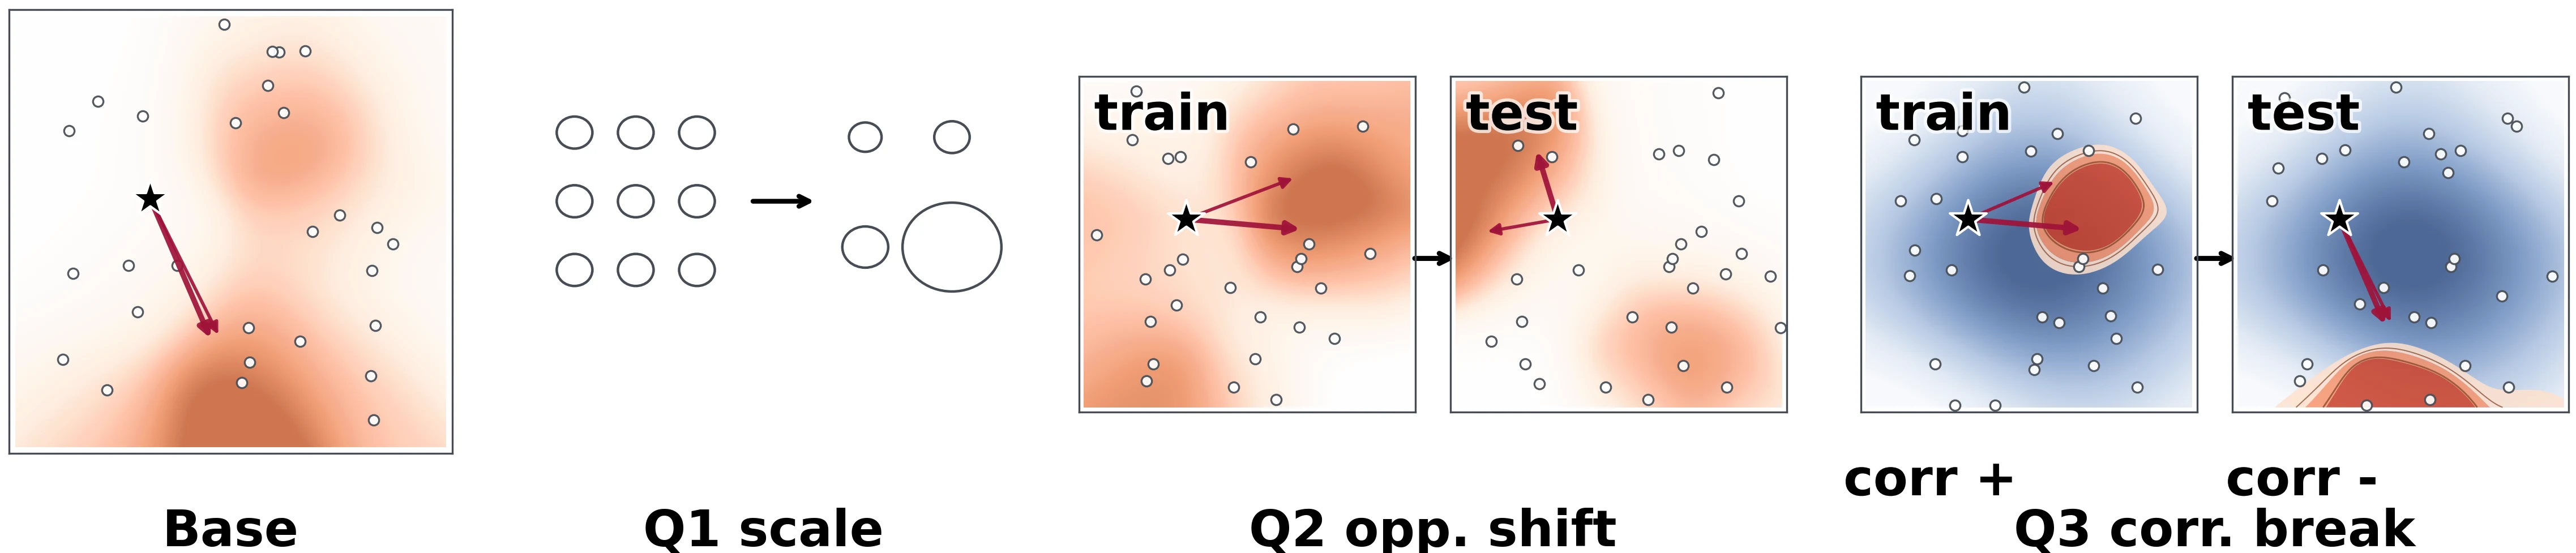
图 3|四类干预各自改动了生成过程的哪一部分?
无字母面板,从左到右为 Base、Q1 scale、Q2 opp. shift、Q3 corr. break。Base 是带机会热力的空间底图,星标和箭头表示一次出行的起终点。Q1 只把圆圈所代表的起点规模放大,空间机会场不动。Q2 的训练与测试使用不同的机会热力,箭头指向的目的地跟着改变。Q3 左侧机会与阻抗同向集中,右侧改成反向,用来拆开“机会吸引力”和“更近更好走”。部件消融的柱状结果在图 4(d),不在这张示意图里。来源:原论文 Fig. 3。
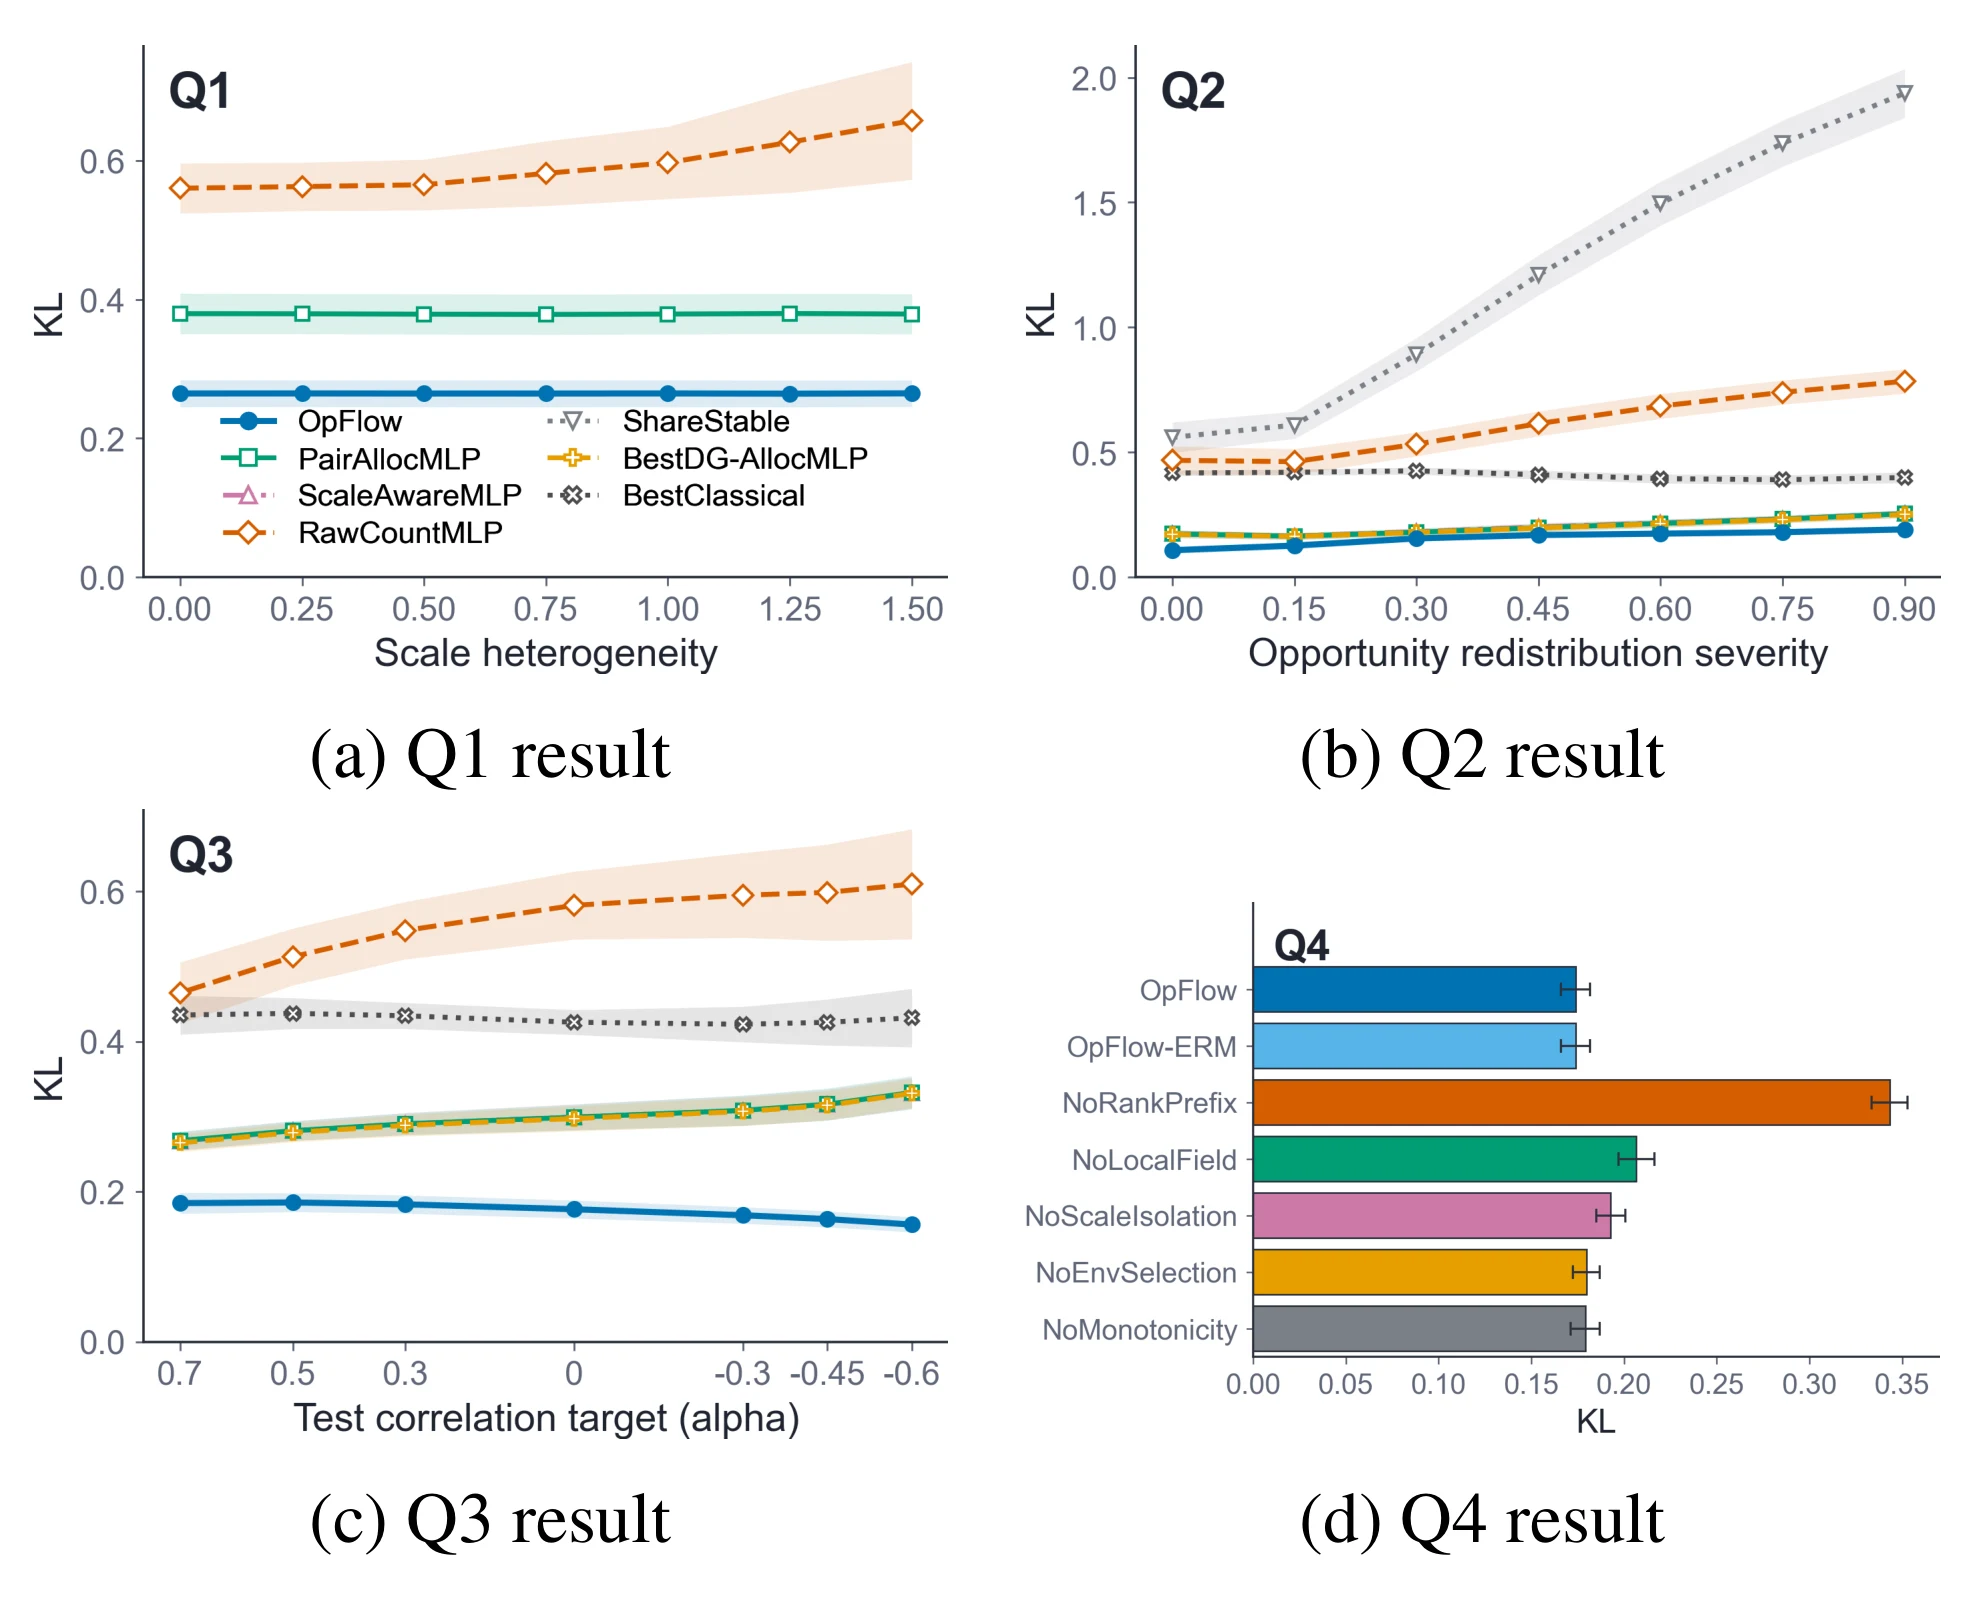
图 4|三种分布偏移和一次消融里,Row-KL 怎样变化?
纵轴都是 KL,越低越好。色带和误差线对应正文所说的 30 个种子与 95% 置信区间,图例本身没有再写一遍区间定义。(a)横轴是起点规模异质性,从 0 到 1.50。RawCountMLP 上升,OpFlow、PairAllocMLP 和 ScaleAwareMLP 基本平坦。正文没有给出这张面板的逐点 KL。(b)横轴是机会重分配的严重程度,刻度标到 0.90。OpFlow 在各档保持最低;最强一档相对 BestDG-AllocMLP 改进 23.7%,分母是该基线的 Row-KL。ShareStable 随严重程度上升。固定份额在新的机会场上对不上新的分配。(c)横轴是测试相关 α,从 0.7 到 −0.6。BestDG-AllocMLP 从 0.265 升到 0.331,OpFlow 在最强反转处为 0.156,相对降幅 52.9%,分母是 0.331。(d)柱状图比较完整模型和去掉单个部件后的 Row-KL,横轴画到 0.35。去掉秩前缀的柱最长。正文说消融做在 Q2 和 Q3 的压力端点上,图中没有分成两套柱,也没有印出每根柱的读数。来源:原论文 Fig. 4。
图 4(a)回答的是监督目标:规模差异变大时,直接拟合人数的 Row-KL 变差,单独监督份额的曲线基本保持平坦。图 4(b)里,真实分配随机会场改变。要看的是新机会场上的 Row-KL 是否仍然较低,曲线可以随严重程度缓缓上升。BestDG 相对它的领域泛化组件增益很小。作者把余下的差距归于 OpFlow 的机会条件结构。
图 4(c)把一件更容易混淆的事拆开。训练和验证都处在机会与可达性正相关的环境里,模型可以借用“近的地方机会也多”。测试把这个相关反转。OpFlow 的 Row-KL 在每个严重程度上都最低。这支持结构化通道有助于分开两项暴露,不支持模型已经识别出居民的真实偏好函数。
图 4(d)里,正文点名的承重部件是秩前缀:去掉沿途机会之后,机会重分配和相关反转两端的 Row-KL 都明显上升。局部机会场的作用较小,主要出现在相关反转的压力下。其余变体留在图中,正文没有逐一给出数值。
换一个美国县,县内通勤还能分对吗?
真实数据来自 Rong 等人 2025 年的大规模通勤出发地—目的地基准,覆盖美国 3,333 个县级单元。每个县再分成多个人口普查区块,通勤发生在区块之间。实验只保留县内通勤,一个县就是一个环境。表 2 比较的是换县之后的县内去向。跨县通勤留在这个实验之外。
每个县构造一张 OD 矩阵。起点和终点的协变量是按年龄、性别、收入、教育描述的人口结构,以及各类兴趣点数量。成对协变量是路网距离和空间邻接。本文没有写这套通勤流的调查年份、区块与人口属性如何对齐,也没有写兴趣点的分类清单。
三种划分都把县当作环境。RandSP 随机划分训练、验证和测试,作为分布内式的参照。GeoSP 每次留出一个普查大区,用其余大区的县训练,检查地理上的分布外。OppSP 按输入侧机会集中度留下不典型的县:对每个县计算归一化赫芬达尔式分数,分子是各单元机会份额的平方和减去 1/n,分母是 1 − 1/n,n 是该县的 tract 数。低尾和高尾县用于测试,分别对应机会异常分散和异常集中。数据集叙述写的是人口普查区块,集中度公式写的是 tract 数。论文没有说明两套空间单元是否相同,也没有给出尾部的百分位切点。OppSP 检验的是作者定义的输入侧集中度尾部。
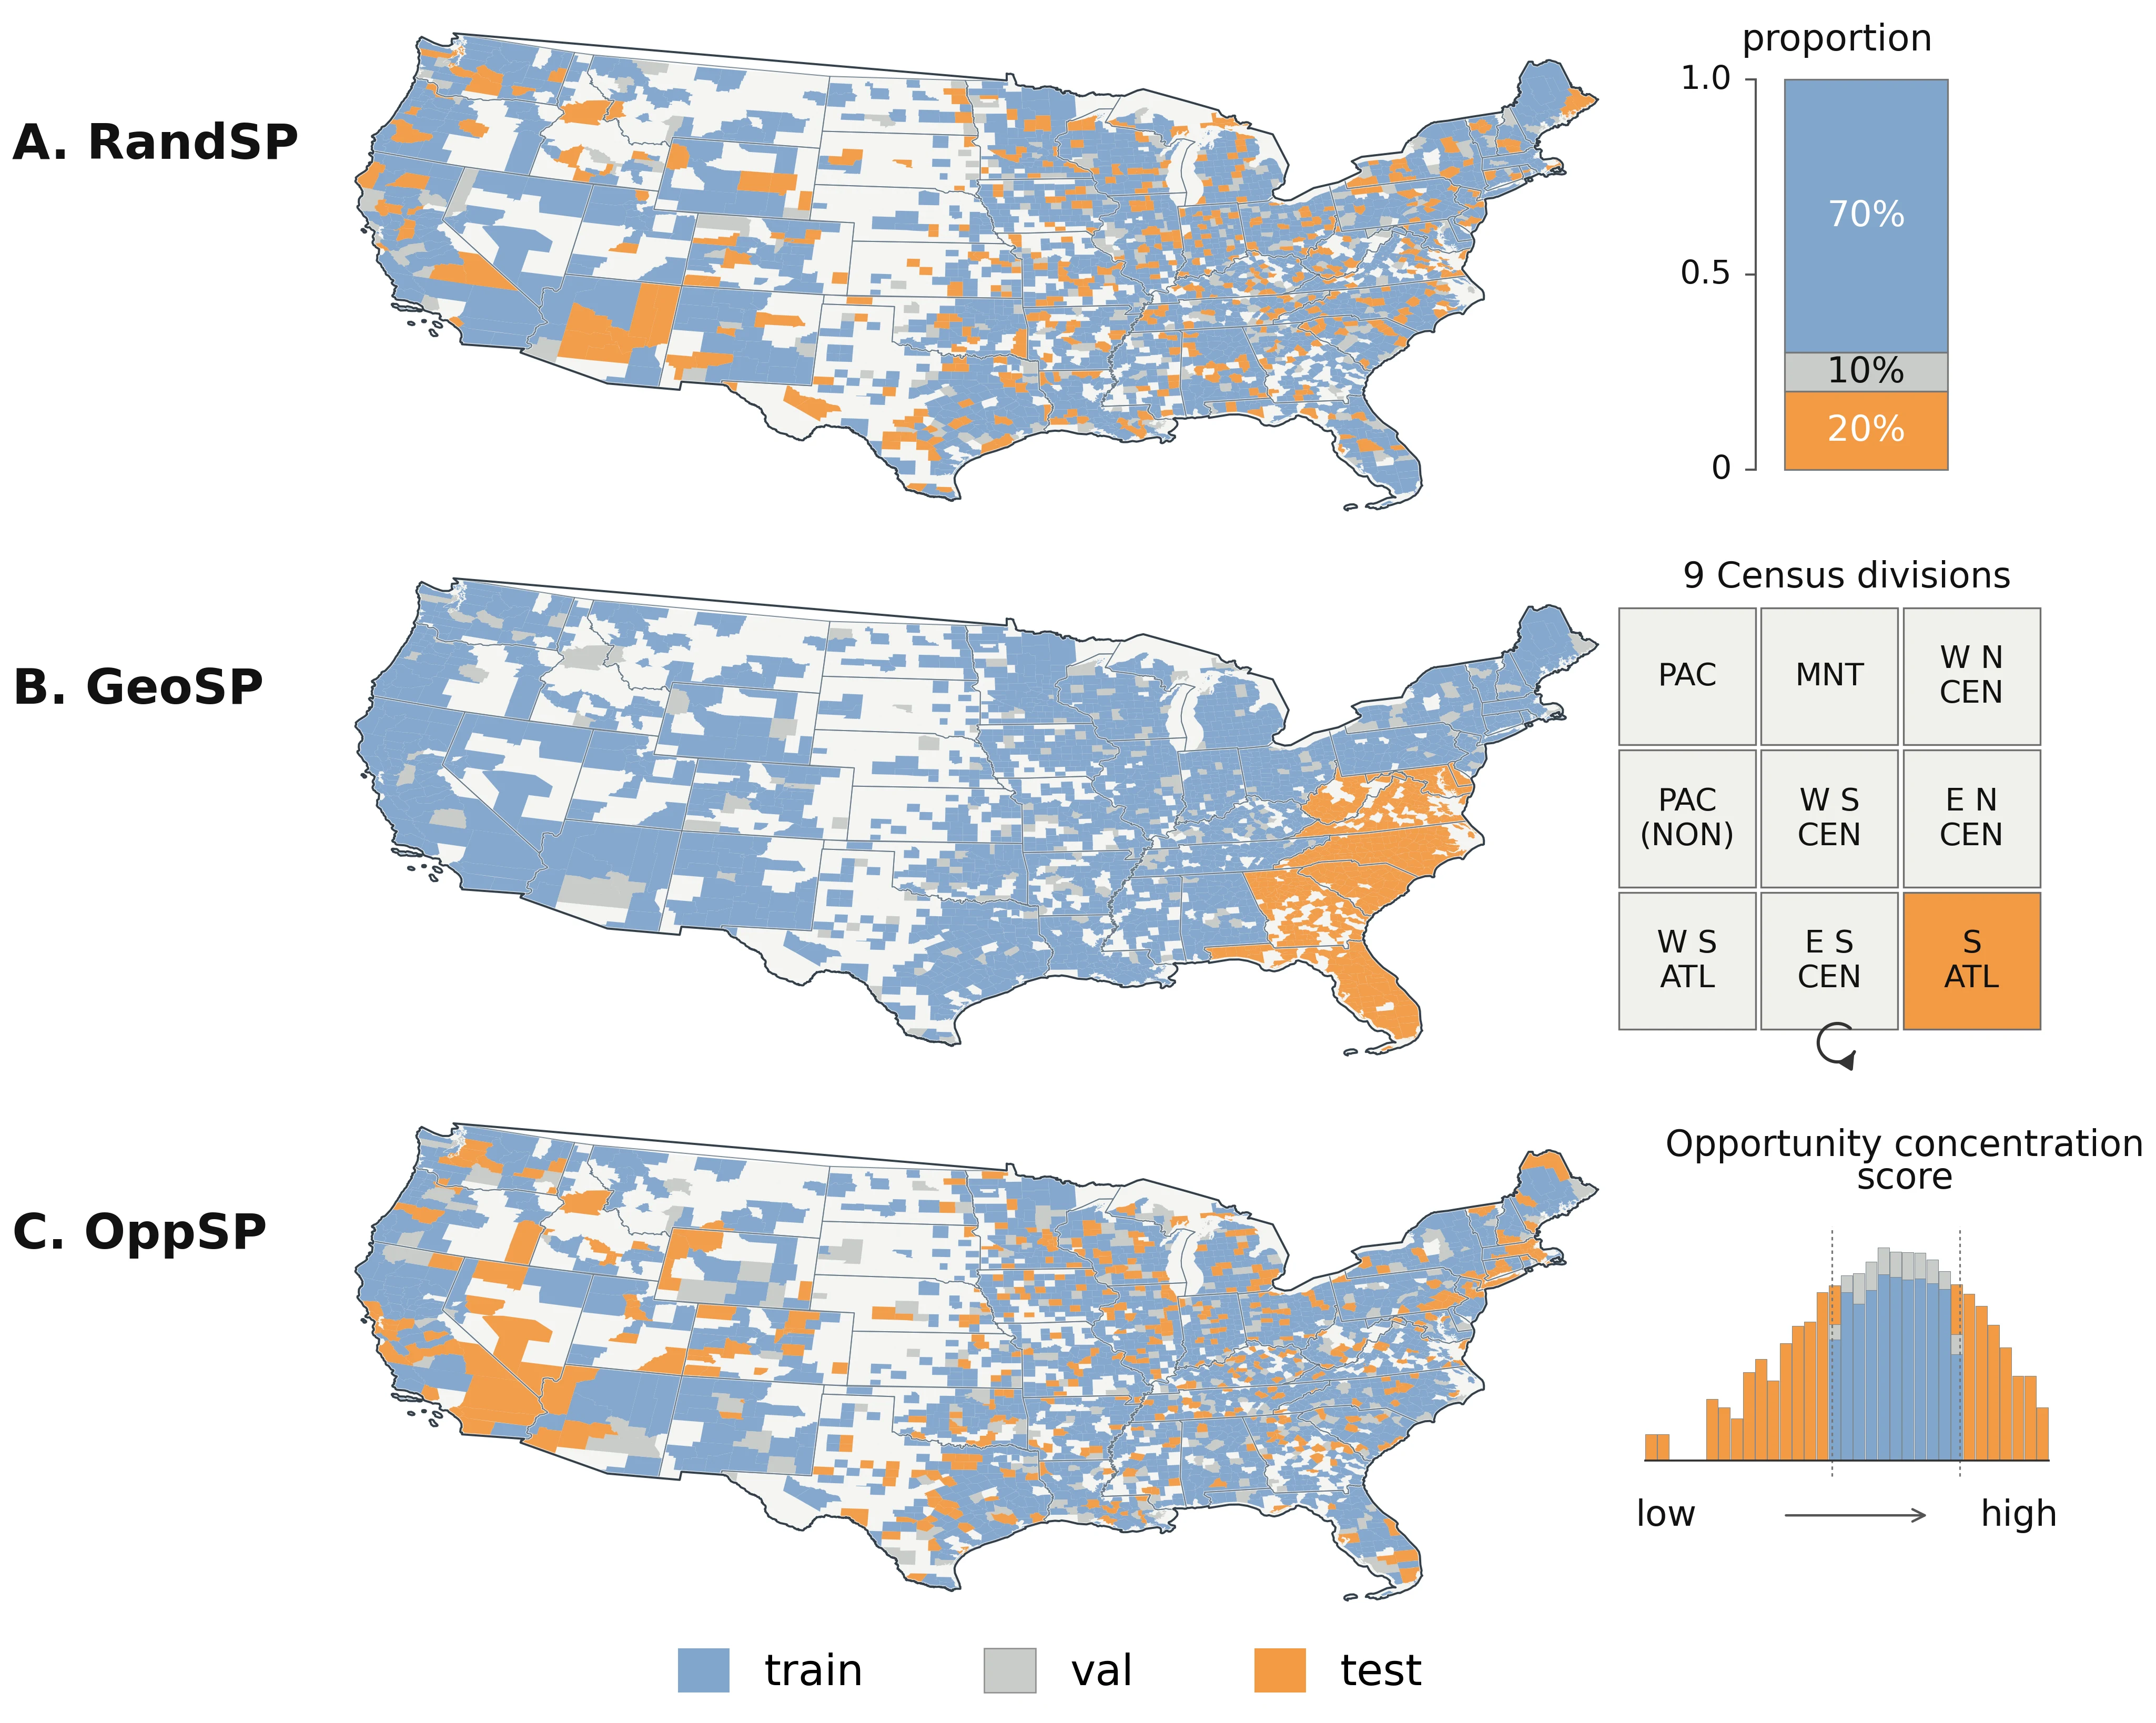
图 5|三个县集合是怎样划开的?
蓝色为训练,灰色为验证,橙色为测试。(A)RandSP 的比例条写明训练 70%、验证 10%、测试 20%,县在地图上交错分布。(B)GeoSP 的九宫格列出 PAC、MNT、W N CEN、PAC (NON)、W S CEN、E N CEN、W S ATL、E S CEN 和 S ATL;橙色的 S ATL 是图中展示的那一次留出,弯箭头表示大区轮换。正文的协议是每次留出一个普查大区,这张地图展示其中一次。(C)机会集中度从低到高排列,两端橙色、中间蓝色,阈值附近有灰色柱。正文只规定低尾和高尾用于测试。来源:原论文 Fig. 5。
真实通勤的分配指标仍按行计算。计数预测会先按行归一化,再和观测流量的行份额比较。Log-RMSE 则回到人数:对每个被评估的 OD 对,计算 log(1 + 预测) 与 log(1 + 观测计数) 的差,再取均方根,分母是 OD 对个数。对数压缩的是长尾人数。RandSP 上 OpFlow 的 1.088,是这些对数差的均方根。
表 2 的每一格都是 Row-KL/Row-CPC/Log-RMSE。KL 和 Log-RMSE 越低越好,CPC 越高越好。表中的 Avg. 是论文报告的汇总,没有写权重。Pair 三行的 Row-KL 为 0.399、0.392、0.468,简单平均约 0.420,表内 Avg. 却是 0.413。后文的“平均”都指表内 Avg.,不把它当成三行的算术平均。
| 划分 | 引力 | 介入机会 | 辐射 | 随机森林 | 梯度提升 | GM | Pair | Scale |
|---|---|---|---|---|---|---|---|---|
| RandSP | 0.545/0.613/1.468 | 8.590/0.260/3.132 | 0.999/0.538/1.582 | 1.364/0.420/2.129 | 0.810/0.521/1.655 | 2.842/0.426/2.414 | 0.399/0.684/1.222 | 0.438/0.676/1.193 |
| GeoSP | 0.575/0.604/1.419 | 8.729/0.252/3.060 | 1.088/0.524/1.540 | 1.235/0.440/2.028 | 0.775/0.532/1.634 | 2.850/0.414/2.486 | 0.392/0.684/1.201 | 0.407/0.672/1.180 |
| OppSP | 0.692/0.571/1.336 | 8.747/0.248/2.826 | 1.487/0.480/1.534 | 0.961/0.495/1.743 | 0.781/0.537/1.663 | 2.929/0.395/2.612 | 0.468/0.682/1.257 | 0.481/0.693/1.222 |
| Avg. | 0.604/0.596/1.408 | 8.689/0.253/3.006 | 1.191/0.514/1.552 | 1.186/0.452/1.967 | 0.789/0.530/1.651 | 2.874/0.412/2.504 | 0.413/0.684/1.220 | 0.441/0.685/1.201 |
| 划分 | DGM | NetGAN | DiffODGen | WeDAN | GMEL | OpFlow |
|---|---|---|---|---|---|---|
| RandSP | 0.656/0.545/4.337 | 0.595/0.615/1.470 | 0.676/0.611/1.623 | 0.645/0.609/1.629 | 0.435/0.674/1.299 | 0.322/0.710/1.088 |
| GeoSP | 0.712/0.530/4.447 | 0.749/0.572/1.652 | 0.761/0.579/1.705 | 0.711/0.582/1.689 | 0.514/0.655/1.322 | 0.370/0.686/1.14 |
| OppSP | 0.792/0.510/4.631 | 0.800/0.578/1.498 | 0.711/0.592/1.416 | 0.740/0.589/1.443 | 0.558/0.635/1.386 | 0.438/0.670/1.04 |
| Avg. | 0.720/0.529/4.472 | 0.715/0.588/1.540 | 0.716/0.594/1.581 | 0.699/0.593/1.587 | 0.502/0.655/1.336 | 0.377/0.688/1.09 |
GM 在表中归入通用机器学习,论文没有写出全称。深度与图模型一列使用表中的缩写,其中平均表现最好的是 GMEL:0.502/0.655/1.336,仍高于 OpFlow 的 0.377/0.688/1.09。DGM 的平均 Log-RMSE 为 4.472,人数误差在这列里最大。
和正文的概括对一下。OpFlow 的平均 Row-KL 是 0.377。表 2 里 Pair 的平均 Row-KL 是 0.413,Scale 的平均 Log-RMSE 是 1.201;正文写成从 PairMLP 的 0.410 降到 0.377,并从 ScaleMLP 的 1.20 降到 1.09。0.377 和 1.09 两处一致,基线的 0.410 与表内 0.413 相差 0.003。逐格比较时以表 2 为准。
分划分看,随机参照上 OpFlow 为 0.322/0.710/1.088,Pair 为 0.399/0.684/1.222。地理留出上 OpFlow 的 Row-KL 为 0.370,Pair 为 0.392,差距 0.022;Row-CPC 为 0.686 对 0.684。机会结构留出上,OpFlow 的 Row-KL 为 0.438、Log-RMSE 为 1.04,Scale 为 0.481 和 1.222,但 Scale 的 Row-CPC 为 0.693,Pair 为 0.682,都高于 OpFlow 的 0.670。平均 CPC 的优势也很小:OpFlow 0.688,Scale 0.685,Pair 0.684。
经典模型里引力最强,平均 0.604/0.596/1.408,仍高于 OpFlow 的三项误差中的前两项,CPC 也更低。介入机会模型的平均 Row-KL 为 8.689,CPC 为 0.253。这是该受限形式在这个县内通勤基准上的误差。表 1 仍把它保留为对数势的一个特例。
作者的解读是:分配监督和规模意识都有用,Pair 与 Scale 已是最近的对手;只加上这两点,仍缺少可迁移的暴露到选择势映射。深度与图模型能表达更丰富的 OD 依赖,GMEL 在该族中最强,但没有显式分开规模和分配。GeoSP 与 OppSP 上的一致改进,被用来说明 OpFlow 学到的不只是某个县的流量量级。改进的幅度并不均匀:地理划分上的 Row-KL 只比 Pair 低 0.022,机会结构划分上的 CPC 排序还反过来。
这些比较停在哪里?
合成实验的生成式就是论文自己的强度公式加上漂移,OpFlow 的网络又按同一套通道搭建。它能在这套生成过程里恢复较低的 Row-KL,说明结构对上了设计出来的机制。换一套论文没有生成的行为规则,这个优势是否还在,实验没有回答。
真实通勤实验比较的是换县。县内区块之间的流量、路网距离、人口结构和兴趣点计数,都来自同一类美国县级环境。跨县通勤、一天之内的动态流量,以及票价或远程办公改变同样阻抗下的反应,都留在表 2 之外。论文把分布外的分配误差分成两块,再把人数误差接上规模。第一块是训练分配 KL 乘以暴露覆盖比 ρ 之后开方,第二块是暴露解释不了的结构漂移;人数误差再叠加规模预测的绝对误差。美国实验没有估计 ρ 和漂移的大小。这个界说明误差由哪几块组成。
Row-KL、Row-CPC 和 Log-RMSE 分别衡量份额比值、份额重叠和对数人数。OppSP 上 OpFlow 的 KL 和对数人数更好,Scale 的份额重叠更高。更在意主要目的地是否重叠时,表 2 里 Scale 的 OppSP Row-CPC 排在 OpFlow 前面。模型输出是期望流量和份额。
一句话总结
起点发出多少通勤,和这些通勤在目的地之间怎么分,可以分开学习和标定;在论文设置的合成偏移和美国县内通勤划分里,这样得到的选择势映射降低了行 KL 和对数人数误差,但份额重叠并不在每一套划分上都领先。
核心来源
- arXiv:2607.03200,2026年7月3日预印本 v1。题目、作者、图 1 至图 5 和表 2 均按该版本核对。
- Rong、Ding、Liu 与 Li,2025,A Large-scale Dataset and Benchmark for Commuting Origin-Destination Flow Generation,The Thirteenth International Conference on Learning Representations。本文的美国县内通勤基准引用这一数据集;调查年份与清洗规则不在 OpFlow 正文中。
- 经典对照来自本文表 1 与附录中的受限对数势:引力、竞争目的地、介入机会和辐射。
作者介绍
- Changjian Liu(刘昌健):第一作者,论文署名为北京大学地球与空间科学学院。个人主页写明他是该校遥感与地理信息系统研究所时空大数据方向的硕士研究生,导师为高勇。2024 年他以第一作者在 International Journal of Digital Earth 发表轨迹语义与出行流论文,OpFlow 的参考文献收录了该文。
- Yong Gao(高勇):通讯作者。北京大学地球与空间科学学院遥感与地理信息系统研究所副教授,研究所页面列出的方向为空间数据挖掘。他参与过基于社交媒体签到的城际出行与空间交互研究。
- Yuqing Wang、Leyi Su、Zhiyang Wang、Xiaoyu Wang:论文均署名为北京大学地球与空间科学学院。本文没有提供可与本人对应的职务简介。
- Honglei Guo:论文署名为浙江大学人工智能学院。2024 年那篇轨迹语义论文的作者中有同名的 Honglei Guo,该文单位为中国地质大学(北京)信息工程学院。
- Fan Zhang(张帆):论文署名为北京大学地球与空间科学学院。该校遥感与地理信息系统研究所的张帆为助理教授,页面所列方向包括地理空间人工智能与城市数据科学。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个县的岗位分布变了,按这篇论文的分解,可以先更新机会和路网暴露,用原有的选择势映射得到新份额,再乘以重新估计的起点规模。这是一张可计算的更新清单,论文没有做真实的岗位搬迁或新开线路实验。一旦改变的是同样阻抗下的反应,例如票价或远程办公,假设里的结构漂移会变大,沿用旧映射就缺少依据。
另一项直接可见的选择是损失本身。OppSP 上 ScaleMLP 的 Row-CPC 为 0.693,OpFlow 为 0.670,而 OpFlow 的 Row-KL 是 0.438、Log-RMSE 是 1.04,Scale 为 0.481 和 1.222。更在意主要目的地是否重叠的人,和更在意对数人数或小概率比值的人,会从同一张表选出不同模型。部署之前需要先写明要比较的是哪一个分数。
县界也限定了能搬走的规律。模型学的是县内单元之间的通勤。把这条映射用于跨出县界的都市圈通勤,环境不再是“另一个县的内部”,而是另一张空间关系。那一次检验还没有出现在表 2 里。