设备只在走近时才传得了数据,人的移动规律能写到哪一步?
论文名片|Poria Pirozmand、Guowei Wu、Behrouz Jedari、Feng Xia,Human mobility in opportunistic networks: Characteristics, models and prediction methods,Journal of Network and Computer Applications,2014,42:45–58。DOI:10.1016/j.jnca.2014.03.007。2013年12月30日收稿,2014年3月12日接收,2014年3月30日在线发表。本文依据这一正式综述解读。
在迈阿密的 Infocom 2005 会场,参与者携带的 41 台内部设备用了 4 天。综述的表 1 记下 22,459 次内部接触,另外看见 264 台外部设备、1,173 次外部接触。机会网络(opportunistic networks,OppNets)靠的就是这种短距离、时断时续的见面:手机或平板通过蓝牙或 Wi-Fi,在彼此进入无线电范围时交换数据。人把设备带在身上,设备怎么移动,就跟着主人的日程走。
早期移动自组织网络常用随机路点(random way point,RWP)或布朗运动来生成合成轨迹,再拿去测试协议。这篇综述指出,人类移动很少是这种无目的扩散,随机模型因此很难准确评估依赖见面的协议。与此同时,出行距离这种基本分布在已有文献里也没有统一结论。文章本身不做新的追踪实验,而是把问题分成三组:移动有哪些可测量的特征,真实记录和仿真模型各自能代表什么,以及下一段路程、停留时间和接触机会能预测到什么程度。
能从文献里反复读到的是结构:短途多、长途少,返回带有大约一昼夜的峰值,接触间隔在“每一对设备”和“所有对混在一起”之间差别很大。能直接套到所有场景的单一参数则很少。下面的指数、天数和准确率,都要连着样本、分母,以及综述里实际印出的公式一起看。
先说结论
- 空间上,多篇被引研究用截断幂律描述位移。Gonzalez 等在综述中的印刷形式给出 β=1.75±0.15、距离阈值 1.5 km;Noulas 等的 Foursquare 位移分布给出 β=1.50、阈值 2.87,原句没有写单位。回转半径分布的参数是 5.8 km、β=1.65±0.15、截断尺度 350 km。
- 时间上,Gonzalez 等的讨论里,人出现在第 R 常去地点的概率近似按 R 的 −1 次方下降,返回概率在 24、48、72 小时出现峰值。Song 等的停留时间指数为 β=0.8±0.1,截断约 17 小时。
- 连接上,Gao 等对 MIT Reality Mining 的分析里,指数分布拟合超过 85% 的个体节点对接触间隔;把所有节点对混成一条汇集曲线,在接触模式不同的网络里经常代表不了每一对。
- 表 1 列出 18 条蓝牙或 Wi-Fi 公开记录,时长从会场上的数天到 1,095 天,设备数从个位数到 100,000。表 2 用 12 项性质给 15 个仿真模型打勾,勾得最多的是 8 项,没有模型 12 项全有。
- 预测百分比回答的不是同一个问题。Dartmouth 上超过 6,000 名用户的最佳地点预测器大约 65%–72%;Lu 等对 500,000 人的手机记录给出理论上限 88%,以及平稳轨迹 87%、非平稳轨迹 95% 的马尔可夫准确率。综述开头另把 93% 和 95% 分别归于 Lu 等与 Song 等,两处表述需要分开读。
随机游走留不下会议里的日程,一条幂律也盖不住所有城市
机会网络里没有一条事先接通的端到端路径。两台设备只有进入彼此的无线电范围,才出现一次接触(contact)。人是设备的携带者,所以协议评估需要的轨迹,最好带有真实的地点偏好、停留和社会关系。Camp 等、Musolesi 与 Mascolo、Aschenbruck 等、Karamshuk 等、Munjal 等已经分别整理过随机模型、真实痕迹、仿真或可预测性。这篇综述认为,特征、模型和预测还没有被放进同一套分类。
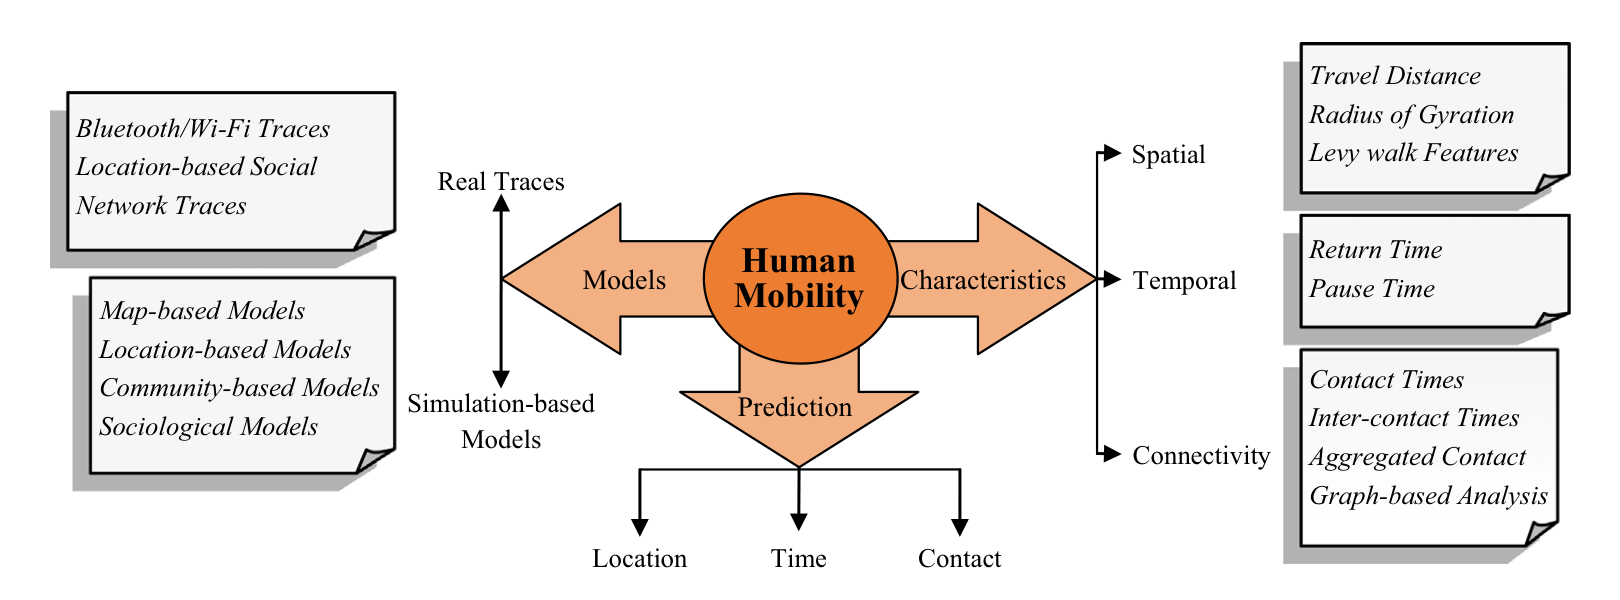
图 1|人类移动被拆成哪三组问题?
图中没有子图字母。中间圆是人类移动。向右是特征:空间下列出行距离、回转半径和莱维游走特征;时间下列返回时间和停留时间;连接下列接触时长、接触间隔、汇集接触和图分析。向左是模型:真实记录分成蓝牙/Wi-Fi 痕迹和基于位置的社交网络痕迹;仿真分成地图、地点、社区和社会学四类。向下是预测,分成地点、时间和接触。来源:原论文 Fig. 1。
这张图是分类地图,不包含新的测量。它说明后文为什么不断在三个问题之间来回:先看一条轨迹在空间和时间上长什么样,再看一份记录或一个仿真有没有把这些性质写进去,最后才谈能否预测下一次地点、停留或见面。
走了多远,和活动范围有多大,要分开算
出行距离或跳跃长度(travel distance,jump size,Δr)量的是人在空间里跨过的路程。综述把用户 l 在一段时间(例子是一小时)内的出行距离定义成相邻位置距离之和:
Δr(l) = Σ(从 i=2 到 n)|rᵢ − rᵢ₋₁|
这里 r₁ 到 rₙ 是该时段的位置序列。求和从第二个点算起,公式里没有再除以段数 n,也没有除以这一个小时。后文讨论的是这个路程以及全体用户的路程分布。一次路程可以只有几公里,也可以到几千公里。走得远的人会把相隔很远的人群连起来,因此路程分布会影响消息能传多远;交通方式、工作和家庭安排都会改变它。
一部分文献把全体用户的位移概率近似成截断幂律(truncated power-law):P(Δr) ∼ Δr 的 −(1+β) 次方,位移指数满足 0<β≤2。幂律的意思是一个量随另一个量的某次方变化;截断幂律则是先按幂律走一段,之后被指数衰减截住。综述用它对应一种日常经验:多数移动很短,偶尔才有很长的行程。
Gonzalez 等(2008)在综述里被写成带指数截断的形式:
P(Δr) ∼ (Δr + Δr₀) 的 −β 次方,再乘 exp(Δr/κ)
其中 β=1.75±0.15,这里的 ± 是均值和标准差;阈值 Δr₀=1.5 km;κ 是随实验变化的截断尺度。幂次上印有负号。exp 括号里按原文印成 Δr/κ,前面没有再印一个负号;同一句仍把它称为指数截断。
这些手机研究容易让人以为存在一条普适幂律。Isaacman 等对洛杉矶和纽约数十万部手机的分析却显示,两座城市的特征行程长度并不一样。综述没有在这里写出两个长度的具体公里数,并由此提出两种可能:要么人类移动没有普适形式,要么物理距离本身不适合作为唯一变量。
Noulas 等(2012)改用 Foursquare 上许多城市的签到。位移分布近似幂律,指数 β=1.50,阈值 Δr₀=2.87,原句没有标注单位。综述认为这个指数与 Brockmann 等、Gonzalez 等算出的指数几乎相同。Gonzalez 等在上一公式里的指数是 1.75±0.15。1.50 和 1.75±0.15 都出现在综述原文里。
回转半径(radius of gyration,r_g)把一段时间里的整条轨迹收成一个数,表示活动范围相对质心展开了多大。综述按 Lu 等(2013)写成:
r_g(l) = √[ (1/n) Σ(i=1 到 n)|rᵢ − r̄|² ],r̄ = (1/n) Σᵢ rᵢ
r̄ 是轨迹质心。根号内除以点数 n,所以它是各点离开质心的典型距离。人在一块有界区域里来回折返时,求和得到的路程可以很长,回转半径仍然小;若一小步一小步朝固定方向走,回转半径可以更大。
r_g 的概率分布同样被近似成截断幂律:
P(r_g) = (r_g + r_g⁰) 的 −β 次方,再乘 exp(r_g/κ)
参数为 r_g⁰=5.8 km,β=1.65±0.15,κ=350 km。指数部分的印刷方式与上面的位移公式相同。综述的读法是:多数人在住地附近活动,少数人经常做长途移动。
Bagrow 与 Lin(2012)把经常访问、彼此靠近的地点叫作栖息地(habitat),再只在每个栖息地内部计算缩小后的回转半径。三个栖息地的人群分布显示,栖息地的空间范围往往比总移动小一个数量级,多数用户的栖息地回转半径在 1 到 10 km。这是栖息地内部的尺度,分母不是一个人的全部出行距离。
莱维游走(Lévy walk)指步长分布拖着厚尾:大量短的直线段,偶尔一个不转弯、不停留的长直线段。Brockmann 等用纸币看到数千公里尺度上的类似形态;Gonzalez 等大约每 2 小时记录一次手机位置,空间分辨率约 2–3 km²,也看到厚尾飞行和超扩散的均方位移。这样的采样会漏掉两个采样点之间的短移动。机会网络的无线电范围往往只有几米、接触只有几秒,公里级、小时级的轨迹很难直接拿来做细仿真。
Injong 等(2011)把户外、10 km 以内的行走放到米和秒的尺度上,发现厚尾飞行,以及先超扩散、再在有限区域内转为次扩散。综述另有一句印刷:正常扩散的均方位移与 r 成正比;另一类与 r^γ 成正比,括号中为 γ<1,并称为超扩散,引用 Shlesinger 等(1982)。γ 的不等号按原文印刷,综述没有在这段重新推导。
人会按天回到熟悉的地方,停留却不是均匀抽一个数
一天里,人高概率、反复出现的地点通常只有少数几个,对应工作、学习和习惯。学生去学校、图书馆、体育馆,晚上回家,是综述用来说明这种重复的例子,不是一次新的校园普查。
返回时间(return time)是随机游走者过了 t 小时后,回到先前被观测位置的时间;相应概率叫首次通过时间概率。Gonzalez 等表明,一个人出现在其第 R 常去地点的概率近似为 R 的 −1 次方,与他一共去过多少个地点无关。返回概率在 24、48 和 72 小时出现峰值。峰值说明日程有昼夜重复;它不给出每个人每天返回的次数。
停留时间(pause time)是人停在一个位置、速度为零或接近零的时长。随机路点模型常从一段均匀区间里随机抽停留。Brockmann 等和 Gonzalez 等的真实轨迹则是厚尾:P(Δt) ∼ (Δt) 的 −(1+β) 次方,0<β≤1。Song 等(2010a)的例子是 β=0.8±0.1,截断 Δt=17 小时,综述认为这大致对应一个人清醒的时段。
自相似最小作用行走(self-similar least action walk,SLAW)是较早把停留写进模型的工作之一。每个访问点有自己的停留,全体停留服从截断幂律,平均停留被调整到整趟行程在 12 小时内完成。综述认为这种写法仍然人工:它主要按时间把行程切开,没有同时处理时间和空间的相关。Ribeiro 等后来用节点之间的社会吸引来生成停留,并以社区移动模型 CMM 为实验底子。这段没有给出新的停留指数。
两次见面隔多久,要先决定统计的是哪一对人
接触时长(contact time,CT)是两台设备处于彼此无线电范围内的时间,可以是一次蓝牙关联,也可以是同在一个接入点覆盖下的停留。接触越长,这次见面能交换的数据越多。接触间隔(inter-contact time,ICT)是同一对设备相邻两次接触之间过去的时间,用来表示它们多久能再见面。间隔短,这一对在观察期里见面更频繁;间隔长,两次见面离得更开。一次接触里能否传完数据,还要看接触时长。另有研究提出传输间隔,用来表示链路真正断开的时间;综述只点出这个指标,没有给出它的分布参数。
在 n 台设备的网络里,节点对的接触间隔分布最多有 n(n−1)/2 条。这是组合意义下的对数,不是接触次数。逐对分析很困难,因为有的对只观察到很少几次。
Chaintreau 等用 8 份真实数据强调接触间隔对机会网络的重要性,并给出理论结果:若个体节点对的接触间隔是厚尾,同质网络里朴素转发可能发散。Karagiannis 等重新分析同一批数据,认为接触间隔除了幂律,尾部还有指数截断。Conan 等发现节点对之间并不相同:相当一部分对用指数分布就拟合得好,另一些对更接近帕累托或对数正态。Gao 等分析 MIT Reality Mining 痕迹,指数分布拟合超过 85% 的个体节点对接触间隔。85% 的分母是这些节点对的间隔分布,综述没有在这句写出节点对总数。
汇集接触间隔把所有节点对的样本放进同一条分布。若干文献认为它呈带指数截断的幂律。Chaintreau 等曾把一组常用痕迹的汇集间隔近似成形状参数小于 1 的帕累托分布;Karagiannis 等再次分析后,认为尾部可能有指数截断。Passarella 与 Conti(2013)接着比较个体对和汇集分布:网络里各对的接触模式并不相同时,汇集分布在多数时候代表不了每一对,只看汇集曲线会把网络的关键性质看错。因此,一条看起来很干净的幂律,可能只是许多不同的对被混在一起之后的形状。
接触也可以收成有向或带权的接触图:方向表示接触顺序,权重表示次数或时长。社交图的节点是人,边可以来自接触频率、共同兴趣或地理偏好。随后才能做连通性、社区检测等社交网络分析。Yang 等用中心性和重叠社区构造移动模型;Yoneki 等用身体接近和重叠社区分析见面时间。Hossmann 等把真实痕迹画成带权接触图,综述转述其小世界性质和很强的模块性。Mayer 与 Waldhorst 用谱图方法比较合成痕迹和真实痕迹,认为图结构会强烈影响随机模型和社会模型中的接触间隔;他们使用的真实城市地图在结构上差别有限,不足以明显改变一个社会移动模型的接触间隔。这是对所考察地图的判断,综述没有把它写成所有城市的测量结果。
综述在这一节的收束是:地理和社会约束确实让移动带有结构,但出行距离和接触间隔的具体分布仍没有普遍一致的结论。一个重要原因是可靠的大尺度数据一直难获得。
公开的蓝牙和 Wi-Fi 记录,覆盖的是设备与接触,不是全部居民
真实痕迹来自 GPS、通话、无线接入点关联等,粒度和准确度并不相同。机会网络常用的两类来源,是蓝牙/Wi-Fi 设备,以及基于位置的社交网络(location-based social network,LBSN)。
前一类在会议、校园和商场这类中等环境里记录位置与接触。携带专用传感器的参与者是内部设备(internal device),被这些传感器看见的蓝牙或 Wi-Fi 设备是外部设备(external device)。接触次数按内部、外部分开计数。因此表 1 的分母是设备或接触次数,不是受访人数,也不能换成城市人口。传感器数量和愿意携带设备的人都会限制样本。综述列出当时公开、并可在 CRAWDAD(crawdad.cs.dartmouth.edu)找到的一批记录。
| 记录 | 类型 | 时长 | 内部设备 | 外部设备 | 内部接触 | 外部接触 |
|---|---|---|---|---|---|---|
| UCSD | W | 77 天 | 275 | NA | 195,364 | NA |
| Proximity | B | NA | NA | 27 | NA | NA |
| Dartmouth | W | 114 天 | 6,648 | NA | 4,058,284 | NA |
| Infocom 2005 | B | 4 天 | 41 | 264 | 22,459 | 1,173 |
| Infocom 2006 | B | 4 天 | 98 | 14,036 | 191,336 | 63,244 |
| MIT Reality Mining | B | 246 天 | 89 | NA | 114,046 | NA |
| Toronto | B | 16 天 | 23 | NA | 2,802 | NA |
| Intel | B | 6 天 | 8 | 92 | 1,091 | 1,173 |
| ETH | B | 75 天 | NA | 285 | NA | NA |
| Ile Sans Fils | W | 1,095 天 | 140 | 45,000 | NA | NA |
| Roller | B | 3 h | NA | 62 | NA | NA |
| SIGCOMM | B | 150 | NA | 100 | NA | NA |
| Nottingham/mall | B | 6 | 2 | 23 | 28,4492 | 60,223 |
| MDC | B | 365 天 | 200 | 39 | NA | NA |
| uiuc/uim | B/W | 150 天 | NA | 123 | NA | NA |
| Europe | B | 180 天 | NA | 100,000 | NA | NA |
| upb/mobility | B | 35 天 | 22 | 655 | 341 | 1,127 |
| UIM | B/W | 19 天 | 16 | 50 | 76,000 | NA |
类型栏的 B 是蓝牙,W 是 Wi-Fi,NA 是原表的不可得。Ile Sans Fils 的 45,000 与 Europe 的 100,000 在原表写作 45000 和 100000。UCSD 的文字说明是约 300 台 Windows CE 掌上电脑、约 11 周采集接入点信息;11 周与表中 77 天一致,300 与内部设备 275 是说明和表格两个数字。Dartmouth 的文字覆盖 2001–2004 年的校园 SNMP 日志,表格时长是 114 天、内部设备 6,648、内部接触 4,058,284。MIT 行对应 2004–2005 学年的学生和职员,89 台内部设备、246 天、114,046 次内部接触。
有几格要连着格子里的原文读。Roller 是巴黎轮滑活动中的接触,时长格印的是 3 h,外部设备 62。SIGCOMM 2009 的说明是会议设备,并写入参与者的 Facebook 资料和好友列表;时长格在“天”这一列下印的是 150。Nottingham/mall 的说明是一座 10,880 平方米的商场、从上午 9 点到晚上 9 点;时长格印的是 6,内部接触格印作 28,4492,外部接触是 60,223。28,4492 的逗号位置按原表保留。ETH 的文字说采集方法与 Dartmouth 相同,网络类型格印的是 B,外部设备 285,内部设备为 NA。uiuc/uim 与 Europe 的说明都指向伊利诺伊的 Movement 框架和 Android 手机,两行的天数、类型和外部设备数并不相同。这些差异留在表里。
基于位置的社交网络让用户主动签到,因此还能连上好友和地点属性,规模可以更大。签到是用户选择上报的访问,不是全天的连续轨迹。Gowalla 始于 2008 年,接口曾提供签到、社交关系和好友信息;综述写作时它已被 Facebook 收购,不能再自由获取。Nguyen 与 Szymanski 用它看距离如何限制友谊,Allamanis 等把社交链接和到访地点画成无向图。Hossmann 等用 Gowalla 和 Facebook 的 Stumbl 接口比较移动、社交和通信,认为这三种关系强度彼此依赖。Foursquare 在 2012 年 4 月已有超过 2,000 万用户;这个数字是当时的服务规模,不是某一篇位移分析的样本量。Noulas 等用签到看一天和一周的集体活动、邻里性质,以及活动之间的反复转移。
仿真补上了可控性,12 项性质没有被同一个模型写全
真实记录往往绑在某一所大学或某一次会议,公开数量有限,节点密度和速度也不便随意改。仿真模型用参数生成可扩展的轨迹,再用真实痕迹检查统计性质是否还在。综述把仿真分成四类。分类段写的第四类是 social-based,图 1 和表 2 写的是 sociological;下面按表 2 称为社会学模型。
地图模型从真实移动里抽出规则,再放到地图上放大。工作日移动模型 WDM 区分楼与楼之间、楼内的移动,并能产生接近真实测量的接触时长和接触间隔。日程驱动模型在表 2 中写作 ADM、正文写作 ADMM,都指向 Zheng 等(2010);它使用美国交通部家庭出行调查的活动和停留分布,在城市路网上看拓扑和路由。校园模型 SAME 把宿舍、学习、吃饭、外出和交通分成子模型,综述说它比 WDM 更接近实际痕迹的统计,没有写出具体误差差多少。
地点模型强调人反复去的少数地点。SOLAR 利用宏观上部分重复的社会轨道,适合不必不断广播位置的机会网络,综述同时认为它还不足以代表一般自组织网络。时变社区模型 TVCM 用社区区域表现偏斜的地点偏好,用不同时段表现人周期性回到同一地点。SLAW 在此之上偏好较短行程,并让汇集过程保持相关;它能贴近真实痕迹的接触间隔,也能生成停留,评测显示它适合校园、公司和主题公园这类共享场景。SWIM 给每个节点一个家,目的地由该点在全体节点中的受欢迎程度和离家距离决定,只用少量参数。STEPS 用幂律概括时空偏好,意图覆盖较宽的移动谱。
社区指成员内部联系强于对外联系的一组人。Herrmann 的早期模型把社区绑到地点并按日程移动,数学定义还不严格。CMM 先把区域划成网格,朋友与非朋友都有链接,节点按吸引移动:一个社区里,先决定离开的那个高吸引节点会带动同社区的人。Boldrini 与 Passarella 把这种“全体跟着第一个离开的人走”称为群聚行为,并提出家乡小区模型 HCMM。HCMM 保留 CMM 的社会结构,同时让部分节点连向家乡以外的外部社区,移动概率正比于与目标社区的社会链接数。仿真中 HCMM 的接触时长和接触间隔与 CMM 同类,并与 Cambridge、UCSD、Infocom 2005 等痕迹的形态一致。ECMM 补上停留和群体移动,并允许换用不同的社交输入。Geo-CoMM 的速度、停留和地点选择分布直接来自 GPS 痕迹的统计。
社会学模型把社会互动写成移动的主要驱动。SIMPS 让“当前的社会互动量”和“想要认识更多人的需求”交替发挥作用;综述指出它没有纳入停留这类时空规律。GeSoMo 把社交网络结构和移动内核分开:输入一张社交图,再安排相遇,吸引可以是节点吸引、地点吸引,也可以是排斥。SPoT 更像一个可调框架:输入社交图,检测社区并映射到地点,再按可配置的随机过程安排访问。它用 Gowalla 和 Foursquare 检查访问时间,认为多数情况下伯努利过程就能近似用户是否去某个地点。
表 2 把上述模型对照 12 项性质。√ 表示综述认为模型具备该项,× 表示不具备,− 表示含糊。吸引分成节点吸引和地点吸引两列。这些符号是综述的文献编码,不是在同一份数据上重新计算的误差。
| 模型 | 出行距离 | 回转半径 | 社区 | 节点吸引 | 地点吸引 | 返回 | 停留 | 接触时长 | 接触间隔 | 汇集间隔 | 接触图 | 社交图 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 地图·WDM | √ | × | × | × | × | √ | √ | √ | √ | × | √ | × |
| 地图·ADM | √ | − | × | × | × | × | √ | − | − | − | × | × |
| 地图·SAME | − | − | √ | × | × | − | √ | √ | √ | × | √ | × |
| 地点·SOLAR | × | √ | √ | × | × | − | √ | − | − | × | × | × |
| 地点·TVCM | × | × | √ | × | √ | − | √ | − | − | − | √ | × |
| 地点·SLAW | √ | √ | √ | × | × | − | √ | √ | √ | √ | √ | × |
| 地点·SWIM | √ | √ | √ | × | × | × | √ | √ | √ | × | × | √ |
| 地点·STEPS | √ | − | √ | × | √ | − | √ | √ | √ | √ | × | √ |
| 社区·CMM | × | − | √ | √ | × | − | − | √ | √ | × | × | √ |
| 社区·HCMM | √ | − | √ | √ | √ | × | × | √ | √ | × | × | √ |
| 社区·ECMM | × | − | √ | √ | √ | × | √ | √ | √ | × | × | √ |
| 社区·Geo-CoMM | √ | × | √ | × | × | √ | √ | √ | √ | √ | √ | × |
| 社会学·SIMPS | × | × | × | √ | × | √ | × | √ | √ | × | √ | × |
| 社会学·GeSoMo | √ | − | × | √ | √ | √ | × | − | √ | √ | × | √ |
| 社会学·SPoT | × | × | √ | × | × | − | √ | √ | √ | √ | × | √ |
只把 √ 计入“具备”、把 − 单独视为含糊时,SLAW、STEPS 和 Geo-CoMM 各有 8 项,是表中最多;ADM 有 2 项,SOLAR 有 3 项。没有任何模型 12 项都是 √。CMM 有节点吸引,地点吸引为 ×;HCMM 两列都是 √。这与正文对群聚行为和家乡小区的区分一致。SIMPS 的停留列是 ×,与正文所说的未纳入停留一致。SLAW 的社交图是 ×,SWIM 的社交图是 √、接触图是 ×。勾的数量回答的是综述认为哪项机制被写进了模型。
65% 和 95% 预测的不是同一件事
预测要分开三个问题:下一次去哪里,在那里留多久或何时到达,以及谁会和谁接触。综述把同时预测三者的方法放在接触预测里讨论。地点数据的采样方式会明显改变准确率。下面的百分比都来自综述所引的实验,不是这篇综述重新抽样的结果。
地点预测方面,Song 等(2006)在 Dartmouth 无线局域网数据上比较了四类预测器,用户数写为超过 6,000,后文也写到 6,000 名用户。最佳地点预测器的准确率大约 65%–72%。低阶马尔可夫预测器的表现不低于更复杂、更占空间的压缩预测器;使用 n≥3 个历史地点的马尔可夫预测器精度更低。表 1 的 Dartmouth 行是 6,648 台内部设备、114 天。综述没有说明预测实验的 6,000 多人是否就是这 6,648 台设备的同一筛选样本,两个数字应并列保留。
在此之后,商场实验里的混合马尔可夫模型 MMM 最高预测准确率为 74.4%;综述没有在这句写出行人数量。n-MMC 记住前 n 个地点。在三份移动数据上,n 达到 2 以后,下一次地点的准确率在 70%–95%。三份数据的名称和各自样本量,这段没有列出。
Lu 等(2013)用手机记录分析 500,000 人的出行,以熵衡量移动的不确定性,理论上限高达 88%。马尔可夫链对平稳轨迹的预测准确率是 87%,对非平稳轨迹是 95%。综述在第 5 节开头还写到,Lu 等(2013)和 Song 等(2010b)分别发现人类行为有 93% 和 95% 可预测。开头这句没有给出 93% 和 95% 的样本。500,000 人那段把 88% 写成理论上限,把 87% 和 95% 写成两类轨迹上的预测准确率。两处句子按原文并列保留。
NextCell 利用通话记录里的社会互动,在 MIT Reality Mining 痕迹上、基站级别、未来 1 到 6 小时的精度和召回高于所比较的已有方法。综述没有写出两侧的精度和召回数值。新用户往往缺少训练轨迹。McInerney 等用 38 名用户的真实地点习惯,把新用户和已有用户匹配,下一次地点的准确率比基准方法高 16%。16% 是相对提高,综述没有给出提高前后的绝对准确率。
空间模式通常比时间模式更稳,把两者一起放进地点预测因此更难。Gao 等用平滑方法保留访问的时空上下文;Huang 等从 MDC 数据提取 54 个特征,做语义地点预测。这两段都没有给出与 65%–72% 同一口径的准确率。
时间预测要回答的是何时到达、何时离开、当前地点还要留多久。Do 与 Gatica-Perez 用 153 名用户的智能手机数据,把多种依赖上下文的移动模式用概率方法合在一起;综述报告了这 153 人的潜力评估,没有写出准确率。NextPlace 不去预测地点之间怎么转移,而估计重要地点的访问时长,以及相邻两次访问的间隔。仿真的总体预测精度最高到 90%,相对当时已有方法至少提高 50%。90% 是综述所写的上限,50% 是相对提高,基准方法的绝对精度没有在这段给出。Yohan 等记录 10 名用户一整天、每两分钟一次、室内到房间级别的位置。依赖具体地点的预测器,在预测停留时长时优于不区分地点的预测器;这段同样没有给出两侧的百分比。
接触预测研究移动、朋友关系和见面概率的关系。Eagle 等发现人更可能遇见朋友而不是陌生人。Cho 等认为社会关系大约解释全部人类移动的 10%–30%,周期性行为解释 50%–70%。这是综述对 Cho 等的转述,本段没有重写那项研究的样本量,10%–30% 与 50%–70% 也不能相加后当成 100% 的分解,因为综述没有声明二者互斥且穷尽。另有工作由部分接触图补缺失接触,认为时间、空间信息加上社会信息优于单独使用;这段没有给出命中率。Jyotish 用 50 名参与者的 Wi-Fi 与蓝牙记录同时预测地点、停留和接触,并认为两类记录合在一起可以把移动看到更细的粒度。准确率数字没有出现在这段。
这些分类能用到多大的人群,综述自己留了边界
大尺度移动关系到通信网络验证和流行病研究,采集却受实验成本、缺少足够有吸引力的应用、以及商业模式和组织方式限制。开放问题一节写到,表 2 说明多数可得记录规模较小,更宽尺度的移动还考虑得不够。表 2 实际比较的是仿真模型有没有某项性质;天数和设备数在表 1。表 1 同时包含 4 天的会议、1,095 天的加拿大热点,以及外部设备达到 100,000 的一行。规模大小取决于拿哪一行、外推到哪一种场景。
综述举例的大尺度工作包括:室内 Wi-Fi 的移动地图,由通话详单的时空概率生成合成人口的详单,以及用基于位置的社交网络看城市尺度上的活动类别分布和到访时间。Stopczynski 等在一场 130,000 人的音乐节里采集时空与社交数据,只有一小部分参与者在自己的手机上安装了蓝牙感知应用。综述没有写出这一小部分的人数。
第二个开放问题是,数据转发若只预测会不会接触,地点和时间尚未一起进入预测。综述点名的例子包括 PRoPHET、CiPRO、PER 和 SPRINT,并建议以后把一周日程也放进预测。地点、时间和接触仍然是三项分开的输出。
因此,特征部分的幂律来自所引的手机、纸币或签到样本,模型部分的勾来自文献编码,预测部分的百分比来自不同任务和不同人数。三者可以互相提示,不能连成一条新的、已经在全体人口上复核过的移动定律。
一句话总结
机会网络要写进仿真的是带日程、短途很多、见面稀疏的人;这篇文章把特征、记录与模型和三类预测摊开之后,出行距离、接触间隔和各种“准确率”仍然各自绑在自己的样本上。
核心来源
- Journal of Network and Computer Applications 正式页面,卷 42,2014 年,第 45–58 页。题目、作者、收稿日期和 DOI 以这一版为准。
- 正文图 1、表 1 和表 2 都在这 14 页期刊论文里。图 1 是三组问题的分类;表 1 是 18 条蓝牙/Wi-Fi 记录;表 2 是 15 个仿真模型的 12 项性质。综述写明多数蓝牙/Wi-Fi 记录可从 CRAWDAD(crawdad.cs.dartmouth.edu)获取。
- 资助说明写在文末:国家自然科学基金 61173179 和 61202441,中央高校基本科研业务费 DUT13JS10。
作者介绍
四位作者都署名大连理工大学软件学院,通信地址写为大连 116620。论文没有逐人的贡献说明,这里只保留论文上的身份。
- Poria Pirozmand:论文作者之一,署名为大连理工大学软件学院。
- Guowei Wu:论文作者之一,署名为同一学院。
- Behrouz Jedari:论文作者之一,署名为同一学院。
- Feng Xia:通讯作者,署名为同一学院,论文给出的邮箱是 f.xia@ieee.org。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
挑选一条痕迹做协议仿真时,可以把表 1 的三个分母先写在同一行:天数、内部设备、外部设备。Infocom 2005 的 22,459 次内部接触来自 41 台内部设备、4 天;Dartmouth 的 4,058,284 次来自 6,648 台内部设备、114 天。外部设备为 NA 的行,连路过设备有多少都没有进入表。若结果报告只保留一个接触次数,读者无法判断它更接近一次会议,还是一所大学一个学期的无线网。
预测数字也需要先对齐任务。65%–72% 是 Dartmouth 地点预测器的准确率区间;500,000 人那段里,88% 是理论上限,87% 和 95% 是平稳与非平稳轨迹的马尔可夫准确率;38 名新用户的 16% 是相对基准的提高。把这些百分比排成一条上升曲线,会把不同分母加成一个并不存在的进展。更有信息的比较,是同一批人、同一种“下一次地点”任务、同一种训练和留出划分。
表 2 的勾表示机制有没有被写进模型。SLAW、STEPS 和 Geo-CoMM 都有 8 项勾,社交图一列却分别是 ×、√ 和 ×。若问题是谁和谁见面,勾更多的模型不一定更合适。值得单独做的检验,是在留出的接触记录上比较接触间隔或接触对象,而不是比较勾的个数。