同样叫人类移动,为什么换一种数据,规律就换一种?
论文名片|Kai Zhao、Sasu Tarkoma、Siyuan Liu、Huy Vo,Urban Human Mobility Data Mining: An Overview,2016 IEEE International Conference on Big Data (Big Data),2016,pp. 1911–1920。DOI:10.1109/BigData.2016.7840811。本文依据该会议论文正文解读。这是一篇综述,把已有数据和模型放进同一条挖掘流程,没有在同一批数据上重做统一实验。
一辆出租车的定位点可以落在河里,一部手机有时只知道自己离某座基站大约两三公里。两份记录都在说城市里的人在移动,量到的却不是同一件事:一个是车辆上的卫星定位,一个是人相对通信设施的粗位置。
这篇综述要回答的是,这些记录怎样经过清洗、建模和预测,变成交通、空气或网络还能用的知识。方向已经比较清楚:飞行长度写成幂律、写成指数,还是写成两地人口和距离的公式,取决于数据是相对位置、个人轨迹还是出租车汇总,也取决于行程有没有按交通方式拆开。作者把物理里的移动模型和计算机里的预测器放在一张流程图上。文中的准确率和样本数大多来自被引研究,或来自综述自己的汇总表;两处口径碰到一起时,并不总是同一个数字。
先说结论
- 表 I 列出 9 份公开数据,分成相对位置、个体移动和汇总移动。表中样本数从 11 M 到 868 M,但 Geolife、诺基亚、罗马、旧金山和 T-Drive 的正文介绍,与表中对应格子的条数或参与者数并不相同。表头也没有定义一条样本是定位点、接触记录还是一次出行。
- 纽约黄色出租车的 GPS 点会出现在河里、海里和北美以外;同一辆车还会出现前后行程重叠。用城市边界删点,只能处理界外点。把 1,400 万个 GPS 样本用 R 树匹配到街区,大约需要十分钟。
- 混合轨迹常被写成带许多短飞行、少量长飞行的莱维行走。综述同时列出四种解释,其中两种认为个人轨迹本身不是幂律,单种交通方式更接近指数或对数正态。只看出租车时,飞行长度写成随距离指数下降,指数里的衰减率没有给出数值。
- 韩国高速 30 座城市的车流被写成两城人口相乘、再除以距离的平方。辐射模型在此之外乘上起点的总出行,并放入中间地带的人口,因此两个方向的流量可以不同。多视图模型相对单视图平均高出 51%,综述没有说明这 51% 是准确率、误差还是别的分数,也没有给出参与平均的城市或天数。
- 被引的 50,000 名用户分析给出 93% 的潜在可预测性。可预测性上限为 0.3 的人,至少 70% 的时间里位置呈现随机,未来位置的准确率不能高于 30%。一阶马尔可夫可以接近这一上限,更高阶没有相对一阶提高。深度长短期记忆网络被报告为未来移动和交通方式的准确率超过 80%,测试集规模没有在本文重述。马尔可夫预测的计算时间约为深度学习方法的 0.03%。
这条流程把六件事连在一起,连起来以后各自还在回答什么?
人类移动性(human mobility)在这里指人在城市中怎样变换位置,例如步行回家、开车去工作地或乘坐公共交通。它不是户籍意义上的人口迁移。综述借用数据挖掘的知识发现过程,把工作分成六步:找到数据,清洗和预处理,选择模型,用机器学习寻找模式,评价模式,再把结果用到城市问题。作者认为,此前的综述往往只覆盖其中一段,或只从物理学、只从计算机科学一侧来写。这是作者对文献版图的判断。
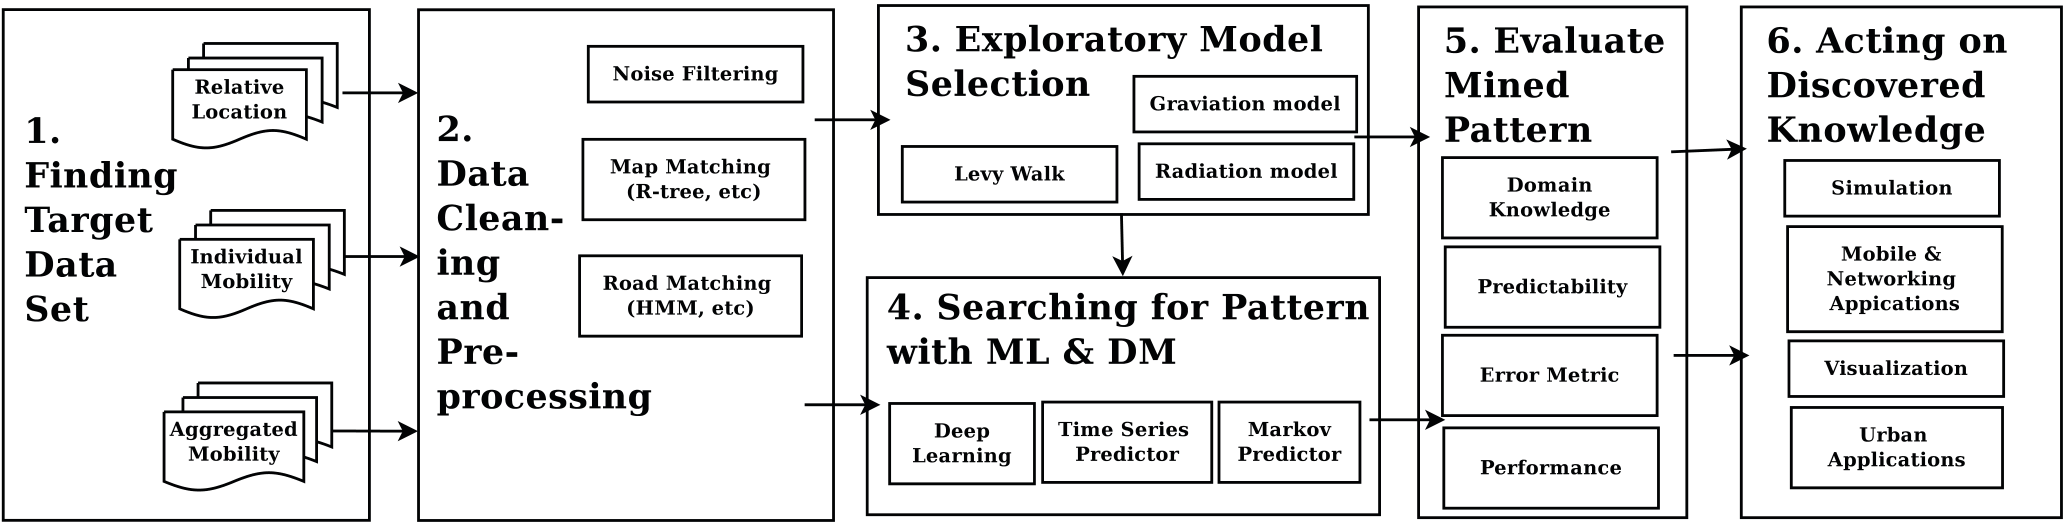
图 1|从一份位置记录到一项城市应用,中间要经过哪些不同的选择?
无字母子图。左起第一栏是三类目标数据:相对位置、个体移动、汇总移动。第二栏是清洗和预处理,列出噪声过滤、用 R 树做的地图匹配,以及用隐马尔可夫模型等做的道路匹配。第三、四栏把模型选择和模式搜索分开:模型栏有莱维行走、重力模型和辐射模型,重力模型方框印作 Graviation model;搜索栏有深度学习、时间序列预测和马尔可夫预测。第五栏用领域知识、可预测性、误差指标和计算性能来评价。第六栏是仿真、移动与网络应用、可视化和城市应用。箭头表示综述心目中的先后关系,不是一次实验的数据流。来源:原论文 Fig. 1。
这张图的用处是防止把后面的公式当成同一种测量。相对位置、个人 GPS 和出租车汇总进入的是同一条管道,出来时却对应不同的模型和误差。图本身不包含任何准确率。
公开数据里,一条样本到底在数什么?
数据被分成三类。相对位置记录设备靠近蓝牙、Wi-Fi 或蜂窝基站;知道接入点在哪里,才能反推人的大致位置。蜂窝基站的定位精度通常是 2–3 公里,比 GPS 粗。个人 GPS 直接记参与者的坐标,适合刻画个人,也因此更难大规模公开。汇总移动来自出租车、公交或地铁这类车辆轨迹;对出租车来说,上车点和下车点被当作某一次出行的起点和终点,分析单位已经从人换成了车辆行程。
表 I 是综述给出的汇总,样本数保留表中的 M。参与者一列同时装着会议参与者、学生、志愿者和车辆,不能一律读成人。
| 数据 | 类别 | 地点 | 场景 | 样本数 | 定位 | 参与者 | 时长 | 采样间隔 |
|---|---|---|---|---|---|---|---|---|
| INFOCOM06 | 相对位置 | 巴塞罗那 | 会议 | 24 M | 蓝牙 | 78 | 4 天 | 120 秒 |
| Reality | 相对位置 | 波士顿 | 校园 | 11 M | GSM | 97 | 9 个月 | 300 秒 |
| UCSD | 相对位置 | 圣迭戈 | 校园 | 11 M | Wi-Fi | 274 | 2 个月 | 120 秒 |
| Geolife | 个体移动 | 北京 | 城市 | 21 M | GPS | 182 | 5 年 | 1–5 秒 |
| Nokia MDC | 个体移动 | 日内瓦 | 城市 | 17 M | GPS | 200 | 1.5 年 | 10 秒 |
| Rome | 汇总移动 | 罗马 | 城市 | 11 M | GPS | 536 | 1 个月 | 64 秒 |
| San Francisco | 汇总移动 | 旧金山 | 城市 | 21 M | GPS | 316 | 1 个月 | 9 秒 |
| T-Drive | 汇总移动 | 北京 | 城市 | 17 M | GPS | 10,357 | 1 周 | 177 秒 |
| NYC Yellow Taxi | 汇总移动 | 纽约 | 城市 | 868 M | GPS | 13,237 | 7 年 | 1 秒 |
正文对其中几份数据另给了一套数字,分母并不相同。
INFOCOM06 的正文说,98 台设备里 78 台发给参与者、20 台固定,记录的是参与者相对固定设备的位置。表中参与者 78 与此相符。若 78 人每 120 秒一条、连续 4 天,条数约为 78 × 4 × 24 × 3,600 / 120 = 224,640。表中样本数是 24 M。综述没有说明多出来的记录是接触、扫描还是别的事件,因此 24 M 不能当成 78 个人的定位点个数。
Reality 的正文是 95 名参与者、9 个月;表中是 97 人。UCSD 的正文是 274 名新生的 Wi-Fi PDA,2002 年 9 月 22 日到 12 月 8 日共 11 周;表中时长写成 2 个月。
Geolife 的正文是 182 名用户、2007 年 4 月到 2012 年 8 月、超过 2,400 万个 GPS 样本,累计 1,292,951 公里、50,176 小时,交通方式由参与者手工标注。表中样本数是 21 M。用正文的 50,176 小时去除以超过 2,400 万个样本,平均间隔短于 50,176 × 3,600 / 24,000,000 ≈ 7.5 秒;用表中 21 M 去除,平均约 8.6 秒。两套样本数都落在表中 1–5 秒间隔之外。1,292,951 公里除以 50,176 小时,约为每小时 25.8 公里,这是累计里程除以累计时长,不是某一位通勤者的速度。
诺基亚 MDC 的正文是日内瓦湖区 200 名志愿者、2009 年 9 月到 2011 年 4 月、1,100 万个点;表中是 17 M。
罗马的正文是 316 辆出租车、30 天、大约每 7 秒一次 GPS。旧金山的正文是约 500 辆黄色出租车、2008 年 5 月 17 日到 6 月 10 日、1,100 万个点。表中罗马一列是 536 个参与者、11 M、64 秒,旧金山一列是 316 个参与者、21 M、9 秒。316 和 1,100 万出现在另一座城市的格子里。仅凭这篇综述,不能确定罗马或旧金山该用哪一个样本量。
T-Drive 的正文是北京 10,357 辆出租车、2008 年 2 月 2 日到 8 日、约 1,500 万个 GPS 点,轨迹总距离最高达 900 万公里。表中参与者 10,357、时长 1 周与此相符,样本数写成 17 M,间隔 177 秒。若 10,357 辆车按 177 秒连续记录 7 天,点数约为 10,357 × 7 × 86,400 / 177 ≈ 3,539 万,高于正文的约 1,500 万,也高于表中的 17 M。177 秒因此不能理解成这 7 天里每辆车都不间断采样。
纽约黄色出租车在正文里是另一套单位:每天超过 50 万次出行,大约服务 60 万人。表中则是 868 M 个样本、13,237 个参与者、7 年、间隔 1 秒。868 M 除以 13,237,平均每个参与者约 6.56 万条;再按每年 365 天分到 7 年,大约每天 26 条。若这 13,237 个参与者真的每秒记录、连续 7 年,条数会到约 13,237 × 7 × 365 × 86,400 ≈ 2.9 × 10^12。表里的 1 秒和 868 M 不能连乘成完整轨迹。13,237 与每天服务的约 60 万人也不是同一个分母,前者在参与者列,后者是每天的乘客规模。
运营商通常不愿公开原始相对位置。Mir 等人用合成通话详单去模仿真实都市人口的移动,并用来自纽约和洛杉矶都市区、数十万部手机的数十亿条相对位置样本做了对照。那是隐私保护下的替代数据,没有进入表 I 的九行。
点掉进河里之后,后面的模型还在解释谁?
GPS 会被高楼和接收算法带偏。综述把纽约黄色出租车的点画出来,用来说明误差长什么样。
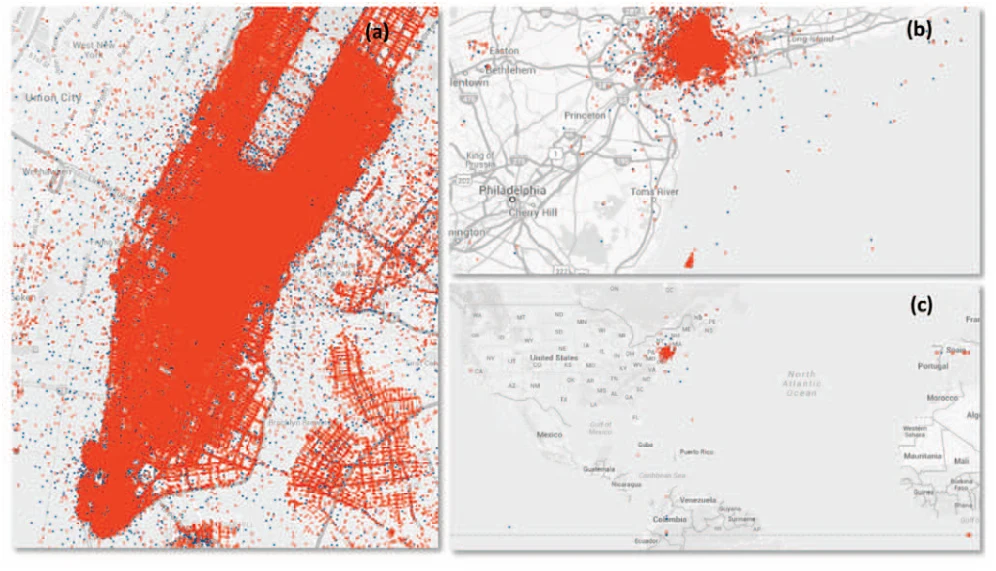
图 2|这些出租车定位点有多少已经离开了车可能在的地方?
(a)纽约一带,大量点铺在陆地上,也进入河道。(b)美国东北沿海,海上有散点。(c)尺度拉到大西洋,北美以外仍能看到点。图中同时有红色和蓝色点,正文没有分别定义两种颜色,也没有给出落在水里或界外的点数占全部样本的比例。来源:原论文 Fig. 2。
除了空间错误,时间也会错。纽约出租车数据里,同一辆车的新行程会在上一程结束前开始。原因可能是设备错误,也可能是司机忘记记下乘客下车。综述没有给出重叠行程占全部行程的比例,只要求使用前先删掉。
清洗之后还要把点配到街区、道路或社区。常用 R 树把 GPS 点匹配到建筑街区的边界。纽约每天超过 50 万次出行、大约服务 60 万人,这个匹配本身就是大数据任务。把 1,400 万个 GPS 样本匹配到对应街区,R 树大约用十分钟。Spark 和 Hadoop 被提到是常用平台,本文没有比较它们和这十分钟的快慢。隐马尔可夫模型被列为道路匹配的一类方法,本文没有给出匹配准确率。
地理边界可以删掉界外的点,对应图 2(c)那种远点。河道若仍在城市边界以内,只靠外边界删不掉图 2(a)里的水上点。后面的流量模型如果直接使用未处理坐标,解释的对象里会混入这些不可能的位置。
短飞行很多,是一个人的习惯,还是好几类出行叠出来的?
飞行(flight)在这里指一个人从一处到另一处、中间不停留的一段行程。随机路点(random waypoint,RWP)不使用观测:节点自由移动,目的地、速度和方向都随机,且与其他节点无关。布朗运动(Brownian motion,BM)使用一个平均飞行长度和飞行之间的平均停留,飞行长度按正态分配。表 II 给这两行的数据集都是 None,表示它们是假设出来的合成模型。
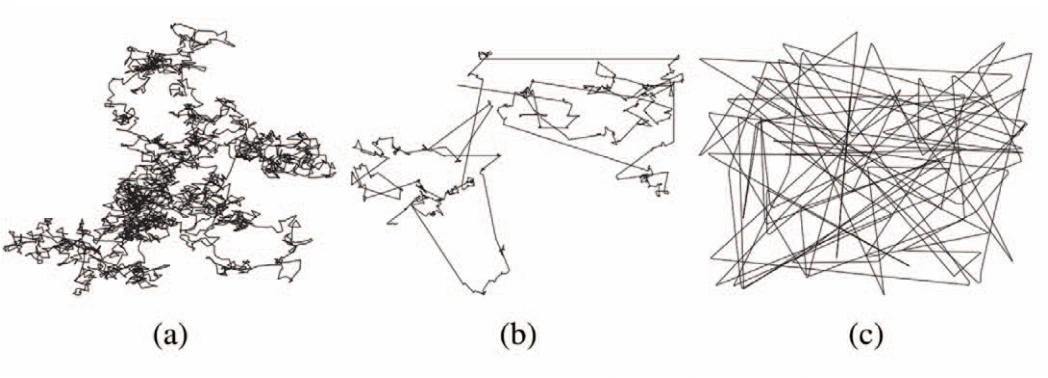
图 3|没有观测的合成轨迹,和带长跳跃的轨迹,看起来差在哪里?
(a)轨迹在局部来回折返。(b)短线段之外出现明显的长跳跃。(c)长直线在整个区域里来回交叉。图注写的是(a)布朗运动、(b)莱维行走、(c)随机路点。合成模型一节另有一句,把(a)和(c)说成随机路点和布朗运动。画面与图注一致,与那一句不一致。三幅都是示意轨迹,没有坐标、样本数或拟合优度。来源:原论文 Fig. 3。
莱维行走(Lévy walk)用来描述另一类观测:许多短飞行,加上一些长飞行。综述写飞行长度 l 服从幂律,并把公式印成
P(l) ∼ l^(1+β),位移指数 β < 2。
印刷出来的指数是正的 (1+β),式中没有负号。按这个印刷式,更长的飞行会有更高的概率,这和同一段所说的短飞行很多、长飞行较少对不上。后文的指数公式确实印了负号。本文按印刷式转述,不把负号补进公式(1)。
支持这一类重尾的材料来自纸币追踪、手机位置和 GPS,比表 II 里莱维那一行所写的汇总移动更宽。表中这一行的数据集写成 Aggregated Mobility,交通方式是 None。综述接着说,重尾的机制还没有被同一种解释收束,并列出四条。
第一条来自 Gonzalez 等人对手机用户的研究。人的移动被看成围绕一个中心位置的随机过程;跳跃长度的幂律来自个人移动统计与人群差异的卷积,也就是把每个人自己的移动和人与人之间的差别叠在一起之后,整体才呈现幂律。表 II 把这项工作标成相对位置、精度 2–3 公里,飞行分布是幂律加高斯模型,解释是时间和空间上的规律性。
第二条把原因放在交通或道路的层级。层级网络上的随机游走可以重现莱维统计,人的移动受路网地理结构影响。表中对应行的空间尺度是 5–10 米。
第三条把方向调过来:个人轨迹并不遵循莱维行走,群体上的幂律来自把个人模式汇总到一起,并可用最大熵来解释。最大熵还预期,只有一种交通方式时,飞行长度遵循指数分布。
第四条按交通方式拆开行程,例如步行或跑步、自行车、火车或地铁、小汽车或出租车或公交。单一方式可以用对数正态分布近似,而不是幂律;把这些对数正态混合起来,才得到幂律。表 II 因此把这一行写成幂律加对数正态,并注明有多种交通方式。
前两条仍把幂律留在所观测的移动上,后两条把幂律看成混合以后的样子。综述把它们并列,没有用新数据判定哪一条成立。对应用来说,这个差别决定了能不能用全体轨迹的重尾去代替出租车、步行或地铁各自的距离分布。
只看出租车这一种方式时,综述引用的结果是指数:
P(l) ∼ e^(−λl)。
一种解释是,少有人愿意坐出租车走很远,因为费用会上去。另一种解释是城市人口密度随距离指数下降,而且飞行长度和人口密度的指数衰减率相同。λ 的数值、拟合用的距离区间和城市名单都没有写在本文里。表 II 把这一行标成汇总移动、指数、出租车,解释为人口密度。
两座城市之间的流量,人口和中间机会各算进去了吗?
引力模型(gravity model,也称重力模型)在这里描述城市之间的交通流量。Jung 等人考察韩国高速公路上 30 座入选城市,发现两城之间的流量与两城人口有正相关。流量写成
Tᵢⱼ = Pᵢ Pⱼ / rᵢⱼ²。
Pᵢ、Pⱼ 是城市 i 和 j 的人口,rᵢⱼ 是两城距离。距离的指数被固定为 2,不是另一次拟合得到的指数。公式对 i 和 j 对称,所以单靠这一式,从 i 到 j 和从 j 到 i 是同一个数。综述没有给出那 30 座城市的相关系数或流量误差。
综述认为引力模型的一个大缺陷,是它不能分别描述两个方向上的个人流量。辐射模型(radiation model)把从 i 到 j 的行程数写成
Tᵢⱼ = Tᵢ × Pᵢ Pⱼ / [(Pᵢ + Pᵢⱼ)(Pᵢ + Pⱼ + Pᵢⱼ)]。
Tᵢ 是从 i 出发的总行程数。Pᵢⱼ 是除 i 和 j 以外、到 i 的距离不超过 i 与 j 之间距离的那些地点的人口,也就是位于这段距离以内的中间人口。因为式子乘的是起点自己的总出行,两个方向可以不同。综述说,辐射模型能在从长期迁移到区域间通信量的多种现象上明显提高预测准确率。提高了多少、相对哪一个引力模型、用的是哪一批地点,本文没有列出对照表。
表 II 还收进一个多视图模型。此前很多模型只用出租车、公交、地铁或通话记录中的一种视图。Zhang 等人把多个视图放在一起,新模型平均比单视图模型高出 51%。本文没有说明 51% 的分子是准确率提升还是误差下降,也没有说明平均覆盖了多少城市、多少天。
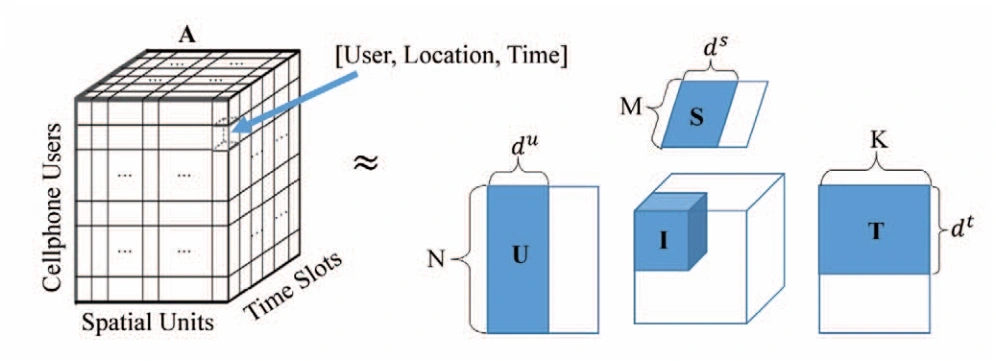
图 4|一份稀疏的通话记录,怎样被拆成更小的用户、地点和时间因子?
无字母子图。左侧立方体 A 的三个轴是手机用户、空间单元和时间片,其中一个格子表示用户、地点、时间的组合。右侧是分解后的因子:用户矩阵 U、地点矩阵 S、时间矩阵 T,以及中间的核心张量 I。括号上的 dᵘ、dˢ、dᵗ 和 N、M、K 标的是各因子的维度,图中没有给出具体维数。这是单视图张量分解的示意图,不是多视图相对单视图高出 51% 的那次比较结果。来源:原论文 Fig. 4。
通话记录很稀疏,所以先把三维张量分解成较小的潜在因子,再用正则项减轻过拟合,用近似张量提高单视图的准确率。几个单视图再迭代合并成一张人流图,边上的权重是从一个地方到另一个地方的乘客量。图 4 只展示了分解的结构。它不能单独证明多视图一定高出 51%,也不能说明这张图已经是真实客流。
下一次出现在哪里,能预测到谁的上限?
预测任务被定义成:一个人在时刻 j 的位置是 dⱼ,历史序列是 Dₙ = d₁d₂…dₙ,目标是给出下一时刻的位置 dₙ₊₁。可用的规律是重复出现的地点和时间。工作日白天去工作地、下班后去购物,回家和去工作地的概率都较高。综述用这些重复出现的地点说明预测何以可能,本文没有另行估计这些概率。
出租车汇总流也可以看到这种昼夜差别。综述用下曼哈顿开出的出租车方向作为例子。
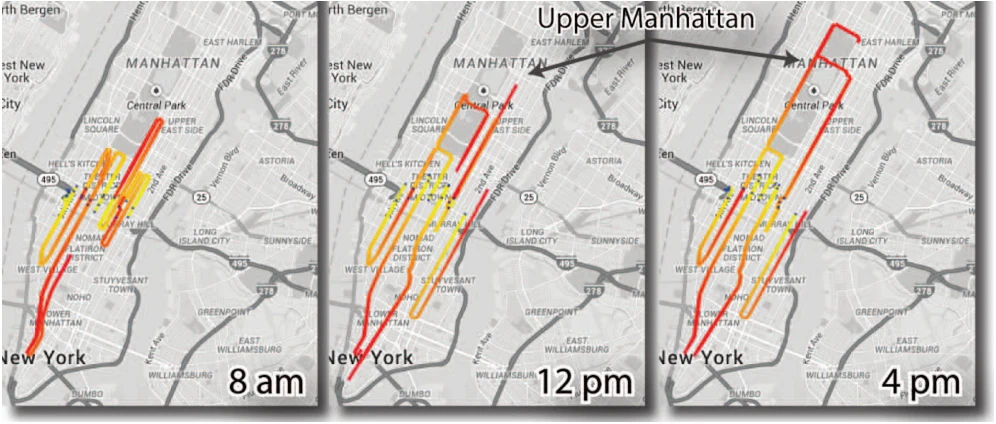
图 5|从下曼哈顿出发的出租车方向,为什么傍晚会伸向上城?
无字母子图,三幅从左到右是上午 8 点、中午 12 点和下午 4 点。方向用从红到黄的颜色表示,图上没有概率数值或图例刻度。上午 8 点,车流主要留在中城及以南;下午 4 点,一条偏红的方向伸到图中标出的上曼哈顿。正文的解释是下曼哈顿主要是工作地,上城(例如上东区)主要是居住地,下班后从南向北的概率升高。中午 12 点画在图里,正文没有单独给它一个数值结论。这是汇总后的出租车方向,不是每位居民的出行概率。来源:原论文 Fig. 5。
预测器被收成四类,表 III 是综述自己的定性比较。
| 预测器 | 表中文献 | 数据 | 特征 | 方法 | 是否接近误差下界 | 计算时间 |
|---|---|---|---|---|---|---|
| 马尔可夫 | [45] | 相对位置 | 地点、时间 | 马尔可夫 | 是 | 快 |
| LZW | [45] | 相对位置 | 地点、时间 | 基于压缩 | 否 | 快 |
| ARIMA | [33] | 汇总移动 | 地点、时间 | 时间序列 | 未知 | 较快 |
| LSTM | [45] | 个体移动 | 地点、时间、交通方式 | 深度学习 | 未知 | 慢 |
k 阶马尔可夫只用最近 k 个位置来估计下一次去 β 的概率。压缩预测器 LZW 先把历史切成若干最短的、此前没出现过的子序列;下一次出现 β 的概率,是扩展子序列出现次数除以当前子序列出现次数。自回归积分滑动平均(ARIMA)用历史序列建立时间序列模型,再外推下一步。正文里出租车热点客流的例子来自 Li 等人,表 III 的 ARIMA 一行却标成另一篇文献。深度长短期记忆网络(LSTM)的结构图来自 Song 等人,表 III 的 LSTM 一行也标成 [45]。读这张表时,只能把它当作综述的定性索引;某一格的文献编号和前后正文并不总是同一篇论文。
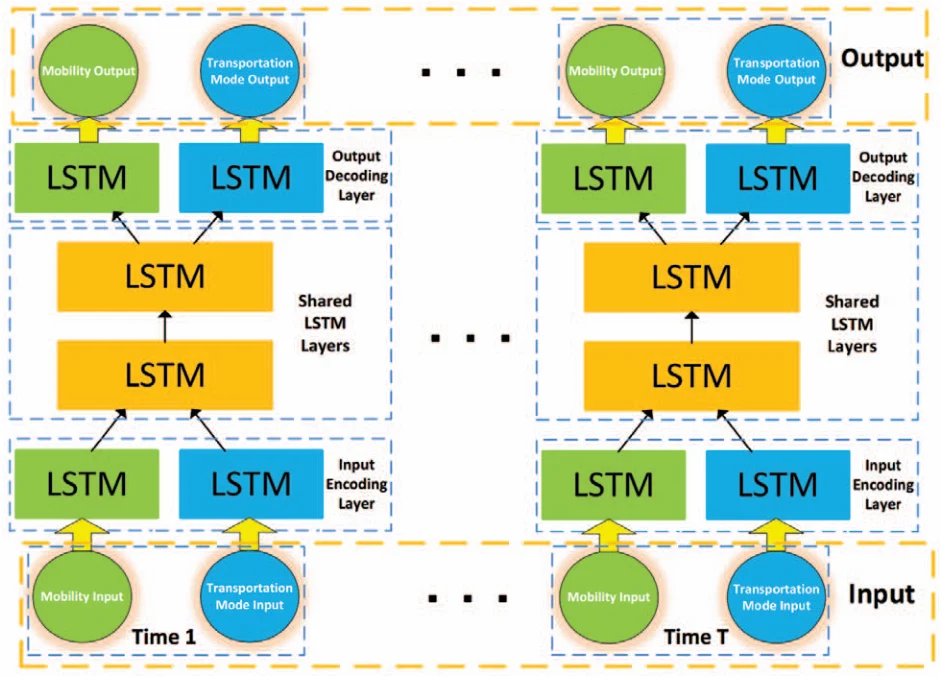
图 6|深度 LSTM 在同时预测位置和交通方式时,输入输出是怎样接上的?
无字母子图。下方是时刻 1 到时刻 T 的输入,每一时刻有移动输入和交通方式输入。中间是共享的 LSTM 层,上下还有输入编码和输出解码。上方输出同样分成移动和交通方式。省略号表示时间展开。图中没有准确率、损失或测试样本数。来源:原论文 Fig. 6。
Song 等人用这套结构预测一个人未来的移动和交通方式,准确率超过 80%。综述没有重写测试集有多少人、多少天,也没有定义怎样算一次预测正确。同一节说,普通循环神经网络抓不住很长的时间依赖,LSTM 可以学习长跨度并自行决定时间滞后。这是对结构能力的转述。超过 80% 这个数不能从图 6 里读出来,也不能当成表 III 里所有预测器的共同成绩。
评价分成误差、计算速度和领域专家三件事。对称平均绝对百分比误差(sMAPE)被当作常用误差。Song 等人用它比较 LSTM 和高斯模型,LSTM 更好。本文没有印出那次比较的 sMAPE 数值。
可预测性上限(limits of predictability,Πmax)来自另一项被引研究:在同时考虑移动的随机性和时间相关性之后,一个预测算法最高能达到的准确率。分析对象是 50,000 名用户的移动,潜在可预测性为 93%。对大多数人,意外事件带来随机性,每周节奏带来规律。若某人的 Πmax = 0.3,则至少 70% 的时间里他的位置呈现随机,只有其余 30% 的时间有希望预测对;再好的算法也不能把这个人的未来位置预测到 30% 以上。93% 是这 50,000 人分析中的潜在水平,0.3 是综述用来说明上限含义的例子,两者不是同一批人的两个统计量。
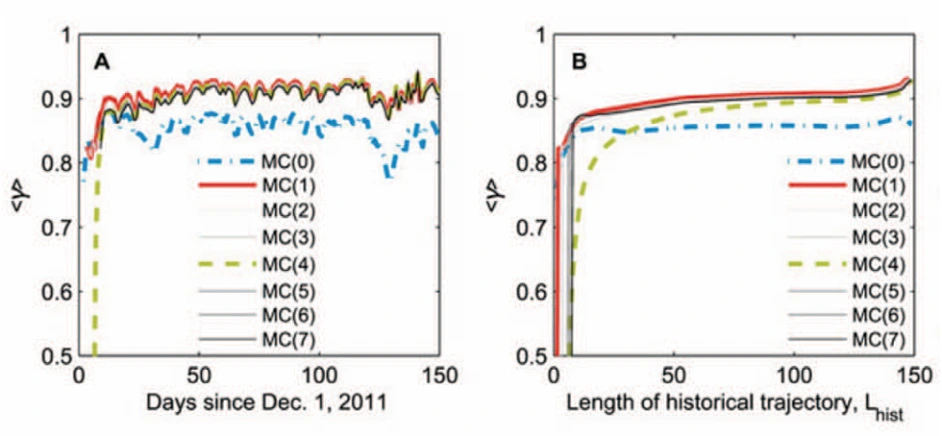
图 7|把历史加长以后,更高阶的马尔可夫还会比一阶更准吗?
图内面板标为 A、B,图注写成(a)(b)。(a)横轴是自 2011 年 12 月 1 日起的天数,刻度到 150;纵轴刻度从 0.5 到 1,图注称为准确率。曲线为 MC(0) 到 MC(7)。历史很短时,部分高阶曲线落在图的底部,随后升到纵轴 0.9 刻度附近,并与一阶曲线叠在一起;零阶曲线整体更低,并在后期有一次向下的波动。(b)横轴是历史轨迹长度,纵轴同样到 1。曲线随历史变长而上升,更高阶没有稳定地离开一阶曲线。图上没有标出逐日数值,因此不能从曲线上再读出一个精确的百分数。这张图来自被引文献,不是本综述新做的实验。来源:原论文 Fig. 7。
Lu 等人的结果是:一阶马尔可夫可以接近可预测性上限,更高阶相对于一阶没有带来更高的预测准确率。表 III 把马尔可夫标成能够接近误差下界,与这一结论同向;LZW 被标成不能,LSTM 和 ARIMA 被标成未知。
速度也要单独看。移动数据在变大,交通预测又常常要求当时就给出结果。综述写道,马尔可夫预测的计算时间约为深度学习方法的 0.03%。比较的分母是深度学习方法的计算时间,不是预测准确率,也没有给出两台机器或两份数据的绝对秒数。
领域知识被当作第三种核对。图 5 里下班后才出现的南向北车流,交通部门或出租车管理机构的人员可以根据经验辨认。本文没有报告专家一致率或盲测人数。专家认出一种昼夜模式,仍然不等于模型已经预测对了下一次出行。
这些模型被拿去处理哪些城市问题,综述自己又停在哪里?
综述举了四类已经发表的用法,都不是本文新做的实验。
交通异常可以由事故、管制、抗议、赛事、庆典或灾害引起。Pan 等人用北京超过 30,000 辆出租车的 GPS 轨迹检测并描述异常,相对传统的、只看交通量的方法,在准确率和计算性能上都有明显优势。优势的幅度没有写在本文。
空气方面,Zheng 等人观察到一个区域的 PM10 浓度,与到达和离开该区域的人数呈正相关。城市里的空气监测站有限,人的移动因此被当作推断细粒度空气质量的一项特征。相关系数没有给出,所以这只说明被引研究找到了同向关系。
功能区把城市分成居住、商业、教育等。正文称 Jing 等人用基于主题的推断,根据人类移动模式判断每个区域的功能;参考文献 [4] 的作者署名是 J. Yuan 等。工作日上午去工作地、下午回居住地,是这种推断使用的节奏。本文没有给出分区准确率。
移动自组织网络(MANET)里,车辆或手机相遇时可以用蓝牙或 Wi-Fi 交换内容。早期仿真常用随机路点。后来的研究发现人的移动更接近莱维行走,用随机路点估计的路由性能会偏高。莱维行走的重尾还会带来路由延迟和吞吐量的重尾。偏高多少,本文没有给出倍数。
作者把本文和若干已有综述分开:有的只评合成模型,有的整理公开数据,有的从社交网络或物理学出发,有的按工程步骤讨论移动网络中的建模和验证。本文强调的是整条挖掘流程,以及同时纳入复杂网络和机器学习。这一差别是作者的定位,不是一场新的准确率比赛。
结论用联合国《世界城市化前景》2011 年修订版作为背景:世界人口的 50% 住在城市,到 2050 年升至 70%;北美已经是 80%,2050 年为 90%。这是城市化比例,不是出行距离或预测准确率。
篇幅所限,隐私保护技术和较新的地图匹配算法没有展开。作者还把跨模型和预测器的基准测试留到以后。因此,表 II 和表 III 的并排,不能代替一次在同一城市、同一种交通方式、同一个空间单元上的比较。引力模型的分母是距离平方,辐射模型的分母里还有中间人口和起点总出行;把它们的被引结论写成谁普遍更准,已经超出了这篇综述实际完成的计算。
一句话总结
换一种传感器或一种交通方式,城市移动的统计形式就会跟着换;这篇综述把数据和模型收进同一条流程,而表中的样本数和文中引用的准确率,仍要回到各自的分母才能当作同一种证据。
核心来源
- Kai Zhao、Sasu Tarkoma、Siyuan Liu、Huy Vo,Urban Human Mobility Data Mining: An Overview,2016 IEEE International Conference on Big Data (Big Data),pp. 1911–1920。DOI:10.1109/BigData.2016.7840811。
- 正文图 1–7 与表 I–III。图 2 的定位误差来自文中对纽约出租车数据的展示,图 3、图 4、图 5、图 6、图 7 分别转引轨迹示意、张量分解、出租车流向、LSTM 结构和马尔可夫准确率。
- 结论写明,隐私保护与较新的地图匹配因篇幅未展开,跨模型基准留作后续工作。
作者介绍
四位作者的单位以论文署名页为准,研究关联只采用本文参考文献和致谢里能够核对的内容。
- Kai Zhao:署名纽约大学城市科学与进步中心。参考文献中的相关工作包括交通方式分解、城市区域分析、纽约出租车数据清理,以及高分辨率出租车需求预测。
- Sasu Tarkoma:署名赫尔辛基大学计算机科学系。文中与其共同署名的文献涉及城市区域分析,以及移动网络中的内容分发。
- Siyuan Liu:署名中国科学院深圳先进技术研究院。致谢写明其工作受深圳基础研究计划 JCYJ20140610152828686 和中国国家自然科学基金 61572488 支持。
- Huy Vo:同时署名纽约大学城市科学与进步中心和纽约城市大学城市学院计算机科学系。参考文献中的合作包括纽约出租车轨迹清理、交通动态可视化和出租车需求预测。全文部分受 CUNY IRG 奖和纽约大学城市科学与进步中心支持。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个城市数据目录直接采用表 I,罗马会得到 536 个参与者和 64 秒间隔,旧金山会得到 316 个参与者;同一篇文章的正文又把 316 辆出租车和大约每 7 秒一次采样写给罗马,把大约 500 辆车和 1,100 万个点写给旧金山。后续任何训练集说明都需要一张逐项对齐后的数据单,而且每一行都要写明计数单位是人、车、行程还是定位点。在单位写清之前,把 868 M 或 24 M 写进模型论文的样本量,只是在复制一个尚未定义的分母。
四种莱维解释也使产品层的推论变窄。用全体轨迹的重尾去决定出租车该在哪些远距离枢纽候客,等于把混合分布当成了单一交通方式的分布。综述引用的出租车结果是指数衰减,并把它和费用、人口密度放在一起。若要检验候客点,至少应在同一种车辆、同一座城市里同时报告飞行长度、费用和人口密度,而不是只拿一条幂律曲线做依据。
可预测性上限还要求报告方式跟着改变。50,000 人分析中的 93% 是潜在水平;Πmax = 0.3 的人,准确率天花板就是 30%。一个只公布全城平均准确率的服务,会把这两类人合成一个数。更有信息的公布方式是给出 Πmax 的分布,并说明平均准确率是在多少用户、多少天上计算的。本文引用了这个上限,没有附上分布。
作者留到以后的基准测试,也需要先固定比较对象。引力公式在这里的输入是 30 座韩国城市的人口和距离平方,辐射公式另有起点总出行和中间人口。一次有用的重做应当在同一批起讫点和同一种流量上,分别报告两个方向的误差,因为综述偏好辐射模型的理由,正是两个方向可以不一样。只比较一个对称的总量,会把这个理由消掉。