公交跑完全程的时间,会集中在少数路段上吗?
论文名片|Caio Ponte、Hygor Piaget M. Melo、Carlos Caminha、José S. Andrade Jr.、Vasco Furtado,Traveling heterogeneity in public transportation,EPJ Data Science,2018,7:42。2018年7月18日收稿,2018年10月8日接收。DOI:10.1140/epjds/s13688-018-0172-6。本文依据这一正式发表版。
早高峰里,同一辆公交车会在几个路口慢慢挪,驶过之后又连着开过好几站。全程如果只记下用了一个小时,这两段完全不同的行驶就被加在一起。这篇论文把问题拆开:沿路线每走同样长的一小段,耗时是否均匀;这种不均匀,能不能用来刻画这趟公交的运行状况。
福塔莱萨和都柏林的公交车载定位给出的方向是:时间会堆在少数路段上,但没有堆到两成路程用掉八成时间。把不均匀收成基尼系数(Gini coefficient,把分布的不均匀压到0和1之间)之后,它在工作日的早晚高峰更高,也随着行程相对本线路平均用时的偏离而上升。这是一次行程对一次行程的统计关系。它支持把重尾看成运行不稳的信号;改动最慢的几段路会不会改善整座城市,以及乘客实际多等了多久,数据都还没有直接回答。
先说结论
- 福塔莱萨过滤后保留约9.1万次公交行程,分母是过滤前约23.8万次;都柏林用同一套规则留下6.5万次。按10米等长分段后,耗时呈重尾。引言把不同线路概括为:较均匀时,20%的路程用掉约35%的时间;较不均匀时用掉约65%。图3里最不均匀的一次行程,在20%路程处大约累计了70%的时间。经典的80/20没有出现。
- 一周工作日里,基尼系数的平均值在早晨和傍晚抬升。都柏林的日内平均曲线多位于福塔莱萨之上,两城的标准差阴影却大范围重叠。图中纵轴刻度在0.30到0.55之间。论文没有另给两城全部行程的基尼均值。
- 相对延误比例D的分母,是同一线路全部车辆的平均行程时间。直线拟合为:福塔莱萨 G=0.38+0.24D,都柏林 G=0.44+0.13D。截距是D=0时直线上的基尼系数,不是城市均值。散点很宽,正文没有给出相关系数。
- 福塔莱萨650I路的五次行程,图上标出的幂律(power law,双对数坐标上接近直线的重尾)指数α为1.89、1.92、2.08、2.51和3.00。论文给出的数学关系是:α从大于2的一侧靠近2时,基尼系数靠近1。其中两次拟合已经低于2。
- 两城全部行程的基尼分布都是单峰。科尔莫戈罗夫–斯米尔诺夫检验(Kolmogorov–Smirnov test)的p约为0,正态假设被拒绝。福塔莱萨峰度1.9493、偏度0.5485;都柏林峰度1.450、偏度−0.0282。
全程只记一个小时,会把路段差异加没
通勤研究里常被引用的是全程时间。论文用两项既有统计说明这个量有多重要,它们不是这次定位数据重新测出来的:巴西大城市平均通勤41分钟;最穷的出行者比最富的多花近20%的时间;最穷的人里有19%通勤超过一小时,最富的人里这一比例是11%。英国的一项研究则把通勤增加20分钟,在工作满意度上比作减薪19%。全程时间分不清多出来的那些分钟是均匀摊在整条路上,还是卡在少数路口。
要分辨的说法,是帕累托原则(Pareto principle)在公交上的版本:完成一次行程时,会不会用80%的时间只走完20%的路程。匀速行驶时,20%的路程只对应20%的时间。后文测到的比例落在这两条参照之间。
定位的是公交车,刷卡只用来对齐起终点
分析单位是公交车的一次行程,不是一名乘客从家到单位的出行链。福塔莱萨约有350条公交线路,论文给出的城市面积是314平方公里,并说明公交是当地主要公共交通方式。车载全球定位系统(Global Positioning System,GPS)来自市政府,覆盖2016年4月12日至17日,周二到周日,约2100万个点,大约每30秒记一次位置。乘客智能卡在本文里不统计上下车人数。公交公司员工记下每趟的出发和到达,再靠车辆编号把起止时刻和定位轨迹对齐,得到约23.8万次行程。
去掉噪声用了三条规则,满足任一条件就整趟删除:某一刻速度超过120公里/小时;全程短于5公里;用时短于30分钟或长于3小时。之后约9.1万次进入分析。约9.1万除以约23.8万,大约留下38%;两个都是论文里的约数,这个百分比只说明过滤很严。留下的是中长距离、且没有被判为超速异常的行程。短驳线路不在这套结论里。
都柏林数据来自爱尔兰开放数据,2013年1月1日至31日,约3700万个定位点,点里已经带有线路编号和行程编号。论文没有写都柏林的采样间隔,也没有写过滤前有多少次行程。同一套三条规则之后留下6.5万次。
| 城市 | 时间 | 定位规模 | 进入分析的行程 |
|---|---|---|---|
| 福塔莱萨 | 2016年4月12–17日,周二至周日 | 约2100万个点,约每30秒一次 | 约9.1万次;过滤前约23.8万次 |
| 都柏林 | 2013年1月1–31日 | 约3700万个点 | 6.5万次;过滤前次数正文未给 |
两座城市的年份、天数和数据组织方式都不同。后面的城市对比要放在这个前提下读。
同样是10米,为什么还要重新切一遍?
原始定位点之间的距离Δs和时间Δt并不相等。若直接比较这些原始间隔,两段点之间隔得远,就会天然占掉更多时间,分不清是路段本身慢,还是采样间距本来就长。
每条轨迹因此被重新切成等长的Δs。图2和图3写明这段长度为10米。每一小段的新耗时Δt由相邻原始点线性插值得到。线性插值把两个定位点之间的时间按距离比例摊开,相当于假定这段路上速度不变。福塔莱萨大约30秒才有一个点。短于这个间隔的急停,会被摊到前后的10米小段上。算出来的不均匀,是插值之后仍能看见的不均匀。
有了等长小段,就可以套用收入不平等的算法。收入基尼系数看的是,占人口一定比例的人累计占有多少财富。这里每10米相当于一个人,这一小段用掉的秒数相当于他的财富。把Δt*从大到小排列,累计时间除以全程时间,得到纵轴;累计路程除以全程长度,得到横轴。这条曲线叫洛伦兹曲线(Lorenz curve)L(s)。匀速时它与对角线E(s)重合,基尼系数为0。若全部时间都花在唯一一段10米上,基尼系数达到上界1。
基尼系数是这条曲线与对角线之间面积的两倍:
G = 2 ∫₀¹ [L(s) − E(s)] ds,并且 0 ≤ G ≤ 1。
耗时从大到小累计,慢的路段先进入曲线,所以L(s)画在对角线上方。
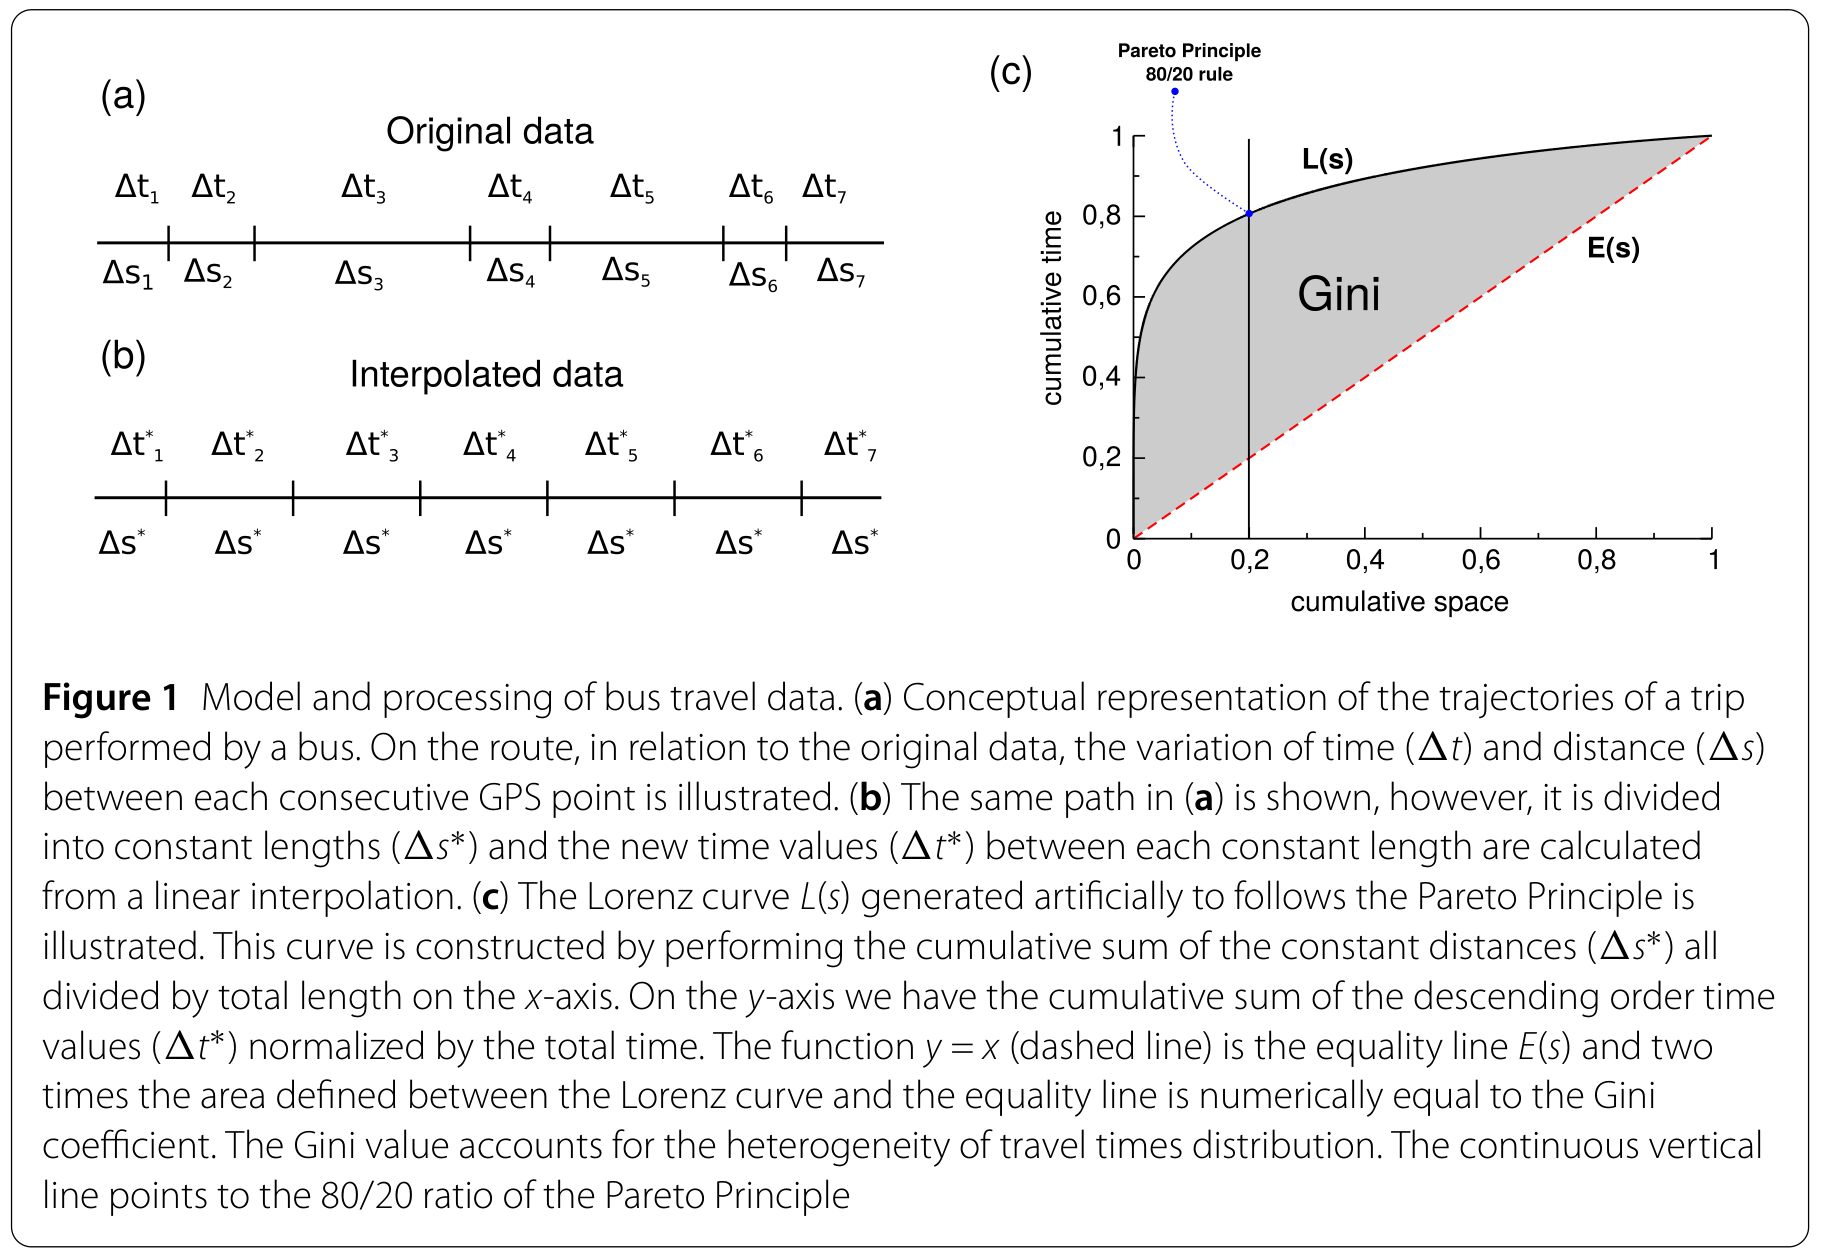
图 1|怎样把一趟公交的路程和时间,变成一个0到1的不均匀指数?
(a)原始定位上,相邻点的时间间隔Δt和距离间隔Δs长短不一。(b)同一条轨迹被切成等长的Δs,每段耗时Δt由线性插值得到。(c)一条按帕累托80/20画出的示意洛伦兹曲线:横轴是累计路程比例,纵轴是按耗时从大到小累计的时间比例;虚线E(s)是匀速对角线,灰色面积的两倍为基尼系数,竖线标在路程比例0.2。这张图是方法示意,曲线不是某次真实行程。来源:原论文 Fig. 1。
早高峰的地图上,慢速是一段段亮起来的
把这个切分用到福塔莱萨7:00至9:00的多趟车上,耗时沿路网的分布就能看见。图2(a)给每10米涂上log₁₀Δt,色标刻度从10⁻¹秒到10²秒。图2(b)抽出75路的一趟,标出起点和终点,颜色是Δt的对数。图2(c)把这趟车按空间序号排开:横轴序号画到1500附近,按每格10米大约是15公里,这是从图轴和分段长度得出的长度,论文没有另报这趟车的官方里程。纵轴是秒。少数尖峰明显高于周围,最高的一根超过100秒,多数路段贴近底部。
超过100秒才走完10米,这一小段几乎是停着的;大约1秒走完10米,则接近36公里/小时。换算只为了读图,论文没有把某个速度写成质量合格线。这张图回答慢出现在哪里。它还没有说明这种形状有多普遍,也还没有和晚点放在一起。
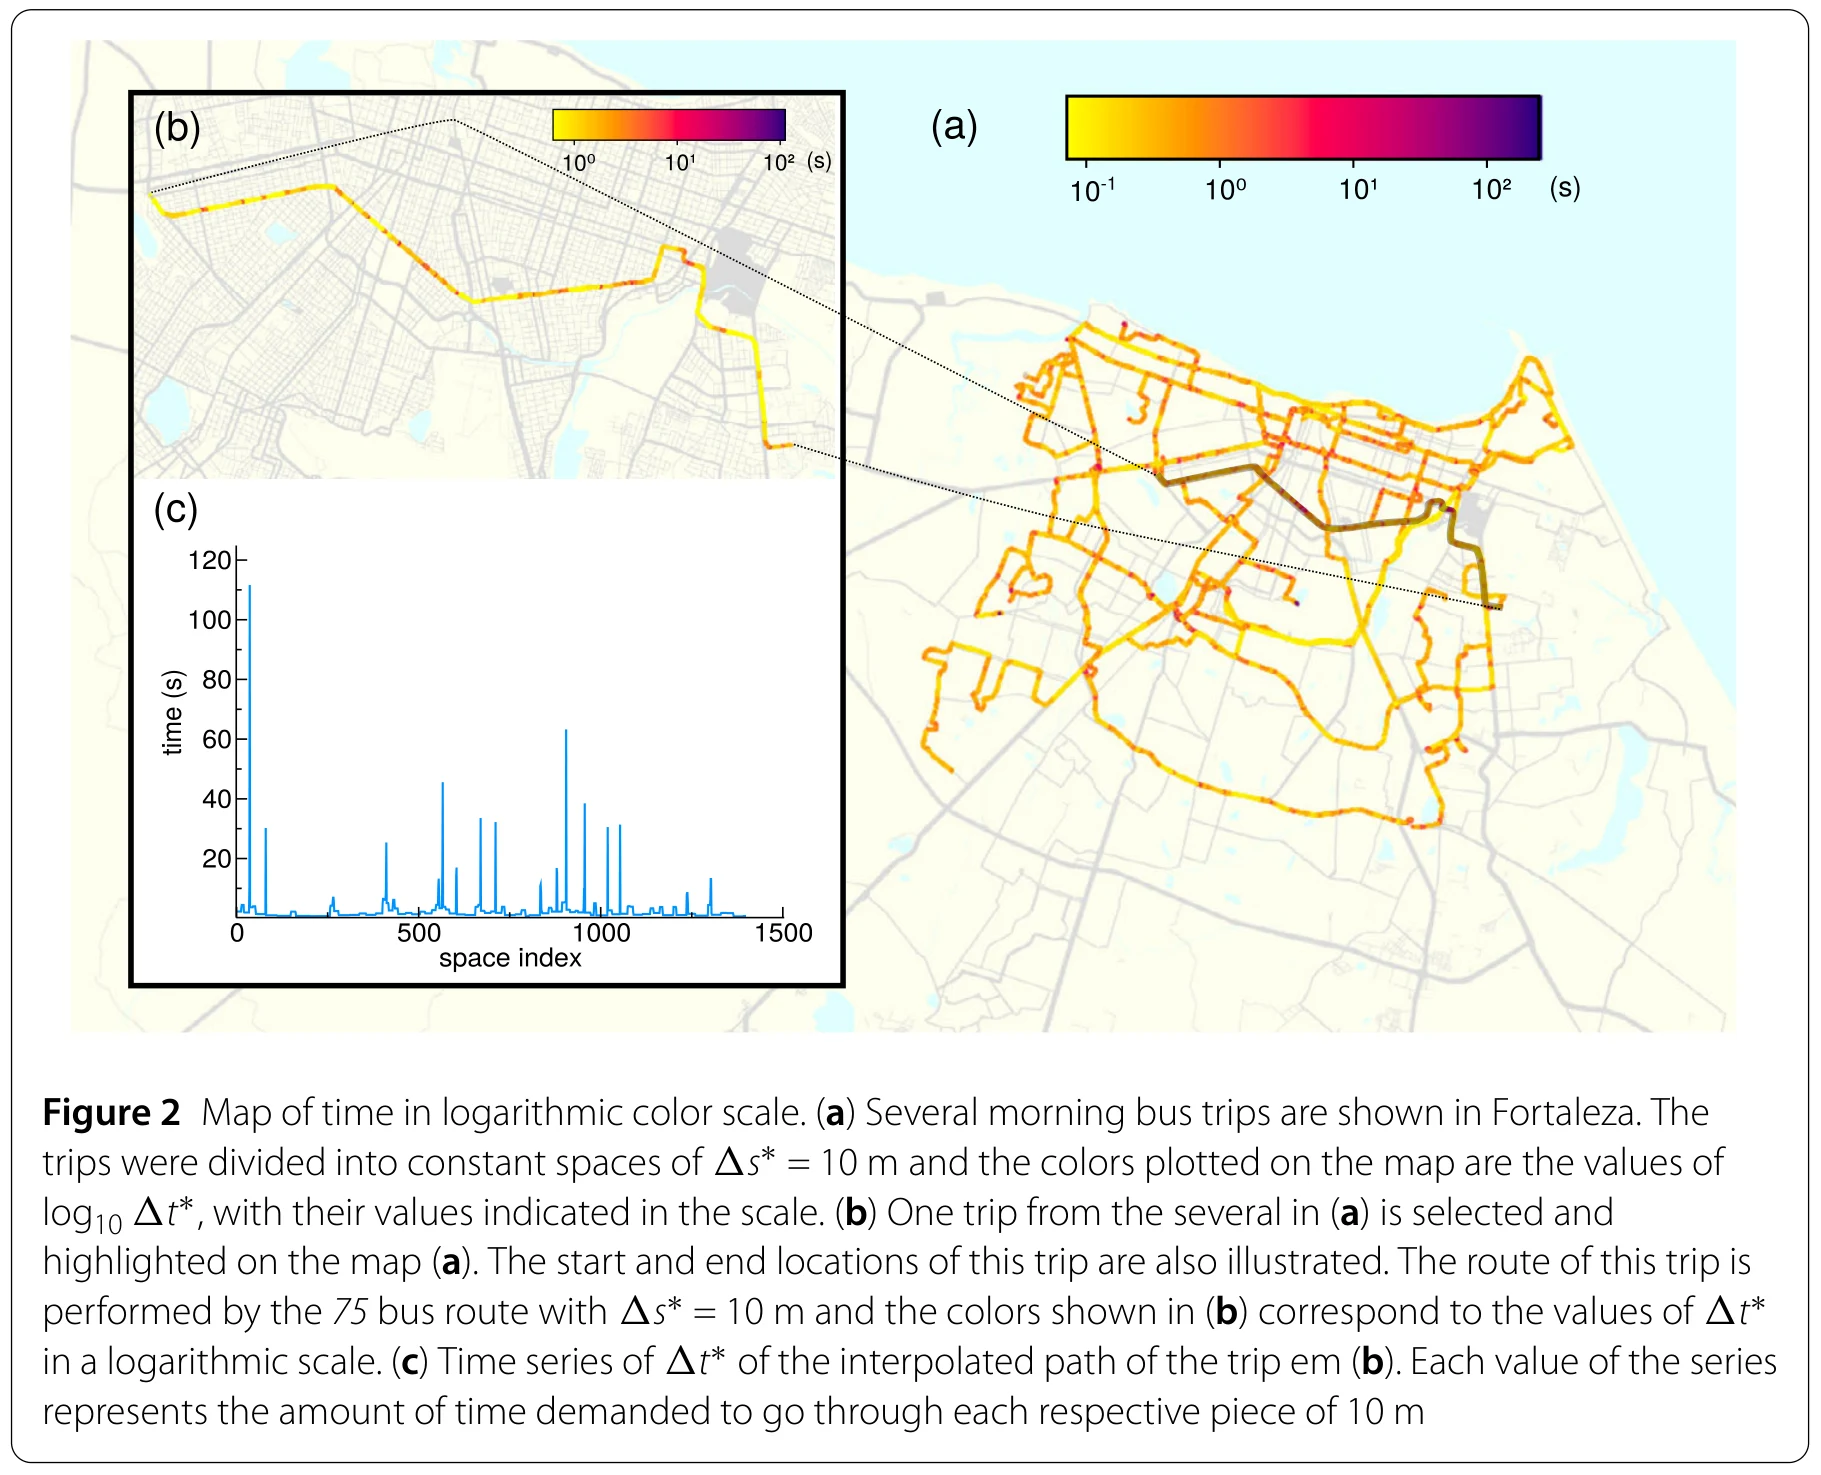
图 2|早高峰的耗时,是均匀铺在路上,还是堆在少数位置?
(a)福塔莱萨7:00–9:00的多趟行程,每10米涂上log₁₀Δt,色标从0.1秒到100秒。(b)其中75路的一趟,标出起点和终点,颜色是Δt的对数。(c)这一趟每10米的耗时,空间序号约到1500,少数尖峰超过100秒。来源:原论文 Fig. 2。
20%的路,实际累加到多少时间?
尖峰是不是重尾,要看全部小段排下来的形状。齐夫图(Zipf plot,按从大到小的排名作图)把每10米的耗时从大到小排名,排名1是最慢的一段。双对数坐标上,这些行程大体沿直线下降。图中虚线的斜率是−0.5,它是参照线,不是每条行程各自拟合的指数。纵轴从大约1秒延伸到上百秒。
同一批行程的洛伦兹曲线都在对角线上方。结果部分写明:最不均匀的一次,走完20%的路程大约用掉70%的时间。引言则把不同线路的范围概括为,20%的路程对应约35%到约65%的时间。35%和65%是引言里的线路概括,70%是图3中最靠上的那次行程;均匀基线是20%对应20%,帕累托参照是20%对应80%。测到的曲线位于这两条参照之间。
基尼系数因而能分开这些行程。它量的是时间在等长路段上的分散。乘客是否觉得这趟车可靠,还要另有证据。
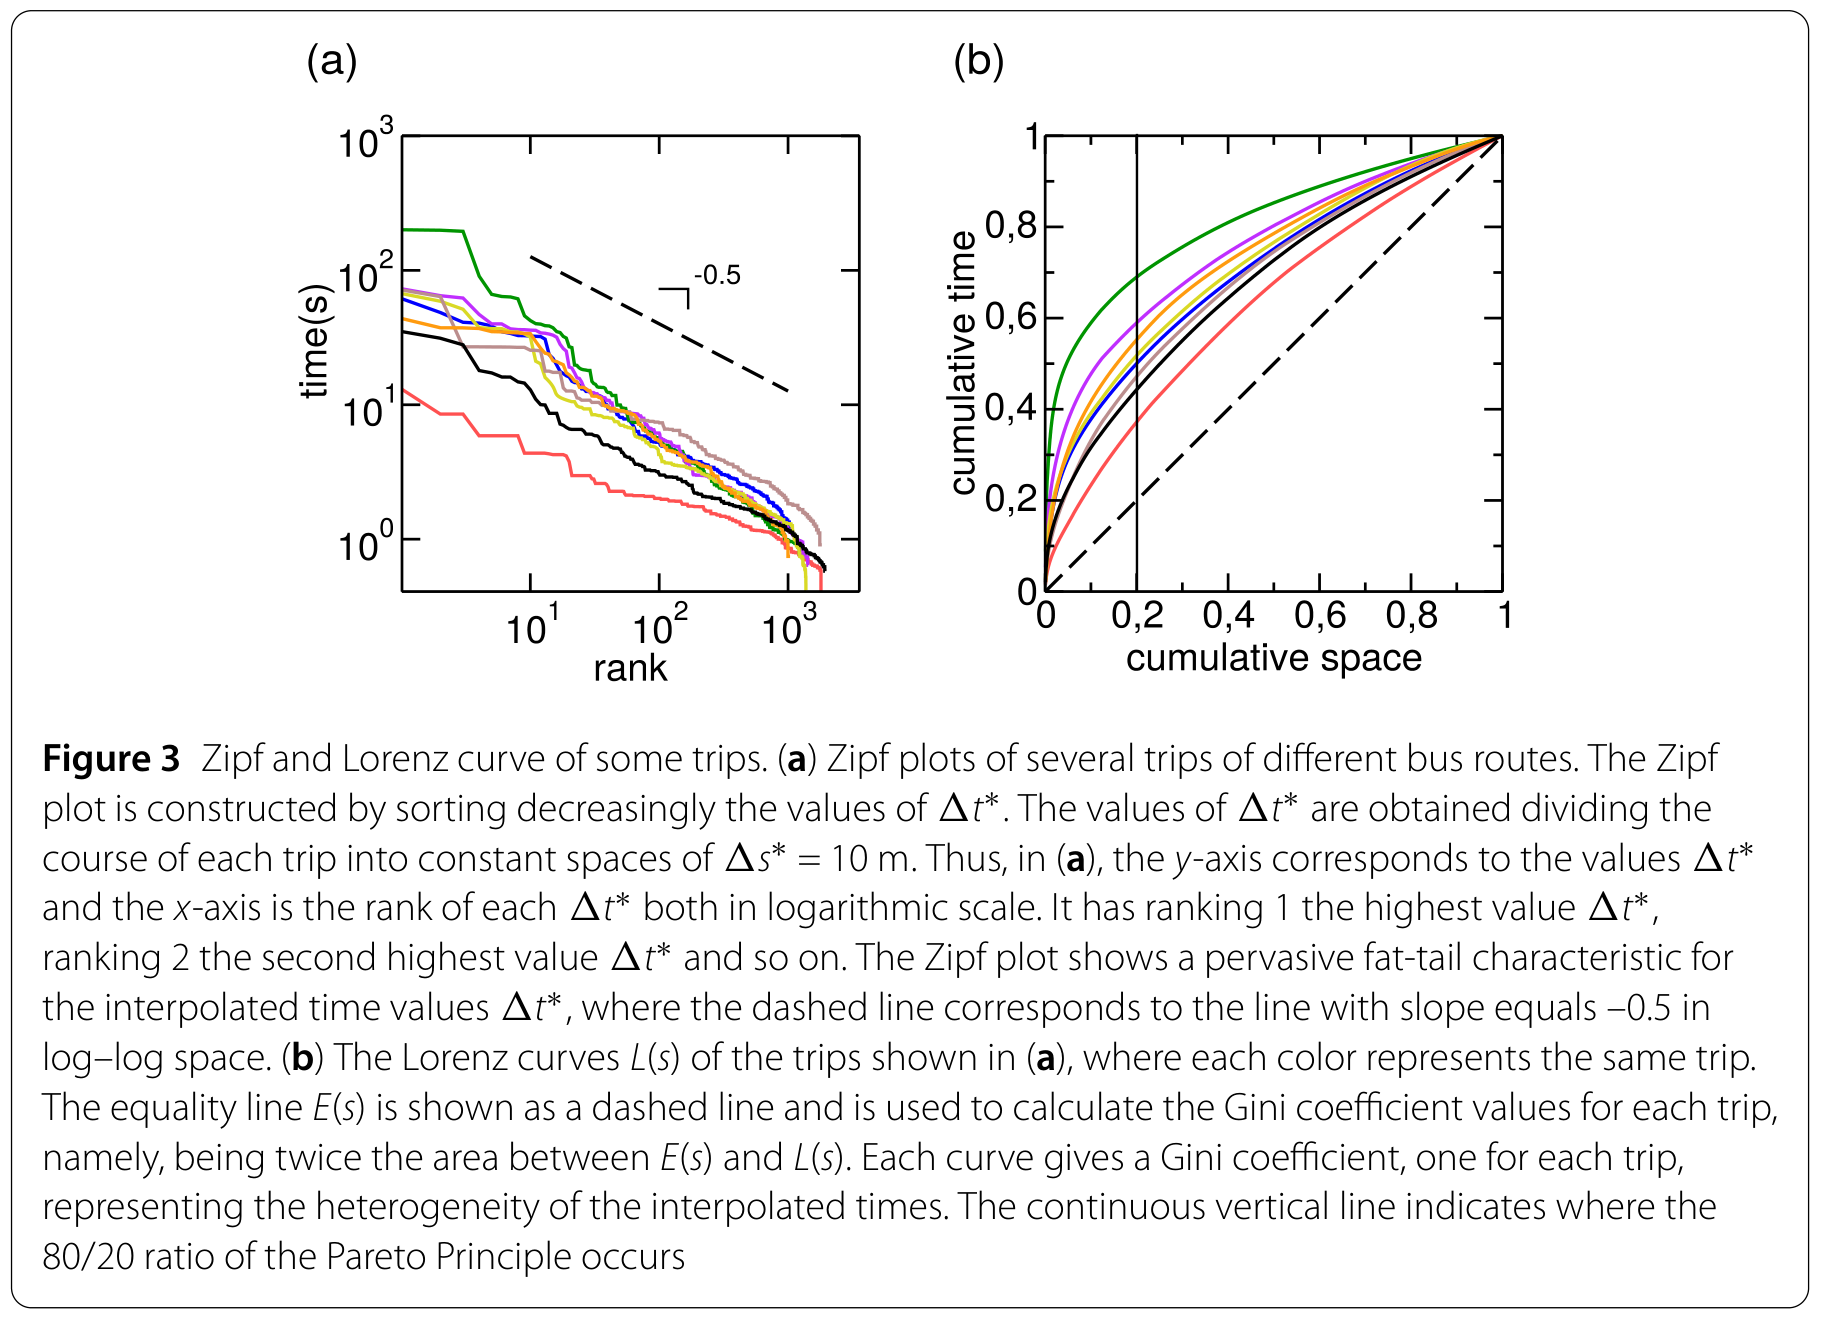
图 3|重尾有多斜,20%的路程累加到多少时间?
(a)若干不同线路的齐夫图。横轴是Δt*的排名,纵轴是每10米的秒数,都取对数;虚线斜率为−0.5,用作参照。(b)与(a)同色的洛伦兹曲线。虚线是匀速对角线,竖线在累计路程0.2处;最上方的曲线在这里大约到达0.7,对应正文所说的约70%时间。来源:原论文 Fig. 3。
高峰会把基尼系数抬高,相对延误呢?
若这个指数能反映运行状况,它会在人多车多的时候变高,并和“这趟车比本线平时更慢”同向变化。图4(a)只取两座城市各自一周工作日的行程,按等宽钟点分箱,画基尼系数的平均值,阴影是该箱均值加减标准差。福塔莱萨是蓝线,都柏林是红线。从图上读,两条平均曲线都在8时前后和17时前后抬升,夜间降到图的下部。都柏林的平均曲线在白天多数钟点位于福塔莱萨之上。阴影重叠很大,城市差异是平均位置的差异,不是每个钟点都能分开。讨论据此认为都柏林的基尼略高,并认为这可能说明福塔莱萨的道路运行更好。福塔莱萨是2016年的六天,都柏林是2013年的一个月,日内曲线又只取一周工作日。这个“更好”是对平均曲线方向的解读。
相对延误的分母决定它在比较什么。对跑固定线路的车辆Vᵢ:
D(Vᵢ) = (Tᵢ − ⟨T⟩) / ⟨T⟩。
Tᵢ是这趟车的全程时间,⟨T⟩是同一线路所有车辆的平均全程时间。D=0表示这趟用时等于本线路在数据里的平均;D=1表示比该平均多用100%的时间。论文在行文里把D说成计划运行的延误,公式比较的是本线路观测到的平均用时。
图4(b)的每个点是福塔莱萨的一次行程,图4(c)是都柏林。直线为:福塔莱萨 G=0.38+0.24D,都柏林 G=0.44+0.13D。另一条实线是纳达拉亚–沃森非参数回归(Nadaraya–Watson regression,用附近的点平滑出一条平均曲线),它不假定关系一定是直线。插图是D的分布,堆在0附近;福塔莱萨插图的横轴大约从−0.5到2,都柏林大约从−1到1.5。点云上下很散,同样的D可以对应很不同的G。正文没有报告相关系数。斜率只在这条直线上有直接含义:D每增加1,拟合的基尼系数在福塔莱萨增加0.24,在都柏林增加0.13。截距0.38和0.44是D=0时的拟合值。
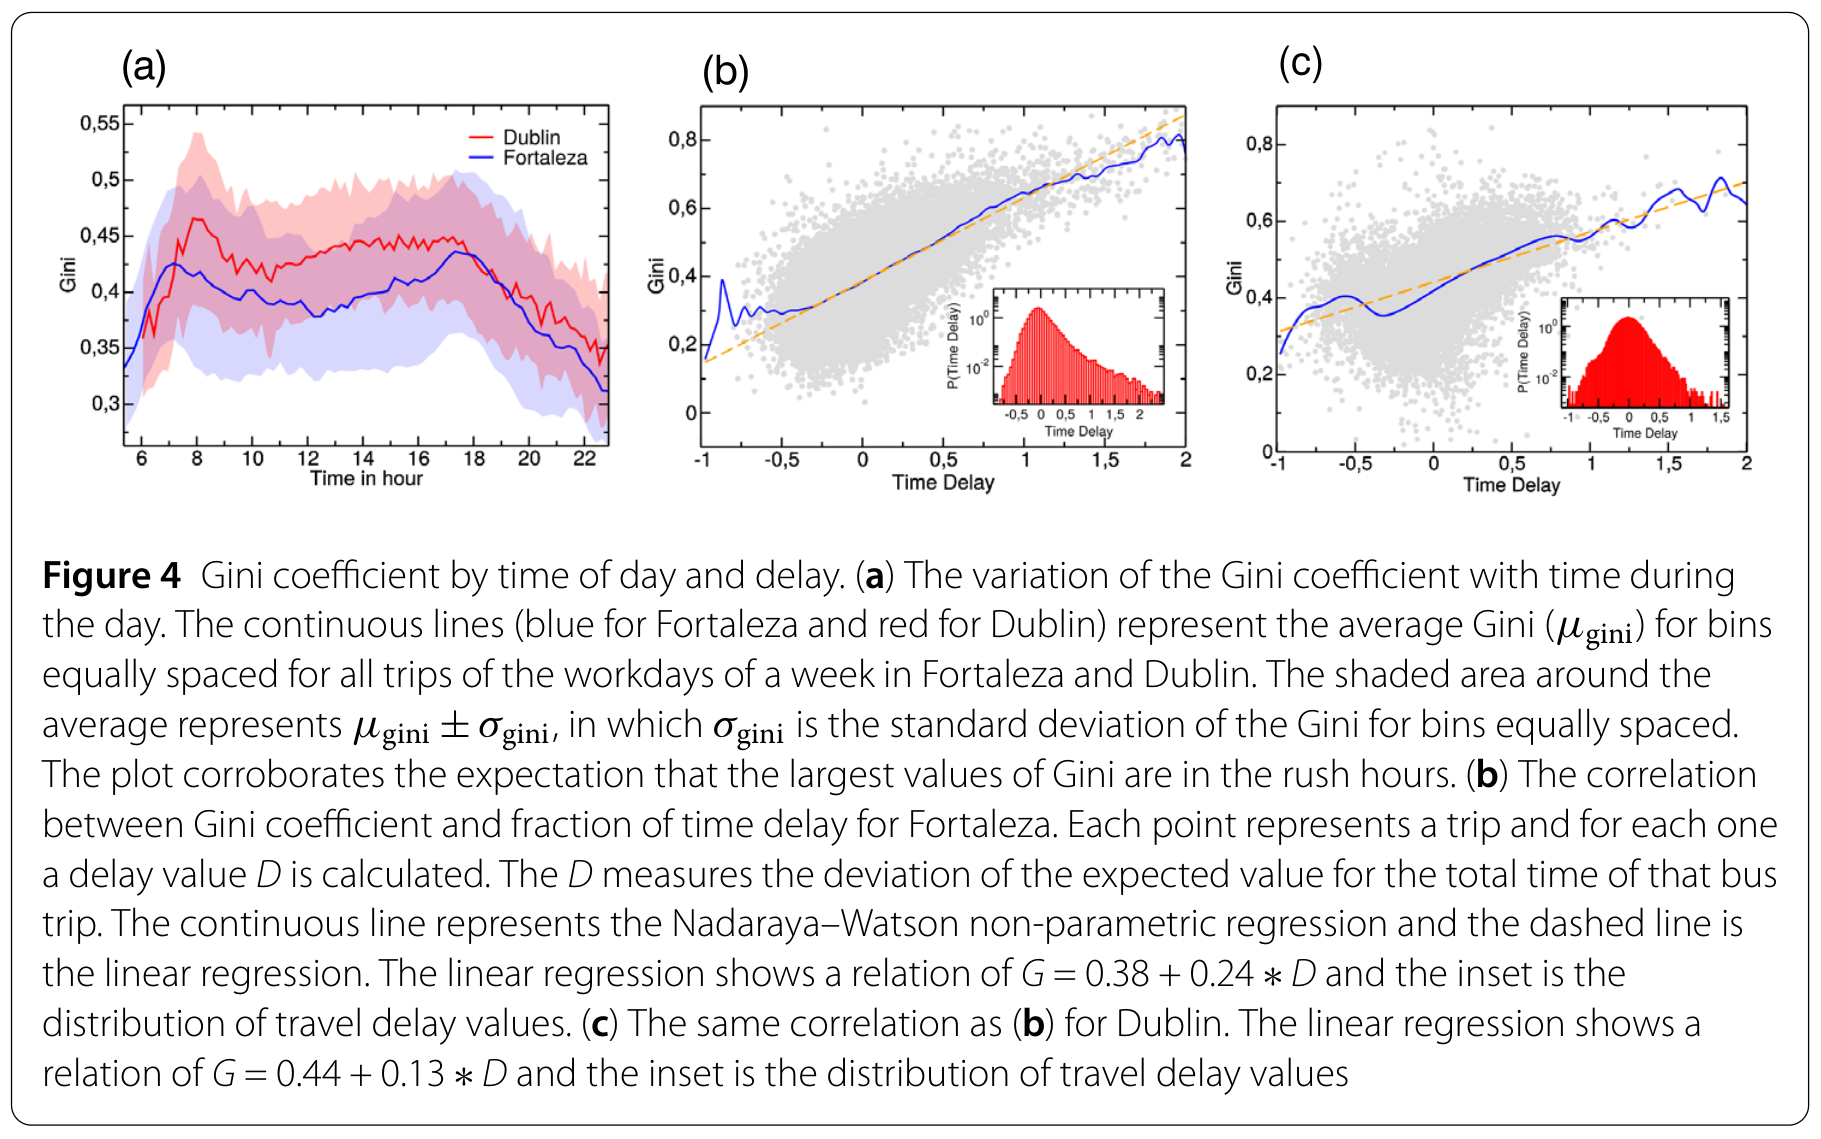
图 4|基尼系数是否赶在高峰,并随着相对延误上升?
(a)横轴是钟点,大约从6时到22时;纵轴是基尼系数,刻度从0.30到0.55。蓝线为福塔莱萨,红线为都柏林,均是一周工作日、等宽钟点箱里的平均基尼;阴影是均值±标准差。(b)福塔莱萨每次行程的D与G。虚线为G=0.38+0.24D,实线为非参数回归,插图是D的分布。(c)都柏林的同样关系,虚线为G=0.44+0.13D。来源:原论文 Fig. 4。
同一条650I,五次行驶已经是五种重尾
平均关系盖住了同一条线路内部的差别。论文以福塔莱萨650I路为例,并说明其他线路的细节放在补充材料里。正文图上是五次行程。
图5(a)用颜色画出这五次沿路线的Δt。最耗时的位置,也就是色标偏黄的地方,大体落在相近的路程区域,色标大约从0.1秒到100秒。图5(b)是这五次的分布,双对数坐标,各自拟合幂律 p(Δt)=a (Δt*)⁻ᵅ。图上标出的α为1.89、1.92、2.08、2.51、3.00。两条虚线的斜率是−2.0和−3.0,用来对照,不是这五次的拟合线。图5(c)把650I各次行程的α和全程分钟数放在一起,虚线是纳达拉亚–沃森平均:α越靠近2,全程时间越长。
幂律概率密度的指数α与基尼系数有数学联系。论文写的极限是:α从大于2的一侧趋近2时,G趋近1。α=2同时是这类分布均值发散的边界。五次行程里,2.08、2.51和3.00位于这条极限适用的一侧;1.89和1.92已经低于2。低于2的拟合,不能再解释成正从大于2的一侧把基尼系数推向1。正文没有报告幂律拟合的下限和截断方式,也没有报告这五次拟合自己的优度检验。
同一条线路就有从1.89到3.00的指数,一个线路平均数会把这五次压扁。图5(a)里慢点位置的重复,引出下一步要分清的事:慢是绑在固定地点上,还是每次换地方。正文对650I的观察偏向前者,范围是这五次行程。
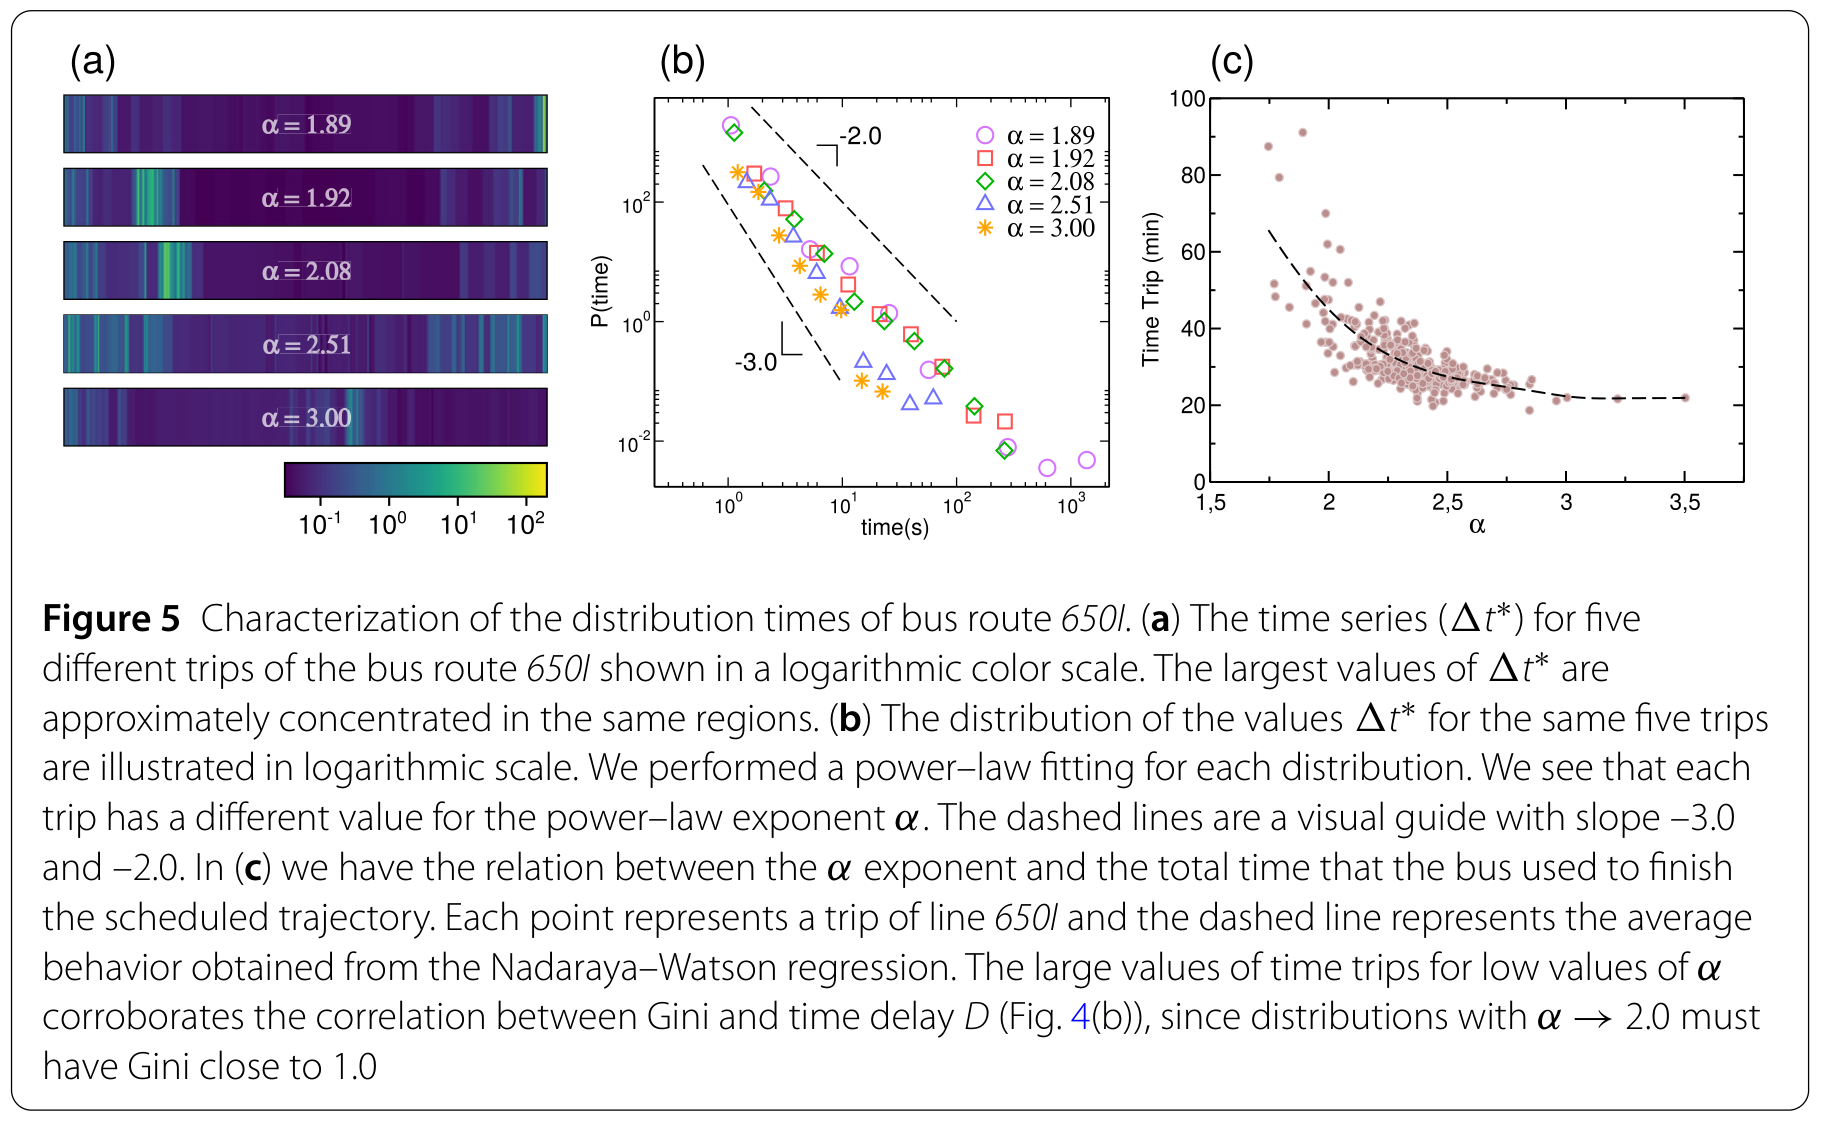
图 5|同一条650I,五次行程的耗时分布差多远?
(a)五次行程的Δt*沿路线的颜色图,标出的α为1.89、1.92、2.08、2.51、3.00;色标大约从0.1秒到100秒,黄色对应更长的耗时。(b)同五次行程的分布,横轴为秒,纵轴为概率密度,均取对数;图例中的α与(a)一致,虚线斜率为−2.0和−3.0。(c)650I各次行程的α与全程时间,纵轴单位是分钟,虚线为非参数平均。来源:原论文 Fig. 5。
指数靠近2时,相对延误一起升高
把保留下来的行程放在一起,α和相对延误的关系仍在。图6(a)是福塔莱萨,纵轴延误比例的刻度大约到4;图6(b)是都柏林,刻度大约到2。每个点是一次行程,曲线是纳达拉亚–沃森平均。两座城市都是α趋近2时平均延误比例处于高位,α继续增大后曲线回落。福塔莱萨靠近2的那一侧升得更陡,都柏林的抬升更温和。论文据此认为,从规划角度看,一条较好的线路需要α明显大于2。α是Δt*分布的拟合参数,它描述已经发生的耗时如何集中,本身不是一条被直接观测到的道路属性。
图6(c)是两城全部行程的基尼系数概率密度。福塔莱萨为蓝,都柏林为红,虚线是各自的统计拟合。两条都是单峰,都柏林整体更靠右,和“都柏林略高”同向;纵轴刻度到7。看起来接近正态,检验不支持把它们当成正态曲线。科尔莫戈罗夫–斯米尔诺夫检验对两城都得到p约为0,正态假设被拒绝。峰度和偏度一并给出:福塔莱萨峰度1.9493、偏度0.5485;都柏林峰度1.450、偏度−0.0282。福塔莱萨更不对称。论文没有说明峰度是否已经减去正态基准3,这里只保留原数。
样本量是数万次行程。在这样的样本量下,很小的形状差别也可以把正态检验的p压到接近0。拒绝正态的直接含义是:不能用严格的正态尾部去外推极高或极低的基尼系数。图本身仍然显示,这些行程的基尼系数集中在0到1区间的中部。
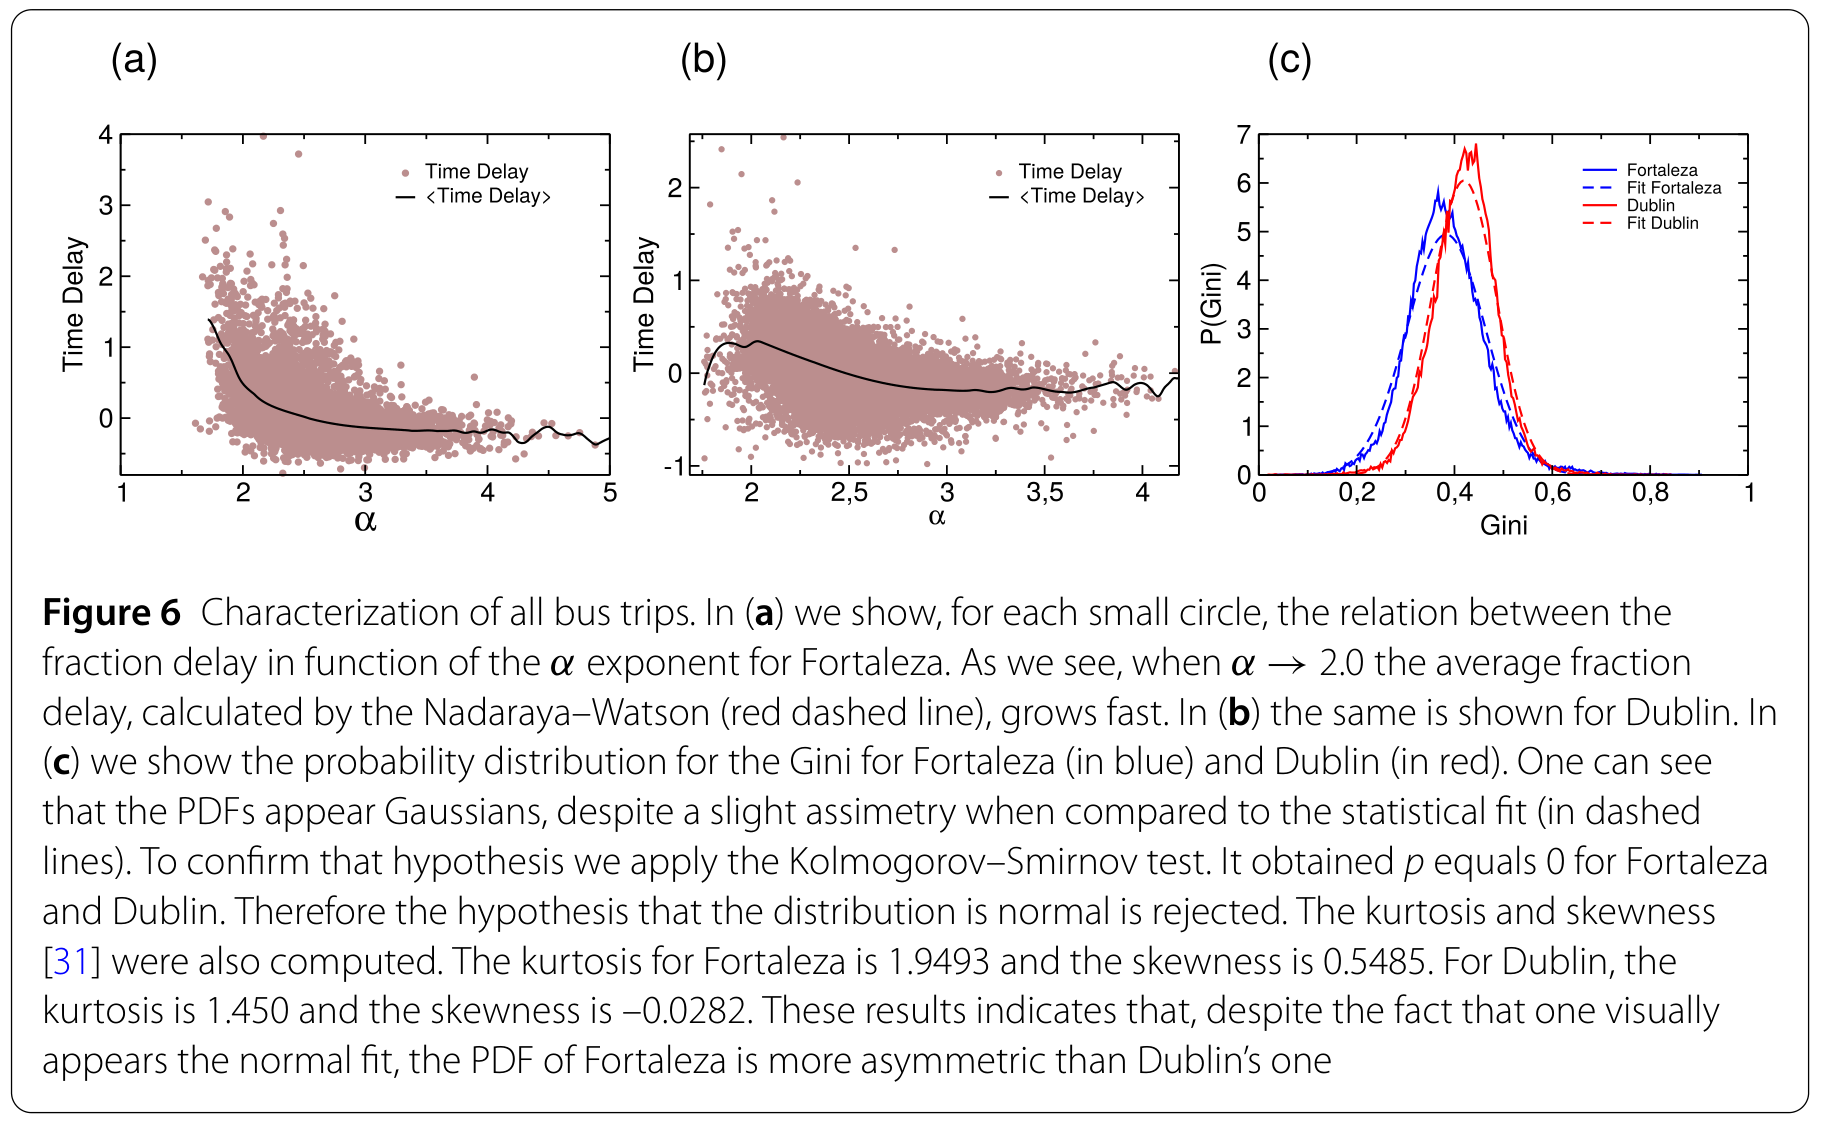
图 6|全部行程上,幂律指数和基尼分布各是什么形状?
(a)福塔莱萨每次行程的α与延误比例,曲线为纳达拉亚–沃森平均;α靠近2时平均延误比例升高。(b)都柏林的同样关系,纵轴刻度比(a)更窄,靠近2时的抬升更温和。(c)基尼系数的概率密度,蓝为福塔莱萨,红为都柏林,虚线为统计拟合。两城正态假设均被p约为0的检验拒绝。来源:原论文 Fig. 6。
这些结果能用到哪一步
基尼系数与高峰、与相对延误同向,这是文中最扎实的经验结果。同向是行程之间的相关。一次行程的G偏高,可能来自拥堵、信号或停站,也可能来自这趟车自己的开法。数据没有把这些原因拆开。
D的分母是本线路平均用时。一条每天都慢的线路,各趟车的D可以都接近0,基尼系数却不必低。乘客感受到的“比时刻表晚了多久”,需要一份计划时刻才能计算。现在的D是相对本线观测平均的偏离比例。
10米和线性插值决定了分辨率。大约30秒一次的定位会把更短的停靠摊开,图上的尖峰是摊开之后仍然突出的尖峰。速度超过120公里/小时的行程被整趟删除,短于5公里、短于30分钟或长于3小时的行程也不在样本里。数值描述的是留下的约9.1万次和6.5万次。
城市比较受同样的样本限制。都柏林基尼略高,发生在不同年份、不同天数的两套公交定位之间。讨论用它打开用基尼系数比较城市的可能性。这是平均曲线的方向,不是两座城市在同一周、同一套调度下的对照。
幂律解释了为什么少数路段能支配全程时间,也给出α从大于2靠近2时基尼系数靠近1的数学边界。拟合还不是机制证明。正文没有报告每次幂律拟合的统计检验。补充材料被用于其他线路的细节,正文展开的例子是650I的五次行程。
讨论里还有两步没有在这套数据里做。一步是微干预:只改轨迹中很小一部分路段,并期望重尾带来较大改善。另一步是用基尼系数给油耗和污染分类;文中依据的是既有文献里速度变化与排放的关系,本文没有排放测量。
一句话总结
公交全程的时间会集中到少数等长路段上,集中程度可以用基尼系数刻画,并与高峰、以及相对本线平均用时的偏离同向;这种集中没有达到80/20,也还不是线路质量的因果结论。
核心来源
- EPJ Data Science正式版,Ponte、Melo、Caminha、Andrade Jr.、Furtado,2018,7:42。题目、作者、DOI、收稿与接收日期、六张图和正文数值以该版为准。
- 福塔莱萨的定位和行程起止来自市政府。论文写明,支持这些结果的数据可向通讯作者合理申请。都柏林定位为开放数据:Dublin Bus GPS sample data,论文标注的访问日期为2016年10月6日。
- 650I一节写明,其他线路的更多细节见补充材料。正文图只展开了这条线路的五次行程。
作者介绍
论文写明五位作者贡献相同。下面只写署名单位,以及能从本文和文末资助说明里核对的信息。参考文献里,同一组研究者此前用过福塔莱萨公交定位、乘客验证和犯罪相关数据。
- Caio Ponte:通讯作者,福塔莱萨大学(Universidade de Fortaleza)应用信息学研究生项目。论文列出的邮箱是 caioponte@edu.unifor.br。
- Hygor Piaget M. Melo:塞阿拉联邦教育、科学与技术学院阿卡劳校区教学系(Instituto Federal de Educação, Ciência e Tecnologia do Ceará, Acaraú)。
- Carlos Caminha:福塔莱萨大学应用信息学研究生项目,与Ponte同一署名单位。
- José S. Andrade Jr.:塞阿拉联邦大学(Universidade Federal do Ceará)物理系。资助说明中,他还得到巴西复杂系统国家科学技术研究所(INCT-SC)的经费。
- Vasco Furtado:福塔莱萨大学,与Ponte、Caminha同一署名单位。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
650I的五次行程把最慢的颜色画在相近位置。若换更多日期、更多车辆之后,这些位置仍然重合,慢点就更像路口、站台或信号,值得按地点做小范围改造;若换一辆车、换一天,慢点就换地方,则更应查驾驶和调度。正文只给了这一条线的五次图像。要把这两种可能分开,需要按车辆编号和日期把慢点对齐,再看重合是否稳定。
另一个能直接计算的对照,是更换D的分母。现在的分母是本线平均用时,一条永远慢十分钟的线路可以有接近0的D,乘客却每次都多坐这十分钟。若改用计划时刻,或用刷卡次数给行程加权,基尼系数和D的斜率如果明显变小,现在这条直线就更多反映了低客流时段的车速波动。智能卡记录已经存在,本文没有用它做这个加权。这个比较能告诉规划者,眼前的不均匀主要落在谁的乘车时间里。