出租、地铁和公交叠在一起,行程距离还会剩同一种规律吗?
论文名片|Shixiong Jiang、Wei Guan、Wenyi Zhang、Xu Chen、Liu Yang,Human mobility in space from three modes of public transportation,Physica A,2017,483:227–238。2016年11月29日收稿,2017年4月28日修回,2017年5月5日在线发表。DOI:10.1016/j.physa.2017.04.182。这是对北京出租车、地铁和公交行程位移的观测拟合。
两公里的路程,很多人会拦出租车;十五公里,地铁往往更说得通。若把全城公共交通画成一条距离曲线,公交会占满近处,地铁会把高峰推向更远。下面的数字来自北京2014年末到2015年春的行程记录。曲线描述的是许多次行程叠在一起以后的形状。
三种方式各自的位移分布并不相同。按2014年客运量比例混合之后,16公里以内更符合一条下降很慢的幂律,更远的尾部更符合指数衰减。这是行程混合物的统计形状,还没有识别乘客为什么选这种方式,也没有还原同一个人的全天轨迹。
先说结论
- 出租车行程的样本平均位移是6.53公里。短于20公里的占96.04%,超过20公里的占3.96%,分母是出租车行程。去掉最前面上升的一段后,2–20公里和20–100公里都由指数分布得到赤池权重1,速率分别为0.1917和0.1768。
- 地铁行程的样本平均位移是15.15公里,超过20公里的占14.37%,分母是地铁行程。伽马分布的赤池权重为1,形状2.6450,尺度4.6318。
- 公交数据集中,短于10公里的占95.82%。在1–40公里上,指数分布的赤池权重为1,速率0.3183;同一张表里幂律的决定系数是0.9671,指数分布是0.9470。
- 按三种方式2014年客运量比例组成的1000万次融合行程中,1–16公里占85.18%,幂律指数0.7788;16–100公里占14.82%,指数速率0.1618。连同这次拟合在内的五次抽取,参数方差都小于10⁻⁵。
- 从地铁和公交里各抽40万次,把起点和终点改到站外随机点后,地铁仍用伽马分布、公交仍用指数分布描述。论文没有给出这组模拟的参数或检验统计量。
一次行程在这里量的是起终点直线距离
人类移动性(human mobility)在这里具体指一次公共交通行程有多远。每一条记录贡献一个起终点位移。地铁矩阵没有持卡人编号,公交卡号也没有被用来追踪同一个人;出租车只保留载客段的上车点和下车点。
出租车数据来自2015年1月12日至18日,超过4.6万辆车,共2,915,488次行程。到2014年底北京约有6.7万辆出租车,这批GPS覆盖其中68.66%,大约每分钟记一个点。一次行程是运营状态为载客的那段轨迹,位移只用上车点和下车点。
地铁数据来自2014年12月23日至25日,13,380,969次行程,论文写明这覆盖了该时段的全部地铁出行。记录不是原始刷卡,而是每半小时一张站间客流矩阵,再配上高德地图上的车站经纬度。同一站进出的行程被删掉。
公交数据来自2015年3月10日至12日的自动售检票记录,20,105,096条。2014年底北京有877条公交线路,数据包含666条,占75.94%。保留正常交易,且上车站、下车站必须属于同一线路、同一车辆。线路上公里标相同的邻站被合成一站,坐标取这些站的几何中心;论文没有给出被合并的站数。
三段数据的日期互相错开,所以换乘无法接回同一次出行。含换乘的完整旅程会被拆成两段或更多段,长行程变少,短行程变多。地铁和公交的位移停在车站,乘客走到车站之前、离开车站之后的路程不在记录里。
位移(displacement)按起点和终点的经纬度计算大圆直线距离,地球平均半径取6371公里,单位是公里。它不受路网绕行影响,因此便于和别的城市比较。沿路里程通常更长,绕行没有写进这个长度。出租车和公交还定义了行程时间,单位分钟;正文结果只报告位移。出租车删去缺少坐标的记录,以及行程时间长于120分钟或短于1分钟的记录。论文给出了这些规则,没有另行报告清洗后剩下多少次行程。后文的分布和模型选择都建立在清洗后的样本上,精确分母未单列。
候选分布包括幂律、指数、对数正态、伽马和威布尔。比较用赤池信息准则(Akaike information criterion,AIC):每个模型的得分等于负二倍对数似然,再加二倍参数个数。参数用极大似然估计。赤池权重把各模型的得分差距换成相对可能性,总和为1,权重最大的模型被选中。决定系数R²同时列出,用来看曲线和散点的贴合,但正式筛选看的是权重。
出租车为什么要先丢掉两公里以内的上升段?
出租车可以上门接送,上下车点比车站更接近乘客真正要去的地方,所以论文把它当作三种方式里最适合讨论行程位移的一种。样本平均位移6.53公里。概率从很短的距离往上走,在1.9公里达到高峰,然后下降。北京出租车起步价覆盖前3公里。论文引用约1.5的绕行系数,用高峰位移1.9公里乘这个系数,去对照这3公里;绕行系数来自别的研究,不是这批GPS估计出来的。
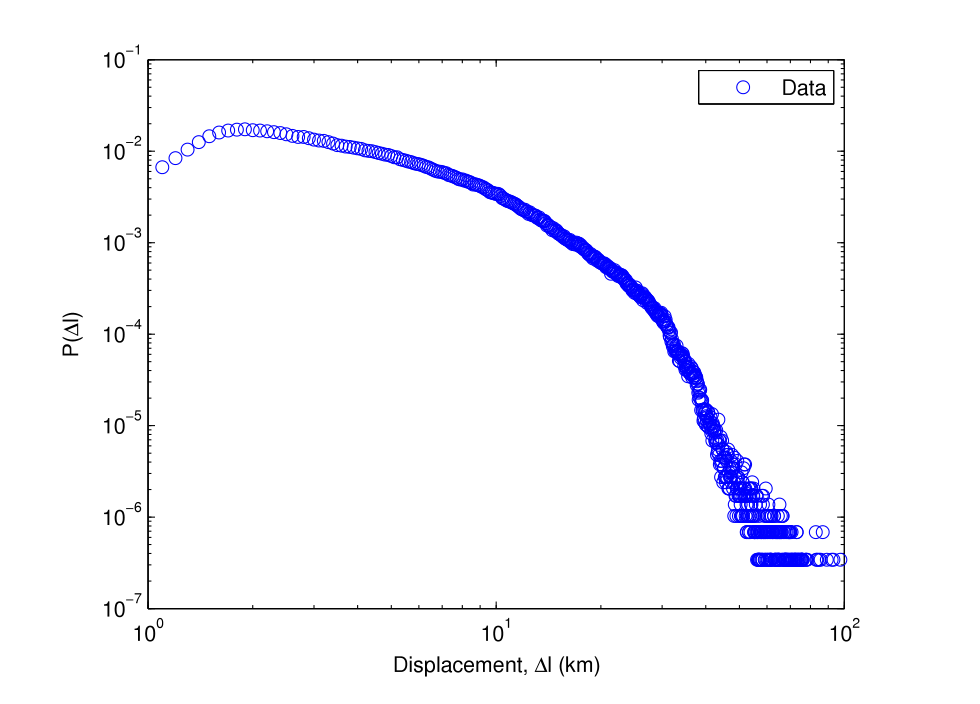
图 1|出租车行程的直线距离,整体长什么样?
无字母子图。横轴是位移,纵轴是论文绘制的P(Δl),两边都取对数;蓝圈为出租车行程。曲线在约1.9公里达到最高,之后下降,20公里以后只剩很薄的尾部。短于20公里的行程占96.04%,超过20公里的占3.96%。来源:原论文 Fig. 1。
幂律和指数都是单调下降的,套不住一开始的上升。论文因此参照既有出租车研究,以20公里为界,只拟合2–20公里和20–100公里。前一段被解释为更多发生在城区,后一段更多连接城区与郊区;这个解释沿用文献,本文没有用行政区边界逐条标注行程。
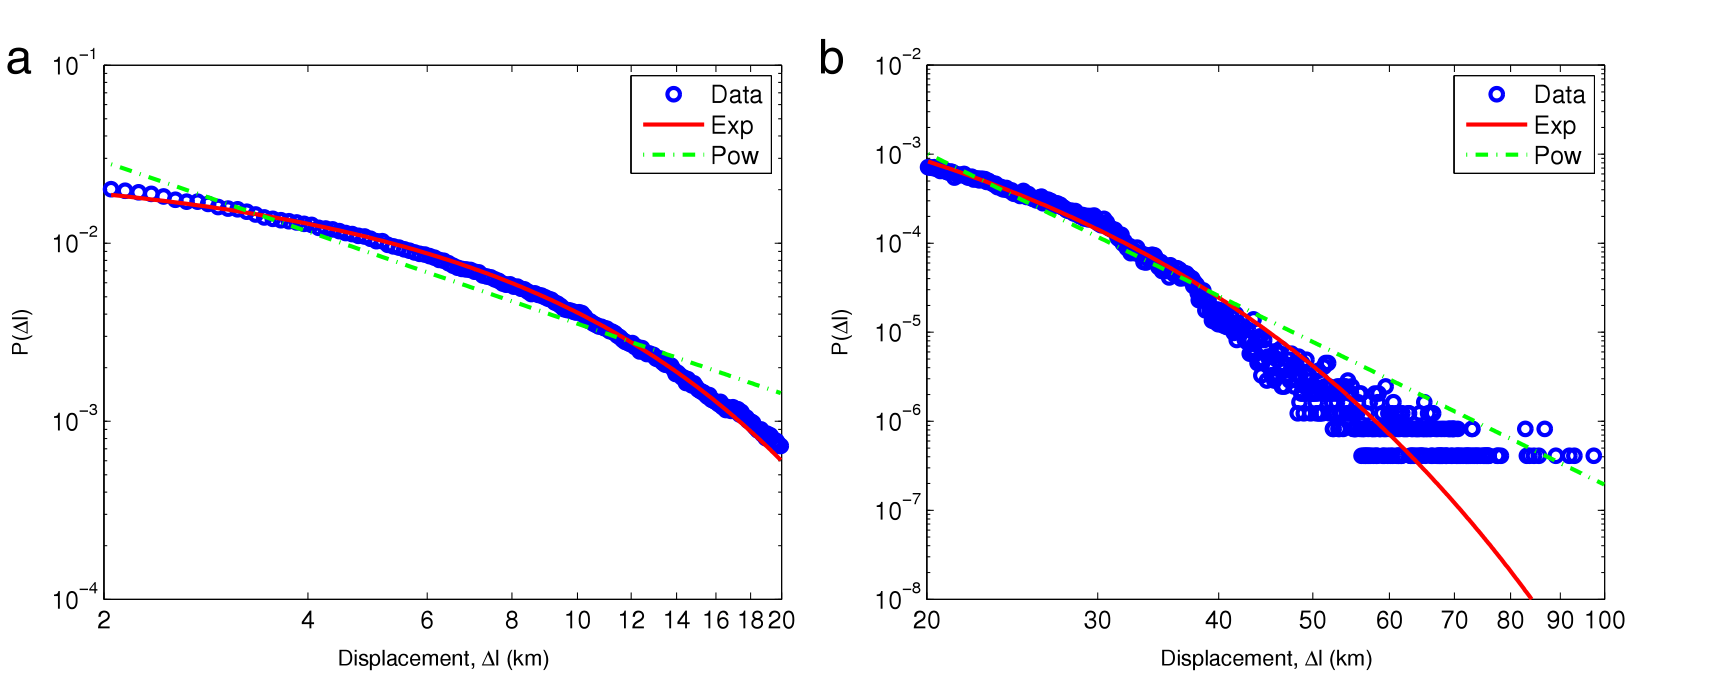
图 2|去掉上升段以后,出租车的两段距离各服从什么?
(a)2–20公里,横轴为普通刻度。红实线是指数分布,λ=0.1917,95%置信区间(0.1914,0.1921),R²=0.9985,赤池权重1。绿点划线是幂律,α=1.3016,R²=0.9662,权重0。(b)20–100公里。指数分布λ=0.1768,置信区间(0.1758,0.1778),R²=0.9896,权重1;幂律α=5.3238,R²=0.9510,权重0。后段散点在大约50公里以后明显变散,指数线落到部分散点下方。来源:原论文 Fig. 2。
两段都是指数分布胜出,后段速率更小。论文据此说短行程对距离更敏感,并与更早的出租车研究一致。速率不同描述的是这批行程的统计衰减,还没有测量票价弹性。超过20公里的行程只占3.96%,后段参数来自这一小部分。
地铁的高峰为什么出现在大约9公里?
地铁只能在车站进出,位移是上车站到下车站的直线距离。概率很快上升,大约在9公里达到高峰,样本平均15.15公里。超过20公里的行程占14.37%,高于出租车的3.96%。数据采集时地铁实行2元单一票价,但进出站要花时间。论文用票价结构和这种时间成本解释高峰的位置,没有在本文里估计一个选择模型。
幂律和指数无法同时容纳上升和长尾,因此比较改在伽马、威布尔和对数正态之间。
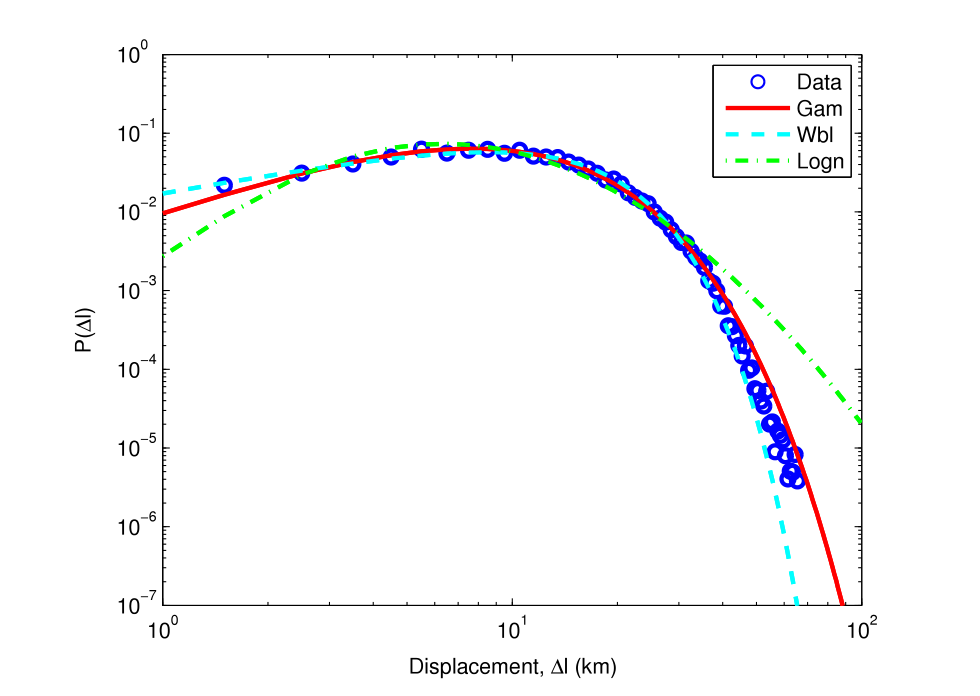
图 3|地铁行程的距离曲线,三种有峰分布谁更贴?
无字母子图。双对数坐标,蓝圈为地铁行程。红实线为伽马分布,k=2.6450,95%置信区间(2.6431,2.6469),θ=4.6318,置信区间(4.6282,4.6355),R²=0.9955,赤池权重1。青虚线为威布尔分布,a=13.7899,b=1.7501,R²=0.9934,权重0。绿点划线为对数正态,μ=2.3048,σ=0.6835,R²=0.9622,权重0。对数正态在长距离一侧高于散点,威布尔在尾部下降更快。来源:原论文 Fig. 3。
表2按正文公式把a称为威布尔的形状、b称为尺度。图3的青色曲线跟着大约9公里的峰走。论文没有再给出由这两个参数算出的众数,因此模型比较只采用赤池权重,不把1.7501公里读成地铁的典型位移。样本平均15.15公里是直接统计;论文也没有说它等于形状与尺度的乘积。
公交很短,但决定系数和赤池权重为什么各选各的?
2014年北京公交完成47.72亿次出行,占公共出行的51.3%。论文没有写出51.3%对应的公共出行总数。公交起步价2元,覆盖前10公里,刷卡再打五折,车站又密,短途因此很多。数据集中95.82%的行程短于10公里,超过40公里的很少,论文将其联系到线路长度。全样本平均位移没有给出。
拟合区间是1–40公里,候选只有幂律和指数。
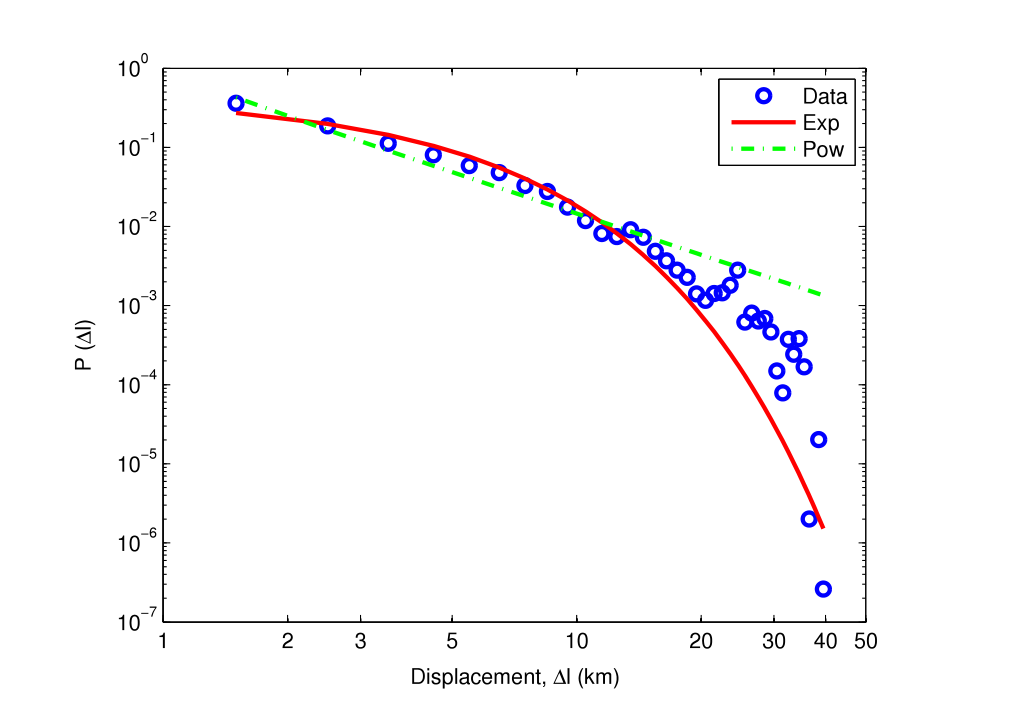
图 4|公交的短途优势,在分布上是指数还是幂律?
无字母子图。横轴为对数位移,范围约1–50公里;蓝圈为公交行程,红实线为指数分布,绿点划线为幂律。指数分布λ=0.3183,95%置信区间(0.3182,0.3185),R²=0.9470,赤池权重1。幂律α=1.7314,置信区间(1.7308,1.7321),R²=0.9671,权重0。20公里以后散点上下跳动,两条线都没有穿过每一个点。来源:原论文 Fig. 4。
正文写指数分布更好地抓住了趋势。表3同时显示,幂律的R²更高。筛选规则是赤池权重,所以指数分布被选中。权重在百万级样本上很容易变成0或1:很小的似然差就会把另一个模型压到0。权重为0只说明在这条准则下落选,不能从图上抹掉幂律仍然贴合许多散点这件事。
公交的0.3183高于出租车前段的0.1917和后段的0.1768,三个置信区间互不重叠。摘要所说的指数显著不同,指的是这种大样本下的参数差异。它仍然是分布拟合,不是乘客对票价或速度作出反应的因果估计。
按年客运量把三次出行混在一起,16公里处发生了什么?
2014年出租车、地铁、公交分别完成6.68亿、33.87亿和47.72亿次出行。三者之和是88.27亿次。6.68、33.87、47.72分别除以88.27,得到7.57%、38.37%和54.06%。论文称这是三种方式占公共交通总出行的比例。这里的分母是三者之和。前面公交占公共出行51.3%,用的是另一个分母。
三个样本里分别有2,915,488、13,380,969和20,105,096次行程。论文接着写,按对应数量随机抽取7.57亿次出租、38.37亿次地铁和54.06亿次公交,组成1000万次的融合集。括号里的三个数相加是100亿,而且每一个都大于对应样本的记录数,不能按字面理解成从样本中抽出的次数。正文又明确写融合集共1000万次。若按7.57%、38.37%、54.06%乘这1000万,则为75.7万、383.7万和540.6万。这三个数是根据正文的比例和1000万回推的,论文没有另给抽样计数表,也没有说明有放回还是无放回、随机种子是什么。
因为三段原始数据不在同一周,融合集是按年客运量重新配比的行程池,不是同一周里三种方式同时发生的联合样本。
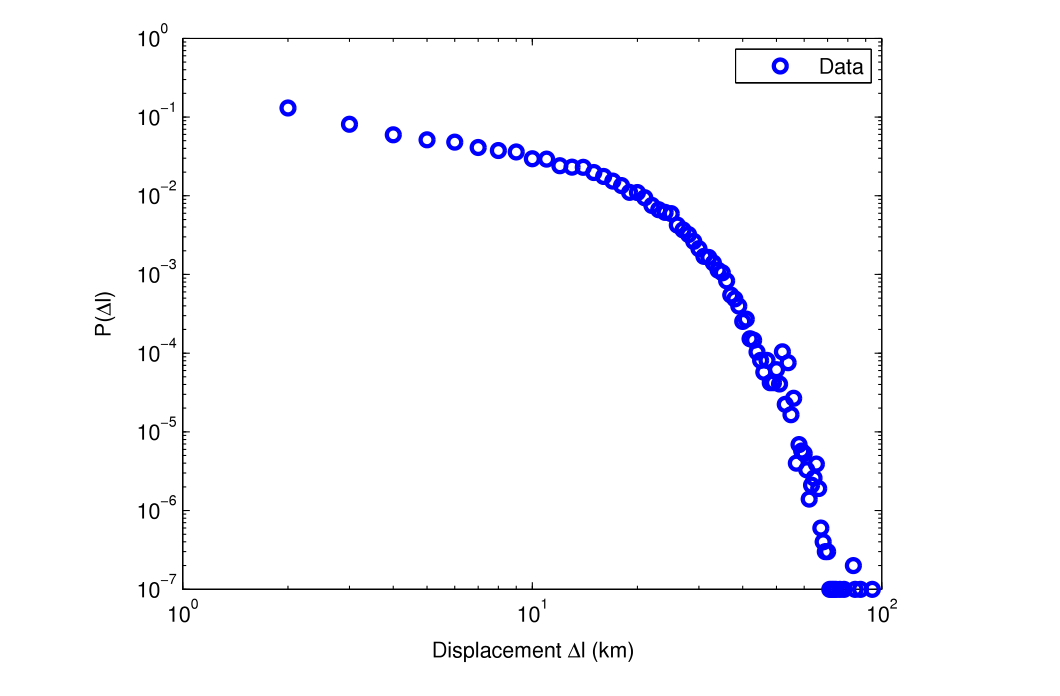
图 5|三种方式按客运量混合后,距离曲线还分得清来源吗?
无字母子图。双对数坐标,蓝圈为融合行程,没有叠加拟合线。近处概率最高,随后下降;大约16公里以后进入稀薄尾部。前段形状接近公交,后段拖尾更接近地铁。来源:原论文 Fig. 5。
短于16公里的融合行程超过85%。论文把分布切在16公里:前段占85.18%,后段占14.82%,分母是这次融合行程。两段分别比较幂律和指数。
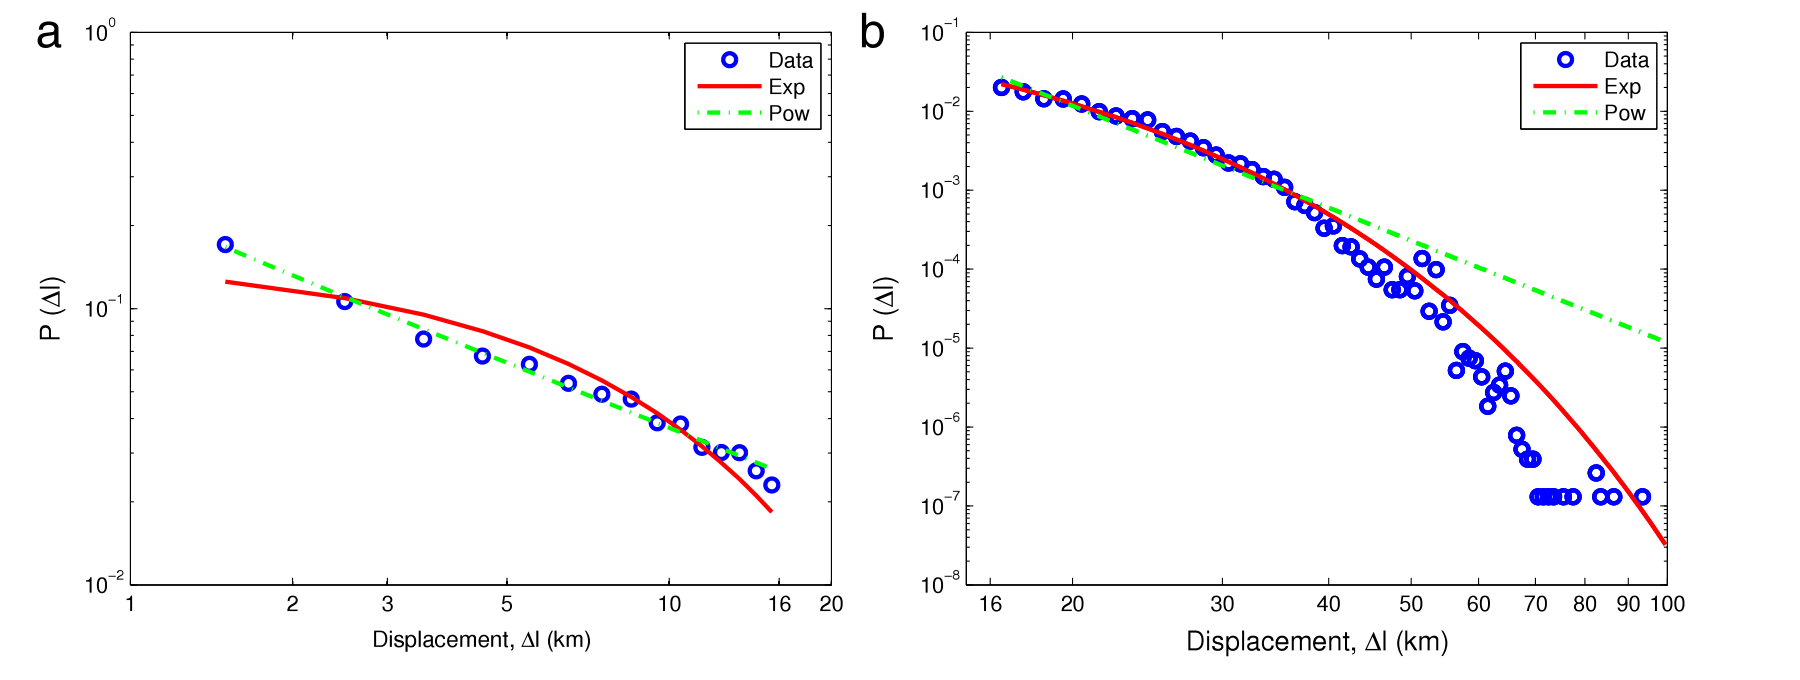
图 6|融合行程为什么要在16公里分成两段来拟合?
(a)1–16公里。绿点划线为幂律,α=0.7788,95%置信区间(0.7778,0.7797),R²=0.9978,赤池权重1。红实线为指数分布,λ=0.1371,R²=0.9575,权重0。幂律更贴散点。(b)16–100公里。红实线为指数分布,λ=0.1618,置信区间(0.1615,0.1621),R²=0.9916,权重1。绿点划线为幂律,α=4.2928,R²=0.9464,权重0。大约40公里以后散点再次散开,指数线仍比幂律更接近下降的趋势。来源:原论文 Fig. 6。
前段写成P(x)=0.2226 x^(−0.7788),后段写成P(x)=0.3192 e^(−0.1618x)。指数0.7788和速率0.1618与表4的极大似然一致。论文没有说明前面的0.2226和0.3192是按有界区间解析归一,还是对箱概率回归得到。α小于1,只说明在1–16公里这段里,拟合的幂律下降慢于1/x。它不表示距离翻倍时人数减半,也不能用到16公里以外。
摘要把整体概括为带指数截断的幂律。正文的操作是两段分开拟合,没有报告一个同时含幂律指数和截断速率的联合公式。
为了看随机抽取稳不稳定,论文又做了五次融合。1–16公里的α落在0.7785到0.7790,对应的指数速率落在0.1371到0.1372;16–100公里的幂律指数落在4.2896到4.2940,指数速率落在0.1616到0.1618。四组方差依次为4.30×10⁻⁸、2.00×10⁻⁹、2.83×10⁻⁶和7.00×10⁻⁹,都小于10⁻⁵。稳定的是同一种抽取和同一种切分下的参数,不是换季节、换城市或接回换乘之后的结果。
车站坐标换成站外随机点,分布类型还保持吗?
地铁和公交的记录停在车站。文献里常用的步行接驳距离是公交400米、轨道交通800米。论文从地铁样本抽40万次作为Data 1,从公交样本抽40万次作为Data 3。地铁站周围800米、公交站周围400米划为缓冲区,在对应车站的缓冲区内各随机取一点,当作模拟的真实起点和终点,得到Data 2和Data 4。
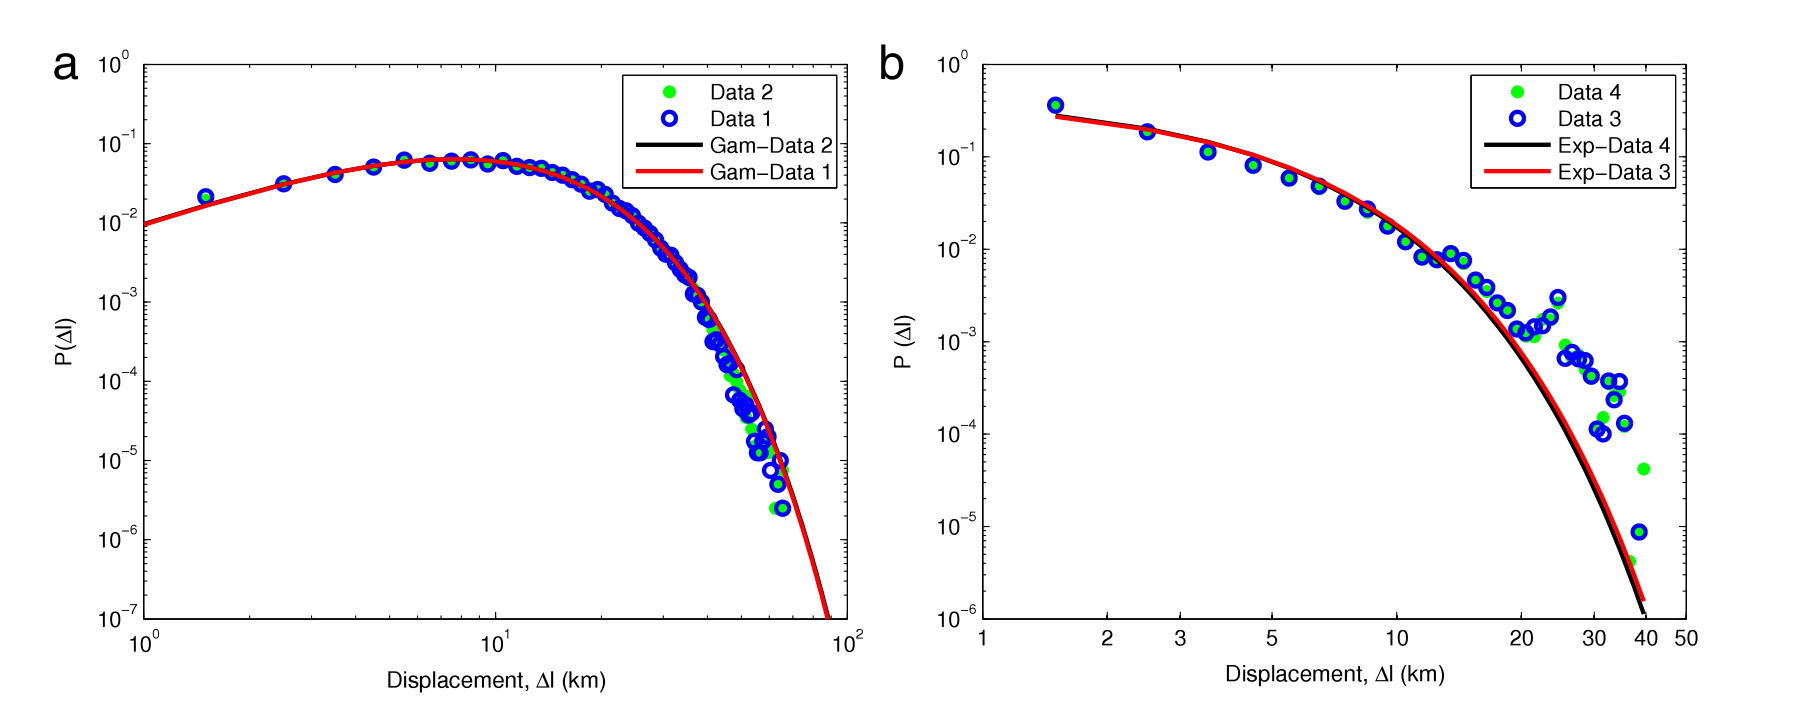
图 7|把起终点从车站挪到站外,分布类型变了吗?
(a)地铁。蓝点和红线是车站对车站的Data 1及其伽马拟合,绿点和黑线是800米缓冲区内随机起终点的Data 2及其伽马拟合。两条曲线都先升后降,高峰仍在大约10公里附近。(b)公交。蓝点和红线是Data 3及其指数拟合,绿点和黑线是400米缓冲区的Data 4及其指数拟合。两组都从短距离开始下降。来源:原论文 Fig. 7。
作者认为,用上下车站代替真实起终点,没有对拟合出的分布类型产生显著影响。图7支持的是分布族保持不变:地铁仍用伽马,公交仍用指数。论文没有给出模拟样本的参数、R²、赤池权重或检验p值,所以“没有显著影响”是对图的定性判断。缓冲半径来自既有步行距离文献,不是这批乘客的实测步行。随机点也没有沿着路网或小区出入口放置。出租车本身用的是上下车GPS,没有做同样的缓冲区试验。
这些曲线可以用到哪一步?
讨论把方式差异联系到票价、速度和准点:公交更偏短途,地铁承担更长的行程,出租车补充两者。这是和分布形状相符的一种解读。本文没有估计方式选择模型,也没有把票价、车速写成位移分布的自变量。
既有研究里,出租车位移常用指数分布,本文两段拟合与此相符;公交和地铁在别的城市曾用负二项描述乘距,本文分别得到指数和伽马。分布族随城市、票制和记录方式变化,不能从北京这一冬一春推出所有城市。
季节是另一条边界。三套数据都在冬季。作者援引天气研究认为,通勤和上学相对稳定,休闲购物会随低温减少;步行和自行车的一部分需求会转到公共交通,因而冬季公共交通占比可能更高。另有研究观察到气温上升时出行距离增加,所以相对全年,这份冬季样本可能少了一些长位移、多了一些短位移。本文没有夏季或全年样本来检验这句话。
私人小汽车、步行和自行车没有进入融合集。论文所说的总体人类移动性,是这三种公共交通按2014年客运量混合后的行程位移。它也还不是接回换乘以后的完整旅程。
一句话总结
北京出租车、地铁和公交的单次行程直线距离遵循不同分布;按2014年客运量叠到1000万次行程上之后,16公里以内更像一条很缓的幂律,更远则转成指数衰减,这个形状属于行程混合物。
核心来源
- Physica A正式论文,卷483,页227–238。首页标题与DOI为10.1016/j.physa.2017.04.182。正文图1–7、表1–5。文末参考文献没有指向本文的在线补充材料。
- 年客运量和线路数引自论文参考文献[37]:J. Guo、X. Li,Beijing transport annual report 2015。
- 江世雄的研究方向见深圳技术大学城市交通与物流学院教师页面。关伟、张文义的机构简介分别见北京交通大学教师页和张文义教师页。
作者介绍
- Shixiong Jiang(江世雄):论文署名为北京交通大学城市交通复杂系统理论与技术教育部重点实验室。深圳技术大学教师页面写明其研究方向包括出行行为、人类移动性与数据挖掘,并于2014年至2019年在北京交通大学攻读控制科学与工程博士。
- Wei Guan(关伟):通讯作者,署在同一教育部重点实验室,邮箱 weig@bjtu.edu.cn。北京交通大学教师页面列其为教授,研究方向包括交通运输系统工程与智能交通系统。
- Wenyi Zhang(张文义):署在同一教育部重点实验室。北京交通大学教师页面列其为副教授,研究工作包括城市交通规划与管理,出版物列表含本文。
- Xu Chen:论文只印英文名,署名为北京交通大学轨道交通控制与安全国家重点实验室。没有采用可能与同校其他同名教师混淆的简介。
- Liu Yang:署在上述教育部重点实验室。2018年与江世雄、关伟合作的北京出租车可达性研究仍把Liu Yang署在该实验室;这里不写无法唯一核对的现职。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一种规划直接采用融合样本的α=0.7788来布置全城站距,它主要反映的是公交占54.06%以后的近距离形状,会错过地铁大约9公里的高峰。可以先在每一种方式内部保留本文已经分开的分布,再按客运量加权预测客流;只有当换一套权重或接回换乘之后,16公里这个切分仍然站得住,混合曲线才更接近可迁移的城市规律。
另一个可检验的问题出在筛选准则。公交的幂律R²更高,指数分布却因赤池权重获胜。若把某一天留出,分别看似然和决定系数是否还指向同一个模型,落选的幂律也许会在长距离尾部重新变得有用。五次重抽只说明从同一池子里再抓一次,参数几乎不变。