易被感染的人,也更容易传染别人,会发生什么?
论文名片|X. Li、L. Cao、G. F. Cao,Epidemic prevalence on random mobile dynamical networks: individual heterogeneity and correlation,The European Physical Journal B,2010,75:319—326,2010年3月18日在线发表。DOI:10.1140/epjb/e2010-00090-9。
设想两个人群,平均易感性相同,平均传染性也相同。但在人群甲中,容易被感染的人往往也更容易传染别人;在人群乙中,这两种特征落在不同的人身上。只比较两个平均数,可能会漏掉传播链反复经过同一类高风险个体的机会。
这篇理论与模拟研究在随机移动接触网络中分析这种差别。它最清楚的结论是:同一个人的易感性与传染性怎样配对,会改变疾病维持传播的条件。它也报告了若干“个体差异越大,感染比例越低”的模拟结果,但这些结果有特定分布前提,不能当作现实疾病的一般规律。
先说结论
- 模型让200个个体在平面上随机移动,碰撞形成临时接触;没有真实患者数据,也没有真实通勤路线。
- 平均场近似给出的临界条件为 τ × 每步平均接触数 × ⟨is⟩=1。⟨is⟩是同一个体的传染性i与易感性s乘积的平均,不是某次接触双方参数的简单平均。
- 在平均i、s不变时,正协方差提高⟨is⟩,使传播更容易维持;交换参数配对的模拟在几类分布下支持这一方向。
- 分布更宽时,感染比例在论文的若干实验中下降;但改变方差、改变均值、改变相关性与改变传播阈值是不同问题,不能合并成一句“异质性总能保护人群”。
临时碰面如何组成传播网络?
个体被表示为半径r的软圆盘,在边长L的正方形中以相同速率v移动,边界首尾相接。每步结束后独立抽取一个新方向;碰撞后两者向相反方向运动,并记录一次接触。网络边随碰撞出现,并非固定的朋友或家庭关系。
接触中,感染者u使易感者w感染的概率参数为iᵤs𝓌。感染持续固定τ步后恢复为易感状态,即易感—感染—易感模型(SIS)。这里的恢复没有留下永久免疫;τ=100是模拟步数,不能直接解释为100天。
默认参数为N=200、L=50、v=1、r=1,初始感染者占10%。以10万步估计接触率后,一个感染期内平均发生约31.12次碰撞,因此临界乘积平均值约为1÷31.12=0.032。
为什么临界值里出现了同一个人的两种特征?
传染性决定感染后向外传播的能力,易感性决定进入感染状态的机会。高易感者更常成为感染者;若他们同时高传染,感染者群体就会聚集更强的向外传播能力。
平均场方程把接触过程压缩为每步平均碰撞数n̄,并用Θ表示感染者贡献的有效传染性。在平衡态,易感性为s的个体感染比例为:
ρₛ=sτn̄Θ ÷ (1+sτn̄Θ)。
把各类个体加总,分析零感染状态附近能否出现非零解,得到τn̄⟨is⟩达到1的临界条件。若用μᵢ、μₛ表示两种特征的均值,则:
⟨is⟩=μᵢμₛ+cov(i,s)。
因此在两个均值相同的比较中,正协方差使阈值更容易越过,负协方差则相反。协方差并非标准化相关系数,数值大小与参数范围有关。
这个公式也划出一个重要边界:若i与s独立,⟨is⟩=μᵢμₛ;保持两个实际均值不变而只改变边缘方差,平均场临界条件并不会单独因为方差变化而改变。阈值与阈值以上的感染比例必须分别讨论。
两种特征都服从幂律时,模拟看见了什么?
论文改变幂律指数γ,报告感染比例随γ增大而上升,模拟临界γ约2.63,而按乘积平均值估计为2.55。图1每点为10轮模拟平均,每轮共1,000步,取最后800步统计;这是有限时间观察到的准稳定比例,不是无限时间不灭的证明。
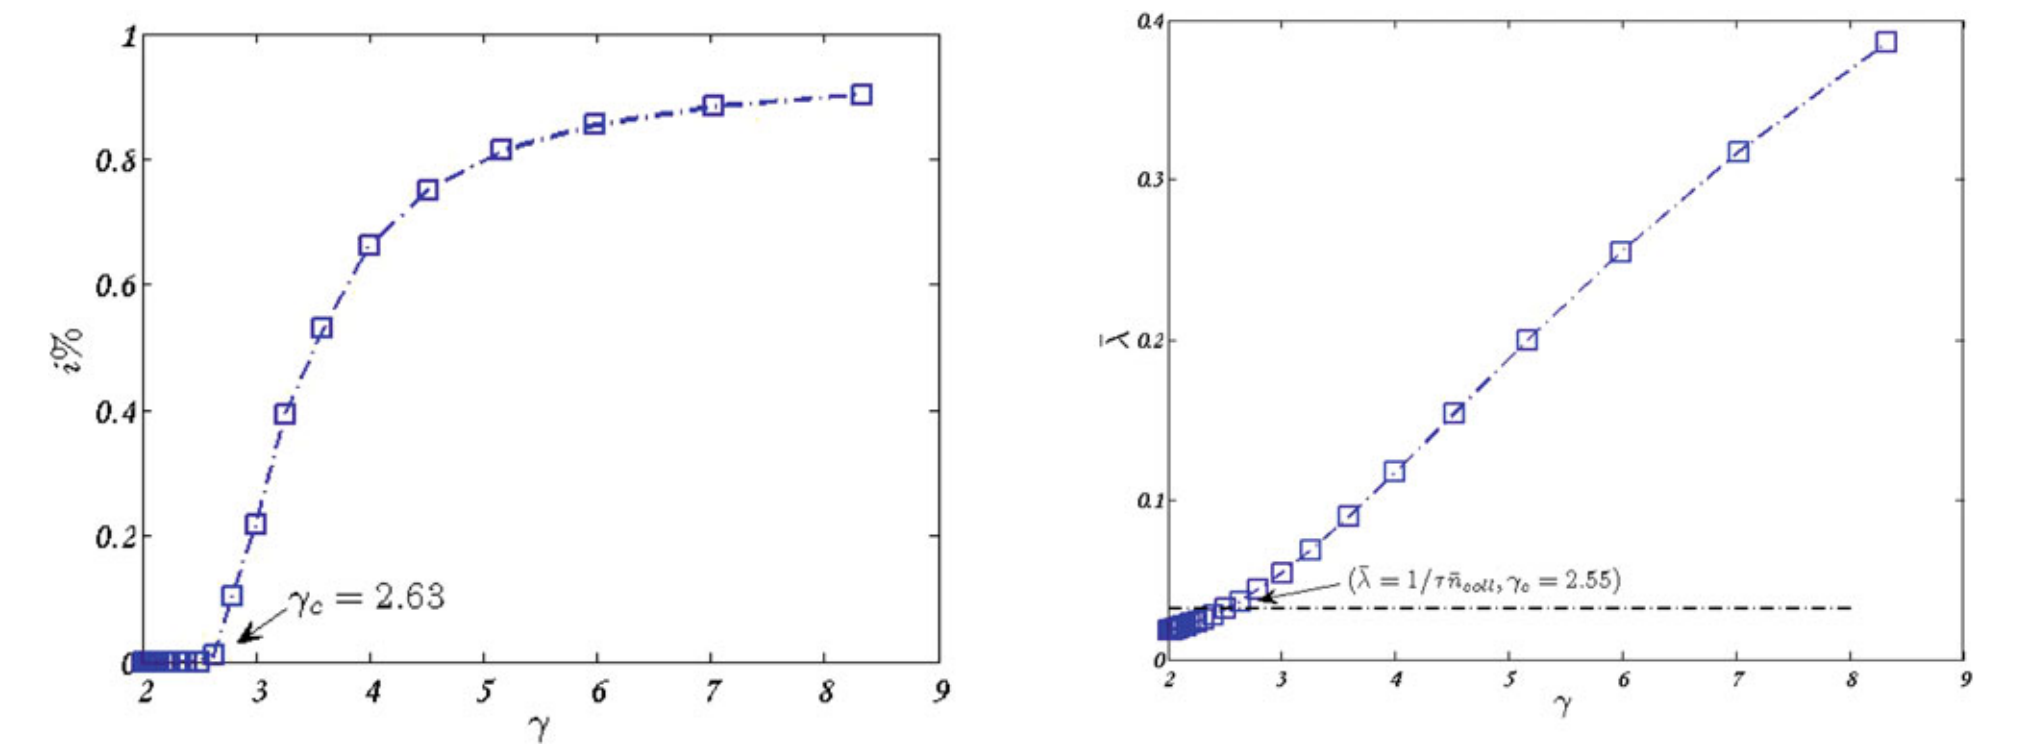
图 1|分布参数怎样与传播临界点相对应?
(a,左)横轴γ、纵轴感染个体比例,模拟临界约2.63。(b,右)横轴同样为γ,纵轴⟨is⟩;与约0.032的水平临界线相交于2.55。两种估计接近但并不相等。来源:原论文 Fig. 1。
这一组实验不宜直接解释为“固定均值,只改变异质性”。γ改变时分布的均值和形状都可能变化。另一个可复现性限制是,原文写p(x)正比于x的−γ次方、取值(0,1],却没有说明靠近0的截断或具体抽样规则;按连续密度字面理解,图中γ大于1时无法在该区间归一化。因此这里保留论文报告的曲线与阈值,不据此补造一个已确定的抽样分布。
更拥挤为什么降低传播维持的难度?
固定200个个体,改变平面大小,即改变密度ρ=N÷L²。接触更频繁时,每个感染期带来的传播机会更多,维持传播所需的个体感染参数可以更低。
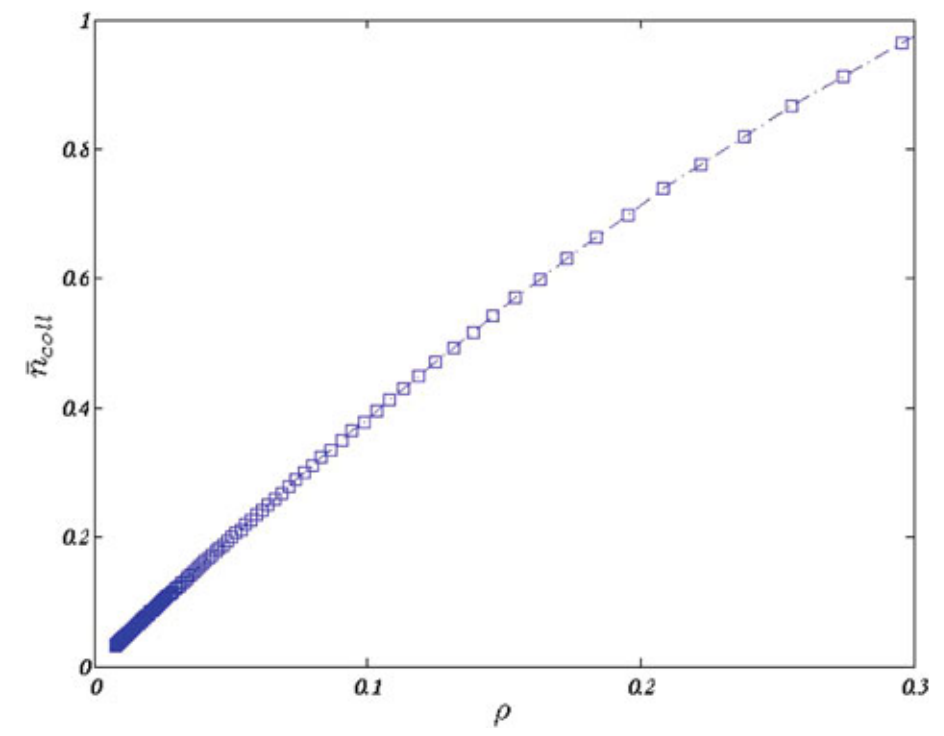
图 2|密度如何进入阈值?
无子图。横轴为模拟人口密度ρ,纵轴为每步平均碰撞数n̄,呈近似线性上升。每点以10轮、每轮10,000步平均;不是现实城市密度与疫情的观察回归。来源:原论文 Fig. 2。
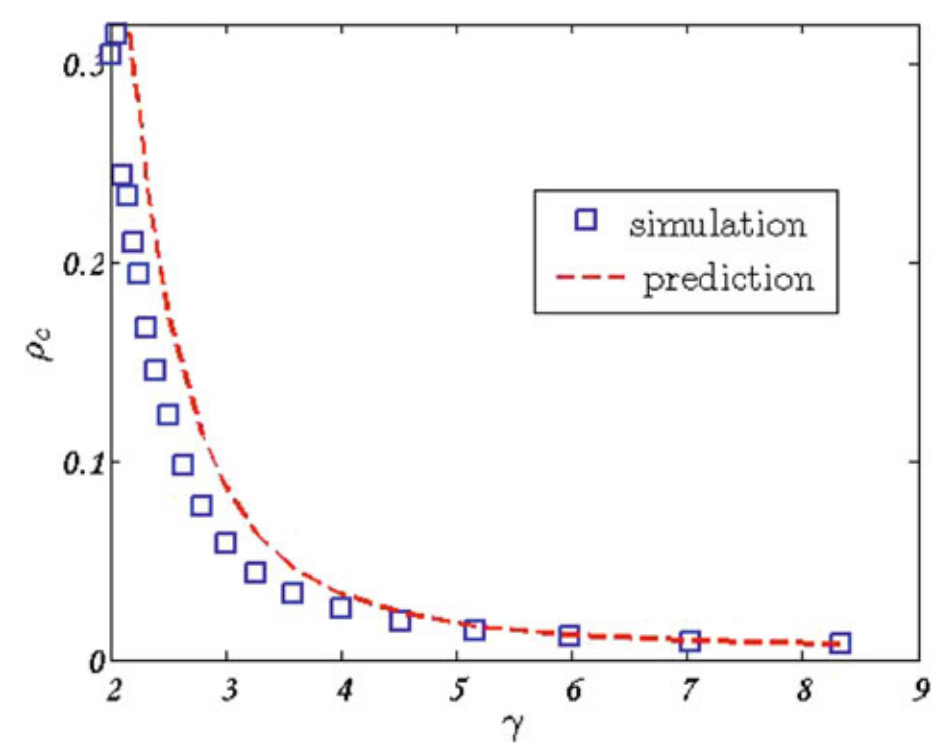
图 3|分布参数改变时,需要多高密度才能维持传播?
无子图。横轴γ,纵轴临界密度ρc;蓝色空心方框为模拟、红虚线为依据临界条件与接触率关系计算的预测。两者随γ下降,较小γ附近仍有可见偏差。来源:原论文 Fig. 3。
这些结果依赖随机混合、同速移动与相同圆盘半径。真实人口密度还会与家庭、职业、环境及行为共同变化,不能把这条线性关系当作真实城市的通用传播系数。
分布变宽与均值升高,是同一回事吗?
两种特征都按以0.5为中心的高斯形式设置,并限制在[0,1]时,方差参数增大,模拟感染比例下降。这是感染水平的结果,并没有单独展示保持实际均值不变时临界值发生同样变化。
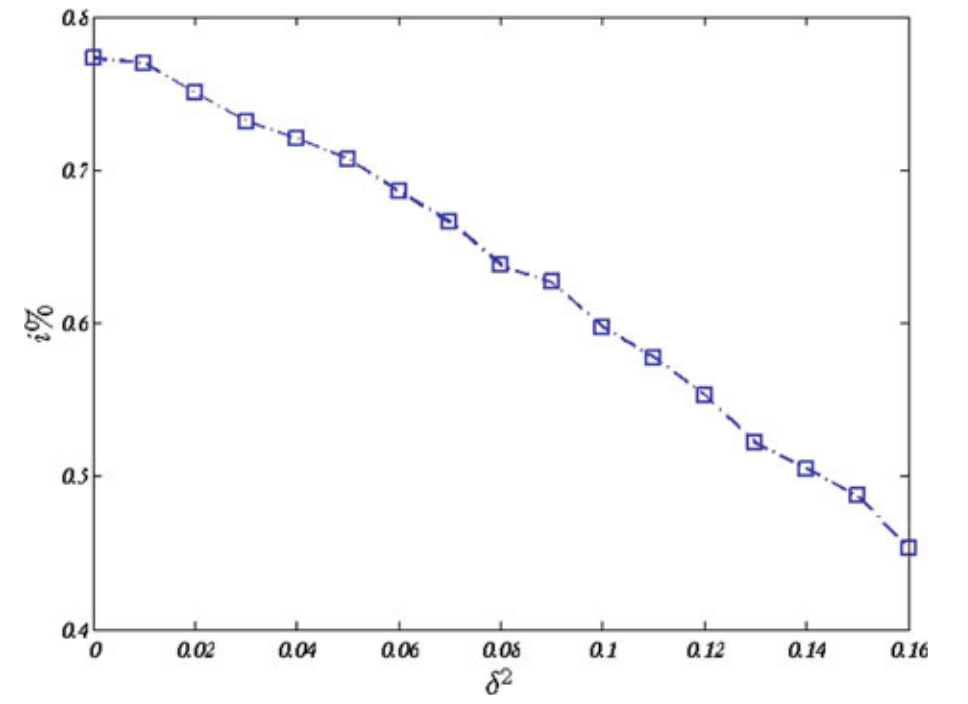
图 4|更宽的高斯分布对应多高感染水平?
无子图。横轴高斯方差参数δ²,纵轴感染比例;从左端约0.78下降至δ²=0.16附近约0.45,点为10次独立模拟平均。变量被限制在[0,1],不能把未经说明的截断后实际方差直接等同于输入δ²。来源:原论文 Fig. 4。
在混合分布中,一种特征按幂律设置,另一种按高斯形式设置。提高高斯中心参数μ使感染更容易出现;提高宽度参数δ则把临界γ向右推。把两种分布在易感性和传染性之间互换,在平均场近似下给出相同临界条件,但有限样本模拟并不完全重合。
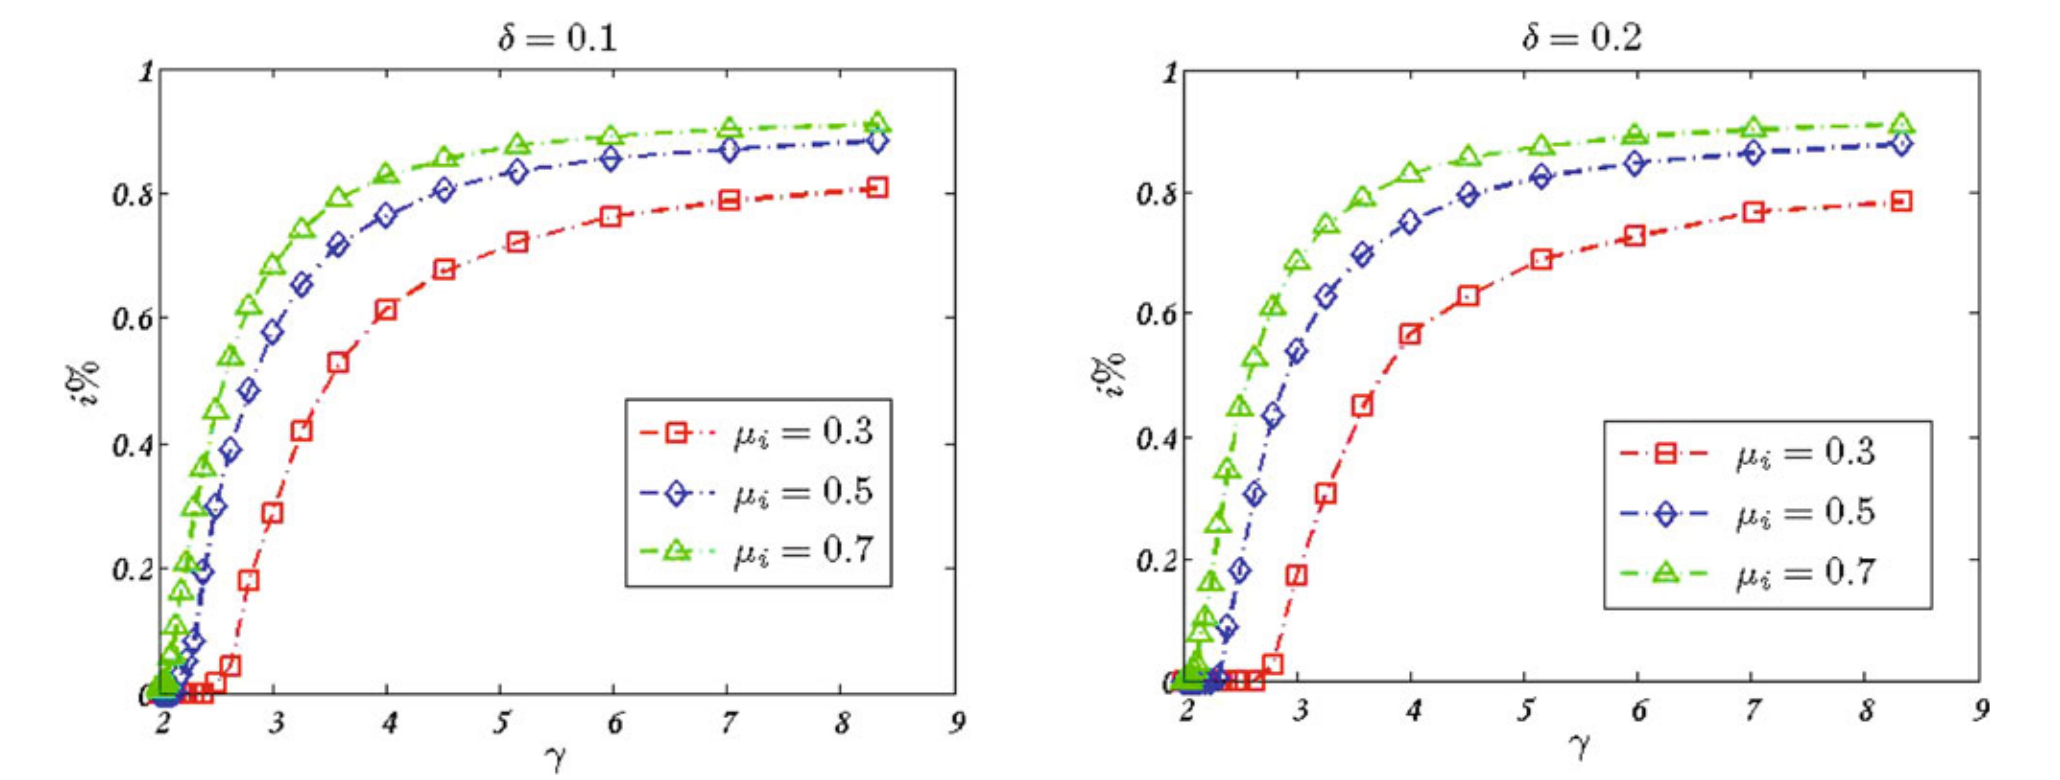
图 5|均值参数和分布宽度怎样共同影响感染比例?
(a,左)δ=0.1,(b,右)δ=0.2;横轴易感性幂律指数γ,纵轴感染比例。红方框、蓝菱形、绿三角分别为传染性高斯中心参数μ=0.3、0.5、0.7。左图临界γ依次为2.63、2.22、2.10,右图为2.80、2.39、2.16,每点10轮平均。来源:原论文 Fig. 5。
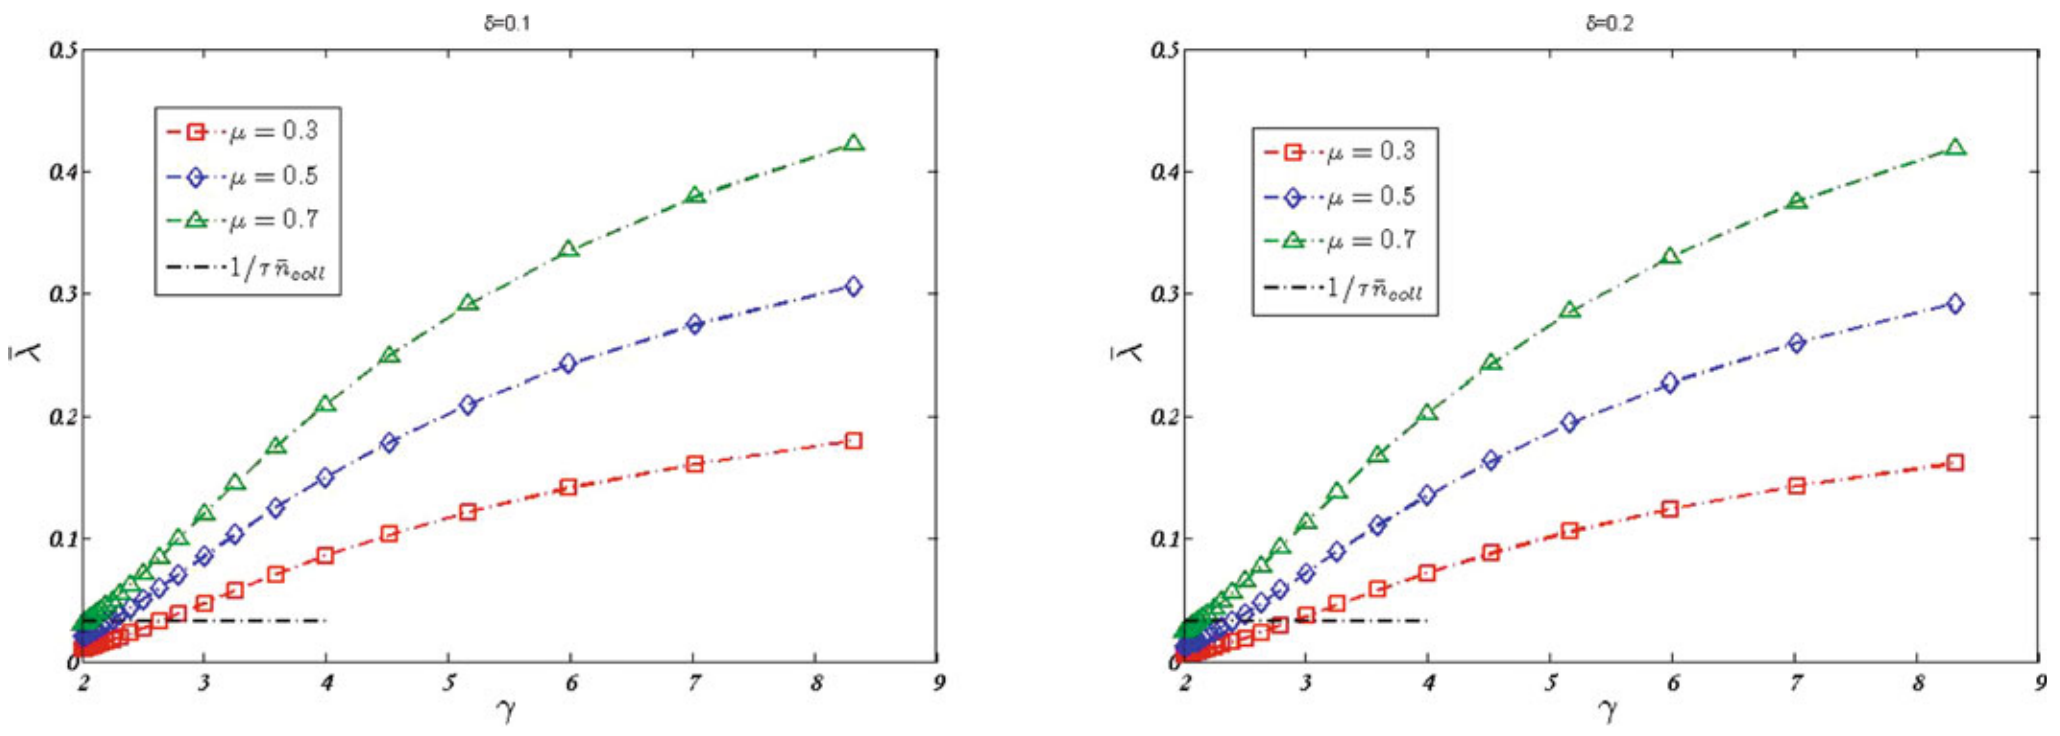
图 6|乘积平均值能否近似预测这些临界点?
(a,左)δ=0.1,(b,右)δ=0.2,横轴γ、纵轴⟨is⟩;颜色与图5相同,黑水平线为约0.032。交点预测依次为左图2.63、2.25、2.08,右图2.90、2.50、2.15,与图5模拟相近但有差距。来源:原论文 Fig. 6。
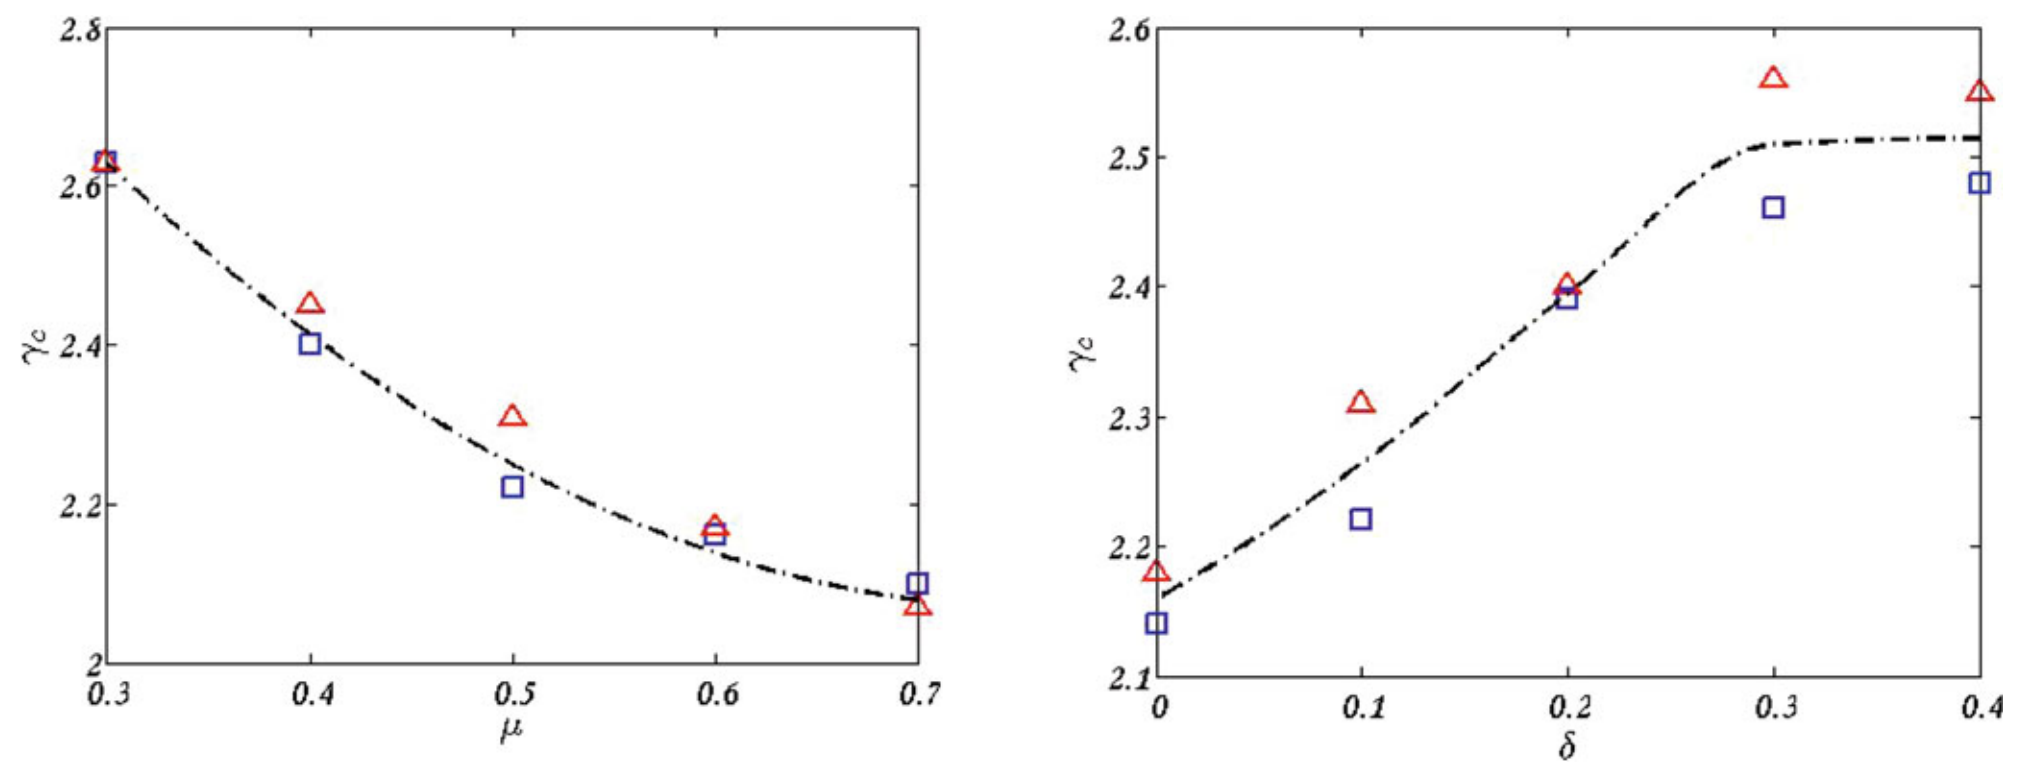
图 7|互换易感性与传染性的分布,结论是否改变?
(a,左)固定δ=0.1,横轴μ、纵轴临界γc;(b,右)固定μ=0.5,横轴δ、纵轴γc。蓝方框为幂律易感性加高斯传染性,红三角为相反配置;黑线为拟合趋势。μ上升时γc下降,δ上升时γc总体上升,两种配置有有限差异。来源:原论文 Fig. 7。
把高易感与高传染安排在同一人身上,会怎样?
与前面的分布形状比较相比,配对实验更直接地检验协方差。附录A先生成两列独立参数,再交换某列在不同个体间的取值,逐步提高或降低两列协方差。交换不改变每列已有数值,因而保留各自边缘分布和均值,改变的是谁与谁配对。
二维高斯参数实验中,中心均为0.5、方差参数均为0.16,改变协方差;幂律实验中,两列均用γ=3。两者均显示,正协方差更大时感染比例总体更高。散点是模拟实现,不是对500名实际患者的观察。
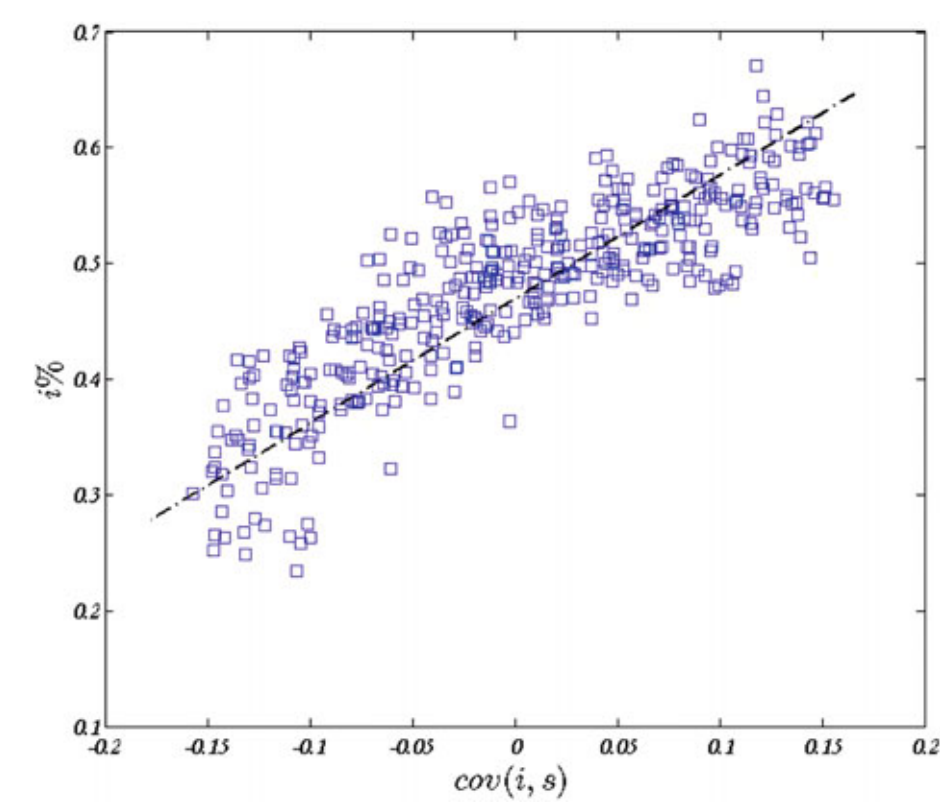
图 8|高斯参数下,配对关系怎样影响感染?
无子图。横轴cov(i,s),纵轴感染比例,500次独立模拟给出总体上升趋势;黑线显示趋势而非每点精确预测。这里的协方差不能读作“相关系数从−0.16变为0.16”。来源:原论文 Fig. 8。
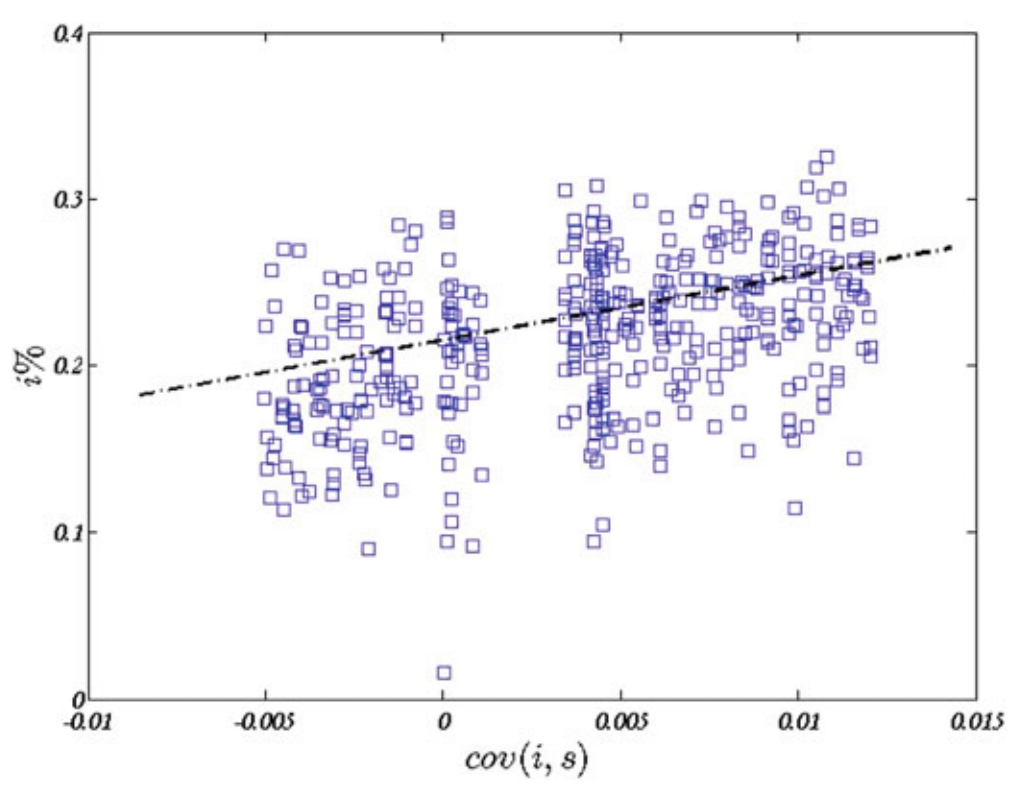
图 9|这种方向是否只出现在高斯分布中?
无子图。两种特征均按γ=3的幂律设置,横轴协方差、纵轴感染比例;500次实现的散点仍总体上升,但离散明显。横轴范围与图8不同,不能直接比较图形斜率来判断哪种分布效应更强。来源:原论文 Fig. 9。
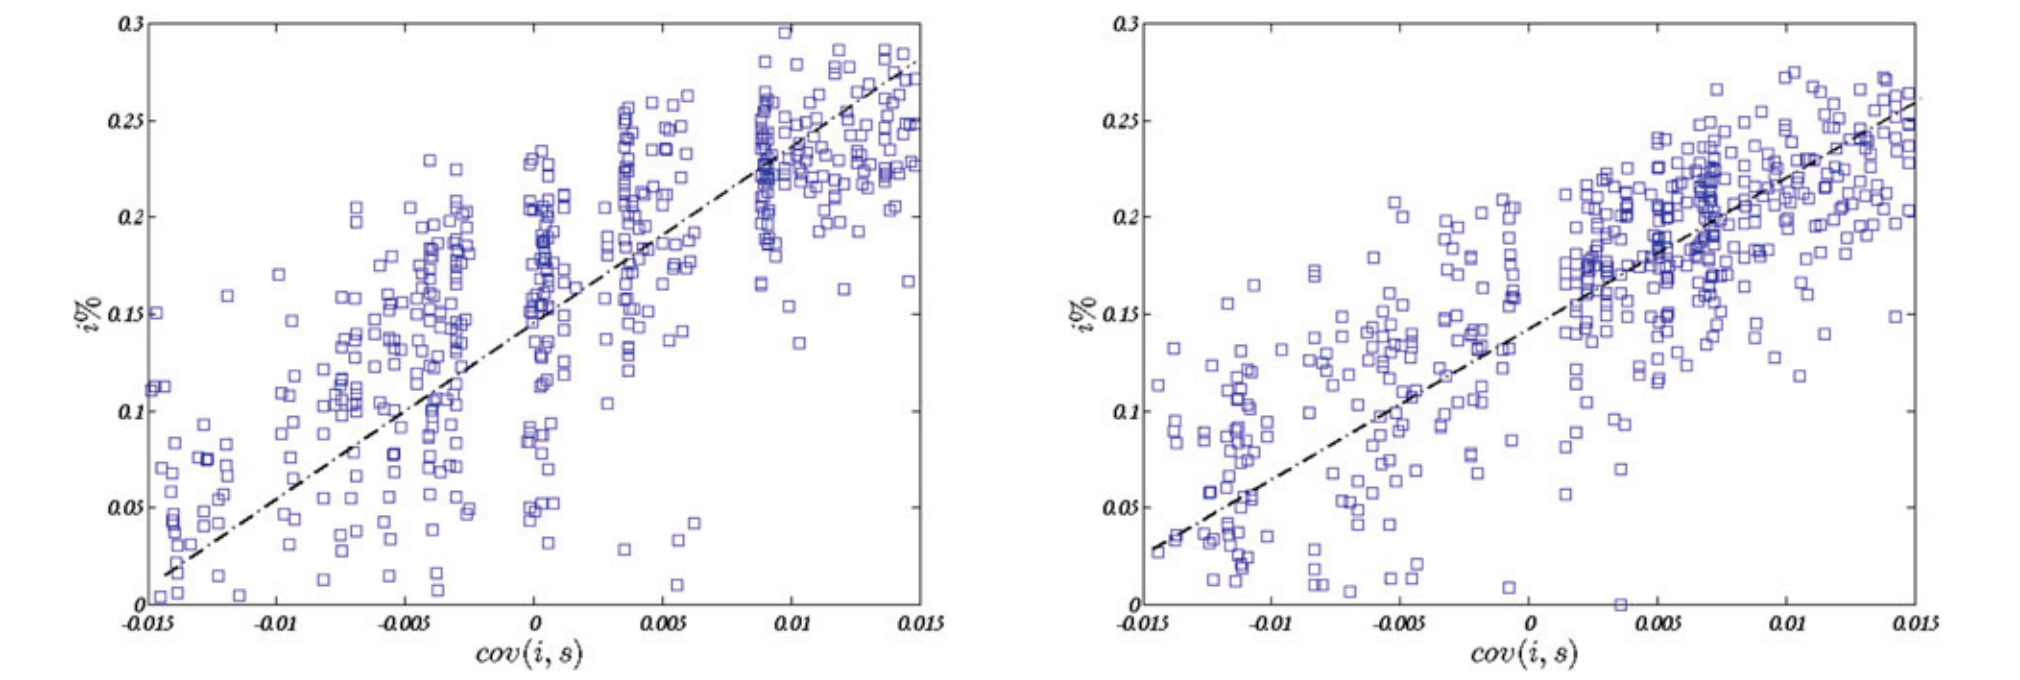
图 10|混合分布中的正配对是否也提高感染比例?
(a,左)高斯易感性与幂律传染性的混合,(b,右)幂律易感性与高斯传染性的混合;均使用γ=3及高斯中心0.5、宽度δ=0.2。横轴协方差、纵轴感染比例,每幅500次独立模拟,均显示正向趋势。原图注左幅重复写了p(s),此处按正文所述两种混合配置解释,不把笔误当作第三种设置。来源:原论文 Fig. 10。
这套结果能推到哪里?
理论与模拟支持的是:随机接触、相同感染期、给定个体参数的SIS系统中,易感性与传染性之间的正配对有助于传播维持。它没有测量任何现实疾病中这两个特征的真实联合分布,也没有验证现实人群确实如此配对。
不能把“谁更会传播”只理解为生理传染性:本文人人运动速率和接触半径相同,没有把职业接触、长期关系、行为变化或环境通风放进个体参数的实证识别。有限200人系统和有限模拟时长也使准稳定感染与最终随机消亡需要区分。
尤其要把两类结论分开:协方差效应有清楚的阈值恒等式和保持边缘分布的交换实验;广义“异质性抑制传播”则受分布抽样、实际均值及感染比例指标限制。二者证据强度并不相同。
一句话总结
平均易感性和平均传染性相同的人群,也可能因两种特征在同一个体身上的配对不同而具有不同传播风险;这比“个体差异越大越安全”更接近论文能稳妥支持的结论。
核心来源
- 原论文DOI,正文、公式1—15、图1—10及附录A;本文全部图像取自原论文。
作者介绍
以下保留论文署名形式与当时机构,不据姓名缩写推测全名或现任职位。
- X. Li:署名复旦大学电子工程系。
- L. Cao:署名东京大学计数工程与信息物理相关部门(Department of Mathematical Engineering and Information Physics)。
- G. F. Cao:署名上海交通大学自动化系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要把这个模型用于观察研究,最难的可能不是测两个均值,而是判断同一个人的两种能力是否被可靠区分。一个接触很多的人,既可能更容易被感染,也可能造成更多后续感染;这种关联可能来自接触机会,而非生理易感性与传染性本身。把接触次数、感染后传播能力与感染前暴露分别测量,才可能检验模型想讨论的配对效应。
另一个可检验方向是加入不同感染期。若高易感、高传染的人同时感染期短,乘积平均值本身就可能不再足够。比较“只用均值”“加入易感—传染协方差”“再加入感染期与接触机会联合分布”的预测,将有助于判断哪些个体差异真的值得保留。