删掉姓名之后,四次出现的位置还会认出你吗?
论文名片|Yves-Alexandre de Montjoye、César A. Hidalgo、Michel Verleysen、Vincent D. Blondel,Unique in the Crowd: The privacy bounds of human mobility,Scientific Reports 3, 1376,2013 年 3 月 25 日。DOI:10.1038/srep01376。研究类型:匿名手机记录的轨迹唯一性测量与分辨率聚合实验。
想象一份已经删去姓名、手机号和家庭地址的出行表。另一边,有人知道你周一上午在某片区域,周三中午又出现在另一片区域。单独看,每个区域都容纳许多人;把时间和地点合起来,却可能只剩下一条轨迹同时符合。这是帮助理解匹配逻辑的假设场景,并非论文实施过的个人身份调查。
这篇研究的结论是:去掉直接身份标识后,轨迹本身仍可能非常独特;把位置和时间变粗,能降低独特程度,却未必降得足够快。它最著名的数字是“四个时空点,约 95%”,但读懂这个数字,必须先问:四个怎样的点,在什么候选库里,识别的究竟是什么?
先说结论
- 在约 150 万用户、15 个月的手机记录库中,以一小时和单基站服务区域为分辨率,随机选取四个已记录时空点,约 95% 的受测轨迹只匹配到库中一名用户。
- “唯一”指候选轨迹只剩一条,实验并未直接找回这些人的真实姓名;从轨迹到身份,还需要能可靠归属于目标人的外部信息。
- 同时聚合为五小时、约五个相邻基站一组时,给定四点,仍有超过一半的轨迹唯一。单纯把数据变粗,不能保证每个人都藏在人群中。
- 已知点越多,降低分辨率的保护效果越弱;但这里拟合的是一个特定数据集中的经验关系,不是适用于任意数据和攻击者的普适隐私定理。
研究看到的是连续行踪,还是零散的通信事件?
数据来自一个未公开名称的国家的一家运营商,采集时间为 2006 年 4 月至 2007 年 6 月。论文结果部分称其为一个欧洲小国,方法部分使用较宽泛的西方国家表述。库中约有 150 万名用户,每人对应一条匿名轨迹。
手机用户发起或接收电话、短信等与网络交互的事件时,系统才记录连接的基站位置。平均每名用户每月约 114 次记录;没有事件的时间,不等于用户原地不动。因此,这是一份稀疏、离散的事件记录,而非每小时都知道精确坐标的 GPS 日记。“一小时分辨率”表示事件时间被放入一小时窗口,不表示每小时固定采样。
空间位置也只是基站服务区域。约 6,500 个基站覆盖全国;论文给出的典型区域面积从城市约 0.15 km² 到乡村约 15 km²。图示用 Voronoi 分区近似接收区域,实际通信覆盖与最近基站分区未必完全重合。
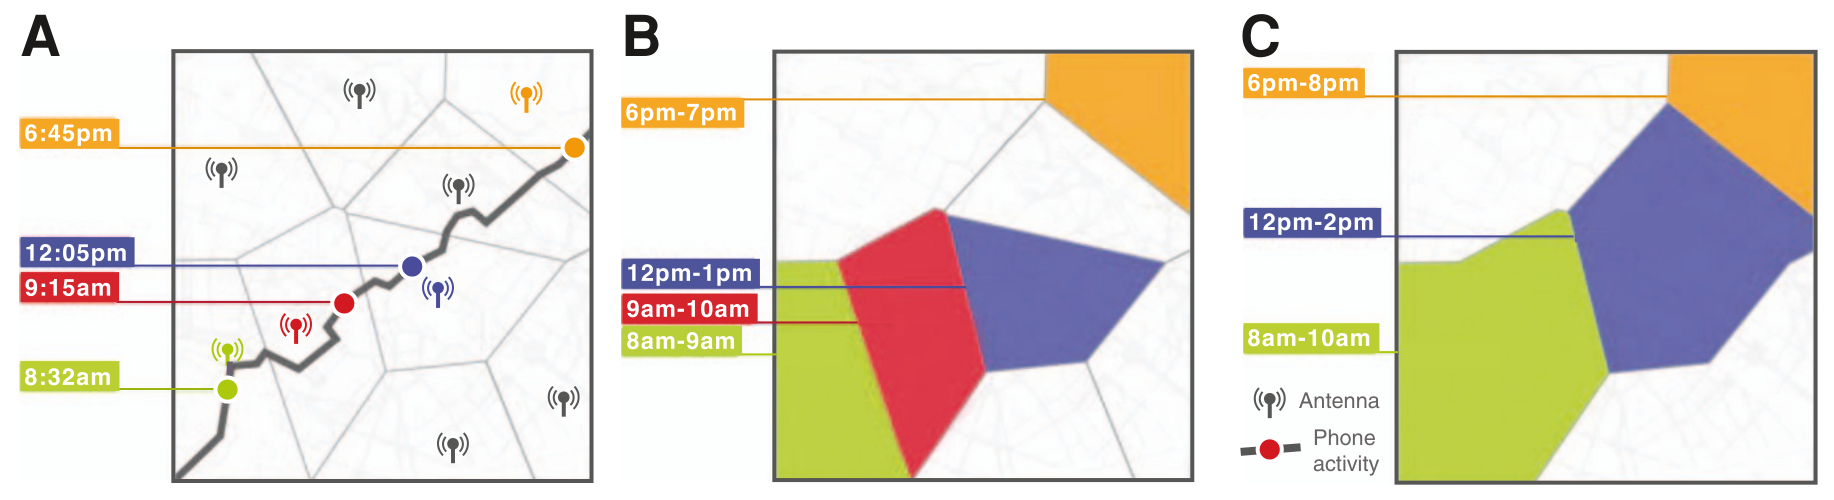
图 1|一条轨迹在数据库中究竟留下什么?
(A)同一用户一天中的移动示意,彩色点是发生通信事件的时间和位置,线条帮助连接场景,并非连续观测。(B)数据库只保留事件所属区域与一小时时间段。(C)把相邻基站合并、时间窗口扩为两小时后,原本可区分的事件可能变成同一粗粒度记录。来源:原论文 Fig. 1。
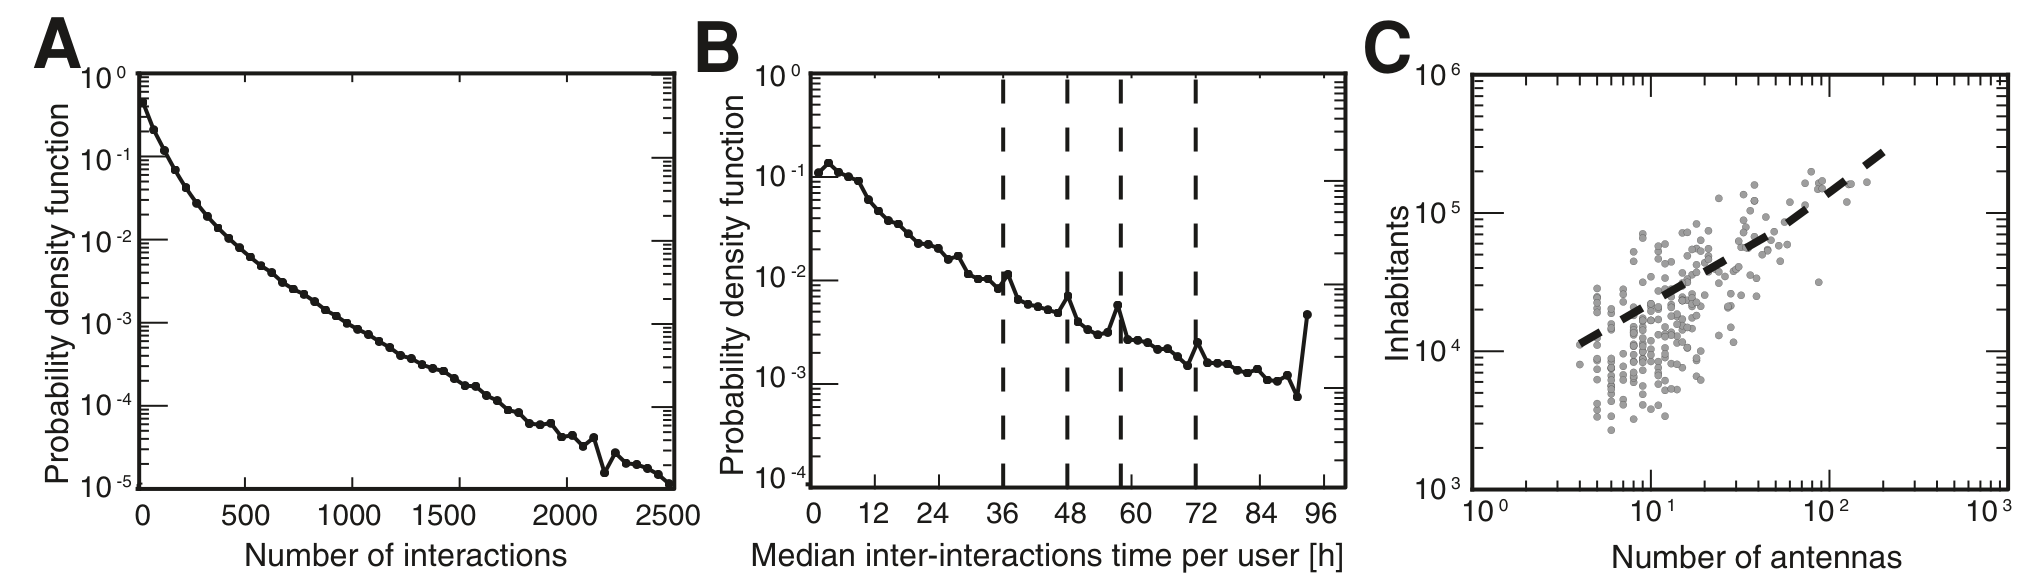
图 2|稀疏记录为什么仍然值得研究?
(A)用户每月记录次数的概率密度,显示用户活跃程度差别很大。(B)每名用户相邻交互时间中位数的概率密度,横轴单位小时,说明事件间隔并不均匀。(C)地区基站数与人口数的关系,R² = 0.6426;人口更多的地区通常也布设更多基站。来源:原论文 Fig. 3。
后一个关系提醒我们,简单说“城市里人多,必然更匿名”并不充分:人更多会增加候选者,但更密集的定位设施也可能提高空间区分能力。论文据此讨论外推的可能性,尚未以另一个国家的独立数据库完成验证。
四个点怎样从一百五十万人中缩小候选范围?
轨迹唯一性(unicity)衡量的是一组约束能排除多少候选者。研究先随机选择一名用户,再从这个人已有的通信记录中随机抽 p 个时空点。每个点同时包含区域和时间窗口。随后扫描整个约 150 万用户的库,查找哪些轨迹包含全部 p 个点。
把符合条件的候选集记为 S。如果 S 只有一条轨迹,这次测试就是唯一;若剩两条,则尚不能在二者中区分。这里要求点来自目标轨迹,时间与空间按照数据库分辨率匹配;没有测试外部消息存在时间误差、地点误差或认错人的情况。
论文用随机抽取的 2,500 条轨迹估计唯一比例。因而,150 万是检索候选库规模,2,500 是比例估计的受测轨迹数,95% 不是实际对全部 150 万人逐一实名调查后的结果。
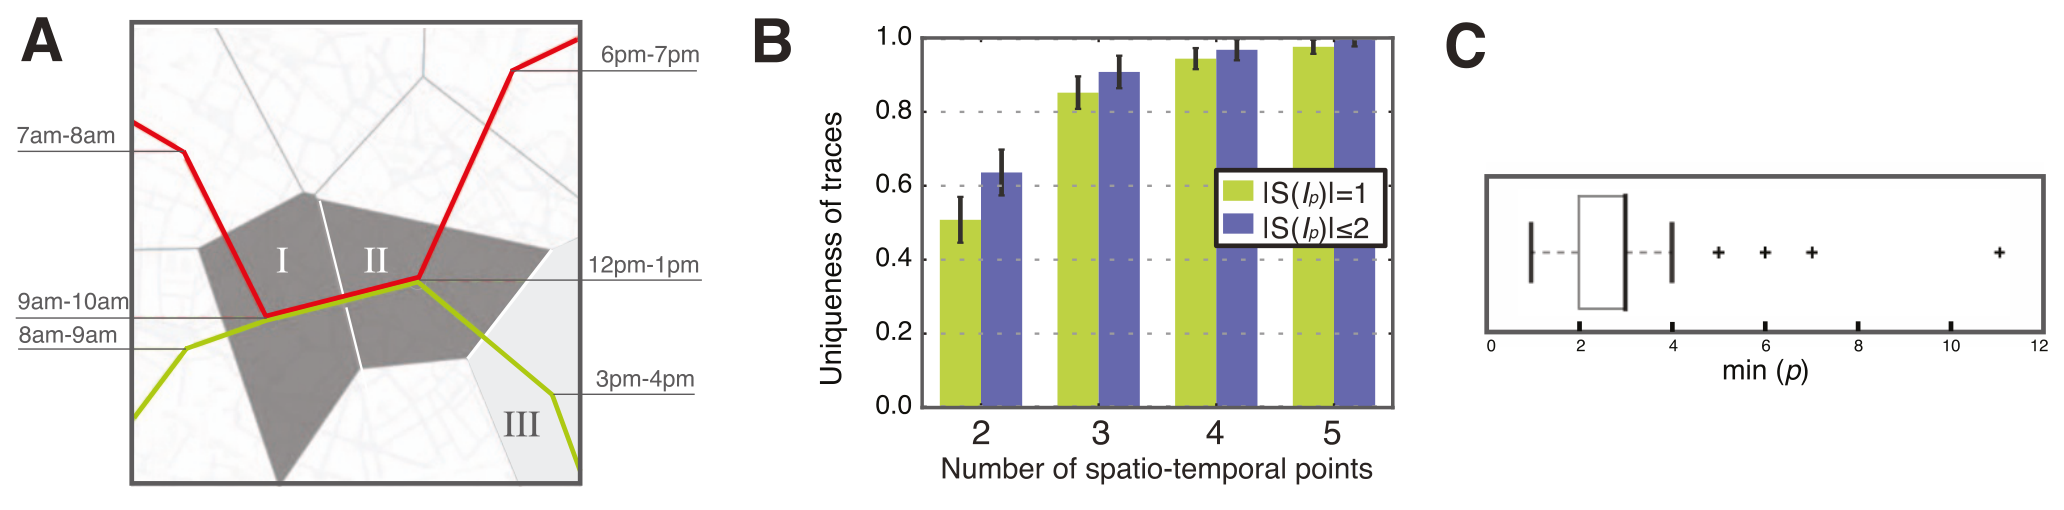
图 3|多一个时空点,怎样改变可区分程度?
(A)红、绿两条示意轨迹都符合前两个区域—时间条件,加入第三个条件后,只剩绿线符合。(B)横轴为随机已知点数 p,绿柱是候选集恰为一条的比例,蓝柱是候选集不超过两条的比例;两点时超过一半唯一,四点时约 95% 唯一。误差条按原图保留,不补作论文未明确说明的置信区间。(C)另一项测试中,使每条受测轨迹唯一所需的最少点数分布,长尾到 11 点。来源:原论文 Fig. 2。
(C)不能读成“数据库里任何用户都只需最多 11 点”。它使用另一份随机抽取的 1,000 名高活跃用户样本,高活跃定义为每月至少使用手机 75 次。它与(B)的 2,500 条随机轨迹估计回答不同问题,样本不能混为一谈。
“唯一”也不等于“已经知道姓名”。如果外部信息可靠地属于某个具名对象,且这组信息在匿名库里只对应一条轨迹,就可能把身份关联到整条记录;实验量化的是这种关联的可行条件,而非现实攻击成功率。没有外部身份信息、目标不在库里、外部点不准确,都可能改变实际结果。
把地点合并、时间取整,能把风险降到多低?
降低分辨率有两个方向:把时间窗口从一小时扩大为 h 小时,或者把相邻基站聚合为约 v 个基站一组,再合并其服务区域。空间聚合使用频率敏感竞争学习,目的是让分组大小相对均衡。
v 是基站数量尺度,不是公里半径,也不是每一组都恰好含 v 个基站。补图 S2 给出目标大小为四时的组大小分布,确实仍有离散和尾部。因此,不能把五个城市基站和五个乡村基站当成面积相同的隐私保护。
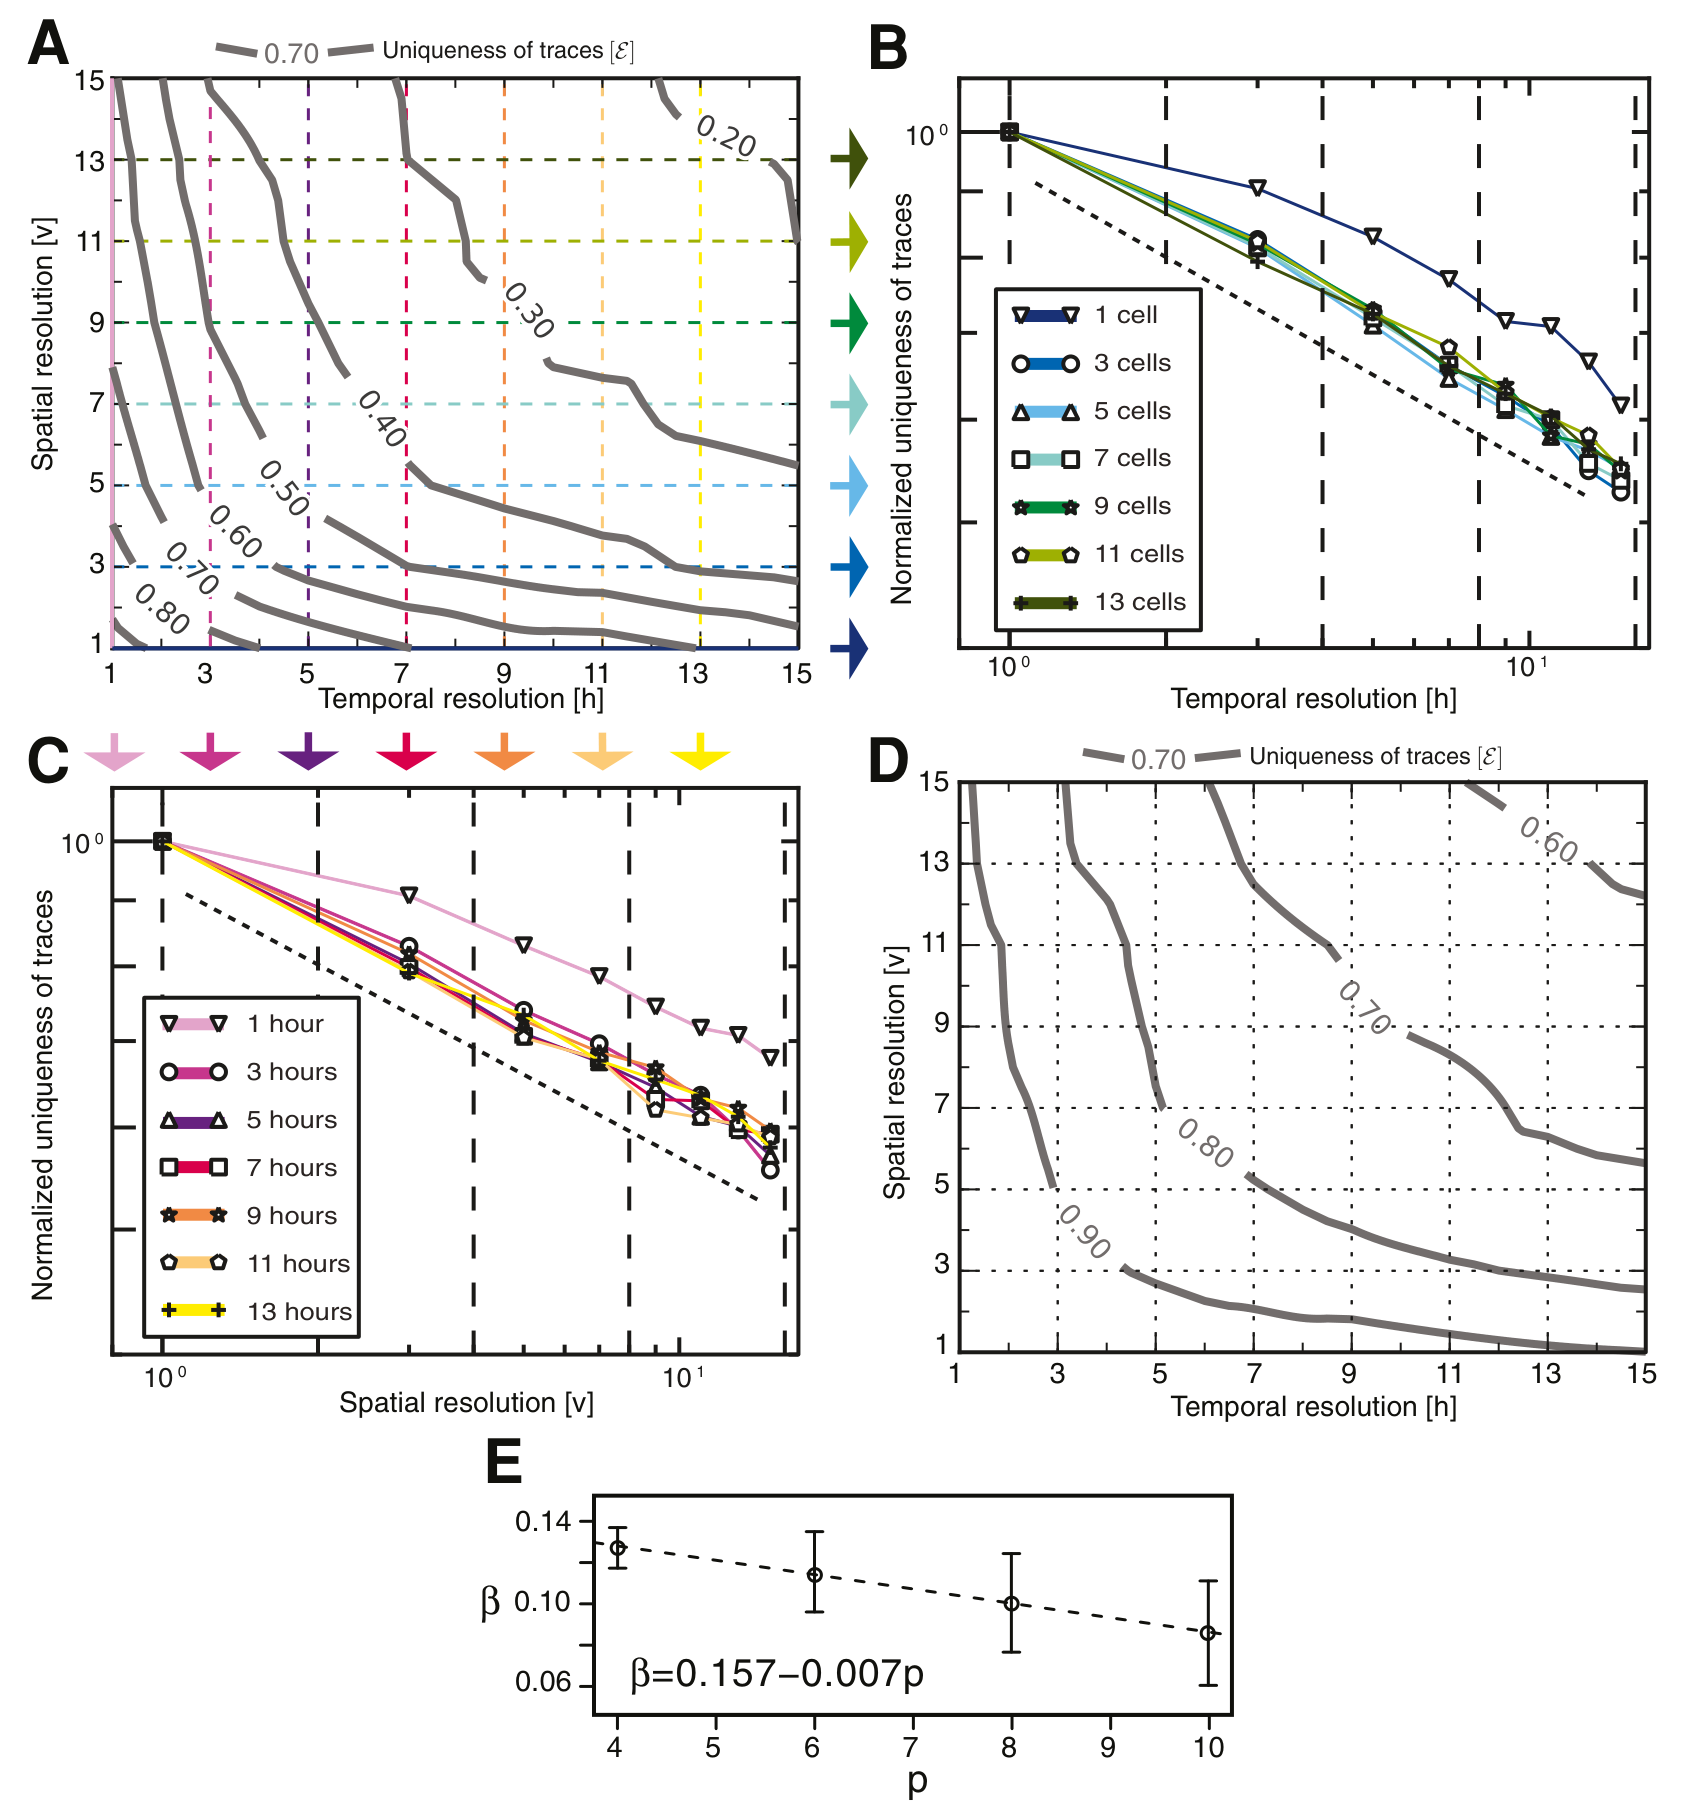
图 4|降低分辨率的收益,会被更多外部信息抵消吗?
(A)已知四点时,横轴 h、纵轴 v,等值线表示唯一比例;往右上降低两种分辨率,唯一性逐渐下降。(B)固定不同空间聚合级别,观察时间变粗时归一化唯一性的变化。(C)固定不同时间窗口,观察空间变粗时的相同变化。(D)已知十点时的等值线,说明相同聚合下更多轨迹仍然唯一。(E)拟合指数 β 随已知点数 p 下降,虚线为 β = 0.157 − 0.007p。来源:原论文 Fig. 4。
在四点条件下,h = 5 小时且 v = 5 时,唯一比例仍超过 50%。只把一个方向变粗,另一个方向保留细节,也可能剩下很多可区分信息:论文报告单独把时间变为 15 小时或空间变为约 15 个基站一组,唯一比例仍超过 60%;把两个方向都设为约七的量级时,图示接近或低于 40%。这些数值是该数据和聚合方式下的结果,不是通用安全阈值。
为概括变化,论文用 ε = α − (vh)ᵝ 拟合唯一性 ε,α、β 是拟合参数;相应切片写成 ε = α − xᵝ,其中 x 表示所改变的聚合级别。这个式子是减去一个幂函数项,不能误写为 ε 与 (vh)⁻ᵝ 严格成正比。它只在研究的聚合范围内经验拟合,超范围外推甚至可能不再得到合理概率。
补充表 S1 给出 p = 4、6、8、10 时的平均 β,依次为 0.1282、0.1164、0.1011、0.0860,所附标准差分别为 0.009、0.019、0.024、0.025。β 随 p 下降,对应更多已知信息时,依靠进一步聚合来降低唯一性的效果更弱。
拟合优度的平均 pseudo-R² 分别为 0.983、0.987、0.984、0.975。补图 S3 检查不同聚合级别的残差,未出现某一级别特别失配的总体图形。补表也比较指数、线性与拉伸指数形式,整体残差配对比较支持所选形式,但不能说每种点数下的每一个拟合指标都优于所有替代函数:四点时拉伸指数的平均 pseudo-R² 为 0.987,高于幂函数的 0.983。
因此,最稳妥的读法是“在这份数据中,简单聚合降低唯一性较慢,而且已知点越多越难保护”,而不是把大约十分之一的指数当成自然界固定不变的隐私常数。
随机抽点,会高估还是低估现实中的可关联程度?
不是每个点都提供同样多的信息。一个拥挤商业区的常见时段,可能留下很多候选轨迹;一个少见区域与时段的组合,则可能更能缩小候选集。后者也取决于已经知道的其他点,不能仅看地点是否偏远。
论文从实际通信记录随机抽点,天然更可能抽到常去地点和常发生通信的时段。补图 S1 显示一周中的小时和日期分布明显不均匀,白天和工作时段的记录较常见。研究者据此认为,有意选择信息量较大的观察可能让匹配更容易,但本文没有系统实现这种策略,也没有量化它会把四点降低为几点。
另一方面,现实外部观察未必恰好落在通信事件发生的时空窗口,平台之间的位置精度也可能不同。这会削弱本文的精确兼容匹配条件。因而,这个实验揭示了简单匿名轨迹的结构性弱点,却不等于任何拿到四条社交动态的人都能以 95% 概率找到身份。
应怎样理解这条隐私边界?
最清楚的证据是:即使数据稀疏、位置只到基站区域、时间只到小时,少量正确的时空约束仍能把很多轨迹从大型候选库中分开。删去直接标识,和防止跨数据源关联,是不同的保护目标。
研究同时留下几项外推限制。只有一家运营商、一个国家和特定历史时期的数据;用户和设备、通信习惯与实际人口之间未必一一对应;估计唯一性使用抽样,且点来自已记录事件。人口密度、基站密度、窗口长度与样本规模改变后,结果都需重新检验。
它没有比较差分隐私、只发布聚合流量或受控计算等方案,更没有证明所有轨迹研究都无法安全开展。论文直接挑战的是“删除姓名,再适度模糊坐标,就足以使逐人轨迹匿名”这一简单推断。
一句话总结
在这份 150 万用户的稀疏手机记录中,四个正确的随机时空点便足以唯一匹配约 95% 的受测轨迹;真正需要防范的,是身份已删、整条轨迹却仍可被少量外部线索关联起来。
核心来源
- 正式论文及书目信息。
- PMC 全文与补充材料入口:Supplementary Information,含 Figs. S1–S3、Table S1。本文四张图均来自正式论文。
作者介绍
- Yves-Alexandre de Montjoye:论文署名机构为 MIT Media Lab 与鲁汶天主教大学的信息通信技术、电子学及应用数学研究所;设计并实施实验、分析数据和撰文。
- César A. Hidalgo:论文署名 MIT Media Lab、哈佛大学国际发展中心及瓦尔帕莱索复杂系统研究所;设计实验、开发分析工具并撰文。
- Michel Verleysen:署名鲁汶天主教大学上述研究所;参与实验设计与写作。
- Vincent D. Blondel:署名鲁汶天主教大学上述研究所及 MIT 信息与决策系统实验室;参与实验设计与写作。以上均按论文发表时署名介绍。
延伸思考:保护对象不应只是一行记录
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一张轨迹表可以没有姓名,每一行也都落在人很多的区域,但若稳定的匿名编号把几百行连接起来,保护对象就从单次出现变成整段生活。逐行检查是否“够模糊”,容易漏掉这些记录联合后提供的区分力。
这提示一种更贴近使用场景的评估:先明确研究到底需要整条逐人轨迹,还是只需要群体流量和统计规律,再分别衡量输出能够回答哪些科学问题、还能被哪些合理的外部线索关联。这样的比较需要同时报告研究效用与轨迹级风险,不能只给一个坐标保留了几位小数的技术参数。