一条消息传不开,是没人遇见,还是遇见的人不想转?
论文名片|Narisa Zhao、Guoqin Sui、Fan Yang,Effect of Heterogeneous Interest Similarity on the Spread of Information in Mobile Social Networks,Journal of the Physical Society of Japan 87, 064003(2018),2018 年 5 月 14 日在线发表。DOI:10.7566/JPSJ.87.064003。研究类型:随机传播模型、平均场近似与五条微博传播曲线拟合。
同一条新品消息,有人很喜欢,见到朋友就想分享;朋友可能兴趣相近,也可能只是礼貌地看一眼。即使两人碰面的机会一样,消息能不能继续传,也取决于发出和接收两边的选择。这个日常场景只为说明论文的机制,并非论文中的现场实验。
本文把“遇见”“愿意发”“愿意收”分开,并允许一部分人逐渐开始感兴趣、另一部分收到消息的人退出传播。模型结果提示,兴趣最明显地改变传播的起速和早期覆盖;等观察时间足够长,几组结果可能靠近。微博案例表明这套方程能拟合若干累计转发曲线,但尚不能据此证明现实传播中的兴趣因果机制。
先说结论
- 接触不等于传递。模型把发送者对消息的兴趣与双方兴趣相似度相乘,再与相遇过程结合。
- 典型的 1,000 节点模拟中,提高平均兴趣会显著提前扩散:覆盖 400 人所需时间,从低兴趣组约 30,930 秒降到高兴趣组约 7,932 秒。
- 累计收到消息的人数,与当前仍携带、能传播消息的人数不同。后者可以归零,而前者仍然很高。
- 五条微博的拟合误差报告为 3.81%—8.91%,但总人群规模参照最终转发量设置、部分参数由曲线拟合,并没有构成对陌生消息的独立前瞻预测。
有兴趣、收到消息、继续传播,是三种不同状态
论文把固定的 N 个节点分成四类:UI 是不感兴趣,US 是有兴趣但尚未收到消息,S 是已收到、可继续传播,D 是已收到后丢弃消息、不再传播。这里的 S 指 satisfied,不能按常见传染病模型把它误读为易感者。
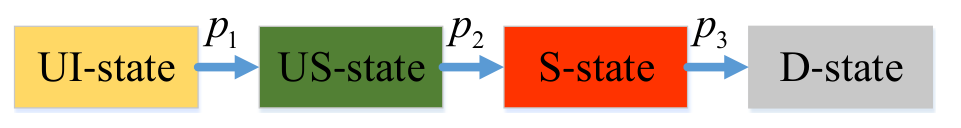
图 1|消息传播需要经过哪些门槛?
原图没有子图:从左到右,UI 以概率 p1 转为 US,US 接收到消息后以概率 p2 转为 S,S 以概率 p3 退出成为 D。D 是吸收状态,模型中不能再回来。来源:原论文 Fig. 1。
兴趣变化在这里有很具体的含义:未感兴趣的人以速率 ρ 进入有兴趣状态,携带消息的人以速率 μ 退出。每个节点的数值兴趣 xi 在一条短时消息的传播期间保持不变;变化的是状态,不是 xi 随时间不断漂移。模型也不允许从 US 返回 UI,或从 D 重新开始传播。因此,它刻画的是一种单向的生命周期,不能解释反复退热又复燃的全部过程。
相遇被设为泊松过程,相邻接触间隔服从指数分布;在 Δt 内相遇的概率为 1 − exp(−λΔt)。这是均匀接触假设,不是从这些用户的真实定位轨迹估计出的出行规律。论文虽讨论移动社交网络,但没有显式模拟城市道路或每个人的位置。
接触之后,谁愿意把消息交给谁?
xi 在 0 到 1 之间,越大表示越喜欢该消息。若发送者 l、接收者 g 的兴趣分别为 xl、xg,论文给定接触后成功传递概率:
P(l→g) = xl × [1 − |xl − xg|]。
第一项体现发送者对内容的兴趣,第二项体现双方兴趣接近程度。这两个作用由模型预先假设,后续模拟检验的是这些假设共同产生什么结果,而非从实验中独立发现这个乘法关系。
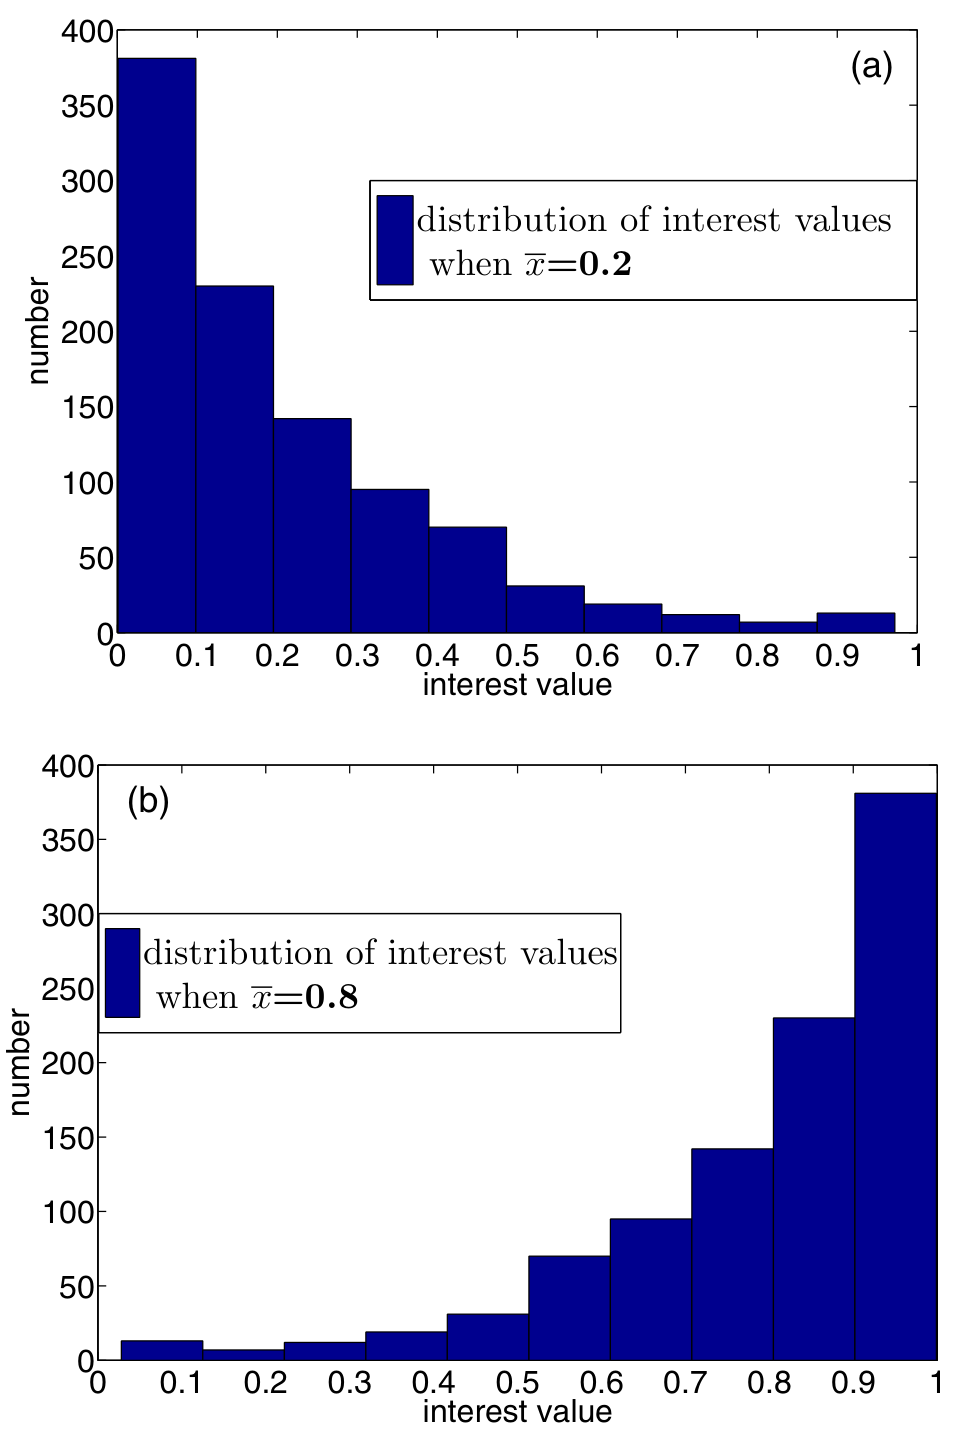
图 2|平均兴趣较低或较高,模型里的人群是什么样?
(a)平均兴趣约 0.2 时,大多数节点兴趣较低,采用截断指数分布。(b)平均兴趣约 0.8 时,分布向高值集中,由 1 − xi 的截断指数分布构造。横轴是兴趣,纵轴是节点数;它们是设置出来的人群,不是调查测量。来源:原论文 Fig. 2。
因此,改变平均兴趣时,兴趣方差和两人相似度也一起变化。“内容吸引力”和“人与人相似度”并没有在这些实验中保持其他条件不变地分别随机操控。论文在所选分布族中认为内容兴趣的作用更强,这个结论不宜直接推广为现实中兴趣同质性始终不重要。
怎样从逐人随机过程得到一条总体曲线?
随机模型逐个判断相遇、传递和退出。平均场方程则用每种状态的期望人数描述整个系统,近似把节点间的状态与兴趣组合效应压缩为一个总体参数 β。
记 X 为仍能传播的人数期望,Y 为有兴趣未收到,Z 为未感兴趣,D 为已退出。式(16)的结构是:X 的增长来自接触项 λβXY/[N(N−1)],减少来自 μX;Y 接收消息会减少,但又从 ρZ 得到补充;Z 以速率 ρ 衰减,D 以 μX 增长。全体人数保持 N 不变。
这里 β 汇总不同有向节点对的传递概率,和节点规模有关,并非某一个人的兴趣,也不是直接可以跨数据集比较的概率。实际微博部分使用 β 的标度与图示数量级未完全统一,复现应连同归一化方式核对,不能把两处数值直接代入同一方程。
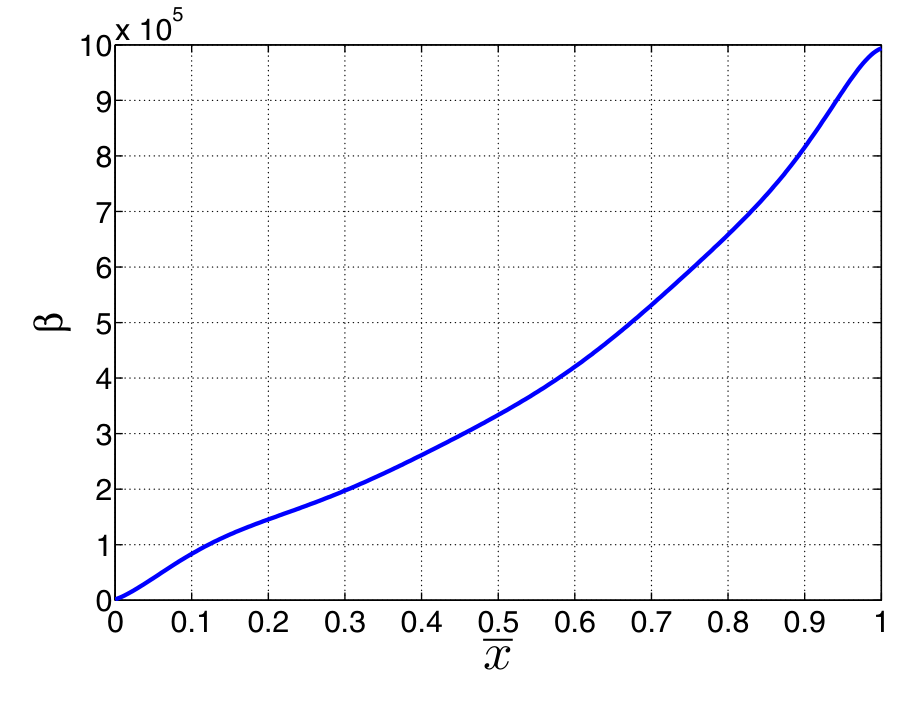
图 3|个体兴趣分布怎样进入总体方程?
原图没有子图,横轴为平均兴趣,纵轴为按式(9)汇总的 β,标有 10⁵ 数量级。曲线在设定分布下整体上升。它解释了参数如何变化,并不是由现实用户估计出的普遍关系。来源:原论文 Fig. 5。
为区分“当前传播”和“曾经覆盖”,论文采用累计覆盖 S(t) = X(t) + D(t)。这个 S(t) 是人数统计,与上面的 S-state 名称相近,却不是只数当前携带者。后面所有累计覆盖图都应按这一口径读。
方程能否重现同一套规则下的随机模拟?
典型设置为 N = 1,000,初始一人携带消息、199 人有兴趣但未收到、800 人不感兴趣,没有退出者;μ = 2×10⁻⁴、ρ = 10⁻⁴,时间单位为秒。Java 随机接触模拟与 MATLAB 常微分方程求解作比较,共运行 50 次模拟。
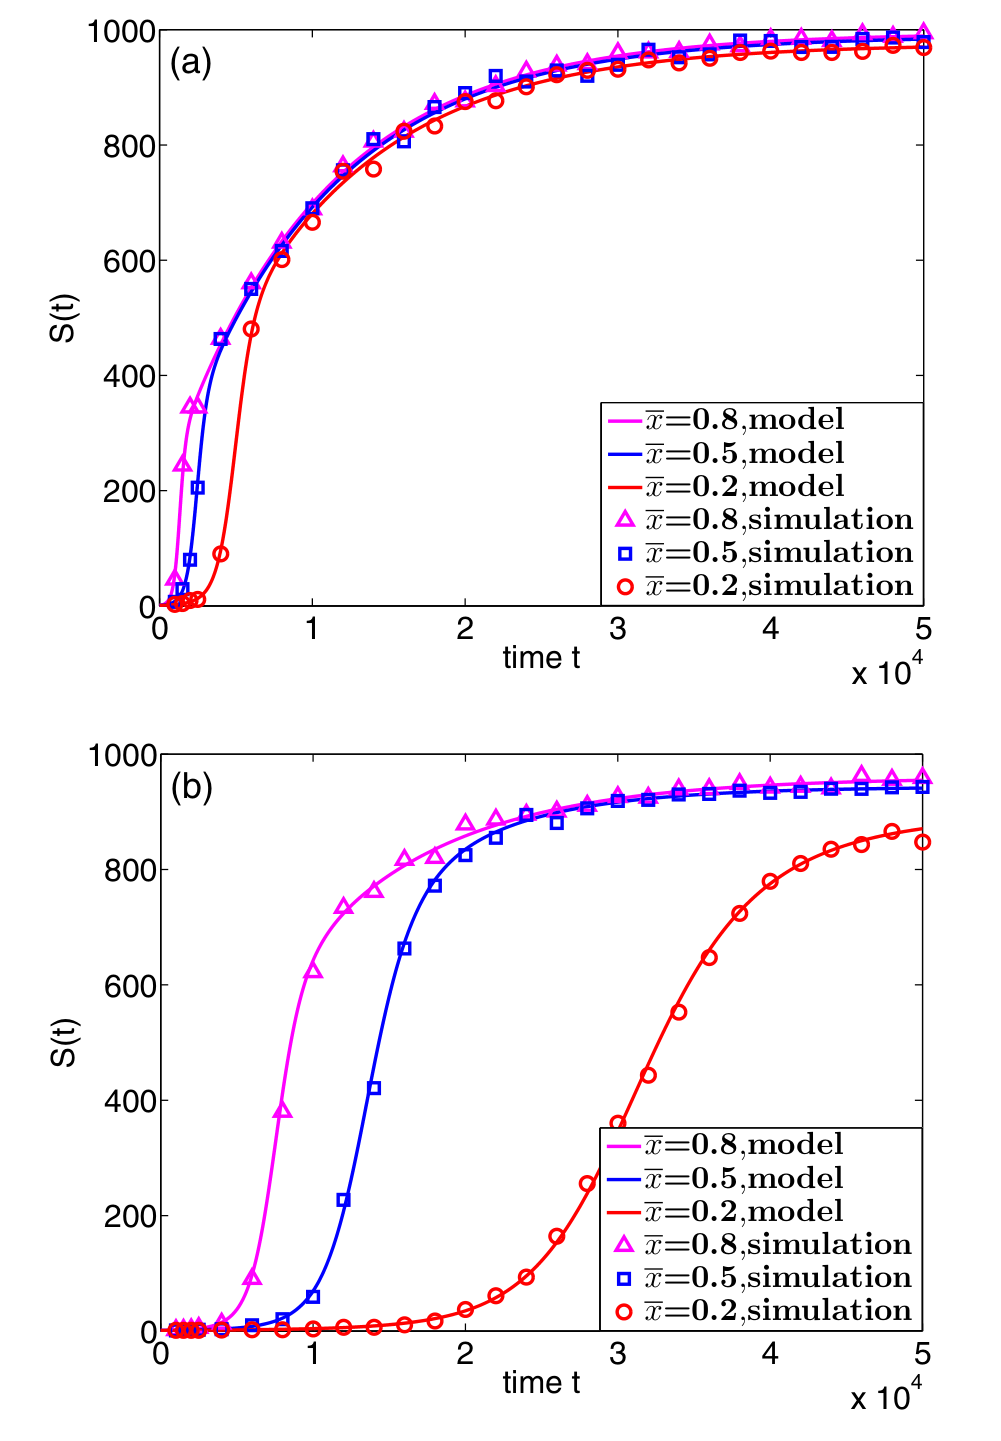
图 4|把逐人过程平均化,会不会改变扩散曲线?
(a)接触率 λ = 2.8×10⁻⁵,(b)λ = 3.71×10⁻⁶。横轴为秒、纵轴为累计覆盖人数,不同颜色对应平均兴趣 0.2、0.5、0.8;实线为方程结果,符号为随机模拟。低接触率下不同兴趣组的起速差更明显。来源:原论文 Fig. 4。
报告的平均相对误差在高接触率下分别约为 3.19%、4.69%、5.12%,低接触率下约为 6.2%、3.48%、7.9%。这些数值支持平均场近似在测试设置下能接近相同机制的随机模型,不能当作现实信息传播的预测误差。
论文还给出基本再生数 R0 = λβ/[μ(N−1)]。它是在接收者都处于可接收状态附近得到的局部传播阈值,不是最后一共有多少人收到消息。
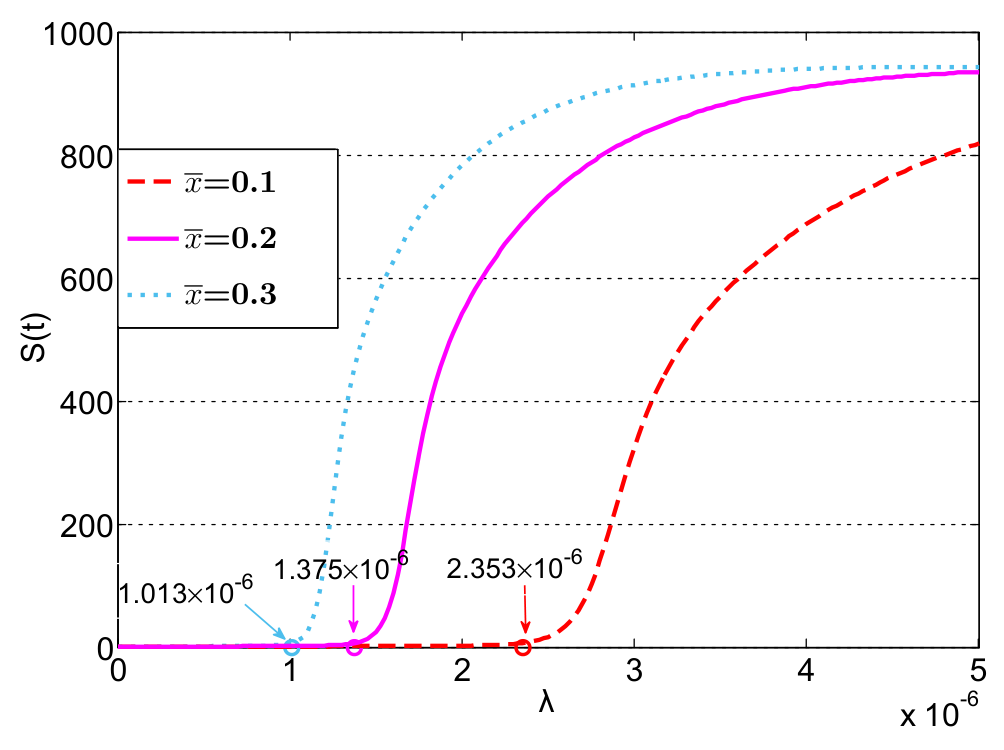
图 5|提高兴趣,会降低模型启动传播所需的接触率吗?
原图没有子图,横轴为 λ,纵轴为第 150,000 秒的累计覆盖人数;红、紫、青对应平均兴趣 0.1、0.2、0.3。原图标出的 R0 约为 1 的接触率依次为 2.353×10⁻⁶、1.375×10⁻⁶、1.013×10⁻⁶。来源:原论文 Fig. 3。
R0 的式子里没有 ρ,不意味着改变开始感兴趣的速度永远无效。推导选取的是 Z = 0、Y = N 附近的状态;在真实有限时间的过程里,接收者能多快补充仍可能改变传播。这个区分对理解后面的敏感性分析很关键。
提高兴趣,改变的是早期速度还是最终人数?
后续比较主要固定较低接触率 λ = 3.71×10⁻⁶,其他条件沿用上面的典型设置。这样可以看到,在同样接触机会下,兴趣改变会怎样移动覆盖曲线。
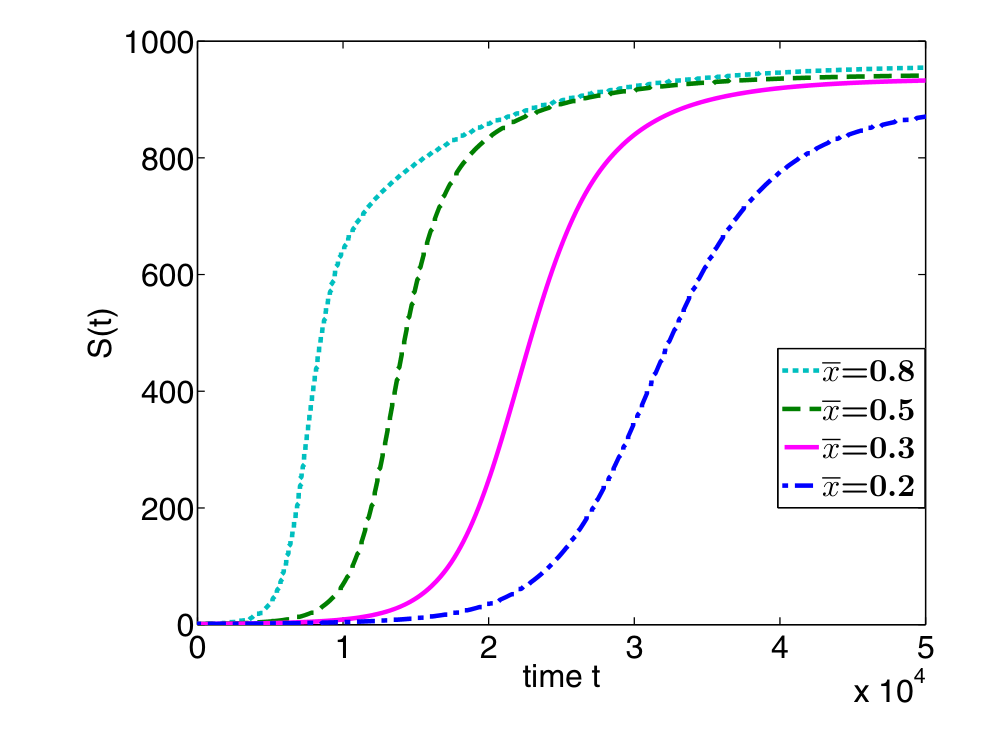
图 6|同样接触机会,哪一组更早收到消息?
原图没有子图,横轴为秒、纵轴为累计覆盖人数,四条线对应平均兴趣 0.2、0.3、0.5、0.8。兴趣较高的曲线更早上升,但到较晚时间,几组曲线间距缩小。来源:原论文 Fig. 6。
达到 400 人,也就是这 1,000 节点系统的 40% 覆盖,平均兴趣 0.2、0.5、0.8 所需时间分别约为 30,930、13,560、7,932 秒。这里比较的是同一模拟总体下达到同一覆盖水平的时间,不是实际微博平均传播时长。
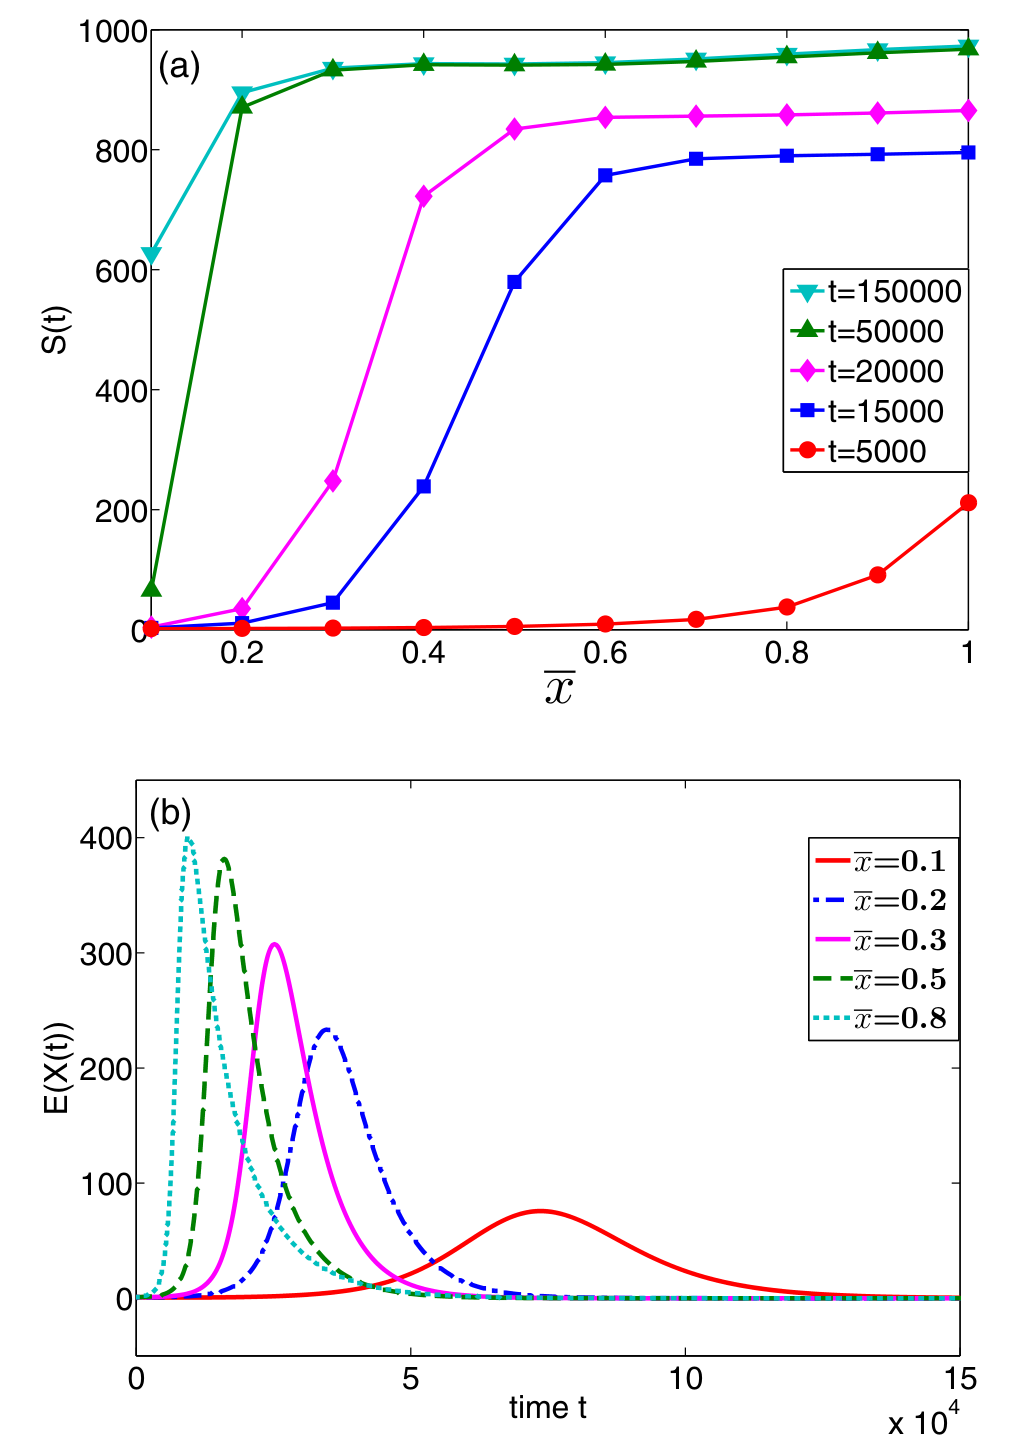
图 7|早期差别很大,为什么后来会看起来接近?
(a)横轴平均兴趣、纵轴累计覆盖,不同颜色为 5,000 到 150,000 秒的观察时点;观察得越久,达到较高覆盖所需的兴趣水平越低。(b)横轴时间、纵轴当前携带消息的人数 X,较高兴趣组更早出现高峰,最后各组都接近零。来源:原论文 Fig. 7。
两幅图合起来说明:当前没有人继续传播,并不表示消息只到过很少人;人们可能已经收到并退出。另一方面,低兴趣组在有限时间内可能明显落后,不能因为长时间后曲线接近,就说兴趣没有作用。
退热与新兴趣,哪一项更容易让传播停下?
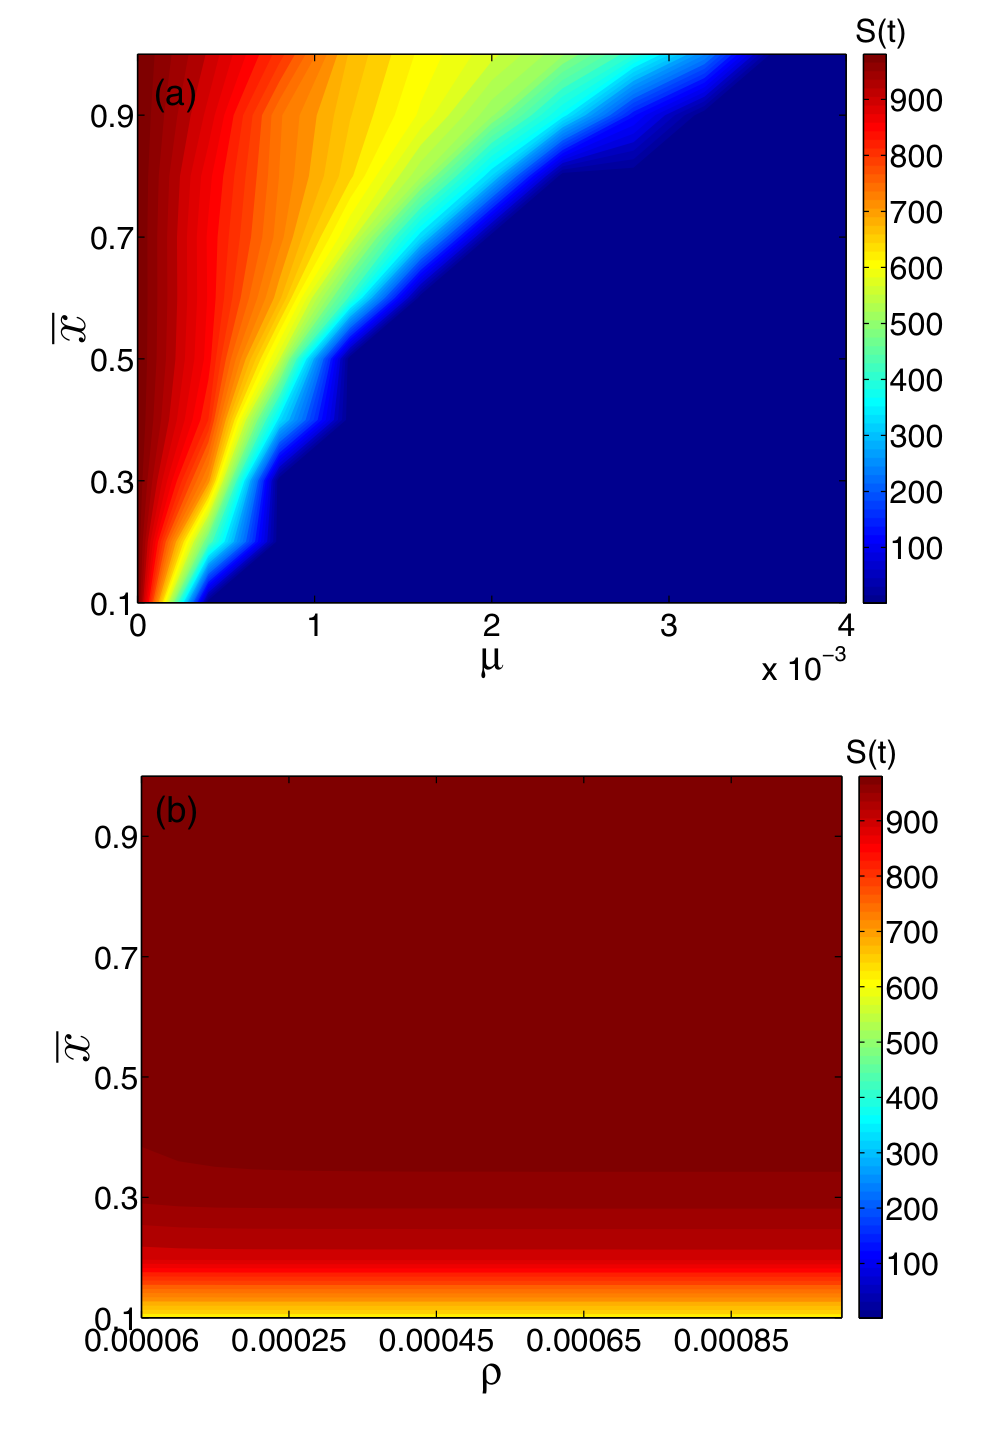
图 8|同样平均兴趣,退出快慢能否改变结果?
(a)横轴 μ 为退出速率、纵轴平均兴趣,颜色是第 150,000 秒累计覆盖;退出越快,通常覆盖越小,较高兴趣可以在部分参数区间抵消这一作用。(b)横轴 ρ 为开始感兴趣的速率,纵轴与颜色含义相同;在测试的 6×10⁻⁵ 到 10⁻³ 范围内,各兴趣组对 ρ 的变化相对不敏感。来源:原论文 Fig. 8。
在这么长的观察窗口与给定 ρ 范围内,不感兴趣者已经有足够时间转入可接收状态,因此(b)不能被推广成“培养兴趣的速度不影响传播”。对更短窗口或更低 ρ,需要重新计算。
五条微博,能验证到哪一层?
现实案例包含华为、Vivo、电影、音乐、新闻五条消息。华为例子在 2017 年 5 月 26 日 17:00 至次日 8:00 收集到 2,088 名转发用户。兴趣得分来自个人标签、兴趣主页标签与是否关注发布者,把与消息主题相交的特征数除以用户特征总数。它是标签构造的代理量,不是用户自报的真实心理兴趣。
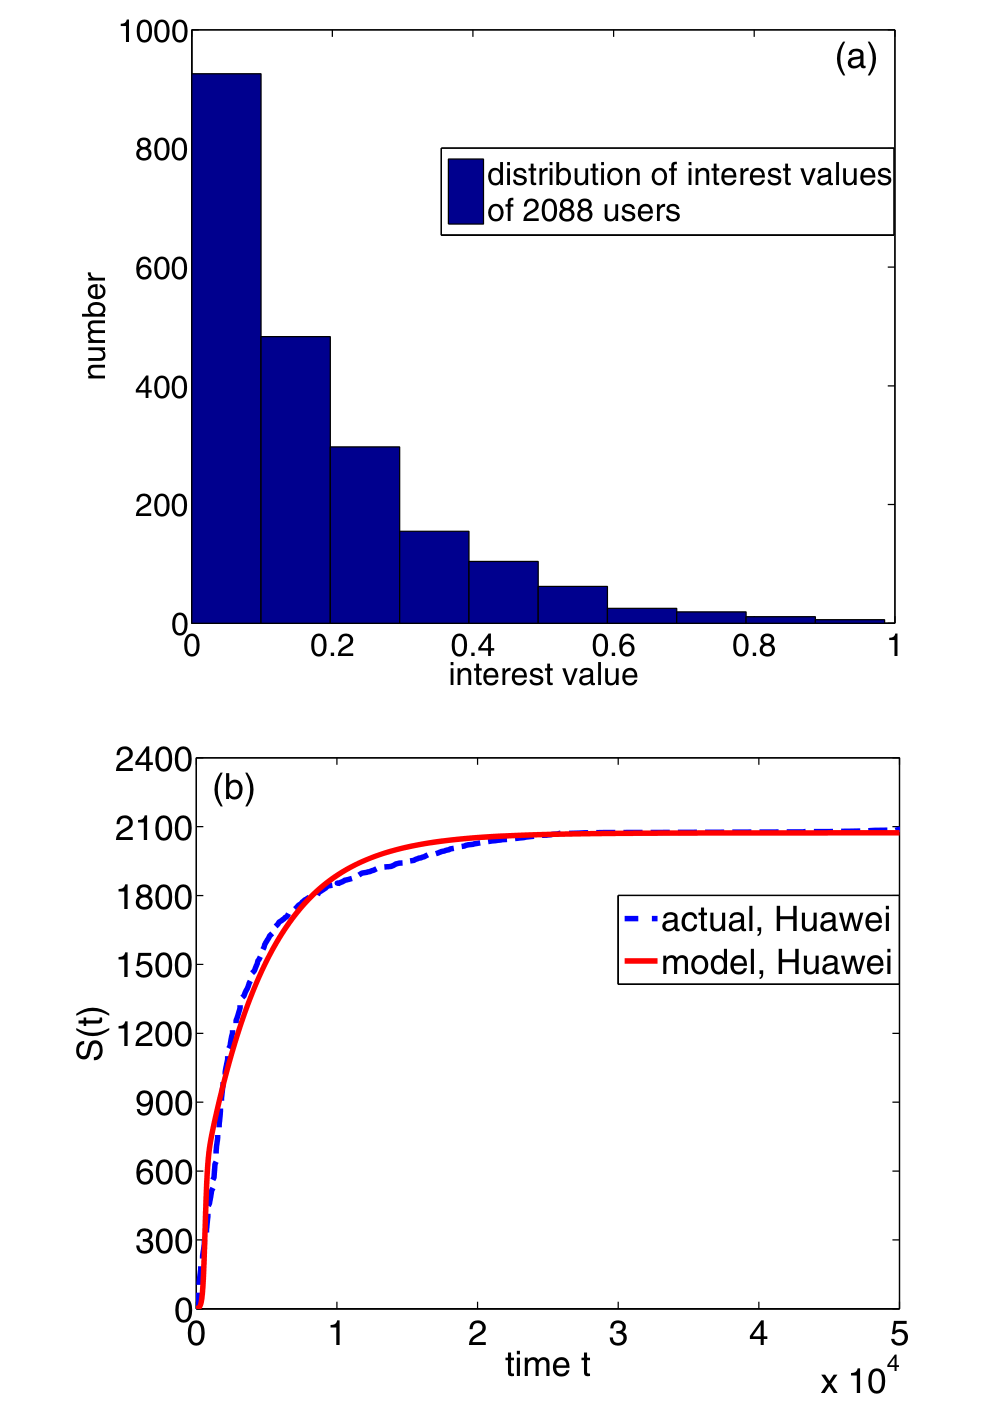
图 9|代理兴趣得分与累计转发,能否同时被模型描述?
(a)2,088 名转发用户的兴趣得分直方图,低得分人数较多;(b)蓝虚线为累计实际传播,红实线为模型曲线,横轴为秒。两条曲线相近,主要说明拟合形状吻合。来源:原论文 Fig. 9。
模型设 N = 2,100,参照最终数据规模;初始设 425 名有兴趣未接收者,对应已观察到的转发用户中关注发布者的人数;一名消息源,其余 1,674 人为不感兴趣者。μ、ρ、λ 难以直接测量,因此使用前 600 条实际数据调参,使误差控制在 5% 内;全曲线报告误差为 3.81%。
这不构成完全独立的预测:标签和初始关注者来自最终已转发的人群,总体 N 也参照最终规模,未观测到、看过但未转发的人并没有以同样方式进入样本。即使只用前一段曲线调参,其他设定仍可能包含事后信息。
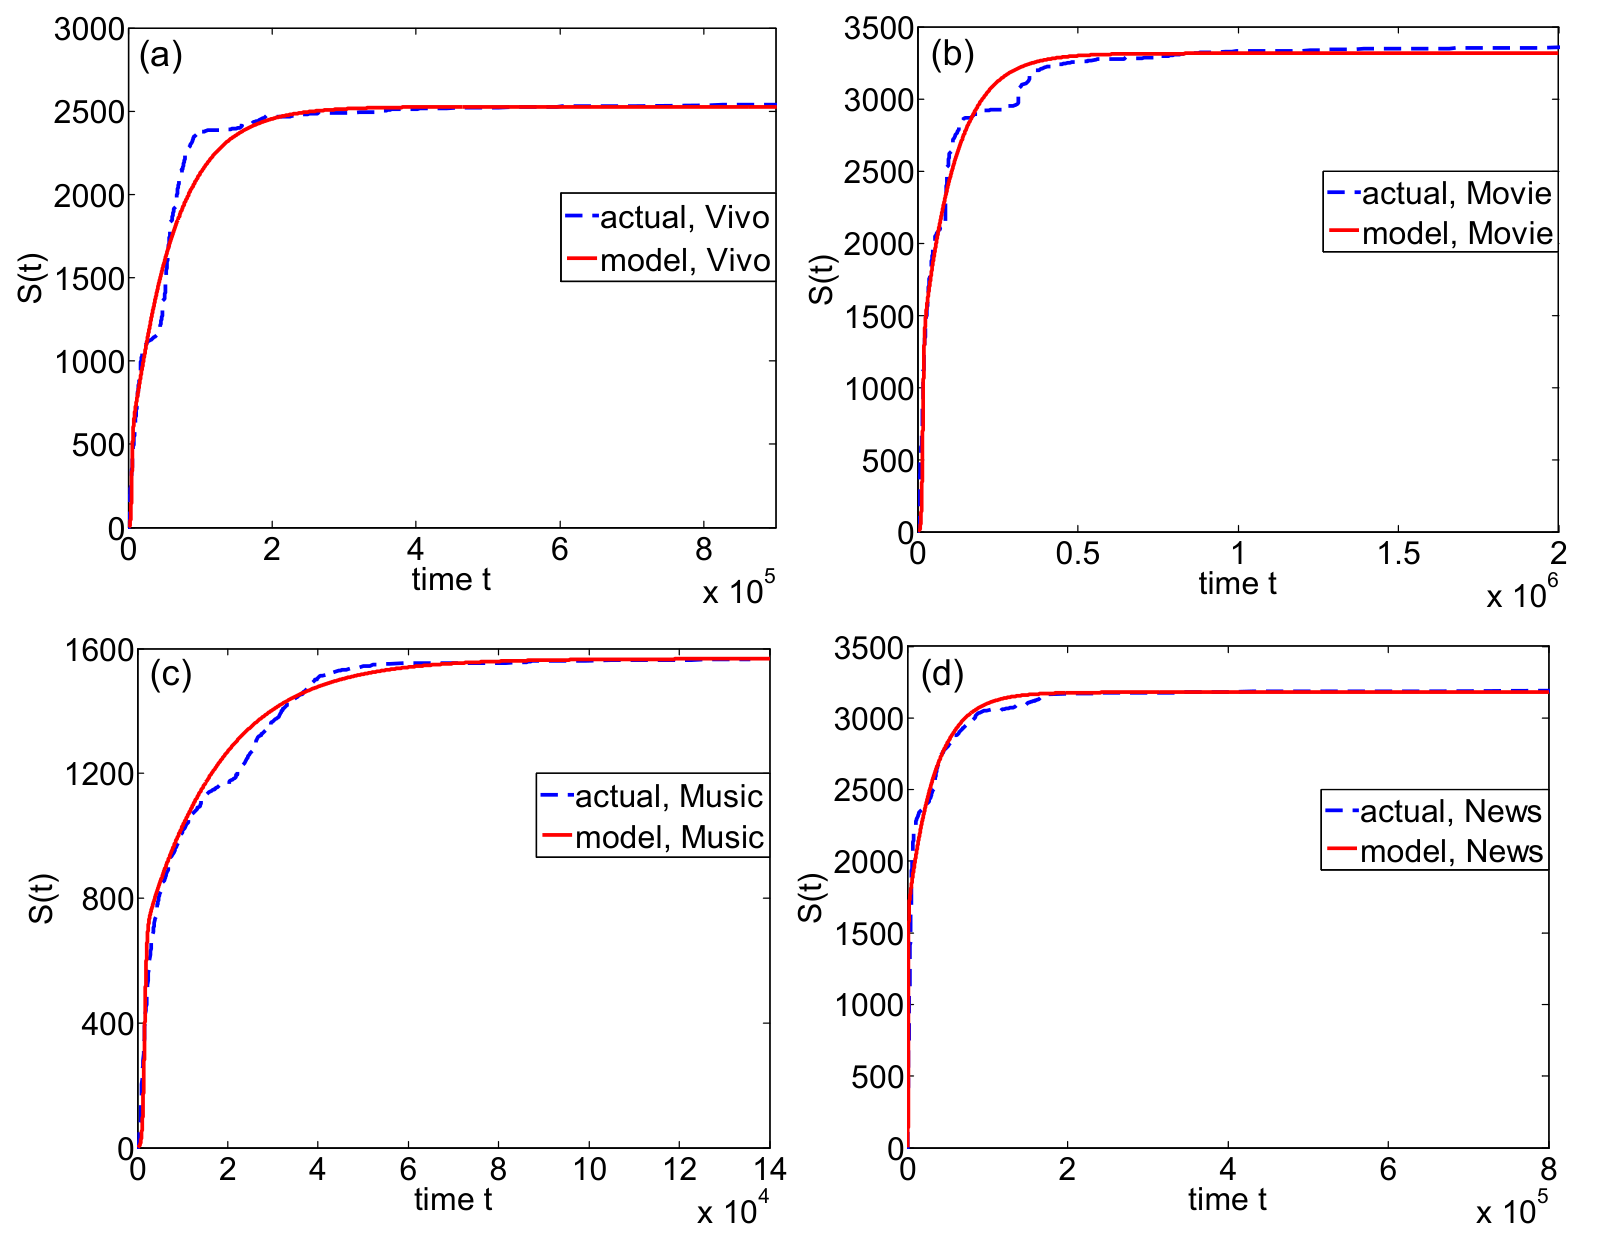
图 10|换几种消息内容,曲线拟合是否仍然可行?
(a)Vivo 研发中心消息,(b)电影预告,(c)电影主题曲,(d)新闻日历。各图横轴为秒、纵轴为累计人数,蓝虚线为实际、红实线为模型;各条消息分别设定规模和拟合速率。来源:原论文 Fig. 10。
| 消息 | 观察到的转发人数 | 设定 N | 报告误差 |
|---|---|---|---|
| 华为 | 2,088 | 2,100 | 3.81% |
| Vivo | 2,539 | 2,600 | 8.91% |
| 电影 | 3,355 | 3,400 | 8.44% |
| 音乐 | 1,566 | 1,600 | 4.81% |
| 新闻 | 3,184 | 3,200 | 4.08% |
其余四组数字来自 Table I。它们显示多条累计曲线可以被模型描述,但没有无兴趣模型、其他扩散模型的同条件比较,也未报告跨消息共享参数的外部验证。因此,误差小于 9% 不能直接换算为“至少 91% 的预测准确率”。
还有一个跨场景边界:理论部分把接触理解为移动节点的相遇,微博转发却可发生在远距离用户之间。用同一个 λ 拟合总体曲线,并未证明微博中存在同样的近距离接触过程。
这篇论文最有用的启发是什么?
它把一条常被合并的传播链拆开:相遇、发送意愿、接收意愿、进入兴趣状态和退出状态,可能分别改变传播。它也清楚展示,同样的最终覆盖数字,可能藏着很不一样的早期速度。
解释力度仍受建模假设限制。固定的兴趣数值、均匀泊松接触、平均场近似和单向状态转换,都简化了真实社交网络。五条微博的曲线拟合没有唯一识别这些机制,真实网络结构、推荐曝光、重复接触与节点位置仍可能重要。更适合把它视为可检验的机制模型,而不是已经验证的传播干预处方。
一句话总结
在这套模型中,消息遇到谁与双方是否愿意传递共同决定扩散,兴趣尤其改变早期速度;现实微博曲线的拟合支持模型可描述数据,却不足以确认兴趣机制或独立预测能力。
核心来源
- 正式论文 DOI 与期刊入口:全部十张主图、式(1)—(22)、五条案例与 Table I。
作者介绍
Narisa Zhao、Guoqin Sui、Fan Yang 均署名大连理工大学系统工程研究所。Guoqin Sui 为论文所标通讯联系人。原文未列逐人贡献分工,故不进一步推定各自负责的实验、分析或写作任务。
延伸思考:同样的最终转发量,不一定需要同样的解释
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
两条消息最后都转发一千次,一条可能靠短时高度集中的兴趣迅速完成,另一条可能靠长时间持续曝光缓慢累积。若只拟合最终人数,很容易把这两种过程压缩成同一个“传播效果好”。
一个更有区分力的检验,是在预先划定、尚未转发的用户总体中分别测量曝光、是否愿意接收和是否继续分享,事先冻结人口规模与兴趣指标,再只用早期数据预测后半段曲线。若引入两种兴趣相似度后,跨消息的时间预测也稳定改善,才更接近证明这些变量提供了可迁移的信息,而不只是增加可调参数。