交换生去了哪里,一张名单怎样变成欧洲流动地图?
论文名片|Tuomas Väisänen、Milad Malekzadeh、Oula Inkeröinen、Olle Järv,Mobility of Erasmus+ students in Europe: Geolocated individual and aggregate mobility flows from 2014 to 2022,Scientific Data 12, 489(2025)。原论文 · 数据描述论文。
假设你想知道,疫情之后欧洲哪些地方重新吸引了交换生。原始记录里有派出学校、接收学校和城市名称,看起来只要放到地图上就行。但同一座城市可能用不同语言拼写,重音字符可能损坏,有些城市栏里甚至填着学校编号。一个错误匹配,可能把整批学生送到同名的另一个地方。
这篇论文的主要贡献,是把 Erasmus+ 2014—2022 年学生流动记录转成能够连接欧洲地区统计的空间数据。它提供了研究区域联系的底座,也展示了一些应用;交换生流入本身,仍不等于毕业后人才永久留下。
先说结论
- 数据保留年满 18 岁、流动持续至少 90 天的学生记录,提供个体层级表与 LAU、NUTS 3 两套地区间汇总表。
- NUTS 3 层级有 2,191,857 条空间化流动记录,LAU 层级有 2,052,029 条;两者覆盖范围不同,不能把缺项都当作地理编码失败。
- 人工核查的 1000 个地名中,966 个落在正确 NUTS 3 区域;按相关流动记录加权后的正确份额约为 99.4%。它不是学校地址或 LAU 都有同等精度的保证。
- 数据揭示接收与派出、来源多样性和疫情时期的区域差异,但没有直接测量经济增长、知识传播或欧洲身份认同的因果效果。
统计的是一次交换,还是一个独立的人?
原始数据由欧盟教育、青年、体育和文化主管部门按年发布,包含的不只有高校学生,也有教师、员工及其他教育活动。研究先筛选 learner 类别、年龄至少 18 岁、持续至少 90 天,排除不符合目标的短期活动与工作人员流动。
一行表示一组具有相同流动特征的记录,Actual participants 给出对应参与人数。在少数情况下,相同出发地、目的地、专业、性别和持续时间的多个参与者合并在一行。因此,流动行数与参与人数之和不同,逐行计数不能直接替代学生人次,也不能据此确定跨年不重复的独立学生数。
表 1 列出原始变量,包括出发与接收的国家、城市、机构,开始月份、持续天数、年龄、性别、学习领域和教育阶段。表 2 按年份展示筛选后、地理编码前的规模;表 3 则对应空间化后两个地理层级的流动行数。比较前后数量时,需要保留同一统计口径。
它覆盖 Erasmus+ 这一项目,而不是欧洲所有学生交换。其他奖学金、学校双边合作、未满 18 岁和少于 90 天的流动均不在相同范围内。英国在 2021、2022 年仍有记录,论文解释为脱欧前已获资助项目继续执行,不能据此把当年项目参与规则作简单推断。
地名清洗,为什么比查一次坐标更重要?
记录中既有 Estocolmo 与 Stockholm 这类跨语言拼写,也有多余字母、问号替换重音和城市名缺失。研究在城市字段损坏或缺失时借助机构名称,再把起点、终点地名合并去重,得到 48,281 个独特地名待解析。
主要地理编码(geocoding,即把文字地点转成坐标)使用 Photon,对未成功解析的记录做人工修正,再辅以 Nominatim。修正优先处理涉及多次流动的地点;只出现一次、最后仍无法定位的 539 个地名被舍弃。最终有 47,742 个地名获得坐标,约为独特地名的 99%。
成功返回坐标不等于正确。地名解析可能偏向更知名的同名城市,机构名也可能对应多个校区。对于只有 NUTS 3 区域代码的输入,研究还曾选区域最大城市来获得更细层级位置;由此得到的 LAU 不能自动当作实际校园所在市镇。
同一所学校,为什么不同年份要用不同边界?
坐标先与区域多边形相交;未相交时,在 5 公里范围内找最近区域,主要处理岛屿附近点落在水面等情况。若仍找不到,则不进行空间归属。这项容差让更多地点可用,也可能在边界附近产生误配,尤其影响更细的 LAU。
LAU(Local Administrative Unit,地方行政单元)大致对应市镇;NUTS 3 是欧洲统计地域单元体系中最细的一档,面积通常更大。边界会调整,因此研究按流动年份选择相应空间版本。
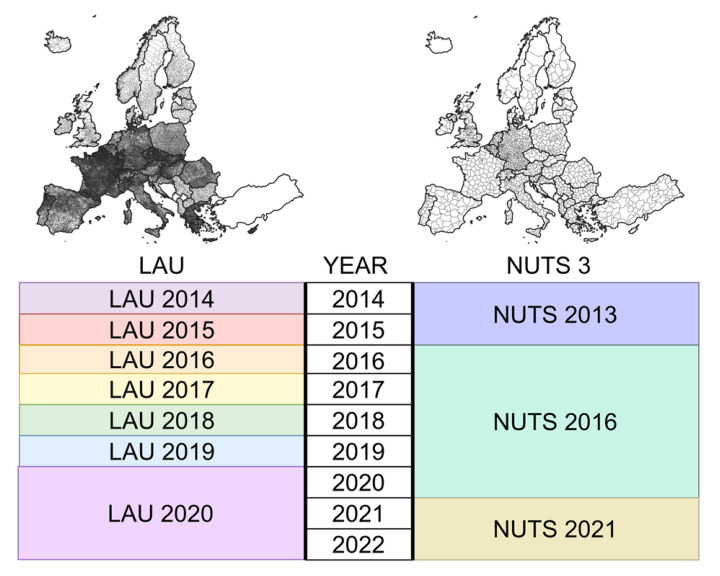
图 1|历史流动应该接到哪一版行政统计地图?
本图没有字母子图。中央列为流动年份,左侧为 LAU 版本,右侧为 NUTS 3 版本:2014—2015 年对应 NUTS 2013,2016—2020 年对应 NUTS 2016,2021—2022 年对应 NUTS 2021;LAU 后期采用 2020 版本。颜色块表示边界版本的适用区间,不是流动量。跨年比较仍要检查边界变化。来源:原论文 Fig. 1。
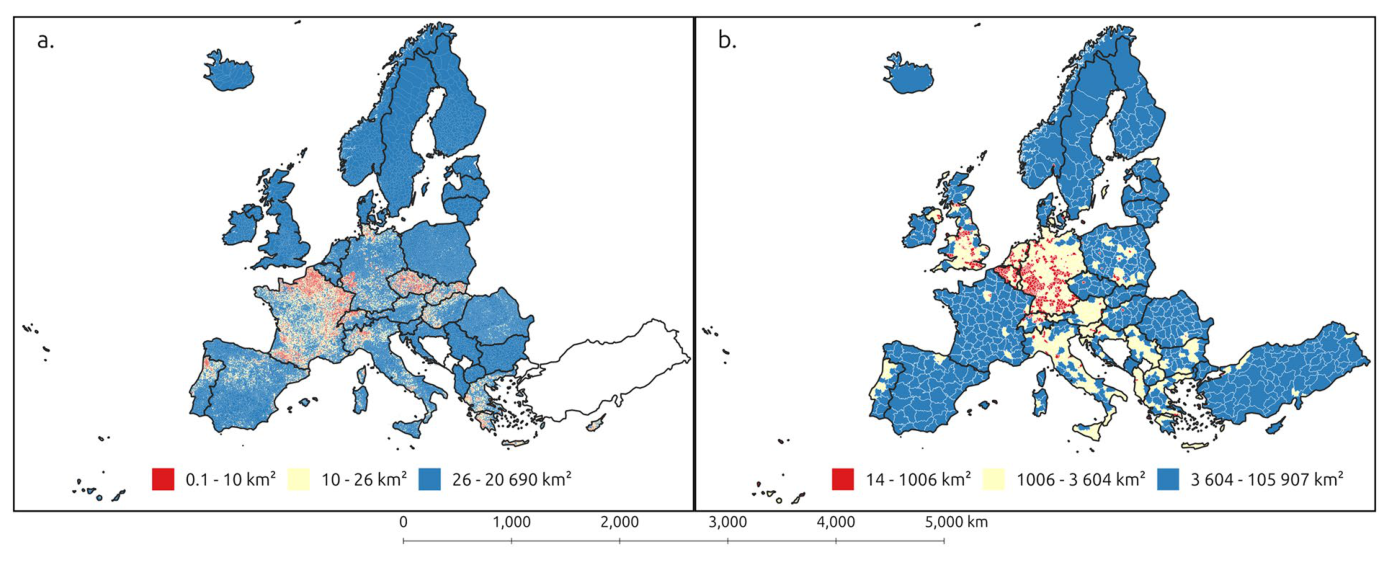
图 2|两套空间单元,细到什么程度?
(a)LAU,采用 2020 版本;(b)NUTS 3,采用 2021 版本。颜色按面积分档,每档区域数相等;蓝色为较大单元,红色为较小单元。LAU 没有覆盖土耳其与斯瓦尔巴等地区,所以细层级汇总缺少部分流动并不意味着这些地方没有交换。来源:原论文 Fig. 2。
表 3 报告,2014—2022 年 NUTS 3 层级共 2,191,857 条流动,LAU 为 2,052,029 条。论文的数据记录部分另给出完整个体表共 2,221,474 条记录;有某种地理信息可用,与两端都能落到指定层级,不能被混为同一条件。
96.6%和99.4%,分别验证了什么?
研究从地理编码结果中按地名在流动中出现的频率加权抽样 1000 个地点,人工检查其 NUTS 3 归属,使用 2021 版边界与 2021、2022 年流动。966 个正确、34 个错误,得到地点层面的 96.6%。
表 6 进一步看这些地点代表的流动记录:起点正确 385,031 条,分母为 387,345 条;终点正确 384,986 条,分母为 387,229 条,对应约 99.403%与 99.421%。较常见地点多数正确,因此加权到流动记录后的份额高于地点本身的正确比例。
这些数值不是对所有年份、所有机构地址和 LAU 归属分别完成的独立验证。NUTS 3 较大,点偏一点仍可能落在正确区域;LAU 更小,误配风险会更高。对于研究小城市、罕见路径或具体校园的人,流动加权的高准确性也可能掩盖自己最关心的误差。
哪些地方接收更多,能直接叫作人才流入吗?
数据可以计算地区接收与派出的相对平衡,并观察 2020 年疫情时期的变化。原图把可正可负的指标称为 receiving-sending ratio,正值表示接收占优、负值表示派出占优;它显然不能按一个普通接收人数除以派出人数的正值商来理解。复用具体数值应核对计算定义。
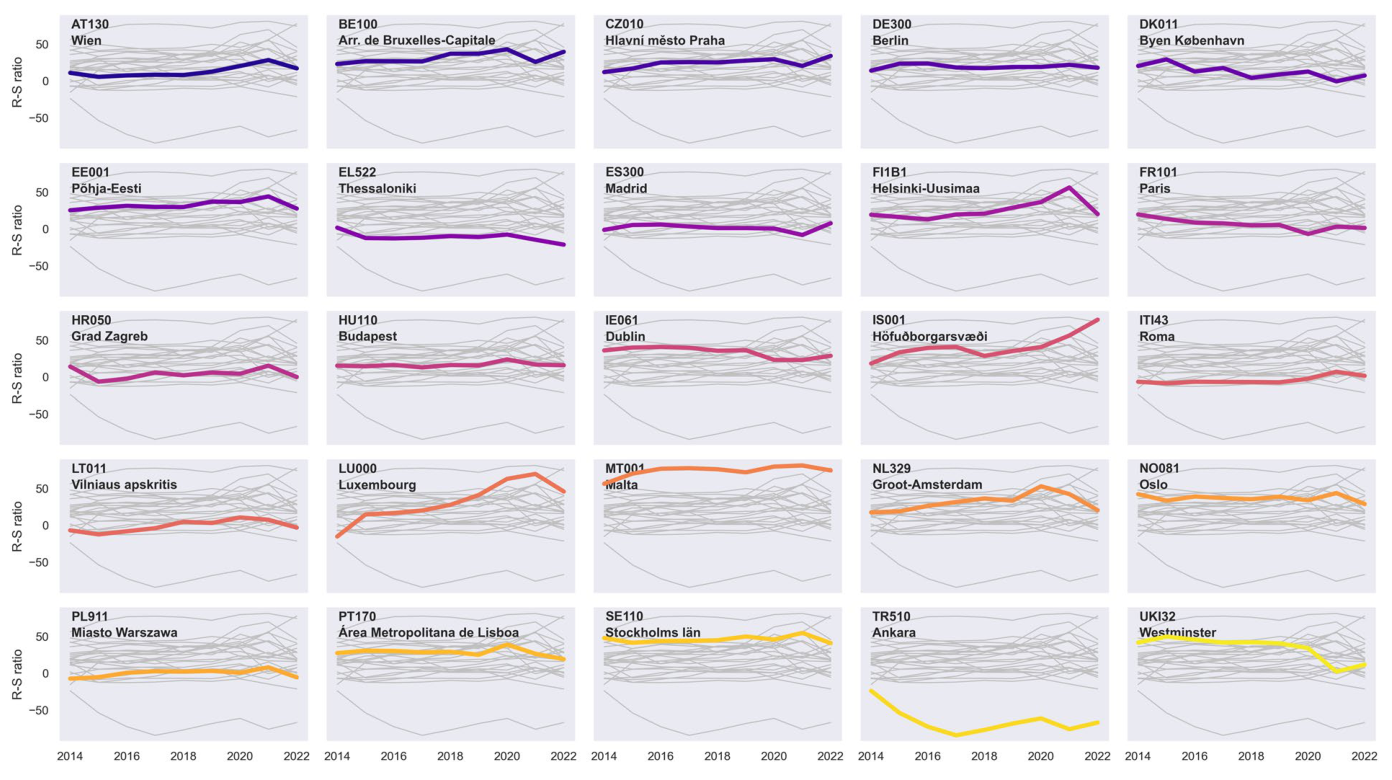
图 3|交换联系的平衡是否稳定?
原图没有字母子图,每个小面板按代码和名称标出一个 NUTS 3 区域;横轴为 2014—2022 年,纵轴为接收—派出平衡指标,彩线突出对应区域,灰线提供其他地区参照。维也纳、柏林、马德里等例子相对稳定,马耳他、赫尔辛基—新地区等波动更明显;部分地区在 2020 年出现变化。相同指标变化不能单独识别疫情、院校协议或学生选择各自的效果。来源:原论文 Fig. 3。
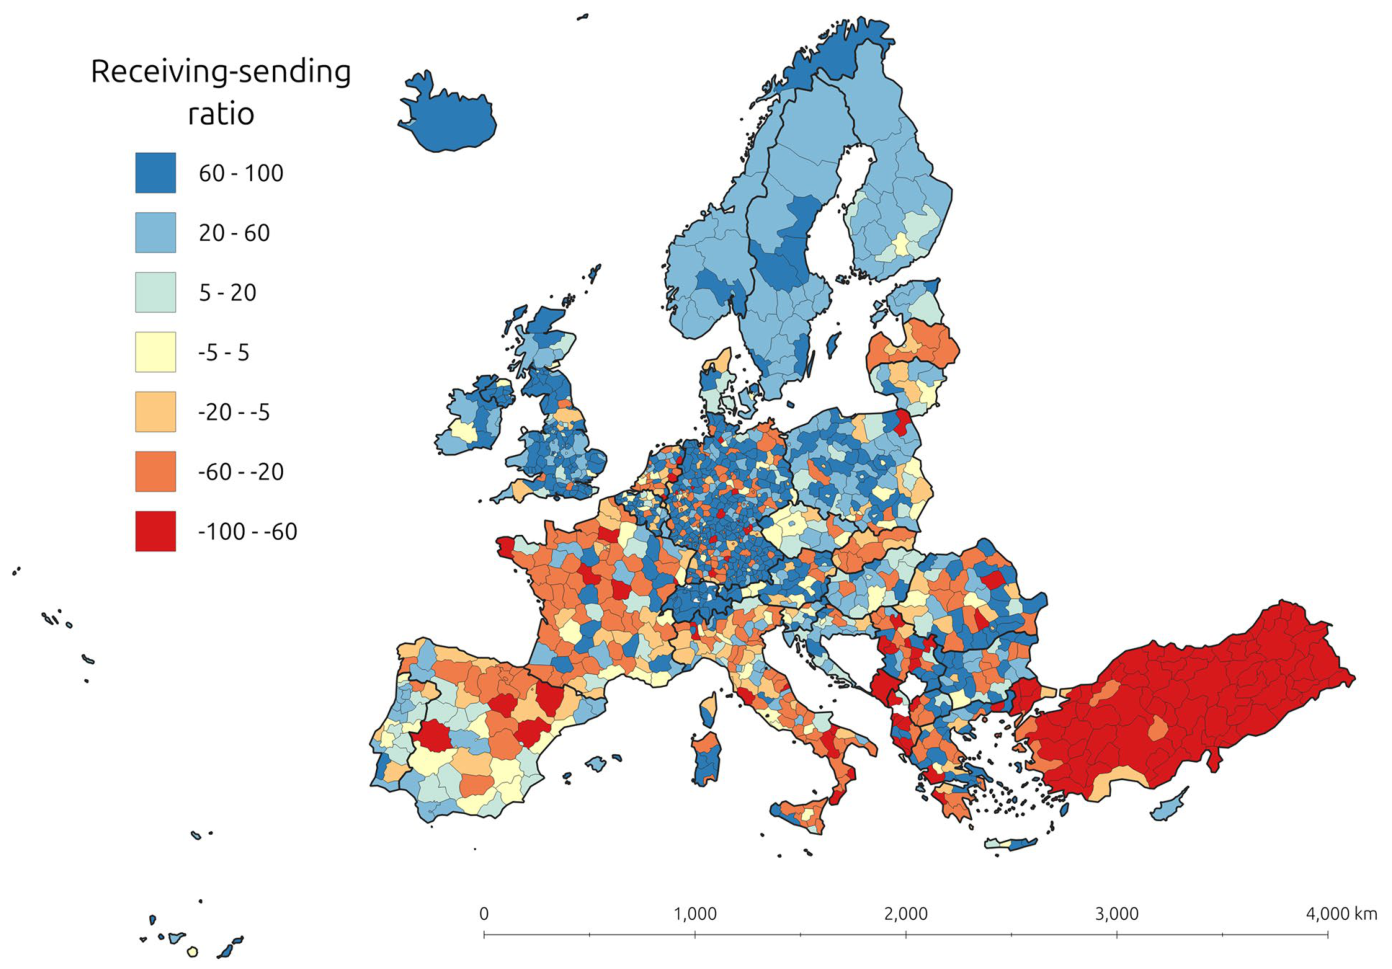
图 4|接收占优与派出占优,分布在哪些地区?
本图没有字母子图。蓝色为接收占优、橙红为派出占优、浅黄色接近平衡,展示各年数据汇总后的区域格局。相邻地区也可能方向相反;图中净交换平衡不记录学生毕业后是否留居,因此不能直接作为永久人才流失或收益的数量。来源:原论文 Fig. 4。
论文用 brain gain、brain drain 讨论应用潜力,但短期交换与毕业后的工作、长期迁移不同。接收较多可能与大学规模、课程语言和合作协议有关,不能仅凭这套流动数据断言地区因此获得多少创新或经济收益。
接收很多学生,来源就一定多样吗?
Berger–Parker 优势度(dominance)取来源人数最多国家的份额;值高,表示一个来源国占得多。标准化 Shannon 熵(normalized Shannon entropy)综合所有来源份额,越接近均匀分布,数值越高。两者一个强调最大来源,一个强调整体分散程度,不是同一指标的简单反面。
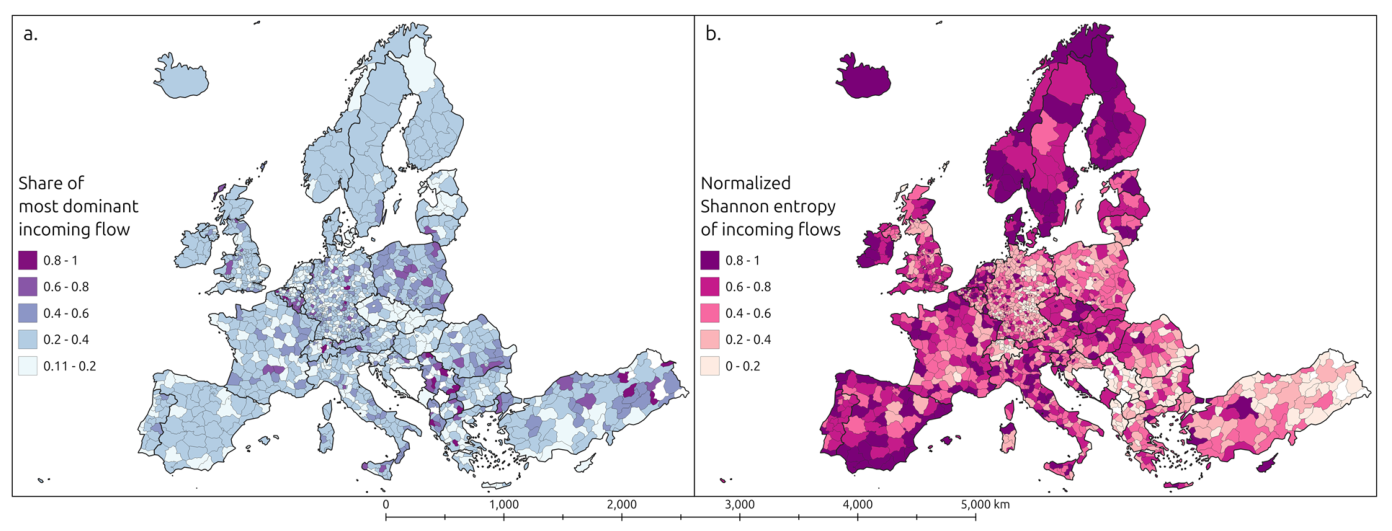
图 5|地区接收的学生,是主要来自一国,还是来自多国?
(a)最大来源国的份额,颜色越深优势度越高,说明来源更集中。
(b)标准化 Shannon 熵,颜色越深多样性越高。地图提示部分地区的接收网络更依赖单一来源;来源国家多样,不等于到访学生之间已经发生学术交流,也不等于欧洲身份认同增强。来源:原论文 Fig. 5。
区域经济特征,是原因还是伴随关系?
论文示范把流动与地区统计相连,在 NUTS 2 层级区分 3—11 个月和超过 11 个月的交换。图 6 展示数字化、经济劳动力市场、生活条件、空间距离等特征的重要性与关联方向。
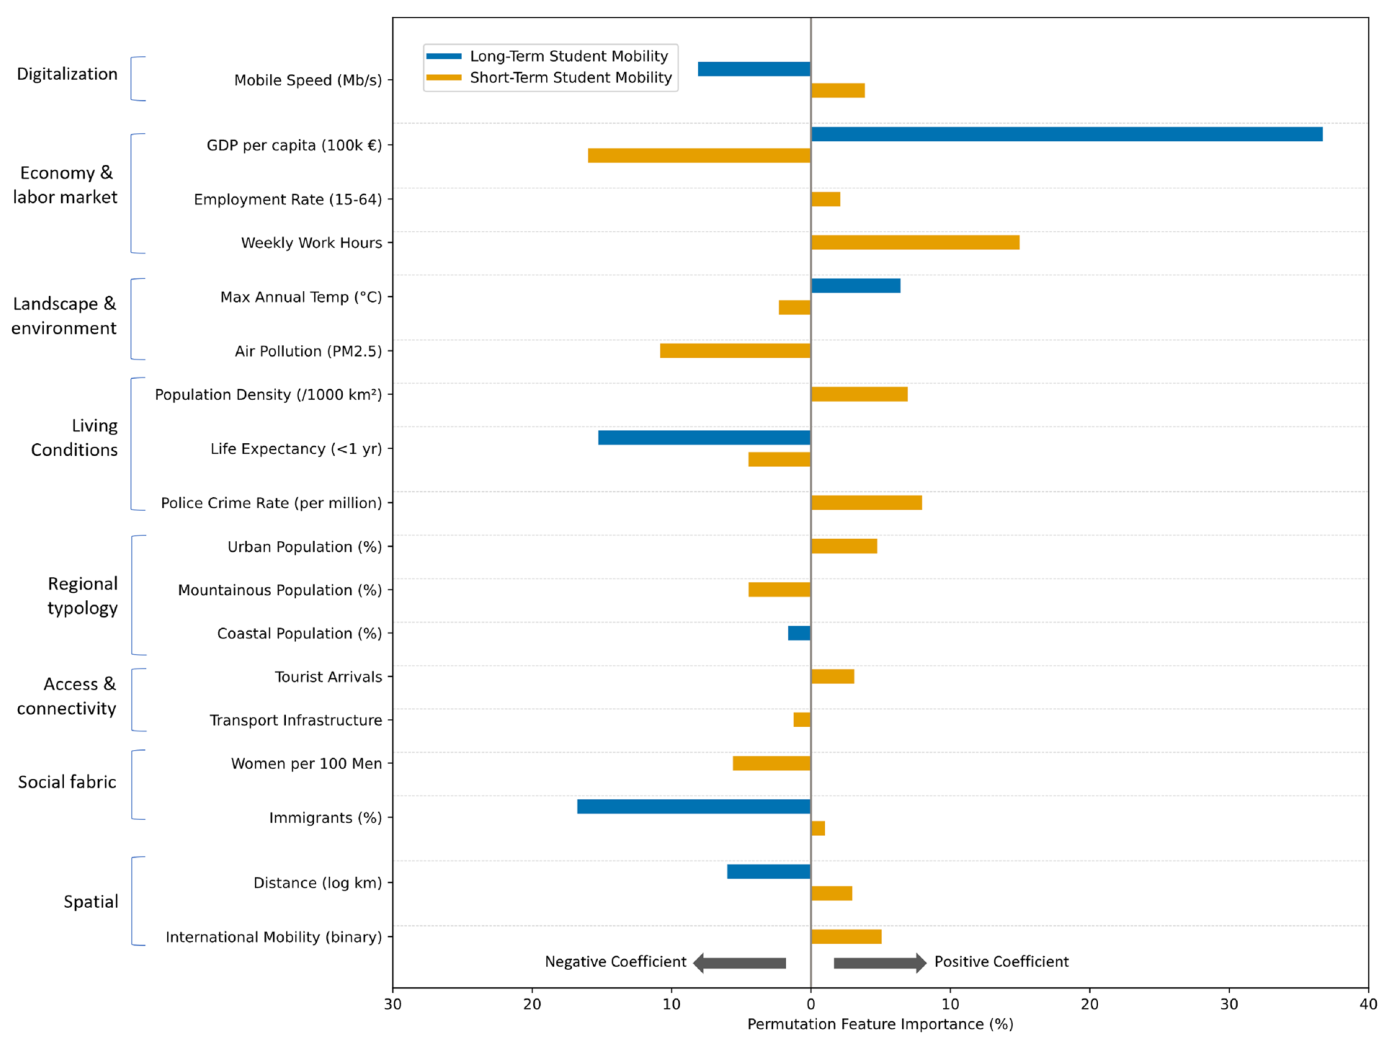
图 6|不同持续时间的流动,是否与相同地区特征关联?
本图没有字母子图。蓝条表示较长期、黄条表示较短期;纵向列出区域特征,横向为置换特征重要性,左右方向结合系数符号标示正负关联。人均 GDP 对长期流动的重要性较高,部分因素在两类流动中的方向不同。条长是示例模型中的预测贡献,不能读成提高某项指标会造成多少学生流入,也不能由此量化学生给地区经济带来的收益。来源:原论文 Fig. 6。
这是一项数据复用示例,正文没有为所有关联给出完整因果识别设计。若要判断交换生对零售、住房或就业的影响,需要另设比较与反事实,而不是把地区特征关联的方向倒过来解释。
几十万条联系,怎样才不会画成一团线?
起点和终点之间直接连线,流动一多就难以阅读。边捆绑(edge bundling)把相近方向和相邻线路在视觉上汇集,便于辨识主要联系走廊。
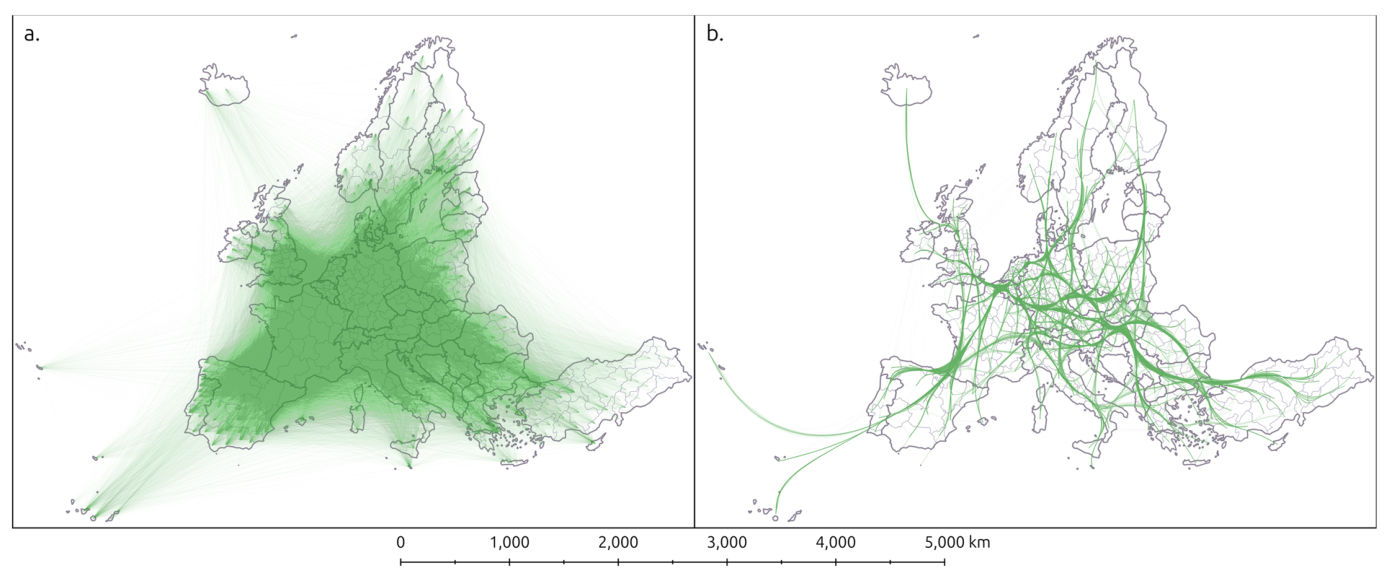
图 7|地图上的线更清楚,意味着数据本身也更细吗?
(a)以 NUTS 3 起讫点直线连接,重叠较多;(b)在 NUTS 2 层级进行边路径捆绑,主要联系更容易辨识。两图还改变了空间汇总层级,因此差异不能完全归功于捆绑算法。弯曲线是流动关系的可视化,不是学生乘飞机、火车或汽车走过的真实路线。来源:原论文 Fig. 7。
拿到文件后,怎样避免把几种分母混在一起?
个体层级表保留原始描述变量,并增加来源、目的地的 LAU 与 NUTS 3 编码,表 4 列出这些字段;CSV 与压缩 Parquet 是同一数据的不同格式,不应重复累加。
表 5 的地区汇总表包含 OD 标识、起点、终点、地区名、年份和参与人数 COUNT。流动行数是个体表记录数,汇总表 COUNT 则是人数计数,统计时应先明确要分析记录还是参与人次。
按 NUTS 层级聚合时可截去末尾字符,把 NUTS 3 归入 NUTS 2、NUTS 1 或国家层级,再按起终点与年份汇总。但同一个代码层级不代表所有年份边界固定;跨年趋势需要统一空间支持。2018 年部分挪威与斯洛文尼亚 LAU 名称缺失,论文称编码和几何仍正确,因此用名称作连接键比用稳定地理标识更脆弱。
一句话总结
这份数据把交换生记录变成了可复用的区域联系,但它记录的是特定项目、年龄和时长下的交换,不能直接替代永久人才迁移或经济效果的证据。
核心来源
- Väisänen, T., Malekzadeh, M., Inkeröinen, O. & Järv, O.(2025)原论文及完整图表,Scientific Data 12, 489。本文图 1—7 均源自原论文。
- 空间化数据与复现材料。
- 地理编码与整理代码。
作者介绍
作者身份和分工依据论文署名及表 7。
- Tuomas Väisänen:署名赫尔辛基大学 Digital Geography Lab,并关联该校可持续性科学、城市与区域研究及不平等研究机构;为通讯作者,承担数据整理、分析、初稿和修改。
- Milad Malekzadeh:署名 Digital Geography Lab,参与分析与稿件修改。
- Oula Inkeröinen:署名 Digital Geography Lab,参与数据整理。
- Olle Järv:署名 Digital Geography Lab,并关联该校可持续性科学和城市与区域研究机构,参与分析与稿件修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个地区来源多样性较低,可能是吸引力不足,也可能是院校只签了少数国家的合作协议。如果不知道可选择的交换机会,把实际流量当成学生的纯偏好,就会忽略制度先划出的选择集合。
可以把院校协议网络作为机会基线,再看学生实际选择相对可选目的地偏向哪里。若某地协议很多、实际流量仍集中,才更值得研究语言、费用或生活条件;若协议本身已经集中,政策工具可能应先作用于合作网络,而不是直接要求学生改变选择。