百度迁徙指数,能换算成每天有多少人次往来吗?
论文名片|Zhibang Xu、Hua Zheng、Gang Xu、Jinfeng Ma,Daily intercity human mobility estimates across Chinese cities from 2020 to 2025,Scientific Data,2026,Article in Press 版本。原论文 · 数据描述论文。
假设两座城市之间的迁徙指数翻了一倍。你可以判断平台记录的相对联系增强,却不能直接说多了多少人次。把这种没有物理单位的指数用于碳排放、灾害传播或交通需求分析,往往还缺一把能把指数换算为人数尺度的尺子。
这篇论文用交通运输部门发布的全国出行总量作锚点,学习每天的换算尺度,再施加到百度公开的城市间联系上。得到的 DIMNet-CPC 是模型估计人次,而非逐条观测的真实出行;它只覆盖平台披露的部分联系,也不是把全国总量完整拆到所有城市对。
先说结论
- 数据覆盖 366 个行政单元在 2020—2025 年可获得日期的有向城际联系;没有披露的城市对是未观测,不能补成零。
- 全国校准依靠 2024—2025 年 110 天直接发布总量,以及九个月总量推导的较低可信度逐日训练约束;2020—2023 年属于回溯应用。
- 在 22 天全国留出记录上,最终模型的加权绝对百分比误差为 4.74%;到了独立 OD 城市对比较,误差指标升至 26.52%,全国表现不能当作每条边的精度。
- 2020 年缺 145 天、2021 年缺 4 天,研究保留缺失。直接比较完整年度总量,尤其容易把缺数据误当成出行下降。
这把尺子,先在全国总量上校准
原始百度迁徙指数(Baidu Migration Index,BMI)提供的是相对强度:每个行政单元的流入、流出指数,以及前 100 个来源或目的地的比例。平台未完整公开定位停留时长、距离阈值、轨迹筛选和用户覆盖规则,因此不能把指数直接当成实际跨城出行人次。
研究先用全国互联网普及率与移动互联网用户占比作归一化,减轻平台覆盖随年份变化造成的干扰。但全国普及率不能自动修正年龄、地区和平台用户组成差异。
接着,110 天交通运输部直接发布的全国跨区域人次记录作为较高可信度锚点,按 80/20 分成 88 天训练与 22 天留出。九个月的总量再按当月调整后 BMI 的日占比拆成伪逐日约束。这里的日变化继承自百度,而非新增加的独立每日观测,因而只进入训练,不进入验证。
模型还使用距除夕天数、法定节假日、普通周末、调休工作日和过渡高峰等日历特征。它在 ln(人次+1) 尺度上学习,再转换回人次;对数转换压缩极端高峰的影响,并不改变这些值仍是模型估计的性质。
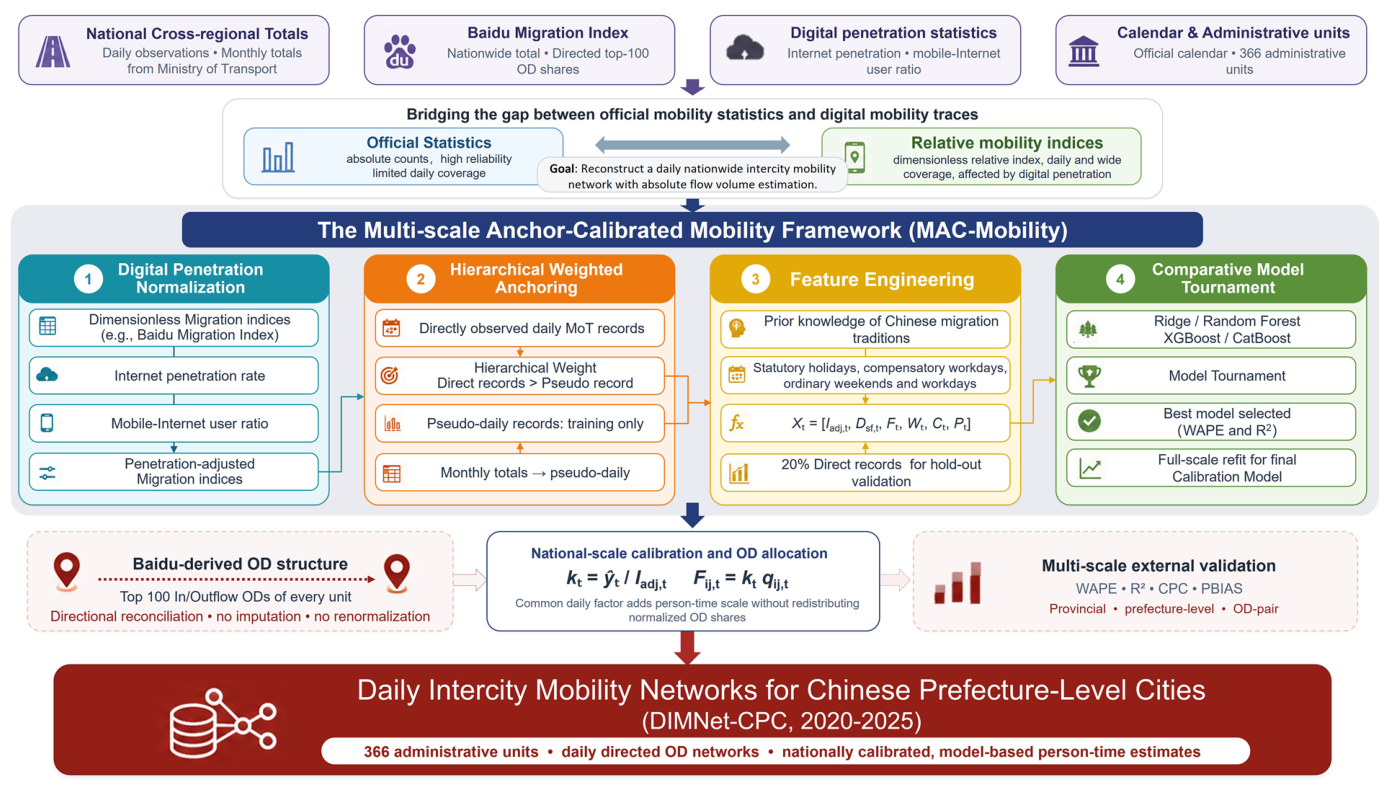
图 1|全国统计、平台指数和城市对结构怎样接起来?
本图没有字母子图。顶部汇集全国统计、百度指数、数字普及率与日历数据;中部四个模块分别为普及率归一化、分层加权锚定、特征构造和候选模型比较;下部把估计全国尺度应用到百度已披露的 OD 结构,再在多个尺度检验。最后输出 366 个行政单元的逐日有向网络。来源:原论文 Fig. 1。
表 1 进一步区分各来源的职责:全国日记录负责校准与留出检验,月记录只提供训练约束,地方统计和报道提供外部验证,行政代码与边界保证地点识别。把所有来源都叫训练数据或真实流量,会抹掉证据之间的层次。
给全国找对尺度,就能推断每座城之间的流量吗?
模型先得到全国某天的估计总量,再除以调整后的全国 BMI,形成当天共同换算系数。对于城市 i 到城市 j,出发端可用流出指数乘目的地份额给出相对量;到达端也可用流入指数乘来源份额给出相对量。
如果两端都有数据但不一致,取较小者,作为保守协调;只有一端披露,则保留那一端。最后乘以当天换算系数,得到该方向的人次估计。
这种做法学习的是全国尺度随时间怎样转换,不是独立学习每个城市对的空间份额。百度两端前 100 名列表里都没有的联系,不会被模型重建。保留下来的联系也不重新归一化,长尾没有补齐,因此所有发布 OD 的人次和不被强制等于全国校准总量。
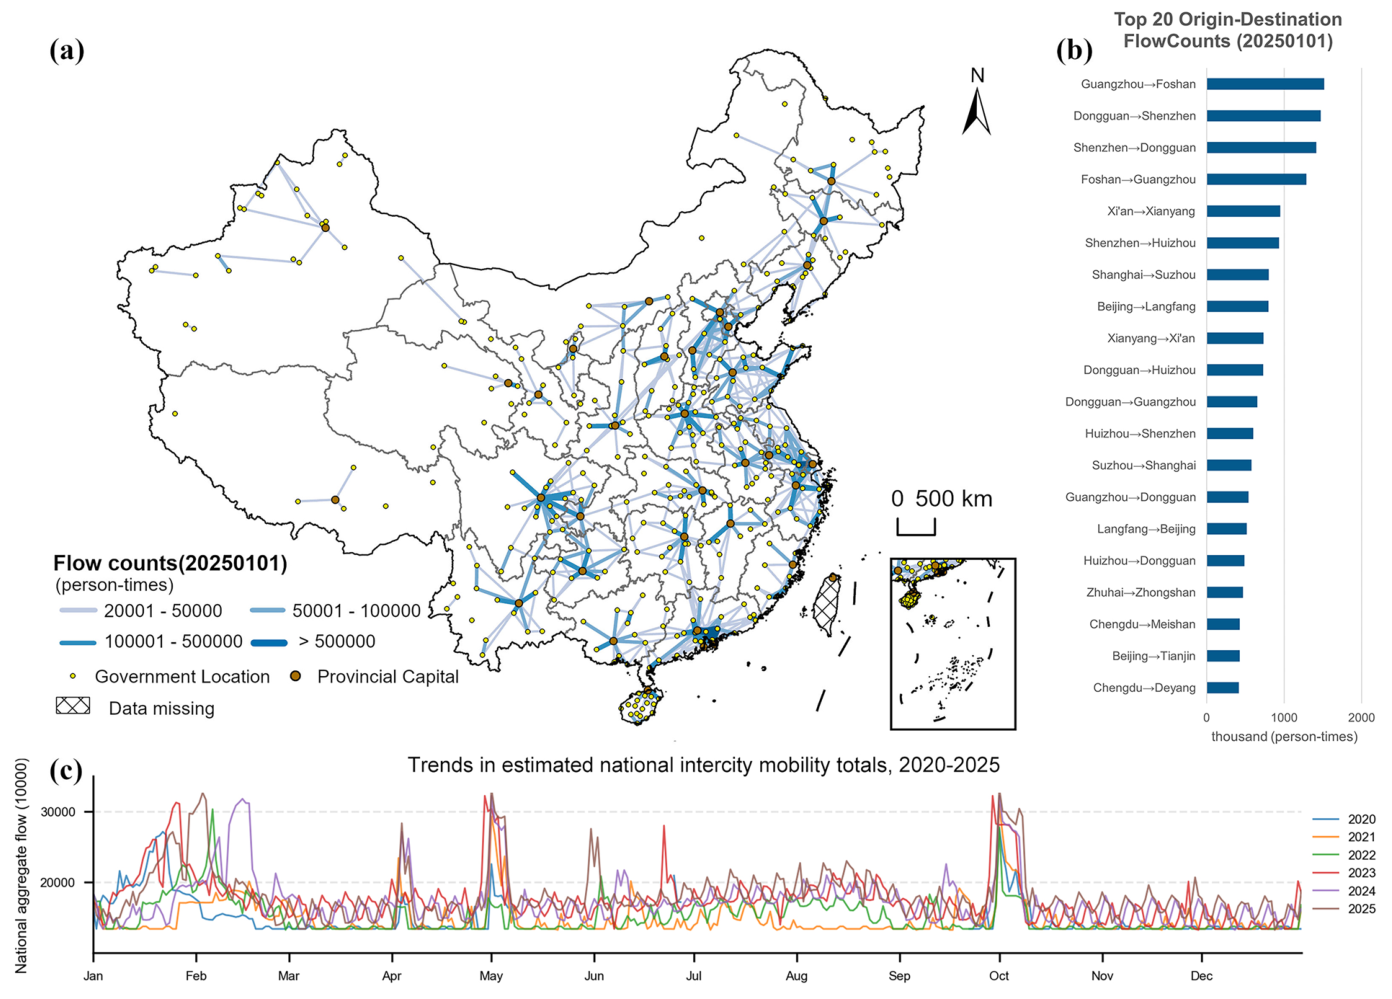
图 2|这份数据实际呈现什么网络和时间变化?
(a)2025 年 1 月 1 日的主要城际联系,只显示估计超过 2 万人次的已发布边,节点标出市级政府位置与省会;图中没有线不能直接理解成零往来。
(b)同一天估计值最高的 20 个有向城市对,横轴单位为千人次,起终点方向影响其含义。
(c)2020—2025 年的全国汇总估计日变化,纵轴单位为万人次,不同颜色对应年份。节日附近的峰值和跨年差异可作为描述,但缺失日期、平台覆盖与回溯校准都限制直接比较。来源:原论文 Fig. 2。
全国误差不到5%,为什么城市对误差会更大?
四种候选模型使用相同特征、相同划分与训练权重。全国 22 天留出中,岭回归、随机森林、XGBoost、CatBoost 的 R² 分别为 0.832、0.871、0.824、0.899;加权绝对百分比误差(WAPE)分别为 5.41%、5.39%、5.93%、4.74%,因此最终选用 CatBoost。
WAPE 是各观测绝对误差之和除以真实观测总量,给出总量尺度上的相对误差;4.74%不表示 95.26%的旅客被正确识别,也不保证每一天都误差小于 5%。而且这 22 天同时用于候选模型选择,报告的是留出比较表现,不是另有一套未参与选模的最终测试集。
独立外部比较包含 35 条省级、9 条地级以及 11 条 OD 城市对观测。相应 WAPE 为 14.37%、25.45%、26.52%;OD 比较的总偏差指标 PBIAS 为 21.76%,提示整体倾向高估。空间粒度越细,原平台份额、截断与地方统计口径差异越难由全国换算系数消除。
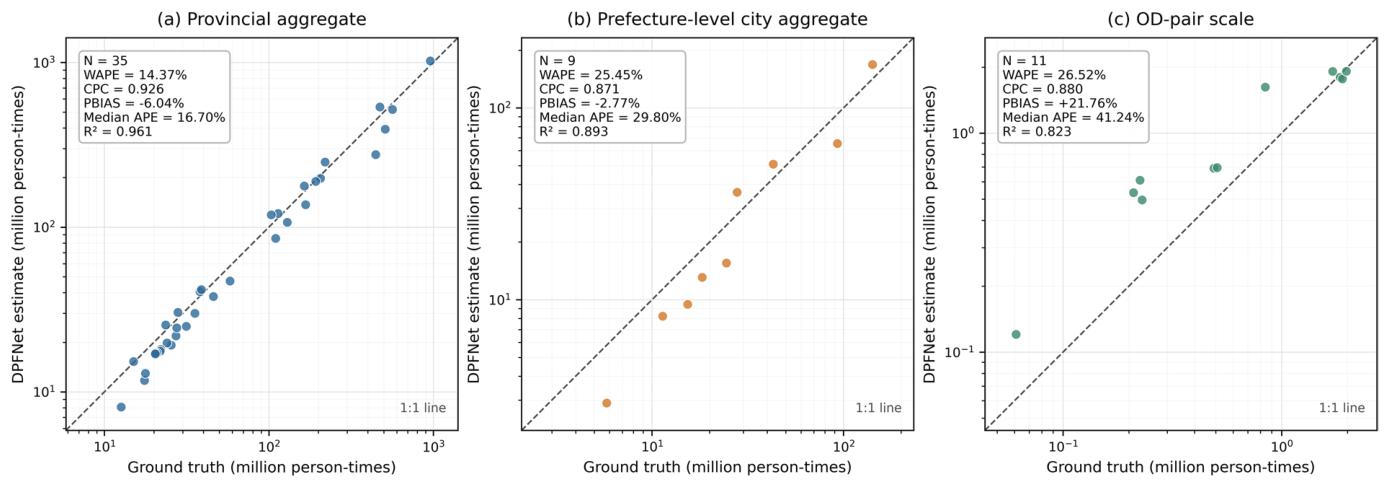
图 3|聚合尺度变细后,估计与外部记录怎样偏离?
(a)省级,N = 35;(b)地级,N = 9;(c)OD 城市对,N = 11。横轴均为参照人次、纵轴为估计人次,单位为百万人次且采用对数坐标,虚线为一比一;点落在线上方表示高估。三幅图报告各自的误差指标,而不是对所有城市、所有日期都完成了相同验证。来源:原论文 Fig. 3。
这些样本在地理和时期上集中,无法证明每座小城市、每条弱联系或每个普通工作日同样可靠。少量 OD 参照还是年度日均值,与对每天细节逐一核验不是同一件事。
节假日特征帮了什么忙,又没有证明什么?
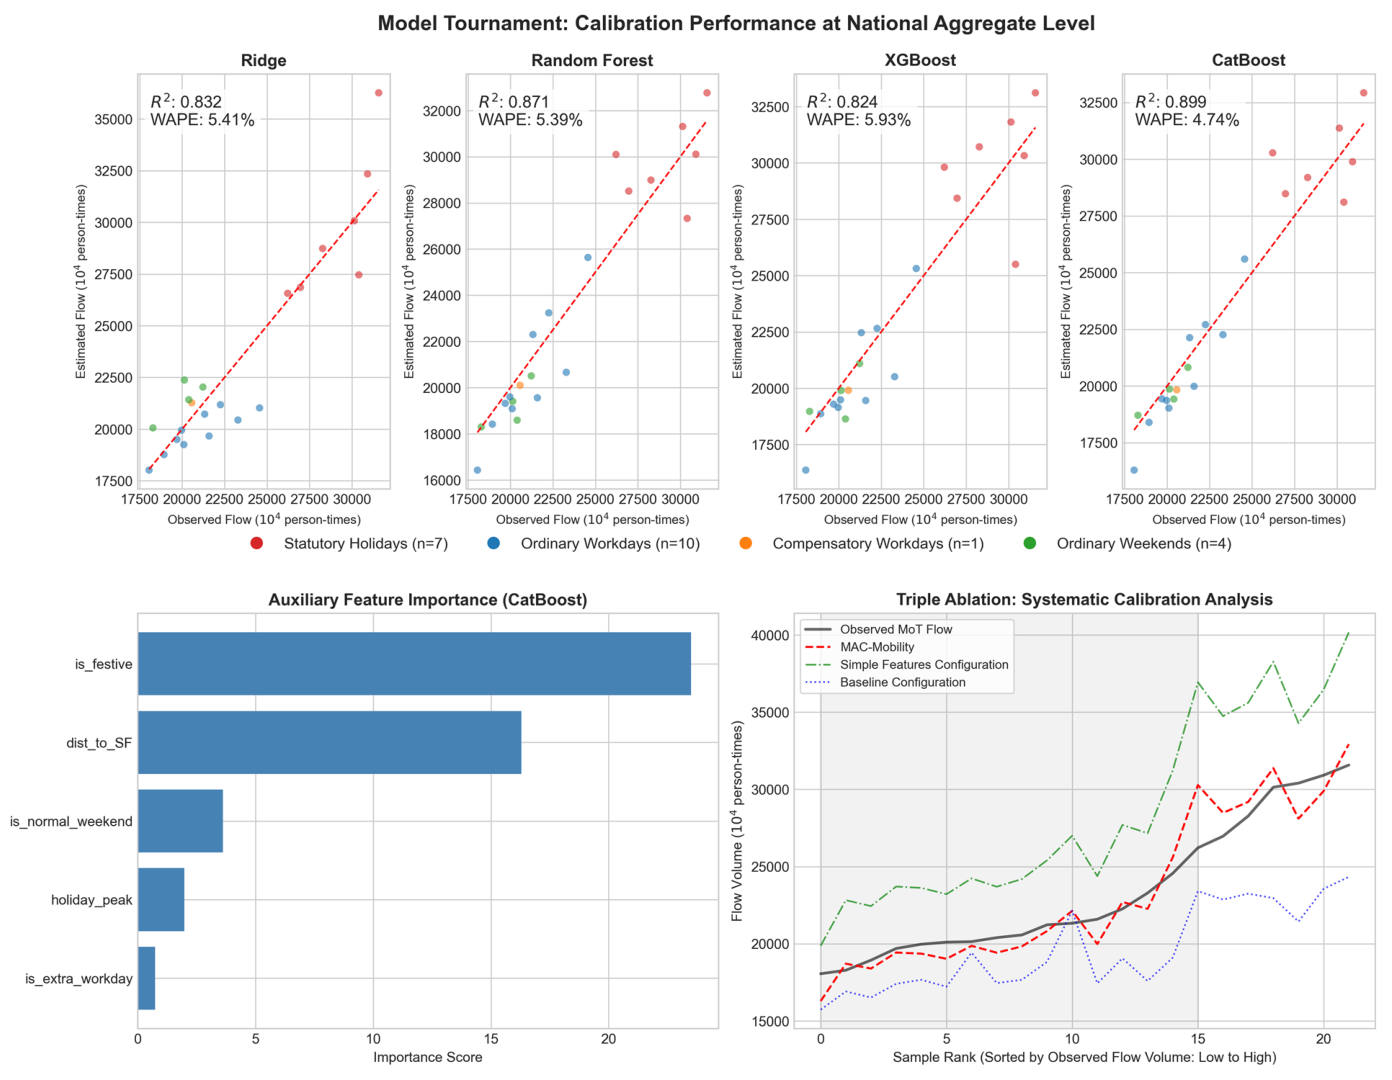
图 4|不同模型和框架部件,怎样改变全国尺度估计?
本图没有字母子图。上排从左至右为岭回归、随机森林、XGBoost、CatBoost,横轴为观测全国人次、纵轴为估计值,单位均为万人次;点色区分法定节假日、普通工作日、调休工作日和普通周末,虚线为一比一。
左下排除主要迁徙指数后,比较辅助特征的重要性,法定节假日和距春节天数较突出;重要性是模型依赖程度,不是节假日的因果效应。
右下按观测流量由低到高排列样本,比较仅调整 BMI 的基线、加入简单日历特征与完整 MAC-Mobility 的消融结果。横轴是排序后的样本,不是连续日期;曲线更贴近观测表示这组诊断中的行为改善。来源:原论文 Fig. 4。
88 天直接训练样本包括 34 个法定假日、39 个普通工作日、4 个调休日和 11 个普通周末;22 天留出对应 7、10、1、4 天。普通工作日又主要分布于重大出行时段前后,因此不能用这组消融宣布全年普通工作日都经过独立验证。
附录改变日记录与伪日记录的单条样本权重比,并选择 3:1,以保留直接日观测更高的单条影响。分别用 2024、2025 年校准再回推 2020 年时,匹配 OD—日期结果的相对差中位数约为 2.75%。这是模型对校准年选择的敏感性检查,不是拿到 2020 年真实 OD 后验证了准确性。附录
哪些比较最容易把缺失当成真实变化?
2020 年 5—9 月缺 145 天 BMI,2021 年另缺 4 天,研究没有插值。若把缺行补零再求年总量,会人为制造出行坍塌;若把剩余日期直接当全年代表,也可能被季节与疫情阶段差异扭曲。跨年比较应限制在共同可观察日期,并说明因此舍弃了哪些时段。
2020—2023 年使用的是 2024—2025 年建立的换算关系。普及率调整能够处理一部分覆盖变化,无法保证疫情期间平台使用、识别机制和交通统计口径与后来完全可比。校准年敏感性较小也不能证明这个跨期假设成立。
OD 未披露的长尾同样影响网络指标。边少可能来自真实联系弱,也可能来自跌出前 100 名;一条边从列表消失,不能立刻认作真实通道关闭。弱联系多的外围城市尤其需要核对这种观察机制。
真正复用时,应把它当成什么?
每天的 Excel 文件便于单日查询,合并 Parquet 采用 Date、Origin、Destination、Flow 长表;两种格式是同一产品的不同组织方式,不应重复累加。地点保留中文名,并提供 Unit_Lookup.xlsx 关联行政代码和英文名,避免安徽宿州与江苏苏州的拼音同名歧义。
空间单元统一到 2025 年行政标准。和其他资料连接应优先使用行政代码并检查边界口径,而非假设名称相同就代表同一范围。Flow 的单位是人次,不是独立人数,一个人多次出行可能产生多个人次。
这套数据适合在承认截断、缺失与模型不确定性的前提下研究区域连接和网络变化。用它估计排放、传播或客流时,还需补充出行方式、距离或相应机制,不能把人次乘一个未经核对的统一系数就当成已经观测到的环境或健康结果。
一句话总结
全国统计可以为百度迁徙指数补上一把人次尺度的尺子,但这把尺子不会自动补全未见联系,也不会把每条城市对估计变成真实客流观测。
核心来源
- Xu, Z., Zheng, H., Xu, G. & Ma, J.(2026)原论文,Scientific Data,Article in Press。本文图 1—4 均源自原论文。
- DIMNet-CPC 数据归档。
- MAC-Mobility 代码。
作者介绍
以下仅列论文署名身份。
- Zhibang Xu:署名中国科学院城市环境研究所区域与城市生态国家重点实验室。
- Hua Zheng:署名同一研究机构,为论文通讯作者。
- Gang Xu:署名武汉大学资源与环境科学学院。
- Jinfeng Ma:署名中国科学院生态环境研究中心。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
网络研究常把边是否存在看得很重要,但这里的存在首先受平台前 100 名披露规则影响。某座城市新增一条强联系,可能把另一条变化很小的弱联系挤出列表,于是观察网络少了一条边,真实交通却并未中断。
一个可行的敏感性分析,是先在强联系构成的稳定核心上检查结论,再逐步纳入靠近披露边缘的联系,比较中心性、社区划分和韧性排序是否改变。如果结果对边界联系很敏感,就应把观察机制作为解释的一部分,而不是把所有结构变化都归给现实城市系统。