同样是早高峰,地铁站是在把人送去上班,还是把人接回居住区?
论文名片|Peiyan Sun、Jinming Yang、Zongyuan Huang 等,Human Mobility Datasets in the Complex Metro System of Shanghai,Scientific Data,2025,12:1061,2025 年 6 月 23 日发表。论文原文 · 数据 · 代码。
想象你只看到一个地铁站今天有很多人。这个数字还不足以决定早上是否需要加车:人是在进入地铁,还是走出地铁?他们是固定往返家与工作地的乘客,还是前往商场、景点或铁路枢纽的乘客?同一个总量背后,可能是完全不同的城市活动。
MetroFlow 把上海 2017 年四个月的刷卡记录整理为 10 分钟粒度的进出站量和站间 OD 流量,并附加基于行为规则推断的出行类型。它的价值不只在于规模,更在于同时保留站点位置、网络结构和活动类型。但进站时刻经过估计,出行目的经过分类,缺失日也仍然存在,不能把全部字段都当作直接观测真值。
先说结论
- 数据对应 2017 年 5 月 1 日至 8 月 31 日,共 123 天、302 个站点,整理自约 7.368 亿次地铁行程和 1,969 万用户标识。
- 每日保留 6–23 时的 102 个十分钟时段,OD 按进站时刻归档;原始进站时间缺失,研究用路线 API 的预计耗时反推,并非每次进站都被准确计时。
- 三类标签分别表示家–工作站往返、与家站相关的其他出行、非家相关出行;它们来自站点规律推断,不能直接等同于真实问卷目的。
- 六个日期存在严重缺失,应单独标记。天气与参考数据比较支持总体模式合理,却不验证每个十分钟格子或每个通勤标签都准确。
先把原始刷卡记录,变成可比较的行程
原数据来自自动售检票系统(Automatic Fare Collection,AFC)。研究先选出地铁记录,排除缺少完整进出站事件的行程、估计耗时少于三分钟或超过五小时的异常记录,并剔除 6 时之前和 23 时之后的记录。
数据最值得注意的处理,是进站时间。作者拥有进站、出站站点和出站时刻,却缺少可直接使用的进站时刻,于是通过高德地铁路线规划 API 获取预计耗时,再从出站时刻倒推。排队、候车、换乘、绕行和途中停留都可能使实际耗时偏离估计。10 分钟是发布分辨率,不能因此认定事件时间误差小于 10 分钟。
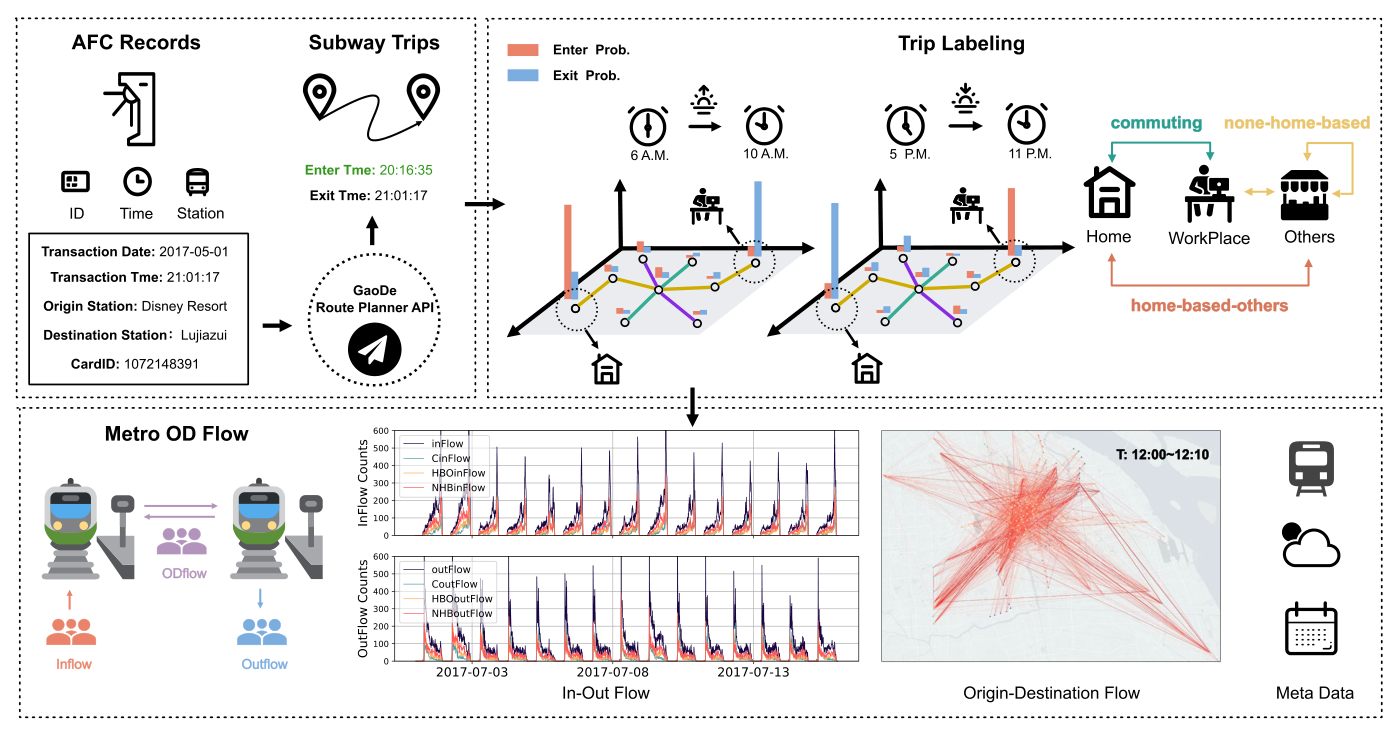
图 1|从一次交易到一格客流,中间推断了什么?
这张图没有字母子图。左上由 AFC 记录和路线规划耗时补出行程时间;右上用个人站点规律确定家站、工作站并分类;下方聚合成站点进出量、OD 和元数据。箭头同时包含观测、估时和标签推断三个环节,不能把推断标签误写成原始刷卡自带的活动目的。来源:原论文 Fig. 1。
原始用户标识在分析前匿名化,公开内容则是聚合流量,不含可直接识别个人的信息。1,969 万是资料中的用户标识规模,不应直接理解成经过身份核实、互不重复的常住居民人数,也不等于上海全部交通方式的出行者。
怎样从站点规律判断家和工作地?
模型为每个用户建立家站候选池和工作站候选池。早间常作为进站点、晚间常作为出站点的站更可能是家站;反向规律更可能对应工作站。候选池里出现最多的站占比超过 40% 时,才将它识别为对应锚点。论文报告,能为超过 67% 的用户识别家与工作站。
在这些锚点基础上,通勤(commuting,C)指家站与工作站之间的行程;基于家的其他出行(home-based-others,HBO)指一端为家站、但不是通勤的行程;非基于家的出行(non-home-based,NHB)指两端都不为家站的行程。地铁站只是活动地点的近邻代理,不是精确住宅或办公楼。
另一个分类边界可以从公开代码看到:NHB 最终按总量减 C、再减 HBO 得到。因此,对家站未能可靠识别的记录,应留意是否也进入剩余类别,不能只凭 NHB 字段就断言所有人都经过了同样可靠的活动目的识别。夜班、轮班、多工作地点和只偶尔乘地铁的人,也未必符合早出晚归假设。
全城的一天,有哪些模式可以从数据中看出来?
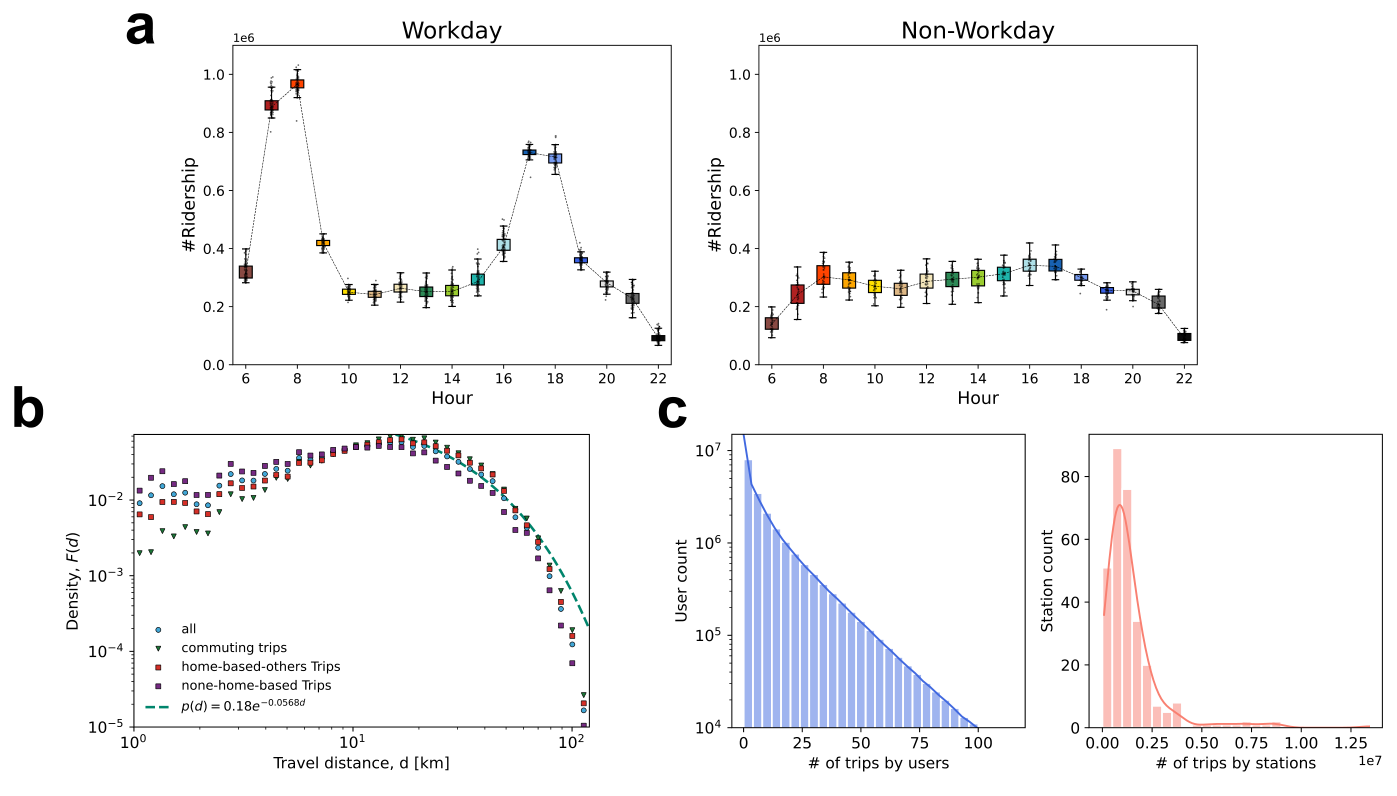
图 2|总体高峰背后,出行距离和使用频率是否一样?
(a)工作日与非工作日的小时进站量,工作日出现清晰早晚高峰,非工作日变化更平缓。纵轴是全系统进站量,不是每位乘客的出行次数。
(b)不同标签行程的距离分布,横轴为距离、纵轴为概率密度,绿色虚线拟合超过约十公里的尾部。通勤分布的长距离尾部更重;这不表示所有通勤都比所有其他出行更长,也不直接证明一种唯一的人类移动机制。
(c)左侧按行程次数呈现用户活跃程度,右侧按累计行程量呈现站点繁忙程度。两者分别以用户与站点为单位,不能把一个分布的频数读到另一个对象上。来源:原论文 Fig. 2。
论文指出,工作日早高峰约为 7–9 时,晚高峰约为 17–19 时;距离分布在约十公里附近达到高点。这里的距离来自路线估计,不是对每位乘客实际路径逐段定位得到的里程。
人民广场与莘庄,为什么有相反的早晚方向?
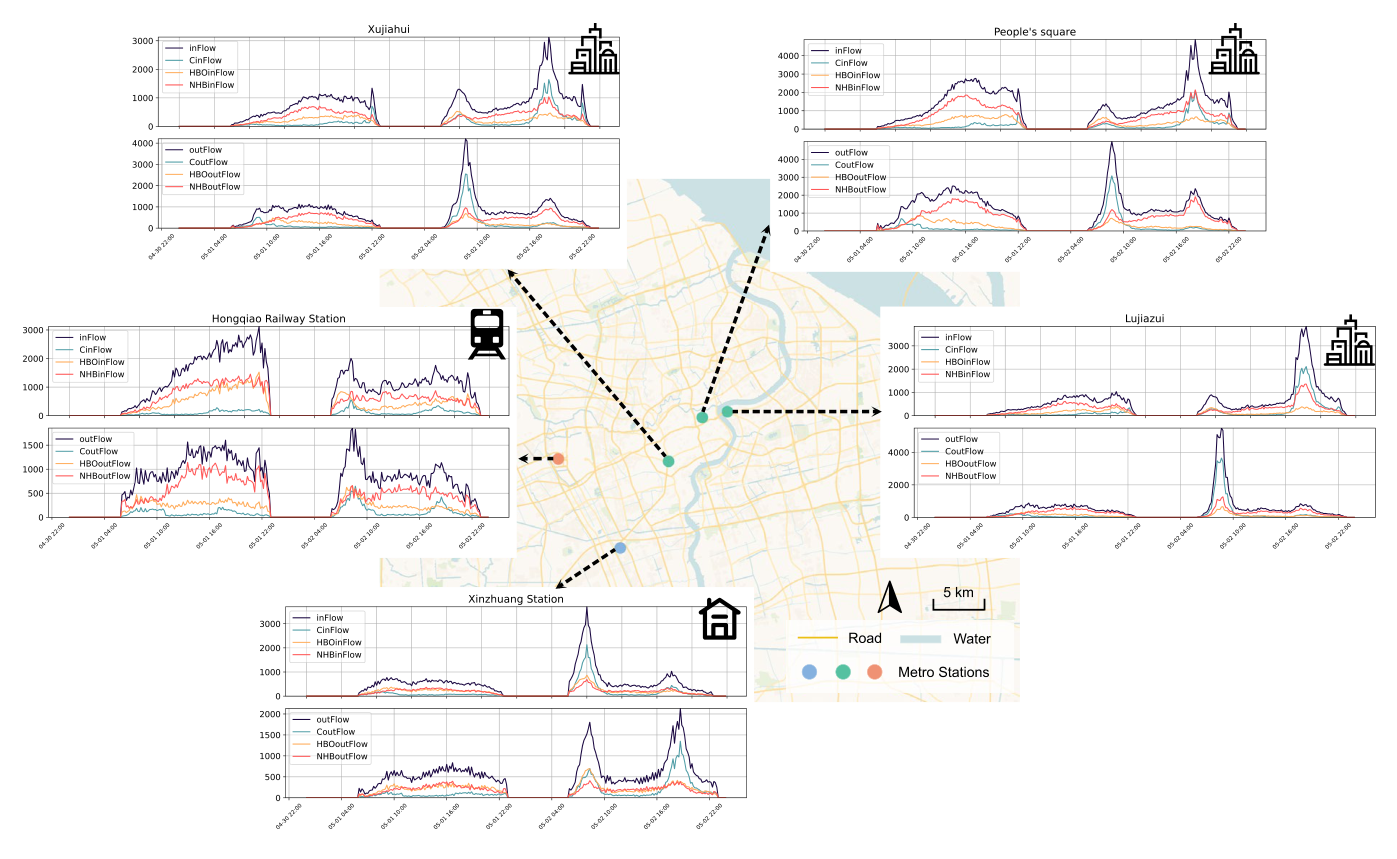
图 3|同样的客流峰值,代表怎样不同的站点功能?
原图没有字母子图,保留地图与全部五组时间曲线。每组分别展示进站与出站,曲线区分总量和三类行程,并并列 5 月 1 日非工作日与 5 月 2 日工作日。
徐家汇、人民广场和陆家嘴:工作日早间通勤出站、晚间通勤进站突出,与工作地一侧的站点模式相容。
莘庄:早间进站、晚间出站更突出,显示居住端与通勤换乘节点的不同方向。
虹桥火车站:NHB 份额较高,非工作日客流也较明显,符合铁路枢纽包含临时和跨城旅客的解释。但标签推断没有直接核实每位乘客的职业、常住地或完整跨城行程。来源:原论文 Fig. 3。
这里的进站,是进入地铁系统;出站,是离开地铁系统。早上从办公区车站走出地铁的人,并不是在离开办公区。方向口径如果读反,同一张曲线就会得出相反的功能解释。
一份连续时间表,为什么仍然有缺失日?
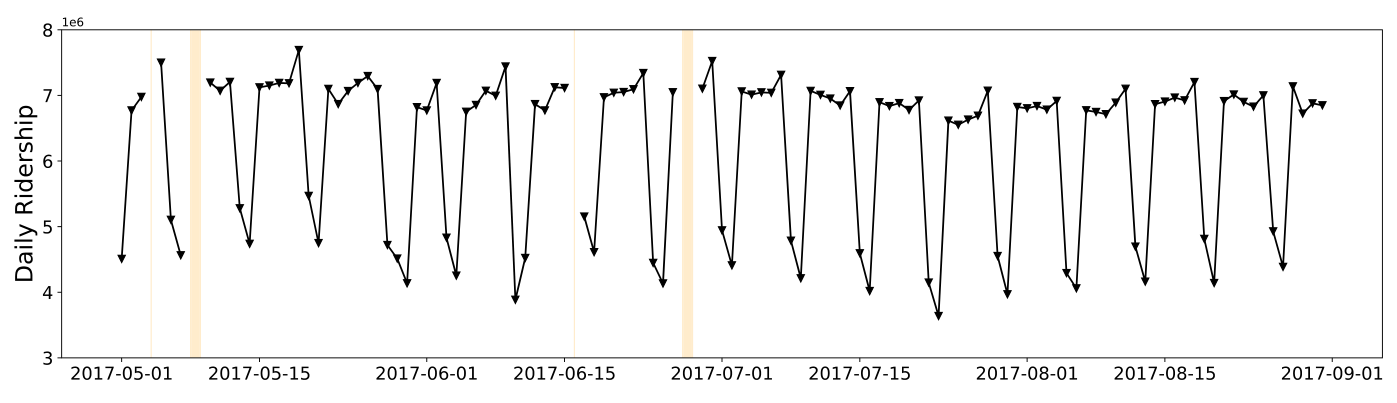
图 4|异常低谷是真实需求下降,还是记录不完整?
图中没有字母子图。横轴为日期,纵轴为每日进站量;橙色标记指出 5 月 4 日、5 月 8 日、5 月 9 日、6 月 16 日、6 月 27 日和 6 月 28 日。作者将这些日期识别为原始数据不足,而不是解释成真实全城需求骤降。来源:原论文 Fig. 4。
作者进一步按站比较日客流与各自 123 天平均值,将这些日期判定为严重不足,后续分析排除了这六天。按日期数计算,六天占 123 天约 4.9%;不应把原文“低于 2%”的表述直接当作缺失日期占比。
因此,“连续 123 天”描述的是时间跨度,不表示每个日期都有完整有效观测。做预测基准时,缺失日不能被当作真实低需求训练目标;如果插补,应让训练、验证和测试都保留缺失标记与处理说明。
下雨和高温的关系,足以证明客流准确吗?
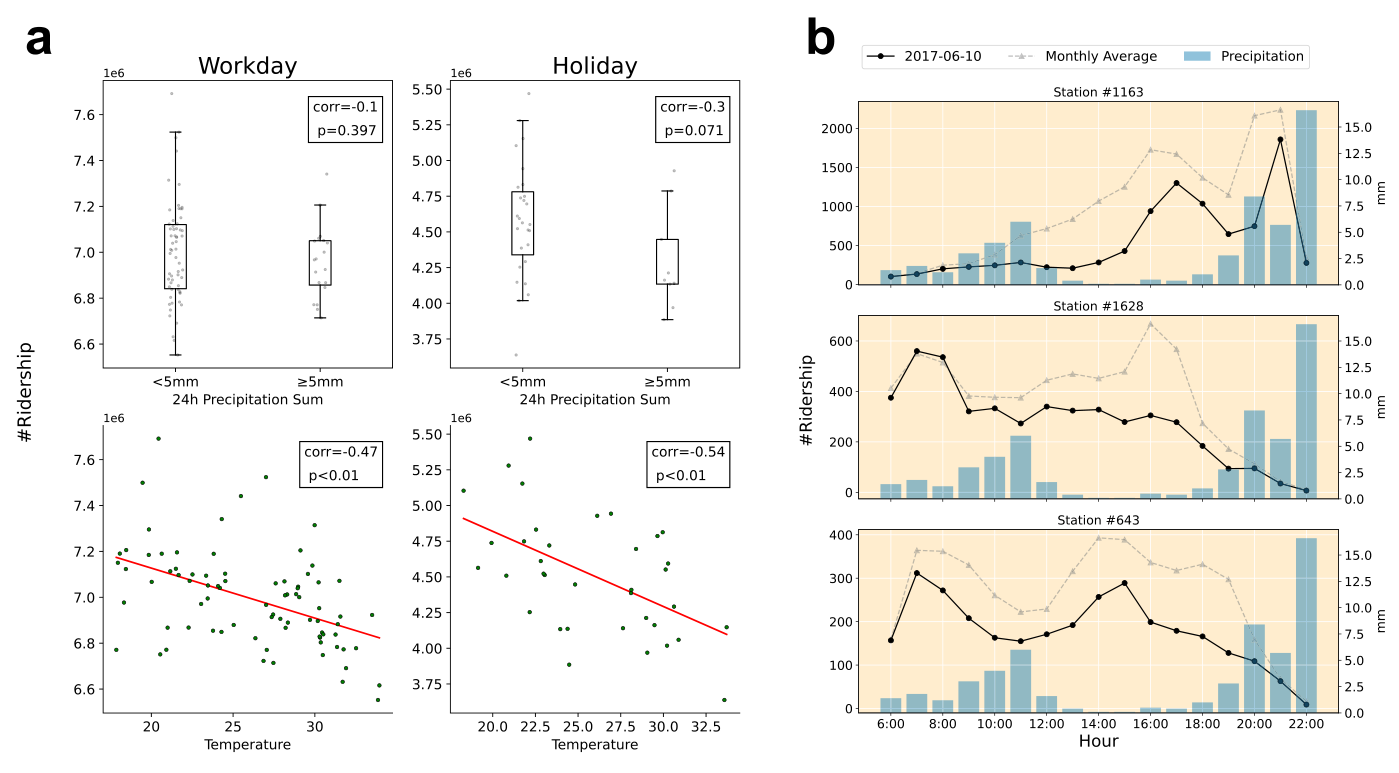
图 5|客流变化是否与可理解的外部条件相容?
(a)左侧四幅小图:上行分别比较工作日、非工作日在日降雨量五毫米阈值两侧的客流;下行比较两类日期中气温与客流。温度相关约为 −0.47 和 −0.54,p<0.01;非工作日降雨比较图中 p 约为 0.071,不能写成已达到通常的 0.05 显著性门槛。
(b)右侧三幅小图:2017 年 6 月 10 日暴雨时,站点 #1136、#1628、#643 的小时客流与该月非工作日平均比较;柱形为降雨,实线和虚线分别为事件日与参照。前两个站对应迪士尼和野生动物园,第三个位于暴雨中心附近。曲线下降与天气冲击相容,但仅这一事件比较不能排除所有其他日期差异。来源:原论文 Fig. 5。
这些检验有助于判断数据是否呈现合理的需求变化,却不是逐条刷卡、逐十分钟时间戳或活动标签的准确性验证。气温又与季节、工作安排等因素共同变化,不能把相关系数直接换算成升高一度就减少多少乘客的因果效应。
和另一份上海客流很像,像的是站点,还是全城节律?
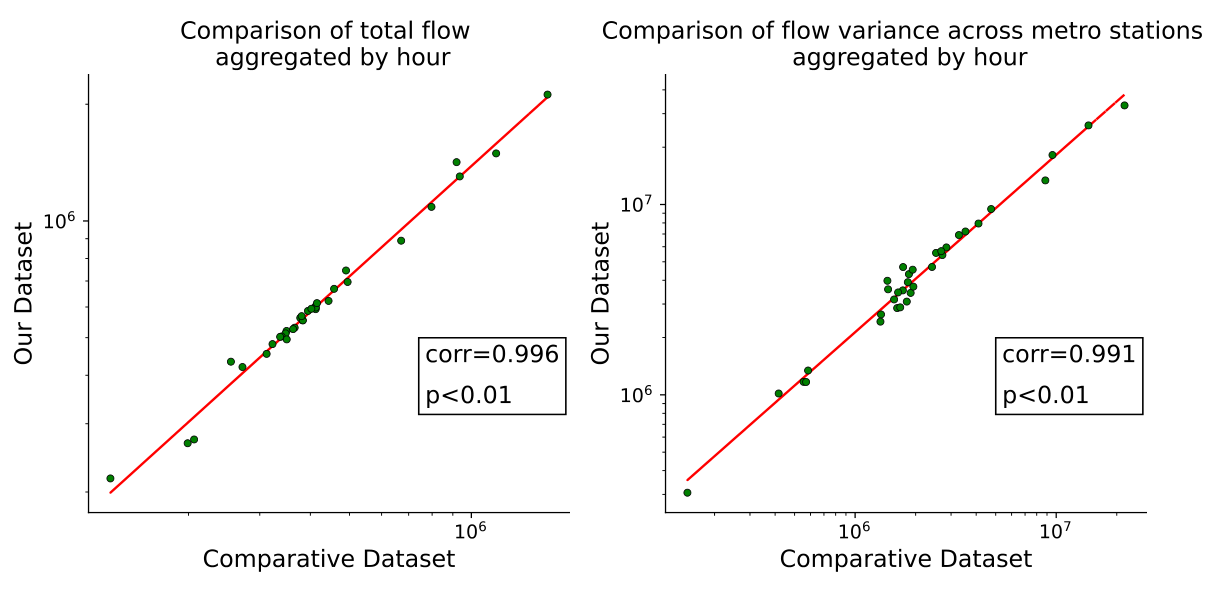
图 6|两个数据集在哪个尺度上相互支持?
原图没有字母标号。左面板比较工作日与非工作日小时格子的全系统客流总量,Pearson 相关约为 0.996;右面板比较同样时间格子内各站客流的方差,相关约为 0.991。横轴为参考数据,纵轴为本文数据;两轴都使用对数刻度展示,红线帮助查看对应关系。来源:原论文 Fig. 6。
由于参考集只有匿名站点编号,无法逐站匹配真实位置,比较合并成工作日和非工作日各 17 个小时格子,共 34 个时间格子。因此,高相关支持全城节律与站间离散模式相近,不能证明 302 个站逐一对应正确,更不验证家站、工作站识别达到 99% 准确率。
论文对参考集的年份在不同段落还有不一致表述。复用这项比较应回到具体参考文件核对年份和时段,而不要用它估计两个年份之间的精确增长量。
真正使用数据时,两张流量表怎样对应?
原论文表 1 是站点进出站表,表 2 是 OD 表。二者使用同一站点标识,另有站名、经纬度、相邻站、天气与工作日历。工作日历考虑中国调休,不能简单用周一至周五代替所有工作日。
| 内容 | 主要字段与含义 |
|---|---|
| 站点进出量 | IF、OF 为总进站与出站量;CIF、HIF、NIF 及 COF、HOF、NOF 为对应三类分量 |
| 站间 OD | 起站、终站、Flow 总量以及 CFlow、HFlow、NFlow 三类分量 |
| 时间 | Date、Slot、StartTime、EndTime,使用 UTC+8;每日 102 格,123 天共 12,546 格 |
| 站点与环境 | 站名、位置、拓扑、小时天气和工作日标记 |
OD 按估计进站时刻分组,同一旅客的出站会发生在稍后的格子;不能要求同一十分钟格子的 OD 到达端合计必然等于该格实际出站量。做流量守恒或延误分析,应先统一时间口径。
OD 采用稀疏存储,没有流量的站对时段不写入行,文件仍约 12 GB。正常日期里的省略行与六个缺失日期中的数据不足需要区别处理,不能把两者一律补成真实零值。
还有两条适用范围。数据只覆盖当时这 302 个站和四个月,不能代表今天全部上海地铁;它也不包含地铁之外的完整活动链。若用活动标签进行预测,又要求评估面向未来的能力,应注意家与工作站是否由整个四个月推断,避免把测试时期行为反向用于训练期标签。
一句话总结
MetroFlow 把上海地铁客流从单一总量推进到站点、OD 和行为类别,但时间估计、标签规则和缺失标记决定了这些精细字段应该怎样读。
核心来源
- Sun, P., Yang, J., Huang, Z., et al. (2025). Human Mobility Datasets in the Complex Metro System of Shanghai. Scientific Data, 12, 1061. DOI: 10.1038/s41597-025-05416-8。六张完整原图均来自该论文。
- 数据仓库及作者公开代码。标签剩余项的说明另核对了
step1_LabelUser.ipynb、step2_ExtractOD.ipynb中的实现。
作者介绍
- Peiyan Sun:共同第一作者,署名上海交通大学人工智能相关研究机构及数据驱动管理决策实验室,参与研究构思、数据整理和初稿。
- Jinming Yang:共同第一作者,署名同上,参与研究构思、数据整理和初稿。
- Zongyuan Huang:署名上海交通大学,参与数据验证。
- Shaoyu Huang:署名上海交通大学,参与数据验证。
- Shengyuan Xu:署名上海交通大学,参与数据验证。
- Weipeng Wang:署名上海交通大学,参与分析与可视化。
- Wenxuan Guo:署名上海交通大学,参与分析与可视化。
- Yuting Feng:署名上海交通大学,参与分析与可视化。
- Xi Zhai:署名上海市交通信息中心、上海市城乡建设和交通发展研究院,参与数据收集。
- Tao Yang:署名上海市交通信息中心、上海市城乡建设和交通发展研究院,参与数据收集。
- Xiaokang Yang:署名上海交通大学,参与研究指导。
- Yaohui Jin:通讯作者,署名上海交通大学,参与研究指导。
- Yanyan Xu:通讯作者,署名上海交通大学,参与研究指导。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
数据发布得更细,并不一定意味着研究者可以问得同样精确。某条通勤流在 8:00–8:10 上升,可能是真实需求变化,也可能是一部分行程的反推时间跨过了十分钟边界。如果任务只预测小时总量,这种误差或许影响较小;如果要判断哪一分钟该调整进站管控,它就可能成为决定性问题。
一个可检验的方向,是给估计进站时刻增加合理的时间扰动,比较模型排名和站点高峰识别是否稳定。同时对已识别锚点与未识别锚点的乘客分别评估,检查所谓非家相关出行的模式是否主要来自少量可识别用户。这样能把聚合数据的便利转化为明确的适用边界,而不是用十分钟这个精细数字掩盖推断的不确定性。