手机定位画出的城市,哪些部分值得相信?
论文名片|Chen Zhong、Zhengzi Zhou、Nilufer Sari Aslam、Yikang Wang、Adham Enaya,Anonymised human location data in England for urban mobility research,Scientific Data 12,2040(2025),正式发表版。论文 DOI。
一个定位点落在商场附近,是去购物,还是在附近上班?一段夜间停留,是回家,还是上夜班?手机留下的是时间与位置,研究者想知道的却是活动、通勤和城市联系。把前者转换成后者,需要一连串规则,而每一条规则都可能改变地图。
这篇论文提供英格兰 2021 年 11 月移动应用定位数据的处理与验证框架,并开放一部分轨迹和全国起讫流量。它的价值既在数据,也在于展示哪些中间判断应该接受检验:大区域的相关性可以很高,缩小到社区以后,代表性仍会明显变化。
先说结论
- 原始月份记录 793,502 个活跃设备,其中 628,649 个至少有 14 个连续有效日。开放产品包括伦敦地区随机抽取的 5,000 个设备轨迹,以及覆盖英格兰观测活动的聚合起讫矩阵。
- 停留点、家、工作地和活动目的都经过推断。距离阈值、停留时间、日历规则和周围 POI 会影响这些标签,它们不是设备直接报告的真实意图。
- 检测居住用户数与普查人口,在地方行政区尺度的 Pearson 相关为 0.905,较小区域降至 0.52;粗尺度的一致性不能保证每个小区域都可靠。
- 通勤矩阵在地方行政区尺度相关约为 0.95,但分区内部更细尺度的相关有明显差异。补材还显示,零流量不一致与社会经济覆盖偏差需要单独检查。
全国数据和 5,000 条轨迹,并不是同一份东西
输入来自 Locomizer 授权的约 200 个移动应用 GPS 数据,使用匿名设备标识、经纬度和时间戳。论文将一个设备近似视为一个人,也承认多设备使用未在预处理中完全解决。因此,设备数不能不加条件地当作独立人口数。
研究选择 2021 年 11 月作为流程示例。该月不是节假日旺季,但仍有疫情背景;伦敦超低排放区在此前扩展,也可能影响活动。数据不能直接代表所有年份或所有时期的通常出行。
| 开放产品 | 覆盖范围 | 记录口径 |
|---|---|---|
| 匿名轨迹 | 大伦敦地区随机抽样的 5,000 个设备、30 天 | 活动—出行链;位置汇总到 MSOA,起止时间采样到 15 分钟间隔 |
| 全活动起讫矩阵 | 英格兰全部观测移动 | 中层超级输出区 MSOA 与 H3 第 9 级六边形尺度的区域联系 |
| 上班起讫矩阵 | 英格兰推断的上班移动 | 从全体观测数据提取的通勤联系 |
MSOA(Middle layer Super Output Area)是英国人口统计使用的空间单元,不宜直接当作中国行政街道。矩阵以边列表保存起点、终点和次数;“全部观测”也不等于全人口的全部出行。公开轨迹已降低空间与时间精度,不能拿来恢复每个拐弯或精确进店时间。
论文的处理和统计基于完整输入数据;公开 5,000 个设备轨迹是另一个抽样产品,不能用其样本量替代所有验证图的分母。
定位点怎样变成一段有意义的停留?
原始定位既可能密集抖动,也可能长时间缺测。Infostop 把连续位置序列转成停留事件:位置在一定空间范围内、持续达到一定时间,才识别为停留。本文使用 50 米空间阈值、1 分钟最低停留时长。
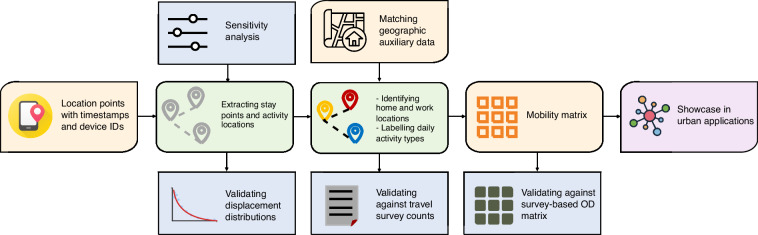
图 1|从定位到城市联系,哪些步骤需要验证?完整流程图从位置点进入停留识别,再推断家、工作地与活动类型,形成移动矩阵和应用示例。上方加入敏感性分析及地理辅助数据,下方分别检查位移分布、调查计数和调查起讫矩阵。原图无子图字母,颜色和箭头区分输入输出、处理与验证环节。来源:原论文 Fig. 1。
50 米并非从所有城市通用的真值推导出来。补图 S2 改变空间阈值,同时考察 1、10、20、30、60 分钟等时间门槛。太小的范围容易把 GPS 抖动分成许多片段,范围过大又会合并不同地点。
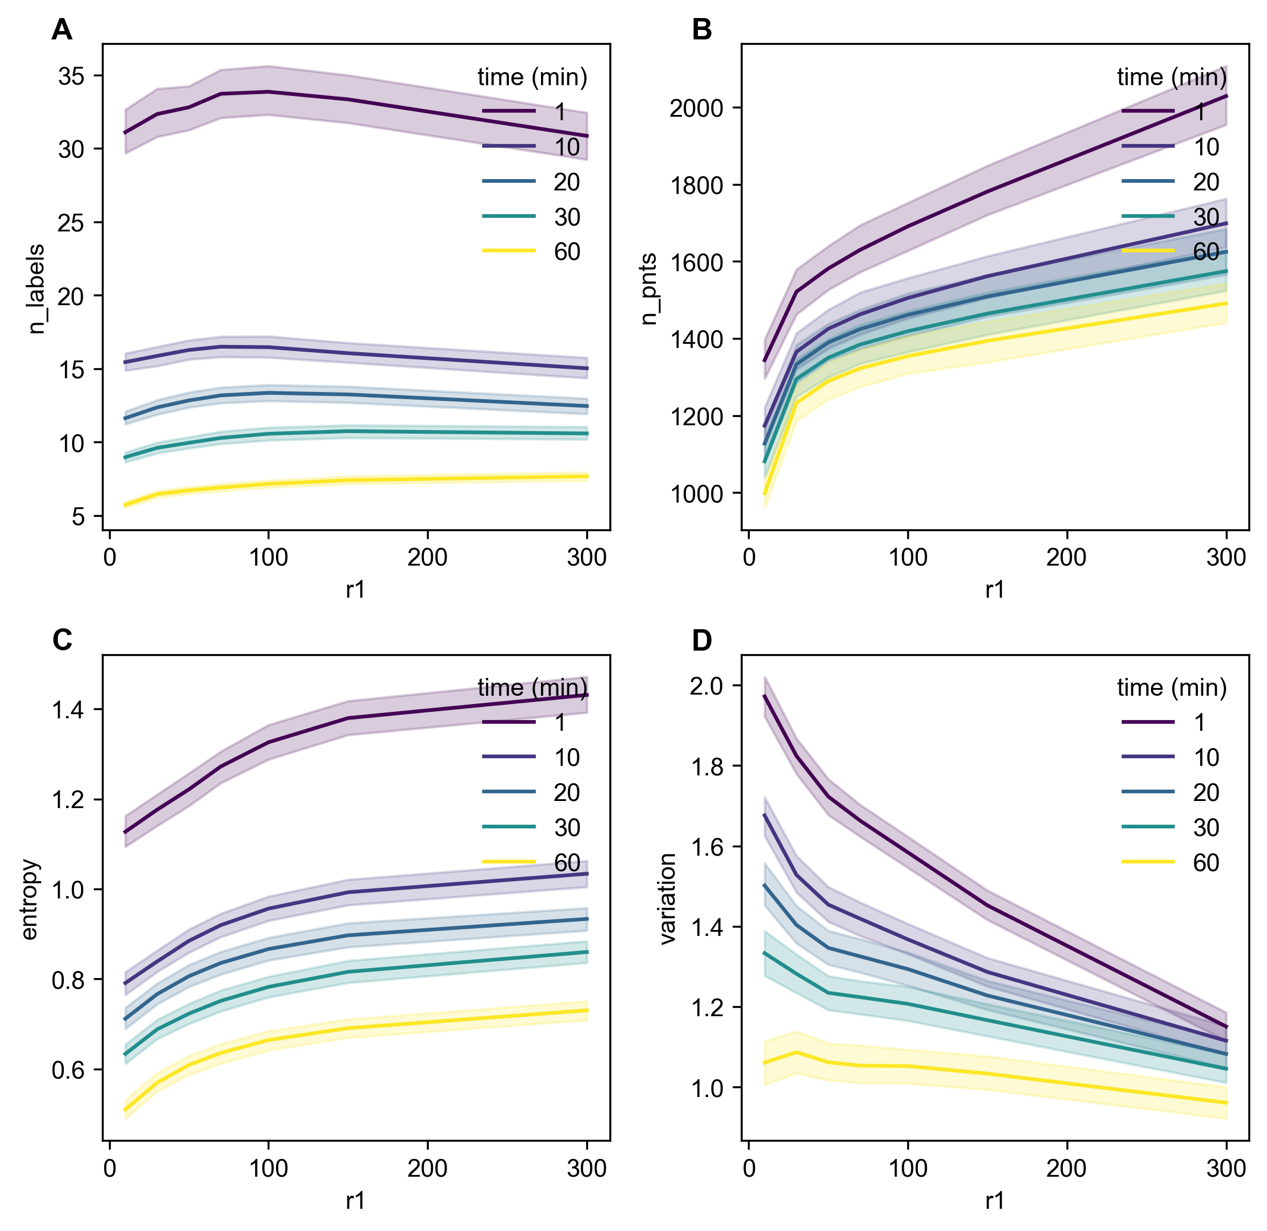
补图 S2|更换阈值,会把同一段轨迹加工成什么?四幅图横轴都是空间阈值 r1,颜色对应最低停留分钟数。(A)独立地点标签数;(B)停留记录数;(C)标签熵;(D)变异指标。地点多样性在部分设置下约 80 米附近较高,作者选择 50 米作为压制抖动与保留地点差别的折中;这不等于对每种活动都最优。来源:原论文 Supplementary Fig. S2。
定位采样也会随时间改变。补图 S1 显示,按小时观测到的用户数量较稳定,而定位记录数在早晚更明显上升。这提醒读者:定位点更多既可能反映活动增加,也可能反映采样强度增加,不能把两者直接等同。
给停留贴上“家、工作、购物”标签,依据是什么?
正式发表版识别家的规则,是在 21 点至次日 7 点的候选停留中选择最长停留位置;工作地则从非家候选中,在工作日 8 点至 17 点选择最长停留位置。这些规则适合常见日程,但对夜班、流动工作、多工作地或居家办公等安排可能失效。
其他活动借助英国 Ordnance Survey 的兴趣点(point of interest,POI)和外部调查设定的时间权重识别。每个停留周围搜索 500 米范围,Huff 模型结合到候选 POI 的距离与类别在该时段的权重,给出相对概率,再选择最高的活动类别。
补充 Table S2、S3 分别给出 POI 类别和逐小时权重。活动包括家、工作、教育、餐饮、日常采购、其他购物、娱乐和其他;后六类借助 POI 与时间模式推断。靠近餐馆并不保证是在吃饭,尤其在混合用地建筑中,直线距离、POI 漏项与人为时间先验都可能影响标签。
补图 S3 把家、工作和其他地点的逐小时用户数按星期展示。它要求用户在该小时有连续至少 30 分钟的静止活动,每人每小时只计到一种地点。夜间和周末仍有被标作工作地点的停留,这既提醒我们存在非标准日程,也不能单靠曲线区分真实夜班与误分类。
看起来像通常的人类移动,就能证明处理正确吗?
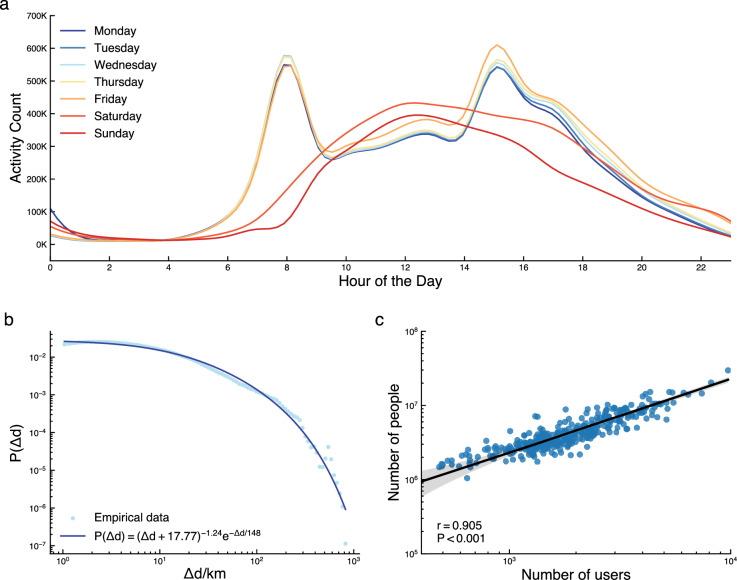
图 2|处理后的活动是否呈现可理解的时间与空间规律?(a)横轴为小时,纵轴为平均活动开始次数,颜色区分星期;工作日呈早晚峰、周末更集中于中午附近。(b)相邻停留的位移距离与概率,展示 1—1,000 公里范围内的截断幂律拟合,指数约 1.24。(c)横轴为设备居住用户数、纵轴为普查人口,两者采用对数刻度;地方行政区 LAD 尺度 Pearson r=0.905。来源:原论文 Fig. 2。
时间峰和位移分布提供了合理性检查,但相似的宏观规律并不能验证每个停留或活动标签。更直接的比较是人口与通勤调查,同时还要检查空间尺度。
人口对比中,粗尺度相关 0.905,较小区域仅为 0.52。这可能来自家识别误差,也可能来自应用用户的地域覆盖偏差,两者不能通过一个相关系数被完全分开。
补图 S4 进一步把居住地区按房价、人口密度、高学历比例和失业比例分成十分位组,检查设备用户的分布。原始样本对部分低房价、低密度、较低学历及低失业地区的覆盖更高。事后分层调整后,分布更接近各组 10%,但改善的是这些被选指标上的平衡,不能证明所有人群的移动行为已被校正。
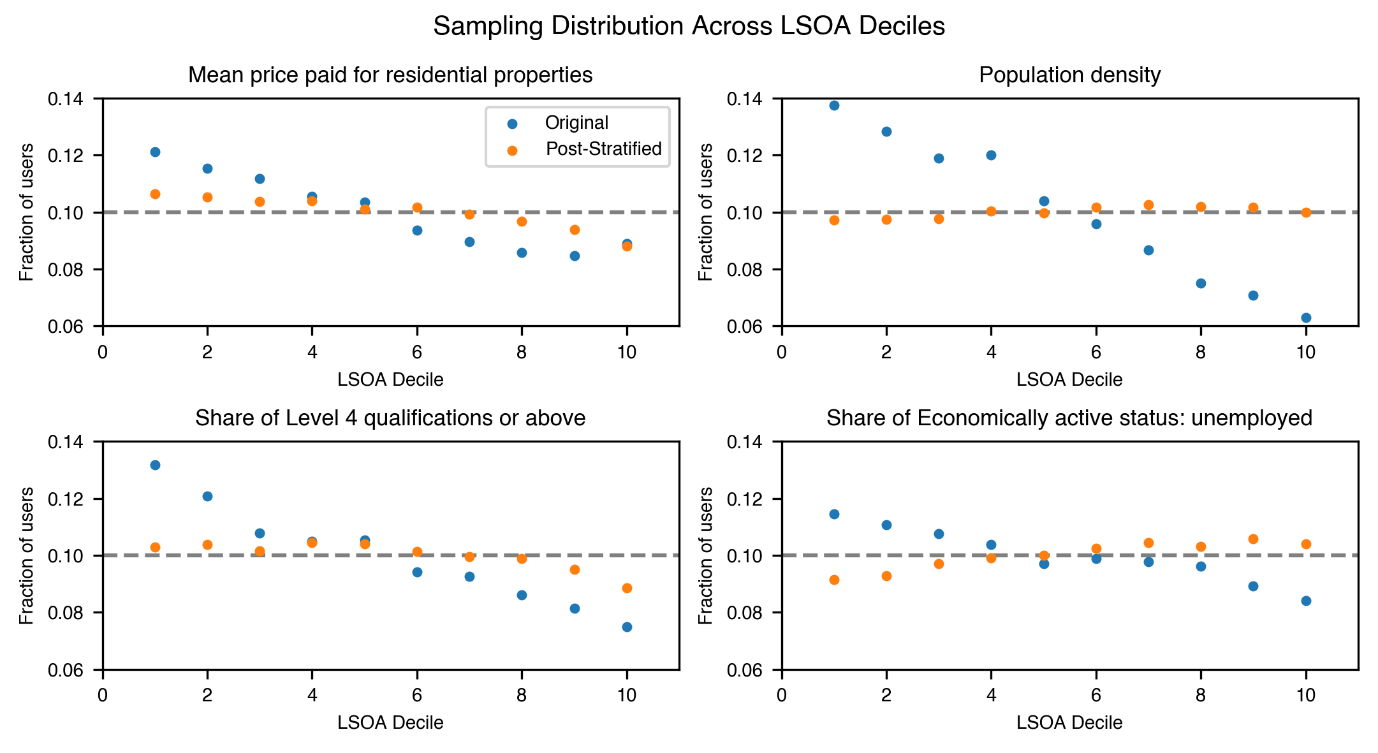
补图 S4|总量相关高,样本构成是否也均衡?四幅图依次为房产均价、人口密度、高学历比例、失业比例;横轴为 LSOA 地区特征的十分位组,纵轴为用户占比。蓝点是原样本,橙点是事后分层后的样本,虚线为每组 10%。原图没有面板字母,按左上、右上、左下、右下说明。来源:原论文 Supplementary Fig. S4。
通勤联系的高相关,为什么到了社区仍有落差?
地方行政区(Local Authority District,LAD)尺度的通勤起讫矩阵与 2021 年普查通勤数据,Pearson 相关约为 0.95。细尺度验证则把 7,264 个 MSOA 按 331 个 LAD 分组,在有充分记录且不止一个 MSOA 的 311 个 LAD 内,比较经 log(1+x) 变换后的联系。
原论文 Table 1 给出:组内 Pearson 相关均值 0.704、中位数 0.718、标准差 0.095;正文报告范围约为 0.38—0.87。Spearman 秩相关均值为 0.646,移动与普查通勤量之比的均值为 0.016。这里的 0.016 是所比较通勤量的比例,不能直接称为全国人口覆盖率。
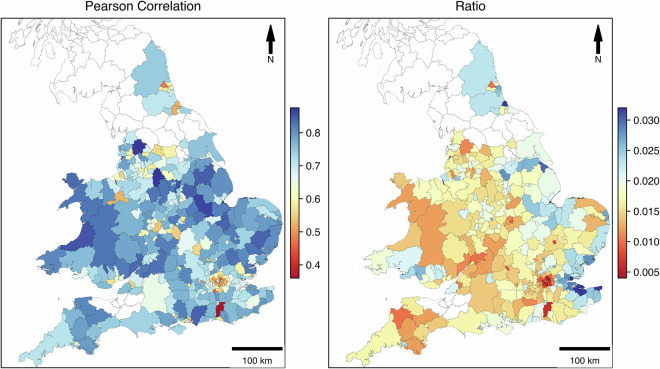
图 3|哪些地区内部的通勤联系更一致?左图按 LAD 展示内部 MSOA 联系的 Pearson 相关,右图展示移动数据与普查通勤量的比例;颜色使用各自的图例,灰白区域不能自动解释成没有通勤。两图均保留比例尺与方向标。原图无面板字母。来源:原论文 Fig. 3。
还需检查零流量。补图 S5 报告:普查有流量但移动数据为零的起讫对有 30,978 个,双方均零有 26,171 个,只有移动数据为正有 6,369 个,双方均正有 31,963 个。小流量未被设备样本覆盖,与两份数据描述的对象不同,都可能造成不一致。
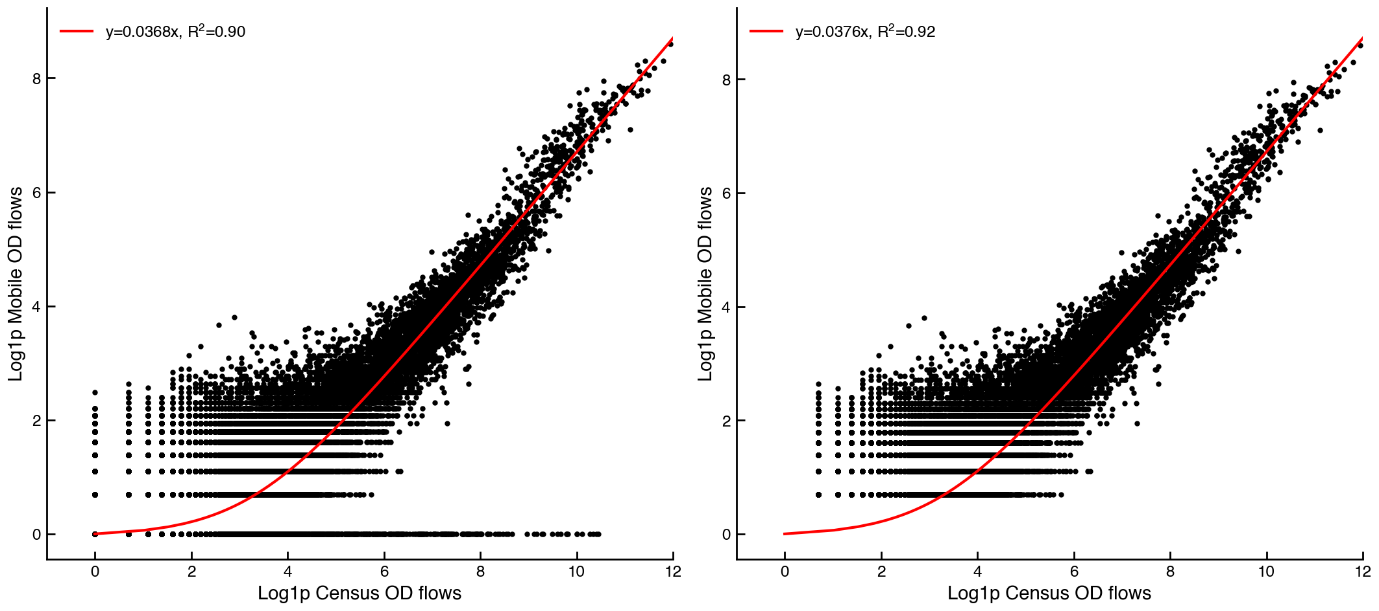
补图 S5|只看双方都观测到的联系,会不会得到更漂亮的结果?左图保留全部起讫对,右图只保留两份数据都为正的起讫对;横轴为 log(1+普查流量),纵轴为 log(1+移动流量)。原图标注拟合 R² 从 0.90 升至 0.92。去掉零值后的一致性提高,不等于被漏掉的联系已经恢复。来源:原论文 Supplementary Fig. S5。
数据能支撑空间模型,不代表每条联系都已无误
论文用四类空间交互模型作应用检验:无约束引力模型、出发总量约束、到达总量约束,以及双约束模型,分别采用幂函数和指数函数距离衰减。研究比较它们在普查通勤与移动通勤上的拟合表现,而非用一种数据直接证明另一种数据准确。
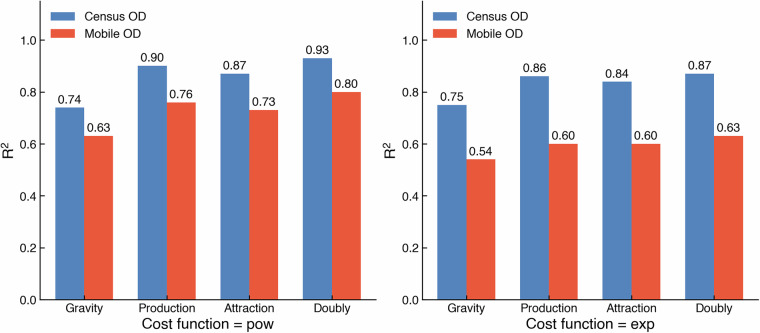
图 4|不同数据能否支持相近的模型比较?左右两幅分别使用幂函数和指数距离成本,横轴为四种约束设置,纵轴为 R²,蓝柱代表普查、红柱代表移动数据。幂函数下两套数据的双约束拟合分别为 0.93、0.80;指数函数下分别为 0.87、0.63。趋势相近但移动数据拟合普遍较低,不能概括为两者表现完全相同。原图无面板字母。来源:原论文 Fig. 4。
另一个示例用全部活动起讫网络识别联系密集的社群。空间单元在内部联系更多、对外联系较少时被分到同组,再通过分辨率参数控制分组颗粒度。
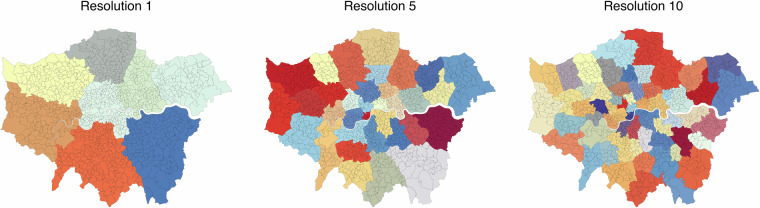
图 5|同一张移动网络能呈现几层城市结构?左、中、右三幅依次为分辨率 1、5、10,颜色区分检测出的网络社群,边界随分辨率改变。颜色不是活动类别、行政等级或人口高低;空间分组的连贯性支持结构合理性,但不是独立真值验证。原图无面板字母。来源:原论文 Fig. 5。
补图 S6 还画出伦敦各 MSOA 的 log(流出量)/log(人口)、log(流入量)/log(人口),中心就业区与希思罗机场周边数值较高。这是单区域的描述性对数比值,不能直接当作跨地区回归得到的幂律弹性,也不足以推断某地人口翻倍后流量会增长多少。
什么问题适合用它回答?
这套产品适合检验聚合区域之间的联系、在明确规则下比较活动模式,以及开发可复用的停留识别与验证流程。若关注小区域绝对通勤人数、夜班人群、完整个人日记或出行方式,就需要额外证据:定位轨迹不连续、应用使用存在选择性,研究也没有完成出行方式识别。
因此,复用时应保存处理阈值、时间窗、空间单元和缺失规则,并在目标城市、目标人群与目标任务上重新验证。统计规律像、人口相关高、模型能拟合,分别是不同层次的检查,不能合并成一个无条件可靠的标签。
一句话总结
手机定位可以生成有用的城市活动与流动数据,但只有把加工规则、空间尺度和未覆盖的联系一起交代,地图才有可解释的可信范围。
核心来源
Chen Zhong, Zhengzi Zhou, Nilufer Sari Aslam, Yikang Wang, Adham Enaya. Anonymised human location data in England for urban mobility research. Scientific Data 12, 2040 (2025),2025 年 11 月 26 日发表。正式论文与补充材料,PMC 正文。正文 Fig. 1—5 及补图 S2、S4、S5 均为原论文完整组合图。
Zenodo 数据归档提供公开产品;作者代码仓库提供复用入口。这里的更新信息不代表本文保证仓库长期持续更新。
作者介绍
- Chen Zhong:论文署名为伦敦大学学院高级空间分析中心(CASA),为通讯作者,与 Zhengzi Zhou 共同第一作者;负责概念、方法、资源、指导及写作等工作。
- Zhengzi Zhou:署名为 UCL CASA,与 Chen Zhong 共同第一作者,参与方法、分析、可视化、验证与写作。
- Nilufer Sari Aslam:署名为 UCL CASA,参与方法、分析、可视化、验证与写作。
- Yikang Wang:署名为 UCL CASA,参与方法、分析、可视化、验证与写作。
- Adham Enaya:署名为 UCL CASA,参与方法、分析、可视化、验证与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一项城市比较可以先问:如果把每个城市都稀疏采样到同样的定位频率,再用相同规则识别停留,排名还会不会变化?这能帮助分离真实活动差异与采样密度差异,尤其适合解释看似更活跃、实则记录更密的地区。
另一个值得保留的结果是未观测到的联系。把普查为正而手机样本为零的起讫对单列,研究它们是否集中在小流量、特殊工作时段或弱覆盖地区,比仅报告删零后的高相关更能帮助规划者判断哪些人和地区仍被地图遗漏。