不知道是哪座城市,还能公平比较人们下一步去哪里吗?
论文名片|Takahiro Yabe、Kota Tsubouchi、Toru Shimizu、Yoshihide Sekimoto、Kaoru Sezaki、Esteban Moro、Alex Pentland,YJMob100K: City-scale and longitudinal dataset of anonymized human mobility trajectories,Scientific Data,2024,11:397,2024 年 4 月 18 日发表,Data Descriptor。DOI · Zenodo 数据版本 v3。
假设两组研究者都声称能预测人们的下一站。一组用某城市的小样本,另一组用另一家公司的百万轨迹;两边地点、日期、缺失率都不同,模型分数就很难直接比较。可是一旦公开长期个体轨迹,又必须面对位置隐私。
YJMob100K 选择保留大规模个体的匿名网格序列,同时隐藏城市、经纬度和真实日期。它想解决的是共同基准上的轨迹预测比较,而非提供一张可以追溯真实生活地点的城市全景图。
四点核心信息:
- 正文具体定义的数据集 1 是 10 万人、75 天通常状态;数据集 2 是 2.5 万人、60 天通常状态加 15 天紧急状态。
- 地点变成 500 米网格、时间变成 30 分钟时段,每人每时段只留第一条观测;这是稀疏观测序列,不是连续真实路径。
- 居住地分布与人口普查有较高空间相关,但这不能验证每个人的全部活动或人口属性代表性。
- 第 27 天存在已知异常;日内覆盖图聚合了全部日期,不能把某时段累计看见过几乎所有人,写成每一天每时段都看见所有人。
两份轨迹,为什么不能简单说成连续 90 天?
论文的数据记录部分将两份轨迹明确分开:
| 文件 | 人数 | 时间安排 | 记录数 |
|---|---|---|---|
| yjmob100k-dataset1.csv.gz | 100,000 | 75 天通常状态 | 111,535,175 |
| yjmob100k-dataset2.csv.gz | 25,000 | 60 天通常状态与 15 天紧急状态 | 29,389,749 |
两份文件的 day 都为 0–74。摘要提到 90 天、75 天通常状态加 15 天紧急状态,与上述文件层面的描述不同;不能把它改写成每个人都被连续观察 90 天,也不能假设两份文件的同一 ID 指向同一人。
Zenodo v3 顶部说明还写有第一份 80,000 人、第二份 20,000 人的不同口径,其下竞赛说明则描述任务 1 共 100,000 人,80,000 人有完整序列、20,000 人需预测末 15 天;任务 2 共 25,000 人,其中 2,500 人末段被遮挡。本文按论文具体数据记录介绍正式数据,复现时仍需固定文件版本并实际核对唯一 ID、天数和缺失,不能把仓库摘要或竞赛分组直接当成同一个样本定义。
紧急情况的性质没有公开,因此无法把它直接命名为某次疫情、地震或政策事件。数据集 2 的价值在于测试分布改变时的泛化,不能据此识别具体灾害效应。
从手机 GPS 到匿名序列,中间做了哪些选择?
原始数据来自安装 Yahoo Japan、现称 LY Corporation 应用的手机,经用户同意采集。原始定位频率随移动状态变化:停留时较低,移动时较高,以减轻电池负担。因此记录数首先受采集机制影响,不等于出门次数。
研究先选日本未公开都市区域的边界框,保留某个 10 天窗口内在框中出现超过 10 次的用户,再按拥有足够时段观测的条件筛选。后一个阈值没有具体公布。区域外观测被丢弃,因此离开研究区后的空白,不能自动解释为在家或停止活动。
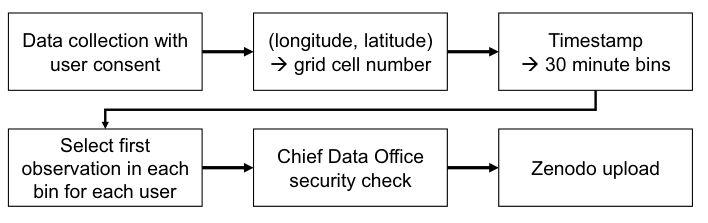
图 1|公开的轨迹序列是如何形成的?
在用户同意后采集,经纬度映射成网格,时间映射成 30 分钟时段,每个用户每时段选第一条观测,再经公司安全检查上传 Zenodo。原图无子图字母。来源:原论文 Fig. 1。
保留第一条观测意味着,一个时段内跨过多个格子的移动会被压缩。未出现记录的时段也没有被论文定义为静止。空间粗化和时间抽样会影响短距离、短时活动的可见性,因此预测目标应明确为发布序列中的网格位置。
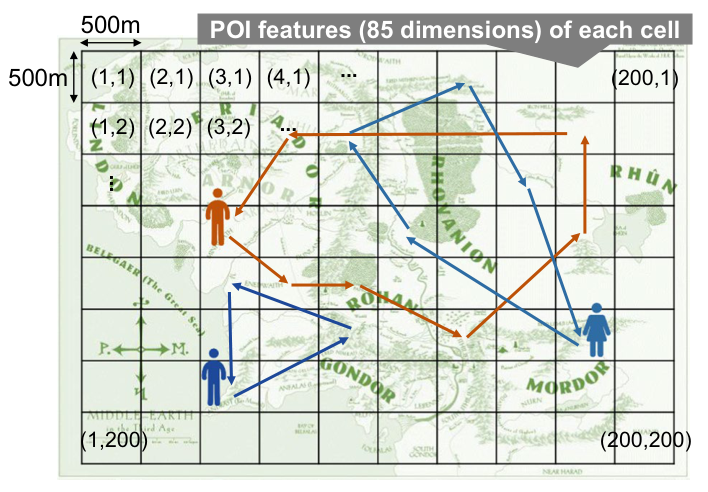
图 2|去掉真实地点以后,还保留了什么结构?
横纵坐标各为 1–200,每格 500 米,示意轨迹在格网内移动;每格另有 85 维 POI 类别计数特征。图是数据表达方式示意,不能据背景图识别实际城市。原图无子图字母。来源:原论文 Fig. 2。
表 1 给出的轨迹字段为 user ID、day、timeslot、x、y。每天 48 个时段,timeslot 0 表示 00:00–00:30,13 表示 06:30–07:00;day 隐藏真实日期,不能直接连接实际节假日与天气。200 × 200 个格子对应一个边长约 100 公里的框,这是由格网尺度计算的几何范围,不表示框内都是连续建成区。
表 2 的 POI 文件使用 x、y、POIcategory、POI_count,表示某格某匿名类别的设施数量。配套类别名清单虽列出 85 类,如餐饮、购物、学校,但论文明确不公开匿名维度与实际类别的对应关系,不能按名单行号自行把某个编号解读成餐馆或医院。它可以作为匿名预测特征,无法直接赋予每一维确定的场所语义。
人口分布接近普查,究竟验证了哪一层?
作者用晚上 20 点至次日早上 8 点最常出现的格子估计居住地,再把用户分组到 1 公里网格,与人口普查比较。
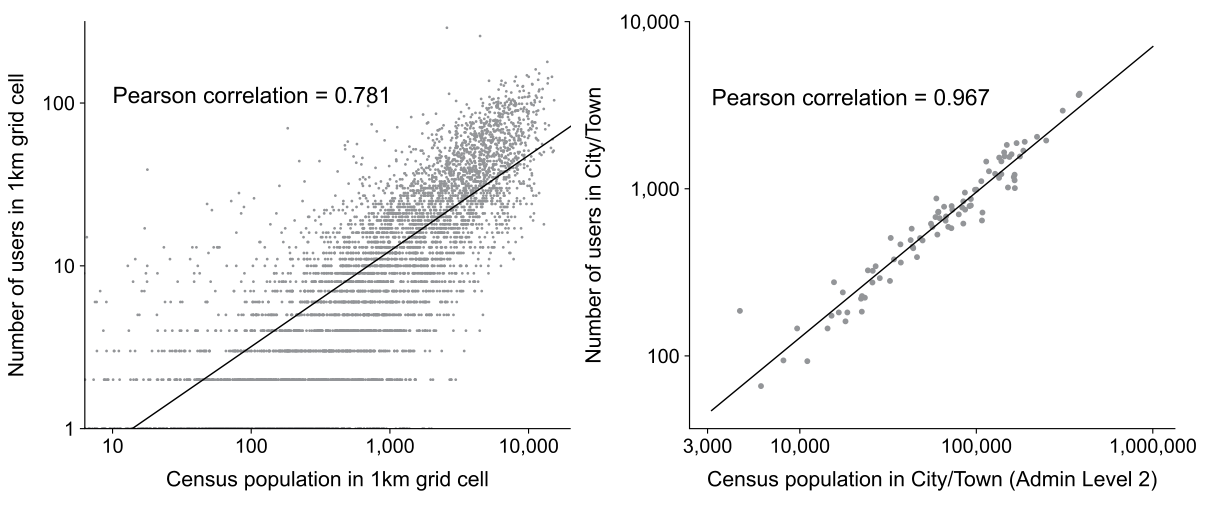
图 3|样本在空间上是否集中于人口较多的地方?
左图横轴为 1 公里格网的普查人口,纵轴为估计住在其中的样本用户数;双对数散点显示正相关,图内及图注标注 Pearson r = 0.781。
右图按城市、町级行政区聚合,横轴为普查人口,纵轴为样本用户数,图内 r = 0.967。两面板保持原组合。来源:原论文 Fig. 3。
正文在 1 公里尺度另写 r = 0.796,与图内和图注 0.781 不一致,因此这里保留并注明两种数字,不将其平均成一个新值。行政区尺度的 0.967 在正文和图中一致。聚合尺度变大可能提高相关,也会掩盖细格差异。
这项验证支持样本居住分布与人口密度大体一致,并未验证年龄、收入、职业或出行方式代表性。论文提到原始定位数据约覆盖格网人口的 5%,也不能将这个原始总体比例直接当作最终筛选后每个格子的抽样率。
居住地是夜间频次推断,不是逐人核验的住址。公开数据又隐藏了真实位置,因此不能可靠连接社区收入或其他人口统计,不能用这份基准直接替代具体城市的社会隔离研究。
10 万人,并不意味着每个人每天都有 48 个位置
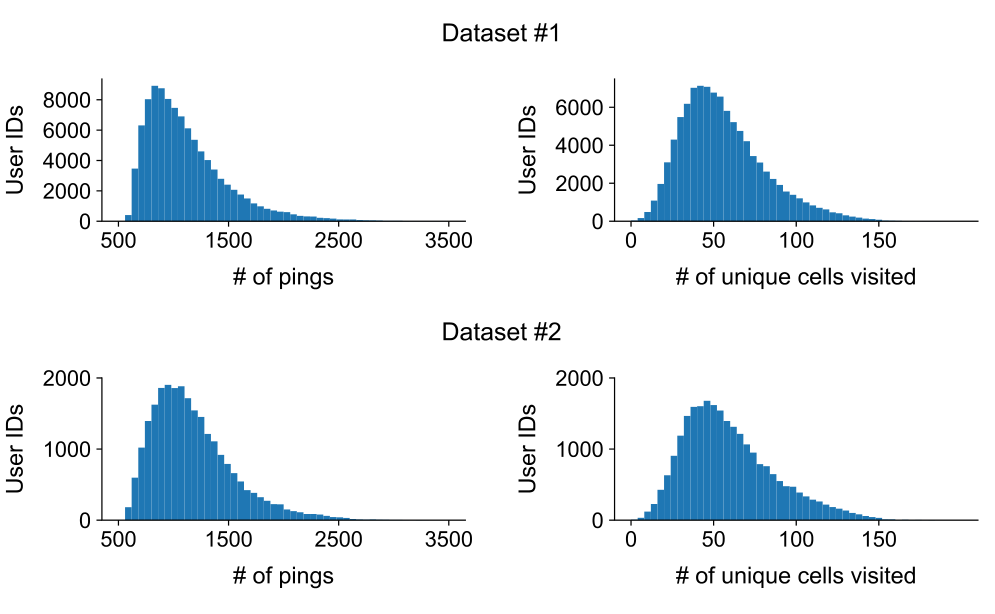
图 4|不同用户提供的观测有多不均衡?
上排为数据集 1、下排为数据集 2;左列横轴为每人的记录数,右列为每人去过的不同格数,纵轴均为用户数。记录量与活动范围都存在差异,少部分用户远高于主要群体。原图没有子图字母。来源:原论文 Fig. 4。
按论文总量计算,数据集 1 平均每人每天约 14.9 条,数据集 2 约 15.7 条,均远低于 48 个可能时段。这是以人数和天数为分母的整体平均,不代表每人每天均匀采样。补齐空白、把上一位置向后延续,都是使用者额外作出的假设。
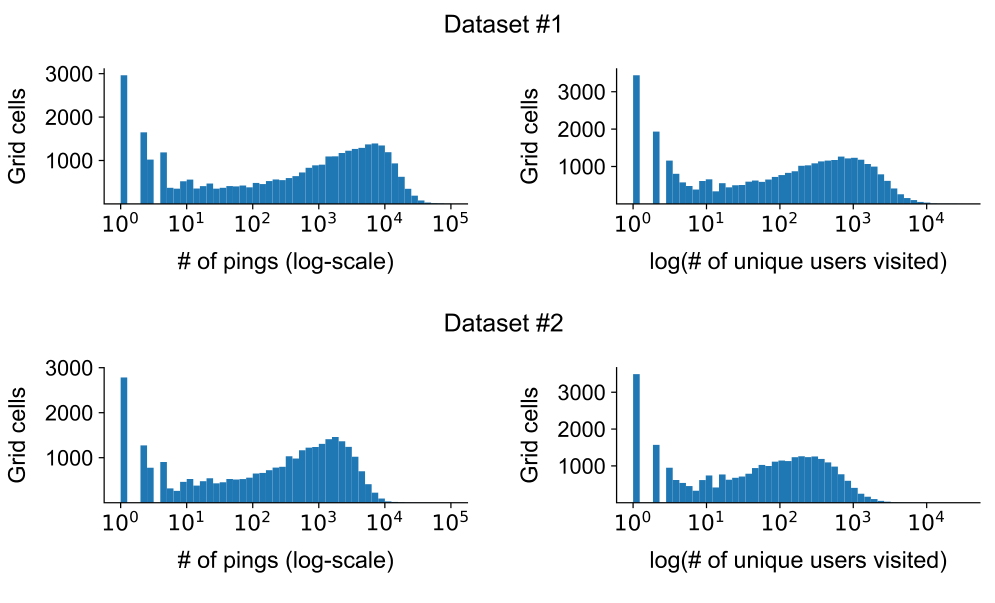
图 5|哪些格子容易被看见,哪些几乎没有信息?
上排为数据集 1,下排为数据集 2。左列横轴为每格记录数,右列为每格不同用户数,横轴均为对数刻度,纵轴为格子数。许多格子观测很少,另有较密集的一组格子,显示观测分布高度不均。来源:原论文 Fig. 5。
记录多可能来自访客多,也可能来自少数用户反复出现。图 5 因而同时保留记录数和不同访客数;只用前者会混合人群规模与重复观测。论文将双峰与区域中城市、乡村混合联系起来,但没有在公开数据中提供足以逐格核验的真实土地利用标签。
时间规律里,哪些是真变化,哪些可能是观测异常?
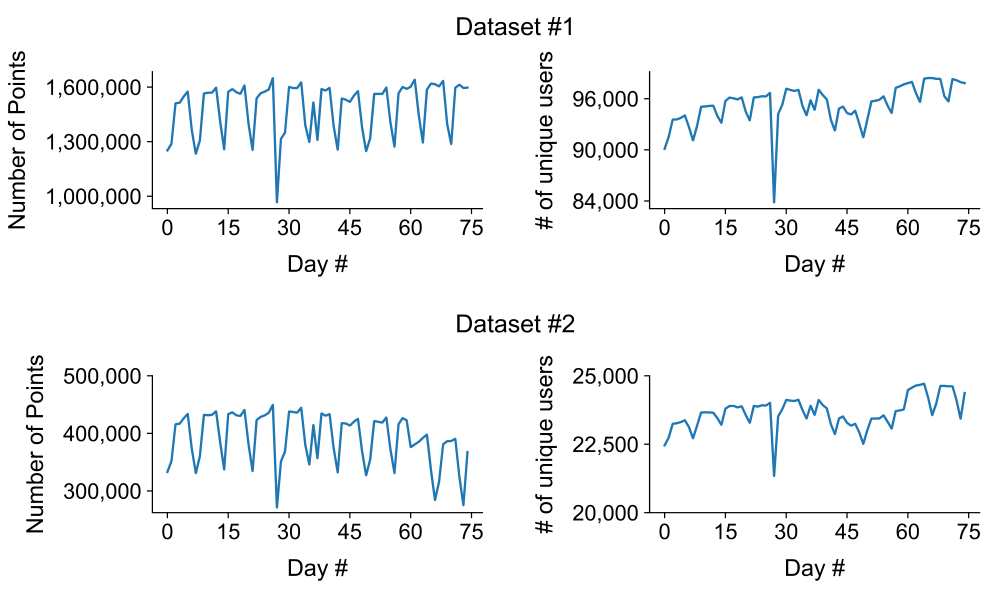
图 6|75 天的观察强度是否稳定?
上排为数据集 1,下排为数据集 2;左列是每日记录总数,右列是当日不同用户数,横轴 day 为 0–74。曲线呈周期波动,第 27 天有共同的明显下降,后期记录量和用户量也并非完全恒定。来源:原论文 Fig. 6。
第 27 天需要特别处理。论文先称其为数据采集问题,又称两份数据在该日的下降来自自然灾害,具体性质未公开,并建议分析时排除该日。这些表述不足以把下降分解为真实行为改变与数据采集中断,因此不能把那一天直接当作模型捕获灾害反应的成功案例。
数据集 2 后 15 天另有紧急状态安排,但它与第 27 天异常不能凭文字相似就视为同一事件。使用时应明确异常日处理规则,并在所有模型之间保持一致。
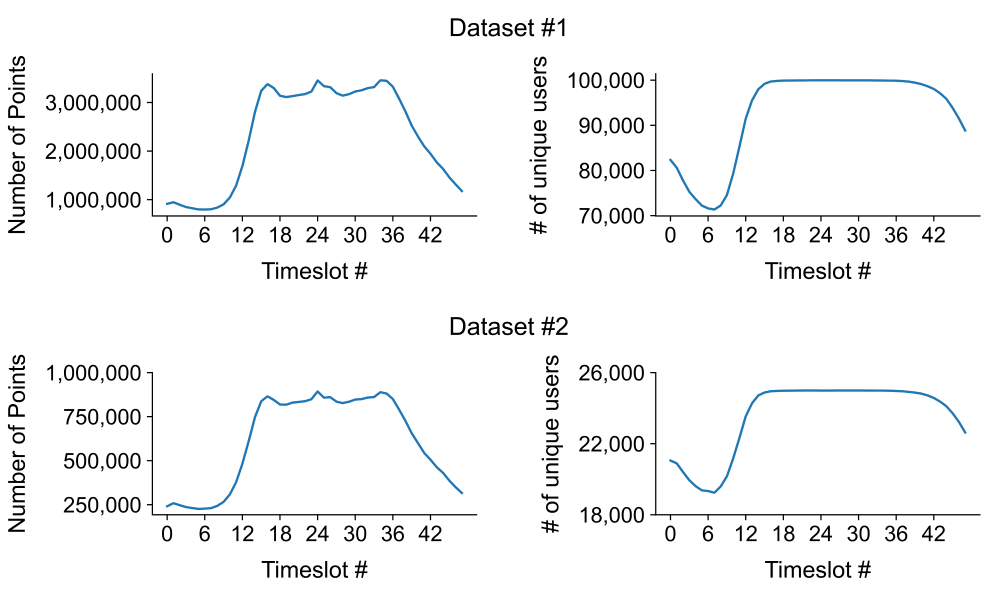
图 7|一天内哪些时段更容易获得观测?
上排为数据集 1,下排为数据集 2。左列是把所有观察日按 timeslot 聚合的记录数,右列是该时段在全期出现过的不同用户数。横轴每格半小时,白天记录较多,右列在白天接近样本总人数。来源:原论文 Fig. 7。
图 7 右列的含义尤其重要:75 天中,只要某人在这个半小时位置出现过,就可被计入。接近 10 万并不说明每天 6 点到 20 点都同时观察了 10 万人。评估连续多步预测时仍要逐人、逐日检查覆盖,不能拿全期累计覆盖代替单日完整率。
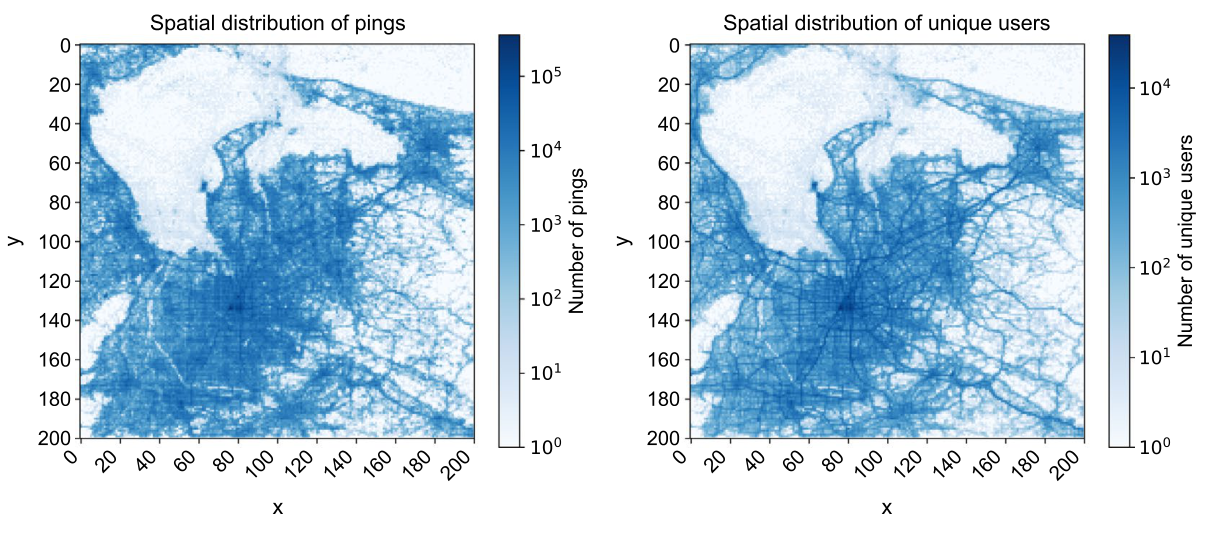
图 8|密集观察区域是否在两种指标下都存在?
左图为每格累计定位记录数,右图为不同用户数,坐标为匿名 x、y 网格;色条使用对数刻度,深蓝代表更高数量。稀疏与密集区域在两图中均可辨认。原图是蓝色连续色阶,不应将其解释成额外的红色乡村分类。来源:原论文 Fig. 8。
这张图让预测者看到空间样本不均,也解释为什么总体准确率可能被热门格子主导。它没有公布真实地标,不能据热度猜测具体社区或用户身份。
这份数据适合比较什么,不适合证明什么?
YJMob100K 的主要定位是人类移动轨迹预测基准。研究者可以在相同匿名序列、相同训练测试划分、相同缺失处理和指标下比较方法,并利用紧急状态部分考察分布变化。2023 年 HuMob Challenge 已以此组织预测任务,但这篇 Data Descriptor 没有给出一种新模型的完整性能排名。
公平比较仍需把任务说清:预测一个已知用户的未来时段,与预测训练中很少出现的新用户,难度不同;按全部记录随机拆分也可能让未来信息进入训练。POI 特征是否可用、第 27 天是否剔除、缺失时段是否补齐,都应固定后报告。
另一方面,500 米格网无法精确还原楼宇或面对面接触,半小时取一个位置也无法验证详细路线与交通方式。隐藏地理和日期、缺乏用户人口属性,使具体地点的社会经济解释受到根本约束。论文明确建议将其用于预测基准,而非以真实城市、具体 POI 为基础的城市科学或行为研究。
隐私保护也不能简单总结成“分箱后绝不可能识别”。本文报告了用户同意、原始数据留在公司服务器、安全审查和多方面匿名化处理,但没有提供重识别攻击率的系统测试。我们能够确认的是作者采取了哪些处理和公开了哪些信息,不能把这些步骤扩展成所有使用场景的风险保证。
一句话总结
隐藏真实城市以后,匿名网格序列仍能支持大规模轨迹预测比较;它的价值来自共同基准,使用边界则来自稀疏观测、筛选、数据口径和被有意移除的地点语义。
核心来源
- Scientific Data 正式论文:处理流程、表 1–2、图 1–8、空间验证、使用限制及作者信息。本文八张图均保留对应完整原图。
- Zenodo v3 数据记录:四个配套文件与竞赛任务说明;仓库顶部人数口径与论文不同,使用时须固定版本核对。
作者介绍
以下按论文署名机构和贡献声明介绍。
- Takahiro Yabe:MIT 数据、系统与社会研究所,以及纽约大学 Tandon 学院 CUSP 与技术管理创新系;通讯作者,与 Kota Tsubouchi 开发并计算移动性指标。
- Kota Tsubouchi:LY Corporation;通讯作者,参与移动性指标开发与计算。
- Toru Shimizu:LY Corporation,开发评估指标代码。
- Yoshihide Sekimoto:东京大学空间信息科学研究中心,参与论文写作与审阅。
- Kaoru Sezaki:东京大学空间信息科学研究中心,参与论文写作与审阅。
- Esteban Moro:MIT 数据、系统与社会研究所、马德里卡洛斯三世大学复杂系统跨学科组及美国东北大学网络科学研究所,参与写作与审阅。
- Alex Pentland:MIT 数据、系统与社会研究所及媒体实验室,参与写作与审阅。
延伸思考:预测分数提高,是学会移动,还是学会观察机制?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
移动时采样较密、停留时较疏,意味着发布记录的分布已经被观测机制塑造。如果模型只在有记录时预测,它可能更擅长数据出现的那些时刻,却未必更准确地描述完整的一天。提高“观测位置预测准确率”,与改善“真实活动预测”之间仍有距离。
一个可操作的评估是按用户每日观测覆盖分组,同时报告热门格子、冷门格子与紧急状态下的表现,再检查结果是否依赖特定缺失填补法。如果优势只出现在覆盖高、地点热门的用户上,结论就应限定到那个群体。这样的分层比较,比单一总分更能说明模型到底学到了什么。