早高峰的箭头,是挤向一个中心,还是在多个方向散开?
论文名片|Pengjun Zhao、Hao Wang、Qiyang Liu、Xiao-Yong Yan、Jingzhong Li,Unravelling the spatial directionality of urban mobility,Nature Communications,2024,15:4507。DOI:10.1038/s41467-024-48909-7。2023年12月6日收稿,2024年5月15日接收,2024年5月27日在线发表;所据 PDF 页脚标明为 2024 年更正后的版本。这是一项观察研究,并用一个模拟模型讨论可能的生成机制。
设想一座城市的中央商务区从市中心挪到边缘。若只保留一张地点对地点的流量表,地点编号之间的数字可以看起来几乎没变;把箭头画回地图,原本指向旧中心的早高峰会整片转向新位置。论文用这个设想说明:人类移动性(human mobility,人在空间中的移动)若只看成起讫流量,会漏掉空间方向性(spatial directionality),也就是流量在各个地理方向上是否均衡、以及是否朝向市中心。这是思想实验,论文没有观测一次真实的商务区搬迁。
他们用约 9000 万手机用户、60 座中国大城市在 2019 年 8 月和 11 月的聚合出行,把每个起点的流出收成一个向量,再做成两个 0 到 1 的城市指标:各向异性(anisotropy)和向心性(centripetality)。早高峰 7:00–7:59 上,城市分成强单中心、弱单中心和多中心。单中心城市的平均直线通勤距离随建成区面积和人口上升;多中心城市的这组相关没有达到显著。
先说结论
- 60 座城市在早高峰流出加权后的各向异性–向心性平面上分成三类:强单中心 36 座,弱单中心 13 座,多中心 11 座。比较单位是城市,分母是这 60 座城市。
- 平均通勤直线距离对建成区面积的对数拟合:强单中心 R² = 0.87(系数 a = 3.67,P = 8.91×10⁻¹⁷,36 座城市),弱单中心 R² = 0.80(a = 2.86,P = 3.52×10⁻⁵,13 座),多中心 R² = 0.17(a = 0.87,P = 0.21,11 座)。对人口,多中心同样不显著(R² = 0.22,P = 0.15)。
- 按出发总量相等划成五圈后,各向异性向外增大,正文给出的增幅为强单中心 80.3%、弱单中心 75.5%、多中心 40.5%。向心性的降幅为 2.1%、13.2% 和 22.1%。正文没有印出用来计算这些百分数的两个圈层均值。
- 4–8 时向心性的升幅为强单中心 23.6%、弱单中心 22%、多中心 15.4%。同期各向异性在强单中心上升,弱单中心较稳,多中心下降。9–17 时三类城市的方向指标都较平稳。
- 随机职住选择模型里,就业吸引强度 α 和通勤距离尺度 β 同时较大时,模拟向量又长又朝向中心;一组标出的小参数例子主要是向心性更低。该模型是 100 次模拟的均值,没有报告与这 60 座城市的拟合误差。
同一张流量表,为什么换一张地图方向就变了?
以往的城市流动指标多半读起讫矩阵里的数字。热点流量矩阵比较居住热点和工作热点之间的流量比例;流动层级比较热点排序相近的地点之间流了多少。这些都是非空间方向性(non-spatial directionality):它知道 A 流向 C,不知道这支箭头在地图上朝北还是朝市中心。人口分布、就业分布和道路形态研究的是另一套空间结构,也不直接回答早高峰箭头的朝向。
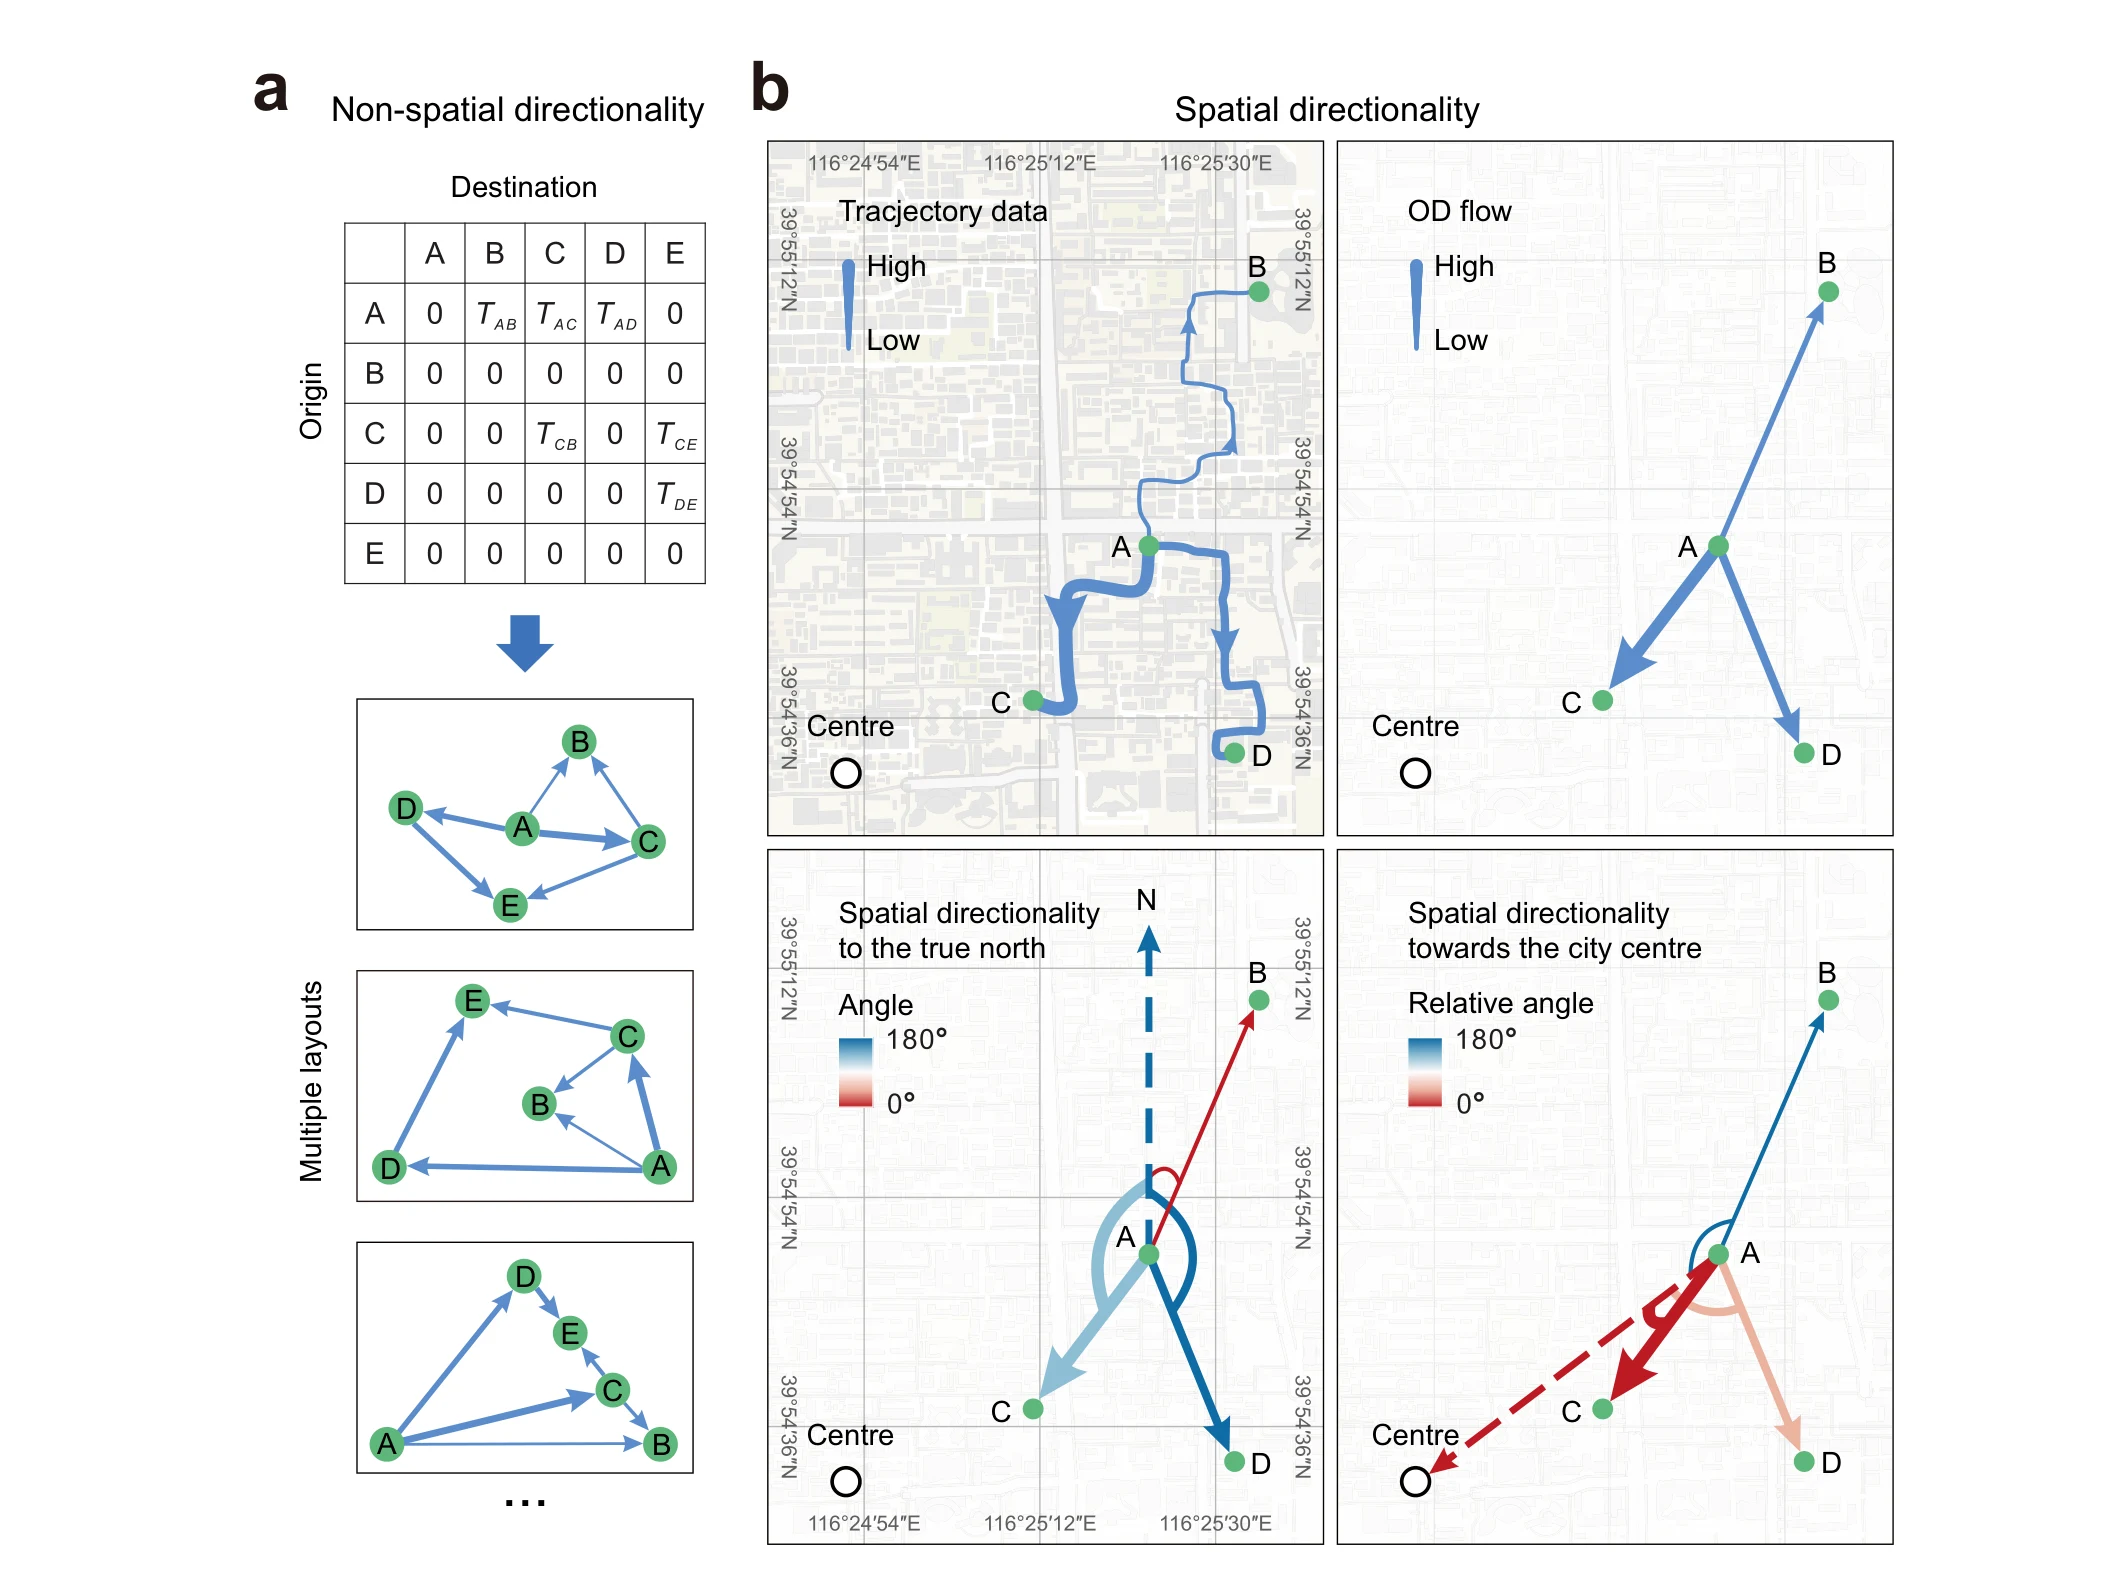
图 1|只有流量表时,箭头在地图上可以怎么摆?
(a)地点 A 到 E 的起讫矩阵,以及同一组数字可以摆成的多种布局。矩阵给出谁流向谁,摆法一变,地理方向就变。(b)左上为轨迹示意,颜色表示相对高低;右上为起讫箭头,线的粗细表示流量。左下按与正北的夹角着色,红接近正北、蓝接近相反方向,A→C 与 A→D 颜色接近,表示两支流近乎平行。右下按与市中心方向的夹角着色,A→C 比 A→B 更朝向中心。来源:原论文 Fig. 1。
因此后面的计算要同时保留流量大小和地理方向。图 1 是示意,坐标约在北纬 39.9°、东经 116.4°附近,用来说明定义,其中的箭头厚度不是 60 座城市的统计结果。
一个起点上的许多箭头,怎样收成两个 0 到 1 的数?
数据来自一家中国电信运营商的聚合、匿名记录,覆盖 60 座城市、约 9000 万居民。匿名用户数平均为这 60 座城市总人口的 18%,论文说这与手机用户占人口的比例相当。18% 是 60 座城市的平均份额,每座城市的份额可以不同。原始格子为 0.005°,大约 0.5 公里见方,分析前合并到约 1 公里见方。记录是 2019 年 8 月和 11 月每个小时、格子之间的出行次数,没有个人轨迹。时间上先取周二到周四共 25 个典型工作日,再对每个小时的格子流量取平均。
城市范围不用行政区。论文采用全球人类住区数据:连片区域的人口密度至少为每平方公里 1500 人,或大部分为建成区且人口至少 5 万人。随后只统计从这些城市范围内出发的流量。行政区外、密度不够的地区不进入城市一级的加权平均,因为那些地区在城内和城际都更杂。
分类和通勤距离用的是 7:00–7:59 的平均流量。论文把这一小时当作典型早高峰,并认为它反映居住地与工作地之间的联系。原始记录是该小时的全部格子间出行,方法部分没有逐趟标注家到单位。下文的通勤距离,指的是这一小时、城市范围内出行的直线距离加权平均。
每个起点先把流出变成向量。平面以经线为 y 轴、正北为正方向。从 i 到 j 的流量 Tᵢⱼ 除以 i 的总流出 Oᵢ,再乘上从 i 指向 j 的单位向量。总流出 Oᵢ = Σⱼ≠ᵢ Tᵢⱼ,格子内部的出行不进入这个向量。相加之后得到人口流动向量(population mobility vector,PMV):
T⃗ᵢ = Σⱼ≠ᵢ (Tᵢⱼ / Oᵢ) u⃗ᵢⱼ
除以 Oᵢ,是为了让出发量大的格子在比方向时,先按自己的流出比例说话。向量长度 λᵢ 在 0 到 1 之间:各方向对称抵消时为 0,全部流出指向同一方向时为 1。论文把 λᵢ 称为该地点流出的各向异性。城市各向异性是用出发量加权的平均:
Λ = Σᵢ Oᵢ λᵢ / Σᵢ Oᵢ
分母是进入分析的全部出发量。Λ 高,表示许多起点的流出都挤在各自的某一个方向上。
方向要有共同参照。论文用最大向心性算法(maximum centripetality algorithm)选市中心:逐个尝试格子,取使全市向心性最大的那个位置。多中心城市仍只保留这一个主中心,论文认为它是多个中心中对全市流量影响最大的一个。地点 i 的相对角 θᵢ 是 T⃗ᵢ 与从 i 指向该中心的单位向量之间的夹角,范围 0 到 π;朝向中心为 0,背向中心为 π。地点向心性 γᵢ = 1 − θᵢ/π,再按出发量加权得到城市向心性 Γ,公式与 Λ 相同,只是把 λᵢ 换成 γᵢ。Γ 接近 1,表示加权后的流出整体朝向这个主中心。夹角公式的分母含有向量长度;长度为 0 时方向没有定义,正文没有说明这种格子如何计入 Γ。
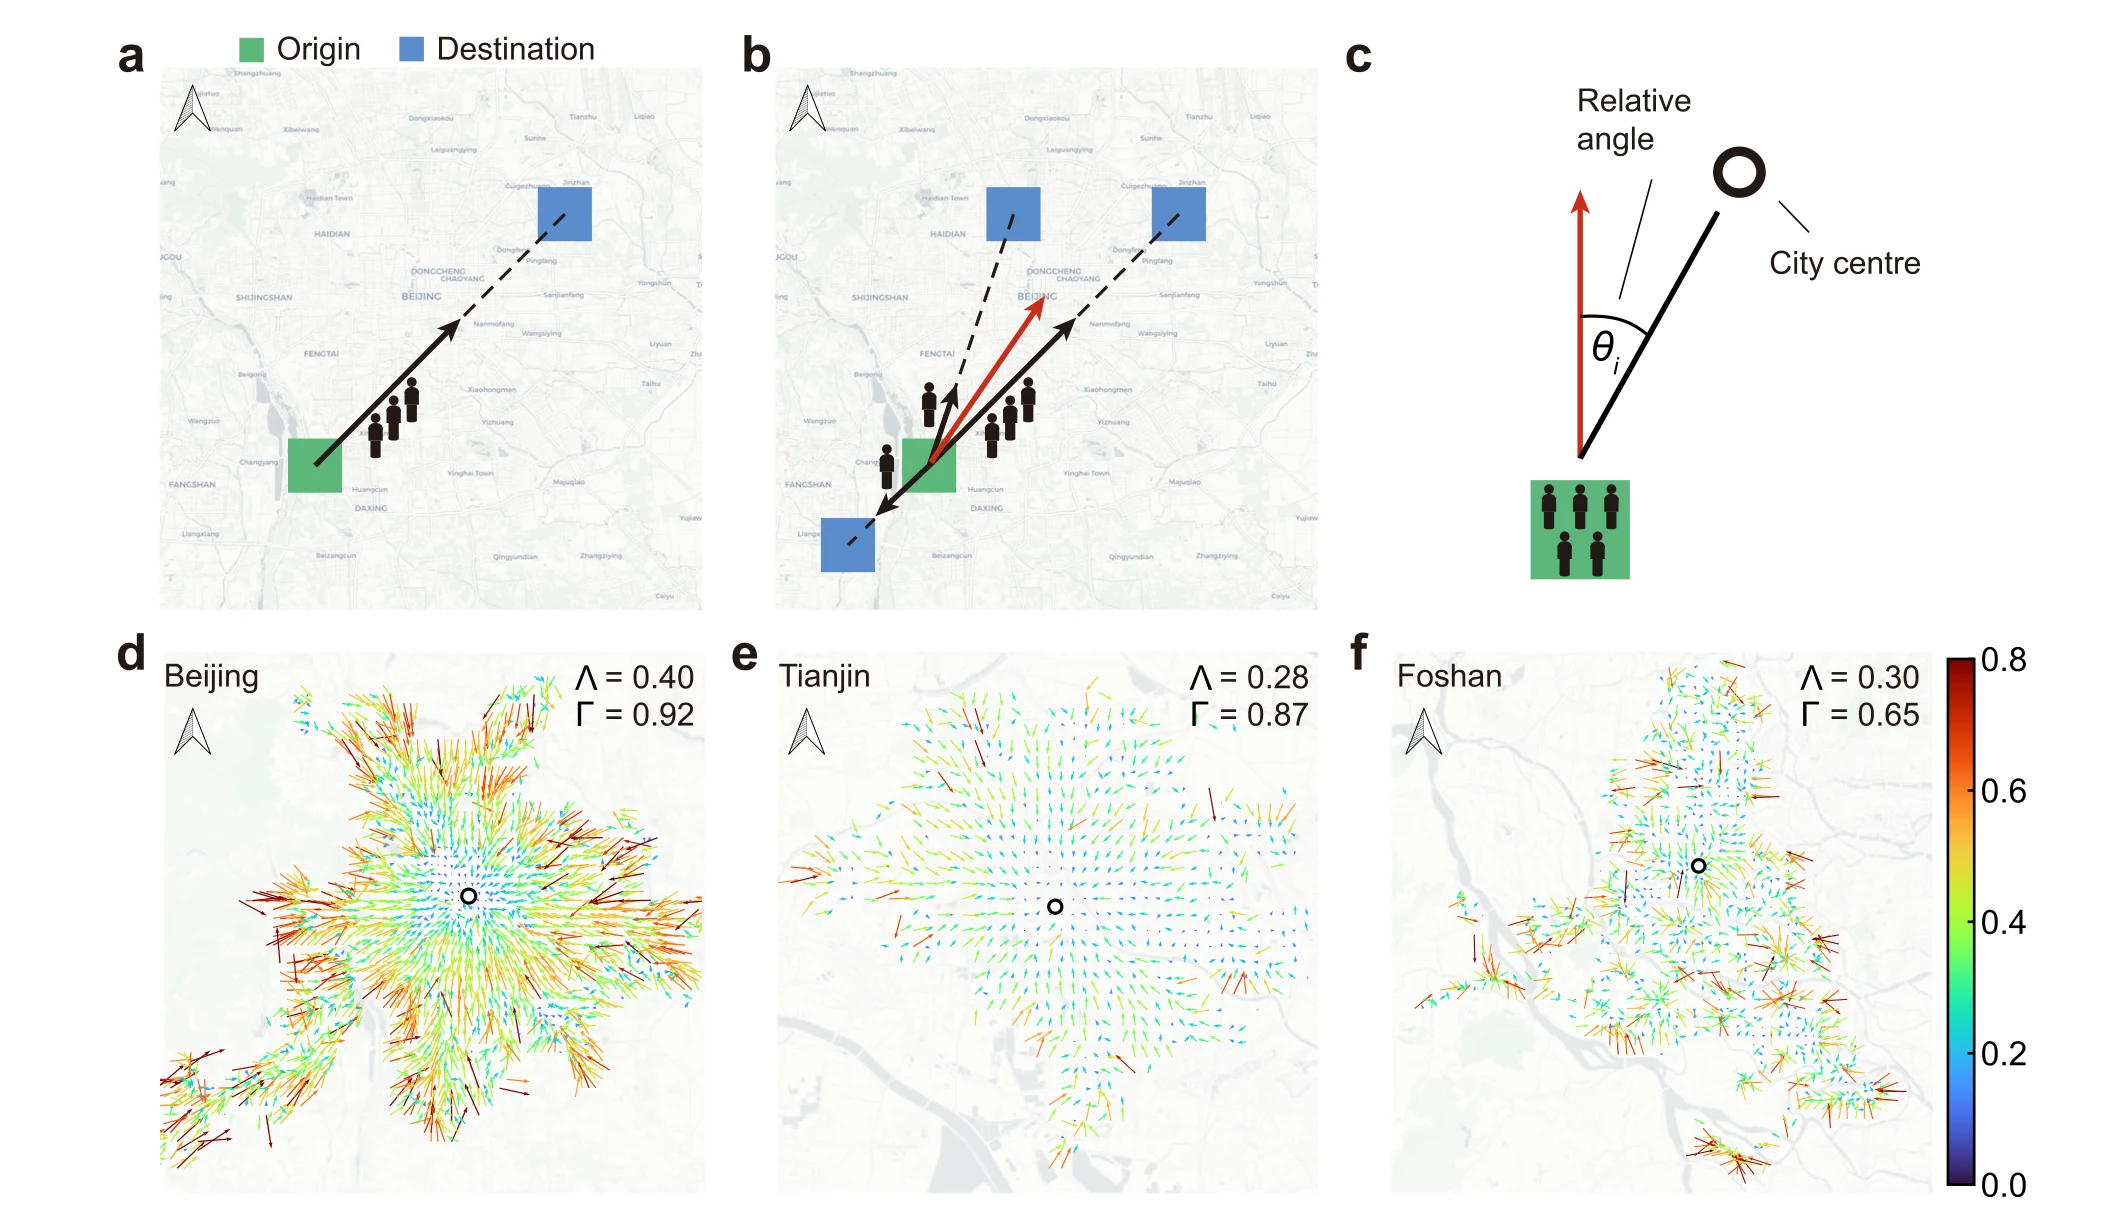
图 2|从一个起点的流量,到三座城市的早高峰向量场
(a)绿为起点、蓝为终点,黑箭头的方向沿起点到终点,长度是该流量占该起点总流出的比例。(b)同一起点的多支箭头相加,红箭头为人口流动向量。(c)θᵢ 是该向量与指向市中心方向的夹角。(d)北京,Λ = 0.40,Γ = 0.92。(e)天津,Λ = 0.28,Γ = 0.87。(f)佛山,Λ = 0.30,Γ = 0.65。三张地图中白点为算法选出的市中心,箭头长短和颜色表示向量长度,色标标到 0.8。来源:原论文 Fig. 2。
按论文的读法,北京是高各向异性、高向心性的单中心流动;佛山两者都较低,对应多中心;天津各向异性低、向心性仍高,处于过渡。这三个数都是 7:00–7:59、出发量加权后的城市值。向量场是粗化结果:它保留方向上的不平衡和是否朝向主中心,不再展开每一对格子的流量。
60 座城市为什么分成三种?
把每座城市画成各向异性–向心性平面上的一个点,再用层次聚类分成三支。稳健性检验写在补充说明中,正文的结论是:换多种聚类方式、以及层次聚类里的距离定义,三分结果仍然成立。
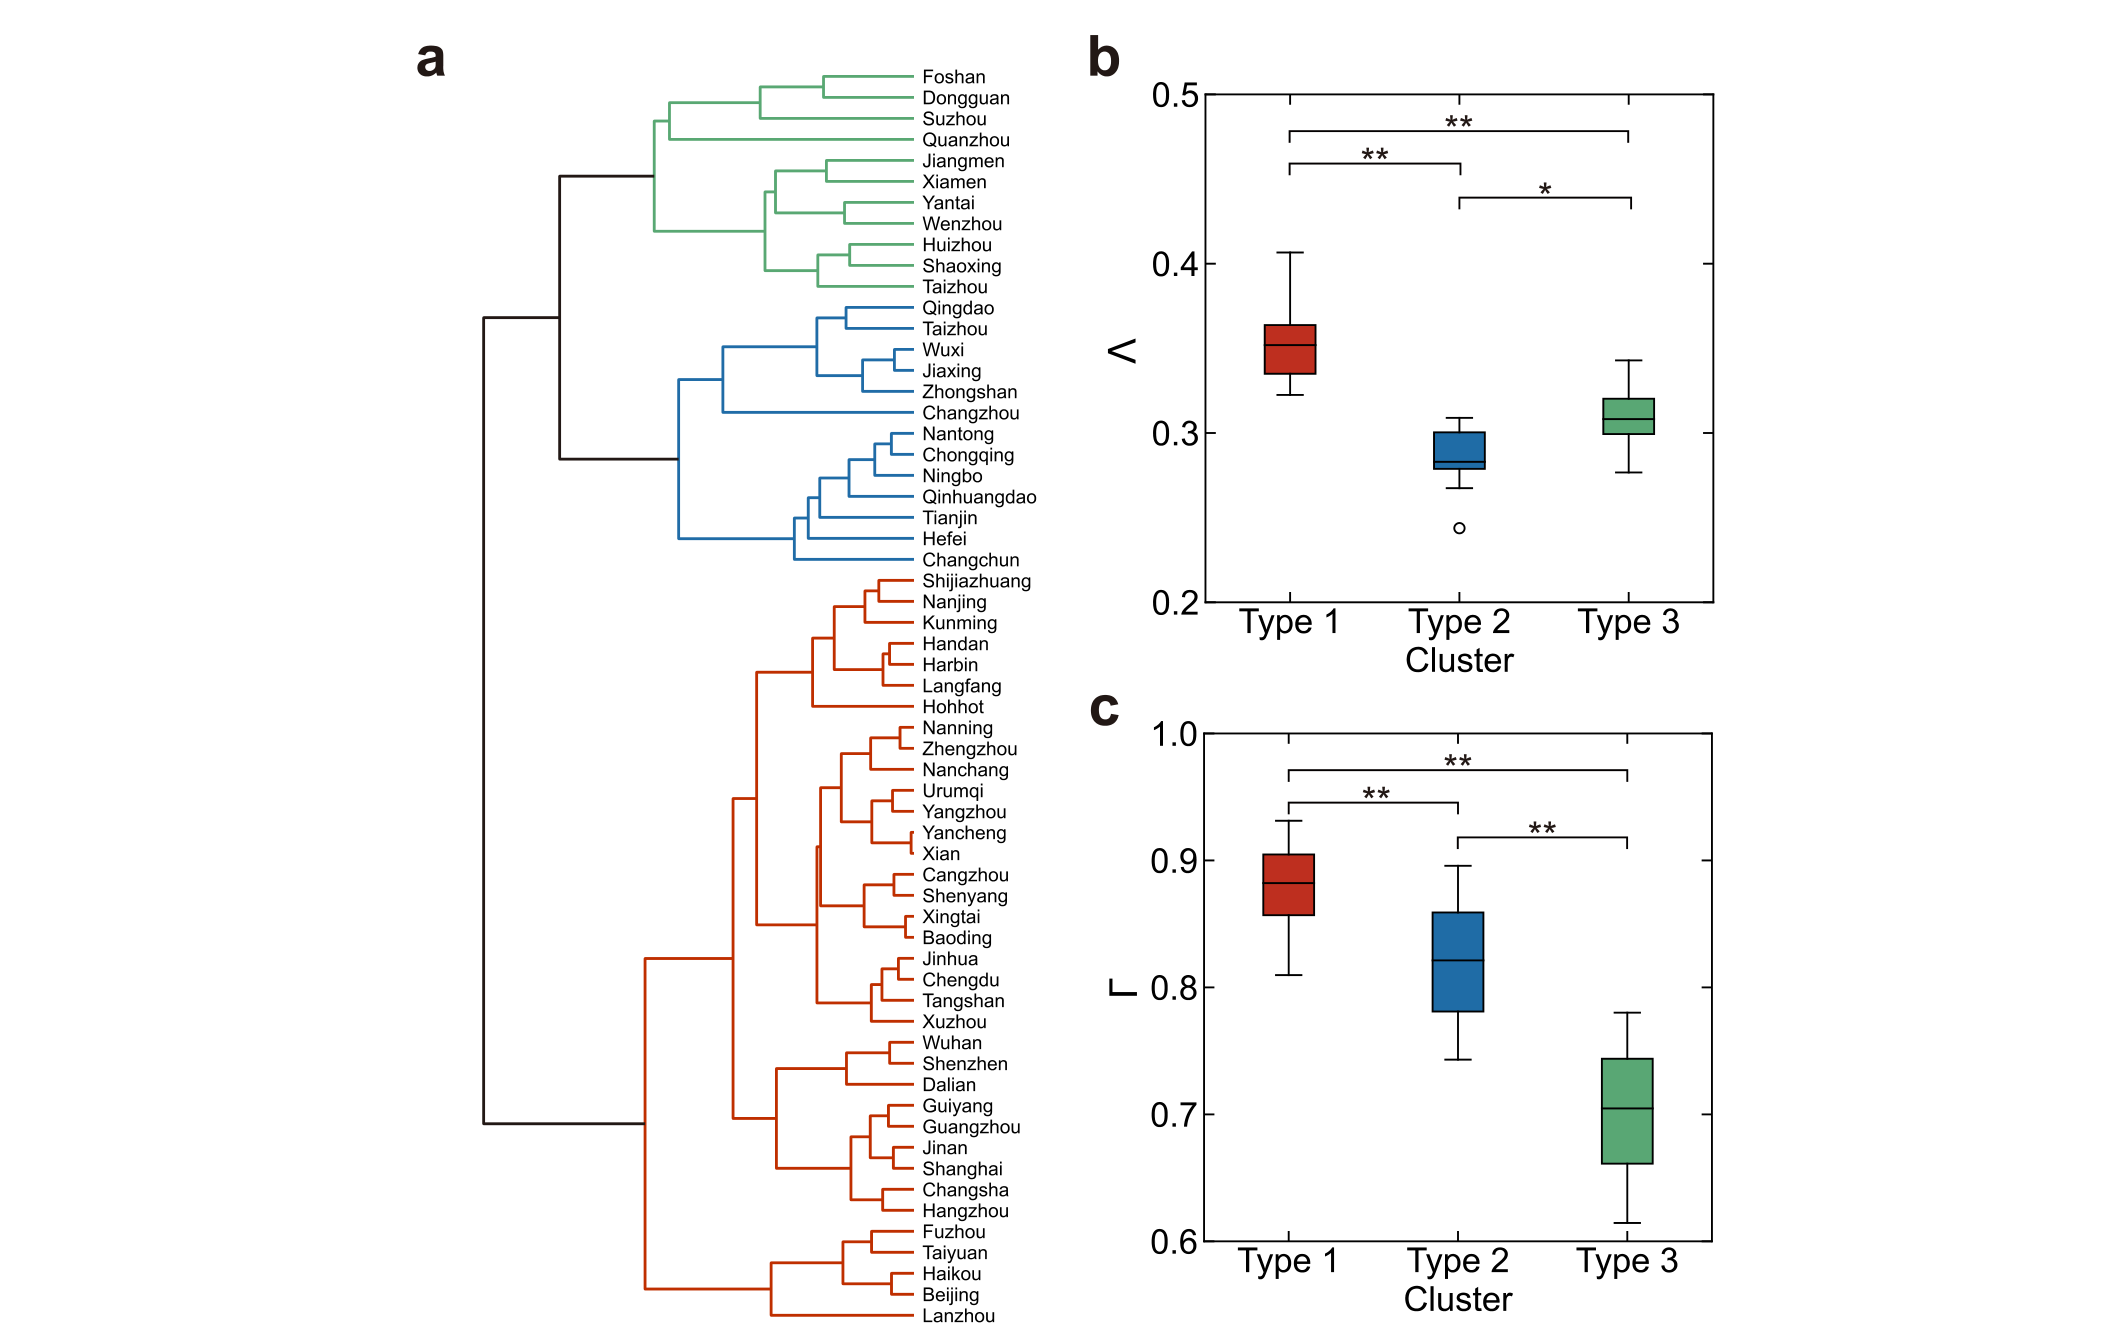
图 3|三类城市在两个指标上是否分开?
(a)60 座城市的层次聚类树。红色为强单中心,36 座;蓝色为弱单中心,13 座;绿色为多中心,11 座。(b)各向异性。双侧 t 检验并经 Bonferroni 校正:第 1 与第 2 类 P = 9.43×10⁻¹³,第 2 与第 3 类 P = 0.003,第 1 与第 3 类 P = 7.96×10⁻⁷。(c)向心性,对应 P 为 2.40×10⁻⁵、4.70×10⁻⁶ 和 2.60×10⁻¹⁷。箱线中间为中位数,箱体为第 25 与第 75 百分位,须线延伸到 1.5 倍四分位距内的最远点,圆点是更极端的城市。来源:原论文 Fig. 3。
这三组 P 值的样本是 36、13、11 座城市的城市级指标,检验的是类与类的均值差。强单中心两个指标都高:论文将其对应为有主导的中心就业区、郊区居住,早高峰沿放射方向进城。多中心两个指标都低:居住与工作混在多个片区,方向更分散,也更少指向那一个主中心。弱单中心各向异性低、向心性高:郊区已经有较均衡的职住,方向不如强单中心那样挤在少数放射走廊上,中心仍然吸引向内的通勤。图 2 的北京、天津、佛山分别被论文用作这三种方向形态的例子。树状图上的城市名单以图 3 为准;某一座城市落在哪一支,还同时取决于两个指标的距离,不能只凭市辖区人口猜测。
向心性默认存在一个可识别的主中心。对多中心城市,低 Γ 表示流量较少指向算法选出的那一个主中心,仍然可以在各个副中心内部很有方向。后面的小时变化会回到这一点。
城市变大,早高峰直线距离一定变长吗?
平均通勤距离 D 用起点和终点坐标的欧氏距离,也就是地图上的直线距离。对一座城市,
D = Σᵢⱼ Tᵢⱼ dᵢⱼ / Σᵢⱼ Tᵢⱼ
i、j 都在提取出的城市范围内,dᵢⱼ 是两格之间的直线距离。分母是 7:00–7:59 这些出行的次数之和,分子是每趟出行的直线距离乘以次数。它衡量这一小时出行端点的直线分离,沿路里程、耗时和油耗都还没有放进公式。论文同时用城市建成区面积 A 和城市人口 N 表示城市规模。图中实线是对数拟合,写成 D ∼ log(Aᵃ) 或 D ∼ log(Nᵇ)。系数印在图上;直线还有截距,截距没有印出。因此 a、b 用来比较上升有多快,不能直接换成“面积每增加 1 平方公里,距离增加 a 公里”。
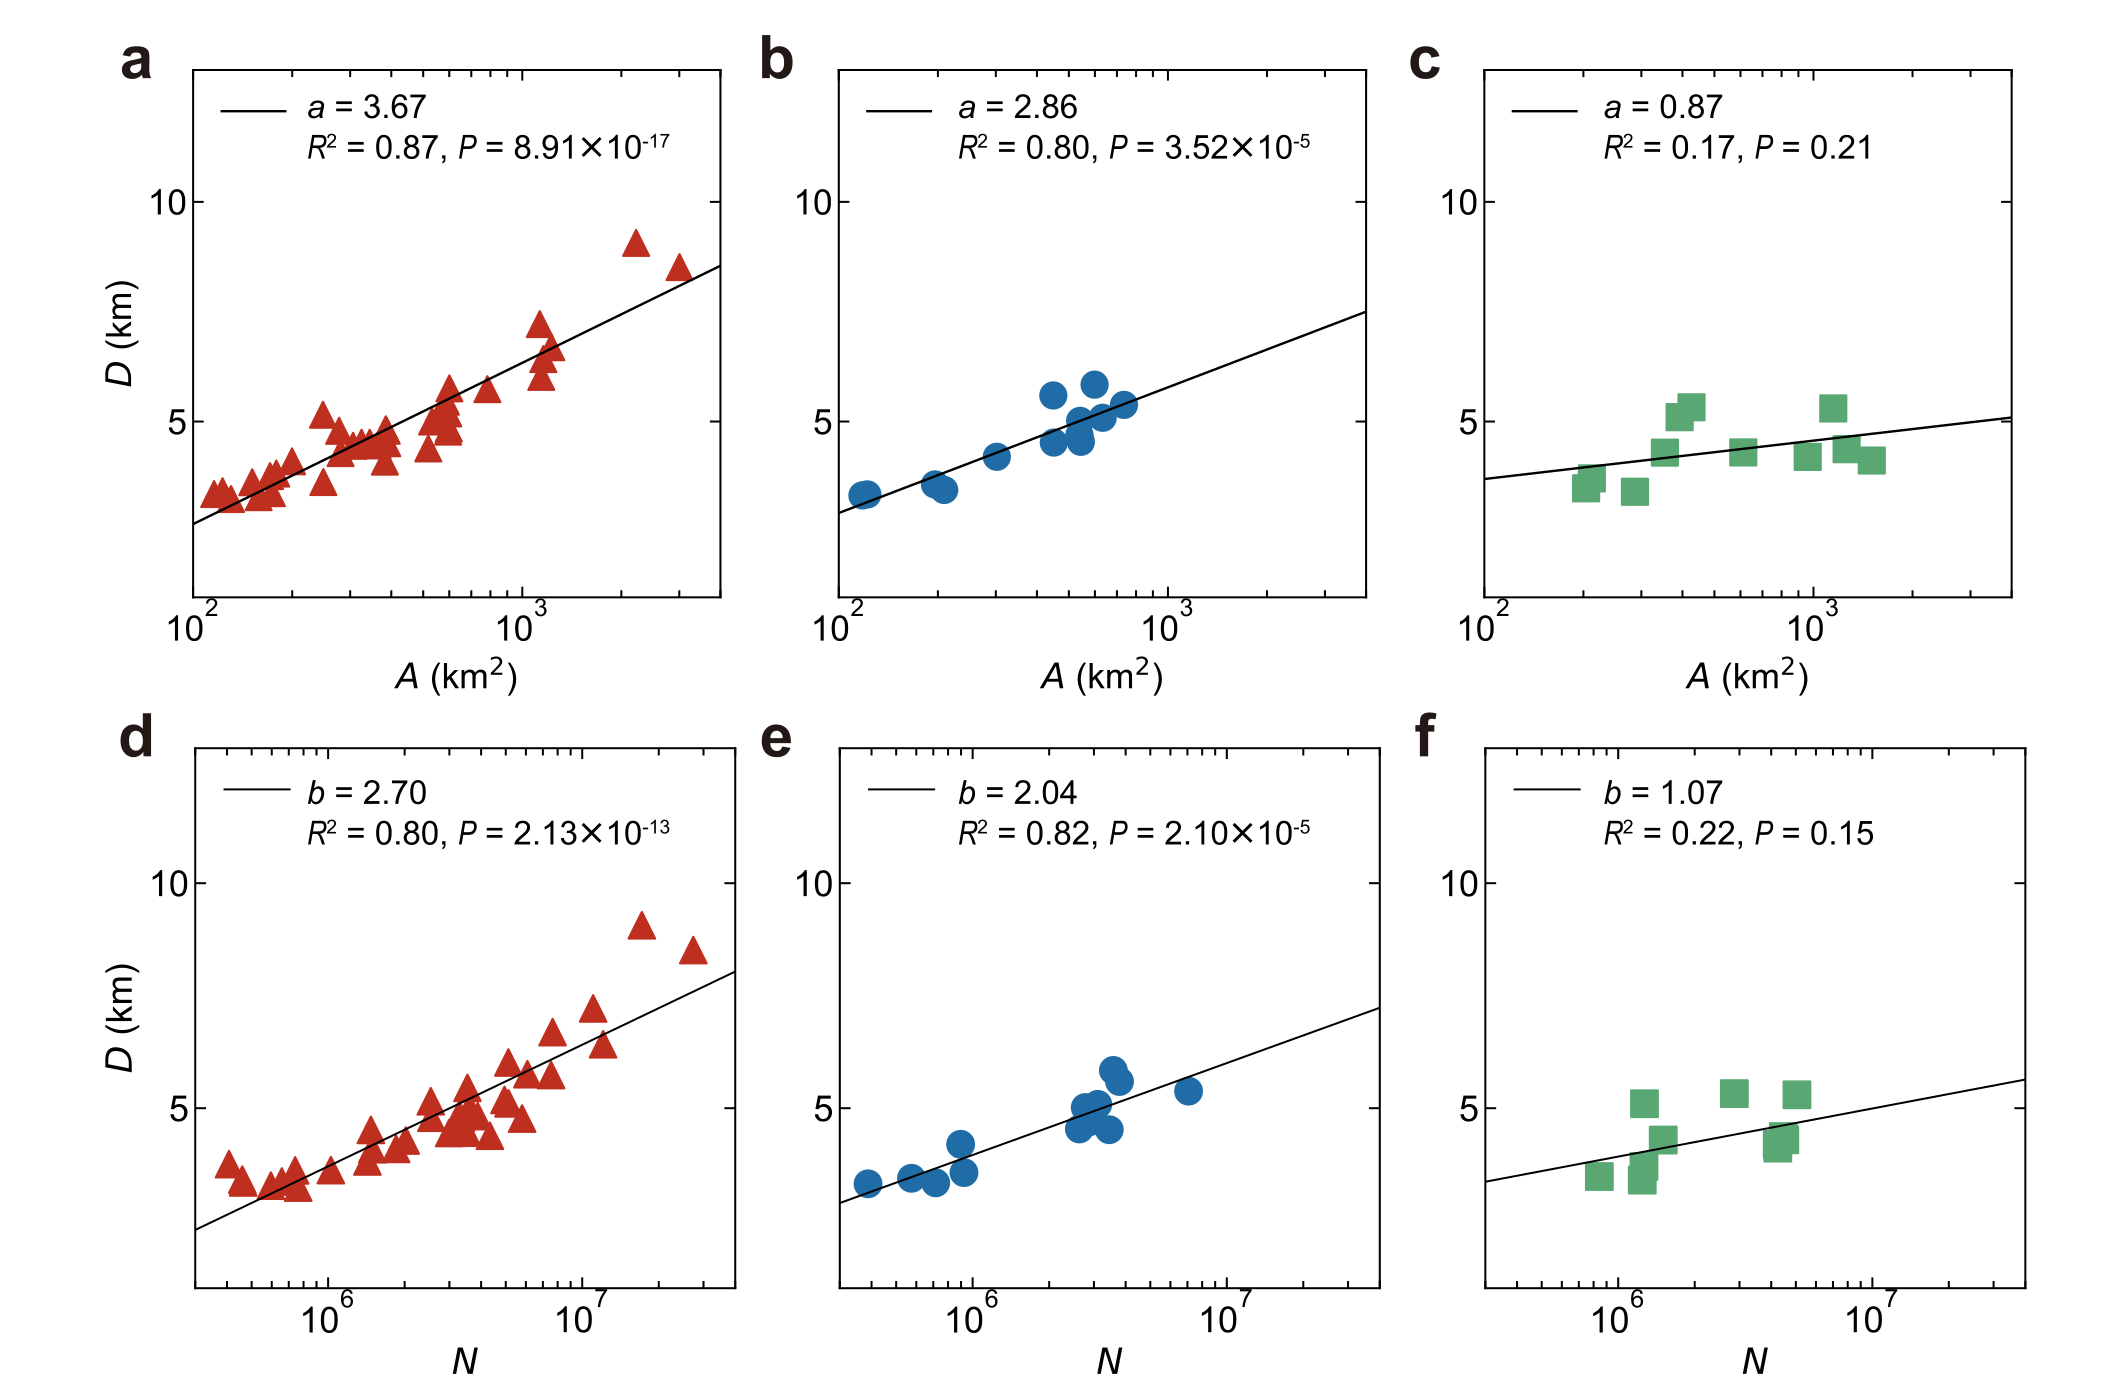
图 4|平均直线通勤距离怎样随城市面积和人口变化?
每个点是一座城市。纵轴 D,单位公里;横轴为对数坐标。(a)强单中心对面积,a = 3.67,R² = 0.87,P = 8.91×10⁻¹⁷,36 座城市。(b)弱单中心对面积,a = 2.86,R² = 0.80,P = 3.52×10⁻⁵,13 座城市。(c)多中心对面积,a = 0.87,R² = 0.17,P = 0.21,11 座城市。(d)强单中心对人口,b = 2.70,R² = 0.80,P = 2.13×10⁻¹³,仍是 36 座城市。(e)弱单中心对人口,b = 2.04,R² = 0.82,P = 2.10×10⁻⁵,13 座城市。(f)多中心对人口,b = 1.07,R² = 0.22,P = 0.15,11 座城市。P 来自线性回归 t 检验,原假设是斜率为 0。来源:原论文 Fig. 4。
R² 的分母是该类城市之间 D 的方差:强单中心有 87% 的城市间距离差异与面积的对数拟合相符,多中心只有 17%。面积上,强单中心的系数 3.67 大于弱单中心的 2.86,与正文所说强单中心升得更快一致。多中心的两个 P 值都大于常用的 0.05 门槛。在这 11 座城市里,看不出 D 随面积或人口的斜率异于 0;样本只有 11 个点,这个结果的含义是现有数据没有显示出那条上升关系。
论文对形态的解释是:单中心城市多由中心就业区向外摊开,居住区外扩、工作地仍留在原处,所以面积越大,早高峰直线距离越长。多中心城市常由多个聚落并成,居住和工作混布,城市变大时平均直线距离保持在相近范围。这是结合方向分类之后的解读。图 4 本身是城市之间的横截面相关,每座城市只有 2019 年这两个月的一个距离值,不能从这张图单独证明某座城市在历史上因为扩张而变长。
从核心走到外围,两个指标一起变吗?
城市尺度的 Λ 和 Γ 还看不出核心与外围的差别。论文参照 Bertaud 和 Malpezzi 的圈层想法,以主中心为圆心划分 l = 5 个圈。中国许多城市有五环道路,但这里的五圈也用在没有五条环路的城市上。分圈标准是出行发生量相等:每一圈所含格子的出发总量相同,圈的面积可以差很多。正文称 l 取别的数值时结果仍然稳健,该项比较在补充说明中。
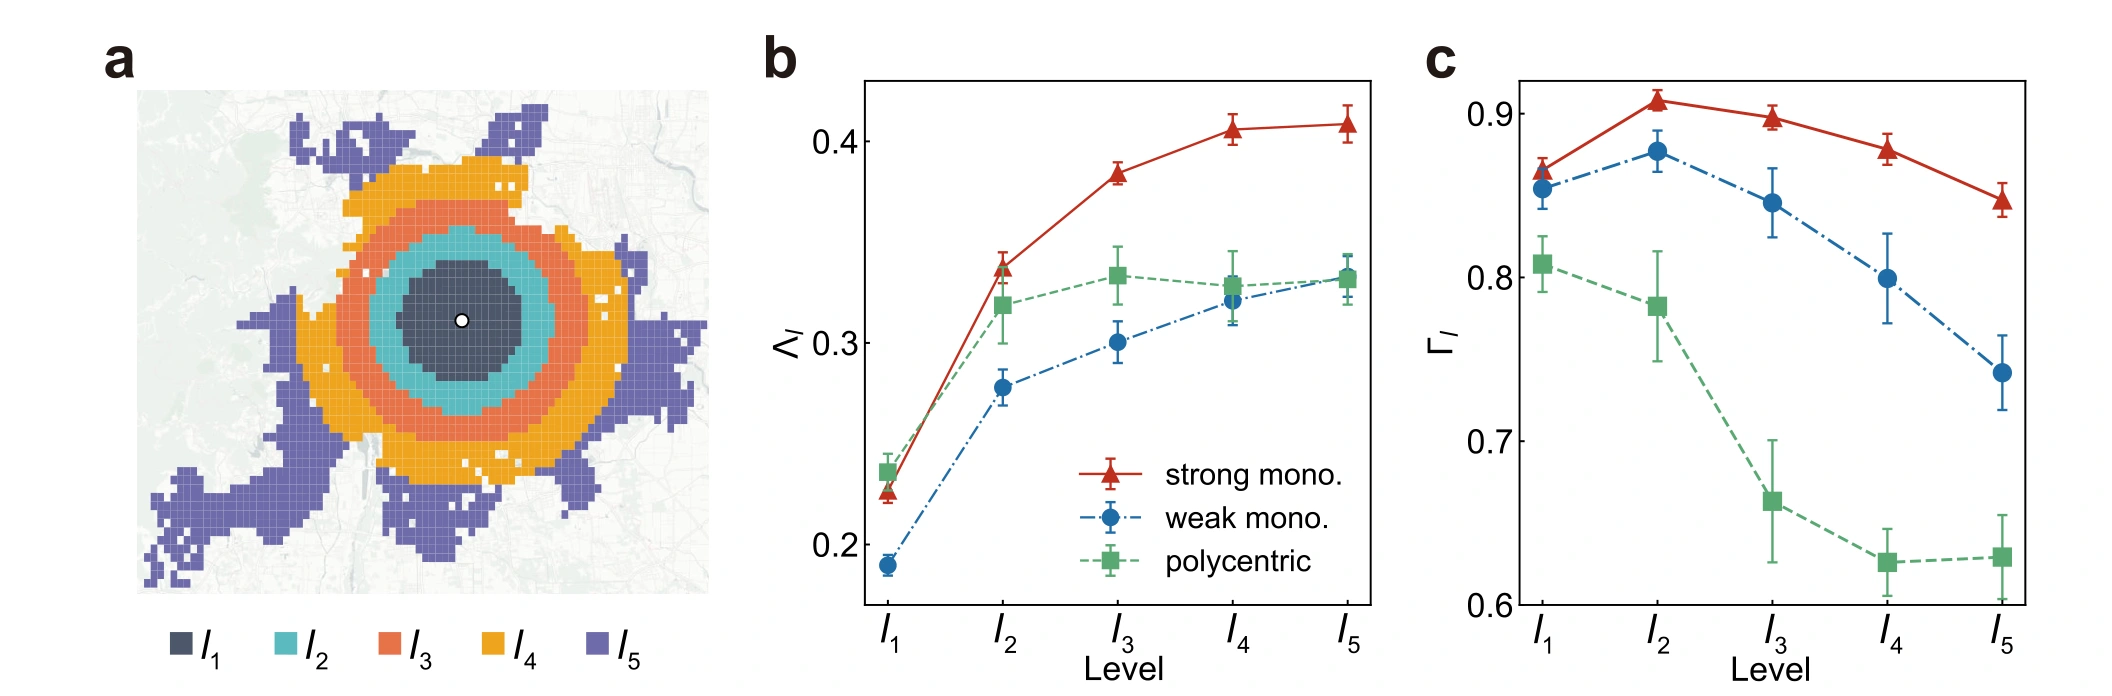
图 5|从内圈到外圈,各向异性和向心性怎样变?
(a)以北京示意五圈。颜色从内到外为 l₁ 到 l₅,各圈出发总量相等,中心白点为市中心。(b)三类城市各圈的各向异性均值,误差线为标准误;红为强单中心(36 座),蓝为弱单中心(13 座),绿为多中心(11 座)。三条线都向外上升,多中心在 l₂ 之后趋于平缓。(c)各圈向心性。两类单中心在 l₂ 高于 l₁,再向外下降;多中心从内圈向外下降更明显。来源:原论文 Fig. 5。
各向异性在三类城市都随圈层上升。正文给出的增幅是强单中心 80.3%、弱单中心 75.5%、多中心 40.5%。论文的解释是:核心区各个方向都有岗位,流出不容易挤进单一方向;强单中心外围的岗位方向最不均衡,多中心在 l₂ 以外已经比较均匀。图上能看出多中心的曲线在第二圈后变平,强单中心升到外围更高的位置。80.3% 这些百分数的起止圈层均值没有印在正文里,这里只保留论文给出的增幅。
向心性整体上外围低于核心,降幅为强单中心 2.1%、弱单中心 13.2%、多中心 22.1%。图 5c 同时显示,两类单中心在最内圈低于第二圈。论文的解释是:这两类城市的主要就业中心就在 l₁ 里,住在最内圈的人可以选择的工作地方向更多,朝向“市中心”这一个点的程度反而较低。多中心的下降更陡,外围流量更少汇向那个主中心。误差线是城市之间的标准误,强单中心的城市数是多中心的三倍以上,线的长短不能直接读成某一圈内部格子的波动。
一天之中,哪几个小时把三类城市分开?
圈层分析仍固定在早高峰。把 25 个工作日的平均流量按小时重算 Λ 和 Γ,可以看到指标在一天内的轨迹。点的大小表示该小时出行发生量的相对高低,图上没有给出每小时的绝对人次。
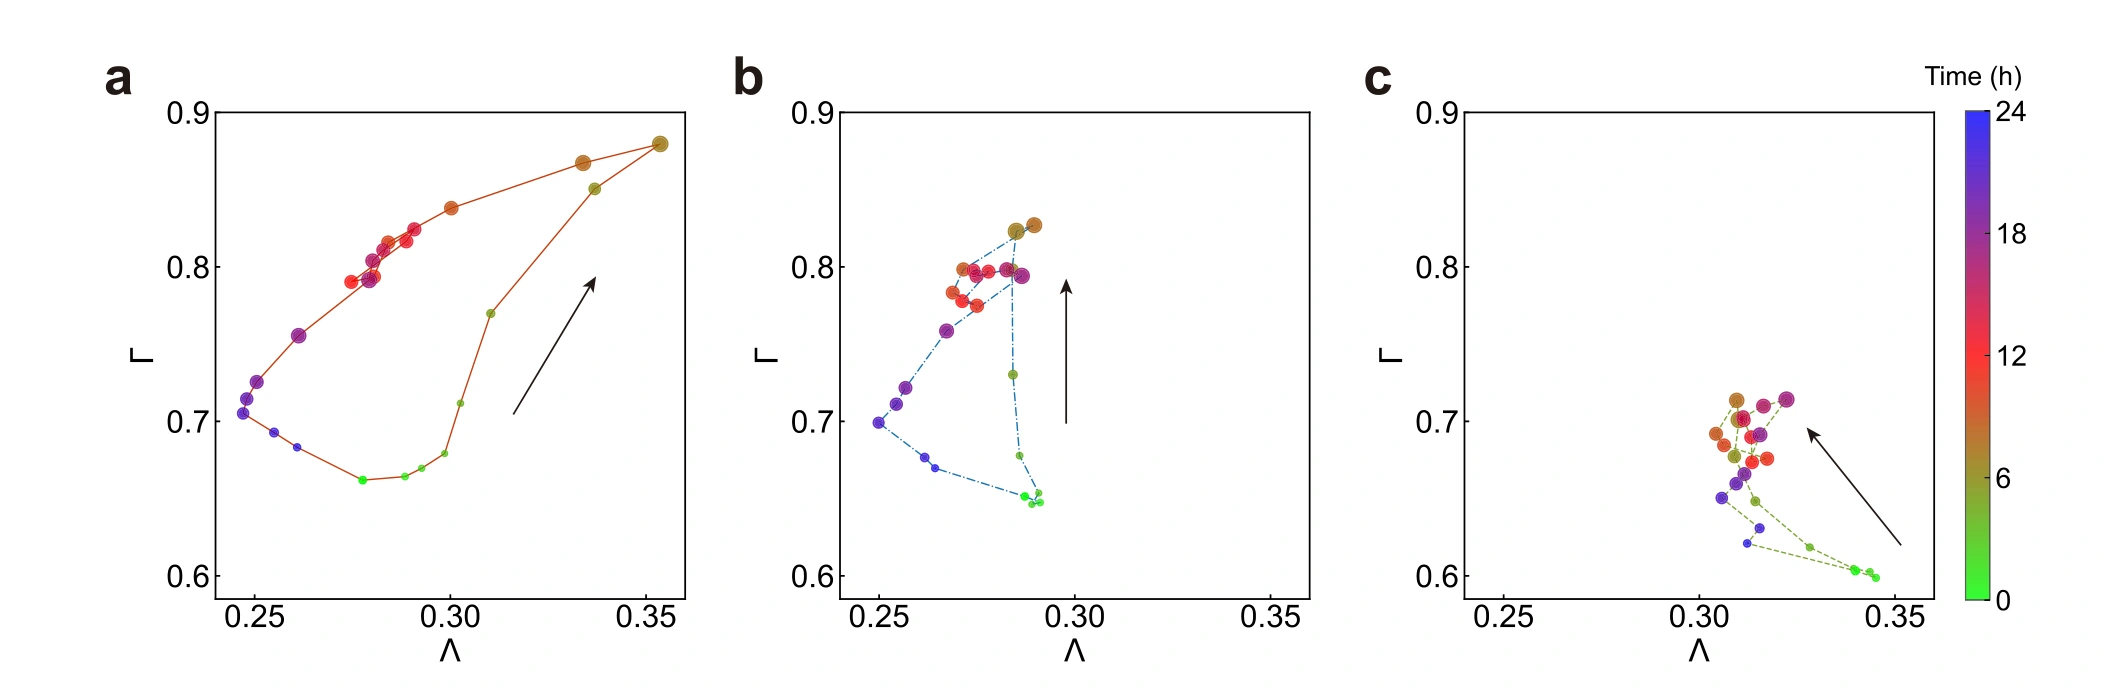
图 6|各向异性和向心性在 24 小时里怎样走?
(a)强单中心,36 座城市的小时平均。(b)弱单中心,13 座。(c)多中心,11 座。横轴为各向异性,纵轴为向心性;颜色表示小时,绿和蓝靠近深夜与清晨,黄和红靠近中午;点越大,该小时的出行发生量相对越高。来源:原论文 Fig. 6。
9–23 时,两类单中心的轨迹相近,并在 4–8 时明显分开;多中心全天的轨迹都更靠右下,各向异性高于弱单中心,向心性更低。9–17 时三个指标组合都少有起伏。18–21 时 Λ 和 Γ 一起下降,对应回家行程:方向更分散,也更少指向主中心。22 时以后各向异性上升、向心性下降,论文将其联系到夜间休闲出行更集中于某些方向、同时离开主中心。
早高峰 4–8 时,正文给出的向心性升幅为强单中心 23.6%、弱单中心 22%、多中心 15.4%;4 时和 8 时各自的向心性没有印出,百分数的前后两个水平因此无法在正文中还原。各向异性只在强单中心随早高峰出行增加而上升;弱单中心基本持平,多中心下降。论文据此认为,强单中心在出行变多时,岗位方向上的不平衡会加重。多中心全天各向异性更高,被解释为多个副中心内部仍有稳定的方向性流动。正文举了佛山均安:早高峰各向异性明显,周围乡村受到商业中心吸引。该例的图在补充材料中,正文没有给出均安单独的 Λ 和 Γ。
同一类城市在非高峰时段的方向变化趋势相近,早高峰才把三类拉开。这支持用 7:00–7:59 做分类,也说明全天平均会把早高峰的差别抹平。小时曲线是 25 个工作日的平均,一周中某一天的偶然封路或大型活动不在这张图里。
岗位越黏在人多的地方,箭头就会朝向中心吗?
前面的三类是观测分类。论文接着用随机职住选择模型(random workplace and residence choice,RWRC)问:怎样的选址规则能长出类似的向量场。空间是 50×50 的格子。第一个人把中心格同时当作工作地和居住地,此后每一步加入一个人。工作地选在 j 的概率正比于 Nⱼ 的 α 次方,Nⱼ 是 j 上居住人口与工作人口之和,用来代理就业机会。α ≥ 0,越大,新的工作越黏在已经活跃的格子上;这是优先连接假设。居住地 i 与工作地 j 不同,被选中的概率正比于 e^(−dᵢⱼ/β),β > 0。β 越大,距离进入指数衰减越慢,人越能住得离工作地远。
模拟人口为 10⁴。α 从 0 到 2,步长 0.1;β 从 0.01 起以 0.1 增加,直到两个指标稳定。每个参数组合做 100 次独立模拟,图上的颜色是这 100 次的均值。
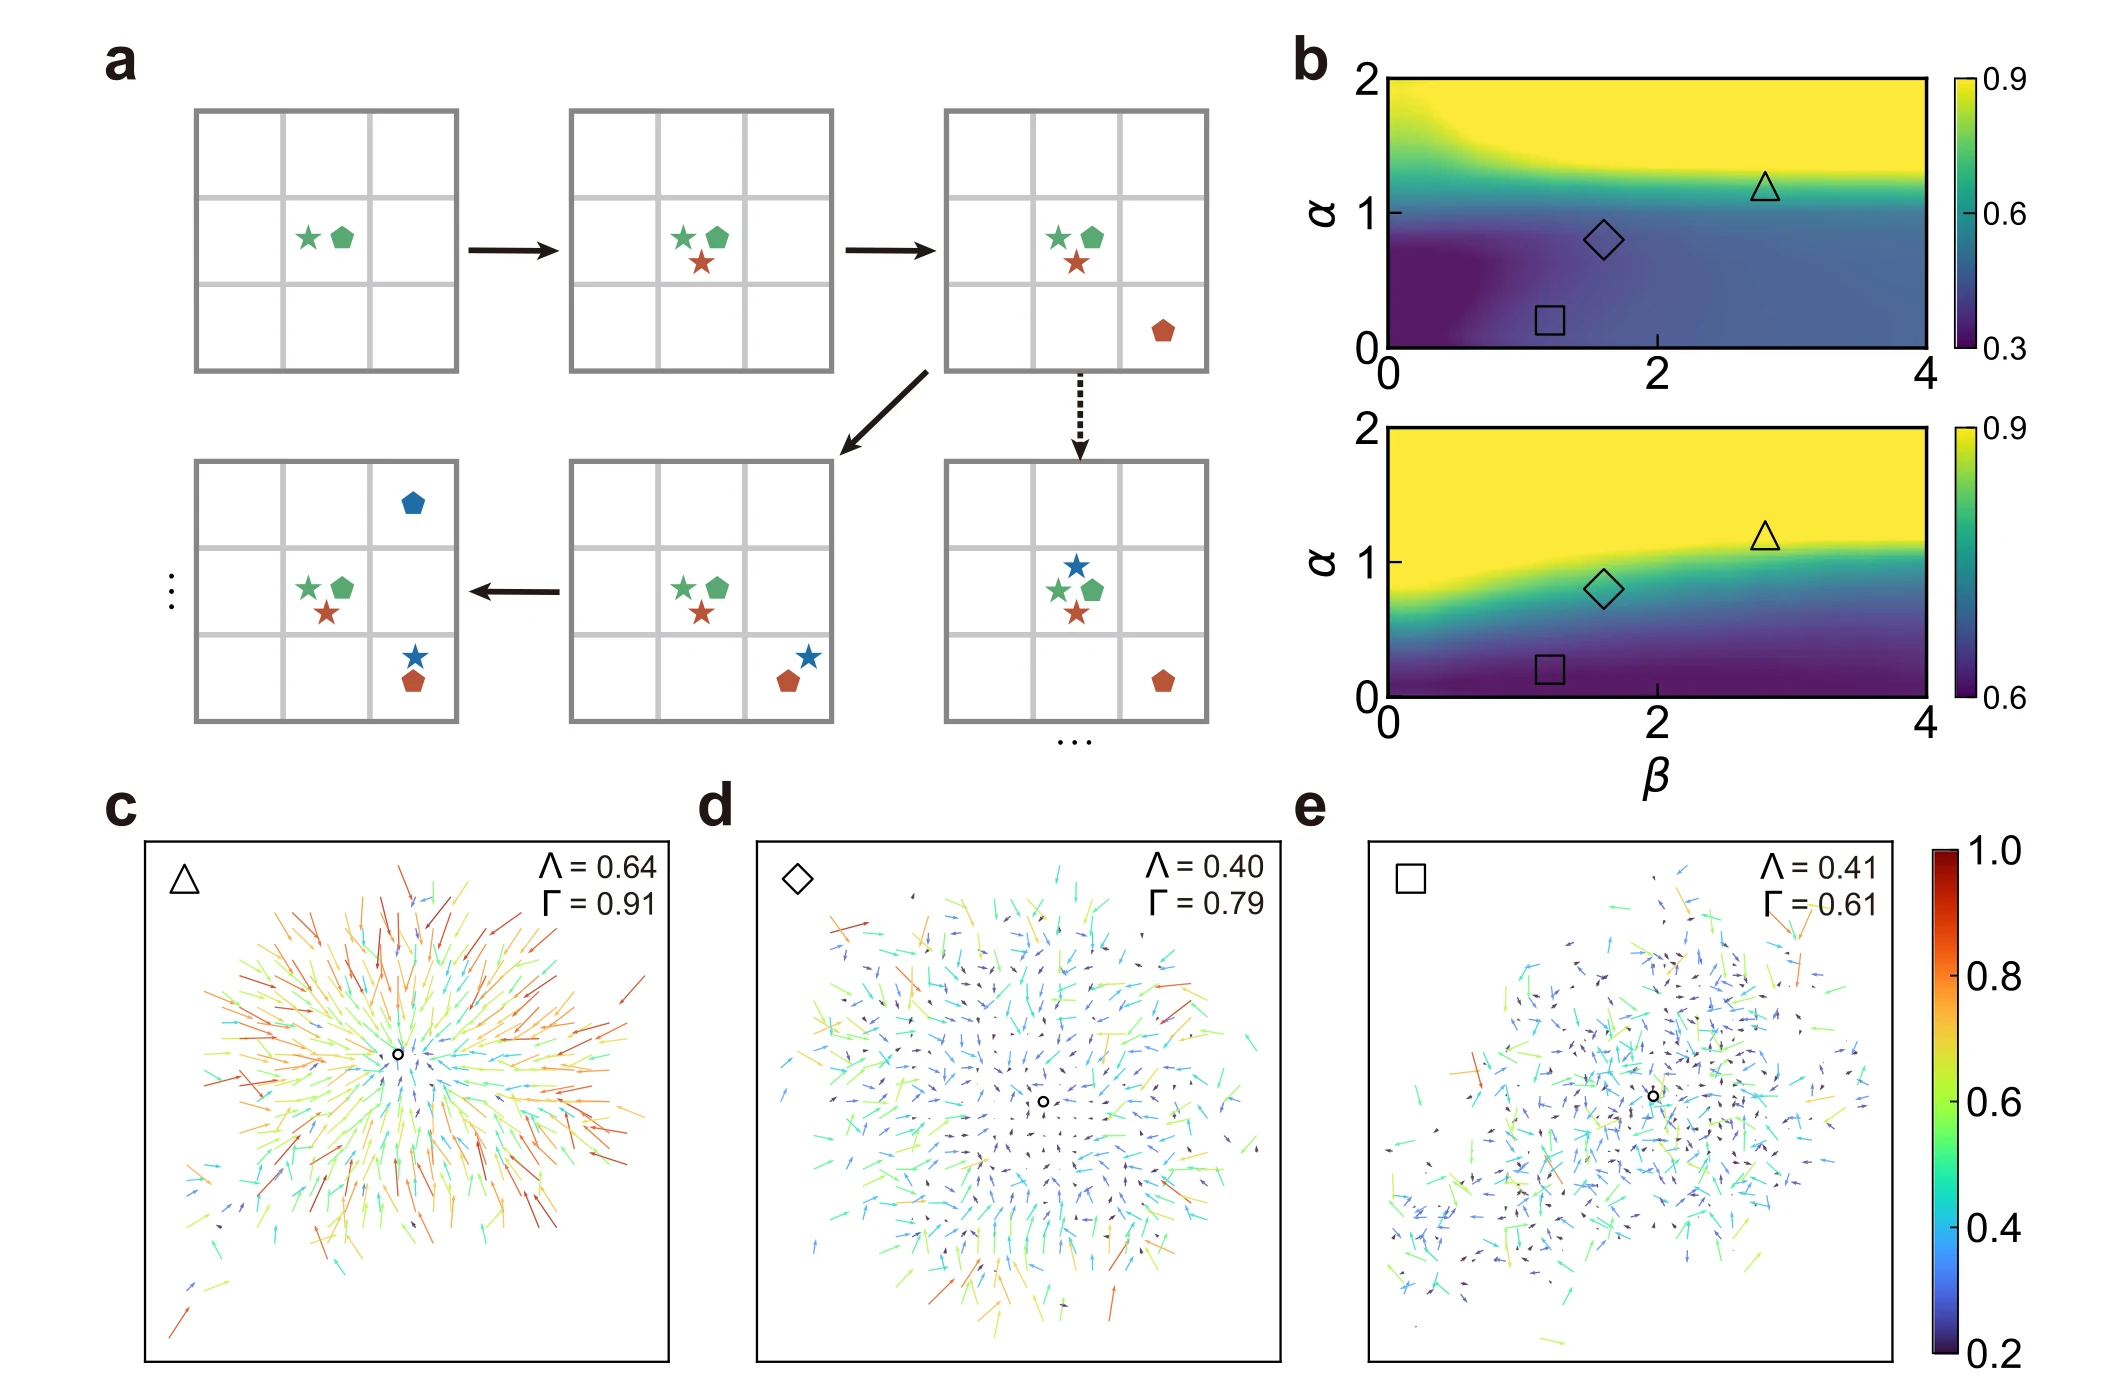
图 7|两个参数怎样改变模拟出来的方向?
(a)模型示意。星为工作地,五边形为居住地。第一个人占用中心格;后来的人按就业吸引和距离衰减选择。实线箭头是一次选中的结果,虚线是另一种可能。(b)上图为各向异性、下图为向心性,颜色是 100 次模拟的均值。三角为 α = 1.2、β = 2.8,菱形为 α = 0.8、β = 1.6,方形为 α = 0.2、β = 1.2。(c)三角情景,Λ = 0.64,Γ = 0.91。(d)菱形情景,Λ = 0.40,Γ = 0.79。(e)方形情景,Λ = 0.41,Γ = 0.61。箭头长短和颜色表示向量长度。来源:原论文 Fig. 7。
α 和 β 都较大时,新增的人更多把工作放在中心、把家放在外围,向量又长又朝向中心,对应强单中心。中等参数对应较低的各向异性和仍较高的向心性。α、β 都较小时,工作地更分散,居住地更靠近工作地。图上标出的方形例子 Λ = 0.41,与菱形的 0.40 几乎相同,差别主要在向心性从 0.79 降到 0.61。所以这一组标定点说明向心性可以分开,不能据此说任意较小的 α、β 都会把各向异性压到明显更低;参数平面的颜色才是 100 次均值的整体分布。
这些模拟数值也和北京的 0.40 与 0.92 不是同一套测量。模型格子、人口和距离单位都由模拟设定。论文的结论是:就业吸引强度和通勤距离尺度的搭配,足以在这个规则下产生三类通勤方向。它把个人选址和城市向量场接上了,同时仍然是一套假设下的生成结果。拥堵、房价和社会经济差异都没有进入概率。模型也没有对 60 座城市估计 α、β,或报告与观测 Λ、Γ 的误差。
这些比较能说到哪一步
方向指标区分的是 2019 年 8 月和 11 月、周二至周四平均之后的聚合流动。60 座城市以直辖市和省会为主,代表的是论文所称经济发展较好的大城市。一个运营商平均 18% 的用户份额,使没有使用该网络的人留在样本外。1 公里格子会把格子内部的短出行从向量中拿掉,因为 Oᵢ 的求和排除了 j = i。
D 与城市规模的关系是城市之间的相关。单中心越大、直线距离越长,与“居住外扩、工作仍在中心”的叙述相符,这张横截面图本身没有跟踪每座城市的扩张过程。多中心的斜率不显著,只说明这 11 座城市里没有检出异于 0 的斜率。直线距离也还不是道路距离;河流、山地和绕行会使同样的 D 对应不同的实际出行。
圈层百分数和早高峰升幅是正文直接给出的变化幅度,计算它们的前后两个均值没有印出。五圈按出发总量相等划分,外圈面积可以很大,外圈 Λ 升高同时包含岗位方向和这种空间聚合。主中心只有一个,多中心城市里指向副中心的流动,在全市 Γ 里会表现为较少朝向主中心。
RWRC 表明一组简单规则能够长出相近的方向形态。能够生成,仍是在 50×50 格子和给定概率下的结果。它没有证明真实居民按 Nⱼᵅ 和指数距离选址,也没有证明调整 α 或 β 就能在真实城市里得到图上的 Λ、Γ。
一句话总结
早高峰人流是在挤向一个中心,还是散向多个方向,要同时看流出是否同向、以及是否指向那个主中心;在这 60 座大城市里,单中心城市越大,7 点这一小时的直线通勤越长,多中心城市则没有表现出同样的上升。
核心来源
- Nature Communications 论文页,题目、作者、收稿日期与 2024 年 5 月 27 日在线版本;本文依据页脚标明 corrected publication 2024 的正文 PDF。
- 正文方法、图 1–7 与公式 (1)–(9)。手机原始数据因隐私和合同未公开,论文给出的申请入口为 智慧足迹数据说明。复现代码在 Code Ocean 胶囊 9118584。
- 城市范围采用 Florczyk 等,GHS Urban Centre Database 2015,欧盟联合研究中心。
作者介绍
- 赵鹏军(Pengjun Zhao):论文署名为北京大学城市与环境学院、北京大学深圳研究生院城市规划与设计学院,通讯作者,与 Hao Wang 同等贡献。北京大学页面列其为博雅特聘教授,研究交通地理与城市规划。
- Hao Wang:论文署名为北京大学深圳研究生院城市规划与设计学院,与赵鹏军同等贡献,并参与研究设计、计算、分析和写作。除论文署名与贡献说明外,这里不补充未经论文或机构页面核实的职务。
- 刘启旸(Qiyang Liu):论文署名为北京大学深圳研究生院城市规划与设计学院,通讯作者。学院页面列其为助理教授,研究方向包括交通公平与交通治理。
- 闫小勇(Xiao-Yong Yan):论文署名为北京交通大学系统科学学院,通讯作者。学院页面列其为教授,研究人类移动行为、交通数据挖掘与复杂系统。
- 李京忠(Jingzhong Li):论文署名为许昌学院城市与环境学院,参与写作。许昌学院页面介绍其为副教授,从事城市空间信息与数据驱动的城市研究。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若规划部门只把全市向心性当作“城市是否高效”的分数,多中心城市会天然得分较低,因为算法只认定一个主中心。佛山均安那种朝向副中心的早高峰,在全市 Γ 里更像离开主中心。用提高 Γ 来决定把就业继续收回主中心,可能正好削弱论文在图 4 里看到的现象:多中心城市的直线通勤距离没有随规模显著变长。更可检验的问题是,一个副中心要吸收多大比例的出发量,全市 Γ 才会下降一个能与 13 座弱单中心区分开的幅度。正文的聚类已经给出类间差异的量级,但没有做这项政策模拟。
另一个可分开的量是直线距离和排放。D 的分母是 7 点这一小时的出行次数,分子是欧氏距离。沿江、靠山或依赖环路的城市,短直线可以对应长绕行。若把图 4 的 a = 3.67 直接换成人均碳排放的上升速度,就把端点分离、道路绕行和出行方式绑在了一起。值得单做的检验是:在同一类城市里,用直线 D 排序和用路网时间排序是否还会保持强单中心高于多中心的差别。