同一座上海,地铁和出租车的群体出行能共用一条远近曲线吗?
论文名片|Feng Xia、Jinzhong Wang、Xiangjie Kong、Zhibo Wang、Jianxin Li、Chengfei Liu,Exploring Human Mobility Patterns in Urban Scenarios: A Trajectory Data Perspective,IEEE Communications Magazine,2018年3月,56(3):142–149。DOI:10.1109/MCOM.2018.1700242。观察数据上的分布比较,不是对照实验。
工作日早晨,地铁被写成固定线路上的通勤。正文点名 9 号线九亭到漕河泾高新技术园区是高峰里的热门路径,而且早晨高峰的地铁客流多于傍晚。周末的出租车是另一幅画面:虹桥火车站和浦东机场从 7 点忙到 19 点,傍晚的热点落到江苏路、陕西南路和南京西路一带。两幅画面都来自 2015 年 4 月的上海。拥挤的位置不同,并不自动等于周末换成了另一种出行定律。
这篇文章比较的是群体行程:一次地铁乘车或一次出租车载客有多远、花多久、离下一次同类行程隔多久。同一种交通方式内部,周末和工作日的直线距离仍更接近对数正态;地铁和出租车之间,90% 行程盖住的距离、乘车时长和相邻行程间隔并不相同。出租车的间隔是同一辆车的相邻载客,不是乘客自己的下一次出门。
先说结论
- 地铁刷卡超过 4.51 亿条、14 条线、346 座车站;强生出租车 GPS 为 340 亿条。摘要、文中提要和数据节写 13,695 辆车,引言一处写 13,965 辆。这批车约占上海出租车的 25%。清洗后的行程条数没有给出。
- 地铁的周末与工作日、出租车的周末与工作日,位移都由对数正态拟合得更好,优于幂律和指数。引言写两种方式完全相同;图上形状相近,90% 行程的距离尺度并不一样。
- 地铁行程里,周末 90% 的直线距离不超过 24 公里,工作日不超过 21 公里。出租车相应是 11 公里和 12 公里。时长上,地铁被拟合为威布尔分布,出租车为对数正态;文中强调的典型时长是地铁周末 26 分钟、工作日 28 分钟,出租车 8 分钟。
- 地铁相邻乘车间隔有两个峰,6 分钟和 569 分钟,前段更接近威布尔、尾部更接近对数正态。工作日的第二峰更高。90% 的地铁间隔落在周末 580 分钟、工作日 643 分钟以内。出租车间隔整体更接近威布尔,比较对象是车,不是人。
一条幂律,能同时描述地铁和出租车吗?
人类移动性(human mobility)在这里不是搬家,而是人在城市里借助交通工具完成的一次次行程。较早的参照包括:银行券流转被描述成幂律,移动轨迹被联系到莱维飞行(Lévy flight,步长重尾、方向近似各向同性)。Zhao 等人用四种交通方式说明,单一方式更接近对数正态,把不同方式混在一起才更像幂律;那份材料是北京 182 名参与者手记的方式,作者认为样本和记录方式都不够。另一项城市内出租车研究则认为,位移更接近指数分布,而不是幂律。
这些结论的评价标准并不共用。上海这篇文章改成同一座城市、同一个月、两种大规模轨迹:地铁交通卡和出租车 GPS。它要看的是,分开方式之后位移是否仍服从幂律,以及周末和工作日是换成另一类分布,还是只改变尺度。Song 等人用手机熵得出约 93% 的移动可预测,那是被引用的既有结果,不是这批上海刷卡算出来的预测上限。
留下的行程,是谁的、按什么去掉的?
数据来自上海 SODA 竞赛网站,时间是 2015 年 4 月 1 日至 30 日。论文没有写出 SODA 的全称,也没有给出下载链接。地铁覆盖 14 条线和 346 座车站,交易记录超过 4.51 亿条。出租车由上海强生公司提供,GPS 记录 340 亿条,平均采样间隔 6 秒,约占全市出租车的 25%。车辆数出现两个写法:数据节与摘要为 13,695,引言为 13,965。后文讨论车辆规模时采用数据节的 13,695,并不把两个数字平均。
出租车状态用 0、1、2、3 表示:0 是载客,1 是空车,2 和 3 是非运营。行程在接客和落客的状态变化处切开。每条出租车 GPS 记录有九个字段。数据节还有一句把出租车交易的经纬度说成地铁站位置,字段表本身没有附上。位移后来统一按车站或轨迹点的经纬度计算,不以这句混写为准。
分析前去掉重复记录和设备故障造成的无效记录,并按上下文修改了占 1.85% 的脏数据。论文没有写明 1.85% 的分母是全部记录还是另一批抽查记录。时长短于 1 分钟或长于 3 小时的行程丢掉,因为作者认为日常乘车很少只有几秒或长达数小时。直线距离短于 200 米或长于 120 公里的也丢掉。空间窗口是东经 120.52° 至 122.12°、北纬 30.40° 至 31.53°。
周末地铁、工作日地铁、周末出租车、工作日出租车分别记为 Ds1、Ds2、Dt1、Dt2。过滤之后还剩多少条行程,正文没有报告。后面的 90%、6%、19% 都是这一未知条数内部的比例,不能换成人数,也不能和 4.51 亿条原始交易直接相除。
曲线看起来贴合,就算选中了吗?
作者把行程组织成人类移动网络(human mobility network,HMN):有向图里的点是起点或终点,边从起点指向终点。真正拿来比较的不是这个网络的度数或中心性,而是三个行程量。行程位移(trip displacement)是两点之间大圆劣弧的长度,也就是球面直线距离,不是沿路里程,也不是地铁换乘后的实际乘坐距离。行程时长(trip duration)是从起点到终点经过的时间。行程间隔(trip interval)在地铁上是论文所称同一人的相邻两次乘车间隔,在出租车上是同一辆车相邻两次载客的间隔。
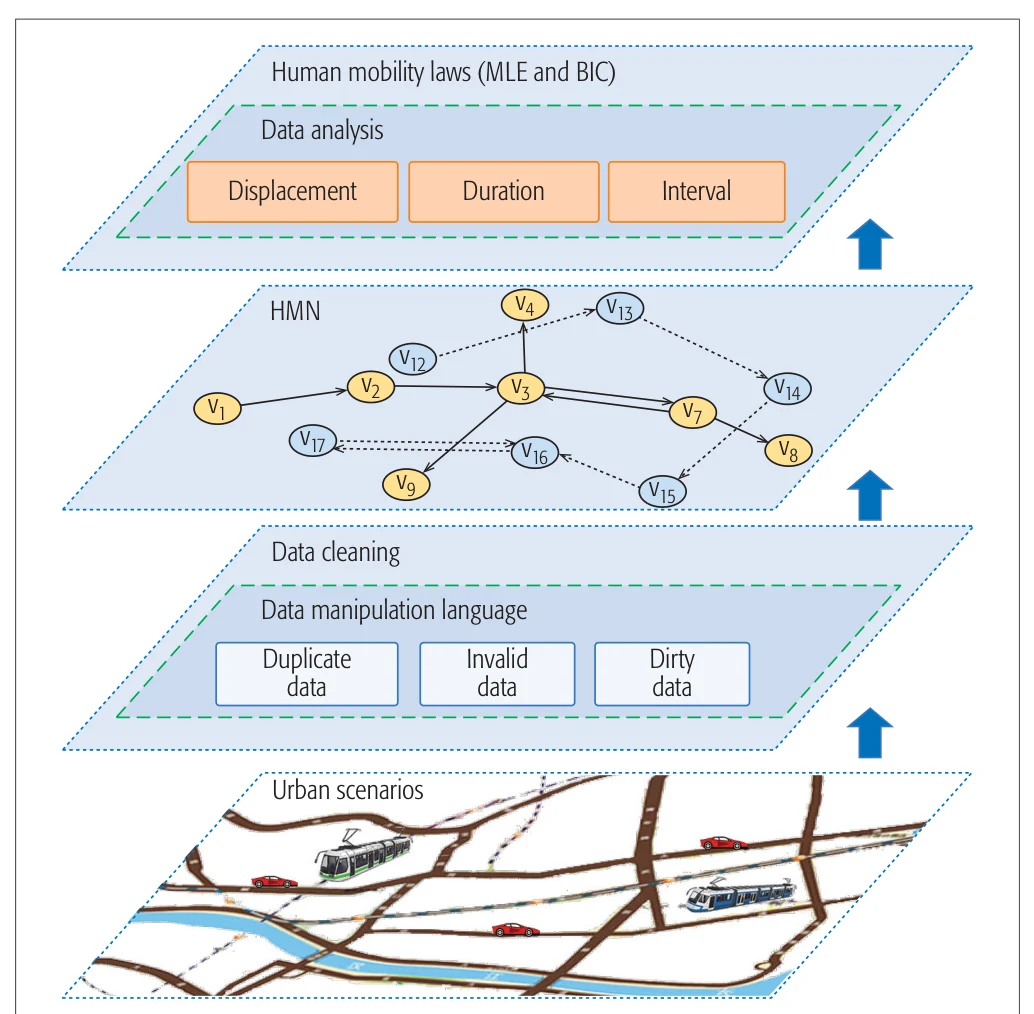
图 1|从城市轨迹到一条分布,中间经过哪些步骤?
图中没有子图字母。自下而上是城市场景、数据清洗、人类移动网络、三项行程指标,以及用极大似然和贝叶斯信息准则选出的移动规律。清洗框列出重复、无效和脏数据。网络里的 v1 到 v17 是示意图,不是上海实测网的统计结果;实线与虚线的差别图中没有说明。来源:原论文 Fig. 1。
分布比较放在对数坐标上,并用对数分箱(logarithmic binning):区间宽度按指数增大,用来减轻重尾数据里的噪声。候选分布先做极大似然估计(maximum likelihood estimation,MLE),再算贝叶斯信息准则(Bayesian information criterion,BIC):
BICᵢ = −2 log(Lᵢ(θ̂ | data)) + Kᵢ log(n)
θ̂ 是估计出的参数,Kᵢ 是参数个数,n 是观测条数。参数越多,后一项惩罚越大。各模型与最小 BIC 的差记为 Δᵢ = BICᵢ − BICₘᵢₙ。印刷出来的权重是 exp(−Δᵢ2) 除以所有候选模型的同样一项之和,Δᵢ 和 2 之间没有除号。常见写法是 exp(−Δᵢ/2)。正文没有列出任何一个 BIC 或权重,分布是否胜出主要靠作者的文字判断和后图的曲线。极大似然用的是每一条行程还是分箱后的点,正文也没有写明。
人流在地图上聚成什么样?
一天被分成 12 个 2 小时时段。地图只展示早晨高峰 7:00–9:00、午间 11:00–13:00 和傍晚高峰 17:00–19:00。
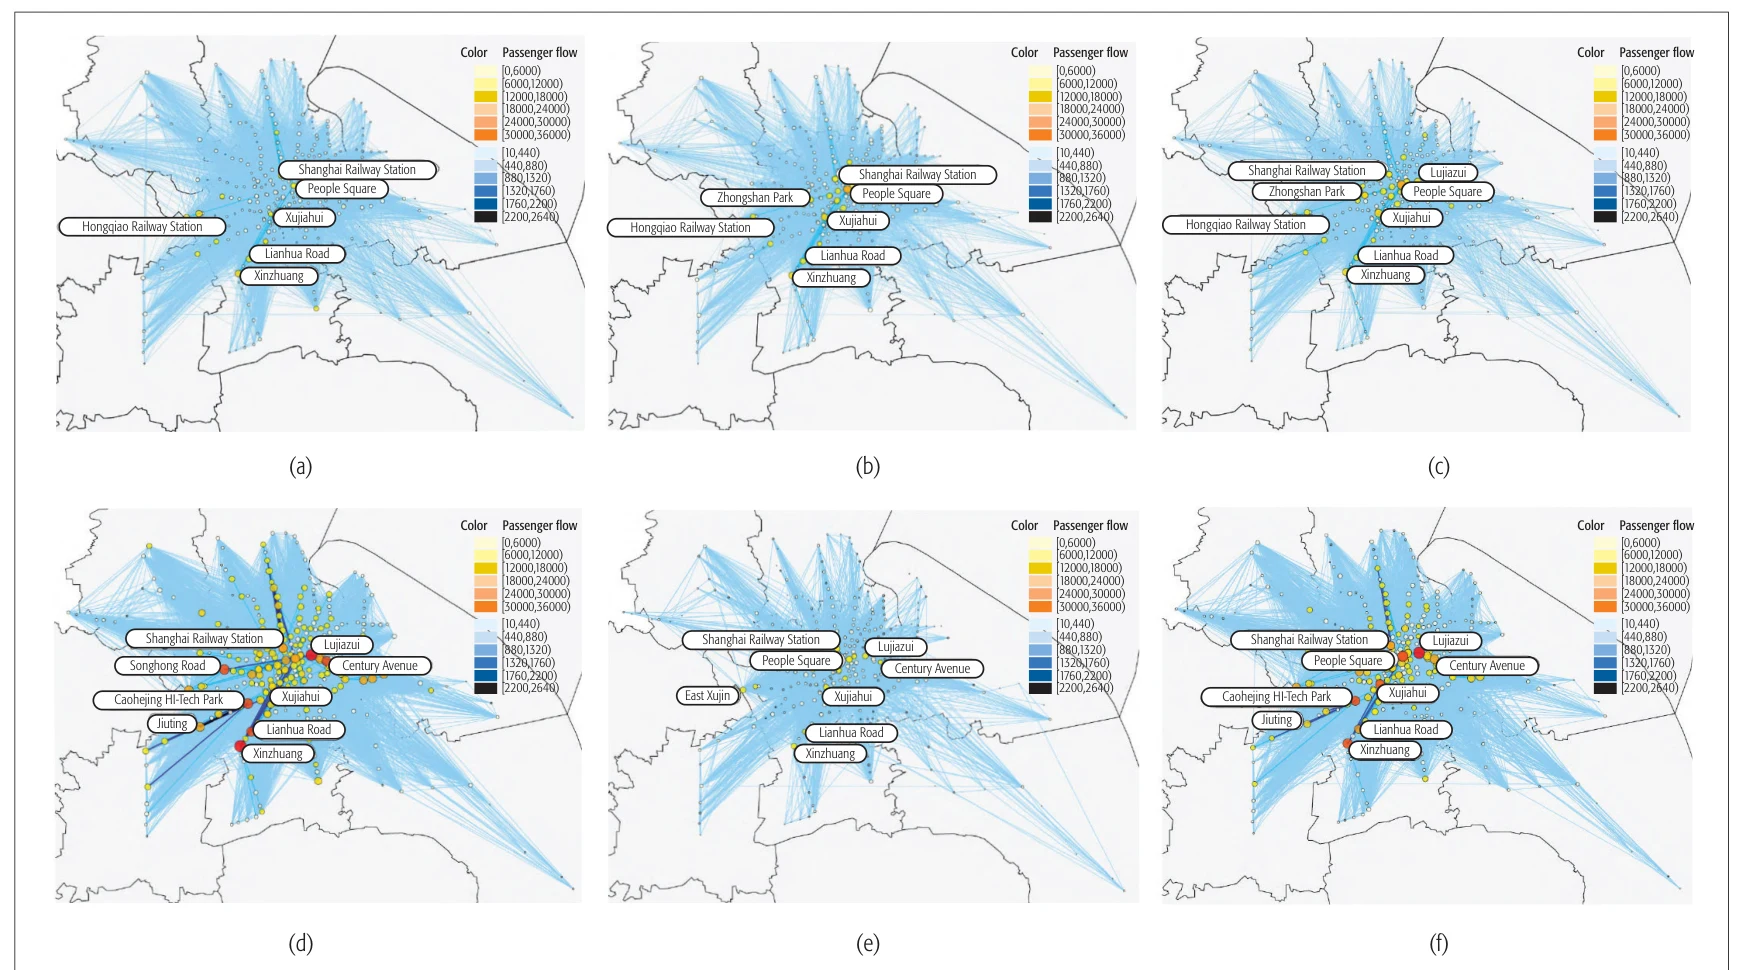
图 2|三个时段里,地铁客流在周末和工作日各聚在哪里?
六张小图共用两套客流色标,不是周末一套、工作日另一套。黄到橙色标为 [0, 6000)、[6000, 12000)、[12000, 18000)、[18000, 24000)、[24000, 30000)、[30000, 36000);蓝到黑色标为 [10, 440)、[440, 880)、[880, 1320)、[1320, 1760)、[1760, 2200)、[2200, 2640)。站点圆点偏暖色,站间连线偏冷色。论文把两套都标成客流,没有单独写明圆点和连线各用哪一套,因此不能把一条蓝线和一颗黄点放在同一套数字上比大小。
(a)周末 7:00–9:00。(b)周末 11:00–13:00。(c)周末 17:00–19:00。上海火车站和虹桥火车站从 7 点到 19 点保持忙碌。中山公园和人民广场的早晨客流明显少于其他时段,作者据此认为周末人们更晚才往这两站集中。徐家汇位于市中心,傍晚客流高于其他时段。正文另写周末早晨最热行程是通河新村到上海火车站,傍晚莘庄与徐家汇之间来往更多;通河新村没有出现在这张图的站点标签里。(d)工作日 7:00–9:00。(e)工作日 11:00–13:00。(f)工作日 17:00–19:00。早晚高峰的客流多于午间,早晨又多于傍晚,作者推测有一部分人 19 点以后还在工作。工作日高峰里最热的是 9 号线九亭到漕河泾高新技术园区。
工作日地铁客流是周末的四倍。论文没有说明这是全月合计还是按天平均,也没有列出周末和工作日各有多少天。2015 年 4 月工作日天数多于周末,又包含公共假期;文末才把假期留作以后的研究。因此四倍不能直接读成每一个工作日都是每一个周末日的四倍。作者还写,多数人周末从事社会活动、工作日去上班;9 号线在工作日非常忙,1 号线在周末相对更忙。线路忙闲是文字结论,图上没有按线路编号着色。
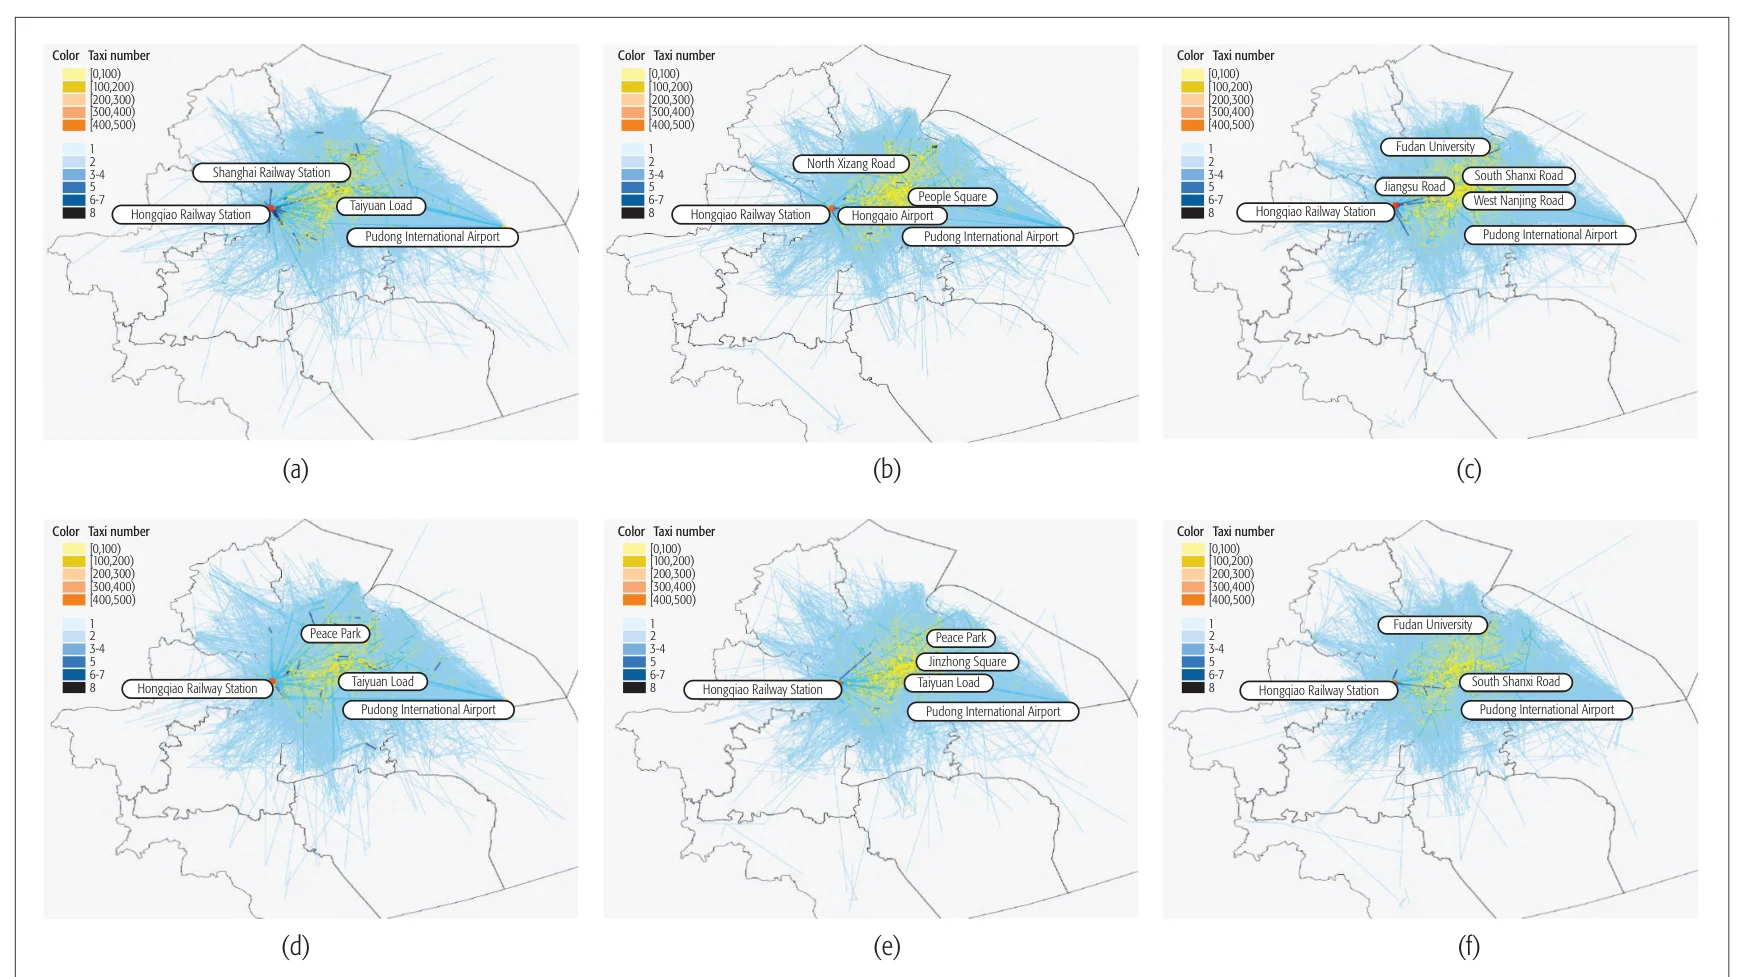
图 3|同样三个时段,出租车的热点和较忙路线在哪里?
色点的出租车数量分为 [0, 100)、[100, 200)、[200, 300)、[300, 400)、[400, 500)。连线分为 1、2、3–4、5、6–7、8 档。论文说色点和连线表示热点与较忙路线,没有写明 8 档是路段上的行程次数还是车辆数。六张图共用这套色标。
(a)周末 7:00–9:00。(b)周末 11:00–13:00。(c)周末 17:00–19:00。虹桥火车站和浦东机场从 7 点到 19 点都忙,火车站的量在高峰而非午间达到高点;市中心与浦东机场之间主要是长行程。作为上海第二座机场,虹桥机场的出租车行程主要出现在中午,作者把它联系到位置更方便,这是解释而不是单独测到的可达性。傍晚热点包括江苏路、陕西南路和南京西路,周边有餐饮和商业,作者认为人们周末晚上去那里休息。(d)工作日 7:00–9:00。(e)工作日 11:00–13:00。(f)工作日 17:00–19:00。早晨行程明显多于其他时段,两个枢纽仍然突出。正文把复旦大学在傍晚变得极忙归因于放学后的通勤时间;图上(c)和(f)都标有复旦大学,这一解释写在工作日傍晚。工作日早晨相对较多的行程包括万科七宝国际花园到虹桥火车站、虹桥机场到 South Zhuxiang,傍晚则有虹桥火车站到申昆路(Shenkun Road)。论文只给英文地名,South Zhuxiang 不另译。
出租车与地铁的周末效应方向相反:乘出租车的人周末多于工作日,定量倍数没有给出。出租车行程高度聚集在市中心。并排看图 2 和图 3,地铁因为线路固定而更规则,出租车连线更散。这是路网约束下的空间形态,不是同一个人从地铁改乘出租车的记录。
多数行程到底有多远?
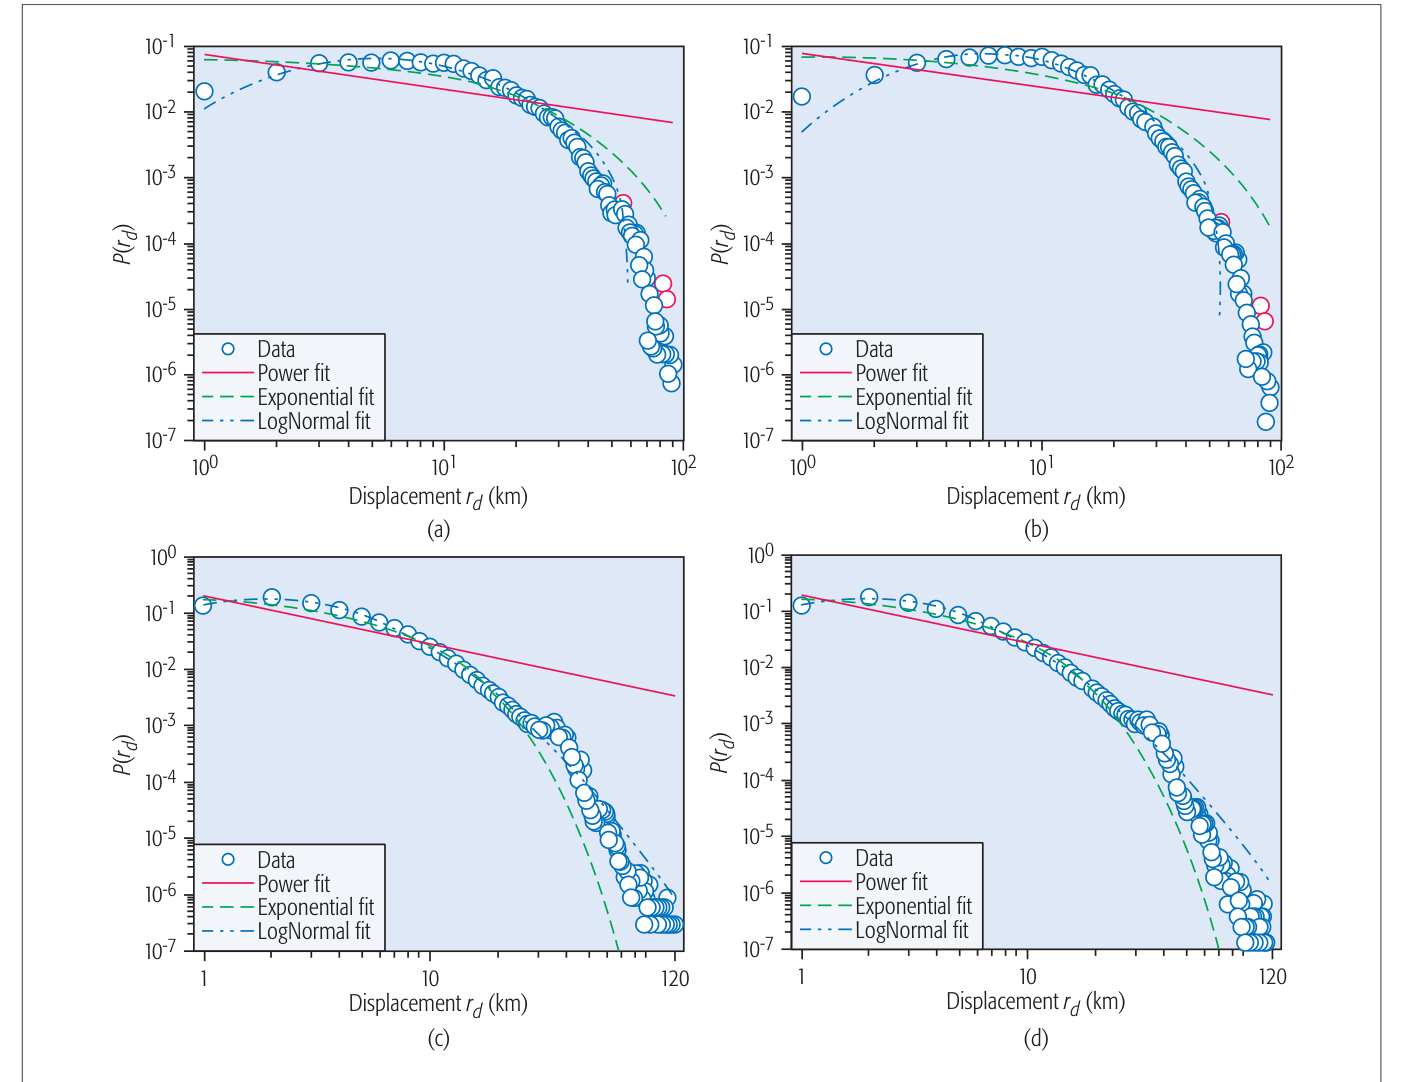
图 4|位移分布是幂律、指数,还是对数正态?
纵轴是对数分箱后的 P(r_d),横轴是直线距离 r_d,单位公里。圆点为数据,红实线为幂律,绿虚线为指数,蓝点线为对数正态。幂律在双对数坐标上接近直线,数据则先平缓、后加快下降。(a)周末地铁,横轴约从 1 公里到 100 公里,纵轴约从 10⁻¹ 到 10⁻⁷。(b)工作日地铁,坐标范围与(a)相同;蓝点线在右端先于最后几个点掉下去,尾部并没有被一条曲线完全盖住。(c)周末出租车,横轴从 1 公里到 120 公里,纵轴从约 10⁰ 到 10⁻⁷。(d)工作日出租车,坐标与(c)相同。四张图都是对数正态更顺着弯折走。120 公里也是清洗时丢掉更长位移的上限;地铁图只画到 100 公里,正文没有解释 100 到 120 公里为什么没有出现在地铁图上。来源:原论文 Fig. 4。
作者用 BIC 认定四组位移的最佳拟合都是对数正态,并认为出租车两组略好于地铁两组,且地铁模型比出租车少 2 个参数、复杂度更低。参数估计和 BIC 数值都没有列表,少 2 个参数这一句无法在图上复核。对数正态有两个常用参数,四种情形若用的是同一种分布,参数个数不应相差 2。这里只保留图 4 上看得见的形状比较。
比例写在正文里,没有标在坐标轴上。分母是论文所称的 occupied trips,地铁段落也用了这个词,更接近保留下来的乘车行程,而不是出租车状态码里的载客车辆数。
| 交通方式 | 周末,90% 行程的直线距离 | 工作日,90% 行程的直线距离 | 文中另给的高比例距离 |
|---|---|---|---|
| 地铁 | 不超过 24 公里 | 不超过 21 公里 | 6 公里占 6%,7 公里占 7%;最高比例被概括在大约 7 公里 |
| 出租车 | 不超过 11 公里 | 不超过 12 公里 | 2 公里:周末占 19%,工作日占 18% |
6 公里与 7 公里那一句没有用分别对应把 6% 和 7% 分给周末和工作日。英文里的 longest trip 和后文的最高比例放在一起,读起来是比例最高的距离档,不是地图上最远的那一趟。大约 20 公里是作者对地铁活动范围的概括,依据就是上述 21 公里和 24 公里这两个 90% 界线,不是另算的平均位移。
周末地铁比工作日地铁走得更远:90% 界线是 24 公里对 21 公里。出租车两边只差 1 公里,而且工作日的 90% 界线(12 公里)略高于周末(11 公里)。作者把出租车更短归到费用更高,所以更远的行程更愿意乘地铁。费用本身没有在这批数据里测量,这是对距离差别的一种解释。直线距离也短于沿路或含换乘的实际路程,不能把 7 公里直接当成票价里程。
同样的直线距离,地铁和出租车要花多久?
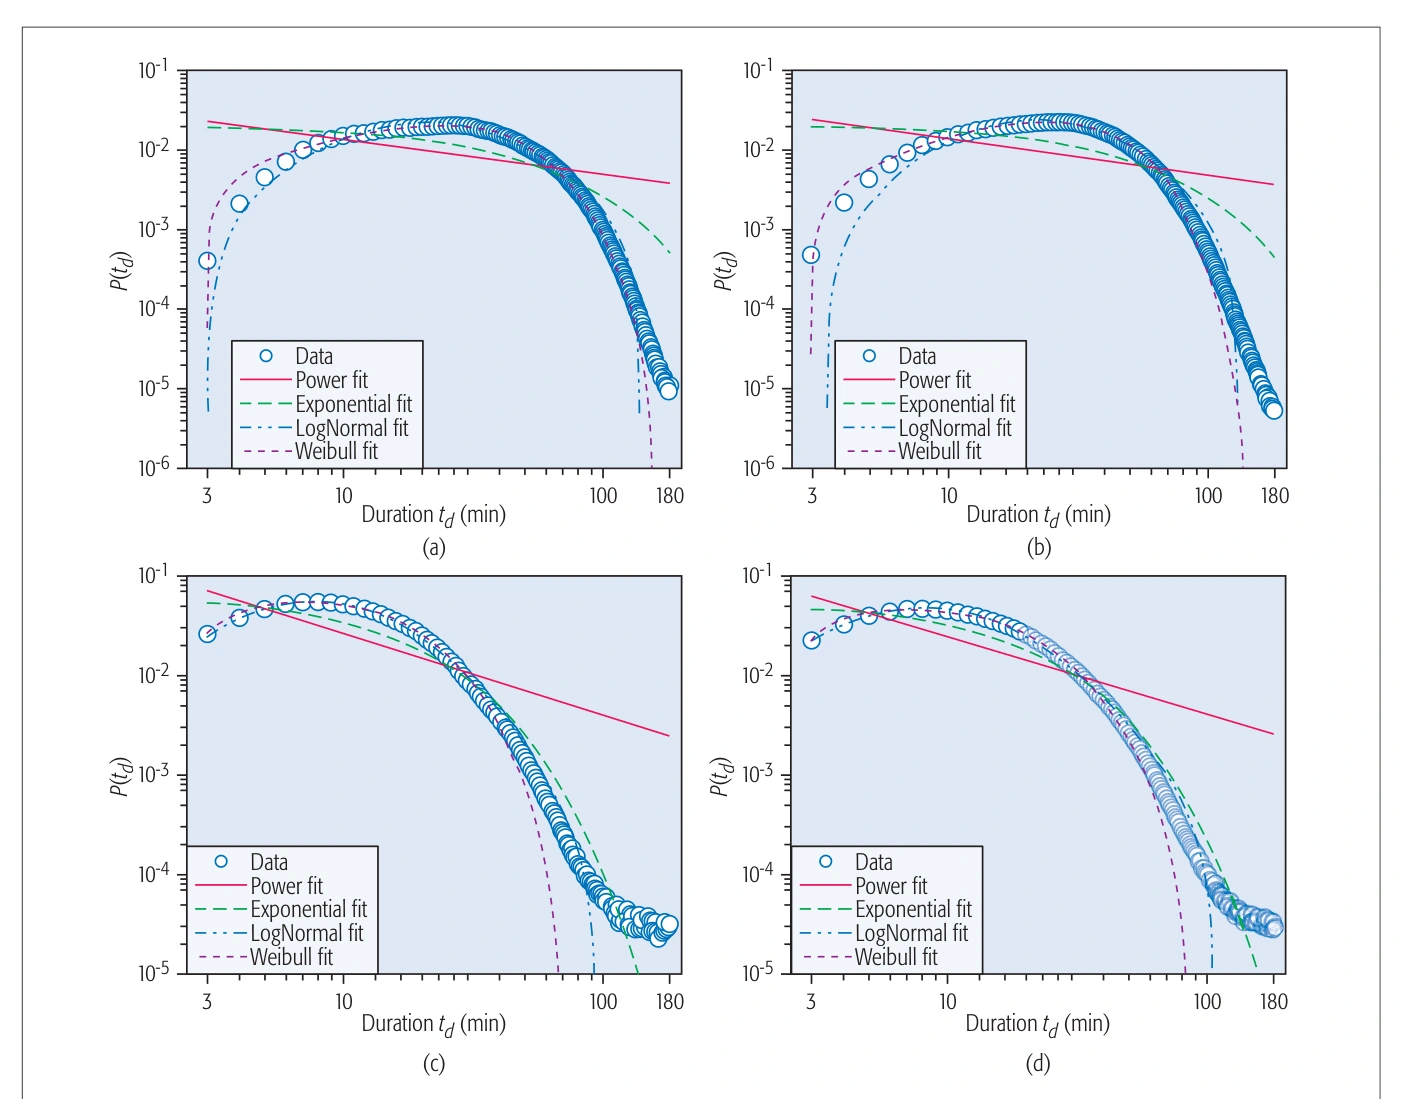
图 5|乘车时长更接近哪一种分布?
纵轴为 P(t_d),横轴为时长 t_d,从 3 分钟到 180 分钟。圆点为数据;红实线幂律,绿虚线指数,蓝点线对数正态,紫虚线威布尔。清洗保留的是 1 分钟到 3 小时,图从 3 分钟画起,1 到 3 分钟没有展开。(a)周末地铁。(b)工作日地铁。两条曲线都先升后降,威布尔跟着这个峰走,幂律的直线盖不住。(c)周末出租车。(d)工作日出租车。出租车从较短时长一侧下降,威布尔在中后段掉得太快,对数正态贴得更久。周末和工作日在各自方式内部形状相近。来源:原论文 Fig. 5。
正文据此认为,地铁时长拟合为威布尔分布,出租车拟合为对数正态。作者写人们乘地铁通常花 26 分钟(周末)和 28 分钟(工作日),乘出租车多数只花 8 分钟。结论段把地铁收成 28 分钟,没有再写周末的 26 分钟。这三个数没有标注在图 5 上,正文也没有说明它们是众数、中位数还是平均数。图只支持地铁有一个中间峰、出租车偏向短时长,不能从图上把峰顶精确读成 26 或 8。
位移和平均时长的关系没有单独的图,数字来自正文。地铁的平均时长随直线距离上升而上升,近似一条直线,平均速度从 18 公里/小时变到 35 公里/小时。这里的速度是直线距离除以时长,不是列车时刻表速度。距离超过 46 公里后曲线略有起伏,作者推测与换乘和线网有关。超过 120 分钟的地铁行程要在换乘站花更多时间,平均速度下降。
出租车更起伏。周末,平均时长在直线距离 93 公里处达到峰值 388 分钟;工作日,对应的峰值距离是 97 公里,该点的平均时长没有另给数字。用 93 公里除以 388 分钟,约 14 公里/小时。这是对这两个正文数字的换算,不是论文报告的速度,也低于地铁那段 18 到 35 公里/小时的范围。作者仍写出租车平均速度总体上快于地铁、波动更大,并把 388 分钟理解成周末长途遇上较差路况。论文没有按距离段列出速度表,所以总体上更快不能读成每一个距离段都更快。短直线距离上出租车也会花更多时间,作者归因于路网和司机交接班,天气、事故和假期只被列为可能因素,没有在本月数据里分开估计。
下一次行程要隔多久,隔的是人还是车?
地铁间隔是论文定义的同一人相邻两次乘车的时间差,数据来自交通卡交易。正文没有说明怎样确认两次交易属于同一个人。下面只使用汇总后的群体分布,不补充从卡记录对应到自然人的步骤。出租车间隔是同一辆车相邻两次载客之间的时间,服务的可能是不同乘客。论文自己也写,出租车间隔远短于地铁,是因为评价对象不同。两条曲线不能当成同一种等待。
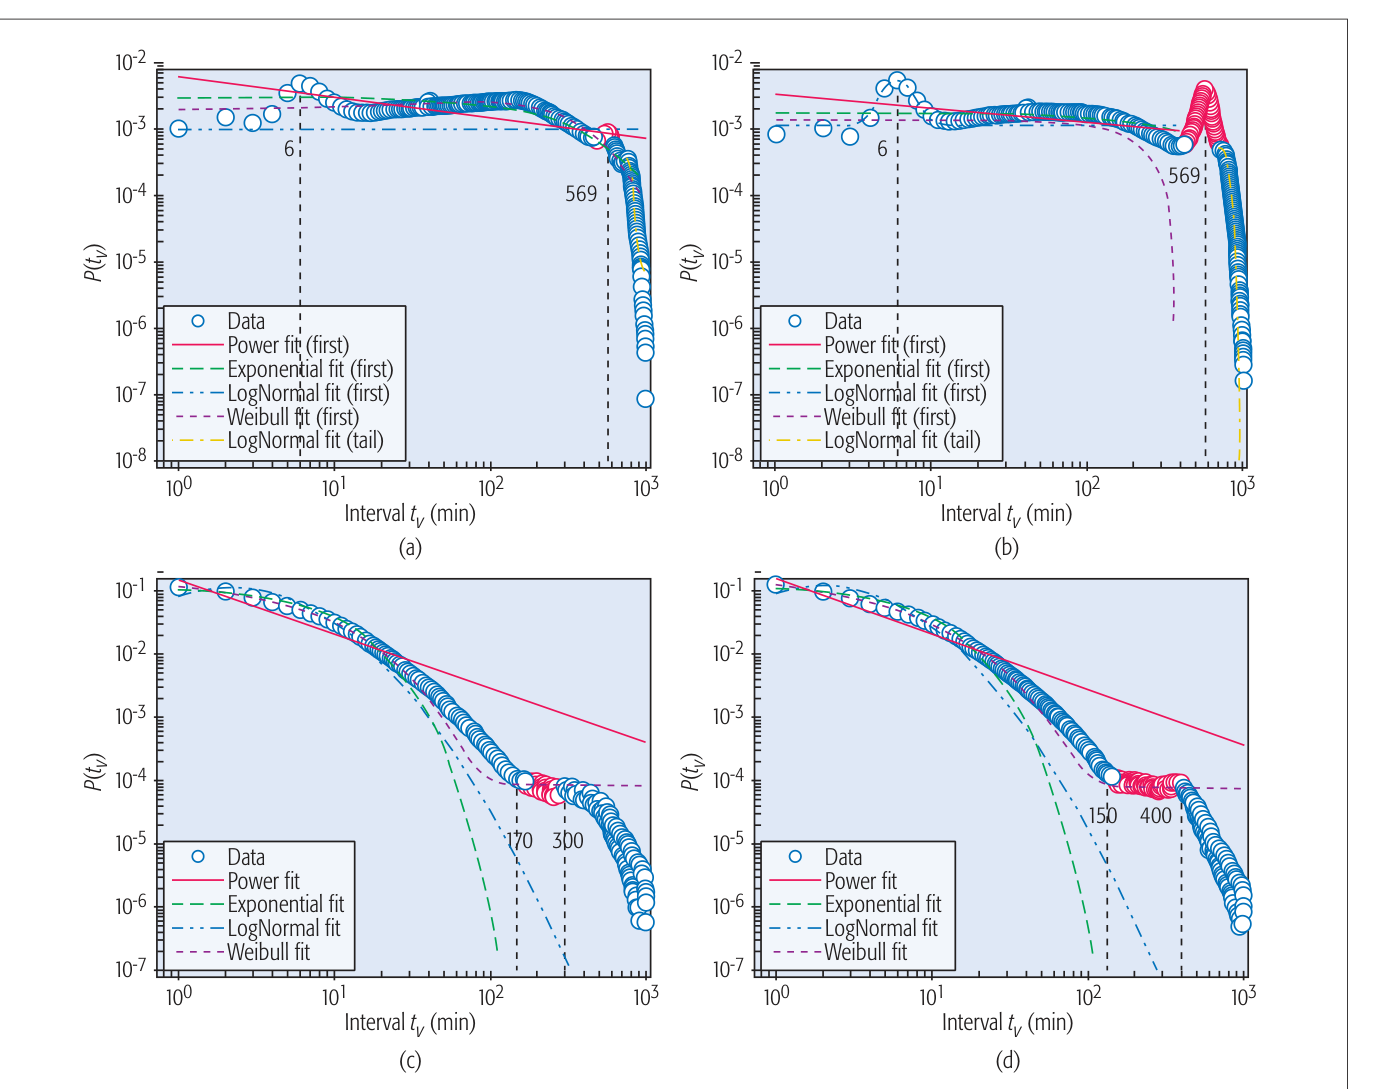
图 6|相邻行程间隔是单峰衰减,还是两段规律?
纵轴为 P(t_v),横轴为间隔 t_v,约从 1 分钟到 10³ 分钟。(a)周末地铁。(b)工作日地铁。图例把幂律、指数、对数正态和威布尔标成前段拟合,另有一条对数正态拟合尾部。两条曲线都在 6 分钟和 569 分钟处标出峰;6 分钟之后缓慢下降,569 分钟附近再次升起,然后迅速跌落。工作日的第二峰明显高于周末。单一条威布尔盖不住第二个峰,尾部改用对数正态。(c)周末出租车。(d)工作日出租车。概率从 1 分钟附近的高值下降。威布尔在前段比指数和对数正态更靠近数据,但中段有一段几乎走平、并不贴着任何一条下降曲线。(c)把这段标在 170 到 300 分钟。(d)标在 150 和 400 分钟。来源:原论文 Fig. 6。
正文写出租车间隔的概率在周末 170 到 300 分钟、工作日 160 到 400 分钟之间保持不变。图 6(d) 印的是 150 和 400,与正文的 160 不一致。两处都保留,不把其中一个改成另一个。作者认为这段平台说明周末出租车运营比工作日更高效。图上看得见的是概率在一段中等间隔里变化很小,周末这段平台比工作日更窄;空驶率、收入或接单等待并没有被直接测量。
地铁第二峰的高度,工作日远高于周末。作者认为多数人把这个间隔花在工作上,并写它与 8 小时工作时间正好相合,还提到家或公司到地铁站的距离。569 分钟约 9.5 小时,长于 8 小时也就是 480 分钟。论文没有给出从 569 折到 8 小时的计算。结论段又说地铁间隔非常接近 8 小时、而且工作日更明显。能够核对的是峰的位置 569 分钟,以及工作日第二峰更高;8 小时是作者的解释。
90% 的地铁间隔落在周末 580 分钟、工作日 643 分钟以内,两者相差 63 分钟。论文把它概括成周末大约早 1 小时进入下一次乘车,并认为周末更多是社会活动、交通也更顺畅。这仍是同一人相邻乘车的群体分位,不是路网速度的测量。出租车的 90% 间隔在周末和工作日之间差得不多,具体分钟数没有给出。
这些规律能用到哪一步?
位移上,四种情形都更接近对数正态,而不是幂律或指数。这和单一交通方式接近对数正态的既有说法方向一致,也和把出租车位移写成指数分布的说法不同。一致只发生在分布族,不发生在距离尺度:地铁 90% 界线是 24 公里和 21 公里,出租车是 11 公里和 12 公里。引言里的完全相同,不宜覆盖后文的这组差别。
时长和间隔连分布族都随方式改变。地铁时长用威布尔,出租车时长用对数正态;地铁间隔要分成前段和尾部,出租车间隔整体更接近威布尔,还留下一段平台。周末和工作日主要改变地铁的远近、第二峰的高低,以及出租车平台的宽度,没有把同一种方式从一种分布换成另一种。
几处边界跟着这些结果走。相关的时空聚集不是某座车站导致出行的因果证明。费用、路况、下班晚于 19 点和放学通勤,都是作者对热点和时长的解释,数据里没有票价、事故或学校放学时刻。对数分箱后的贴合不是机制证明,BIC 权重又没有印出来。过滤后的行程条数缺失,百分比无法换算成城市人口中的份额。大圆距离短于实际路径。地铁间隔与出租车间隔的对象不同。2015 年 4 月一个月、上海一座城市、地铁和强生出租车两种方式,不能直接外推到私家车、手机信令或其他月份。作者把天气、公共假期和其他交通方式留到以后,也说明这一个月没有把这些因素拆开。摘要说方法可以用于手机、社交签到和私家车,正文没有做这三类数据的拟合。
一句话总结
2015 年 4 月上海的群体行程里,地铁和出租车的直线距离都更接近对数正态,但 90% 行程的距离分别停在地铁 24/21 公里和出租车 11/12 公里;时长与相邻间隔连优选分布都不相同,周末和工作日主要改尺度和第二峰,而不是让同一种方式换一套曲线。
核心来源
- IEEE Xplore 正式页面,核对题目、作者、2018 年 3 月发表信息与 DOI:10.1109/MCOM.2018.1700242。卷 56 第 3 期来自 PDF 书目信息,页码 142–149 印在版心。
- 解读依据是这 8 页正式刊出正文中的图 1–6 与正文数字。文中没有附参数表,也没有报告过滤后的行程条数。
作者介绍
以下身份和方向取自文章脚注与文末简介,是 2018 年刊出时的写法。
- Feng Xia:大连理工大学软件学院教授,并属于辽宁省泛在网络与服务软件重点实验室;学士和博士毕业于浙江大学。文中列出的方向是计算社会科学、网络科学、数据科学和移动社交网络。
- Jinzhong Wang:2002 年获鞍山师范学院计算机教育学士,2005 年获辽宁大学计算机应用技术硕士;刊出时在大连理工大学软件学院攻读博士,并自 2005 年起在沈阳体育学院工作。文中方向是交通数据分析和移动社交网络。
- Xiangjie Kong:通讯作者,大连理工大学软件学院副教授,同属上述重点实验室;学士和博士毕业于浙江大学。文中方向是计算社会科学、城市大数据和移动计算。
- Zhibo Wang:武汉大学计算机学院副教授;2007 年获浙江大学自动化专业学士,2014 年获田纳西大学诺克斯维尔分校电气工程与计算机科学博士。文中方向包括移动群智感知、信息物理系统、推荐系统和隐私保护。
- Jianxin Li:西澳大利亚大学计算机科学与软件工程学院高级讲师;2009 年在斯威本科技大学获计算机科学博士。文中方向包括数据库查询、社交网络分析和交通数据分析。
- Chengfei Liu:斯威本科技大学计算机科学与软件工程系教授;1983、1985、1988 年在南京大学获计算机科学学士、硕士和博士。文中方向包括结构化数据上的关键词检索、图数据库、社交网络和以数据为中心的工作流。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把地铁和出租车合成一条城市距离曲线,缺的恰好是过滤后的行程条数。周末 90% 界线是 24 公里对 11 公里,工作日是 21 公里对 12 公里,两边都像对数正态,但尺度不同。条数未知时,无法知道合成之后的尾巴有多厚。一条不分方式的幂律,有可能只是两种尺度混在一起的样子;在拿到两类行程各有多少条之前,这个判断停在定性。
569 分钟的第二峰是全体地铁间隔直方图上的隆起,工作日更高。它不能单独证明每一个持卡人都上了 8 小时的班。倒班、两段校园活动,或者中间还有步行和公交的人,都会落在同一张图里,却对不上这个峰。把峰顶解释成通勤作息,需要家、工作和交通方式的独立记录;只有峰的高低,说明不了某一个人的日程。
出租车图上那段走平的间隔,周末标在 170–300 分钟,工作日图上标在 150 和 400 分钟。整体上威布尔更贴近下降段,平台却留在曲线外面。若调度只使用一条全天威布尔,中等长度的空档会被当成平滑衰减的一部分。机场排队、交接班和市中心短途混在同一辆车的间隔里,拆开这些运行状态之后,平台还在不在,这篇文章没有检验。