去过的地点一直在增加,为什么同时维持的熟悉地点却差不多不变?
论文名片|Laura Alessandretti、Piotr Sapiezynski、Vedran Sekara、Sune Lehmann、Andrea Baronchelli,Evidence for a conserved quantity in human mobility,Nature Human Behaviour,2018,2:485–491,2018年6月18日在线发表。DOI:10.1038/s41562-018-0364-x。本文依据 Nature Human Behaviour 2018年7月 Letters 正式版解读。
一个人这一年换了健身房,周末开始去另一处公园,午饭也不再固定在同一家店。按这个说法,他认识的地方应该越来越多。可是如果只数他这段时间里反复前往、并且每周都停留一会儿的地方,份数可以几乎不动:新地方留下来的时候,旧地方在退出。
这段想象只用来分开两个数,不是数据集里的某一个人。人类移动性在这里指人在地点之间的反复到访,不是搬家,也不是户籍迁移。到目前为止一共去过多少个不同地点,这个累计数一直在涨。眼下这套熟悉地点有多少个,这个当前份数几乎不动。后一个数才是这篇论文所说的守恒量。
先说结论
- 累计去过的不同地点随时间亚线性增长。个人幂律指数的平均值为 Lifelog 0.71、CNS 0.63、MDC 0.68、RM 0.76。指数的分母是时间,比较的是同一个人累计地点随时间的增长速度。
- 熟悉地点组成的活动集一直有进有出,但个数在群体平均上不随时间上升或下降。归一化容量的线性斜率是 Lifelog 0.0021±0.0039、CNS −0.0022±0.0026、MDC −0.0006±0.0032、RM 0.0060±0.0197,不确定区间都包含 0。
- 对大多数人,平均净增量落在本人净增量的一个标准差之内:Lifelog 99.57%、CNS 97.05%、MDC 95.42%、RM 85.37%。分母是各数据集中的人,不是到访次数。名单仍在更换:相隔更久的两套周活动集,杰卡德相似度按幂律下降,指数为 Lifelog −0.15、CNS −0.31、MDC −0.49、RM −3.00。
- 把定义活动集的时间窗加长后,典型大小饱和在大约 25 个地点;这是四组按时间覆盖重标度后的共同量级。真实容量通常至少比只保留每日时间结构的随机化结果小 30%,分母是随机化容量。
- 地点容量与 20 周内的电话、短信联系人数正相关。皮尔逊系数是 CNS 通话 0.31、MDC 通话 0.48、CNS 短信 0.52、MDC 短信 0.54。这是相关,不是认知上限已经被测量出来。
这四组轨迹,量的是谁、在多长时间内的到访?
主分析用两组至少观测 12 个月的高分辨率轨迹,正文给出的合计约为 4 万人。Lifelog 是 2015–2016 年约 3.6 万名应用用户,追踪 19 个月;用户年龄 18–65 岁,平均 36 岁,约三分之一为女性,位置分布在世界各地。CNS 是哥本哈根网络研究,2013年9月至2015年9月,851 名丹麦技术大学学生,通常 19–21 岁,约 22% 为女性、78% 为男性,跨度 24 个月。
另外两组用来核对,空间分辨率和样本量都更低。MDC 来自洛桑数据采集,概述写持续 19 个月,方法给出的区间是 2009年10月至2011年3月,约 185 名日内瓦湖区志愿者;62% 为男性、38% 为女性,22–33 岁大约占三分之二。RM 是 2004–2005 年麻省理工的现实挖掘数据,94 人;概述写跨度 10 个月,方法写采集过程约 9 个月。其中 68 人在校园同一栋楼工作,90% 为研究生、10% 为职员,另外 26 人是商学院新生。CNS 和 RM 合计约占本文分析人数的 2%,日常作息还受相近的学期表约束。
地点指停留超过 10 分钟的地方。CNS 把手机 Wi-Fi 和 GPS 合在一起估计位置,95% 的情况误差低于 50 米。Lifelog 不按固定间隔采样,设备运动状态变化时才更新位置;93% 的点误差低于 100 米,正文结果对应停留地点最大距离 30 米这一设定。MDC 采用移动通信数据,因为其采样频率高于同一实验里的 GPS。RM 按固定频率记录基站编号。四种位置的空间单位并不相同。正文说,尽管分辨率不同,每周到过的不同地点数在四组之间可比。
活动集是当前这套熟悉地点。对一个人、在时刻 t,它包括此前连续 20 周里至少到访两次,且平均每周停留超过 10 分钟的地点。一次路过不算。只去过一次、或每周平均停不到 10 分钟,也不算。20 周、两次和 10 分钟都是操作性门槛。作者报告,改变时间窗长度或地点定义后,后面的主要结果仍然成立。
CNS、MDC 和 RM 还有电话、短信或 Facebook 上的互动记录。CNS 另有一份 310 题的问卷,其中包含大五人格。这些社交和问卷信息只在后文的相关分析里使用,不参与地点容量本身的计算。
累计地点在涨,熟悉地点为什么是另一套账?
一个人每次离开当前地点,可以回到去过的地方,也可以去一个新地点。若把累计去过的不同地点数记为 Lᵢ(t),它随时间按幂律增长,Lᵢ(t) ∝ t^αᵢ。αᵢ 小于 1 时,新地点还在增加,但增加得比时间慢。这是希普斯定律的形式,也和更短时间尺度上的既有观测一致。
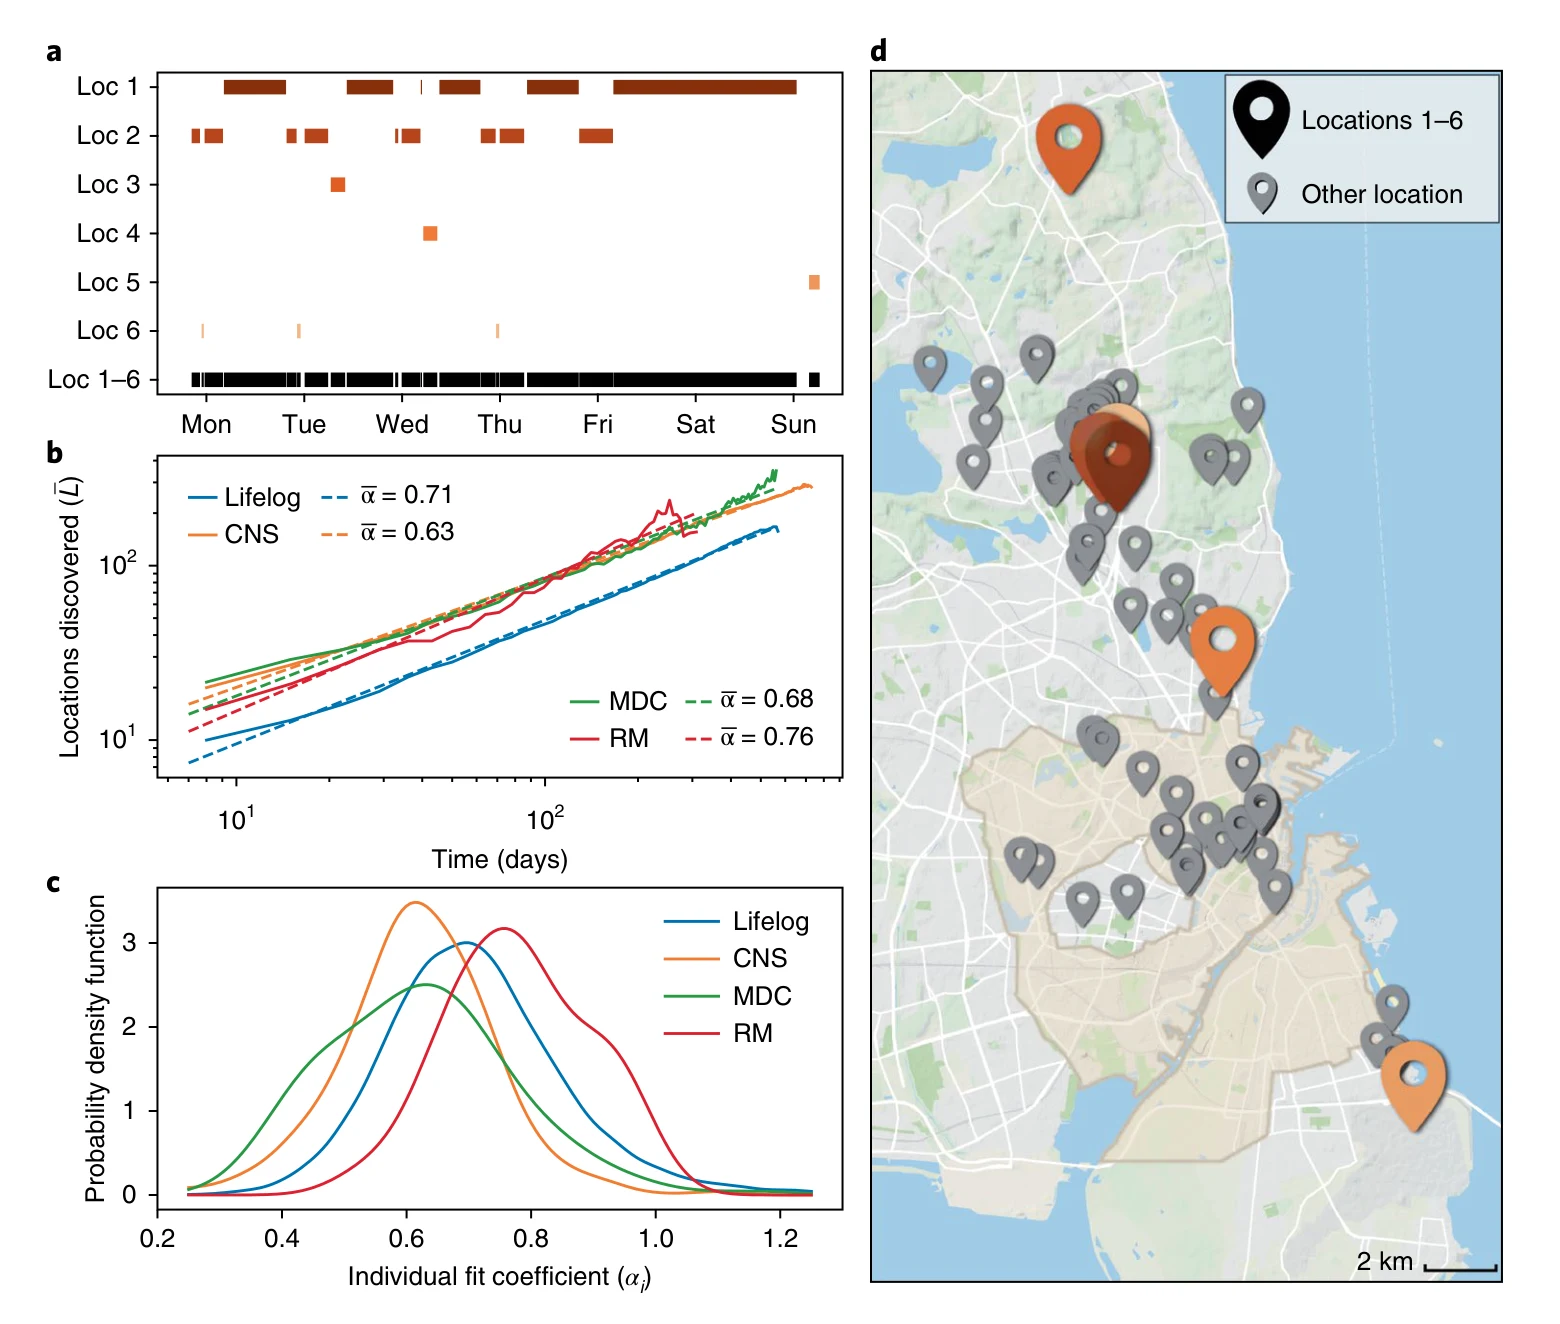
图 1|累计地点怎样增长,当前的熟悉地点又落在哪里?
(a)一个人一周里六个最常到访地点的到访记录,颜色从深到浅对应 Loc 1 到 Loc 6,底部黑条是这六个地点的全部到访。它说明同一些地点会在一周内重复出现,不是 25 这个容量,也不是四组人的平均。(b)累计发现地点数随时间的群体平均。横轴时间和纵轴地点数都是对数刻度,主刻度为 10 和 100;实线是四组平均,虚线是幂律拟合,指数为 Lifelog 0.71、CNS 0.63、MDC 0.68、RM 0.76。曲线高低受采样方式影响,不能直接读成哪一组人去过的地方更多。(c)个人拟合指数 αᵢ 的概率密度,横轴大约从 0.2 到 1.2。四组都是单峰,峰靠近各自平均指数,个人之间仍有明显差别。(d)另一个人的活动集示例,浅色范围是哥本哈根,比例尺 2 公里。图例把六个最常到访地点与其他地点分开;地图上前者是较大的图钉,颜色与 a 对应,灰色图钉是其余地点。坐标加过随机噪声,不能当成精确住址。来源:原论文 Fig. 1。
增长指数的单峰说明,探索速度在各自样本里比较集中,不是一半人几乎不再去新地方、另一半人线性累加。它没有说每个人的 αᵢ 相同。图 1b 的纵轴是累计地点,会继续升高。活动集则是滚动的 20 周窗口,旧地点可以离开。
大多数时间确实花在少数地点上,这和既有的日常移动研究一致。新发现的地点里,只有一部分后来进得了活动集。这个进入概率在长期稳定在 Lifelog 7%、CNS 15%、MDC 15%、RM 20%。分母是新发现的地点。用 100% 减去这些进入概率,相应有 93%、85%、85% 和 80% 的新地点不会成为熟悉地点。进入概率稳定在一个正数,只说明名单不稳定、新成员会持续到来,不说明名单会变长。
名单在换,个数为什么还能停住?
地点容量 Cᵢ 是某个时刻活动集的大小。净增量 Gᵢ = Aᵢ − Dᵢ,Aᵢ 是该时刻新进入的熟悉地点数,Dᵢ 是退出的熟悉地点数。容量不变,要求进来的份数和出去的份数相抵,不是要求原来那些店和教室一直留在名单上。
图 2a 的横轴从第 20 周画到第 80 周。活动集要用此前连续 20 周来定义,更早的周次还凑不齐一个完整窗口。纵轴是归一化后的平均容量。归一化用来减轻不同采集方式造成的尺度差别,具体算法在补充说明里;图上能核对的是,曲线贴着 1,而 1 是容量不变的参照。Lifelog 和 MDC 大约追踪 19 个月,CNS 为 24 个月,都盖得住这条横轴的大部分;RM 只有大约 9 到 10 个月,短于 80 周,不能把四条线都理解成同样长度的观测。
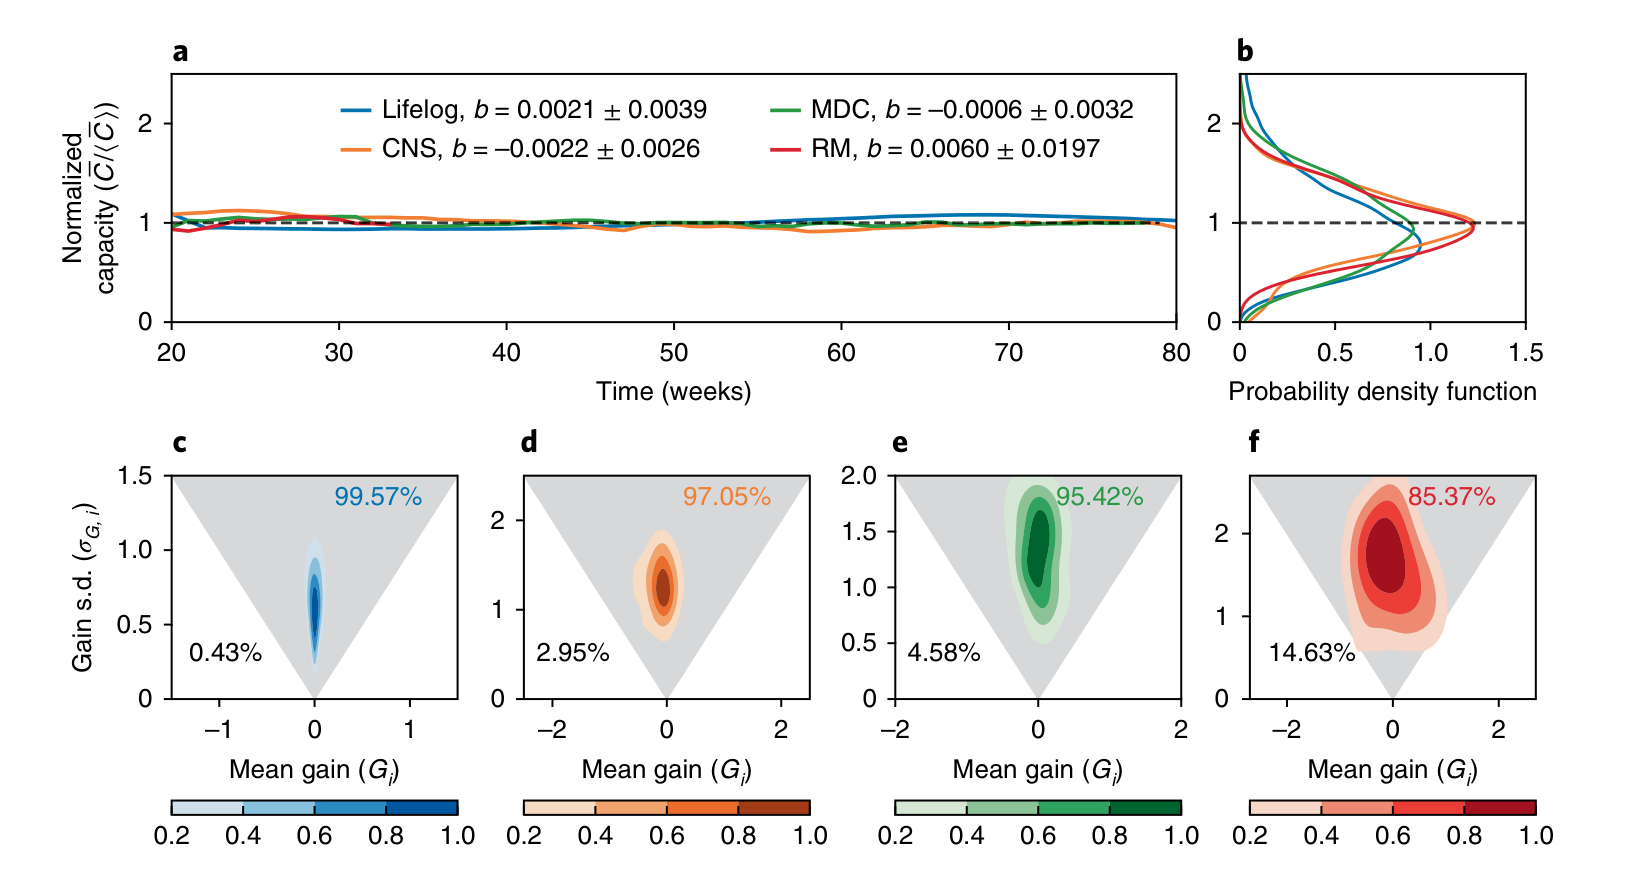
图 2|活动集的个数是否守恒,守恒发生在群体上还是个人身上?
(a)四组平均归一化容量随时间的变化,横轴为第 20 周到第 80 周,纵轴为 C/⟨C⟩。黑色虚线是不变参照。图例中的 b 是线性拟合斜率,单位是归一化容量每周的变化,四组不确定区间都包含 0。(b)个人平均容量的概率密度。横轴是密度,纵轴刻度为 0 到 2,虚线在 1。四组都在 1 附近最密,并向 0 和 2 以上伸展。这里的 1 是样本参照水平,坐标上读不出 25 个地点。(c–f)依次为 Lifelog、CNS、MDC、RM。横轴是平均净增量,纵轴是净增量的标准差;灰色区域满足平均净增量的绝对值小于一个标准差。区域内人数占比为 99.57%、97.05%、95.42%、85.37%,区域外为 0.43%、2.95%、4.58%、14.63%。色条是核密度的累积概率,不是这些百分比。各面板纵轴上限并不相同。来源:原论文 Fig. 2。
线性拟合写成平均容量 = a + b×t。b 与 0 的差别没有超过报告的不确定度。幂律拟合 C̄(t) ∝ t^β 的 β,其不确定区间也同样包含 0:Lifelog 为 9×10⁻⁴±3×10⁻²,CNS 为 −2×10⁻³±6×10⁻²,MDC 为 −2×10⁻⁴±5×10⁻³,RM 为 2×10⁻³±3×10⁻¹。作者还用错误发现率校正后的多重检验比较不同时间的容量分布,没有证据拒绝平均容量不随时间改变。RM 的两条不确定度都比其他三组宽得多,所以 RM 的平坦最不精确。不确定区间包含 0,表示数据没有支持一个清晰的上升或下降,不是证明斜率精确等于 0。
群体平均不动,仍可能是有人的活动集变大、有人变小。个人检验用的是一条描述性规则:若 |Gᵢ| / σ_{G,i} < 1,平均净增量离 0 不到一个标准差,就把它看作与 0 相符。这不是每人一次 p < 0.05 的假设检验。按这条规则,四组分别有 99.57%、97.05%、95.42% 和 85.37% 的人符合。RM 有 14.63% 的人落在外面,是四组里最大的例外。容量在个人层面大体守恒,RM 的支持弱于另外三组。
正文还写道,个人平均容量与其标准差之比 Cᵢ/σ_{C,i} 通常低于 30%,四组为 Lifelog 30%、CNS 28%、MDC 27%、RM 14%,并据此说波动相对较小。按印出的符号,30% 意味着标准差大约是平均容量的三倍多,和波动较小并不是同一个数量关系。正文没有再给出每人的平均值和标准差,因此这里保留符号和四个百分数,不把它们改写成标准差占均值的 30%。
大约 25 这个典型大小,来自时间窗不断加长后的饱和值,并且要按各数据集的时间覆盖做重标度,四组才一致。它是样本的典型规模,不是每个人、每一周都恰好 25 个地点。图 2b 的分布围绕样本均值展开,也说明个人容量有高有低。既有研究区分过返回者和探索者:返回者的特征出行距离主要由少数重要地点之间的移动决定,探索者则涉及更多地点。正文指出探索者的地点容量通常更高。这是容量大小的差别,不取消容量随时间守恒。
CNS 和 Lifelog 还有一项空间上的结果:活动集的回转半径在平均意义上也不随时间变化。回转半径是地点相对活动集重心的典型距离,表示这套地点铺开多大。MDC 和 RM 没有被放进这句结论。重心本身会移动,所以半径稳定也不等于人一直留在同一片街区。
只保留每天的时间约束,容量还会这么小吗?
一周能用的小时数有限,熟悉地点似乎自然不能无限增加。这个解释要求:只要每天内部的停留还在,把天与天之间的顺序打乱,容量也应该同样小。
研究把轨迹切成一天长的小段,再做两种打乱。局部打乱只重排同一个人自己各天的顺序。整体打乱从全体的天数里重新拼序列。一天里面去了哪些地方仍然保留,所以每天可用的时间没有变多。打乱后容量依然不随时间上升,但两种随机序列的容量都显著高于真实序列,检验是科尔莫哥洛夫–斯米尔诺夫检验。正文的概括是,真实容量通常至少比这种只由时间约束预期的结果小 30%。正文没有再分数据集列出比值。30% 的分母是随机化后的容量,不是 25 个地点,也不是前面那个 Cᵢ/σ_{C,i}。
容量可以不变,名单却可以整批更换。杰卡德相似度用来看更换:两份活动集的交集地点数,除以并集地点数。1 表示两套地点完全相同,0 表示没有公共地点。图 3 比较的是相隔 γ 周的两份周活动集,滑动窗口长度为 10 周,短于容量定义里的 20 周。相似度主要随等待时间 γ 变化,不依赖从哪一周起算;季节性会让曲线围绕典型形态波动。
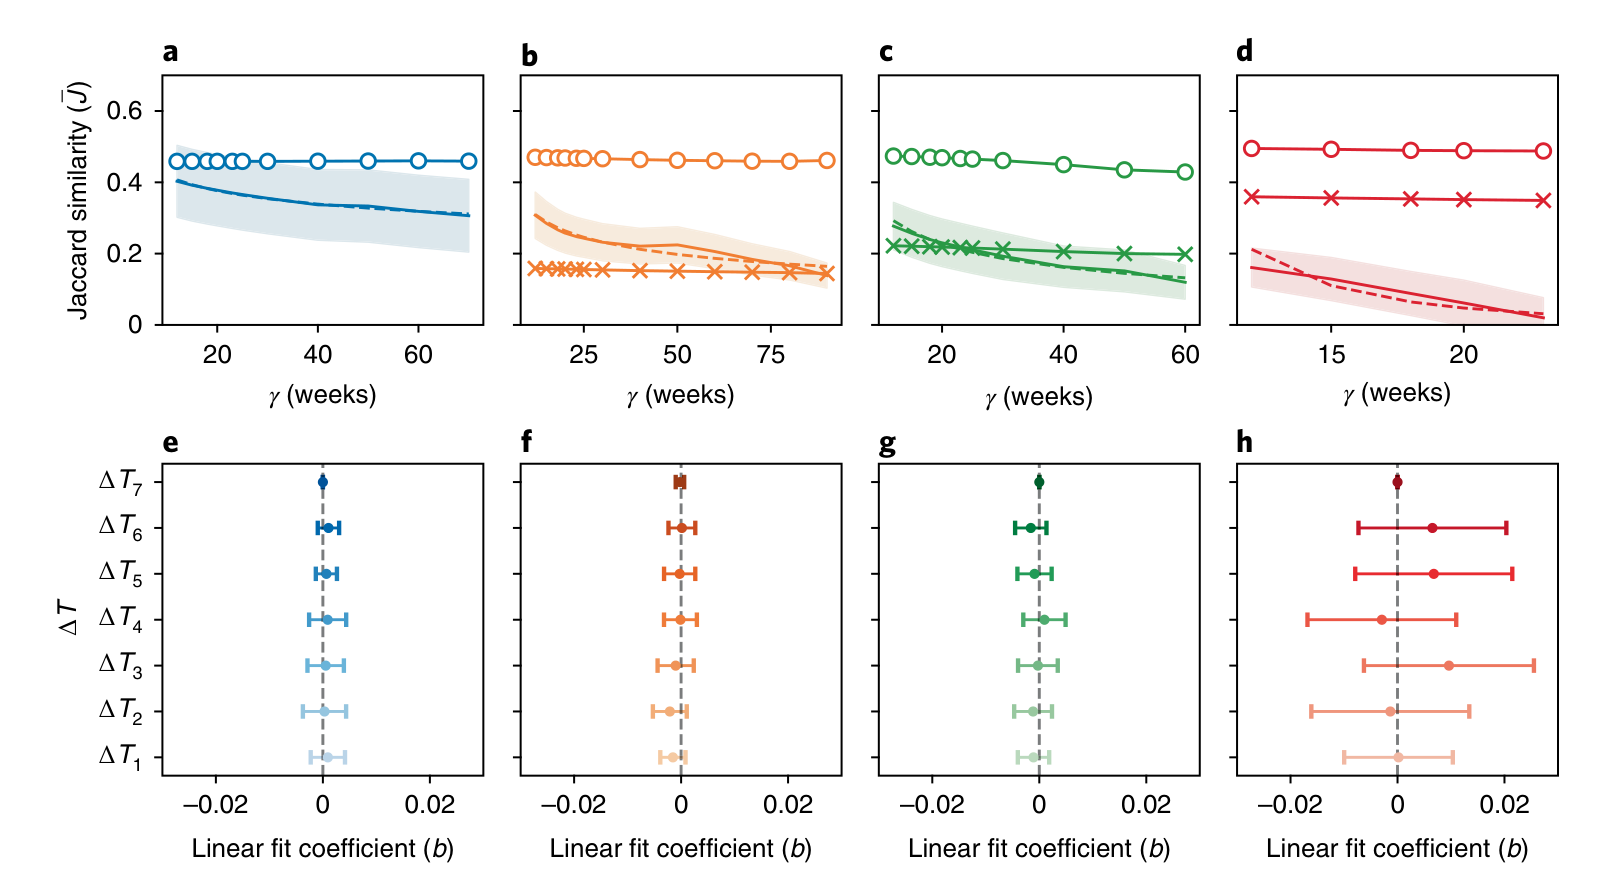
图 3|个数不变时,名单是否在更换,各类停留时长的名额是否也守恒?
(a–d)平均杰卡德相似度随间隔 γ 的变化,依次为 Lifelog、CNS、MDC、RM。实线是观测,圆圈是个人内部打乱天数,叉号是跨人重组天数,阴影是 50% 四分位距,虚线是幂律拟合。Lifelog 没有叉号,因为数据在提供给研究者之前做过匿名化,跨人重组无法进行。观测曲线下降,幂律指数为 Lifelog −0.15、CNS −0.31、MDC −0.49、RM −3.00;随机化曲线不按这个方式下降。四组横轴尺度不同,RM 只画到 20 周附近。(e–h)按停留时长分档后,平均容量对时间的线性斜率。从上到下是每周 48–168 小时到 10–30 分钟共七档。点和误差线覆盖 0,RM 的误差线更宽。来源:原论文 Fig. 3。
四组观测相似度都随 γ 下降,但指数相差很大。RM 的 −3.00 不能拿来代替 Lifelog 的 −0.15,RM 的横轴也短得多。随机化序列的相似度不随时间下降,对应的幂指数为 0;作者的解释是,打乱之后熟悉地点不会被放弃。叉号相对实线的高低在各数据集里并不相同,不能把某一组随机化曲线的位置当成通用基线。
因此,真实数据里的守恒不是一张冻结的名单。新地点按希普斯曲线进入人生履历,其中大约 7%–20% 进入活动集,同时有熟悉地点退出,个数才保持住。活动集的重心还会移动。大小守恒、组成更换、空间位置可以漂移,是三件同时发生的事。
停留时长也被分成七档:每周 10–30 分钟、30–60 分钟、1–6 小时、6–12 小时、12–24 小时、24–48 小时、48–168 小时。最短一档,正文用公交站或杂货店的停留来帮助想象;最长一档,正文以住家为例。研究没有逐个地点做土地利用分类。每一档里的地点个数分别守恒,总容量等于各档容量之和。具体地点仍在各档内部更换。守恒的是每个时间预算档有几个名额,不是某个名额永远属于同一家店。
旧模型能保住个数,为什么保不住名单的更换?
探索与优先返回模型里,人如果不去新地点,就按过去的到访次数回到旧地点:去得越多,被选中的机会越大。另一种模型提高最近到访地点的返回概率。正文说,这些模型能重现地点容量的守恒,也就是图 2 的平坦,却不能重现图 3 里活动集随时间的更换。
修改只加一条有限记忆:返回某地的概率不再使用全部历史到访,而使用过去 M 天里的到访次数。正文报告,这一改动在性质上重现了包括长期更换在内的观测,并说因此可以改进已有模型的预测。正文没有给出 M 的天数,也没有给出误差下降的百分比。性质上相符,不是证明有限记忆是唯一机制。
地点容量和联系人数,是同一个上限吗?
社交研究里的邓巴数,被正文说明为一个人社会关系数量的认知上限。本文没有测量这个社会关系上限本身,而是检查地点容量是否和社交圈大小一起变化。社交圈按 20 周内联系过的人计算,电话和短信分开,不把通话次数当成人数。
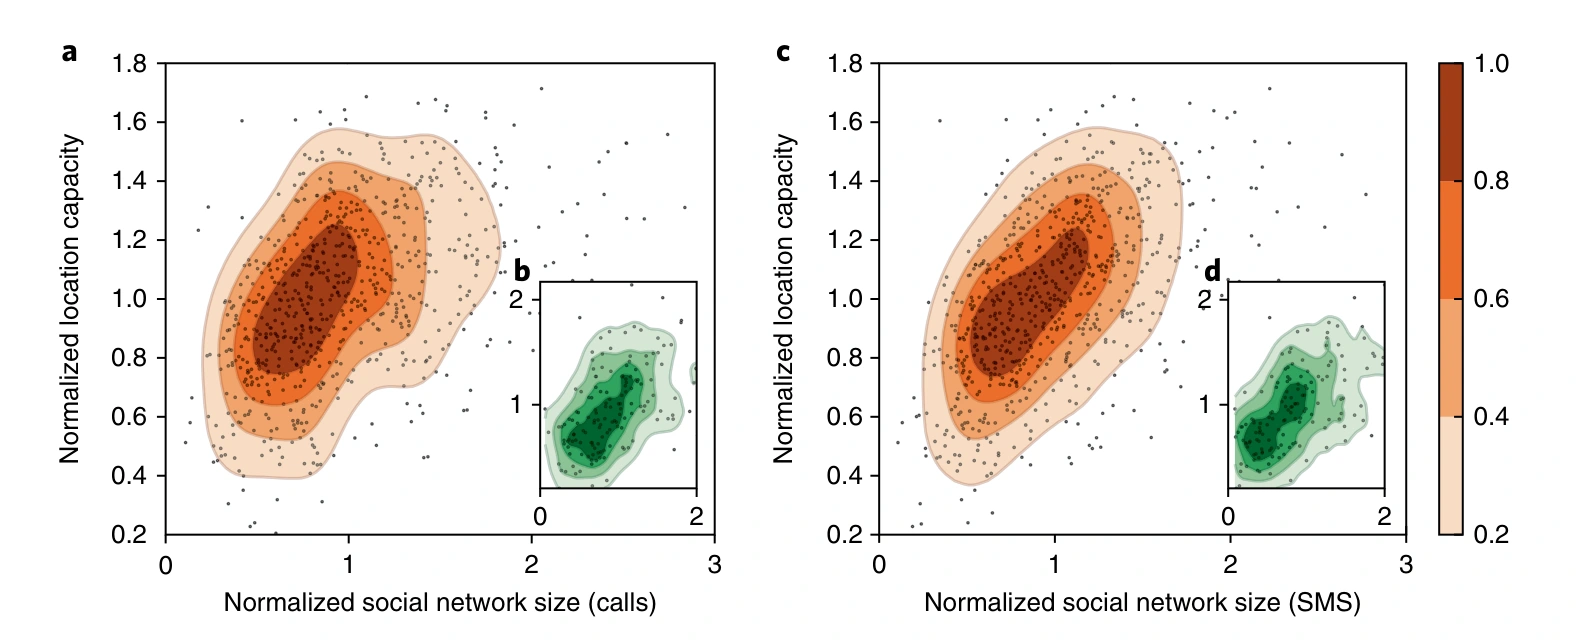
图 4|地点容量较大的人,是不是也联系更多人?
(a、b)纵轴为归一化地点容量,横轴为电话联系人数除以该数据集的平均人数。(c、d)横轴改为短信联系人数,归一化方式相同。大图 a、c 是 CNS,纵轴约 0.2–1.8,横轴 0–3;小图 b、d 是 MDC,两个轴都约为 0–2。黑点是个人,色块是高斯核密度的累积概率,只用于显示聚集,颜色不是第三个行为指标。四团点都沿右上方向延伸。正文给出的皮尔逊系数为 a 0.31、b 0.48、c 0.52、d 0.54,双尾 p 值都小于 10⁻¹³。来源:原论文 Fig. 4。
1 表示各自样本的平均水平。CNS 的 1 和 MDC 的 1 不是同一批地点、也不是同样多的联系人,不能把两个面板的坐标当成可以相加的绝对个数。系数从 0.31 到 0.54,都是正相关,也都远不能由一个数量推出另一个数量。p 值很小,是因为 CNS 有数百人、MDC 也有约 185 人,中等强度的线性相关同样可以很显著。RM 虽有社交记录,图 4 没有给出它的系数。Facebook 的结果被放在补充图中,正文没有写出对应系数。
CNS 里,地点容量与外向性的皮尔逊相关为 0.22,双尾 p 值小于 10⁻⁹;社交网络规模与外向性的相关为 0.40,双尾 p 值小于 10⁻²⁸。外向性来自问卷,不是从轨迹里算出来的。两项相关都只说明外向性较高的人倾向于两边都更大,没有实验去改变性格或社交圈。正文把这些结果看成进一步比较空间行为与社会行为的理由,没有说 25 个地点就是邓巴数,也没有证明两者受同一个认知上限约束。
时间约束检验已经排除一个较窄的解释:容量偏小,不全是因为一天只有那么多小时。这仍然不是认知机制的直接测量。相关、随机化对照和性格问卷回答的是不同问题,不能叠成一条因果链。
这些守恒量可以说到哪里?
可以稳定说的是:在这四组长达数月到两年的轨迹里,滚动窗口中的熟悉地点个数大体守恒,累计去过的地点却继续亚线性增加,名单组成随间隔变淡,各停留时长档的名额也分别守恒。真实容量小于只保留每日结构的随机化容量。有限记忆能在性质上补上旧模型缺少的长期更换。
不能据此说每个人永远维持 25 个地点。25 是加长时间窗并做时间覆盖重标度后的典型饱和值。图 2b 显示个人平均容量分布在样本均值两侧。RM 只有 85.37% 的人落在一个标准差规则内,斜率的不确定度也最大。
样本也不是一般人口。CNS 和 RM 是学生和校园职员,合计约 2%,日程受学期约束。Lifelog 是主动使用记录应用的人。MDC 是日内瓦湖区的志愿者。四组结果方向一致,降低了某一所大学造成全部结果的可能,但没有给出按城市、职业或年龄分层后的容量。
位置来自 GPS、Wi-Fi、基站和 GSM,地点定义依赖 10 分钟、两次到访和 20 周这些门槛。作者报告结果对窗口和地点定义是稳健的,但那些检验不在正文图里。观测相关不是干预效果。模型在性质上重现曲线,不是证明人真的只记得 M 天。城市发展和疫情传播被写成可能受影响的问题,本文没有做相应检验。
以上数量都是样本中的统计结果。RM 有公开数据入口,MDC 需向研究机构申请,CNS 和 Lifelog 的原始轨迹不公开。代码需向通讯作者索取。
一句话总结
人不断把新地点加进自己的履历,但任一时期反复使用的熟悉地点保持在一个有限而稳定的份数上;这份数会更换成员,也不能只靠每天的小时数解释。
核心来源
- Nature Human Behaviour 正式版,核对题目、作者、2018年6月18日在线发表、2018年7月卷期页码 2:485–491,以及正文图 1–4。
- 同一 DOI 下的补充信息。随机化的分数据集比值、记忆长度 M 和 Facebook 相关写在补充材料中,正文没有给出这些数字。
- 数据入口以论文方法为准:RM 见麻省理工人类动态实验室公开页面,MDC 见 Idiap 研究机构的申请入口,CNS 与 Lifelog 原始轨迹不公开。
作者介绍
以下只写论文署名、作者贡献和致谢里能够核对的信息。
- Laura Alessandretti:署名伦敦城市大学数学系与丹麦技术大学。参与研究设计、数据预处理、全部数据分析、结果分析和论文写作。
- Piotr Sapiezynski:署名丹麦技术大学。参与数据预处理。
- Vedran Sekara:署名丹麦技术大学与瑞典隆德的索尼移动通信。参与数据预处理。致谢写明他得到索尼移动通信的支持。
- Sune Lehmann:署名丹麦技术大学与哥本哈根大学尼尔斯·玻尔研究所,通讯作者。参与研究设计、结果分析和论文写作。致谢列出他主持或共同主持的项目,包括 Villum Foundation 的 High Resolution Networks、UCPH-2016 计划中的 Social Fabric,以及丹麦独立研究基金的 Microdynamics of Influence in Social Systems(资助号 4184-00556)。
- Andrea Baronchelli:署名伦敦城市大学数学系,通讯作者。参与研究设计、结果分析和论文写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若每一档停留时长的名额都守恒,新设施要进入某人的活动集,就得替换同一时间档里的旧地点。每周停留几十分钟的新店,竞争的是其他短停留名额,不是住家所在的最长那一档。因此,一条新商业街更可能改变人去哪几家店,而不是把每个人的熟悉地点总数提高一截。这需要用设施出现前后的分档容量来检验,不能从本文的拟合直接推出商店选址。
疾病传播或设施规划若只复现累计地点的希普斯曲线,会让可接触地点一直变多;若把熟悉地点冻结住,又会错过杰卡德相似度的下降。更贴合本文证据的检查是同时保住个数、更换速度和分档名额。四组更换指数从 −0.15 到 −3.00,还不能借用一个城市的指数去填另一个城市。
另一个边界是搬家或转学。本文的平坦容量来自持续数月到两年、且 CNS 与 RM 还共享学期节奏的轨迹。若一次居住地变更先打散活动集、再在新环境里回到相近的份数,守恒的就是一个目标规模,而不是一条从第 20 周到第 80 周都不弯的曲线。现有证据还没有回答哪一种情况会发生。