远处的搬家更少,是人不想去,还是那里本来就没有地址?
论文名片|Louis Boucherie、Benjamin F. Maier、Sune Lehmann,Decoupling geographical constraints from human mobility,Nature Human Behaviour,2025,9:2564–2575,2025年9月1日在线发表。DOI:10.1038/s41562-025-02282-7。
一座半径 10 公里的岛,岛上的住址再怎么搬,距离也到不了 20 公里开外,因为再远是海。两栋房子也不能叠在同一个点上,所以任何一次搬家都有一个最短距离。这些限制写在地图上。
直接数各个距离上有多少次搬家,会把两件事记在同一条曲线里:相隔这么远的地址对本来有多少,以及在这些地址都存在的条件下,这一距离上的相对强度有多大。丹麦登记的地址变更可以把二者拆开。拆开之后,全国合计的相对距离倾向在大约 10 米到数百公里上接近 1/r;单座城市通常是两段幂律,城内较缓、出城较陡。实际走过某一距离的次数,仍然要再乘上该距离有多少地点对。
先说结论
- 丹麦 1986–2020 年有 39,297,646 次不同地址之间的居住地迁移。实际移动距离分布除以地点对距离分布后,最大似然指数是 0.98;扩展数据表 1 的拟合窗是 10 米到 475,032 米。正文把这一段概括为 10 米到 500 公里,横跨五个数量级。
- 休斯敦、旧金山、新加坡的签到移动,指数分别是 0.95、0.94、0.89;法国城际搬家是 1.07。五组数据的最短距离、最长距离和表中的样本量 n 并不相同。法国从 3,000 米起算。新加坡在表里的 n 是 15,167,方法正文里的移动次数是 79,624。
- 把相对距离倾向固定成 1/r,只改地点怎么摆,模拟出来的观察曲线就会分开。1 公里以内,真实丹麦的地点对分布贴近保留城市内部结构的圆盘地图;10 公里以外,贴近保留国土轮廓和城市位置、城市内部改成均匀的地图。
- 论文所写的 1,400 座丹麦城市,各自的相对距离倾向是分段幂律。前一段指数的均值是 0.60、标准差 0.20,后一段均值是 2.0、标准差 0.21。用这两段的均值、城市尺度和随机的城市位置做模拟,可以再装配出全国的 1/r。这是在这些假设下的重建。
一条搬家距离曲线,里面叠了哪两件事?
这里的人类移动性(human mobility)分两种记录。居住地迁移是地址变更;日常出行在本文里是兴趣点之间的签到移动,签到覆盖不了全部真实出行。分析单位是距离 r 上的群体分布,主结果不跟踪某一个人的行程。
实际移动距离分布 f(r) 统计观察到的搬家或签到落在各距离上的密度。地点对距离分布(pair distribution function,p(r))统计相隔距离 r 的地点组合有多少。它统计的是地址、建筑或兴趣点之间的距离组合,陆地轮廓、湖河和建筑不能重叠都会进入这条分布。人口数和实际搬家次数是另外两个量。
若从地点 x 到地点 y 的倾向只取决于二者的直线距离,这个倾向就可以从积分里提出来,于是
f(r) 正比于 π(r) × p(r),也就是 π(r) 正比于 f(r) / p(r)。
π(r) 是相对距离倾向(intrinsic distance attractiveness)。它是地点布局已经定下来之后、群体平均的相对强度。方法里与“机会”对应的那一项,是两端地点密度的乘积,也就是预期有多少地点对;住房是否空着、价格多少、有没有被人认真考虑,都没有逐条测量。
距离用的是投影平面上的欧氏距离,也就是地图上的直线距离。丹麦点位用 EPSG:23032,法国用 EPSG:27561。这个 r 不是沿路里程,也不是通勤时间。
丹麦数据来自统计局 Befolkning 登记。1986 年到 2020 年,不同地址之间的居住地迁移共 39,297,646 次;2,345,453 栋建筑构成 3,251,464 个地址。正文把地址数四舍五入写成约 330 万。地址坐标定在建筑入户门,精度优于 ±2 米。不满一周的居住记录被排除,共 4,034 条,不到全部记录的 0.1%。摘要把这段时间写成 36 年,报告摘要写成 35 年,讨论写成 34 年的合计时段;下面的次数和起止年以方法中的登记窗口为准。这套登记按丹麦规定应覆盖居民的地址变更,原始数据不公开,研究用途可向统计局申请。城市采用丹麦统计局的划分。
法国建筑坐标来自 Base Adresse Nationale,共 21,567,447 栋。住房数量来自 FiLoSoFi 的 200 米网格,再按集合住宅单元均匀分下去,得到 34,041,910 个地址。地址数来自这一分配,集合住宅内部并没有逐套实测的门牌坐标。迁移数据来自 INSEE,2016–2020 年城际迁移 40,465,288 次,距离从城市中心到城市中心,中心是所含地址的质心。短于法国最大城市尺度的距离被去掉,因此法国结果不包含城内搬家。
日常出行来自 Foursquare 公开签到,时间是 2010 年 5 月 27 日到 11 月 3 日,合计 239,788 次移动、43,395 个地点。三座城市把这两笔总数用完:休斯敦 47,996 次移动、11,808 个地点;新加坡 79,624 次移动、15,617 个地点;旧金山 112,168 次移动、15,970 个地点。签到者是当时公开分享位置的用户,这一组和丹麦全登记人口不是同一个总体。
同一条 1/r,换一张地图,观察到的曲线为什么会变?
先看一个圆盘上的示意,再看三张用丹麦地址做成的地图。示意说明:某一距离上如果没有地点,这一距离的移动就不可能发生。三张地图则把同一条假设的相对距离倾向放进不同的地点布局,看观察到的 f(r) 会不会分开。
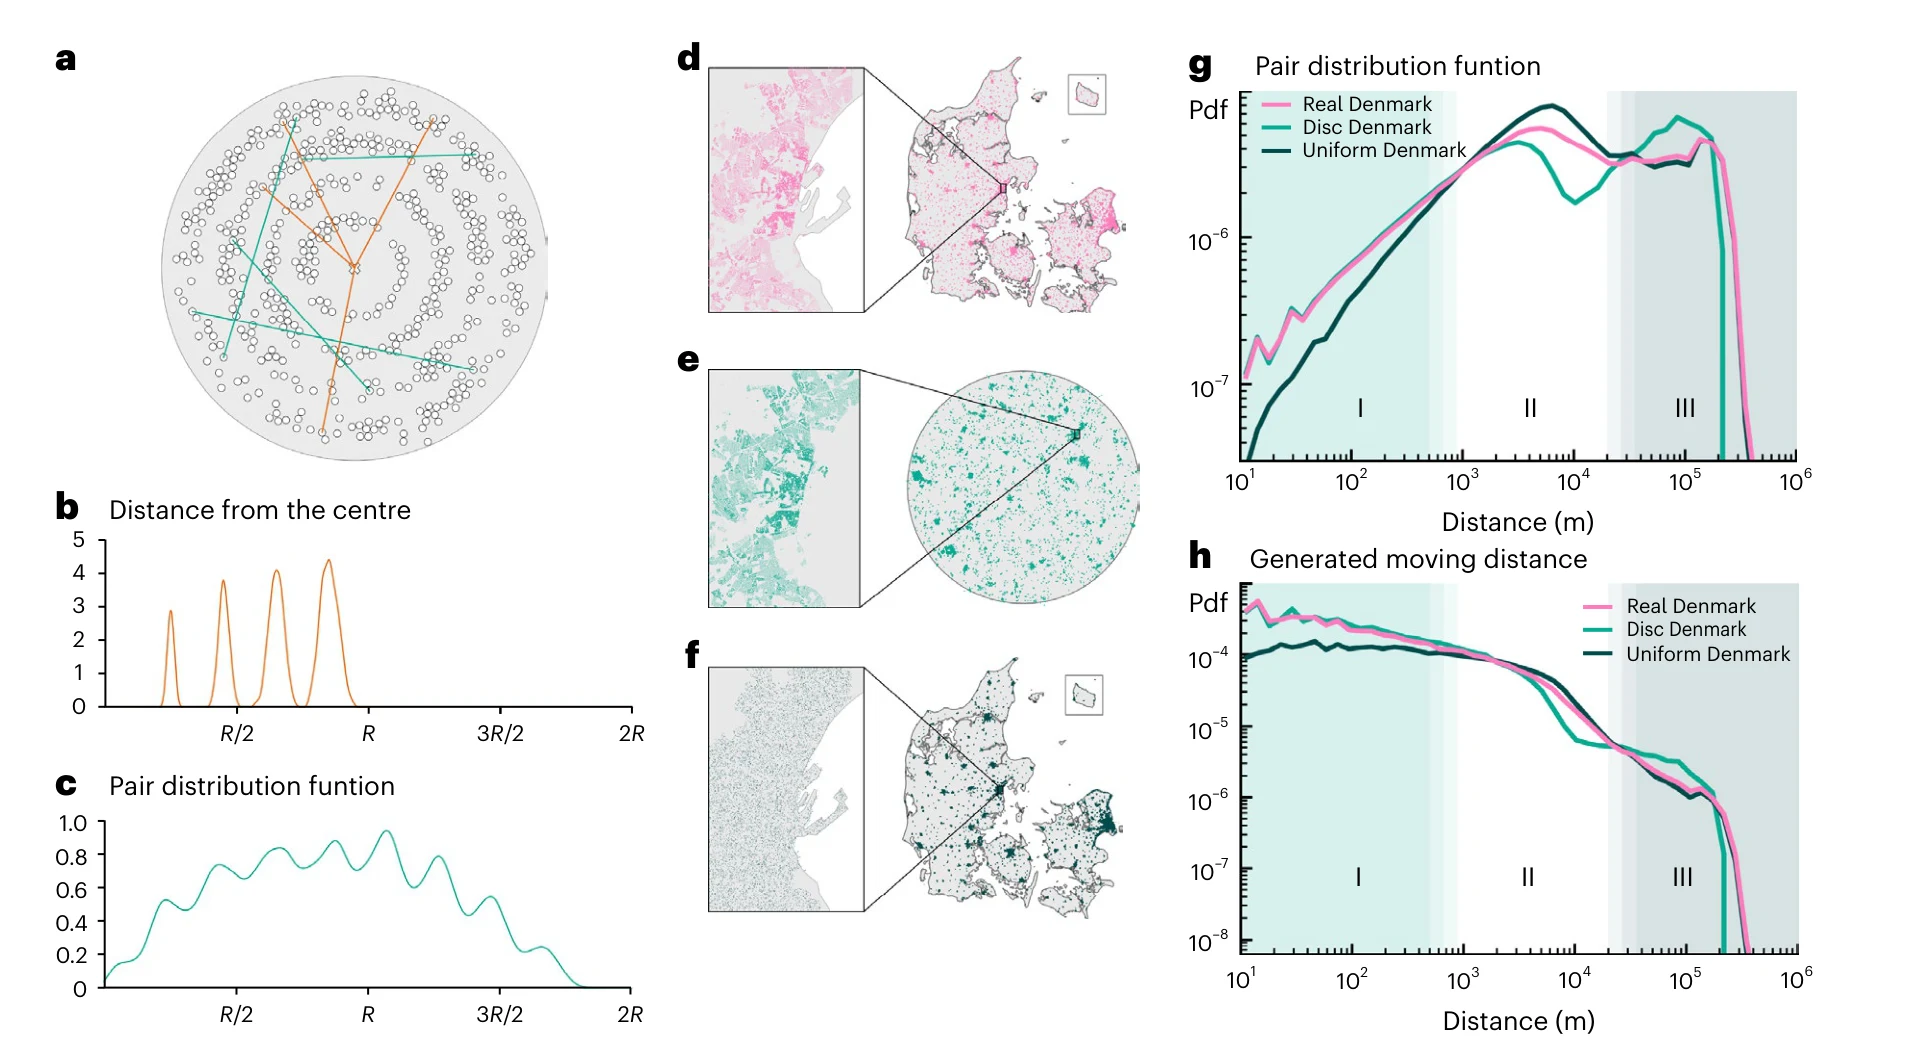
图 1|地点布局不变时,观察到的距离曲线会不会仍随地图改变?
(a)圆盘上的同心圆点位是示意,白叉是圆心。(b)只从圆心看出去,距离分布在若干半径上出现尖峰;缺一圈点,对应距离就没有移动可走。(c)把每个点都当作一次起点,再平均,就得到地点对距离分布;它比(b)平滑,因为计入了全部点对。(d)真实丹麦,使用真实国土和约 330 万个地址。(e)圆盘丹麦:城市内部结构保留,城市中心被随机放到一个圆盘上,陆地轮廓随之改变。(f)均匀丹麦:国土轮廓和城市位置保留,城市内部改成均匀点位。(g)三条地点对距离分布。粉红是真实丹麦,青绿是圆盘丹麦,黑色是均匀丹麦;I、II、III 分别是城内、城市尺度和城际。1 公里以内,真实丹麦贴近圆盘丹麦;10 公里以外,真实丹麦贴近均匀丹麦。(h)三条地图都强加 π(r) = 1/r 之后,模拟得到的观察距离曲线仍然分开。来源:原论文 Fig. 1。
(g)里,短距离的地点对分布主要带着城市内部的摆法,长距离主要带着陆地形状和城市落在哪里。(h)只改了地点布局,倾向被设成同一条 1/r。布局本身就足以把观察到的距离曲线拉开。丹麦登记搬家去除 p(r) 之后的指数,留到下一节。
除掉地点布局之后,五个地方还剩下什么?
丹麦的做法是把登记搬家的 f(r) 除以全部地址的 p(r)。比值在双对数坐标上接近一条下降的直线。最大似然给出 s = 0.98,也就是 π(r) = 1/r^s,非常接近事先写下的 1/r。正文写的区间是 10 米到 500 公里。扩展数据表 1 把拟合上界记成区域直径 475,032 米,下界 10 米。正文把 10 米到 500 公里这一窗口称作五个数量级。
同一除法用到另外四组数据上,得到的仍是随距离下降的幂律,指数却不是同一个数。各组纵轴范围不同,因为区域大小不同,不能拿概率密度的绝对高度跨图比较。
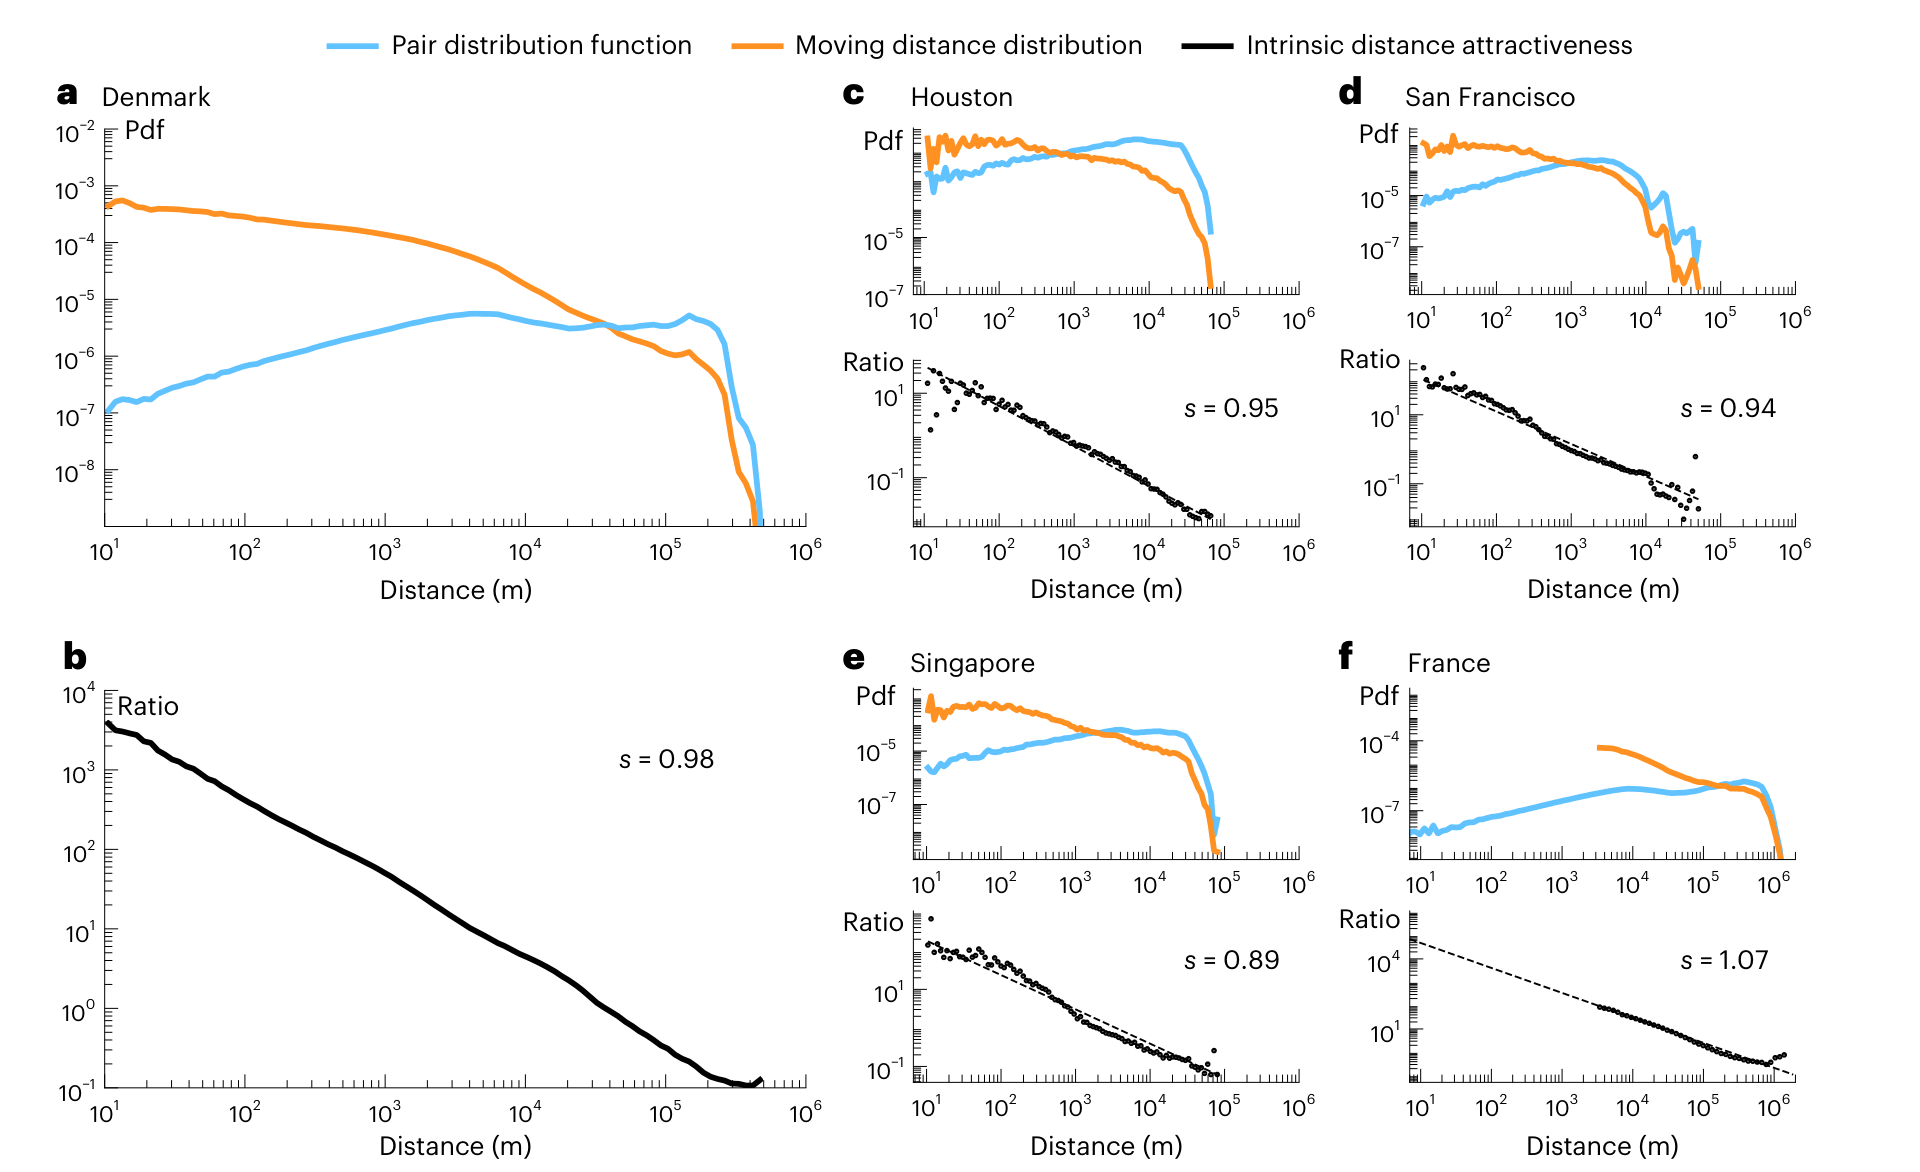
图 2|除掉地点对的多少之后,相对距离倾向是不是一条幂律?
(a)丹麦,整幅都是两条密度:蓝色是地点对距离分布,橙色是实际移动距离分布。短距离上橙色更高,蓝色从很低的密度往上走,到 10^5 米这一量级两条曲线靠近并下降。(b)整幅都是相除之后的比值,黑色曲线从约 10 米延伸到数十万米,最大似然指数 s = 0.98。(c)休斯敦签到,上半是两条密度,下半是比值,s = 0.95。(d)旧金山,排列与(c)相同,s = 0.94。(e)新加坡,s = 0.89。(f)法国城际搬家,s = 1.07;橙色移动曲线大约从 10^3 米才出现,短于法国最大城市尺度的距离没有纳入。来源:原论文 Fig. 2。
扩展数据表 1 给出每次拟合的样本量、距离窗、指数、Kolmogorov–Smirnov 统计量和 p 值。距离单位是米。这里的 p 沿用 Clauset 等人的拟合检验:p 小于或等于 0.1,他们认为幂律模型站不住;p 大于 0.1,偏差仍可能来自随机波动。所以表里的 p = 0.99 是“没有把幂律排除”,普通假设检验里的“效应显著”是另一种读法。指数接近 1 时,常用的无上界估计会偏,因此作者把幂律限制在 xmin 和 xmax 之间,xmax 取该区域最远两点的距离。
| 类型 | 数据 | n | 最短距离 | 最长距离 | 指数 | KS | p |
|---|---|---|---|---|---|---|---|
| 居住地迁移 | 丹麦 | 39M | 10 | 475,032 | 0.98 | 0.01 | 0.99 |
| 居住地迁移 | 法国 | 40M | 3,000 | 1,134,667 | 1.07 | 0.01 | 0.98 |
| 日常出行 | 旧金山 | 112,168 | 10 | 55,639 | 0.94 | 0.07 | 0.96 |
| 日常出行 | 休斯敦 | 47,996 | 43 | 71,209 | 0.95 | 0.03 | 0.98 |
| 日常出行 | 新加坡 | 15,167 | 10 | 79,674 | 0.89 | 0.12 | 0.67 |
| 地理 | 城市半径 | 1,367 | 2,878 | 无 | 3.05 | 0.58 | 0.11 |
丹麦的 39M、法国的 40M 是表中的四舍五入,分母分别对应前面的 39,297,646 次地址间迁移和 40,465,288 次城际迁移。旧金山的 112,168、休斯敦的 47,996 与方法中的移动次数一致。新加坡这一行的 n 是 15,167。方法中的新加坡是 79,624 次移动、15,617 个地点。15,167 与这两笔都不相同,正文没有说明表中的 n 采用哪一个口径,因此不能把 0.89 的分母说成 79,624 次移动。休斯敦的最短拟合距离是 43 米,五组数据也不是都从 10 米开始。
扩展数据表 2 是幂律相对另外三种厚尾分布的对数似然比。正数表示幂律的似然更高,负数表示对照分布更高。
| 数据 | 相对对数正态 | 相对指数分布 | 相对 Weibull |
|---|---|---|---|
| 丹麦居住地迁移 | 128,697 | 19,209 | 89,676 |
| 法国居住地迁移 | 5,042 | 411 | 18,535 |
| 旧金山 | 1,091 | 91 | 2,001 |
| 休斯敦 | 446 | 35 | 2,946 |
| 新加坡 | 729 | 104 | 3,651 |
| 移动城市半径 | −0.96 | 1.91 | 1.18 |
前五行里,幂律的似然高于对数正态、指数分布和 Weibull,所以在这三种对照中,下降的幂律更贴合相对距离倾向。这是分布之间的似然比较。最后一行是移动城市半径,放到城市尺度再看。
地理一行的城市半径也要分开。n = 1,367,最短半径 2,878 米,没有上界,指数 3.05,KS = 0.58,p = 0.11。p 刚好过他们自己的 0.1 线,KS 已经达到 0.58,幂律对这批半径贴合得很差。3.05 是半径分布上的指数,和搬家倾向的 0.98 不是同一个量。
地点本身为什么会在近处密、在远处按幂律铺开?
相对距离倾向来自实际移动除以 p(r),所以先要看清 p(r) 自己的形状。丹麦住宅地点的地点对距离分布分成三段。约 25 米以内,近邻密度近似线性上升,并带着振荡。约 25 米到约 200 米,建筑按 r^0.67 增长;地址的这一段可以延续到约 4,000 米。再往外,增长停住、迅速下降,到国土尺度趋于零。公寓这类建筑在数据里是叠在同一位置上的多个地址。
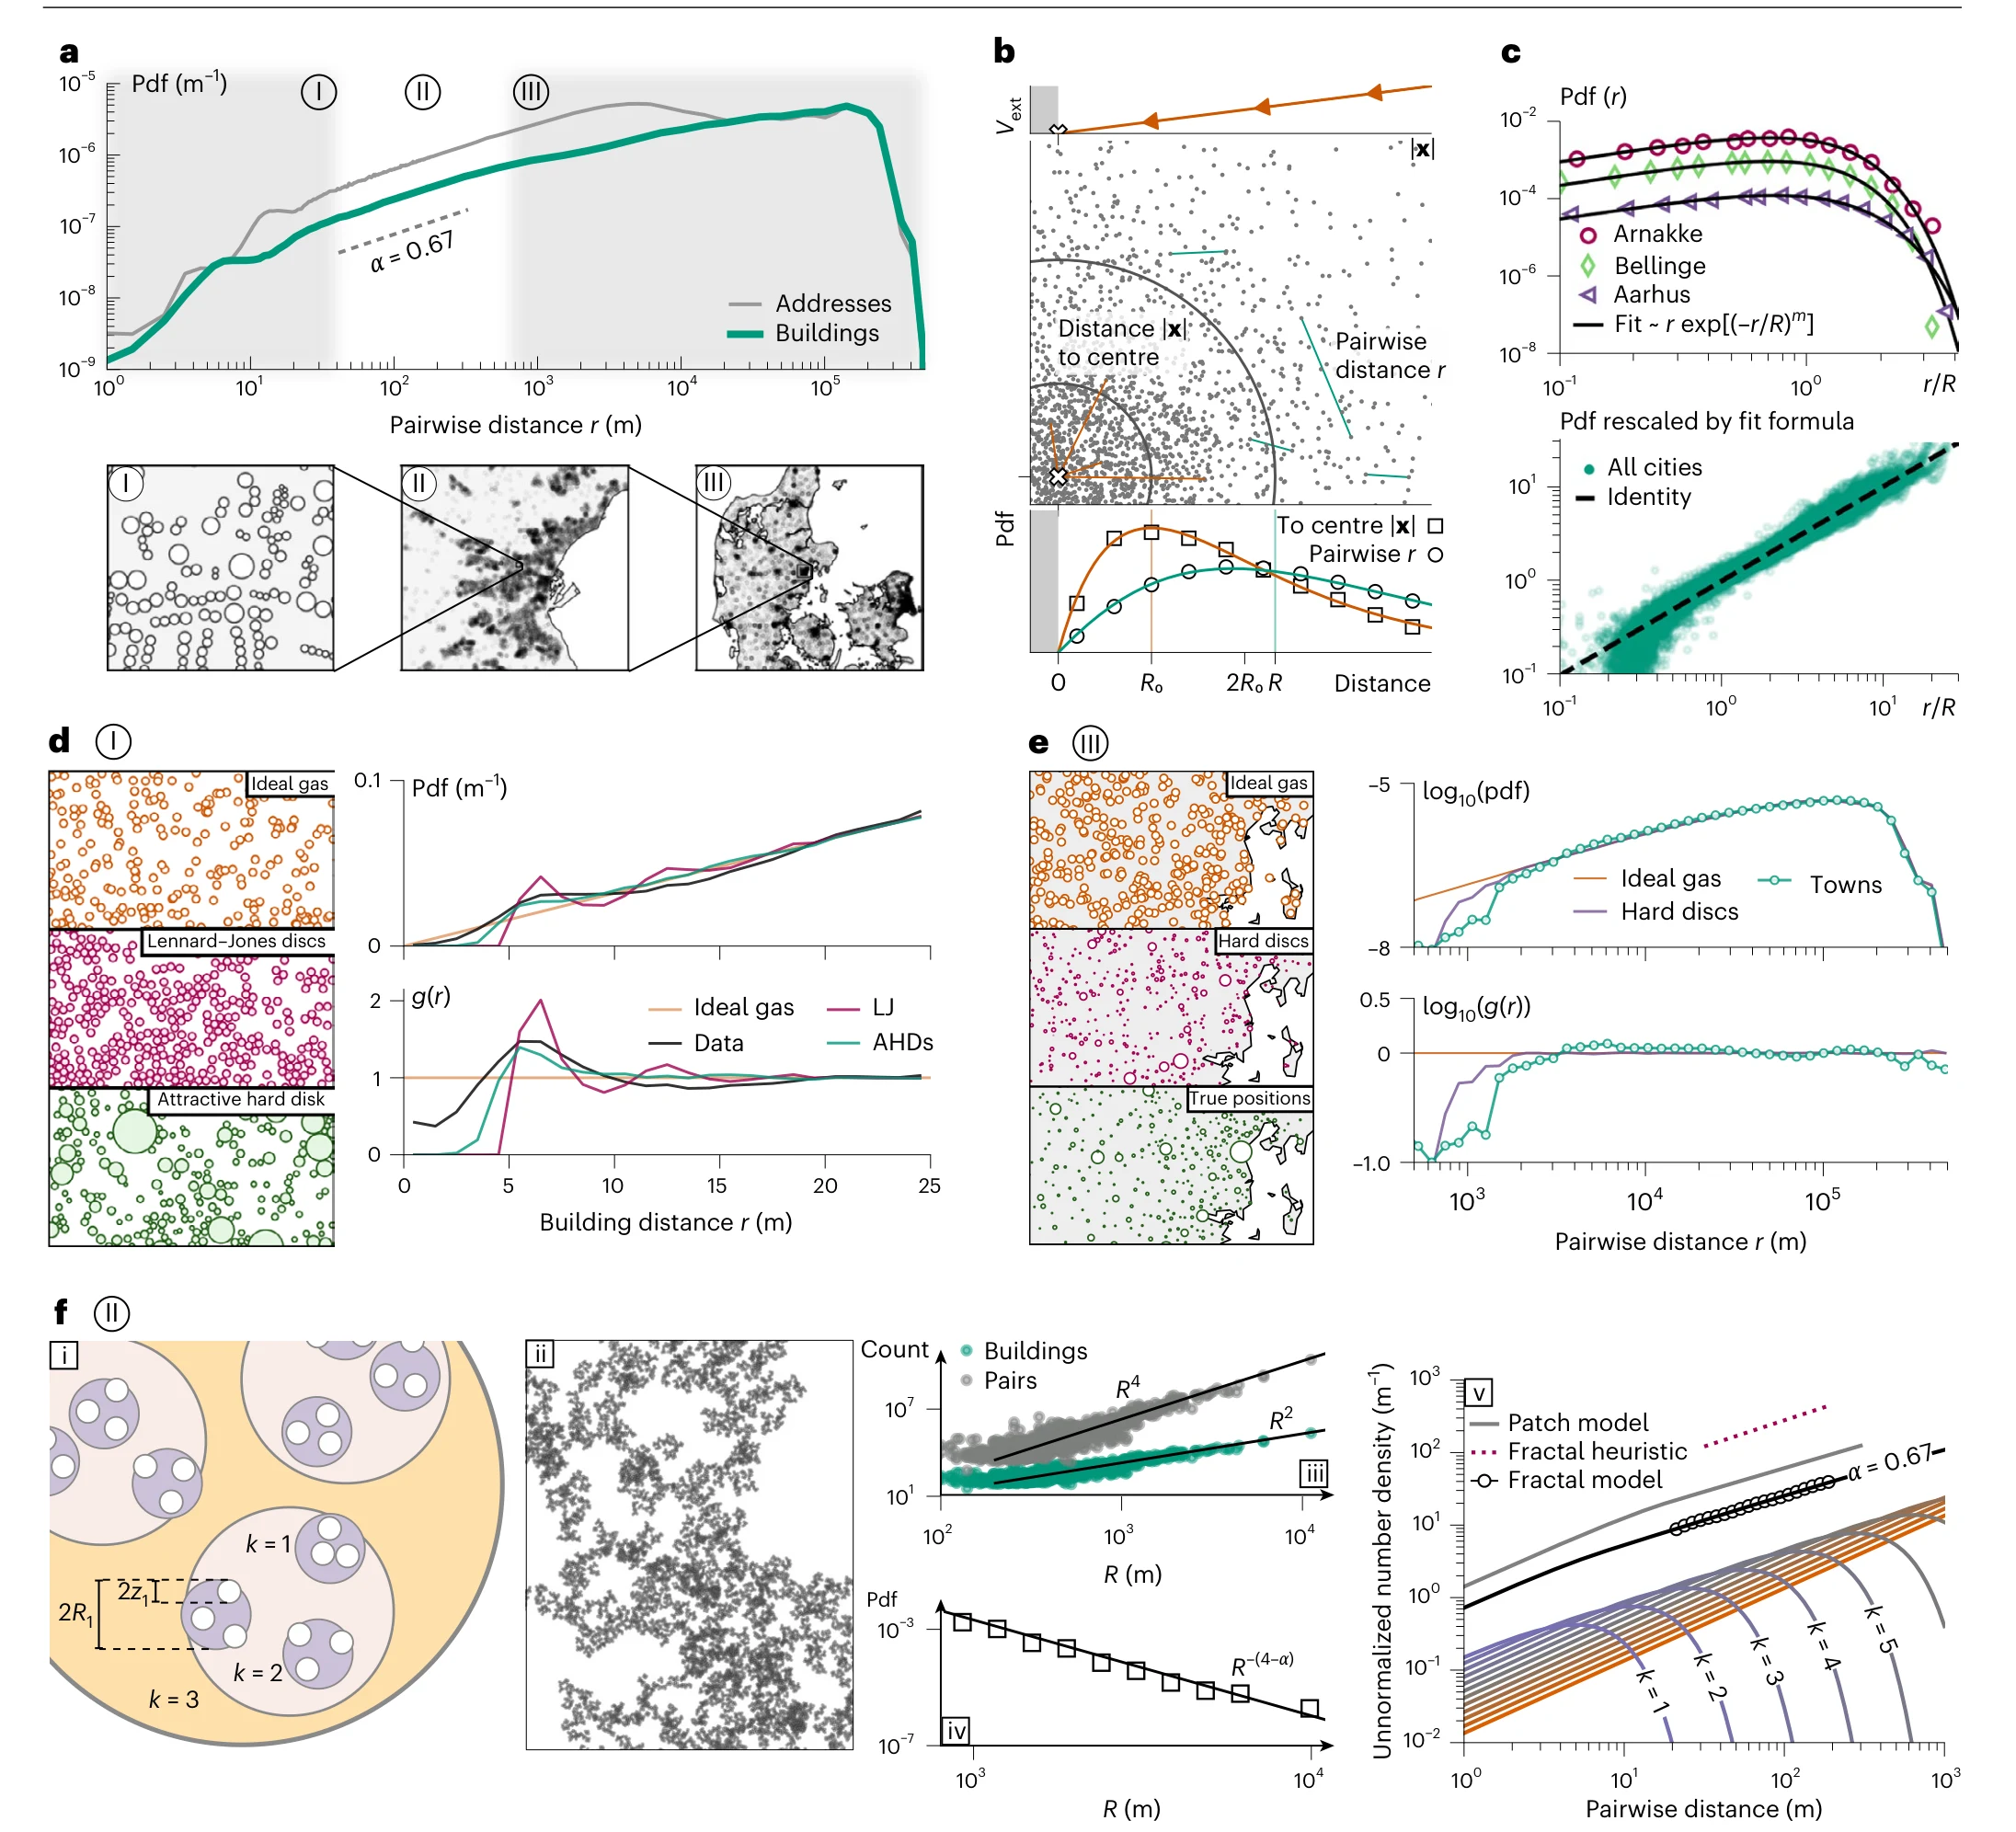
图 3|住宅地点的距离结构,能否用简单的粒子图像复述出来?
(a)地址(灰)和建筑(青绿)的地点对距离分布。I 是近邻,II 是城市中尺度并标出 α = 0.67,III 是国家尺度;下方小图是三个尺度的空间样子。(b)离市中心越远、外部势能越高。理想气体在这个势能下,到中心的距离呈 Erlang 分布;对应的地点对距离分布接近广义伽马分布,尺度 R 被用来定义城市半径。(c)上图是 Arnakke、Bellinge、Aarhus 三座城镇的最大似然拟合;下图把丹麦城镇按 r/R 重标度后靠近同一条曲线,短距离仍有偏离。(d)微观尺度上,真实建筑、理想气体、Lennard–Jones 圆盘和大小不一的吸引硬圆盘都有线性起步和振荡。对关联函数 g(r) 在约 4 米内低于 1,约 6 米处高于 1。(e)城镇尺度:理想气体线性上升;不吸引的硬圆盘和真实城镇在约 1 公里内都缺少邻居,之后 g(r) 很快回到 1 附近。(f)分形与斑块。i 是一层套一层的斑块,每层 b 个子斑块、填充率 θ;ii 是 b = 4、z₁ = 3 米、θ = 0.8、L = 8 的一个样本;iii 中建筑数约按 R²、建筑对约按 R⁴ 增长;iv 中半径分布的尾部按 R^−(4−α) 下降,α = 0.67;v 中斑块模型、分形启发式和分形模型都能回到数据里的 α = 0.67,启发式在图注中等于 0.72。来源:原论文 Fig. 3。
城市尺度的出发点是二维理想气体,再加一个随到中心的距离线性升高的代价。没有相互作用时,房屋到中心的距离密度正比于 r exp(−βγr),这是形状参数为 2 的 Erlang 分布。方法把该分布的尺度 R₀ 记成城市半径的一半。地点对距离分布则用广义伽马分布去拟合,尺度参数 R 就是从这个分布读出的城市半径,不必先指定一个市中心。超过 30 栋建筑的城镇做了最大似然拟合。(c)的下图说明,用各自的 R 缩放之后,多数城镇落在相近的曲线上;短距离的偏离,对应(a)里那种慢于线性的中尺度。
近处的振荡被解释成两种有效作用叠在一起:房子不能占据同一块地,所以有排斥;靠得较近可以共享设施,所以有有效吸引。Lennard–Jones 圆盘,以及半径不齐的吸引硬圆盘,都能再现这种起伏。对关联函数(pair-correlation function)g(r) = p(r) / i(r),i(r) 是没有相互作用时的地点对距离分布。g(r) 大于 1 表示比这套参照多出邻居,小于 1 表示邻居偏少。数据和两个模型都在 r ≲ 4 米明显缺少邻居,又在 r ≈ 6 米出现 g(r) > 1 的峰。5 米以下数据和模型的差距,来自坐标定在入户门,模型里的粒子更接近建筑中心。吸引硬圆盘的示例用 10,000 个按径向 Erlang 分布抽出的位置,尺度参数 R = 675,半径分布的尾部参数 a = 4。这组粒子只负责把振荡做出来,丹麦的门牌坐标没有被逐点拟合进去。
城镇之间是另一套账。1 公里以内,相邻城镇明显少于完全随机的点;过了这段,对数尺度上的 g(r) 很快接近 0,也就是地点对分布贴近理想气体。g(r) 上没有清楚的吸引峰,因此这张图不支持城镇之间还有很强的相互吸引。不允许重叠的硬圆盘,在较短距离上和真实城镇相似。把每一对城镇按双方建筑数的乘积加权之后,长距离上的建筑地点对分布更接近真实的城镇位置;只靠不重叠的随机圆盘补不回这一段。城镇有大有小,位置不完全是“只要不重叠就随机”。
中尺度的 r^0.67 被做成两种可计算的图像。一种是分形:城市由嵌套斑块组成,每层 b 个子斑块,填充率 θ 小于 1,于是每一层都会留下空地。图注的启发式是 α = 1 − 2lnθ / ln(θ/b)。按图中的填充率 0.8、每层 4 块代入,得到 0.72。图注把这个样本的最小半径写成 3 米、层数写成 8;方法正文把同一示例的最小半径写成 4 米。另一种把许多独立斑块放在一起,并令建筑数正比于半径平方。若半径分布的尾部是 R^−(4−α),合在一起的地点对距离分布就以 r^α 增长。用观察到的 α = 0.67 代进去,斑块面积的指数约为 −2.17。由城市半径推断得到的 f(R) 正比于 1/R^3.29,对应面积指数 −2.15,斑块模型给出的增长指数是 α = 0.71。单座城市的地点对指数是 0.69 ± 0.04;方法说明正文里的“均值 ± 数值”按标准差报告。0.67、0.69、0.71 和 0.72 彼此接近,说明这种偏慢的增长在几种模型里都出现。这些模型说明,嵌套的空地和斑块面积的分布足以产生观察到的指数。城市在历史上是否真按这个层次建造,还需要布局模型以外的证据。
法国的地址和建筑也有近处起伏、中段上升、国土尺度下降的三段。图注给出地址在城市尺度的指数同样是 α = 0.67。
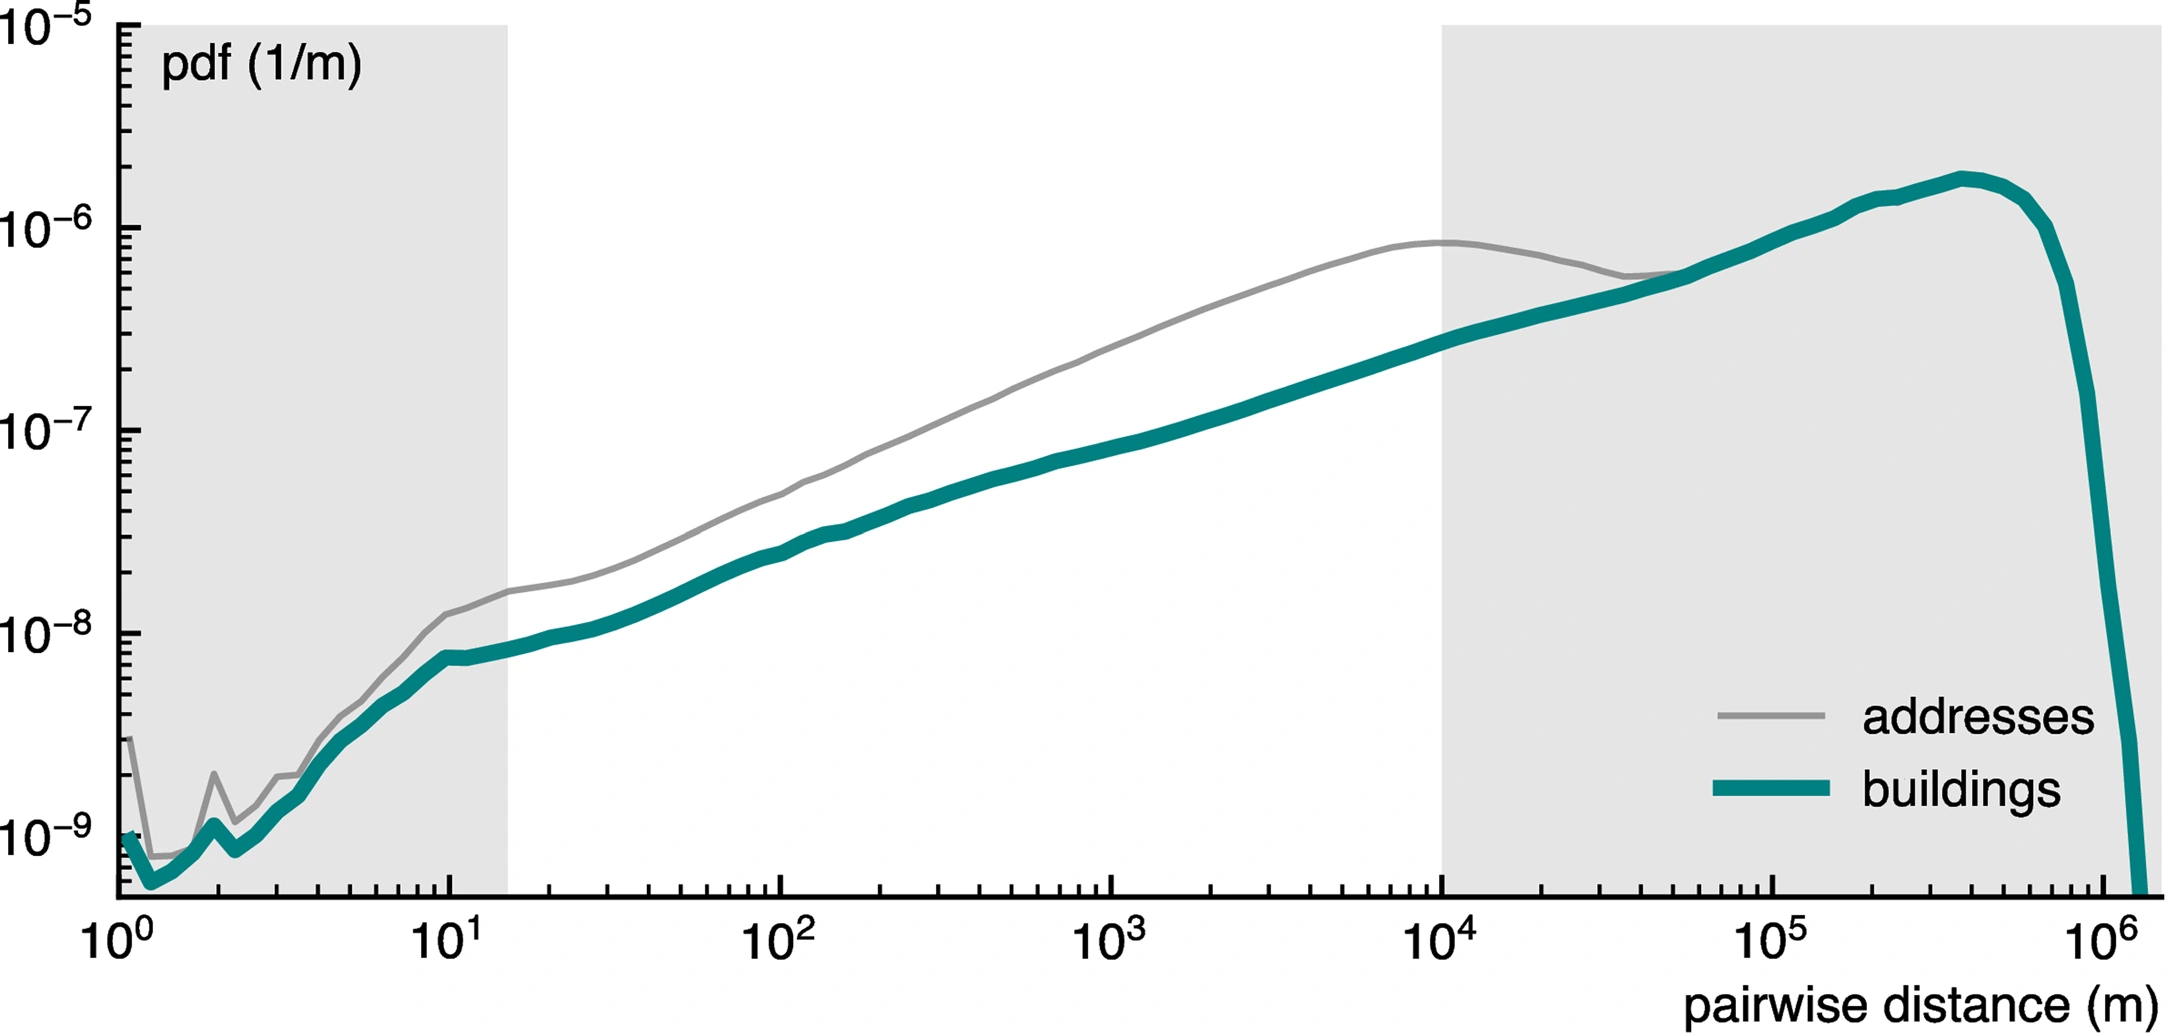
图 4|丹麦地点结构上的三段,在法国地址和建筑里还在吗?
这张图没有子图字母。灰线是地址,青线是建筑,纵轴是每米的地点对密度,横轴是两两直线距离。短距离有起伏,中段上升,接近 10^6 米后下降。两端的灰色背景标出邻里尺度和国家尺度,中间留白对应图注所说的城市尺度。图注写明地址的城市尺度幂律指数为 0.67。来源:原论文 Extended Data Fig. 1。
全国接近 1/r,一座城市自己也是 1/r 吗?
把搬家限制为从某一座城市出发、目的地可以在全国,地点对也至少有一端落在这座城市里。这时相对距离倾向变成两段,而不是贯穿全部距离的一条 1/r。
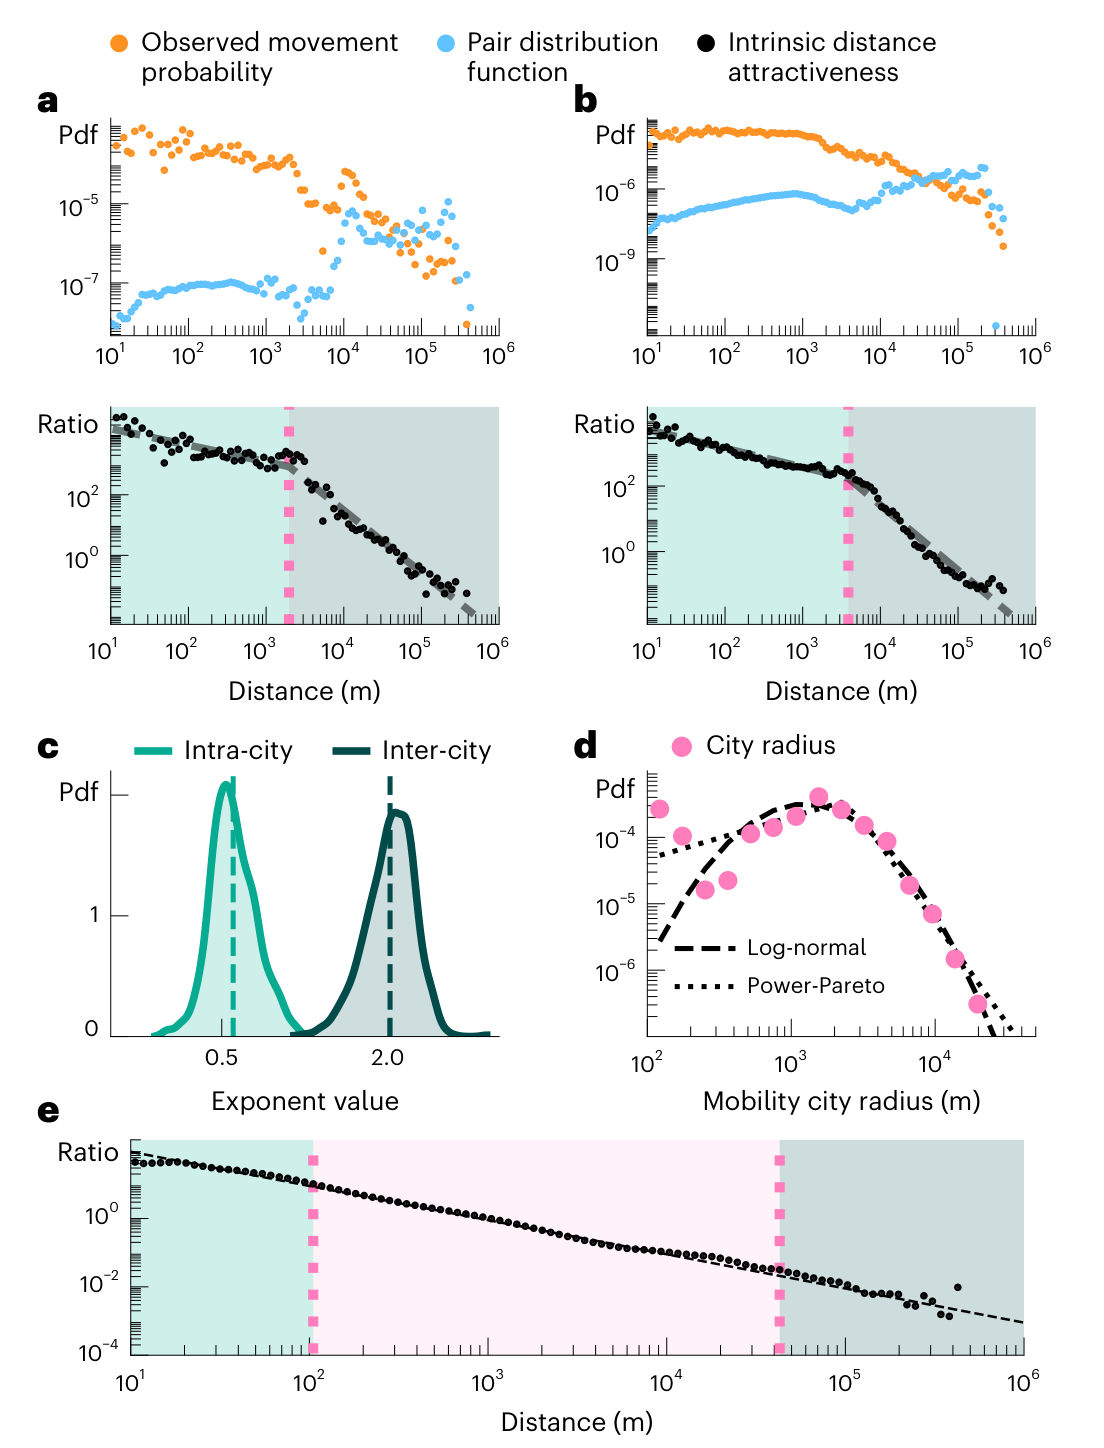
图 5|从一座城市看出去,相对距离倾向在哪里折成两段?
(a、b)一座较小和一座较大的丹麦城镇。上图橙色是观察到的移动概率,蓝色是地点对距离分布;下图黑色是二者的比值。绿色背景是第一段,灰色背景是第二段,粉色虚线是转折。(c)1,400 座城市的两段指数。青绿是城内,深绿是城际;分布中心分别在 0.60 ± 0.20 和 2.0 ± 0.21,加减号是城市之间的标准差。(d)转折距离被定义成移动城市半径。粉色点是数据,虚线是对数正态,点线是 power-Pareto。(e)用(c)的均值 0.6 和 2、城市尺度,以及随机的城市位置做模拟,比值又回到接近 1/r 的下降。来源:原论文 Fig. 4。
0.60 和 2.0 是 1,400 座城市的均值。前一段的标准差是 0.20,相对均值 0.60 已经不小。各城共享的是两段这一形式,指数本身有这么宽的城市间散布。图例把较缓的一段标成城内,把接近 2 的一段标成城际。转折点定义移动城市半径。power-Pareto 的赤池信息准则是 24,046.03,对数正态是 24,161.17,论文称前者略好。扩展数据表 2 里,这条移动城市半径相对纯幂律的对数似然比,对数正态是 −0.96,指数分布是 1.91,Weibull 是 1.18。纯幂律在这里并不占优,半径分布落在对数正态和 power-Pareto 之间。表 1 那个指数 3.05 的 City Radius 使用另一个名称和另一组 n,正文没有写明它与这里的移动城市半径是不是同一批距离。
(e)把分段规律装回一张简化地理:城市内部的地点对距离分布用广义伽马分布,城市位置随机,两段指数取均值 0.6 和 2。模拟回收了 π(r) = 1/r。全国的一条直线,在这个框架里是许多城市的两段曲线按地点布局叠出来的。回收依赖这些假设;图中的点是模拟结果,不是又一次独立普查。
这和重力模型差在哪一级尺度?
离散的引力模型(gravity model)把两城之间的迁移写成两端人口的乘积除以距离。它需要先划定城市。本文的连续版本停在地址这一级:两座城市相距 d,半径相对 d 可以忽略时,地点对距离分布在 d 附近收成一个尖峰,高度是两端地址数的乘积 N₁N₂。再乘上 1/r,观察流量就回到 N₁N₂ / d 这种形式。地址数若与人口成正比,离散引力模型就是这个极限。极限之外,城市有大小,短距离还有大量地点对,离散的城市公式覆盖不到。
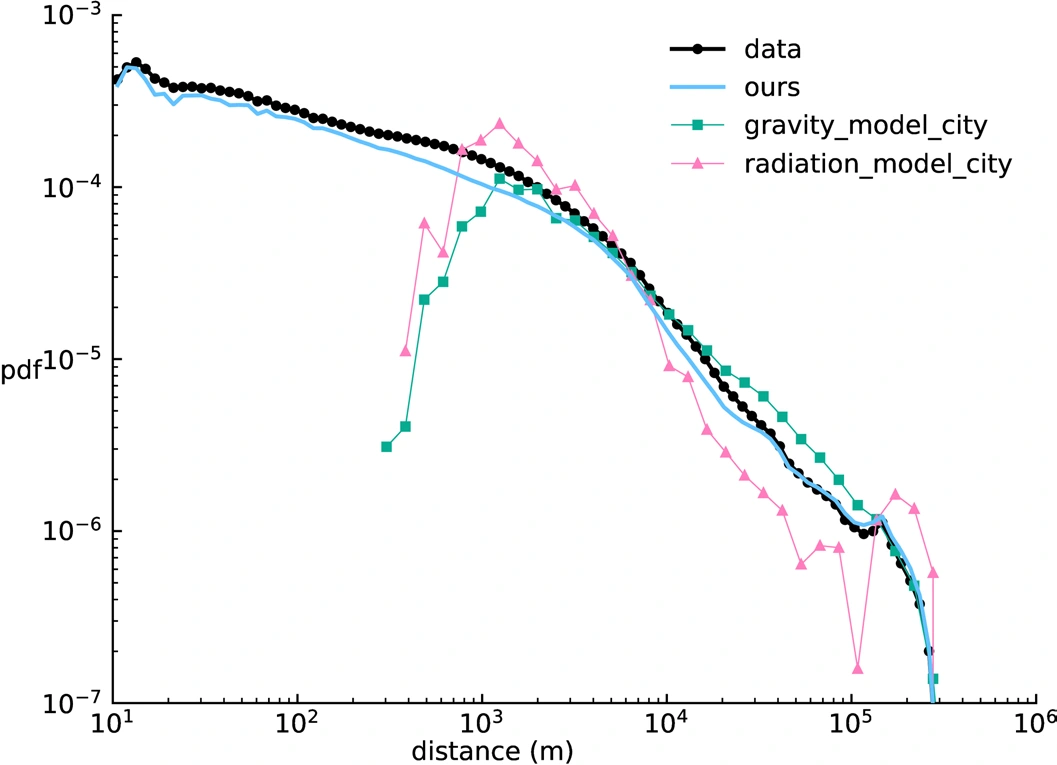
图 6|城市尺度的重力模型和辐射模型,从哪一段距离才开始有曲线?
这张图没有子图字母。横轴是距离,纵轴是概率密度。黑色圆点是数据,蓝色是本文框架,青绿方块是城市重力模型,粉色三角是城市辐射模型。蓝色紧跟着数据,从约 10 米一路到 10^5 米量级。两条城市模型要到大约数百米之后才出现,随后围绕数据起伏,并在长距离与数据一起下降。图中没有印刷误差指标,也没有标明国家;能确认的是各曲线从哪一段距离开始贴近数据。来源:原论文 Extended Data Fig. 4。
辐射模型(radiation model)用周围机会解释流动。图 6 里的粉色曲线是城市尺度上的一个对照,它在短距离没有数据可跟。地址级的地点对分布覆盖了这两条城市模型尚未出现的近距离。图例以外的机会模型是否彼此等价,这张图没有检验。
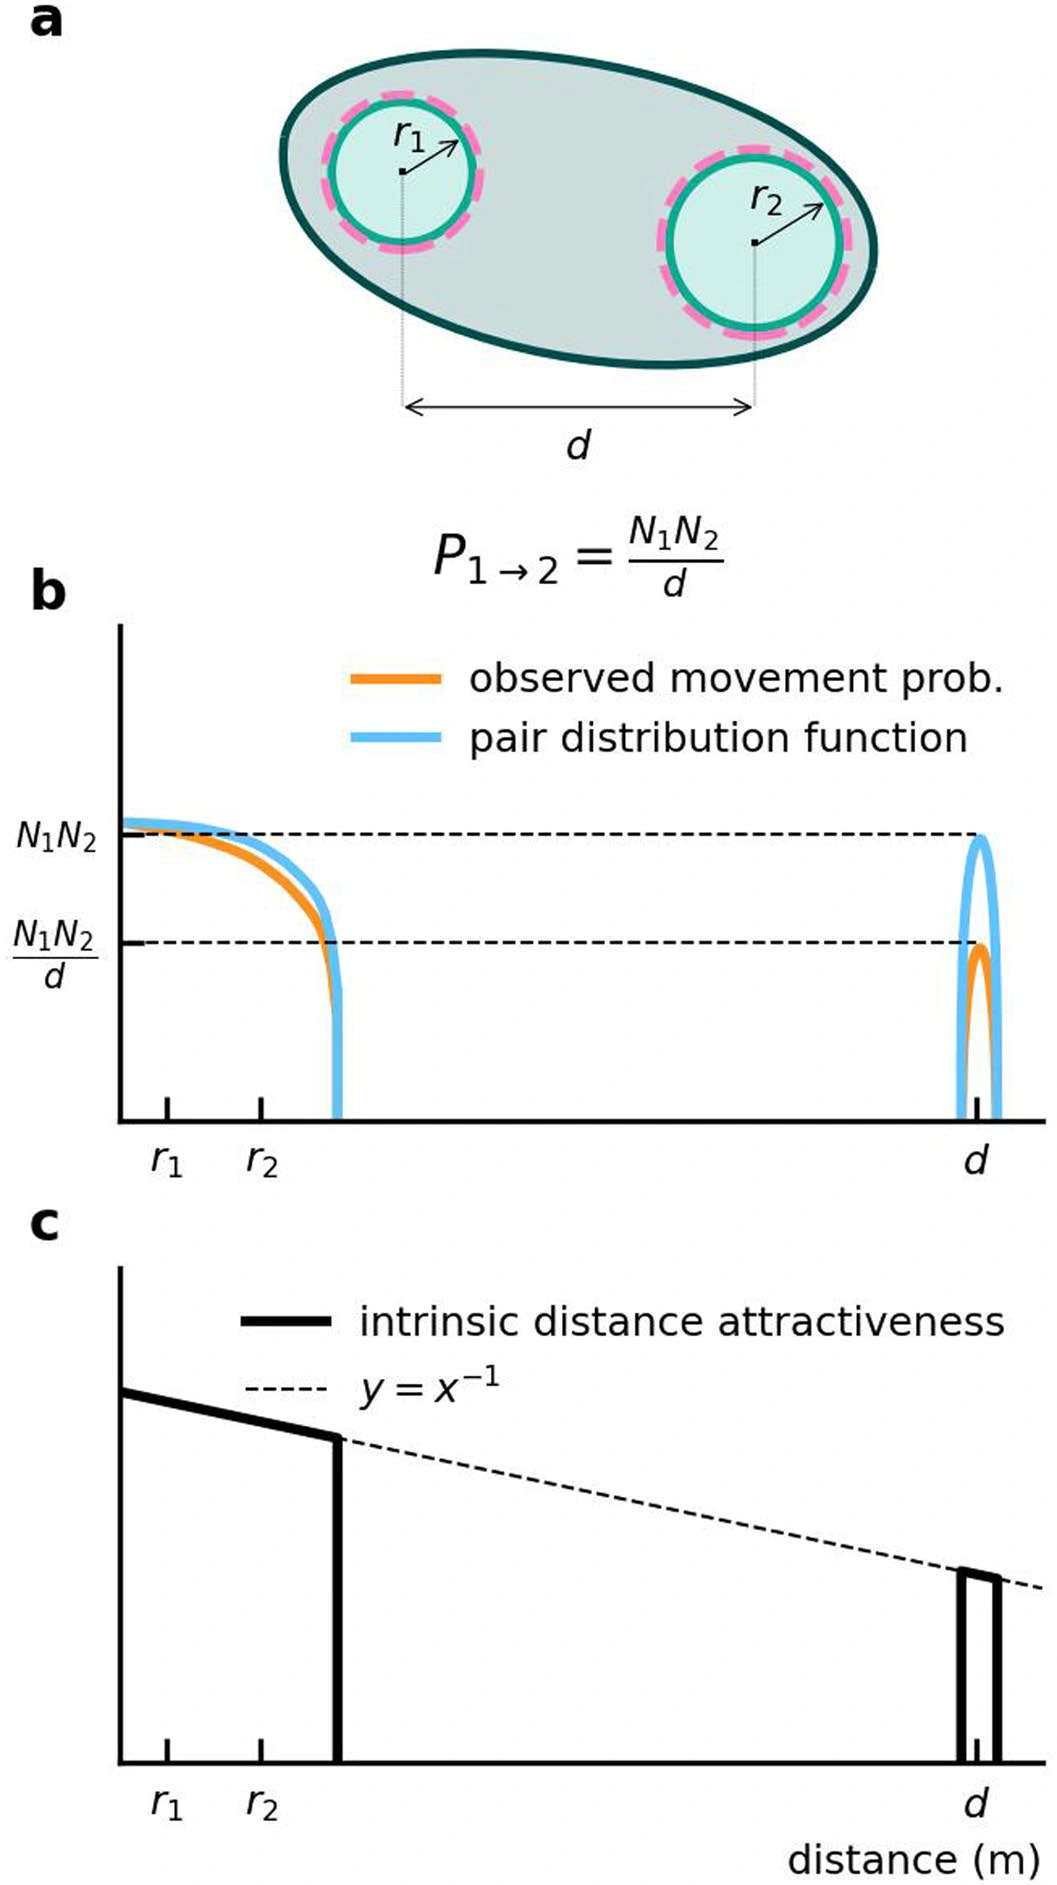
图 7|两端地址数的乘积,怎样在很远的距离上变成引力模型里的质量?
这是示意图。(a)两座半径为 r₁、r₂ 的城市,中心相距 d。(b)橙色是观察移动,蓝色是地点对距离分布。近处两条曲线覆盖城市自身的尺度;在 d 附近,地点对分布收成高度为 N₁N₂ 的尖峰,观察移动的尖峰更低,图中标到 N₁N₂/d。(c)黑色是相对距离倾向,虚线是 y = 1/x。近处和 d 附近各留下一段,中间距离在这个玩具模型里没有城市可去。来源:原论文 Extended Data Fig. 5。
方法里还有一种读法:若人对距离的评价是对数的,随机效用模型可以推出 1/r。这是作者给出的解释,本文没有做相应的选择实验。
这套规律能说到哪里为止?
登记包含性别和出生年,但 0.98 是全部搬家合在一起的指数。扩展数据里的两张人口图说明样本里有谁,没有按人群分开估计 π(r)。
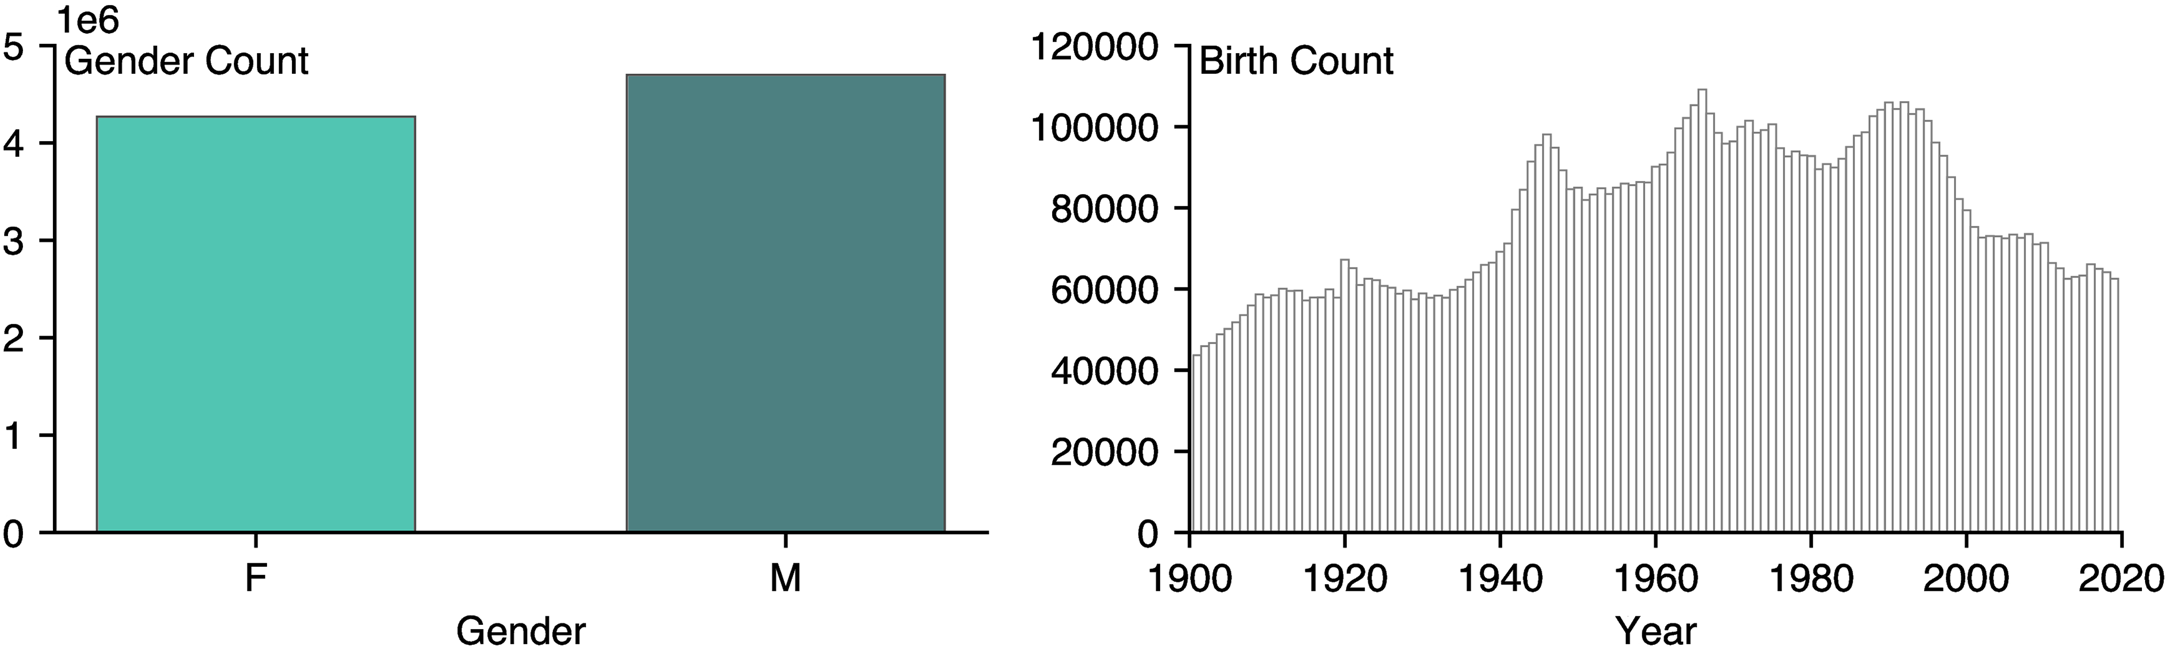
图 8|丹麦这套搬家登记里,性别和出生年是怎样分布的?
这张图没有子图字母。左图是性别计数,男多于女,纵轴以百万计。图注用出生时的男女性别比 1.07 解释这一不平衡;1.07 出自所引的出生性别比文献,图里没有印出搬家记录自身的男女人数比。图注还写明,数据包含登记过的人口,并据此把左图的不平衡和选择性抽样分开。右图是数据中每个人的出生年,大约从 1900 年到 2020 年,形状大体跟随丹麦出生率,差别被归因于迁移。来源:原论文 Extended Data Fig. 2。
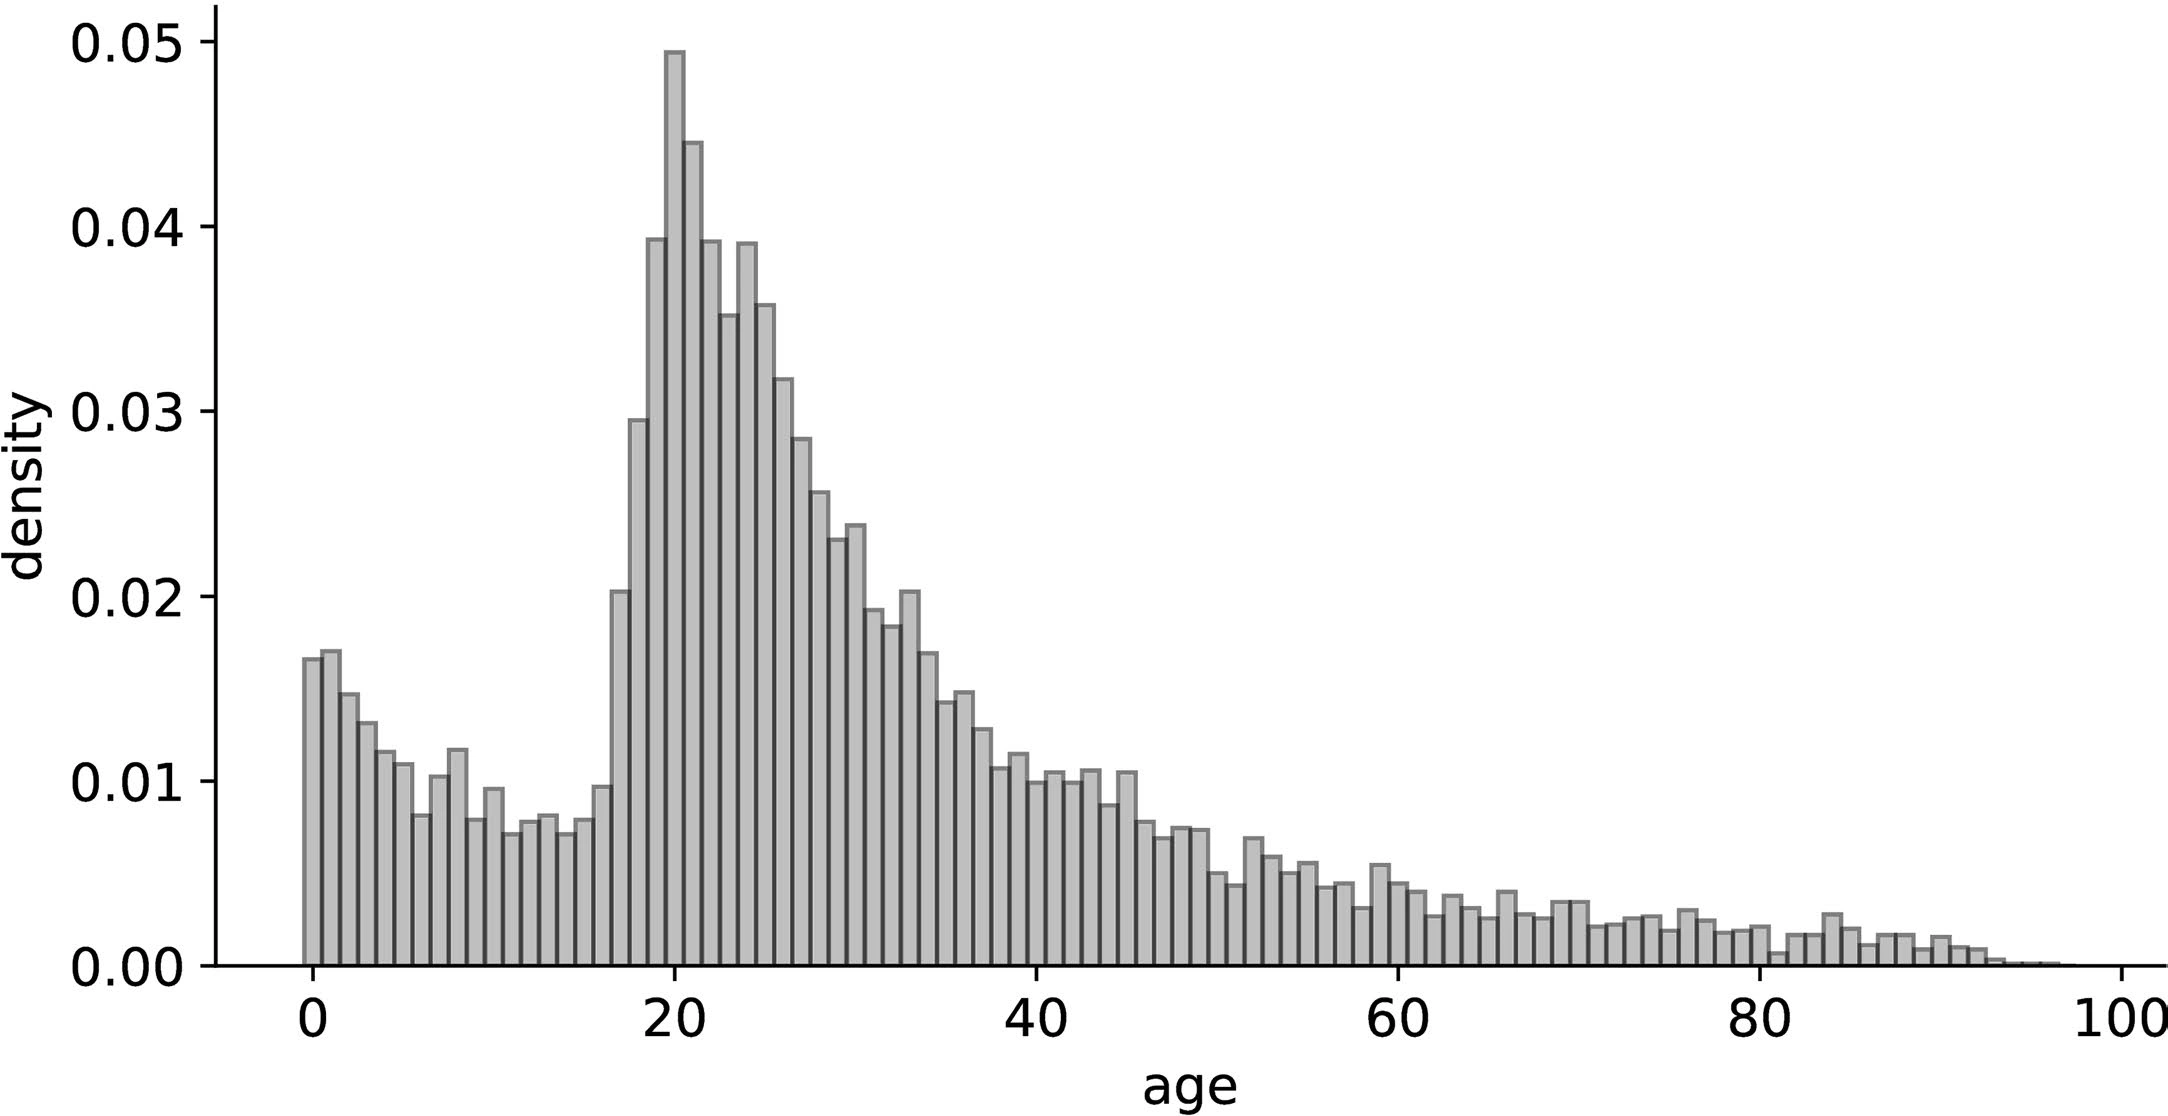
图 9|搬家发生时,年龄密度集中在哪一段?
这张图没有子图字母。横轴是搬家时的年龄,纵轴是密度。密度还要再换算,才会变成该年龄占全部搬家次数的份额。最高的一档靠近 20 岁,柱顶接近 0.05 的刻度;0 岁附近有一个较矮的峰,30 岁以后是一条长尾,年龄可以延伸到接近 100 岁。来源:原论文 Extended Data Fig. 3。
讨论里写明的边界还有四条。第一,地点对模型复述的是一般地址在住宅和国家尺度上的分布,还没有做到住宅和工作地这种不同功能的地点对,因此这组指数不能直接当作通勤距离规律。第二,1986–2020 年被合成一个时期,看的是长期平均。它没有分开这几十年里的变化,也没有 1986 年以前的记录,所以不能判断 1/r 是老特征还是后来才出现。第三,从单座城市看,相对距离倾向是两段;1/r 出现在尺度被汇总之后。第四,π(r) = 1/r 被作者当作分人群比较时的基线。年龄、性别或社会经济地位会不会偏离它,本文没有估计。房价、就业和家庭变化会怎样进入搬家决定,也不在这次的指数里。
还有两条来自做法本身。倾向被假设成只跟直线距离有关;方向、具体是哪两个地点、路上要花多少时间,都会被吸收进这条平均曲线,或者留在残差里。幂律是在各自的 xmin 和 xmax 里拟合出来的,区域直径以外没有被这张表检验。
一句话总结
远处的搬家更少,是因为某一距离上的地点对有多少,和这一距离上的相对强度有多大,一起写进了观察曲线;把地点对除掉之后,丹麦 1986–2020 年的登记搬家在 10 米到 475,032 米的拟合窗里留下指数 0.98 的相对距离倾向,而一座城市自己通常是城内较缓、出城较陡的两段。
核心来源
Boucherie, L., Maier, B. F. & Lehmann, S. Decoupling geographical constraints from human mobility. Nature Human Behaviour 9, 2564–2575 (2025). https://doi.org/10.1038/s41562-025-02282-7
丹麦迁移和地址来自 Danmarks Statistik 的 Befolkning 与地址数据,坐标精度优于 ±2 米,原始数据不公开。法国建筑坐标来自 Base Adresse Nationale,住房网格来自 FiLoSoFi,城际迁移来自 INSEE。签到来自 2010 年 Foursquare 的公开数据。边界来自 geoBoundaries。图的源数据和代码见 Zenodo:10.5281/zenodo.14329837;地理模型代码在 benmaier/ljhouses,作图与统计代码在 LCB0B/role-of-geo。
Louis Boucherie 是本文第一作者,署名丹麦技术大学计算系(DTU Compute,Kongens Lyngby)和哥本哈根大学社会数据科学中心。三位作者共同设计研究和模型;Boucherie 与 Maier 完成分析并实现模型;三人共同分析结果、写成论文。
Benjamin F. Maier 的署名机构与 Boucherie 相同。地理模型的实现对应 ljhouses 仓库。城市分段幂律使用了他给出的分段帕累托最大似然拟合;本文参考文献中也有他关于小世界效应的论文。
Sune Lehmann 是通讯作者,署名机构相同,参与设计、结果分析和写作。本文引用的人类移动尺度(Nature,2020)和人类移动中的守恒量(Nature Human Behaviour,2018)都有他的署名。论文写明相关资助包括 Villum Foundation 的 Nation-Scale Social Networks(项目号 00034288)和丹麦独立研究基金(项目号 0136-00315B),资助方不参与研究设计、分析和写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市只在边缘增加地址,p(r) 的长距离部分会改变。π(r) 即使仍是 1/r,观察到的搬家距离分布也会变,因为观察曲线是二者的乘积。把平均搬家距离变长理解成居民更愿意走远,可能把新建地址的位置读成了倾向的改变。论文没有做这项规划前后的比较,这个例子只是 f(r) 与 p(r) 相乘之后的一个直接推论。
直线距离相同的两对地址,在这套计算里共享同一个 r。一对中间是需要绕行的水域,另一对有直接的道路。p(r) 能反映海上没有地址,反映不了绕路花费的时间。因此 0.98 不能直接当成通勤时间的需求曲线。住宅到工作地的地点对也还没有按同一方法去除,通勤距离不在这次指数的分母里。
图 9 里,搬家年龄密度在 20 岁附近最高,但 0.98 的分母是全部登记搬家。这一档人可能只是搬得更多、相对距离倾向仍接近全样本,也可能转折半径不同。登记里有出生年,这种划分可以再做;在做出来之前,全国指数不能代表 20 岁这一档。表 1 把拟合上界定在区域最远两点的距离上。用 1/r 去预测超出这个直径、而且已经没有地址对的距离,会把拟合窗外面的空域当成还有地点可去。