人走多远和电话打多远,为什么能写成同一条标度关系?
论文名片|Pierre Deville、Chaoming Song、Nathan Eagle、Vincent D. Blondel、Albert-László Barabási、Dashun Wang,Scaling identity connects human mobility and social interactions,PNAS(Proceedings of the National Academy of Sciences),2016,113(26):7047–7052,2016年6月28日出版;2016年1月21日收稿,4月20日接收。DOI:10.1073/pnas.1525443113。
远途比日常短途少,给远处打电话也比给近处少。这是距离分布的日常样子,不是本文单独拆出的通勤或周末样本。引力模型和辐射模型若面对同一套人口分布,会把出行和通话写成同一个幂律指数。
三套数据里,移动指数和通信指数对不上。葡萄牙数据把流量除以该距离的平均流量后,通信和移动的分布叠到同一条曲线上;三套数据都显示,平均通信流量随移动流量亚线性增长,并带一个随距离变化的前置因子。通信的距离指数因此可以写成移动指数、亚线性指数和这个前置因子的组合。这条关系减少了互相独立的参数,记录的是群体尺度上的统计规律。
先说结论
- 通信距离和跳跃距离的尾部都可以近似幂律,但在同一套数据里,移动指数 α 与通信指数 β 并不重合。葡萄牙数据的公里距离上,α 为 2.02±0.08,β 为 1.50±0.06,不确定度按 95% 置信水平估计。
- 以葡萄牙数据为例,把流量除以该距离档的平均流量后,通信与移动共十条分布叠成一条曲线。距离差别主要留在平均流量里。
- 平均社会流量随移动流量的 θ 次方变化,θ 全部低于 1。秩距离上的关系是 β = αθ − δ。用表中四舍五入后的葡萄牙秩指数,1.22×0.89−0.15 约为 0.94,与表中预测 0.94±0.04 一致;直接测到的 β 为 0.89±0.04。
- 在葡萄牙数据上,用重标后的社会流量代替移动流量,再和引力模型比较空间格局。500 次比较在到达稳态前的各阶段,误差系统性低于引力模型。正文没有给出误差下降的百分比。
同一个国家里,两条幂律为什么对不上?
人类移动性研究的是人在空间中的位移。社会互动在本文里具体落到电话和短信:两个人通话或发短信时,用他们之间的距离描述通信有多远。两边都观察到越远越少,于是常被放进空间网络这同一个大类。
引力模型和辐射模型把移动和通信当成同类现象。人口分布一旦给定,它们会在同一个国家里预测同一个标度指数。若数据里的 α 和 β 稳定地不一样,这个预测就需要解释:差别从哪里来,两个指数还能不能互相写出。
本文的做法是把距离倾向和地点对之间的流量不均拆开。流量不均指有的地点对之间来往很多、大多数地点对来往很少,这个形状可以不随距离改变。距离的作用则留在该距离上的平均流量里。拆开之后,两个指数不再各算各的。
三套账单里,距离有两种算法
数据来自运营商计费记录。每通电话记下双方,以及发起通话者的时空位置,于是同一批记录里同时有通信和移动。
| 数据集 | 正文给出的范围 | 用户规模 | 时间跨度 |
|---|---|---|---|
| D1 | 葡萄牙 | 130 万用户 | 1 个月 |
| D2 | 一个未点名的西欧国家 | 约 600 万用户 | 1 年 |
| D3 | 卢旺达,论文称为非洲最大移动运营商的记录 | 正文未给出用户数 | 4 年 |
130 万和约 600 万的分母都是该数据集中的用户。D3 的用户数正文没有写出;表注说明它的数据量小得多,因此各指数的不确定度更大。三套数据的人口、经济和空间尺度不同,正文没有给出收入或城市数量。地点对之间的流量按 1 个月的窗口统计。D2 的采集长达 1 年、D3 长达 4 年,这个 1 个月是流量统计的窗口,短于整份数据的采集长度。
通信距离有两种。测地距离 r 是两人通过电话或短信联系时、在地球表面上的距离,单位公里。秩距离 r′ 是比对方更靠近自己的人数:人口密的地方,同样几公里会对应更大的秩。跳跃距离是同一个人相邻两次被记录位置之间的公里位移;跳跃的秩用同样的人数算法。位置来自发起通话一方的时空记录。后面的图比较的是这些距离的群体分布,以及地点对上的总次数。
社会流量 T^S 是两个地点之间的通信总次数,移动流量 T^M 是两个地点之间的跳跃总次数。分母是地点对。正文没有列出基站总数。
尾部下降的速度,通信和出行并不相同
四条分布都看尾部。峰之前的小距离被正文称为小值饱和,不拿来拟合。虚线只帮助眼睛看斜率。因为样本量和距离不是整数,指数用最小二乘估计,而不是幂律研究里常用的标准拟合;误差对应 95% 置信水平。
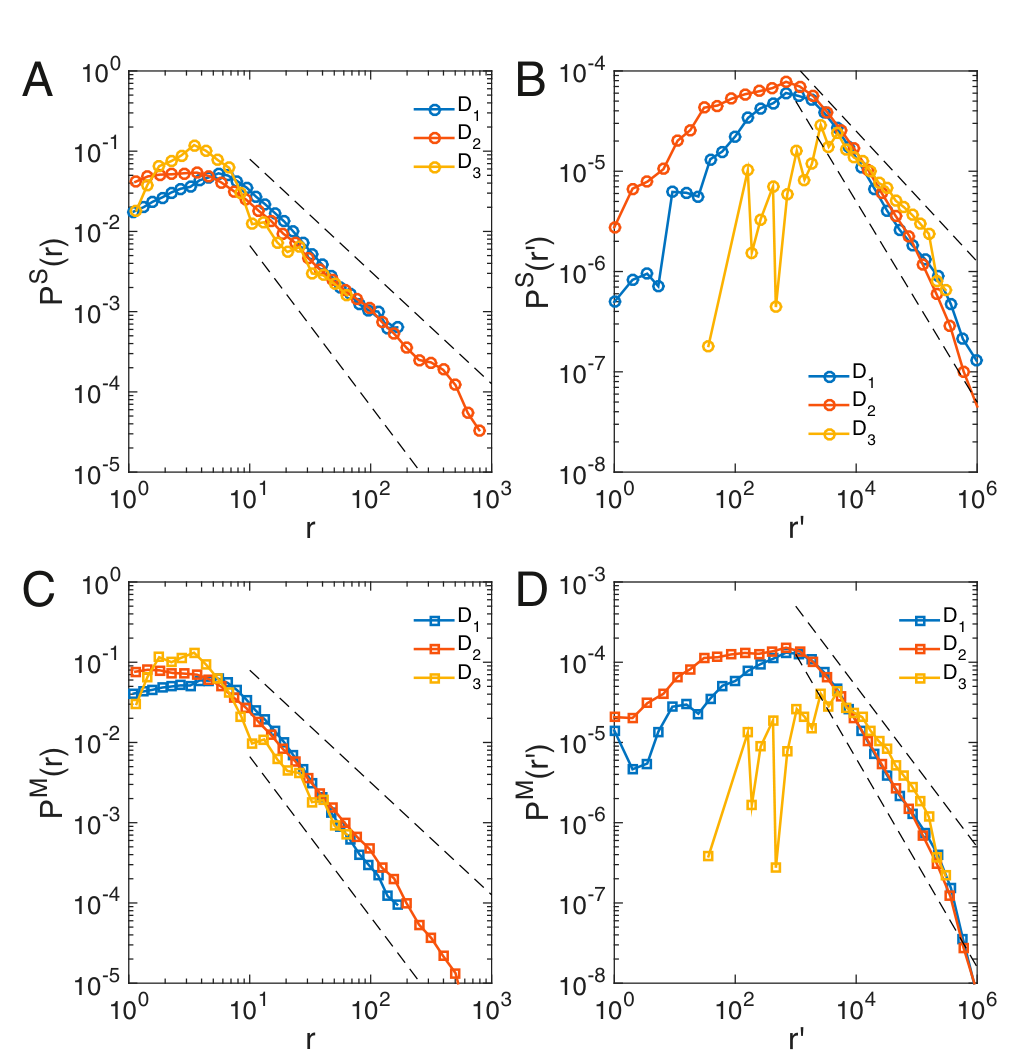
图 1|通信和跳跃的距离分布,尾部斜率是否相同?
(A)通信的测地距离分布 P^S(r)。横轴 r 为公里,从 1 到约 10^3;纵轴为分布值。蓝、红、黄对应 D1、D2、D3。几公里附近有峰,之后下降。(B)通信的秩距离分布 P^S(r′),横轴到约 10^6。D3 在小秩处波动很大。图注给出的尾部指数为 D1 的 0.89、D2 的 1.00、D3 的 0.64。(C)跳跃的公里距离分布 P^M(r),形状与 A 同类,指数不同。(D)跳跃的秩距离分布 P^M(r′)。图注写明 D1、D2 的指数约在 1.2 到 1.3 之间,D3 约为 1。来源:原论文 Fig. 1。
表 1 把四套指数和后面要用的 θ、δ 放在一起。左半边是秩距离,右半边是公里距离。预测列是把 α、θ、δ 代入 β = αθ − δ 之后的结果,不是再独立拟合一次 β。
| 数据 | α(秩) | β(秩) | θ(秩) | δ(秩) | 预测 β(秩) | α(公里) | β(公里) | θ(公里) | δ(公里) | 预测 β(公里) |
|---|---|---|---|---|---|---|---|---|---|---|
| D1 | 1.22±0.03 | 0.89±0.04 | 0.89±0.02 | 0.15±0.02 | 0.94±0.04 | 2.02±0.08 | 1.50±0.06 | 0.88±0.02 | 0.16±0.04 | 1.61±0.09 |
| D2 | 1.28±0.07 | 1.00±0.07 | 0.94±0.02 | 0.16±0.02 | 1.04±0.08 | 1.75±0.05 | 1.35±0.03 | 0.92±0.02 | 0.17±0.03 | 1.44±0.07 |
| D3 | 1.00±0.07 | 0.64±0.03 | 0.67±0.03 | −0.07±0.15 | 0.70±0.16 | 1.80±0.14 | 1.57±0.18 | 0.83±0.04 | 0.24±0.08 | 1.25±0.16 |
同一套数据内部,α 高于 β 的差距在 D1、D2 上大于各自的误差。秩距离上,D1 是 1.22±0.03 对 0.89±0.04,D2 是 1.28±0.07 对 1.00±0.07。D3 的秩距离同样分开:1.00±0.07 对 0.64±0.03。D3 的公里距离是 1.80±0.14 对 1.57±0.18,两个区间有重叠。正文把 D3 的偏差和不确定度都标成三套数据里最大的,原因是数据量更小。
三国的同类指数相当接近。公里距离上的移动指数,D2 为 1.75±0.05,D3 为 1.80±0.14,D1 为 2.02±0.08。要解释的是同一国里通信尾部和移动尾部的指数差。
流量的长尾,能不能代替距离?
若把地点看成点、流量看成连线的权重,权重大小呈胖尾:大多数地点对的次数很少,少数地点对的次数很多。胖尾在这里指大流量一端下降得比指数分布慢。这个不均本身就会让汇总后的距离分布看起来很陡或很缓,所以要先问:图 1 的距离衰减,是不是只是这层不均的投影。
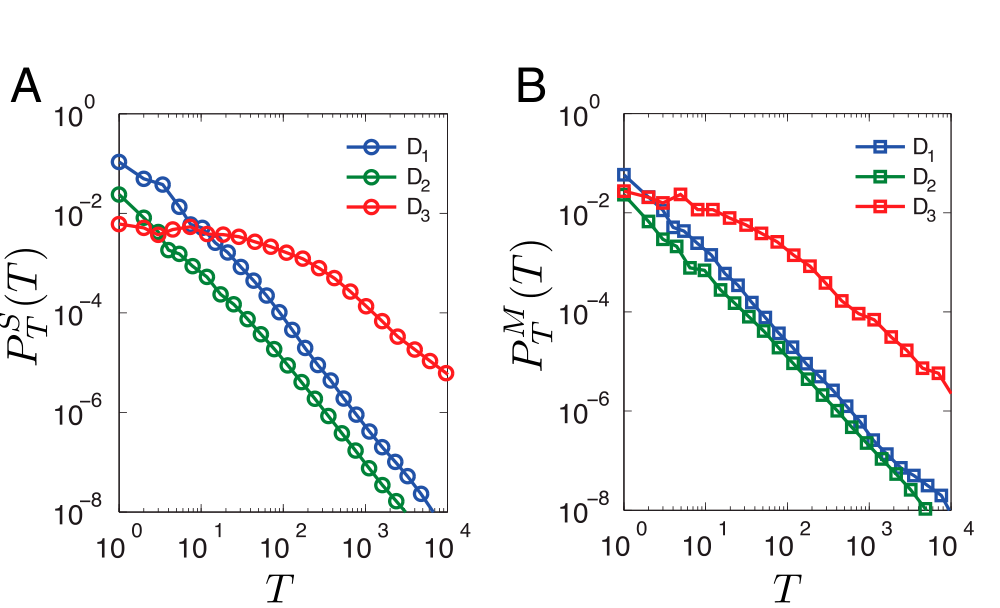
图 2|地点对流量有没有一条长尾?
(A)社会流量的分布。蓝圆点 D1,绿圆点 D2,红圆点 D3。横轴流量 T 约从 1 到 10^4,纵轴是地点对份额,向下到约 10^−8。三条都拖长尾,彼此分开;D3 在大流量处下降更慢。(B)移动流量。三条更接近平行,D3 靠右、D2 靠左。来源:原论文 Fig. 2。
只看全体地点对,还分不清距离和地点对的繁忙程度。下一步把秩距离相近的地点对放进同一组,再看组内的流量分布。近的组整体更靠右,大流量更多;但同一组内部仍然是长尾。近,并不保证这一对地点来往很多。组内那一小段尾巴,承担了大部分流量。
把每条分布的流量除以该组平均流量之后,形状叠到一起。正文把这写成:给定距离时的流量分布,等于平均流量的倒数乘以一个函数 F,而 F 只依赖流量与平均流量之比,不再单独依赖距离。距离效应因而收进 ⟨T(r′)⟩。社会流量和移动流量共用这一个 F。
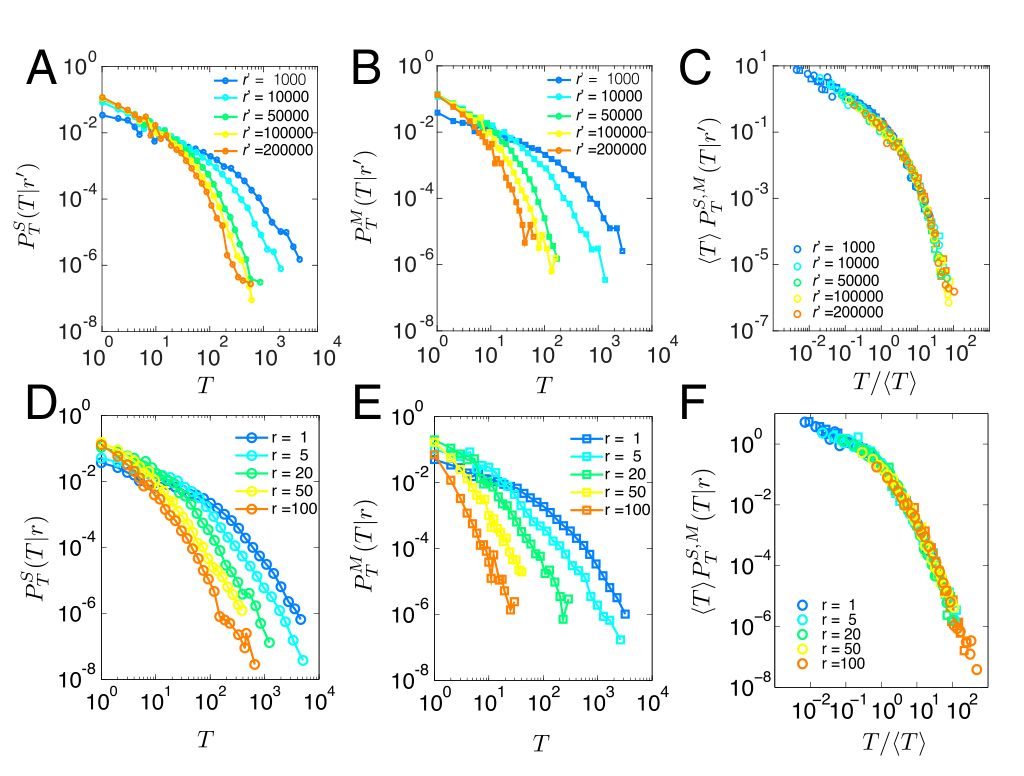
图 3|距离相近时,流量分布能否叠成一条曲线?
正文以 D1 为例。(A)五个秩距离组的社会流量。图例为 r′ = 1000、10000、50000、100000、200000。秩越大,曲线越靠左。(B)同样五组的移动流量,方向相同。(C)横轴改为 T/⟨T⟩ 后,A 与 B 共十条曲线叠合。圆点表示移动,方点表示通信。(D)改用公里距离后的社会流量,图例 r = 1、5、20、50、100,单位与正文一致,为公里。(E)同样五个公里组的移动流量。(F)再除以各组平均流量,十条曲线再次叠合。塌缩说明形状可以不随距离改变;它不表示每一对近邻地点流量都大。来源:原论文 Fig. 3。
图 3 是 D1 的例子。正文说明 D2、D3 的同类流量分布放在补充材料。图 4 和表 1 在正文里给出了这两套数据的 θ、δ 以及指数关系。
通信流量怎样跟着移动流量变?
地点对按距离分组后,看社会流量和移动流量是否一起涨。灰点是一对地点,彩色点是给定移动流量后的平均社会流量。平均社会流量随移动流量呈幂律,指数 θ 小于 1:移动流量增加时,社会流量增加得更慢。这个 θ 在不同距离组之间可以共用;距离的差别进到前置因子 A(r′) 里。
对 D1 的秩距离,把社会流量再除以 r′ 的 0.149 次方,各组平均线合成一条直线,因此 A(r′) 近似随 r′^δ 变化,δ 约为 0.15。移动流量相同的时候,距离更远的地点对有更高的平均通信流量。正文把这个前置因子读成打电话与赶路之间的成本差。D3 秩距离上的 δ 为 −0.07±0.15,区间跨过 0,这一列还支撑不了同一个成本读法。
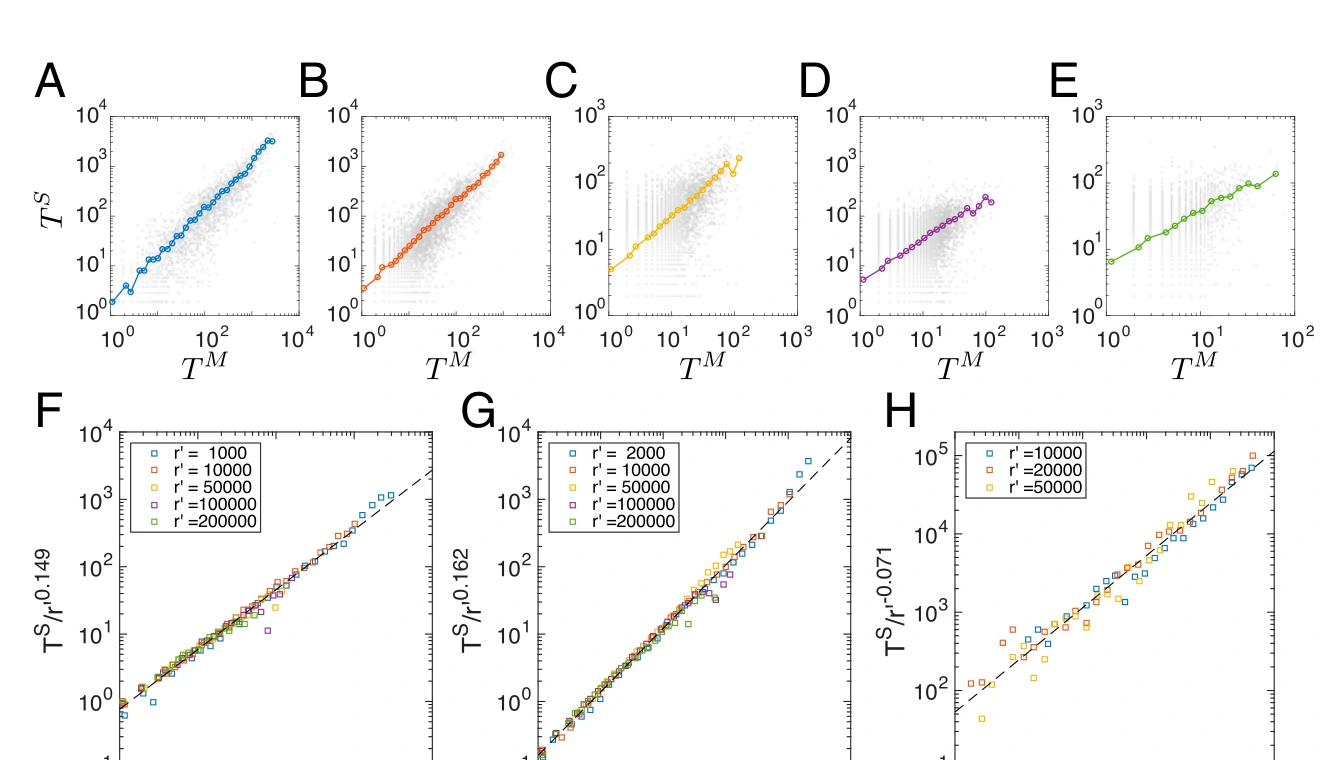
图 4|移动流量增加时,社会流量按什么指数跟上?
(A–E)灰点为地点对,彩色点为条件平均。正文把五张图的秩距离写成 10^3、10^4、5×10^5、10^6 和 2×10^6。F 的图例按蓝、橙、黄、紫、绿写成 1000、10000、50000、100000、200000,颜色与 A–E 对应,后三档与正文相差十倍。两处都按原文保留。(F)D1,纵轴是社会流量除以 r′ 的 0.149 次方,五条平均线合成一条上升直线。0.149 对应表中 δ = 0.15±0.02。(G)D2,纵轴指数为 0.162,图例从 r′ = 2000 起,对应表中 0.16±0.02。(H)D3,纵轴指数为 −0.071,图例只有 10000、20000、50000 三档,对应表中 −0.07±0.15。来源:原论文 Fig. 4。
D2、D3 各有自己的 θ 和 δ。G 的最小秩是 2000,H 只有三档。三套数据都能把曲线叠成直线,各自使用的 θ 和 δ 不同。六组 θ 的 95% 区间上界最高到 0.96,都低于 1。
两个指数怎样写成一条式子?
平均流量里已经含有距离。社会平均流量又等于 A(r′) 乘以移动流量的 θ 次方,而 A(r′) 随 r′^δ 变化。通信分布的距离指数就不再是自由参数,正文由此写出:
β = αθ − δ。
秩距离和公里距离各写一次。预测值的误差由三项不确定度传播,正文给出的形式是 θ 的平方乘 α 的方差,加上 α 的平方乘 θ 的方差,再加上 δ 的方差,然后开方。
用表里已经四舍五入的数回代,D1 秩距离 1.22×0.89−0.15 = 0.9358,表中记为 0.94±0.04;公里距离 2.02×0.88−0.16 = 1.6176,表中记为 1.61±0.09。D2 的 1.28×0.94−0.16 约为 1.04,1.75×0.92−0.17 = 1.44,与预测列一致。直接测到的 β 与预测值的区间互相重叠,表示在所报误差下相容。
D3 的公里距离上,1.80×0.83−0.24 = 1.254,表中写作 1.25±0.16;直接测到的 β 是 1.57±0.18。1.25+0.16 = 1.41,1.57−0.18 = 1.39,两个区间只是刚刚碰上,这是六组比较里最松的一组。D3 的秩距离若用表中四舍五入值计算,1.00×0.67−(−0.07) = 0.74,表中预测却是 0.70±0.16。差 0.04 说明预测用的是拟合所用的原值,读者用两位小数重乘,不必得到完全相同的 0.70。D3 的预测误差本身就有 ±0.16。
这条恒等式把原先分开报告的 α 和 β 连起来,独立参数变少。它依赖流量分布可以塌缩,以及两种平均流量之间的幂律;这两步都是数据上的归纳。正文没有把代数推导逐步展开。拟合成功也不等于已经证明人们先决定出行、再按 θ 决定打电话,或者相反。相关的流量不能写成因果。
只有通信流量时,模拟的传播还像真实出行吗?
恒等式的一个用途,是在只有一边数据时估计另一边。正文用葡萄牙数据比较真实移动流量、由社会流量换算的流量,以及引力模型流量,看空间格局差多远。
换算使用 D1 的 δ = 0.15 和 θ = 0.89。正文印出的换算式把整个括号放到 −θ 次方。按正文式 7,社会流量与移动流量的 θ 次方成正比,从社会流量恢复移动流量时,指数是 1/θ。−0.89 与 1/0.89 相差一截,负指数还会把图 4 的正相关倒转。下面的地图只转述论文报告的比较结果。引力模型的具体参数写在正文指向的参数说明里,图旁没有列出数值。
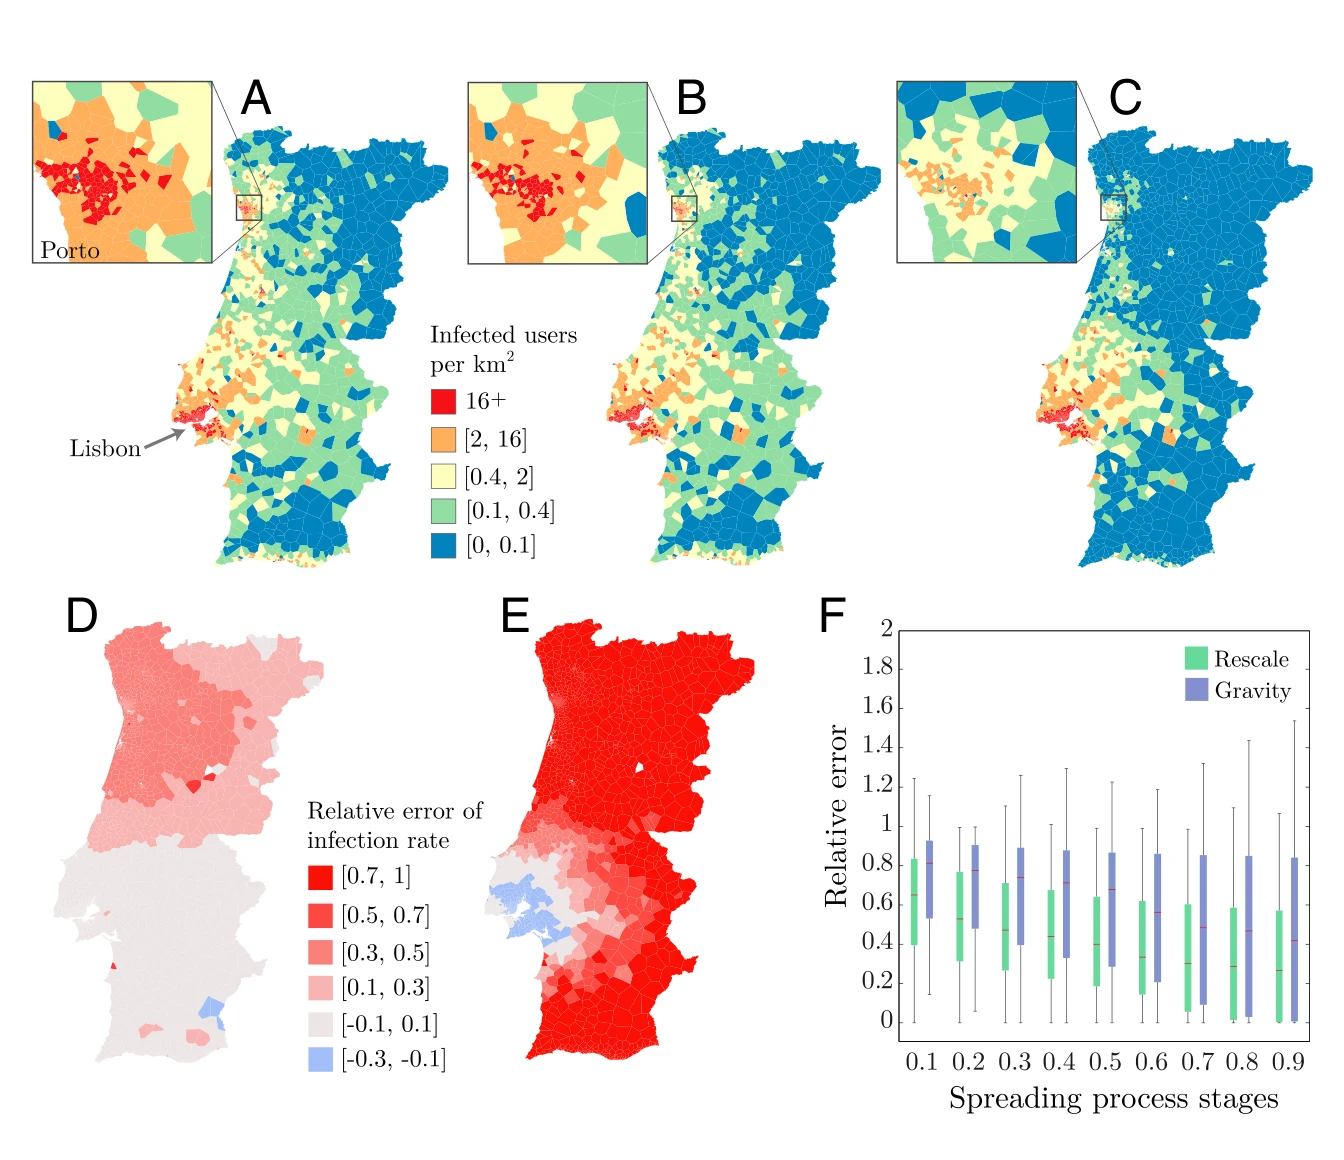
图 5|用社会流量换算的移动,和引力模型差多远?
示意比较用的是葡萄牙 D1,起点在里斯本。(A)真实移动流量。里斯本与波尔图的放大图颜色更深。(B)重标后的社会流量,高密度色块仍然出现。(C)引力模型流量,地图更偏最低一档的蓝,波尔图放大图缺少 A、B 中的高密度块。(D)重标方法的相对误差,大片落在浅色档。(E)引力模型的相对误差,大片落在最高一档。图注把两张误差图记为补充公式 S19 和 S20。(F)500 次比较在到达稳态前的平均相对误差。绿为重标,蓝为引力;横轴阶段 0.1 到 0.9,纵轴刻度到 2。绿箱整体更低,两组须线重叠。来源:原论文 Fig. 5。
论文报告,到达稳态之前的各个阶段,这 500 次的误差系统性低于引力模型。图中箱线重叠,所以系统性更低不等于每一次都更低,正文也没有报告低了百分之几。
在葡萄牙这套数据下,带上 θ 与 δ 的社会流量,比引力模型更接近真实移动流量驱动的空间格局。比较停留在这一设定。D3 的 θ 和 δ 与 D1 不同,0.89 和 0.15 只属于葡萄牙的秩距离结果。
这条关系停在哪里
指数描述的是宏观尾部。正文指出,国家内部和国家之间的社会人口差异,不会被一个幂律指数充分吸收。D3 与 D1、D2 的差别从哪里来,现有指数本身回答不了。
通信只包括电话和短信,移动只包括相邻两次记录位置之间的位移。没有记录的出行、面对面接触和其他通信渠道不在分布里。正文认为,既有的自我报告比较和更高分辨率轨迹研究降低了通话详单特殊性的担忧,同时写明还需要更系统的检验。代表性能走到哪一步,不能由这三套账单单独定论。
塌缩和恒等式是群体分布上的规律。论文自己把重点放在数据里能够测量的统计关系上,而不是这些关系背后的社会机制。亚线性的 θ 表示两种流量不同步放大;正的 δ 只在误差不含零的那些列上,支持远距离、同样移动量时通信更多。二者都不是个体决策已经按这个公式计算的证据。
这个例子限于葡萄牙和一种引力模型对照。相对误差的代数定义写在补充公式 S19 和 S20。图 5 支持的是这一设定下的流量比较。
一句话总结
把距离收进平均流量、再让两种流量按亚线性指数相连之后,通信的距离指数可以由移动指数写成 β = αθ − δ。
核心来源
- PNAS 文章页面,核对题目、作者、卷期、页码与 DOI。本文数值、图和表均来自 2016 年 6 月 28 日刊出的正文,图 1 至图 5 与表 1。
- 正文将数据集细节、指数推导、D2 与 D3 上与图 2 和图 3 对应的流量分布、引力模型参数,以及相对误差公式,放在补充材料中。上文的数字和图都来自正文。
作者介绍
六位作者的单位和分工以论文署名页为准。
- Pierre Deville:署名比利时鲁汶天主教大学应用数学系,以及美国东北大学复杂网络研究中心。六位作者共同设计研究;他与 Song、Wang 完成研究、分析数据并撰写论文。
- Chaoming Song:署名迈阿密大学物理系。参与设计、完成研究、分析数据与写作。本文参考文献中的人类移动标度与可预测性研究列有他的作者身份。
- Nathan Eagle:署名美国东北大学计算机学院。参与设计研究。论文讨论通话记录的代表性时,引用了 Eagle、Pentland 与 Lazer 2009 年对自我报告和手机观测的对照。
- Vincent D. Blondel:署名鲁汶天主教大学应用数学系。参与设计研究。参考文献中的手机数据挑战和手机数据研究综述列有他的作者身份。
- Albert-László Barabási:署名美国东北大学复杂网络研究中心、丹娜–法伯癌症研究所癌症系统生物学中心,以及哈佛医学院布列根和妇女医院医学系。参与设计研究。本文所引的人类移动标度与辐射模型论文列有他的作者身份。
- Dashun Wang:署名宾夕法尼亚州立大学信息科学与技术学院,通讯作者。参与设计、完成研究、分析数据与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
恒等式要在当地估计 θ 和 δ 之后,才减少独立指数的个数。葡萄牙秩距离上 θ 为 0.89、δ 为 0.15;卢旺达对应的点估计是 0.67 和 −0.07,而且 δ 的误差跨过 0。若某地只有通信流量、要估计出行,需要在当地重估这两个数。把葡萄牙的一对指数直接套到卢旺达,会绕过表 1 里偏差最大的那一组。
亚线性也改变按比例换算的结果。按 D1 的 θ = 0.89,移动流量变为 2 倍时,社会流量约为 2^0.89,即约 1.85 倍。论文没有做加倍实验,这只是把拟合指数换算成倍数。若规划把通话量当成出行量的固定比例,最繁忙的地点对会被系统地放得过大或过小,方向取决于用哪一边去推另一边。
图 3 还有一层和距离衰减不同的信息:即使在最近的那一档,大多数地点对的流量仍然很小,少数地点对占据尾巴。只按距离给每一对近邻涂上很高的流量,会错过这层集中。葡萄牙的模拟与这一图像相容,但它仍是一家运营商上的假设病原体。它没有回答真实疫情里应不应停做出行调查,也没有给出可以迁移到另一个国家的误差百分比。