猜下一条还在不在原地,和猜下一站去哪,上限是一回事吗?
论文名片|Douglas do Couto Teixeira、Aline Carneiro Viana、Mário S. Alvim、Jussara M. Almeida,Deciphering Predictability Limits in Human Mobility,27th ACM SIGSPATIAL International Conference on Advances in Geographic Information Systems(SIGSPATIAL ’19),2019年11月5–8日,Chicago。ACM,New York,10页。DOI:10.1145/3347146.3359093。本文依据这一会议正式版本。
手机每隔几分钟记下一个人所在的格子。夜里连续很多条都是同一个格子。题目若是猜下一条记录还在哪一格,答案常常就是原地不动。题目若改成猜下一次真正换地方会去哪,这些重复记录就不再算命中。前一种上限看起来很高,有一部分只是因为人还没离开。
Song等人用地点序列的熵估计任何方法都越不过的命中率上限。那套算法靠压缩,读不出上限到底奖励了原地停留、地点种类少,还是星期和钟点。这篇论文把上限拆开:用规律度和停留性解释压缩熵的高低,再比较星期、一天中的小时和天气进入之后,下一格与下一地点两种题目的熵各降多少。比较的是比特,是序列里还有多少不确定;本文没有把每个用户的命中率上限解成百分比。
先说结论
- 规律度与熵的斯皮尔曼等级相关在GPS和呼叫详单(call detail records,CDR)上都是−0.84。停留性与熵的相关是GPS −0.79、CDR −0.83。两个量彼此的相关只有0.63和0.48,单独一个解释不完熵。
- 用规律度和停留性拟合熵,同一批用户上回看的决定系数R²是GPS 0.76、CDR 0.94。格子变粗时,GPS的R²从0.76升到0.83。回归系数没有报告。
- GPS平均熵随采样变稀而上升:5分钟0.40比特/符号,60分钟1.05比特/符号。格子边长从300米增到1000米,平均熵从0.404降到0.264。停留性不是每一档都更高,600米的76.66低于500米的90.04。
- 下一格、不加情境时,表3的Lempel-Ziv熵是GPS 0.40、CDR 1.01,低于同列的最大似然、Miller-Madow和SG。按小时把历史拆开后,这两格升到0.72和1.38。
- 下一地点去掉连续停留后,Lempel-Ziv升到GPS 3.11、CDR 1.94。CDR上,带小时的最大似然熵降到0.59。正文说下一格的最大似然熵下降45%;这与CDR从1.45降到0.79的比例接近,和GPS表中从6.01降到1.18不是同一个比例。
上限卡的是命中率,后文却一直在比熵
可预测性在这里指一个理想方法在给定数据上最高能猜对多少,记为Πmax。它只由已经记录下来的序列决定,随具体预测器的参数而变的那一部分被拿掉了。因此它是这套数据里移动行为的上限,换一个神经网络不会自动把上限抬高。
计算要先把地图切成互不重叠、等边长的方格,把时间切成等长的时间箱,地点序列就变成格子编号。本文比较两种题目。下一格预测猜下一个时间箱的格子,答案可以仍是当前这一格。下一地点预测猜下一次出现的另一个格子,连续停在原地的那些记录被去掉。后一种更难,因为停留本身不再提供正确答案。两种题目都来自已有定义,本文要补上的是情境信息会把上限改变多少。
序列越难压缩,就越难预测。柯尔莫哥洛夫复杂度是能生成这条序列的最短程序的长度,真实值不可计算。若把地点看成随机过程产生的符号,熵是可压缩程度的下界,可以当作复杂度的近似。Song等人用三种熵:地点上均匀分布的香农熵,访问频率分布的熵,以及同时计入频率和先后顺序的熵。本文若未另作说明,用的是第三种。它不需要事先知道真实概率,适合真实分布未知的出行记录。
设序列长度为n。从位置i出发,向后取一段地点,直到这段在位置1到i−1里从未出现,这段的最短长度记为Λi。熵估计写成
H ≈ log2(n) / (各位置Λi的平均)。
分母越大,熵越低。序列若大量重复,短片段早已出现,要碰到一段没见过的,Λi往往更长,熵就低。对遍历且过程平稳的来源,序列无限变长时,这个估计趋向熵率。出行记录长度有限,也不保证满足这些条件。论文写明,这样得到的上限是近似,Song等人的算法同样如此。不可再改进的硬边界对应柯尔莫哥洛夫复杂度,而该复杂度不可计算。
熵S、不同地点数N和命中率上限Πmax由法诺不等式连在一起:
S = −H(Πmax) + (1 − Πmax) log(N − 1),
H(Πmax) = Πmax log2(Πmax) + (1 − Πmax) log2(1 − Πmax)。
这里的H(Πmax)由命中率构成,地点序列的熵记为S。论文在H(Πmax)里使用log2,在(1 − Πmax) log(N − 1)里把对数写成log。熵越高、不同格子越多,命中率上限越低。本文随后比较熵,是因为上限直接由熵决定;表里没有每个用户的地点数N,后文也就没有把0.40比特换算成百分之多少的命中率。
两套记录的人数、时长和颗粒度各是多少?
分析单位是一个人的地点序列。两套数据代表移动研究里常见的两类记录,时空颗粒度不同,上限会跟着变。
GPS来自志愿者安装的安卓应用MACACOApp,记录上行与下行流量、网络连接和GPS位置,固定每5分钟一条。论文称手机GPS的定位精度使它成为高空间分辨率数据,没有给出米级误差。共45人,2014年7月10日到2016年2月4日,论文记为18个月。
CDR来自中国一家大型蜂窝运营商,2015年里的两周,大约每小时一个位置,位置精度200米,记在最近的基站上。与常见的基站覆盖范围不同,数据方保证记录点是该时段用户位置的质心,落在200米半径内。有人并未覆盖整段时间,因此只保留平均至少每两小时有一个位置的用户,筛选标准与Song等人相同。筛选后2780人。筛选前有多少人、是哪家运营商、覆盖哪些城市,论文都没有写。
若未另外说明,GPS用5分钟一个观测、边长300米的方格;CDR用边长200米的方格,并沿用上面的两小时筛选。CDR的格子边长和位置精度同为200米,相邻格子上的差别有可能混进记录误差,论文没有单独量化这一部分。
45名自愿安装研究应用的人,不能代表一座城市的人口。两周、按小时聚合的通话位置,也不能和18个月、每5分钟的GPS直接比成同一种生活规律。后文的熵差同时包含行为、采样和筛选。
压缩熵很难读,于是改看两种数得出来的结构
Lempel-Ziv类估计输出一个比特数,中间的压缩过程很难对应回某一次停留或某一个常去地点。本文改用两个更直接的量,当作理解这种熵的代理。选择来自对算法行为的观察。
停留性(stationarity)是连续停在同一格子的观测次数的平均。序列(1, 2, 3, 4, 1, 2, 3, 4)的停留性是(1×8)/8 = 1,也就是平均每次只停一个观测。这里的停留性指自转移,也就是下一条仍是当前格子。它和前面说的过程平稳是两个概念:过程平稳说的是生成序列的统计机制不随时间改写,停留性说的是人在记录里有没有久留。
停留性相同,熵仍可以不同。(1, 2, 3, 4, 1, 2, 3, 4)和(1, 2, 1, 2, 1, 2, 1, 2)长度相同、停留性同为1,后一条更易重复。规律度(regularity)定义为序列长度除以不重复符号数。前一条是8/4 = 2,后一条是8/2 = 4。另一条例子(1, 1, 1, 1, 2, 2, 3, 3, 4, 4)的规律度是10/4。规律度高,表示同样长度里地点种类少。钟点是否对齐,要等后文把小时放进条件熵之后才能看见。
这两个例子是为了定义指标,是构造出来的序列。直觉上,规律度对应旧地点和新地点的比例,停留性对应每个地点上停留的观测数。Cuttone等人已经指出停留会抬高可预测性;把规律度一并用于解释,并在两套数据上检查,是本文的工作。
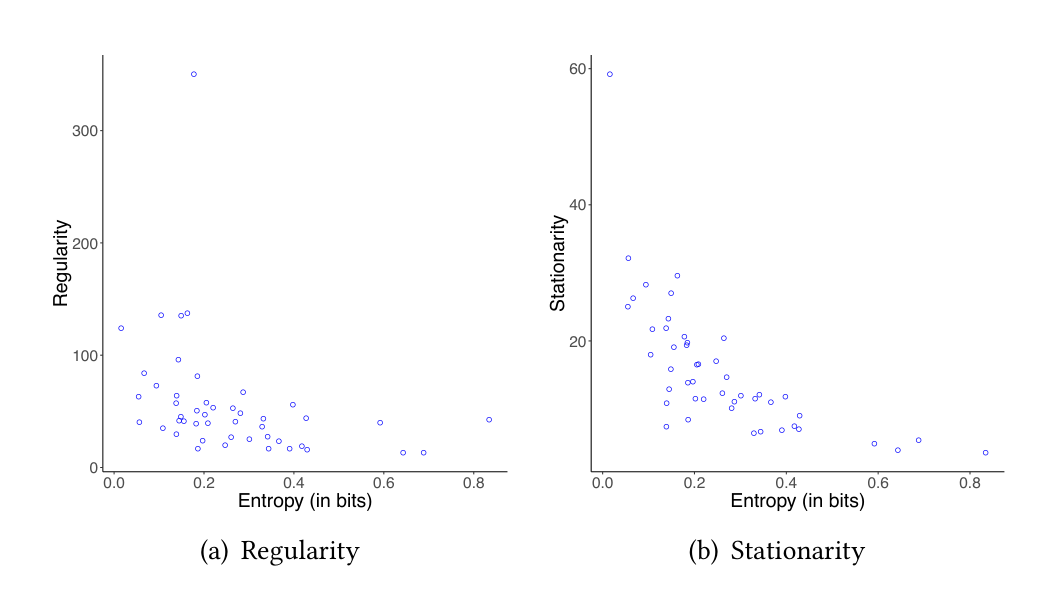
图 1|规律度或停留性升高时,熵会跟着下降吗?
(a)横轴是熵,单位比特,大约从0到0.8;纵轴是规律度。蓝色空心点是GPS用户,每人用完整地点历史算一个点。大多数点的规律度在150以下,熵升高时规律度总体更低;有一个点明显高于300,对应的熵仍然较低。同一规律度上,熵可以差一截。(b)横轴同样是熵,纵轴是停留性,刻度到60附近。熵接近0处有一个停留性靠近60的点,多数点在30以下。关系向下,也不是一条直线。来源:原论文 Fig. 1。
图1只画了GPS。论文写CDR上得到相似关系,散点没有给出。相关则两套数据都有:熵与规律度的斯皮尔曼相关ρ都是−0.84;熵与停留性是GPS −0.79、CDR −0.83。负号表示排序上熵更高的人,规律度或停留性往往更低。−0.84是等级相关,图里的弯曲和离群可以同时存在。每增加1个单位规律度对应多少比特,散点没有配出斜率。论文没有给这些相关的p值或置信区间。
规律度与停留性彼此的相关是GPS 0.63、CDR 0.48。中等相关说明二者有重叠,又远不到可以互相替代。图1里,规律度相近的人熵仍可以差很多,差额常常对应停留性的差别,反过来也一样。
于是把熵同时写成二者的函数。在试过的形式里,拟合最好的是
H = α log(规律度) + β log(停留性) + γ [log(规律度) × log(停留性)] + ε。
对数用来配合图1的非线性,乘积项用来处理两个量缠在一起的混杂。α、β、γ没有给出数值,log没有说明是自然对数还是常用对数,所以不能从公式判断哪一项贡献更大。
这个拟合解释的变异比例是R² = 0.76(GPS)和R² = 0.94(CDR)。结论里的76%和94%就是这两个决定系数。它们表示这批用户的熵变异里,有多大比例能被该曲线跟上。R²等于0.76,表示这条曲线跟上了这批GPS用户熵变异的76%。命中次数占全部预测的比例要另由Πmax或实际预测结果计算,本文没有给出那个百分比。GPS只有45个点,又含交互项,回看自身时R²容易偏高。换空间分辨率时,GPS的R²从最高空间分辨率、更小格子时的0.76,变到最低空间分辨率、更大格子时的0.83。中间每个边长的R²没有列出。
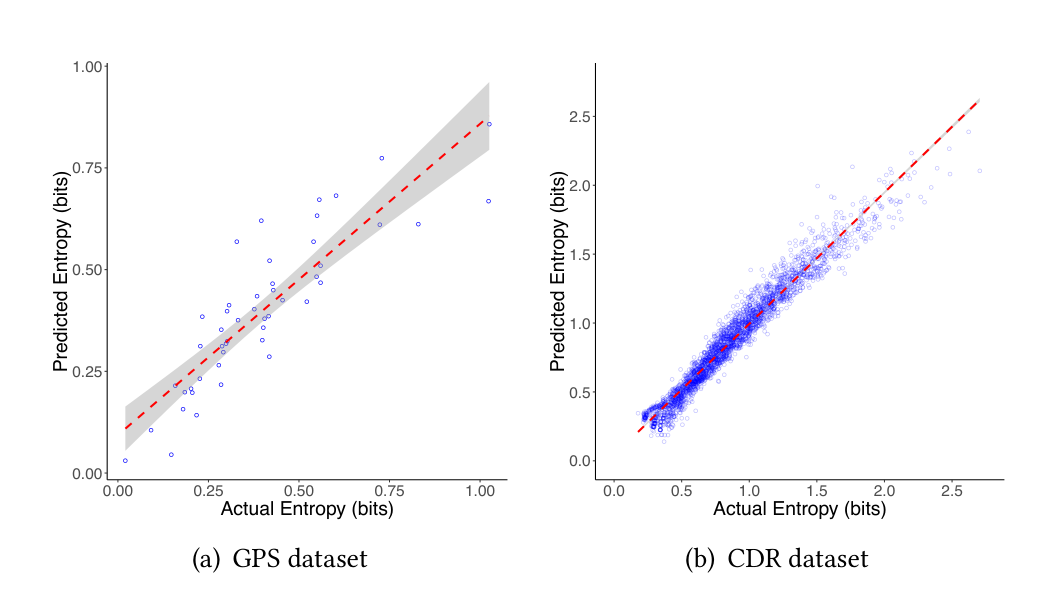
图 2|两个结构指标合在一起,能把熵复原到多近?
(a)GPS。横轴实际熵,纵轴回归给出的熵,单位都是比特,坐标大约0到1。红虚线是拟合关系,灰带是置信区间,论文没有写明置信水平。点围绕红线分散,灰带在右端更宽。(b)CDR,筛选后2780人。坐标大约画到2.5比特。大多数点贴着红线,灰带窄到几乎看不见;低熵处仍有一小团点,高熵处也有偏离。来源:原论文 Fig. 2。
图2是用同一批用户拟合后再回看。论文没有把用户分成训练和测试,也没有按时间前半段拟合、后半段检验。CDR更贴对角线,和2780个点、两周序列的R² = 0.94一致;这同时反映短期、较粗的记录更容易被两个结构指标概括。它还不能推出同一个人若被跟踪18个月,熵的94%仍由这两项决定。
采样一放稀,平均熵就上升;格子一放大,猜中的区域也变大
先前研究已经表明,时间分辨率变高(同一时段观测更多)或空间分辨率变低(格子更大),可预测性估计会升高。本文用规律度和停留性把这条经验再看一遍。时间箱能从5分钟改到60分钟,是因为GPS本来就密;CDR做不到同样的比较。每个时间箱里随机抽取一条观测。论文没有报告换一次随机抽取,平均值会晃动多少。
| 时间分辨率(分钟) | 平均规律度 | 平均停留性 | 平均熵(比特/符号) |
|---|---|---|---|
| 5 | 80.72 | 41.28 | 0.40 |
| 10 | 57.89 | 30.79 | 0.50 |
| 20 | 38.24 | 19.49 | 0.66 |
| 30 | 30.75 | 14.68 | 0.80 |
| 40 | 25.75 | 12.48 | 0.90 |
| 50 | 22.79 | 10.76 | 0.98 |
| 60 | 20.27 | 9.68 | 1.05 |
表1的三列都是GPS用户的平均。从5分钟到60分钟,平均停留性从41.28降到9.68:两次记录隔得越久,越可能已经不在同一格。平均规律度从80.72降到20.27,因为序列变短,而规律度的分子正是序列长度。平均熵从0.40升到1.05,比5分钟那一行高0.65比特。熵上升,对应可预测性上限下降。
空间分辨率只能在GPS上改,因为它的坐标细到可以重划格子。格子变大,更多观测落进同一格,平均停留性总体上升,人走出格子的机会变少,平均规律度也上升。
| 空间分辨率(米) | 平均规律度 | 平均停留性 | 平均熵(比特/符号) |
|---|---|---|---|
| 300 | 129.76 | 41.65 | 0.404 |
| 400 | 140.37 | 71.16 | 0.389 |
| 500 | 165.66 | 90.04 | 0.379 |
| 600 | 168.60 | 76.66 | 0.351 |
| 700 | 184.58 | 94.82 | 0.285 |
| 800 | 194.21 | 96.32 | 0.286 |
| 900 | 202.66 | 96.29 | 0.284 |
| 1000 | 210.40 | 95.69 | 0.264 |
规律度从300米的129.76单调增到1000米的210.40。停留性大体上升,但500米的90.04到600米降为76.66,900米的96.29到1000米的95.69也略降。熵从0.404降到0.264,下降0.140比特,相当于300米那一行的34.7%;800米的0.286比700米的0.285略高。所以整体方向是格子越大、平均熵越低,相邻两档并不每一步都更低。
熵下降、上限上升的代价是预测更空。格子越大,用户的活动越容易被少数格子罩住,猜中下一格更容易,猜中的那一块也越大、越不含信息。极端情形是整张地图只有一个格子:预测永远正确,也几乎没有用。更小的格子提高可用性,同时可能降低命中。
表1在5分钟的平均熵0.40、停留性41.28,和表2在300米的0.404、41.65很接近,规律度却是80.72对129.76。论文没有写明表1固定用哪一种格子,也没有写明表2固定用哪一种时间箱,尽管全文默认是5分钟和300米。两行既然不是同一组平均数,就只能把表1读成时间分辨率的比较、表2读成空间分辨率的比较。
作者还提到,停留性很高时,公开某一个时刻的格子,可能同时让人知道随后一段时间仍在这一格;因此规律度和停留性也可以作为汇总指标单独发布,而不发布整条轨迹。这是数据发布上的提醒。论文没有检验这些汇总会不会对应到具体的人。
钟点为什么不能直接塞进原来的压缩器?
规律度和停留性盖住了熵的大部分变异,星期、一天中的小时、天气,以及社会经济条件,仍可能参与一个人的移动。社会经济条件只出现在这段直觉里,后文没有对应的变量或结果。实际放进估计的,是星期、小时和天气。
最大命中率是熵的函数,所以情境若能降低熵,上限就会提高。地点序列记为X,与每次访问对齐的情境序列记为Y。条件熵
H(X | Y) = H(X) − I(X, Y)
等于地点熵减去二者的互信息。互信息越大,已知情境之后剩下的不确定越少。这是两条已经观测到的序列共享了多少信息。天气是否促使人改道,这两套数据没有单独检验。
Song等人的压缩算法不使用符号的概率分布,而条件熵恰好依赖这个分布,因此情境塞不进去。若把地点和情境捆成一对再压缩,估到的是联合熵H(X, Y),也就是两条序列合在一起有多不确定。本文要的是条件熵:情境已知后,地点序列还剩多少不确定。Lempel-Ziv因此改为按情境取值把历史拆开。小时的例子是拆成24条序列,每条只含该小时到过的地点,分别估计再平均。论文说Lempel-Ziv的结果都用这一做法;星期和天气的分组数没有另给。
另外三种估计直接在概率上计算,可以先算熵和互信息,再代入上面的条件熵。最大似然用经验频率,等价于样本的香农熵。Miller-Madow在香农熵上加偏差校正。SG用狄利克雷多项伪计数,参数a = 1/length(X),在他们试过的同类狄利克雷估计里结果最好;另外几种的数值没有列出。除最大似然和Lempel-Ziv外,校正项使熵估计更保守,更不容易把一条短序列说成极低熵。情境被离散成编号,天气的例子包括雨、雪、云等,名单不完整,数据来自哪一次预报或哪一个观测网,论文没有写。
下一格:频率型的熵会降,压缩型拆短之后反而升
图3用最大似然、以小时为情境,看下一格的熵。正文写这样能把熵降低45%。图上没有画出45%这条线。
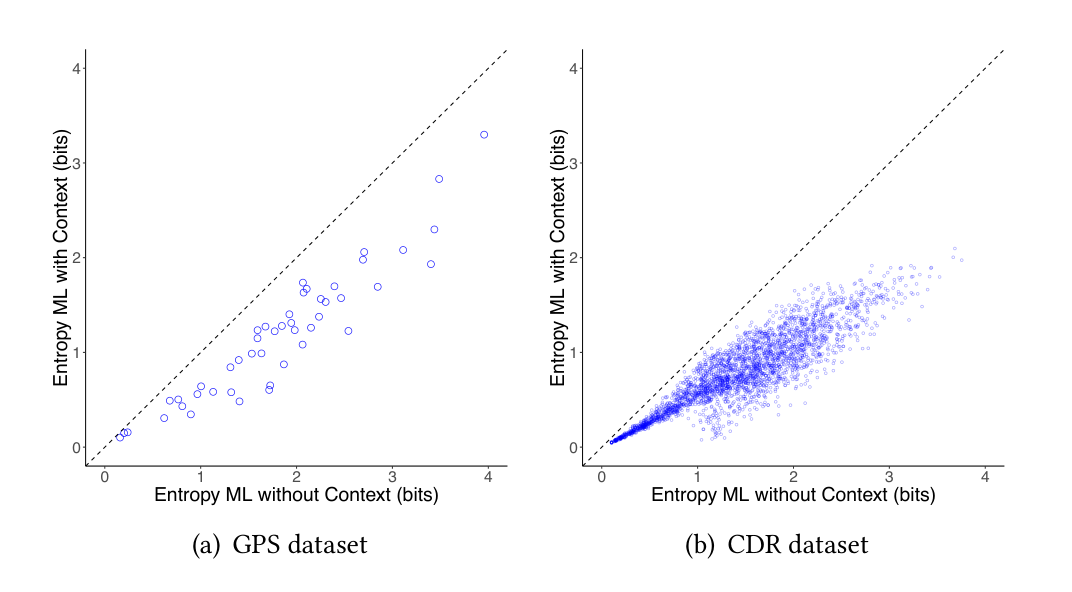
图 3|已知小时以后,下一格的最大似然熵是否更低?
(a)GPS。(b)CDR。横轴都是无情境的最大似然熵,纵轴是加入小时后的最大似然熵,单位比特,坐标0到4。灰色虚线是对角线。点落在线的下方,表示该用户的熵下降。GPS的点较疏,从靠近原点一直散布到横轴4附近;CDR的点在对角线下方形成一条更密的云,低熵一端贴近对角线,高熵一端离线更远。来源:原论文 Fig. 3。
图1写明每个点是一名用户。图3的图注没有再定义分析单位,坐标仍是按序列计算的熵。GPS子图看得见的点都在4比特以内。
表3给出四种估计在两种题目、两套数据上的熵,单位是比特/符号。GPS没有天气列。每个格子只有一个数,论文没有写它是人均、中位数,还是把所有人拼成一条序列后的熵。
| 题目 | 估计 | GPS无情境 | GPS星期 | GPS小时 | CDR无情境 | CDR星期 | CDR小时 | CDR天气 |
|---|---|---|---|---|---|---|---|---|
| 下一格 | 最大似然 | 6.01 | 1.48 | 1.18 | 1.45 | 1.13 | 0.79 | 1.23 |
| 下一格 | Miller-Madow | 10.6 | 1.61 | 1.22 | 7.86 | 1.20 | 0.91 | 1.32 |
| 下一格 | SG | 4.62 | 1.48 | 1.19 | 2.66 | 1.17 | 0.84 | 1.27 |
| 下一格 | Lempel-Ziv | 0.40 | 0.39 | 0.72 | 1.01 | 1.34 | 1.38 | 1.30 |
| 下一地点 | 最大似然 | 4.82 | 3.80 | 2.98 | 2.39 | 1.74 | 0.59 | 1.72 |
| 下一地点 | Miller-Madow | 5.55 | 4.17 | 3.36 | 8.80 | 2.05 | 1.02 | 1.98 |
| 下一地点 | SG | 5.55 | 3.85 | 3.07 | 2.92 | 1.87 | 1.02 | 1.84 |
| 下一地点 | Lempel-Ziv | 3.11 | 2.80 | 2.14 | 1.94 | 1.50 | 0.64 | 1.21 |
先看和45%有关的两格。CDR下一格的最大似然从1.45降到0.79,下降(1.45 − 0.79) / 1.45 ≈ 45.5%,和正文的45%接近。GPS同一行从6.01降到1.18,下降(6.01 − 1.18) / 6.01 ≈ 80.4%。45%概括不了GPS这一行。再加上图3的横轴只到4,6.01也不可能是图3(a)那些点的算术平均。表3的6.01只能当作论文报告的汇总值。与此同时,GPS下一格、无情境的Lempel-Ziv是0.40,与表1里5分钟的平均熵相同,这一格和按人平均的口径接得上。读表时这两类数字不能合成一个平均数。
再看情境有没有让所有估计都变低。最大似然、Miller-Madow和SG在表3的下一格各列里,加了星期、小时或天气之后都低于本数据集的无情境格。Lempel-Ziv相反:GPS从0.40升到小时条件下的0.72,CDR从1.01升到1.38;CDR的星期是1.34,天气是1.30,也都高于1.01。GPS的星期只从0.40降到0.39。拆成24条更短的序列之后,Lempel-Ziv更难靠近真实熵率,估计会偏高。GPS的序列长,小时条件下的0.72仍低于最大似然的1.18;CDR更短,小时条件下的最大似然0.79已经低于无情境Lempel-Ziv的1.01。
因此,无情境的压缩熵在下一格上仍然很低:GPS 0.40,低于同列最大似然6.01、SG 4.62和Miller-Madow 10.6;CDR 1.01,低于1.45、2.66和7.86。顺序里的重复,尤其是连续停留,已经被压缩算法吃进去了。正文据此认为,下一格在长期更依赖常去地点的顺序,小时和天气会改熵,却不一定比这段历史更有信息。这个判断贴合GPS:无情境Lempel-Ziv的0.40,低于表中任何带情境的频率型估计。它盖不住CDR的小时列,因为那里最大似然、SG和Miller-Madow分别是0.79、0.84和0.91,都低于1.01。
天气只出现在CDR。下一格最大似然从1.45降到1.23,降幅0.22比特,小于小时带来的0.66比特。论文举例说,人通常在大致固定的时间上班和回家,用天气去预测这种回家或上班,可能给估计添上噪声。例子没有配上这两套数据里的通勤观测。
下一地点:拿掉原地停留以后,小时才更明显
下一地点只保留换格子的那一步,停留性按定义被去掉。高度停留的序列熵更低;把停留拿掉、情境留着,就能看情境还能不能把熵降下来。
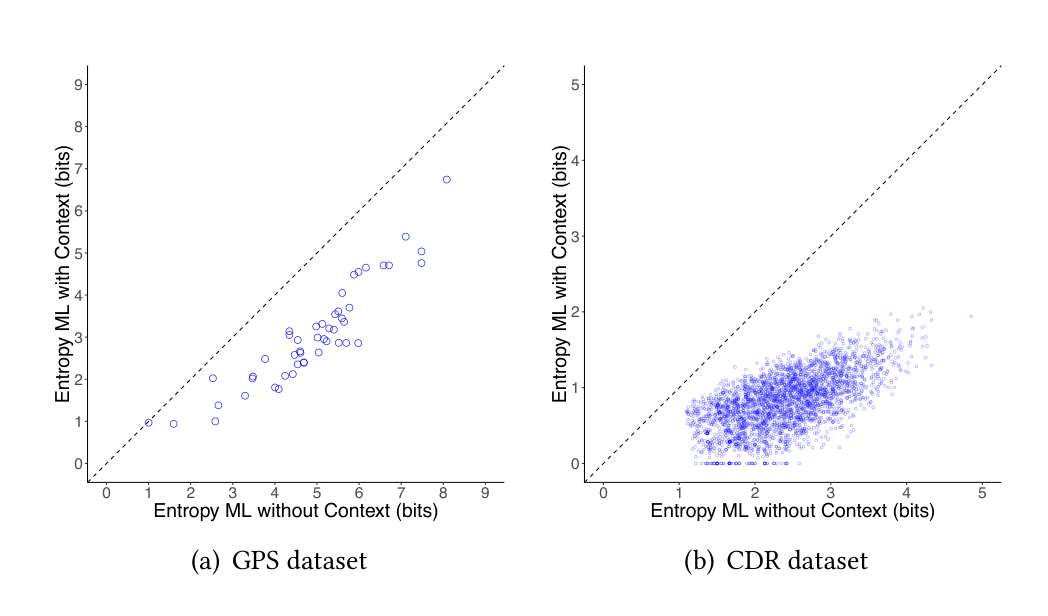
图 4|去掉连续停留之后,小时还能让最大似然熵下降吗?
(a)GPS,坐标大约0到9比特。多数点在灰色对角线下方,低熵一端有点贴着对角线,右端一个点接近横轴8、纵轴7,仍在线的下方。(b)CDR,坐标大约0到5比特。点的主体在对角线下方、纵轴2比特以内;还有一批点贴着纵轴0,这些用户在图中的条件熵落到0;其余点仍散在0以上。来源:原论文 Fig. 4。
无情境的Lempel-Ziv从下一格的GPS 0.40、CDR 1.01,升到下一地点的3.11和1.94。GPS的升幅是2.71比特,CDR是0.93比特。5分钟采样更容易记下连续停留,拿掉这些停留之后熵上升更陡,和停留性的定义一致。两套数据的人数、时长和空间精度不同,差额不能全部算到采样间隔上。
带小时之后,下一地点的熵继续低于各自的无情境格。最大似然从GPS的4.82降到2.98,相对下降(4.82 − 2.98) / 4.82 ≈ 38.2%;CDR从2.39降到0.59,相对下降(2.39 − 0.59) / 2.39 ≈ 75.3%。绝对差距分别是1.84比特和1.80比特。下一格的最大似然绝对差距则是GPS 4.83比特、CDR 0.66比特。所以按最大似然的绝对差距,CDR是下一地点更宽,1.80比特对下一格的0.66比特;GPS是下一格更宽,4.83比特对下一地点的1.84比特。正文说情境带来的缺口在下一地点更宽。Lempel-Ziv的小时行符合这个方向:下一地点从3.11降到2.14、从1.94降到0.64,下一格则从0.40升到0.72、从1.01升到1.38。
CDR下一地点、小时条件下,最大似然0.59略低于Lempel-Ziv的0.64。这是论文指出的例外:序列被小时拆短以后,最大似然可以低于压缩估计。GPS的对应格仍是Lempel-Ziv更低,2.14对最大似然2.98。短历史、新用户,可以先用最大似然;历史长到压缩估计能用之后再换。这个长度随数据集变化,论文没有给出比特或天数的阈值。
星期和天气在CDR下一地点上也低于无情境,但弱于小时。最大似然从2.39降到星期1.74、天气1.72,小时则到0.59。GPS没有天气列,无法做同一比较。
还要分清两件事。条件熵仍然使用地点序列,只是多了一个已知的情境;情境没有替换掉这个人去过哪里。表3每一列还同时换了估计器。最大似然看频率,Lempel-Ziv看能否压缩出的顺序。0.59低于1.94,说明CDR下一地点上,带小时的最大似然条件熵低于不带情境的压缩熵。两列的估计器不同,差距里同时有情境和算法。
这些比特数停在哪里
熵下降表示在当前格子、当前采样和当前估计下,序列的不确定变少,法诺关系允许的命中率上限可以更高。本文没有解出Πmax,也没有训练预测器去逼近它。论文把具体算法能否达到这些估计留作后续工作。表3里最低的比特数,仍然是一种熵估计。
这些估计给出的是近似上限。柯尔莫哥洛夫复杂度对应的硬边界不可计算,论文写明熵估计到不了那个硬边界。序列越短,Lempel-Ziv越可能把熵估高,小时列已经出现这种情况。Miller-Madow和SG的校正把短样本的熵估得更保守。四种估计并排,才能看出最小的那个数依赖哪一种算法。
R²、图1和图2说明规律度与停留性能够在样本内跟上压缩熵。系数缺失,留出检验也缺失。CDR散点被省略之后,仍有−0.84和−0.83两个相关可以核对,图上的离群长什么样则只在GPS里看得见。
表1和表2的5分钟行与300米行不是同一组平均数。时间箱实验又是每个箱随机抽一条。空间上相邻档的停留性和熵也有小幅回升。把300米到1000米说成单调变好,越过了表2本身。
天气的来源和完整类别没有给出,GPS表里没有天气。社会经济因素没有进入计算。两套数据不能互相代表,也不能代表未安装这个应用、或不在这家运营商两周样本里的人。
一句话总结
人的移动有多可预测,先取决于题目是猜下一格还是猜下一地点,再取决于格子多大、采样多密、熵用哪种算法来估;连续停留让下一格很好压缩,拿掉停留之后,小时才更明显地降低熵。
核心来源
- ACM SIGSPATIAL ’19正式论文,DOI 10.1145/3347146.3359093。会议为2019年11月5–8日,Chicago,ACM出版,10页。正文证据是图1–4和表1–3。
- 压缩熵沿用Song、Qu、Blumm与Barabási在Science 327卷5968期(2010)给出的框架;下一格与下一地点的题目划分沿用论文所引的Cuttone、Lehmann与González。法诺公式的展开论文指向Smith等人与Song等人的推导。
- 图1的CDR散点在正文中写明省略。回归系数、每个用户的地点数、天气数据来源和CDR筛选前的人数,正文都没有给出。
作者介绍
以下只依据论文署名页上的单位,论文没有贡献声明,也没有标出通讯作者。
- Douglas do Couto Teixeira:署名第一作者,单位是巴西贝洛奥里藏特的米纳斯吉拉斯联邦大学。
- Aline Carneiro Viana:署名单位是法国帕莱索的Inria与巴黎-萨克雷大学。
- Mário S. Alvim:署名单位同为米纳斯吉拉斯联邦大学。
- Jussara M. Almeida:署名单位同为米纳斯吉拉斯联邦大学。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个城市看板只公布一个可预测性百分比,这个数至少还要带上题目和格子面积。在这套GPS上,边长从300米增到1000米,平均熵从0.404降到0.264比特/符号,上限看起来更高,猜中的区域也从边长300米变成1000米。把全城画成一个格子时,命中率会到顶,交通调度却得不到可执行的地点。并列报告熵和格子面积,才能看出准确率是用信息换来的,还是用放大格子换来的。
另一个容易判反的地方是特征筛选。下一格任务里,按小时拆开历史后,表3的Lempel-Ziv从GPS的0.40升到0.72、从CDR的1.01升到1.38,最大似然的汇总值从6.01降到1.18、从1.45降到0.79。只盯着压缩熵的团队,可能删掉小时;只盯着最大似然的团队,会把小时留下。两周CDR再按24小时切开,每条序列更短,压缩估计向上偏的风险更大。比较应该在同一次拆分上同时看条件熵和压缩熵。论文说Lempel-Ziv开始靠拢的长度因数据而异,却没有给出这条分界,这正是下一步可以测量的数。
第三,同一个人在两种题目下的名次可能不同。下一格熵很低,可能只是因为夜间长时间停在一个格子;下一地点熵把这些自转移拿掉,才更接近目的地是否规律。论文没有报告二者在45名或2780名用户中的等级相关。若推荐系统用低可预测性挑选更愿意接受新地点的人,用下一格还是下一地点,选中的会是两群人。这个相关一旦接近0,两种产品规则就不该共用一个上限。