两个地方之间有多少人通勤,要不要把旁边的街区也算进去?
论文名片|Zhicheng Liu、Fabio Miranda、Weiting Xiong、Junyan Yang、Qiao Wang、Claudio T. Silva,Learning Geo-Contextual Embeddings for Commuting Flow Prediction,首页版权声明为 Association for the Advancement of Artificial Intelligence,2020;同一页印有 arXiv:2005.01690v1,2020年5月4日。arXiv:2005.01690。首页与文末参考文献均未印刷 DOI。这是一篇通勤流量预测方法论文,检验数据是纽约市普查区上的汇总人数。
论文用一个规划问题说明动机:如果布鲁克林某个区域规划一座高科技产业园,上班的人会从哪些区域来,配套交通该怎样布置。实验本身使用的是已经汇总好的居住地—工作地人数。一个普查区会不会送出或接收很多通勤者,往往和紧挨着的街区连在一起。只把起点和终点各自的人口或用地放进公式,邻近街区的影响进不去。
这项研究把地理上相邻的普查区连成图,用两套图注意力网络把周围用地写进向量,再交给梯度提升树,预测一对普查区之间的通勤人数。在 2015 年纽约市数据的测试对上,完整模型的误差低于引力模型,也低于直接使用两端指标的梯度提升树。改进记录在汇总人数上:每条预测都是一个普查区对的人数。
先说结论
- 测试起讫点对上,GMEL 的均方根误差 RMSE 为 4.887 人,平均绝对误差 MAE 为 1.747 人,共同部分 CPC 为 0.741。相对同表最强基线、梯度提升回归树 GBRT 的 5.454、1.974 和 0.707,RMSE 下降 (5.454−4.887)/5.454 = 10.4%,MAE 下降 (1.974−1.747)/1.974 = 11.5%,CPC 升高 0.034。
- 相对指数衰减引力模型 GM-E 的 RMSE 6.944,GMEL 下降 (6.944−4.887)/6.944 = 29.6%。两个引力模型彼此只差 0.091,远小于它们和 GMEL 的差距。
- 去掉多任务后 RMSE 升到 5.356,不再把起点和终点分成两套网络后升到 4.982。完整模型、这两个变体、GBRT、Node2vec 在 RMSE、MAE、CPC 上的排序一致。随机森林的 MAE 是全表最高的 2.436,高于两个引力模型。
- 一层邻居不够,两层及以上变化不大。两跳邻域在纽约平均覆盖 1.5 公里,论文将它约成 15 分钟步行。这是邻近语境的范围;通勤路程由 OSRM 另行计算,正文没有给出路程的均值。2013 年训练、2015 年检验的 5 个普查区,平均绝对误差在 0.86 到 1.40 人之间,五个标准差都大于对应的平均绝对误差,案例里也没有同期基线。
要预测的人数,是居住地和工作地之间的汇总
通勤流量(commuting flow)在这里是一对地理单元之间的通勤者人数。交通起讫点的时间序列预测可以把这条连线过去的流量当作输入。本文的输入是节点上的用地与基础设施,再加上单元之间的路程,输出是这条连线的人数。作者认为通勤日复一日,所以用地指标可以和这张相对稳定的居住地—工作地网络放在一起。
地理单元用的是 2010 年纽约市普查区(census tract),共 2168 个。通勤人数来自 2015 年就业统计 LODES。它按年记录工作者的居住地和工作地,再汇总到地理单元,论文称之为稳定的通勤流。全市共 3,031,641 名通勤者、905,837 个起讫点对。平均每对 3,031,641 / 905,837 = 3.35 人。这个平均的分母是全部观测对;后文测试误差的分母是测试对,两处数字分开引用。
2168 个普查区的有向组合共 2168 × 2168 = 4,700,224 对,其中包含起点与终点相同的 2168 对。905,837 个观测对约占 19.3%。误差只在这些已收集的对上计算。论文把它们按 6:2:2 随机分成训练、验证和测试,没有说明是否按人数加权,也没有给出取整后的三组对数。未出现在 LODES 里的零流量对没有进入 RMSE。
用地来自 2015 年 PLUTO,先记在税地块上,再汇总到普查区。每个普查区 65 个城市指标:基础设施 40 个,包括 25 类建筑数量、4 类密度和 11 个建成年份区间;土地利用 23 个,包括 11 类税地块数量、10 类用地面积比和 2 个容积率统计;特殊类 2 个,表示该区是否含有地标或历史街区。表 1 只给到这一层分类,没有逐项列出全部 65 个名字。
路程用 OSRM 计算普查区质心之间的道路距离,取的是沿路网的里程。这张路程同时扮演两个角色:地理邻接边上的特征,以及预测每一对流量时额外拼上的一个数。
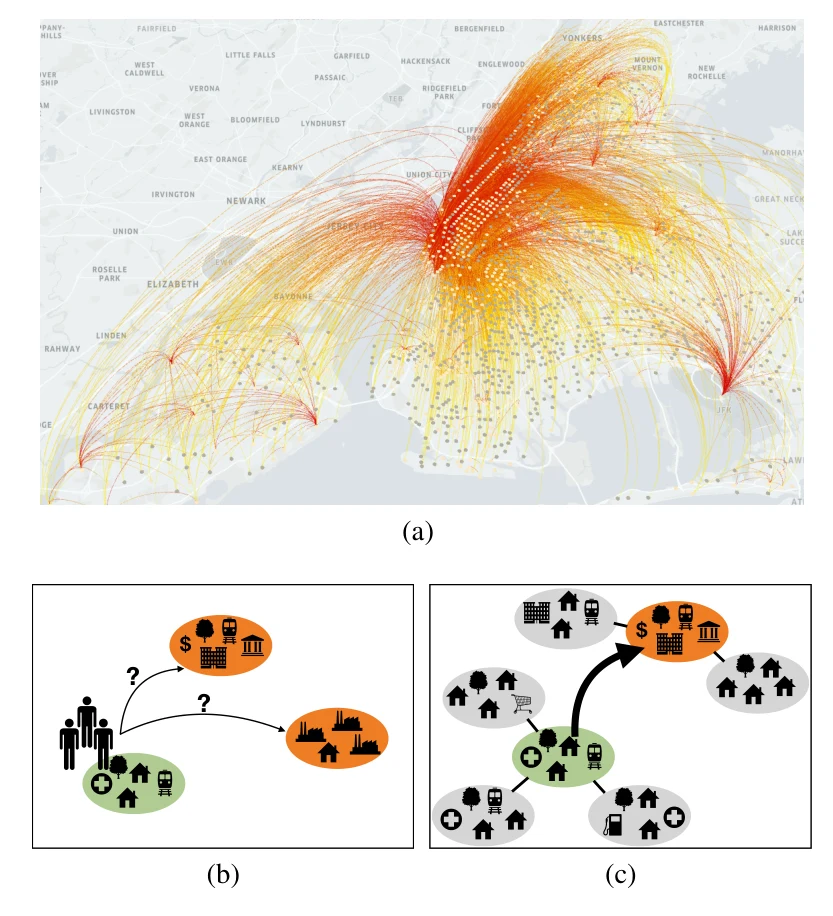
图 1|通勤流量预测到底在预测什么,地理语境又补在哪里?
(a)2015 年纽约通勤流网络的例子。黄点表示起点普查地理单元,红点表示终点单元,线条从外围汇向颜色更红的核心。底图画出了市界以外的地名,画面范围大于后文的分析样本。后文样本是纽约市 2168 个普查区。(b)示意:居民选择工作地时会看配套、距离等因素,问号表示这条流量尚未由历史流量直接给出。(c)示意:把周围地块的用地一起纳入,再估计中心这对地点之间的流量。来源:原论文 Fig. 1。
只看两头,漏掉的是什么?
引力模型把两地流量写成两端规模越大越大、路程越远越小。论文列出的幂律形式是
T̂ᵢⱼ = α₀ × Mᵢ 的 α₁ 次方 × Mⱼ 的 α₂ 次方 / dᵢⱼ 的 α₃ 次方。
Mᵢ、Mⱼ 在公式说明里是两个区域的人口,dᵢⱼ 是路程,四个 α 是待估参数。实验比较了幂律衰减 GM-P 和指数衰减 GM-E。指数形式在既有文献里被报告为更适合通勤,本文测试表上也略好:RMSE 6.944 对 7.035,MAE 2.179 对 2.236,CPC 0.602 对 0.589。正文没有另行说明这次拟合的人口用的是居住人口、就业人口,还是别的规模变量。
随机森林和梯度提升树改用起点、终点的节点属性做回归,能够容纳非线性。论文认为它们仍然忽略邻近区域。介入机会一类模型会考虑附近的竞争目的地,辐射模型是其中的代表;本文没有把辐射模型放进测试表,而是把邻近区域的用地直接编进每个节点的向量。
作者引用地理学第一定律作为动机:事物彼此相关,近处比远处更相关。这是选择图结构的理由。图本身没有单独检验这一定律是否成立。
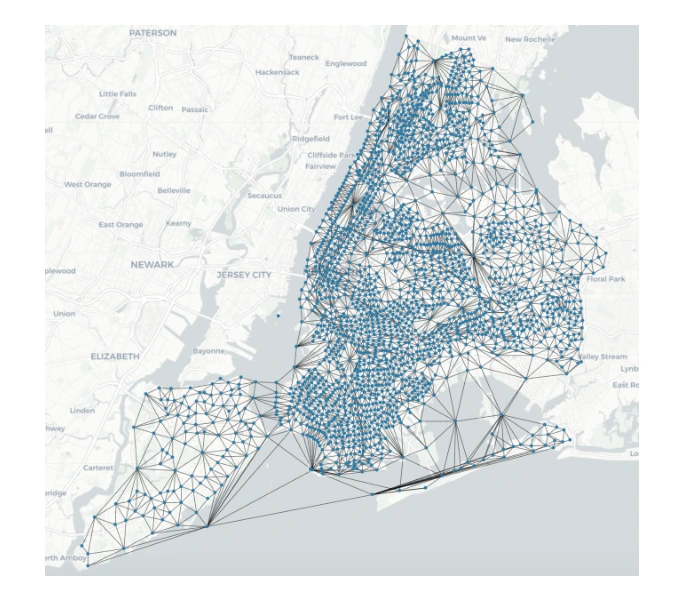
图 2|邻近关系被连成了怎样一张图?
无字母子图。蓝点是纽约市普查区质心,灰线是地理邻接边。底图可见新泽西等地名,节点集中在纽约市五区。边特征在实验里是质心之间的 OSRM 路程。正文把边定义写成地理上相邻,没有进一步写成共边、共点或距离阈值。来源:原论文 Fig. 2。
旁边的街区怎样进入预测?
地理邻接网络是一张无向加权图。节点是 2168 个普查区,节点属性是 65 个用地指标,边只连相邻普查区。图注意力网络(graph attention network,GAT)沿这些边传递信息。邻居的消息先做线性变换;每条边的权重由两端特征和边的路程算出,再在该节点的邻居里归一化。更新后的向量是邻居消息的加权和,再加上节点自身的一份变换。层数就是跳数:一层只看直接邻居,两层看到邻居的邻居。
通勤被看成起点供给和终点需求之间的空间相互作用。起点嵌入经过一个线性层预测该区总流出,终点嵌入预测总流入,两端嵌入再用一个双线性层预测这一对的人数。双线性层用一个可学习矩阵把起点向量和终点向量组合成这一对的预测人数。
多任务学习把这三件事同时放进训练。主任务损失是起讫点对上的平方误差平均,分母是参与计算的对的数量。总损失等于主任务权重乘主任务损失,再加上子任务权重的一半乘流入损失与流出损失之和。主结果里两个权重都取 0.5,于是主任务损失的系数是 0.5,流入与流出两项之和的系数是 0.25。论文把这两个 λ 都等于 0.5 称作权重相等。印刷出来的流入损失是预测值减去预测值,按式子恒为 0;流出损失写成单个平方项再除以普查区数,页面上没有标出对全部普查区求和。表 2 里多任务带来的误差下降,来自消融实验。
同一节里还有一处方向相反的文字。模型假设写的是起点供给、终点需求;紧接着又写起点网络提取需求、终点网络提取供给。公式和后文指标没有跟着对调:总流出由起点嵌入预测,总流入由终点嵌入预测。后面的读法以公式和显著指标为准。
上述网络先在训练对上端到端训练,这一步是预训练。随后把起点嵌入、终点嵌入和这对的路程拼成特征,再训练一棵梯度提升回归树(gradient boosting regression tree,GBRT),由这棵树给出最终人数。表 2 的 GMEL 是这条两段流程的测试结果。图 3 只画了前一段,没有画出最终那棵树。论文也没有报告双线性层单独在测试集上的 RMSE。
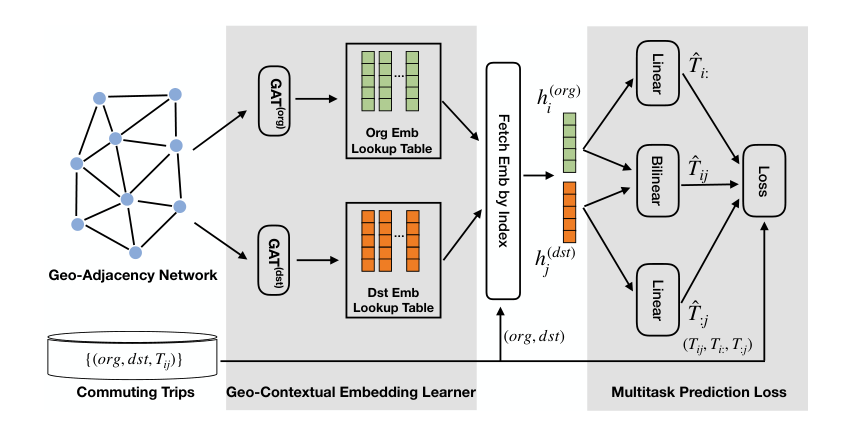
图 3|地理语境怎样被训练成起点向量和终点向量?
无字母子图。左侧是邻接图和通勤三元组。中间两套 GAT 分别维护起点嵌入和终点嵌入,按起终点索引取出一对向量。右侧三个头同时工作:一个线性层预测总流出,一个双线性层预测这对的流量,另一个线性层预测总流入,三者一起进入损失。图中没有第二阶段的梯度提升树。来源:原论文 Fig. 3。
主比较的设置是两套网络都用 128 维嵌入、2 层 GAT,多任务权重都是 0.5。实现使用 PyTorch 和 Deep Graph Library。学习率只以符号出现,批大小、迭代次数和验证集如何参与早停,正文都没有给出。
测试误差相对哪条基线下降?
评价指标有三个,都在测试对上计算。RMSE 和 MAE 的分母是测试起讫点对的数量,单位是每一对相差多少人。CPC 的分子是两倍的“预测与观测取较小值”之和,分母是预测总和加观测总和。0 表示两侧流量没有重叠,1 表示完全相同。CPC 描述的是流量数值的重叠,越高越好。
| 模型 | RMSE | MAE | CPC |
|---|---|---|---|
| 幂律引力 GM-P | 7.035 | 2.236 | 0.589 |
| 指数引力 GM-E | 6.944 | 2.179 | 0.602 |
| 随机森林 RF | 6.273 | 2.436 | 0.638 |
| 梯度提升回归树 GBRT | 5.454 | 1.974 | 0.707 |
| Node2vec | 5.455 | 1.994 | 0.704 |
| 去掉多任务 GMEL-noMul | 5.356 | 1.910 | 0.716 |
| 起点终点共用一套网络 GMEL-noSep | 4.982 | 1.772 | 0.737 |
| GMEL | 4.887 | 1.747 | 0.741 |
表中 RMSE、MAE 越低越好,CPC 越高越好。数字抄自原论文表 2,测试集为 6:2:2 划分中的一份,精确对数未给出。
GMEL 相对 GBRT:RMSE 少 0.567 人,相当于 GBRT 误差的 10.4%;MAE 少 0.227 人,相当于 11.5%;CPC 从 0.707 升到 0.741。相对 GM-E,RMSE 少 2.057 人,相当于 29.6%。全体观测对的平均流量是 3.35 人,分母是 905,837 个观测对;测试 RMSE 是 4.887 人,分母是测试对。平方误差会把少数大流量对的偏差放得很大。
Node2vec 也在同一张邻接图上学习节点向量,再交给梯度提升树。这些向量按网络邻域训练,训练目标里没有通勤人数。它的 RMSE 5.455 比 GBRT 的 5.454 高 0.001,MAE 高 0.020,CPC 低 0.003。论文说它略好于随机森林、只与 GBRT 相当。表上它三项都略差于 GBRT。邻接结构被保存下来之后,供给和需求仍要靠后面的通勤损失才会分开。
两个变体说明设计里的两处选择并不等额。去掉多任务后,RMSE 从 4.887 升到 5.356,升高 0.469,相当于 5.356 的 8.8%,只比 GBRT 低 0.098,相当于 GBRT 的 1.8%。起点和终点共用一套网络时,RMSE 为 4.982,比完整模型高 0.095,相当于 4.982 的 1.9%,仍比 GBRT 低 0.472,相当于 GBRT 的 8.7%。因此,在这一次划分上,多任务带来的额外降幅大于“再拆成两套网络”;只加两套网络、不加多任务,相对 GBRT 的改进很小。论文据此认为两处设计都有效,因为完整模型优于两个变体。这个方向成立,贡献大小并不对称。
随机森林被引用文献称作较强的现成模型。在这张表里,它的 RMSE 6.273 和 CPC 0.638 好于两个引力模型,MAE 2.436 却是八个模型里最高的,比 GM-E 的 2.179 高 0.257,相当于 2.179 的 11.8%。平方误差和绝对误差没有同时改善。
还有一项特征对照没有被单独拆开。论文写明机器学习基线使用起点和终点的节点属性,没有写明这些基线是否也放入了路程。GMEL 的第二阶段明确拼接了路程。表 2 的差距同时包含嵌入方式、多任务,以及第二阶段看到的特征。
残差更平滑,是不是每个普查区都更准?
图 5 把流向同一终点的流量残差加总,画在终点普查区上。色标的单位因此是一个普查区的汇入人数误差。图例标着 −1242、−811、−412、−15、125、380、704。红色表示低估,蓝色表示高估,浅蓝色表示最接近的预测。−1242 的分母是汇入同一普查区的多条流量;4.887 的分母是测试起讫点对上的均方根。
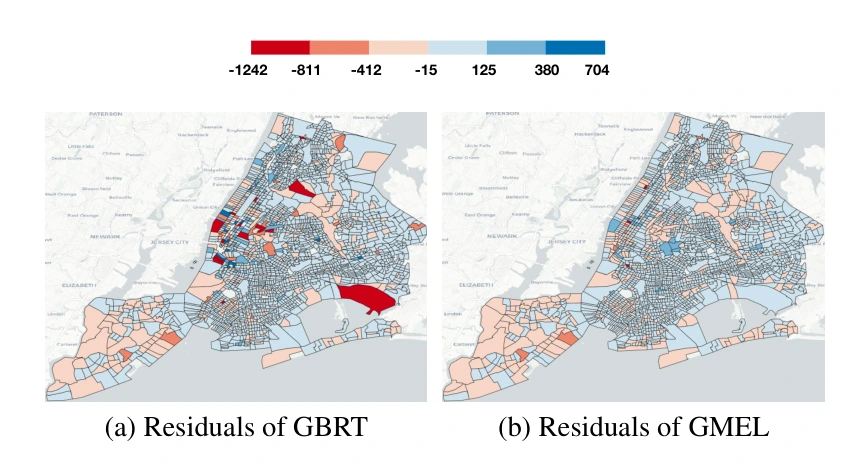
图 5|加上地理语境之后,汇入残差在地图上有什么变化?
色标单位是汇入同一终点的残差之和。红色为低估,蓝色为高估,浅蓝色最接近观测。(a)GBRT 的汇入残差,深红色斑块更醒目。(b)GMEL 的汇入残差,大范围更接近浅色。论文据此认为 GMEL 的残差在空间上更平滑,因为预测同时用到了目标区及其邻近区。图没有给出每个区的残差表。来源:原论文 Fig. 5。
平滑描述的是合计残差的空间分布。一个区的合计变小,既可能来自许多对的小幅改进,也可能来自正负误差互相抵消。图 5 没有分开这两种情形,也没有给出置信区间或多次随机划分。
邻居要看多远,向量要多长?
图 4 分别变动层数、嵌入维度和多任务权重。正文没有印出每个点的 RMSE,精确的主结果仍以表 2 的 4.887 为准。层数为 1 时更差;大于或等于 2 层之后起伏不大。作者由此把有效邻域定为两跳,并写出两跳在纽约平均覆盖 1.5 公里,大约相当于 15 分钟步行。1.5 公里是邻居语境的平均范围。OD 路程另由 OSRM 计算,正文没有报告这些通勤路程的均值或中位数。
嵌入维度试了 32、64、128、256。从 32 增大时表现上升,到 128 趋于饱和。多任务权重从只有主任务,逐步加到主任务与子任务相等。子任务权重上升时,主任务误差下降,直到两者都是 0.5。图上还画了子任务权重更高的 (0.33,0.66),正文没有报告它继续明显变好。
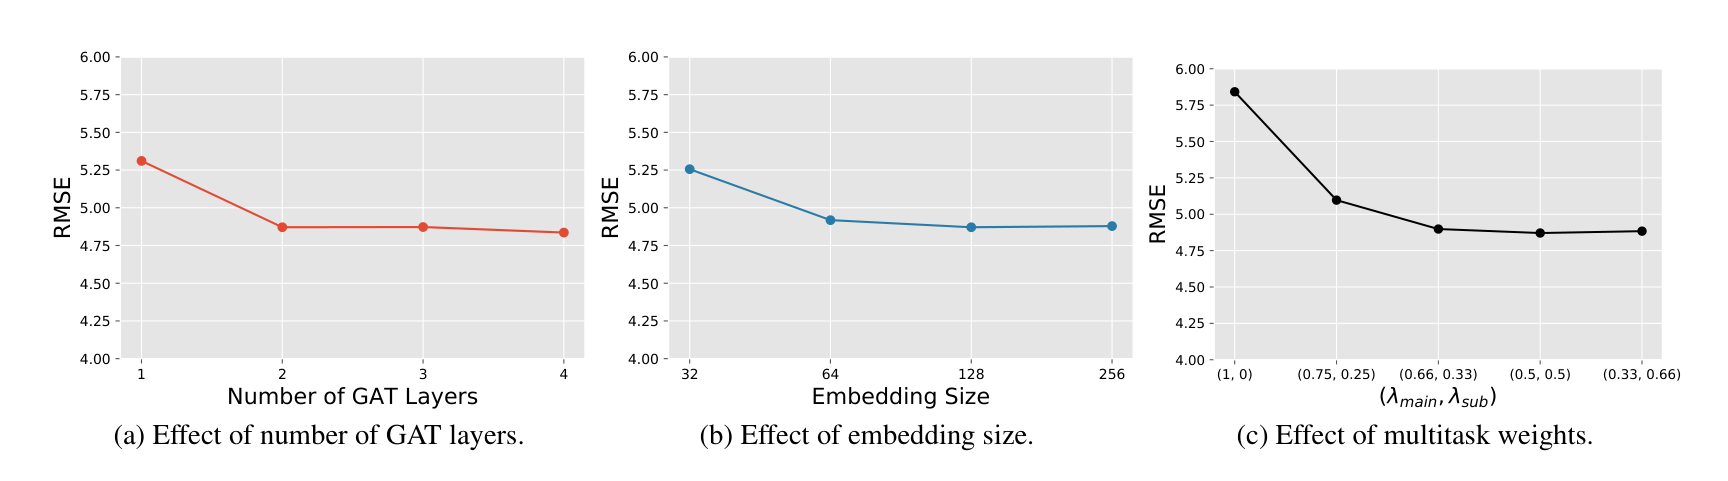
图 4|层数、向量长度和任务权重会把误差推到哪里?
纵轴都是 RMSE,刻度从 4 到 6,越低越好。正文没有给出各点的精确读数。(a)横轴为 GAT 层数 1 到 4。一层更高,两层及以后趋平。(b)横轴为嵌入维度 32、64、128、256。32 较高,128 与 256 接近。(c)横轴为 (主任务权重,子任务权重),从 (1,0)到 (0.33,0.66)。曲线下降到 (0.5,0.5)附近后变平。来源:原论文 Fig. 4。
哪些用地指标更敏感?
敏感度用输出对用地指标的平均梯度表示,绝对值越大,论文视为越突出。图 6 画出三类输出各自的前五名。三个横轴上限分别是 100、5 和 4,柱长只在同一子图内比较。论文没有在正文印出梯度的精确数字,图上可读的是顺序和刻度。
边级流量的前五名,由长到短依次是平均建成容积率、阁楼建筑数量、每平方米建筑数、办公面积容积率和剧院数量。流入的前五名是其他建筑数量、共管公寓数量、开放空间与户外游憩用地、每平方米建筑数、平均建成容积率。流出的前五名是开放空间与户外游憩用地、阁楼建筑、选定政府设施、居住容积率、其他建筑。
作者举的例子是:每平方米建筑数表示就业机会,对流入突出;居住容积率表示日常居住密度,对流出突出。这两个指标确实分别出现在流入和流出的前五名里,但都不是该子图最长的柱。梯度方向与“居住强度伴随流出、就业场所类指标伴随流入”大体同向。梯度是模型输出对输入的敏感程度,在同一批观测上计算。论文没有做用地改变的随机对照,修建剧院或提高容积率之后通勤人数会增加多少,图 6 没有回答。
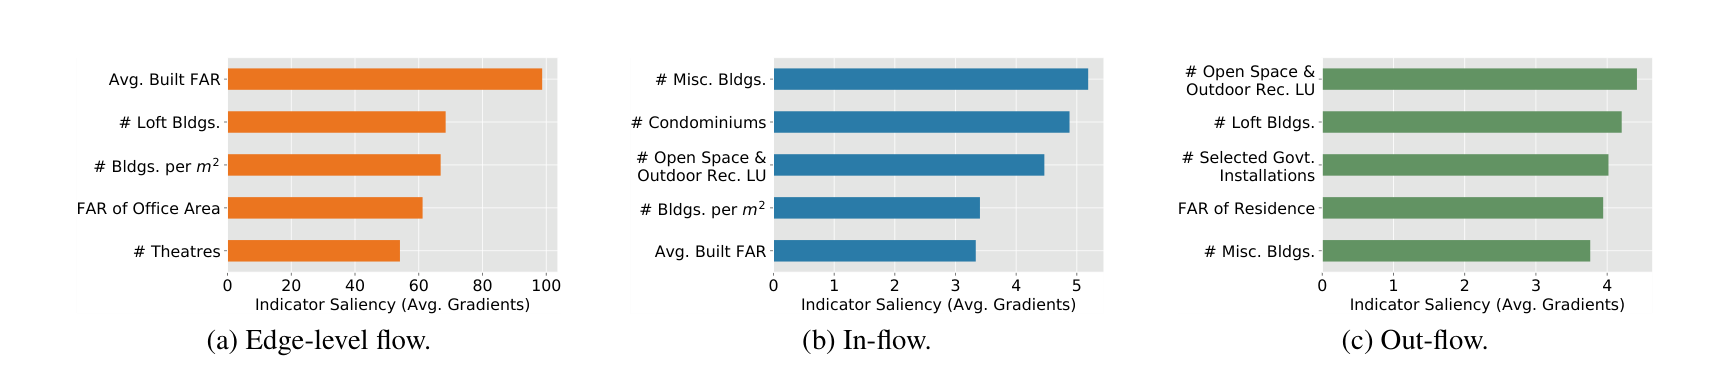
图 6|三类流量分别对哪些用地指标更敏感?
横轴是平均梯度,柱越长越敏感。三个子图刻度不同。(a)边级流量,横轴到 100,最长的是平均建成容积率。(b)流入,横轴到 5,最长的是其他建筑数量;每平方米建筑数在前五之中。(c)流出,横轴到 4,最长的是开放空间与户外游憩用地;居住容积率在前五之中。来源:原论文 Fig. 6。
用地变了,就能回答规划里的假如吗?
案例挑出 2013 年到 2015 年城市指标变化最大的 5 个普查区。模型用 2013 年的 PLUTO 和 LODES 训练,再在 2015 年的数据上计算这 5 个区的预测流量和真实流量之差。论文给出的平均绝对误差及标准差为 1.07±1.25、1.40±2.12、1.26±2.08、0.99±1.73、0.86±1.37。五个标准差都大于对应的平均绝对误差。正文没有说明标准差是对绝对误差还是对带符号误差计算,没有给出变化量的定义和区号,也没有给出每个区平均了多少条起讫点对。
作者写道,有了某一年训练好的模型,就可以在用地指标变化后预测新通勤流的起点和终点,从而帮助规划决策。案例里报告的量是流量数值的绝对误差:这 5 个区上,GMEL 的平均绝对误差约为 0.86 到 1.40 人,这里的人是被平均的那些流量上的人数偏差,五个标准差都大于各自的平均值。案例没有放入 GBRT 或引力模型。换年份之后是否仍然比 GBRT 低 10.4%,以及一座新产业园的通勤来自哪些区,都不在这五个数的覆盖范围内。
这些结果还能够支持的范围
能够支持的判断是:在纽约市 2010 年普查区边界和 2015 年已观测起讫点对的一次 6:2:2 随机划分上,用两跳地理语境和多任务预训练得到的嵌入,再经梯度提升树预测,测试对上的 RMSE、MAE 和 CPC 都优于表中的引力模型、随机森林、GBRT 和 Node2vec。随机划分抽走的是配对,同一个普查区仍可以出现在训练对和测试对里。这个结果说明模型能够补合同一年里没见过的配对。
汇入残差地图支持“GMEL 的合计残差看起来更平滑”。显著度图支持“不同输出对应的用地指标排序不同”。2013 到 2015 的五个区支持“在指标变化较大的少量区域上,GMEL 的平均绝对误差大约为 1 人,且波动更大”。全市换一年、换一座城市、纳入全部零流量对、以及一个指定新区的规划方案,都不在这些比较的分母里。表 2 也只有一轮点估计,没有重复种子和置信区间。
一句话总结
把大约 1.5 公里内的邻近用地写进起点和终点的向量之后,纽约市普查区之间的通勤人数在同一次测试划分上预测得更准;这个“更准”是汇总人数的误差下降,范围停在已观测的起讫点对和这一套城市指标之内。
核心来源
- 解读所据版本即首页标题为 Learning Geo-Contextual Embeddings for Commuting Flow Prediction 的文本。版权声明为 Association for the Advancement of Artificial Intelligence,2020;首页印有 arXiv:2005.01690v1,2020年5月4日。首页与参考文献未印刷 DOI。正文图 1 至图 6,表 1 与表 2。
- 通勤数据:美国普查局 2015 年 LODES,参考文献给出 https://lehd.ces.census.gov/data/。
- 用地数据:纽约市城市规划局 2015 年 PLUTO,参考文献给出 https://www1.nyc.gov/site/planning/data-maps/open-data/dwn-pluto-mappluto.page。
- 路程:Open Source Routing Machine,见 Luxen 与 Vetter 2011。
作者介绍
论文没有标注通讯作者,也没有逐人贡献说明。以下只采用首页署名机构。
- Zhicheng Liu:东南大学信息科学与工程学院,同时署名为纽约大学坦登工程学院。
- Fabio Miranda:纽约大学坦登工程学院。
- Weiting Xiong:东南大学建筑学院,同时署名为麻省理工学院媒体实验室。
- Junyan Yang:东南大学建筑学院。
- Qiao Wang:东南大学信息科学与工程学院。
- Claudio T. Silva:纽约大学坦登工程学院。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
最终用来交卷的是一棵按起讫点对分别预测的梯度提升树。预训练虽然要求起点向量能预测总流出、终点向量能预测总流入,发布出来的比较却没有检查:把一个区所有预测流入加总,是否还接近这个区的总流入。规划问题常常问的是“这个就业中心一共会来多少人”。如果成对预测的合计和节点流入互相偏离,0.741 的 CPC 可能高估了这张表在分区总量上的可用性。把测试对按终点加总后再算一次误差,会直接暴露这个缺口。
另一个可检验的问题出在两跳、平均 1.5 公里的语境上。改一个普查区的用地,模型里的消息会影响到两跳之内的向量,预测变化不该只发生在该区自己的连线上。案例报告了 5 个变化最大的区的绝对误差,没有给出周围 1.5 公里内预测流量移动了多少,也没有在同一套 2015 年指标下比较一棵只看两端的树。再加上全体观测对平均只有 3.35 人,而测试 RMSE 为 4.887 人,大流量对很可能主导了平方误差。若把测试对按流量大小或路程远近拆开,人数较少的那些对上的误差排名,可能会和表 2 的总排名不同。