全市一个系数,为什么说不清北京的出行距离?
论文名片|Ying Long、Zhenjiang Shen,Spatially Heterogeneous Impact of Urban Form on Human Mobility: Evidence from Analysis of TAZ and Individual Scales in Beijing,收入 Geospatial Analysis to Support Urban Planning in Beijing,GeoJournal Library 116,Springer,2015,第133–153页,书中第7章。DOI:10.1007/978-3-319-19342-7_7。这是一项用出行调查和地理回归描述关联的观察研究。
五环以内,正文把收入与平均出行距离读成负向;东南的通州一带、西北的昌平,以及最北的农村地区,又被读成同向。这是作者对局部系数地图的文字解读,调查里没有对应的两户出行日记。收入系数图的图例数字与系数表的最小、最大对不上,方向目前以正文和 t 值图为准。全市回归仍把户均收入收成一个正系数。密度、用地和收入若各只留一个全市数字,各区的差别会被叠在一起。
这项研究要回答的是:城市形态与出行距离的关联,在北京各交通分析区是否保持同一方向。混合地理加权回归给出的结果是,地块、密度、路网和用地混合可以用全市一个系数,户均收入、户均小汽车和平均年龄则随地点改号。全市回归里“收入更高、出行更远”只是这些局部方向叠完之后的平均。
先说结论
- 2005 年调查覆盖北京 18 个区的 1118 个交通分析区,样本为 81,760 户、174,957 人,数据节写的抽样比是 1.36%。全方式平均出行距离的逐步回归 R² 为 0.111;出行次数、出行时间的普通回归 R² 分别为 0.06 和 0.03。
- 1118 个交通分析区的平均出行距离有轻度空间聚集。图上的莫兰指数是 0.141039;空间滞后模型的 R² 为 0.146,同一批交通分析区上进入法普通回归的 R² 为 0.116。
- 混合模型把截距、户均收入、户均小汽车和平均年龄设为局部系数,其余形态指标设为全市系数。R² 为 0.509,调整后 R² 为 0.441。收入局部系数在表中从 -4468.907 到 511.494,图 7.3 的系数图例却是另一组正数。
- 户均小汽车在全方式模型里系数为正,在小汽车、公交、自行车和摩托的分方式模型里为负,步行再次为正。分母都是进入该列的交通分析区,不是出行者人数。
- 个人普通回归的 R² 为 0.146。表中学生身份和路网密度的系数为负,正文同一段写成正相关。个人模型与交通分析区混合模型的设定不同,两组 R² 不能当成尺度之间的公平比较。
先看 1118 个交通分析区的平均距离落在哪一档
人类移动性(human mobility)在本章具体落在日常出行距离上。材料是 2005 年北京居民出行调查,记录的是出行而不是居住地迁移,也没有使用连续轨迹。调查覆盖全部 18 个区,基本地理单元是 1118 个交通分析区(traffic analysis zone,TAZ)。样本为 81,760 户、174,957 人,数据节写抽样比 1.36%。章末把覆盖写成大约 2%。下文的样本规模以户数和人数为准。调查记录出行的出发与到达、目的、方式和距离;本章回归使用的是汇总后的平均距离和表中列出的解释变量。公交在这次调查的方式构成里占 13.81%,分母是调查记录的方式,不是另一次客流普查。
交通分析区尺度的因变量,是每个区里每人的平均出行距离。图 7.1 把这个量标成 y_distance,单位是米。
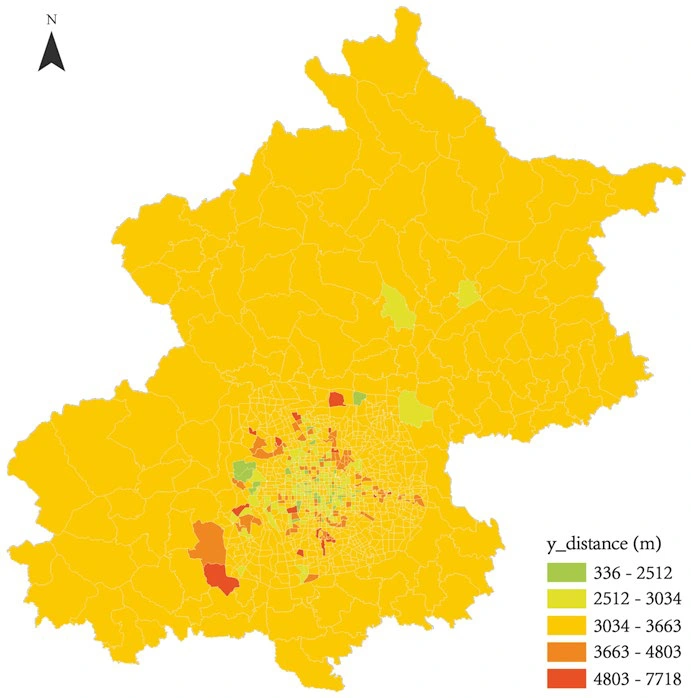
图 1|各交通分析区的平均出行距离落在哪一档?
全图只有一幅分区设色。颜色表示平均出行距离(米):绿色 336–2512,黄绿 2512–3034,黄色 3034–3663,橙色 3663–4803,红色 4803–7718。市域外围的大片交通分析区大多落在中间的黄色档,最短与最长的色块更多夹在中心城区和西南一处成片区域里。这张图给出的是区平均值的分档,看不出个人当天走了多少次,也看不出远距离来自通勤还是其他目的。来源:原论文 Fig. 7.1。
距离会和相邻的区一起偏高或偏低
若相邻交通分析区的平均距离彼此接近,普通回归所假设的独立误差就不成立。本章用 GeoDa 计算莫兰指数,并用局部空间关联指标看聚集出现在哪里。
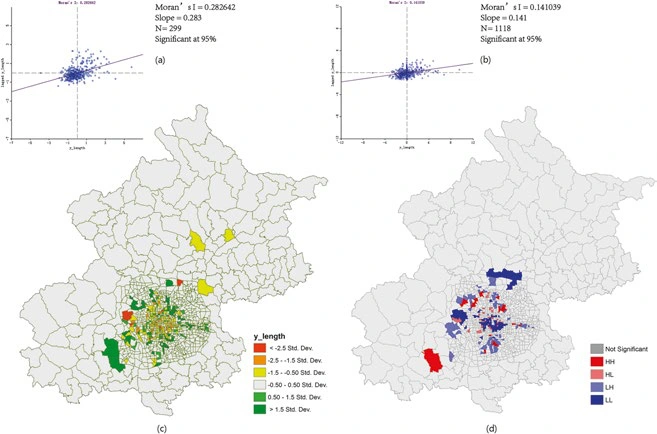
图 2|平均出行距离是随机散布,还是连片聚集?
(a)偏离全区均值 0.5 个标准差以外的 299 个交通分析区,莫兰指数 0.282642,斜率 0.283,标注为 95% 显著。这 299 个区经过偏离均值的筛选,全市指数要单独看(b)。(b)全部 1118 个交通分析区,莫兰指数 0.141039,斜率 0.141,同样标注 95% 显著。正文给出的全市数值是 0.14,999 次置换检验的 p 值为 0.001,并称为轻度聚集。(c)仍是这批偏离 0.5 个标准差以外的区,按 y_length 的标准差分色:红色低于 -2.5,橙色 -2.5 至 -1.5,黄色 -1.5 至 -0.50,白色 -0.50 至 0.50,浅绿 0.50 至 1.5,深绿高于 1.5。图中变量名写成 y_length,正文没有另给一套与 y_distance 不同的定义。(d)局部空间关联:灰色为不显著,红色高高,粉色高低,浅蓝低高,深蓝低低。正文说低低聚集出现在中心区和部分郊区,高高聚集出现在以居住为主、岗位较少的地方;图上没有印区名。来源:原论文 Fig. 7.2。
轻度聚集说明全市一个回归会漏掉成片的高低差异,但莫兰指数本身只描述平均距离的空间格局,还不说明是密度、收入还是遗漏变量造成了这种格局。
十五个指标里,四个“离中心有多远”只能留一个
解释变量参照潘海啸等人 2009 年对上海四个街区的做法,在北京扩展为五类、共 15 个指标:地块平均规模,到天安门、CBD、中关村、最近次中心和最近地铁站的距离,路网密度、公交站密度、公共设施密度,2005 年人口密度、2010 年岗位密度、户均收入、户均小汽车、平均年龄,以及用地混合度。岗位密度的年份比其余指标晚五年,回归把它们放在同一条等式里。
用地混合度是熵。九类用地在正文里只以字母 C、D、F、M、R、S、U、W、X 出现,字母对应哪种用地没有展开。公式是 S = −Σ pi log10(pi):pi 为第 i 类用地面积占该交通分析区的比例,类别越多、占比越匀,S 越高。1118 个区的混合度均值是 0.41,最大 0.85066。
调查缺少收入记录时,用 3400 填补。1118 个区的户均收入均值是 3510.02,范围 1000 到 25,000;户均小汽车均值 0.13,范围 0 到 1;平均年龄均值 42.86,范围 33 到 60 岁。人口密度均值 82.57,岗位密度均值 0.37。表中没有标注密度和距离的单位,这两个密度均值不能直接比大小。到天安门的距离均值印为 19,900、最大 115,481,单位同样没有写在表头。
个人表把交通分析区指标挂到人身上,描述统计的 N 是 174,957 人。此时人口密度均值升到 199.81。人更多住在较密的区,所以个人表的密度均值高于交通分析区的简单平均。两列均值的加权方式不同:一列对交通分析区等权,一列对人加权。
距离变量彼此太像,不能同时进入。正文把皮尔逊相关高于 0.8、方差膨胀因子大于 7 作为筛除规则,但没有印出具体的相关系数和膨胀因子。到天安门、到 CBD、到中关村、到最近地铁站四项被判定共线,两个尺度的模型都只保留到最近次中心的距离。
公式把出行距离和多项解释变量写成对数。后文交通分析区回归的截距却在 3000 上下,与图 7.1 的米制距离同一量级,不像对数距离。下面的交通分析区系数按表中印出的原尺度阅读,并与“米”对照;不再对系数取指数。
全市回归里,密度对应更短,小汽车却随方式改号
全方式逐步回归保留公共设施密度、人口密度、岗位密度、户均收入和户均小汽车。1118 个交通分析区上,R² 为 0.111,AIC 为 16,797;调整后 R² 那一格是空的。三个密度系数都是负的:公共设施密度 -567.579,人口密度 -0.543,岗位密度 -46.789。户均收入为 0.02,户均小汽车为 822.728。括号在这一列更像标准误,分别是 110.33、0.162、11.455、0.009 和 92.987。表注把所有括号都写成标准误,分方式各列括号里却是带星号的 t 值。
把全方式系数乘上表 7.2 的标准差,只为看数量级:公共设施密度约 -96 米(-567.579 × 0.169),人口密度约 -67 米(-0.543 × 123.588),岗位密度约 -58 米(-46.789 × 1.246),户均收入约 30 米(0.02 × 1521.604)。按每 1000 元计,收入系数对应约 20 米。户均小汽车从 0 到 1,对应约 823 米;该变量均值只有 0.13。这些乘积的前提是因变量就是图中的米。R² 为 0.111,意味着这组变量只说明了平均距离变异的一小部分。
分方式模型把出租车并入小汽车、地铁并入公交。调整后 R² 与户均小汽车系数如下,分母是交通分析区数。
| 方式 | 交通分析区数 | 调整后 R² | 户均小汽车系数 |
|---|---|---|---|
| 全方式 | 1118 | 未印出;未调整 R² 为 0.111 | 822.728 |
| 小汽车 | 1015 | 0.195 | -8082.251 |
| 公交 | 982 | 0.195 | -4505.999 |
| 自行车 | 848 | 0.077 | -4717.215 |
| 摩托 | 597 | 0.063 | -5577.429 |
| 步行 | 1045 | 0.028 | 265.816 |
全方式公布的是未调整 R²,分方式公布的是调整后 R²,0.195 与 0.111 分属两行指标。小汽车列的截距是 15570.931,高于全方式地图的最高档 7718 米;它是其他变量取 0 时的基线。图 7.1 里观察到的全区平均距离停在 7718 米以内。离最近次中心更远时,小汽车、公交、摩托三列的距离系数为正,步行系数为 -0.003。地块规模和平均年龄在逐步回归的各列都没有进入。
出行次数的普通回归 R² 为 0.06,出行时间为 0.03。正文没有给出这两次回归的样本量和系数。平均距离尚且只能解释一成左右的差异,次数和时间更接近没有被这组变量说明。
空间滞后把 R² 从 0.116 抬到 0.146
进入法把共线筛选后留下的变量一次放进模型,不再逐步剔除。边角都算相邻的 Queen 权重被采用,因为正文说它比 Rook 权重更显著;Rook 的统计量没有印出。1118 个交通分析区上,普通回归 R² 为 0.116,空间滞后模型和空间误差模型都是 0.146。对数似然分别是 -8389.05、-8374.74 和 -8375.88。空间滞后系数是 0.231,标准误 0.043;空间误差系数是 0.249,标准误 0.047。
滞后模型的稳健性统计量是 3.994,两个星;误差模型是 0.300,没有星。正文据此认为滞后模型更适合描述空间相关。表中的 AIC 是滞后模型 16840.7、误差模型 166775.8、普通回归 16,802。空间误差模型与空间滞后模型的对数似然只差 1.14(-8375.88 与 -8374.74),印出的 AIC 却大约高出十倍,这一格对不上同表的似然。正文写空间模型有更小的 AICc,表头印的是 AIC,滞后模型的 AIC 也高于普通回归。能够对齐的改进是 R² 和对数似然,幅度仍然有限。
进入法里保持显著的方向与逐步回归一致:公共设施密度、人口密度、岗位密度为负,户均收入和户均小汽车为正。平均年龄的系数是 -11.416,标准误 6.753,只有一个星,对应表注的 90% 水平。地块规模、到次中心距离、路网密度、公交站密度和用地混合在这 1118 个区的进入法里没有达到表注的显著标记。
真正换符号的是收入、小汽车和年龄
地理加权回归(geographically weighted regression,GWR)让每个交通分析区有自己的系数,近处样本权重大,远处权重小。混合地理加权回归(mixed geographically weighted regression,MGWR)再进一步:经检验没有地理变异的变量,改回全市一个系数。检验比较“全部系数都局部”和“只把某一个系数固定为全市”两种拟合,用 AICc 的差值判断。正文把临界值定为 2;差值为正,就把该变量视为全市系数。
截距的差值是 -162.39,户均收入 -246.61,户均小汽车 -200.61,平均年龄 -56.73,四项定为局部。地块规模、到次中心距离、路网密度、公交站密度、公共设施密度、人口密度、岗位密度和用地混合的差值都为正,定为全市系数。带宽按高斯核、以 AICc 最小来选,得到 104。正文没有说明 104 是邻近区个数还是距离。
全市系数在结果表里标明为标准化估计:地块规模 3.164,到次中心距离 -18.049,路网密度 -6.049,公交站密度 7.832,公共设施密度 -26.263,人口密度 -8.438,岗位密度 -41.840,用地混合 7.121。局部系数给的是未标准化估计的均值和极值,两列不能按同一个单位比较。收入的局部估计均值 2.224,最小 -4468.907,最大 511.494;小汽车均值 184.962,最小 -1113.669,最大 1861.479;年龄均值 -10.293,最小 -2223.535,最大 2932.294。截距均值 3348.313,最小 2478.510,最大 4512.987。
这套混合模型的 R² 为 0.509,调整后 R² 为 0.441,AIC 为 16331.2,AICc 为 16353.3。局部系数用掉更多自由度,R² 高于 0.116 或 0.146 在这个设定下可以出现;调整后 R² 仍为 0.441,说明放开收入、小汽车和年龄之后,样本内可说明的部分变多。更高的拟合描述的是这批交通分析区,还没有单独证明密度或收入怎样改变一个人的出行。
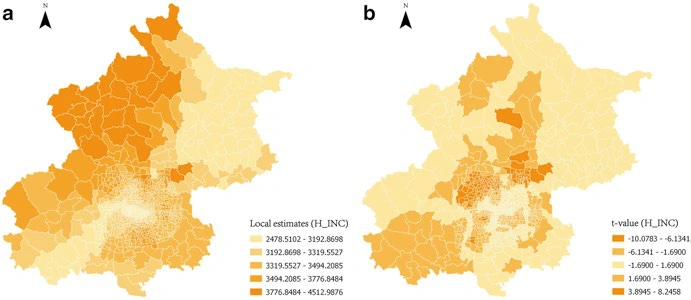
图 3|户均收入与平均出行距离的局部系数,在各区是正还是负?
(a)标题为收入的局部估计。图例五档全是正数:2478.5102–3192.8698、3192.8698–3319.5527、3319.5527–3494.2085、3494.2085–3776.8484、3776.8484–4512.9876。这组端点与表中截距的最小 2478.510、最大 4512.987 对齐,与收入系数的 -4468.907 到 511.494 对不上。颜色因此不能读成“收入每增加 1,距离增加多少米”。(b)收入系数的 t 值,中间档为 -1.6900 到 1.6900,两端分别到 -10.0783 和 8.2458。负的 t 值说明局部检验里存在负向关联,但 t 值图不提供系数的米制大小。正文的文字解读是:五环内多为负向,约一半交通分析区为负,负向峰值在顺义首都机场附近;正向三处为通州一带、昌平和最北农村。图例数字核对不上系数表,这句话只能当作作者对地图的叙述,不能从色标复原。来源:原论文 Fig. 7.3。
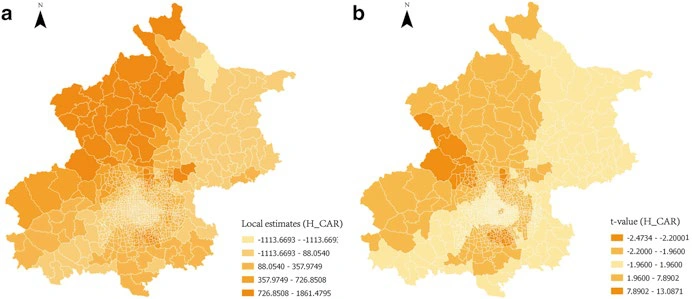
图 4|户均小汽车的局部系数在哪里为正、哪里接近零?
(a)局部估计从 -1113.6693 收到 1861.4795,最低一档的上下界都印在 -1113.669 附近,与表中的最小、最大一致。中心城、西南和东北在正文中被描述为负而很小且不显著;西北和南面的正系数更高。(b)t 值中间档为 -1.9600 到 1.9600,负端到 -2.4734,正端到 13.0871。正文点出的显著区域是东南的马驹桥和西北的延庆附近,原文把延庆写作 Yanqin。显著的正向表示这些区里更高的户均小汽车与更长的平均距离同向出现,并不等于添一辆车就会把通勤目的地推远。来源:原论文 Fig. 7.4。
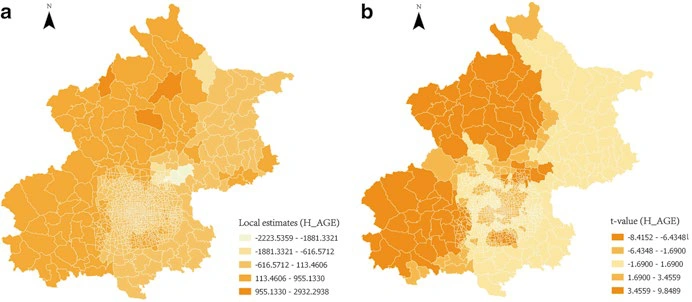
图 5|平均年龄更高的区,平均出行距离是更短还是更长?
(a)局部估计从 -2223.5359 到 2932.2938,与表中最小 -2223.535、最大 2932.294 一致。中心城和东面大片在正文中被读为负向。(b)t 值中间档为 -1.6900 到 1.6900,负端到 -8.4152,正端到 9.8489。这里的年龄是交通分析区的平均年龄,系数描述的是“区平均年龄”和“区平均距离”的局部关联。正文用年轻人更能远距离通勤、内城老年人更多来解释。个人回归里的年龄系数是 -0.481,表上没有显著性星号,所以这张图不能改写成“同区内年轻人比老年人走得更远”。来源:原论文 Fig. 7.5。
三张 t 值图的分界也不相同:小汽车以 ±1.96 分档,收入和年龄以 ±1.69 分档。正文统一写局部系数按 0.05 判断显著。三张图的显著区域并不重合。章末把西部概括为家庭社会经济特征与出行距离的正向显著区、东部概括为多不显著;这是三张图放在一起之后的总述,每张图的显著色块边界各自不同。
另一处表间不一致是公交站密度的全市系数:混合模型结果表印成 7.832,个人与交通分析区对照表印成 -7.832。其余列出的全市系数符号一致。对照表还给公共设施密度、人口密度和岗位密度加了三个星,结果表本身没有这些星号。
个人回归和交通分析区回归各在估计什么?
个人模型的因变量,正文写成一个人一天平均出行距离的自然对数。描述统计里名为 ydis 的变量,174,957 人的均值是 7.5358,范围 1.95 到 12.47,和米的对数同量级。回归表的截距却是 1552.59,与 7.54 不在一个尺度上,更接近以米计的距离。因此表中的 428.686 不能读成“对数距离增加 428”。性别是 0/1 变量,均值 0.50,表中没有说明 1 对应哪一性别。
按表中的符号,个人普通回归里与更长距离同向、且带显著标记的有:性别 428.686、家到工作地距离 283.184、地块规模 28.725、到最近次中心距离 0.008、收入 0.027、小汽车 558.672、用地混合 269.188,均为三个星或两个星。学生身份是 -527.620,路网密度是 -0.731,岗位密度是 -41.640。年龄 -0.481、公交站密度 -26.778、公共设施密度 -17.658、人口密度 0.024 没有星号。R² 和调整后 R² 都是 0.146。回归所用人数没有单独列出,描述统计的分母才是 174,957 人。
正文把学生身份和路网密度也写成与通勤距离正相关。这两项的表中系数是负的,阅读时以表为准。家到工作地距离的系数为正,正文那句正向名单没有点它,但表里它有三个星。
对照表右侧是交通分析区混合模型,R² 0.509、调整后 0.441。个人模型是全体样本共用一套系数的普通回归,交通分析区模型允许三项社会经济变量换符号。尺度不同,模型也不同。可以肯定的是:挂到个人身上之后,个人属性、家到工作地距离和居住地所在区的可达性进入了显著项;汇总到交通分析区之后,地理变异性检验把密度类指标留在全市系数里,把收入、小汽车和年龄留在局部系数里。不能把这个差别写成同一个人在两个尺度上改变了行为。
这些相关停在区平均和个人横截面上
其他变量只是一同进入回归。城市形态没有被随机分配,居住选择会让收入、小汽车和密度在估计之前就已经叠在一起。2010 年的岗位密度对上 2005 年的出行和人口,时间也没有对齐。
全市一个正的收入系数,和局部系数里同时存在的正负方向,回答的是不同问题。前者是 1118 个区叠在一起的平均关联,后者是允许系数随地点变化后的拟合。图 7.3 的色标还没有和收入系数的最小、最大对齐,区位叙述目前主要靠正文,不靠那张图的图例。
分方式样本小于 1118,是因为部分交通分析区没有该方式的记录。小汽车拥有量的符号随方式改变,说明“有车的区出行更远”只出现在全方式和步行两列。个人年龄没有显著标记,交通分析区的平均年龄却有很大的局部摆幅,区平均不能代替区内的年龄差异。
作者由此写到:应按社会经济状况安排规划,以缩短过长通勤,并减轻拥堵和污染。调查关联可以提示全市系数会掩盖区位差异;它还没有测量某项形态改变之后距离、能耗或污染的变化。
一句话总结
在 2005 年北京这 1118 个交通分析区里,密度等形态指标可以放进全市一个系数,收入、小汽车和年龄的关联却随区位改号;全市回归的正号,概括不了这些地方差异。
核心来源
- Ying Long、Zhenjiang Shen,Spatially Heterogeneous Impact of Urban Form on Human Mobility: Evidence from Analysis of TAZ and Individual Scales in Beijing,Geospatial Analysis to Support Urban Planning in Beijing,GeoJournal Library 116,Springer,2015,第133–153页。DOI:10.1007/978-3-319-19342-7_7。本章图表为 Fig. 7.1–7.5、Table 7.1–7.8。
作者介绍
本章页脚的书目行为 Y. Long、Z. Shen。同书作者介绍与出版社目录把这一章记在龙瀛、沈振江名下。
- 龙瀛(Ying Long):同书作者介绍写他当时在北京市城市规划设计研究院任职,并在首都空间规划研究北京市重点实验室做研究,博士毕业于清华大学建筑学院;工作集中在城市规划、定量城市研究和应用城市模型。
- 沈振江(Zhenjiang Shen):同书将他列为这本书的通讯作者,身份是金泽大学教授;研究集中在用地理信息系统和虚拟现实支持规划设计决策。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
密度被设成全市一个系数,收入和汽车却在五环内、通州、昌平被写成不同方向。若一项规划只提高某个区的居住密度,本章的全局密度系数只能提供一个全市平均的距离关联,提供不了这个区的局部预期。要检验紧凑布局,需要在系数已经改号的区位上单独看密度变化,并把“什么样的人选择住进来”从形态指标里分开。本章的回归没有做这个分离。
另一个可核对的裂缝在方式之间。全方式模型里,户均小汽车从 0 到 1 对应大约 823 米的更长平均距离;小汽车方式自身的逐步回归里,系数是 -8082.251,分母是 1015 个交通分析区。一种与这两列同时相容的可能是:有车的区把更多出行转到汽车上,从而拉高全部方式的平均距离,而汽车出行自己的平均距离可以更短。这要靠分方式的出行次数来核对。本章给出的次数回归 R² 只有 0.06,现有的表还回答不了。