不先写下重力公式,让出行数据自己选,最后会选出什么?
论文名片|Hao Guo、Weiyu Zhang、Junjie Yang、Yuanqiao Hou、Lei Dong、Yu Liu,Distilling Human Mobility Models With Symbolic Regression,Geographical Analysis,2026,58(3):e70043,2026年5月4日首次在线发表。DOI:10.1111/gean.70043。本文依据作者2026年2月23日修订预印本v2及其补充材料解读;该论文2025年v1题为 Data driven discovery of human mobility models。
两个地方之间有多少人流,通常要先挑一个公式:人口相乘,再除以距离的某个幂,或者让距离带来指数衰减。如果公式类型一开始选错,后面把参数调得再细,也可能只是在错误框架里寻找最好答案。
这项研究把问题倒过来:给计算机人口、距离、中间机会和几种基本运算,让它同时搜索公式结构与参数。结果不是彻底推翻重力模型。相反,指数距离衰减的重力形式在七组数据中的六组被重新找出;真正的新信息在于,何时需要更复杂的衰减,何时全国平均公式掩盖了区域差异。
先说结论
- 在限定运算符和表达式长度下,符号回归能自动找出简洁的出行流量公式;它探索的是一个人为规定的候选空间,并非证明找到了所有可能公式中的唯一真理。
- 复杂度为5时,七组数据中六组得到指数衰减重力形式;广东县级通勤是例外,其他机会型表达式略好。
- 英格兰和美国通勤的较复杂公式采用 exp(−d的α次方) 衰减,RMSE比简单指数重力模型分别低约4.6%和9.3%,但美国的CPC没有同步提高。
- 美国大区内部占97.5%的通勤流量,更符合指数衰减;跨大区流量的最优形式不同,不能用占主导的短程联系解释全部长程联系。
这里的出行,不是手机上逐秒移动的个人轨迹
研究对象是空间单元之间的起讫流量(origin–destination flows,OD流量):从i流向j的人数或访问流量。主要输入来自四套原始资料,按通勤与一般移动、不同空间尺度拆成七组分析。
广东数据来自中国移动2020年11月约500万用户、500米网格的移动记录,清理错误及重复点后,把停留至少30分钟的位置作为停留点。一般移动是停留点之间的移动;家按凌晨0—7时停留最久的位置识别,工作地按9—18时识别,上午12时以前的家到工作地移动构成通勤。
京津冀数据来自中国联通2019年11月4—10日的县际移动,采用至少30分钟的停留点;人口为年鉴户籍人口。英格兰使用2011年人口普查的通常居住地—工作地联系;美国本土连续州使用2011—2015年ACS五年估计。后三者与广东数据的时间、观测渠道、人口口径并不相同。
| 分析数据 | 空间单元数 | 保留的OD对数 |
|---|---|---|
| 广东街道/乡镇一般移动 | 2,100 | 705,811 |
| 广东街道/乡镇通勤 | 2,100 | 28,392 |
| 广东县级一般移动 | 124 | 14,251 |
| 广东县级通勤 | 124 | 1,150 |
| 英格兰合并地方政府区通勤 | 324 | 57,591 |
| 美国县级通勤 | 3,108 | 131,391 |
| 京津冀县级一般移动 | 200 | 38,813 |
这些数量来自表1,分母是OD对,不是受访者人数。所有分析都去掉起点与终点相同的单元内部流动。因此结果只解释保留下来的跨单元流量,无法直接推出一个人的日常总出行。
让计算机找公式,为什么还要先规定规则?
符号回归(symbolic regression,SR)不仅拟合系数,还搜索公式长什么样。这里允许加、减、乘、除、幂、指数、对数七种运算;变量包括起终点居住人口r、就业人口w、地理距离d,以及中间机会s。中间机会用比目标更近的竞争地区人口近似,分别按居住与就业人口计算;有更细人口数据时,机会量以更细尺度汇总。
算法并非直接生成流量Fᵢⱼ,而是先生成分配权重fᵢⱼ,再计算:
预测流量F̂ᵢⱼ=起点总流出Oᵢ × fᵢⱼ ÷ 该起点所有其他目的地权重之和。
这个设定把总流出固定,只学习如何在目的地之间分配。它缩短待搜索公式,也意味着模型已使用观察到的Oᵢ,不能把任务理解成完全不知起点总流出时的从零预测。
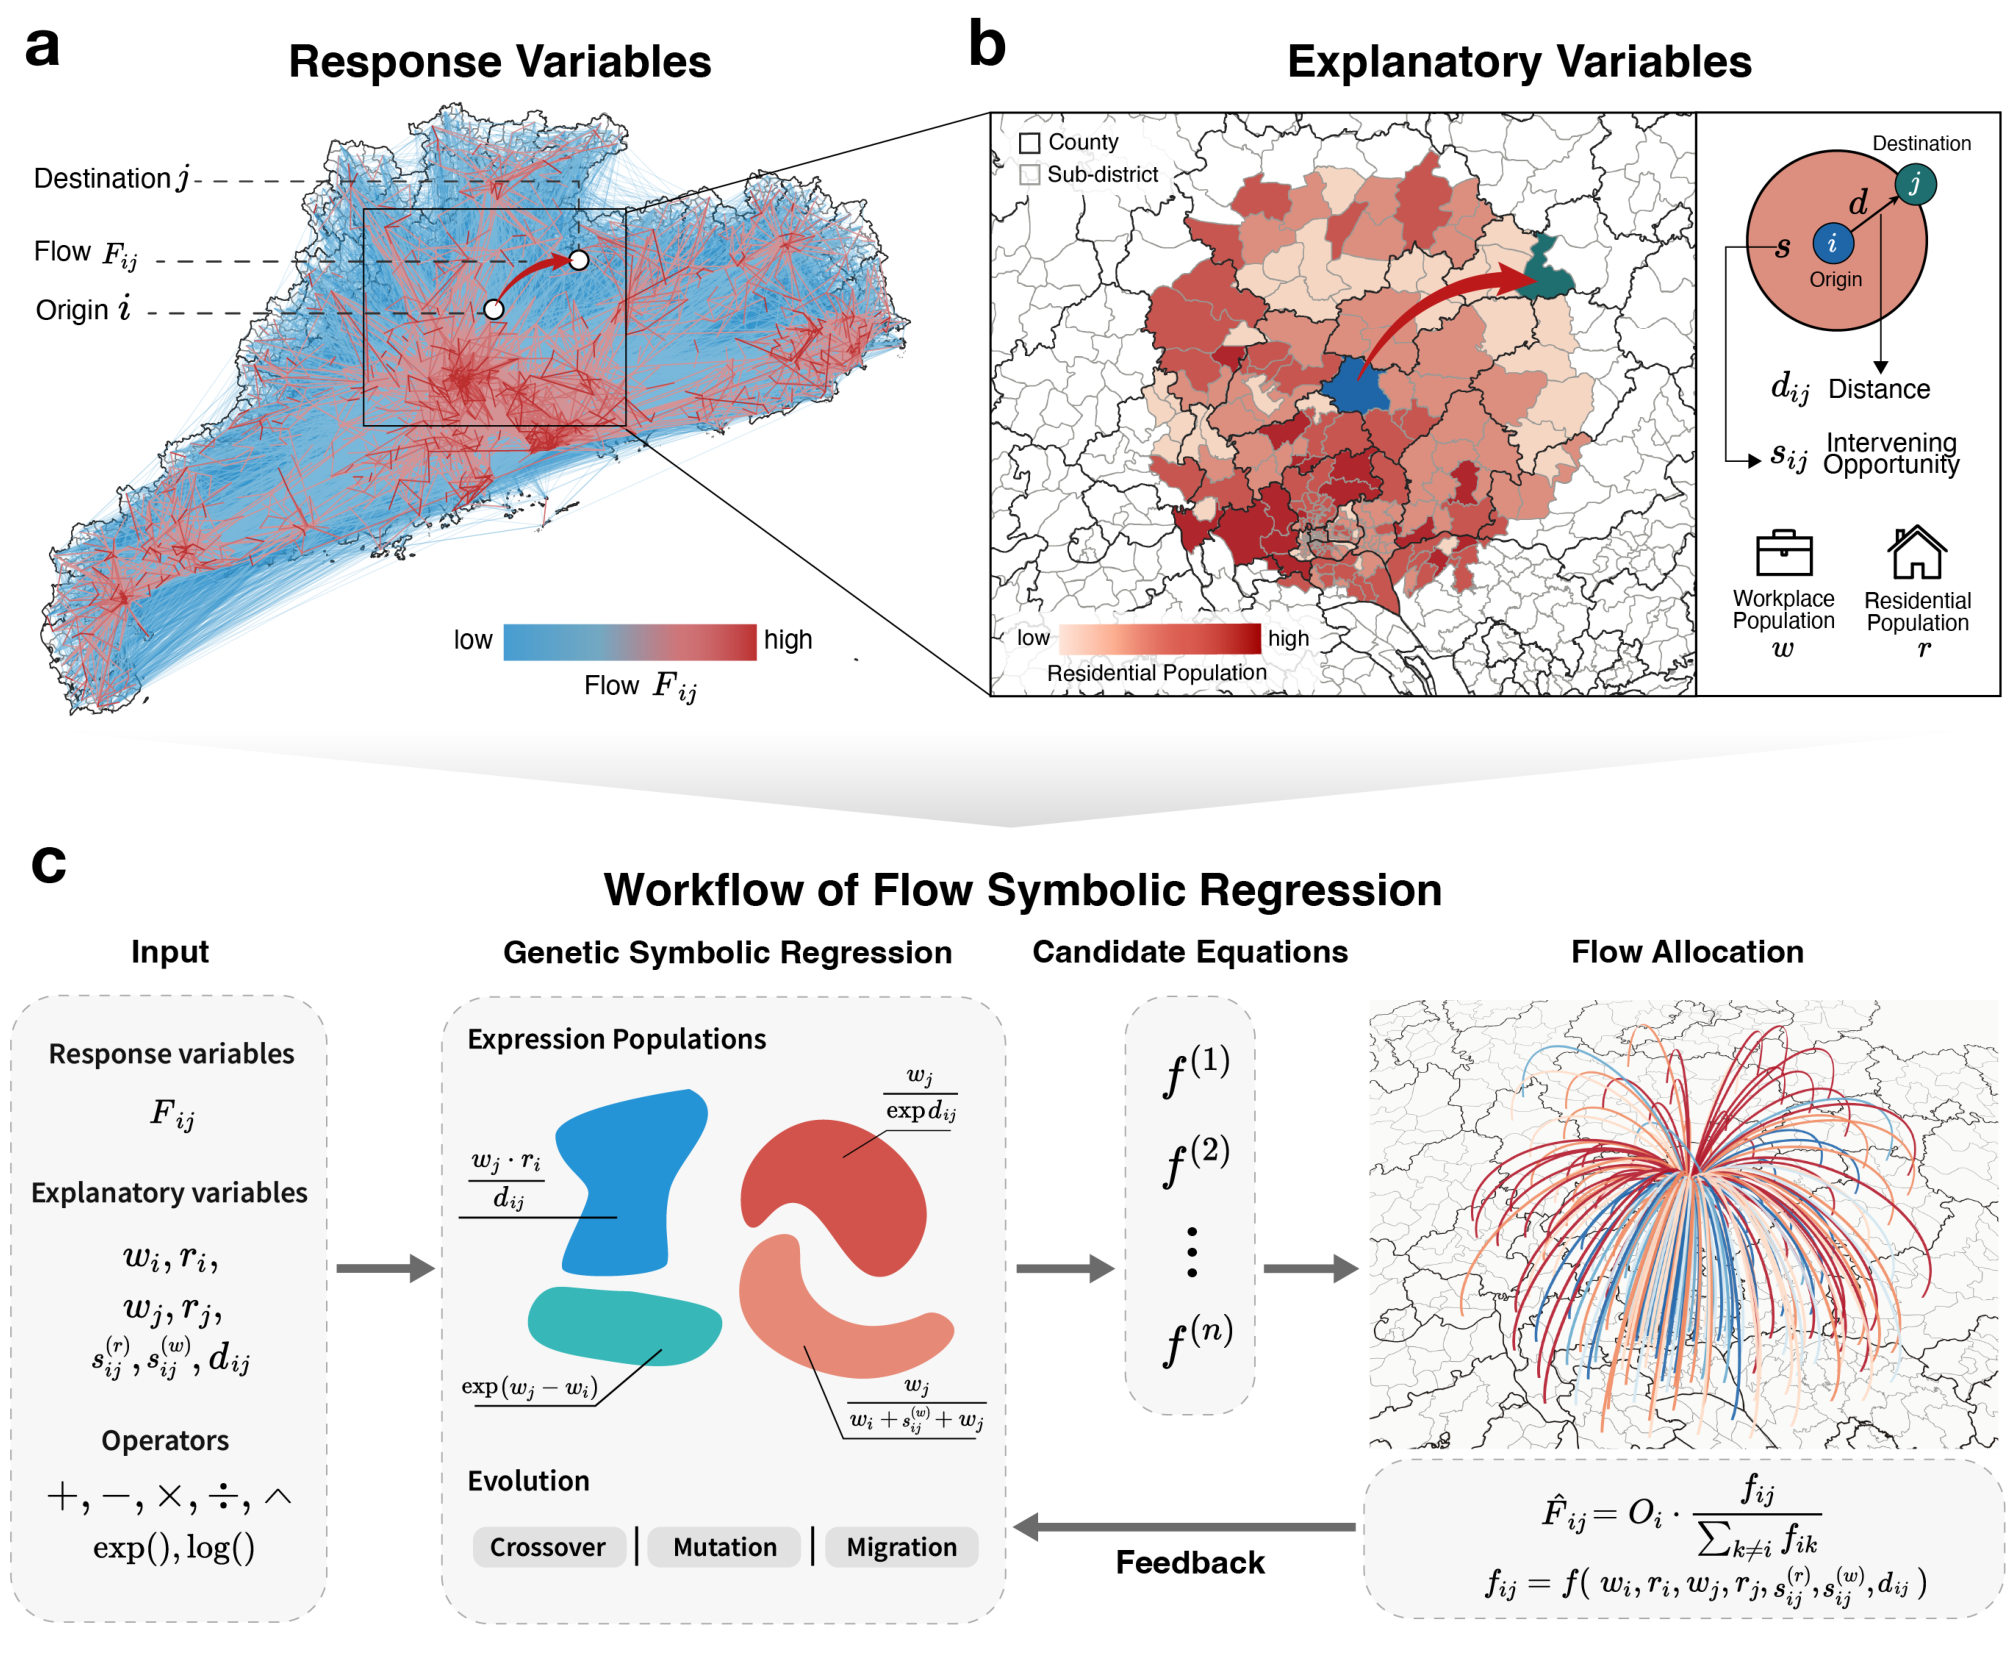
图 1|从人流表到可读公式,搜索经过哪些约束?
(a)广东OD流量为待解释对象,蓝至红表示流量由低到高。(b)人口、距离与中间机会构成候选解释变量,地图示意不同聚合尺度。(c)遗传编程通过交叉、变异、迁移形成候选分配权重,再把固定总流出分配给各目的地,以流量均方误差反馈优化。来源:作者修订稿 Fig. 1。
只要允许公式无限增长,误差下降并不困难,却会丧失解释性。因此研究同时考察误差与复杂度,保留帕累托前沿(Pareto frontier):若不能在不牺牲其中一项的前提下改善另一项,就保留这个折中模型。
复杂度按表达式树的节点计数,变量、常数和二元运算各算1,exp和ln算2,重复符号重复计数。例如分配权重mⱼ÷dᵝ包含5个节点;辐射模型的权重含11个节点。本文说的“复杂度5”,不是5个变量、5个参数或5层神经网络。
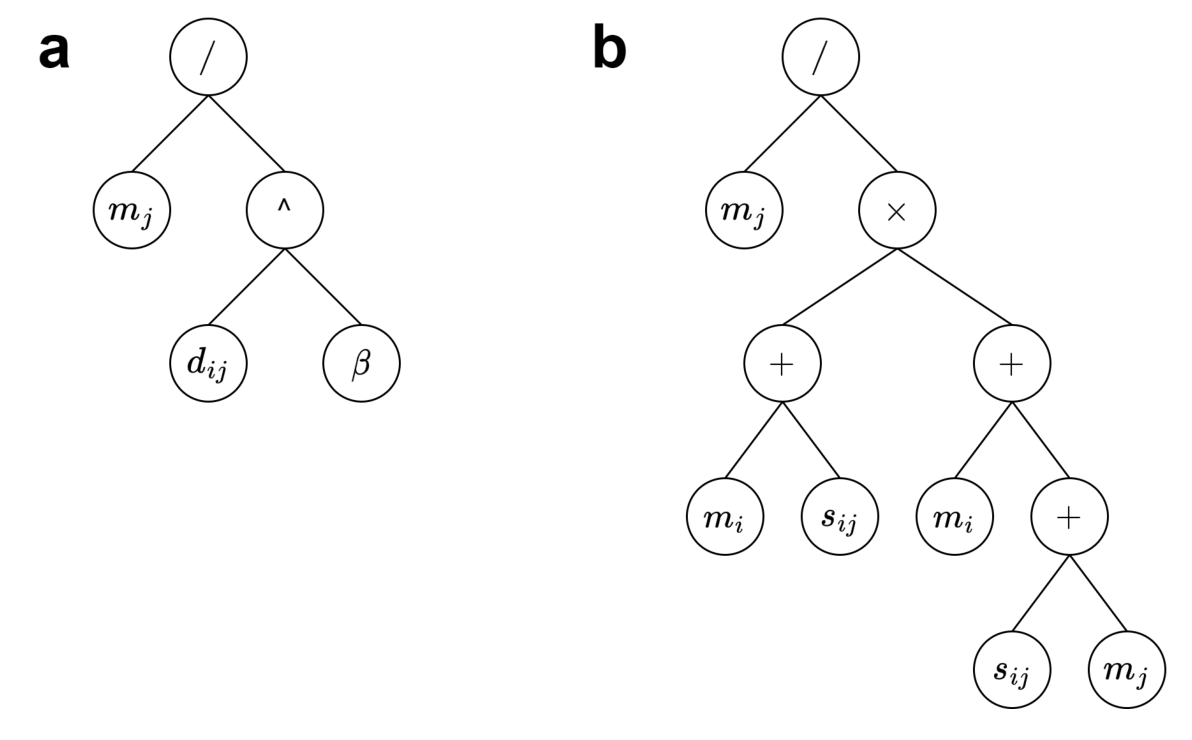
图 2|怎样让不同公式在同一复杂度口径下比较?
(a)幂律重力权重的表达式树有5个节点。(b)辐射模型的树有11个节点;分母包括两个因子的乘积,树形清楚显示括号结构。来源:作者修订稿 Fig. 2。
具体实现修改SymbolicRegression.jl的评估模块,用权重归一化后的人流计算误差。每次100次迭代,真实数据通常先用全变量跑5次,再限制为较重要变量再跑5次;部分大数据使用批量计算,并追加常数优化。不同运行结果合并后挑选前沿。搜索空间随复杂度增长,这个启发式算法仍可能错过更好的公式。
数据为什么重新选中了指数重力模型?
在复杂度3时,模型多先使用距离衰减;复杂度5时,通常加入目的地人口。例如通勤权重近似为wⱼ×exp(−βd),一般移动则常用rⱼ替代wⱼ。这说明在当前候选变量与误差标准下,距离和目的地吸引力已经解释了相当多结构;并不等于其他社会因素没有作用。
七组数据中六组重新找到指数衰减重力形式。广东县级通勤是例外:复杂度5的机会型权重RMSE为110.18,指数重力模型为111.91,后者约高1.6%。这也解释了为什么不能把“六组一致”改写成“机会模型在任何尺度都没有价值”。
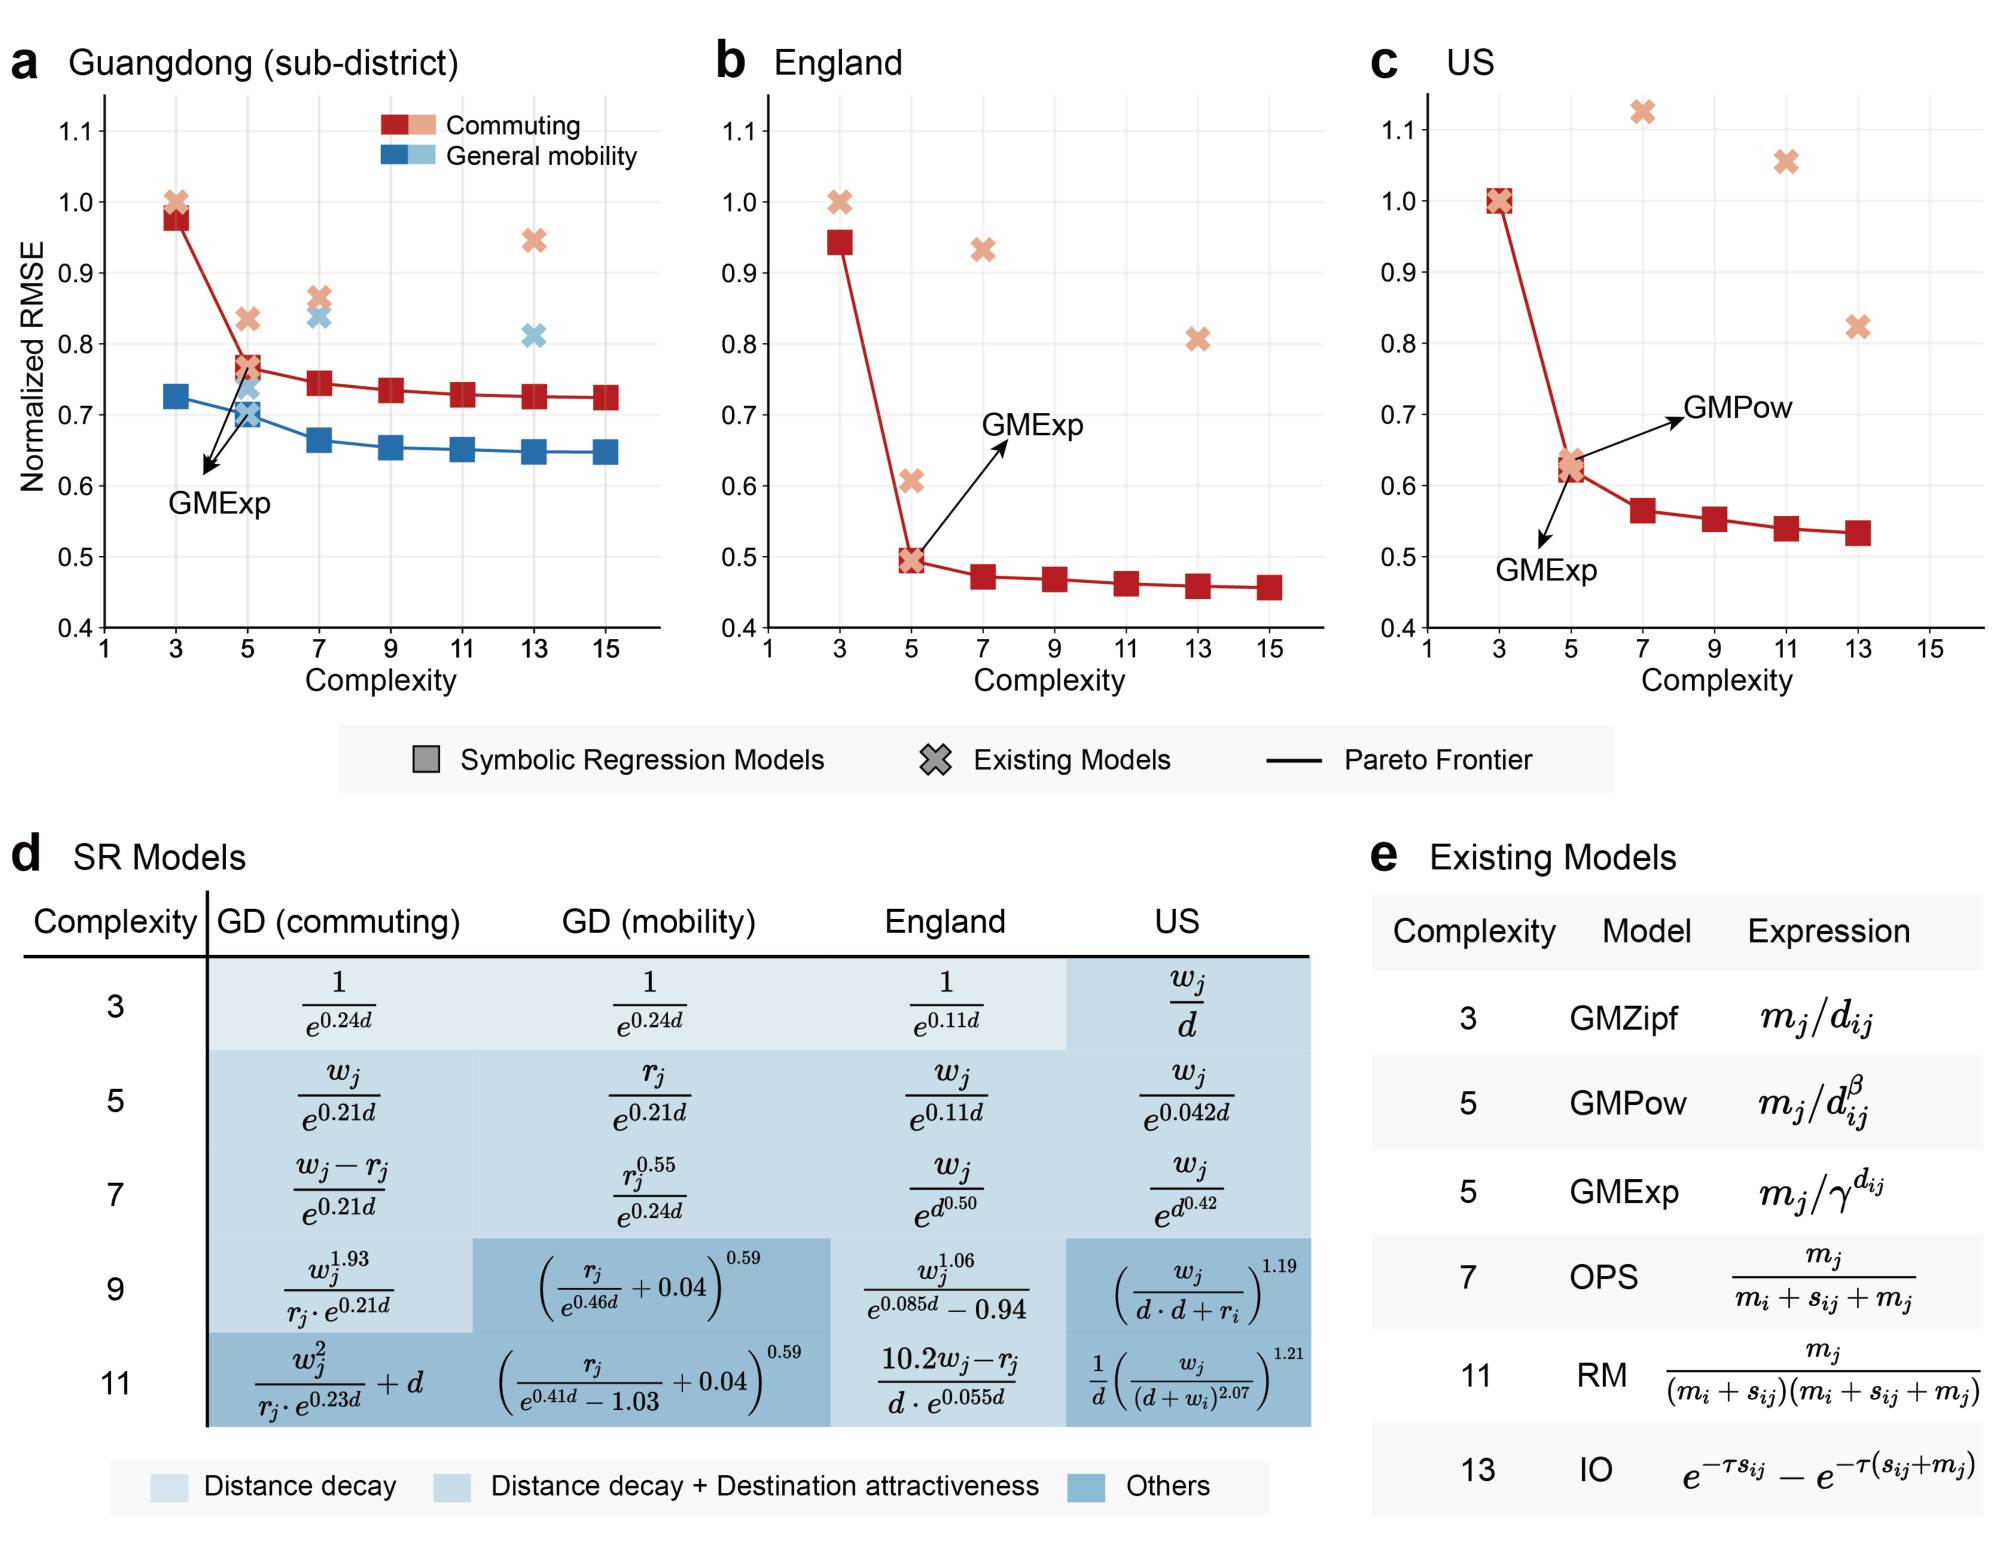
图 3|更复杂的公式带来了多少误差下降?
(a)广东街道/乡镇通勤与一般移动,(b)英格兰通勤,(c)美国通勤。横轴表达式复杂度,纵轴RMSE除以最简单重力模型wⱼ÷d的RMSE;方块为搜索结果,叉号为既有模型,数值越低越好。(d)列出复杂度3、5、7、9、11的代表表达式,底色区分只含距离、距离加目的地吸引力及其他组合。(e)列出Zipf、幂律/指数重力、机会优先、辐射和Schneider中间机会模型作为参照。美国复杂度15的点并非帕累托最优,不应理解成所有连接点都严格位于最优前沿。来源:作者修订稿 Fig. 3。
表2对六种既有模型的RMSE比较中,指数重力在七组中的六组最低,广东县级通勤则辐射模型最低:105.62,对比指数重力111.91。不同模型复杂度并不相同;“既有模型里最低”与“同复杂度搜索里最低”是两种比较,不能混用。
论文还报告,辐射、Schneider中间机会和机会优先模型相对同复杂度SR模型的平均RMSE分别高92.0%、39.8%、49.1%。这些是本研究数据与拟合目标下的平均差异,不是对三类机制的一般性否定。
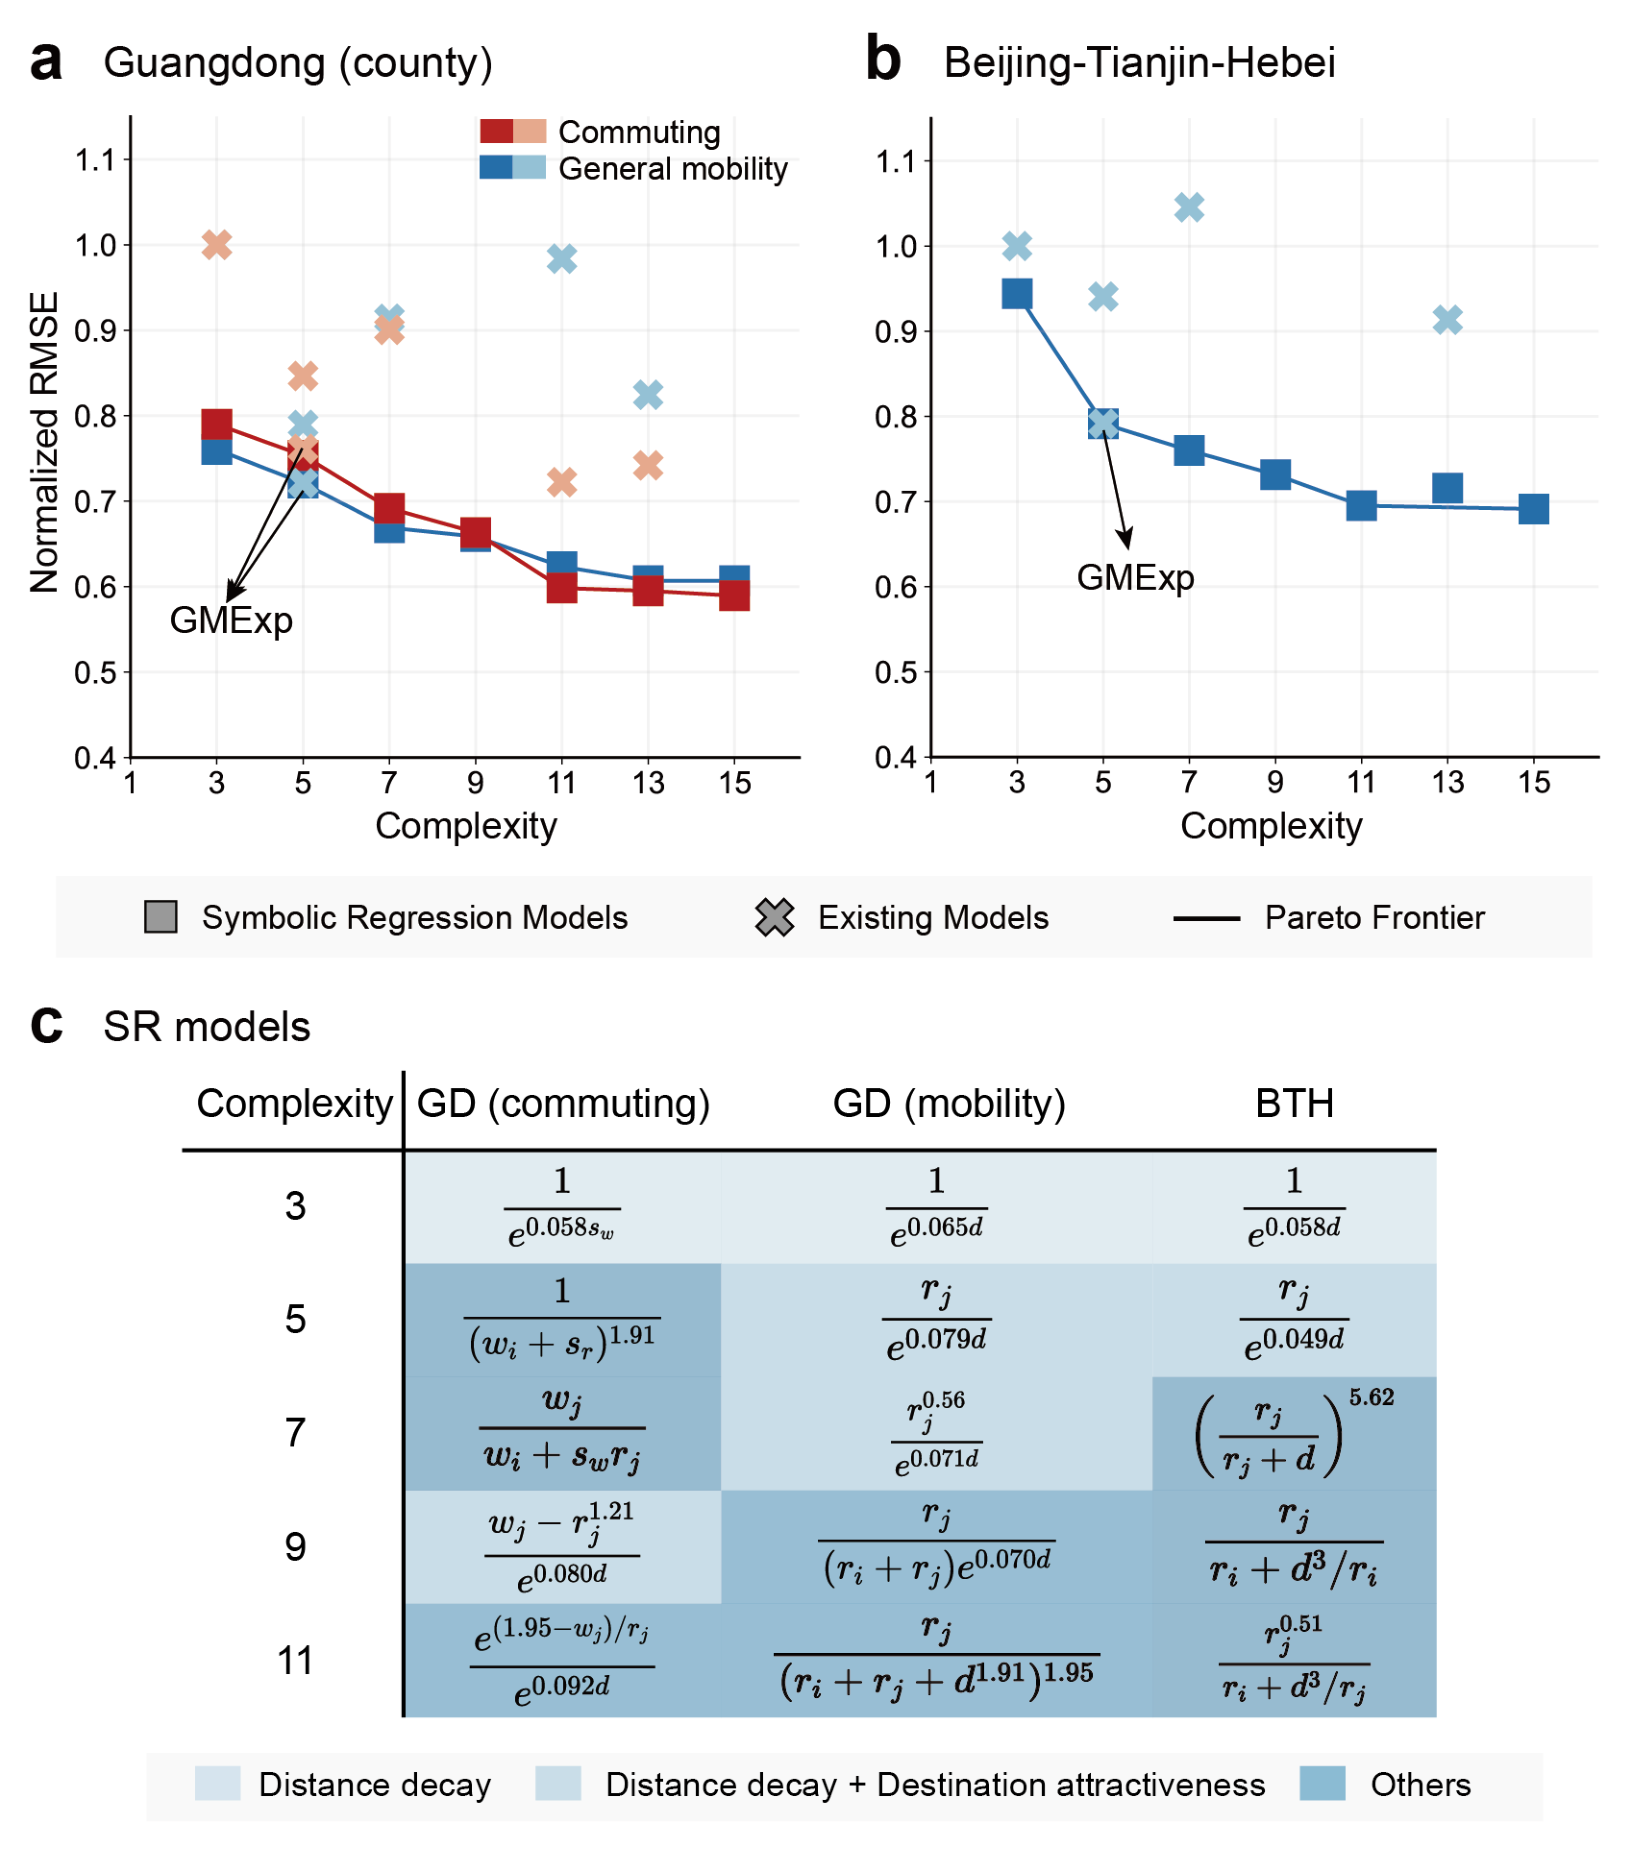
图 S1|正文没展开的尺度是否支持同一结论?
(a)广东县级,(b)京津冀县级的复杂度—归一化RMSE关系;红为通勤、蓝为一般移动。(c)相应公式与效果分类。广东县级通勤的复杂度5表达式使用起点就业人口与中间机会,正是六组一致之外的例外;更复杂公式逐渐呈现地区专属组合。来源:作者修订稿 Fig. S1。
新衰减形式更准,是否意味着机制已经确定?
英格兰与美国通勤在复杂度7时出现了wⱼ÷exp(dᵅ),即目的地就业人口乘以exp(−dᵅ),α分别约0.50和0.42。与简单指数衰减相比,较远距离的惩罚方式发生变化。
英格兰RMSE从360.34降为343.62,约降4.6%;美国从1309.9降为1188.6,约降9.3%。但补充表S3同时给出美国CPC从0.728变为0.724,略降。CPC为两倍共同流量除以真实和预测总流量之和,0到1之间越高越好;RMSE更重视大误差,二者并不保证同向。研究以MSE搜索,因此更低RMSE不能自动解释成所有分布性质更好。
这里的误差主要来自用于搜索公式的同一观测数据,论文没有建立统一的独立留出测试来验证所有发现。因此“更准”首先是该数据上的拟合比较,不能直接承诺未来年份或新城市也提高9.3%。
最大熵解释为新形式提供了可检验的思路:在总流出、总流入和总出行成本约束下,最大熵分布产生对成本的指数衰减;若成本与距离成正比,得到普通指数衰减,若成本与距离的α次方成正比,则得到这里的新形式。
不过研究没有直接观测时间、票价等综合出行成本,也没有独立检验成本—距离关系。该推导给出一种相容解释,不能由流量拟合倒推成本机制已获证明。推导中的双约束重力模型与搜索中固定总流出的分配模型也有不同约束。
全国平均公式为何会错过跨大区联系?
美国按东北、中西部、南部、西部拆为4组区内和12组跨区通勤,再分别搜索。修订稿正文把其中一区写为East,但图4的地图和标签为South,本文按图中的南部解释。
区内流量占全部通勤流量97.5%,四个区内子集仍由指数重力形式占优。12个跨区子集中,幂律重力比指数重力更好,SR又在8个子集找到比两者更好的形式。这是修订版结果,不应沿用旧版的7个。
部分跨区流量在约1,000公里附近出现长程峰,前五大目的地包括芝加哥、纽约、洛杉矶、休斯敦、达拉斯。作者推测大城市工作机会可能抵消距离阻力,但没有直接识别因果。ACS的通常居住地—工作地跨区联系也不能直接理解成每天实际往返1,000公里。
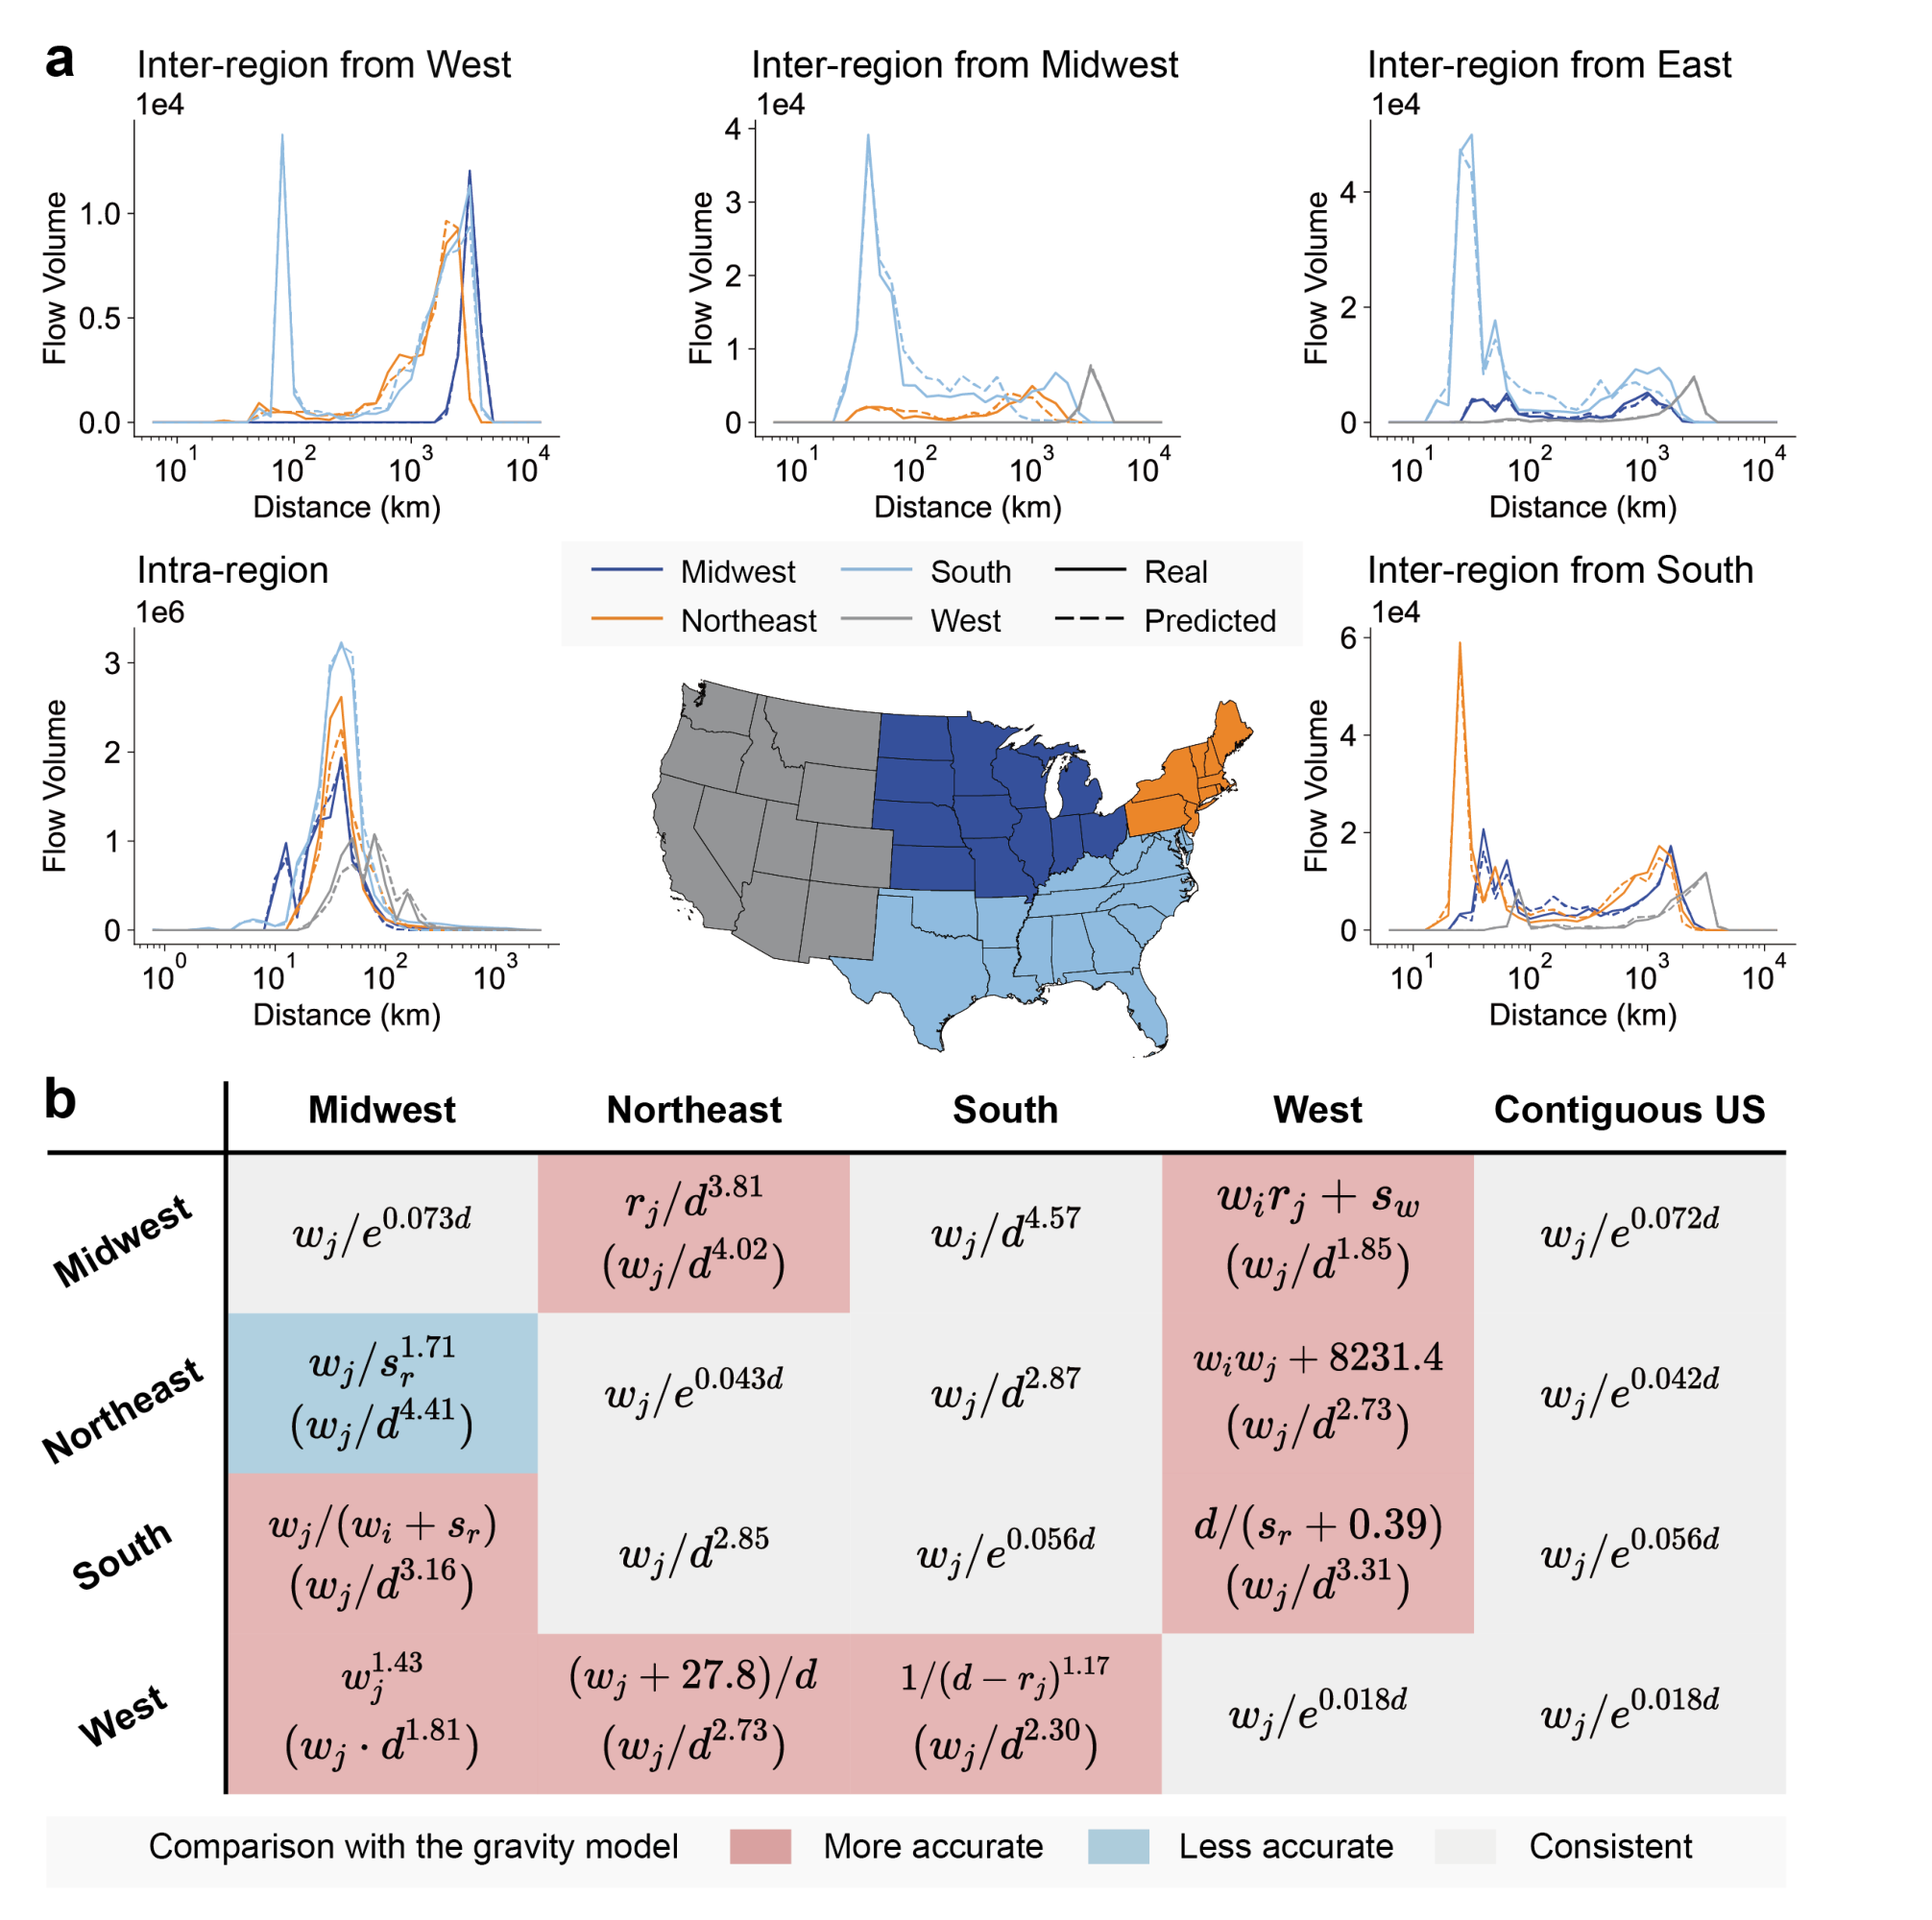
图 4|短程主导的总体规律,能否解释长程联系?
(a)区内及四类起点大区的跨区距离分布,横轴公里、对数刻度,纵轴通勤流量;颜色对应目的地大区,实线为观察、虚线为模型。不同小图纵轴量级不同,区内流量为百万量级,跨区多为万量级。(b)行是居住大区、列是工作大区及美国整体,灰格表示与参照重力形式一致,红/蓝表示SR的RMSE更低/更高;西部到中西部展示复杂度3,因为复杂度5并非最优。并非每个SR子模型都优于参照。来源:作者修订稿 Fig. 4。
图上形状相似,是否每条流量都正确?
补充流量图把实际数据与复杂度5、7的模拟并排,可以看出主要联系和大流量走廊被保留。但地图使用自己的色标范围,整体图像相似不能代替逐OD误差;同一批输入的可视化也不是独立外部验证。
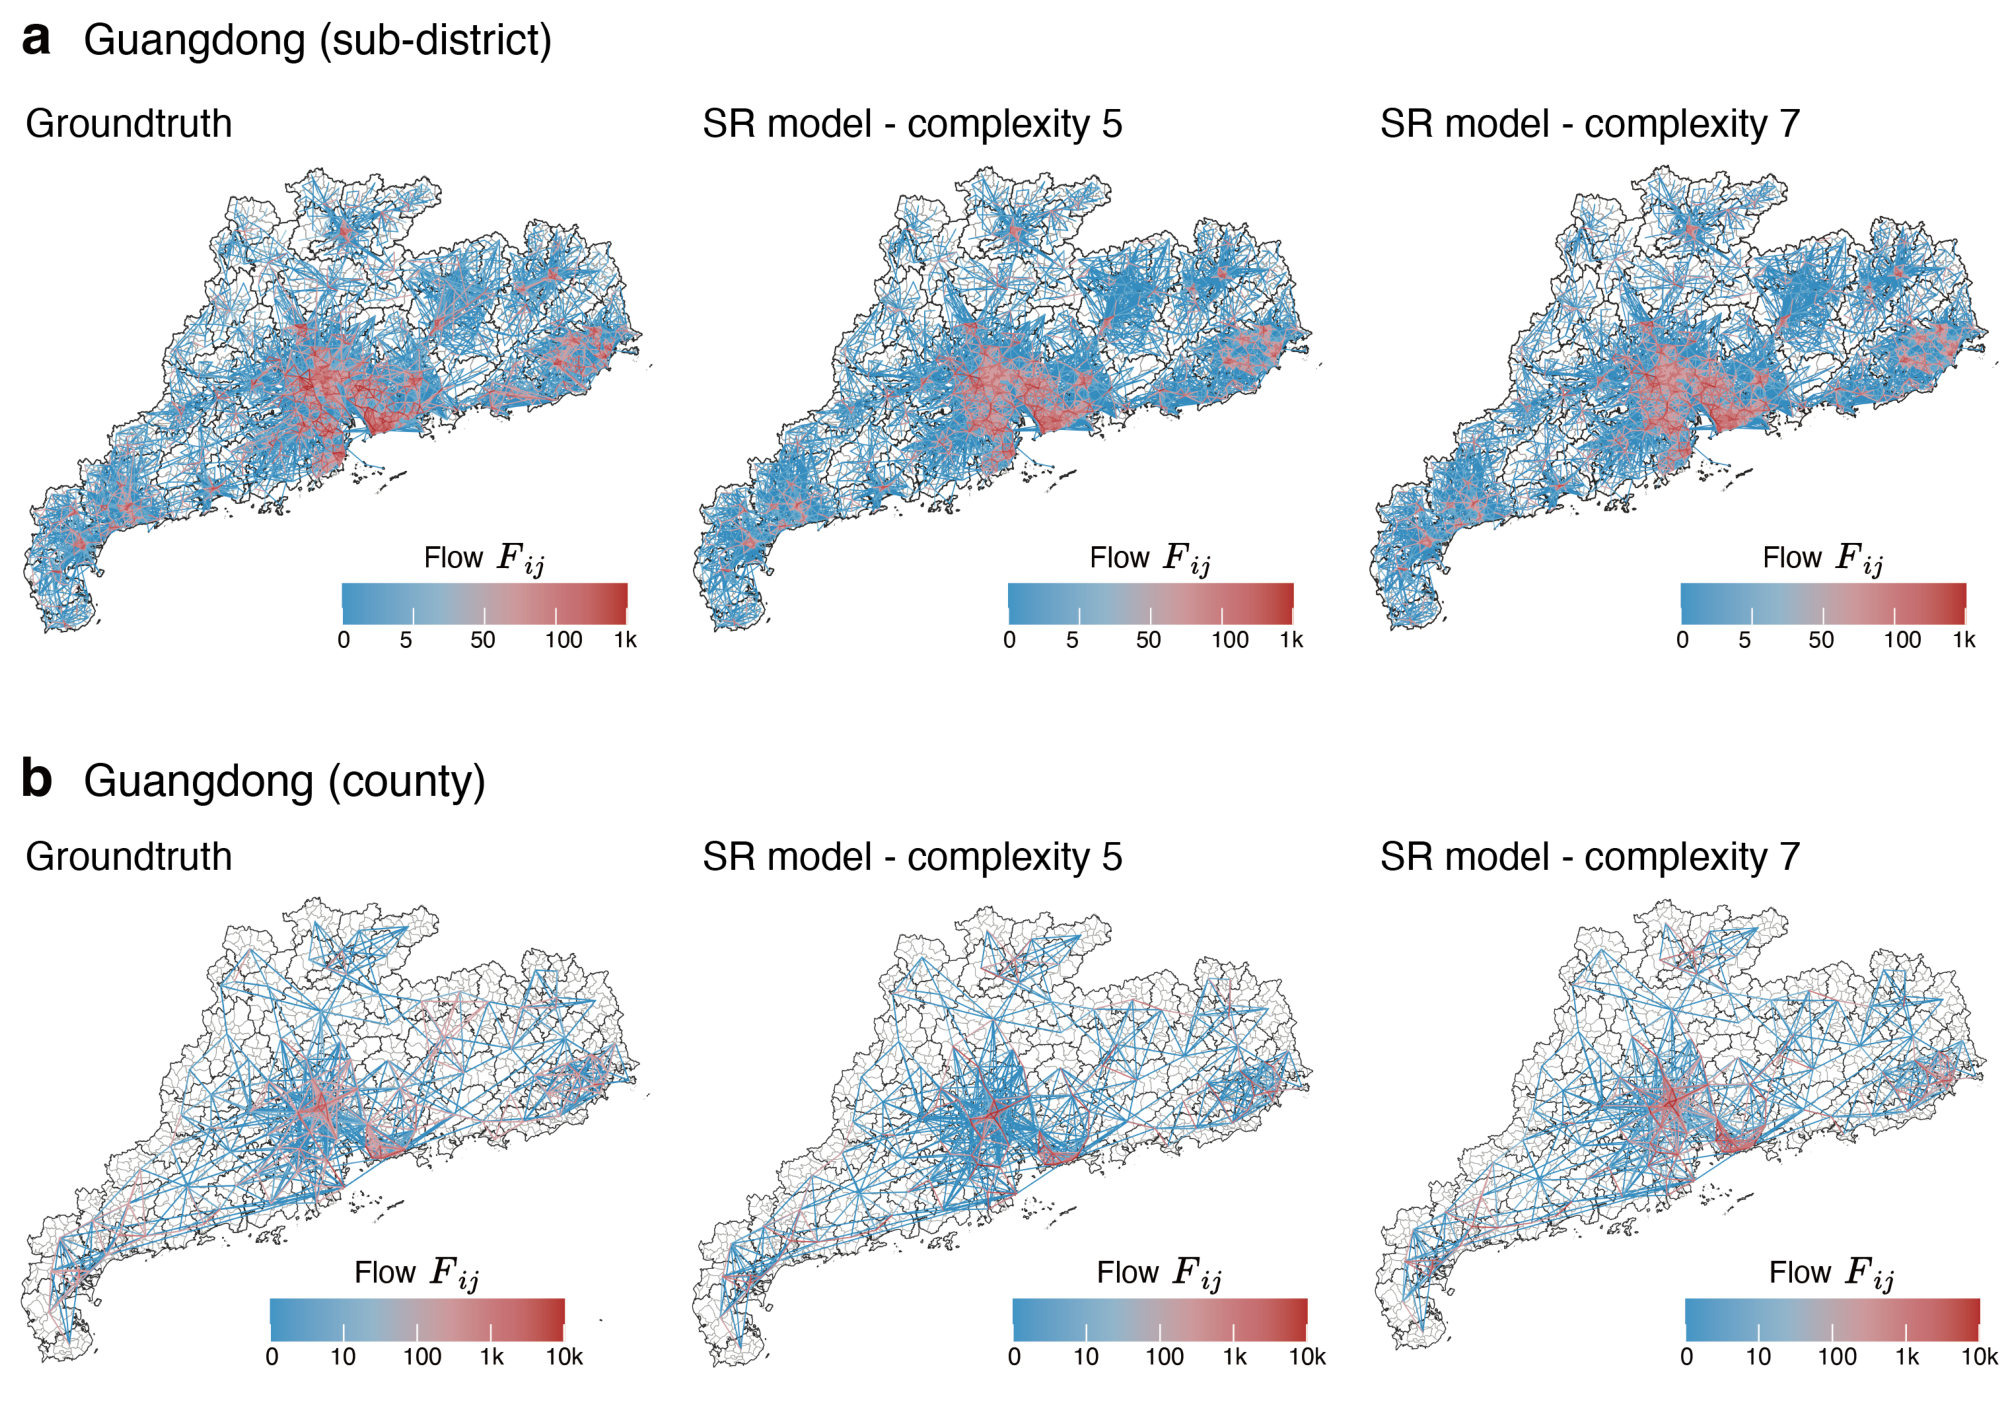
图 S2|广东通勤的主要联系能否由简洁公式重现?
(a)街道/乡镇尺度,(b)县级尺度,每行从左到右是实际、复杂度5、复杂度7模型。蓝至红表示流量增加,上下行色标范围不同;主要结构相近,不表示每条线都准确。来源:作者修订稿 Fig. S2。
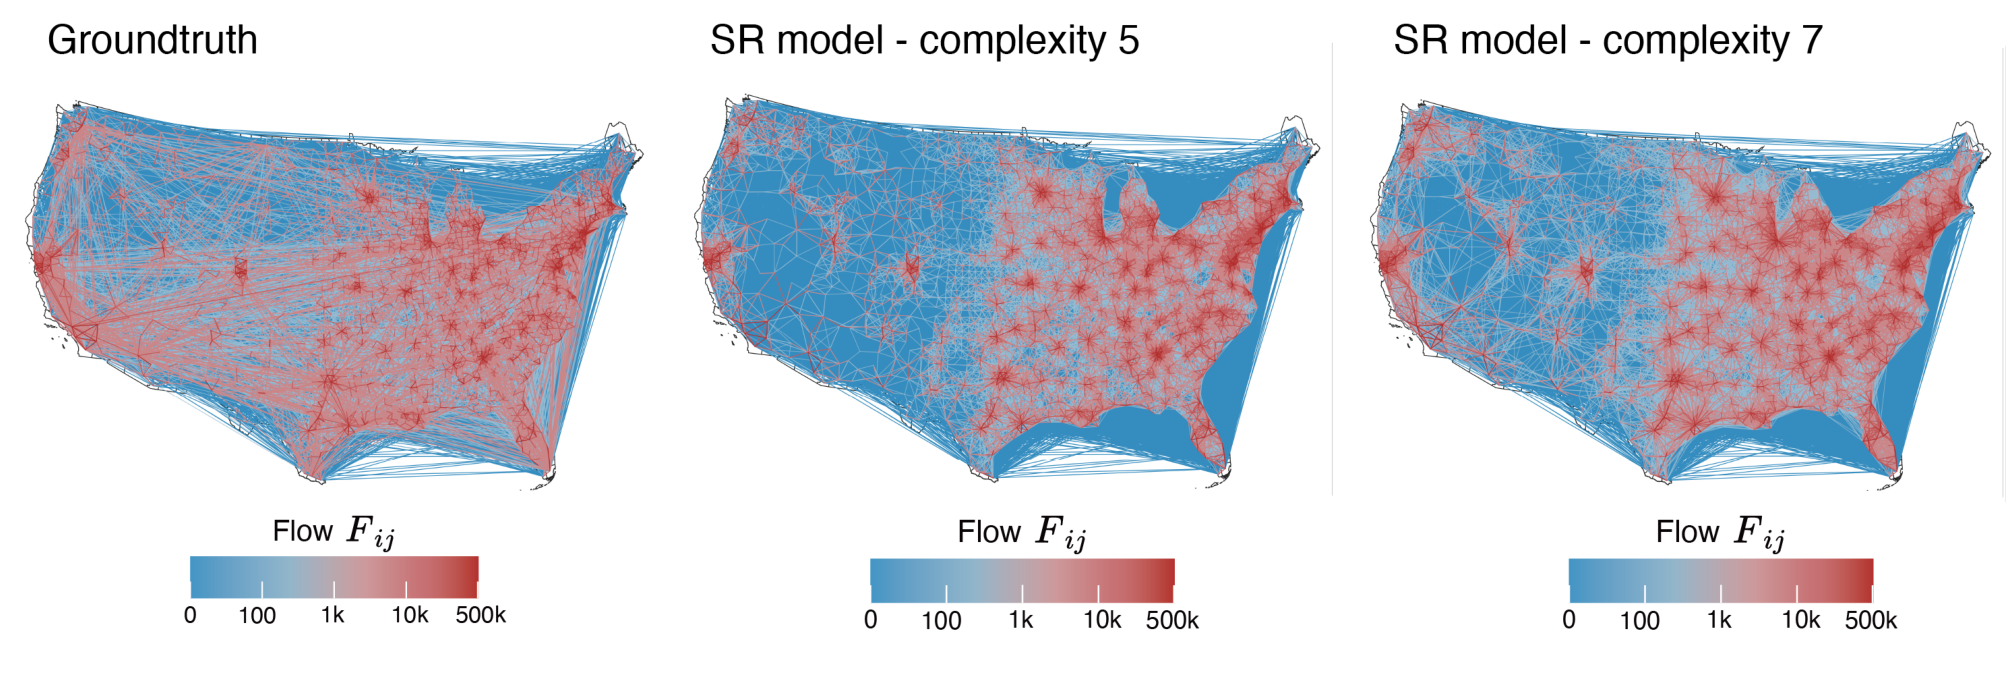
图 S3|美国通勤的整体网络是否保留下来?
无字母子图,左至右为实际、复杂度5、复杂度7,色标最高标至500k。简洁公式能保留密集地区与长距离联系的总体格局,局部仍有差异。来源:作者修订稿 Fig. S3。
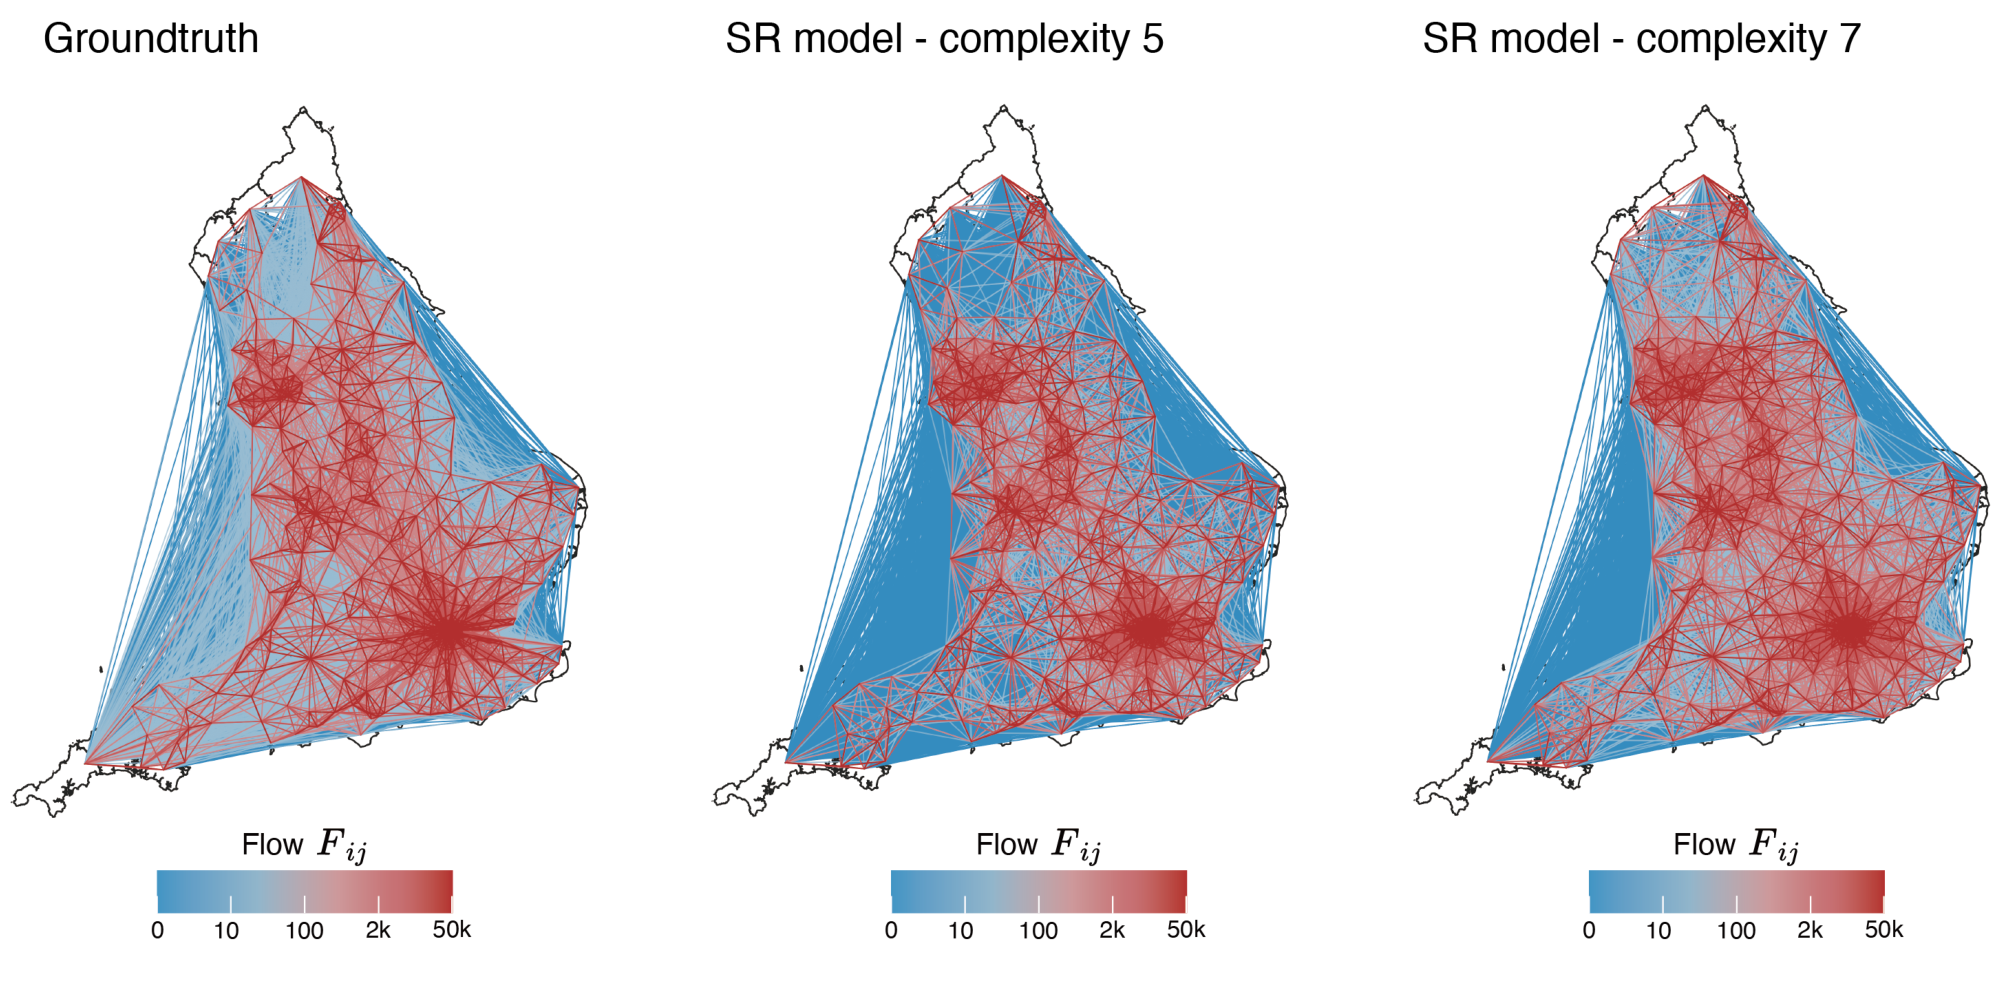
图 S4|英格兰通勤是否也出现总体相似?
无字母子图,左至右为实际、复杂度5、复杂度7,蓝红色标标至50k。主要高流量联系在模型中出现,不能仅靠颜色相似判断独立预测能力。来源:作者修订稿 Fig. S4。
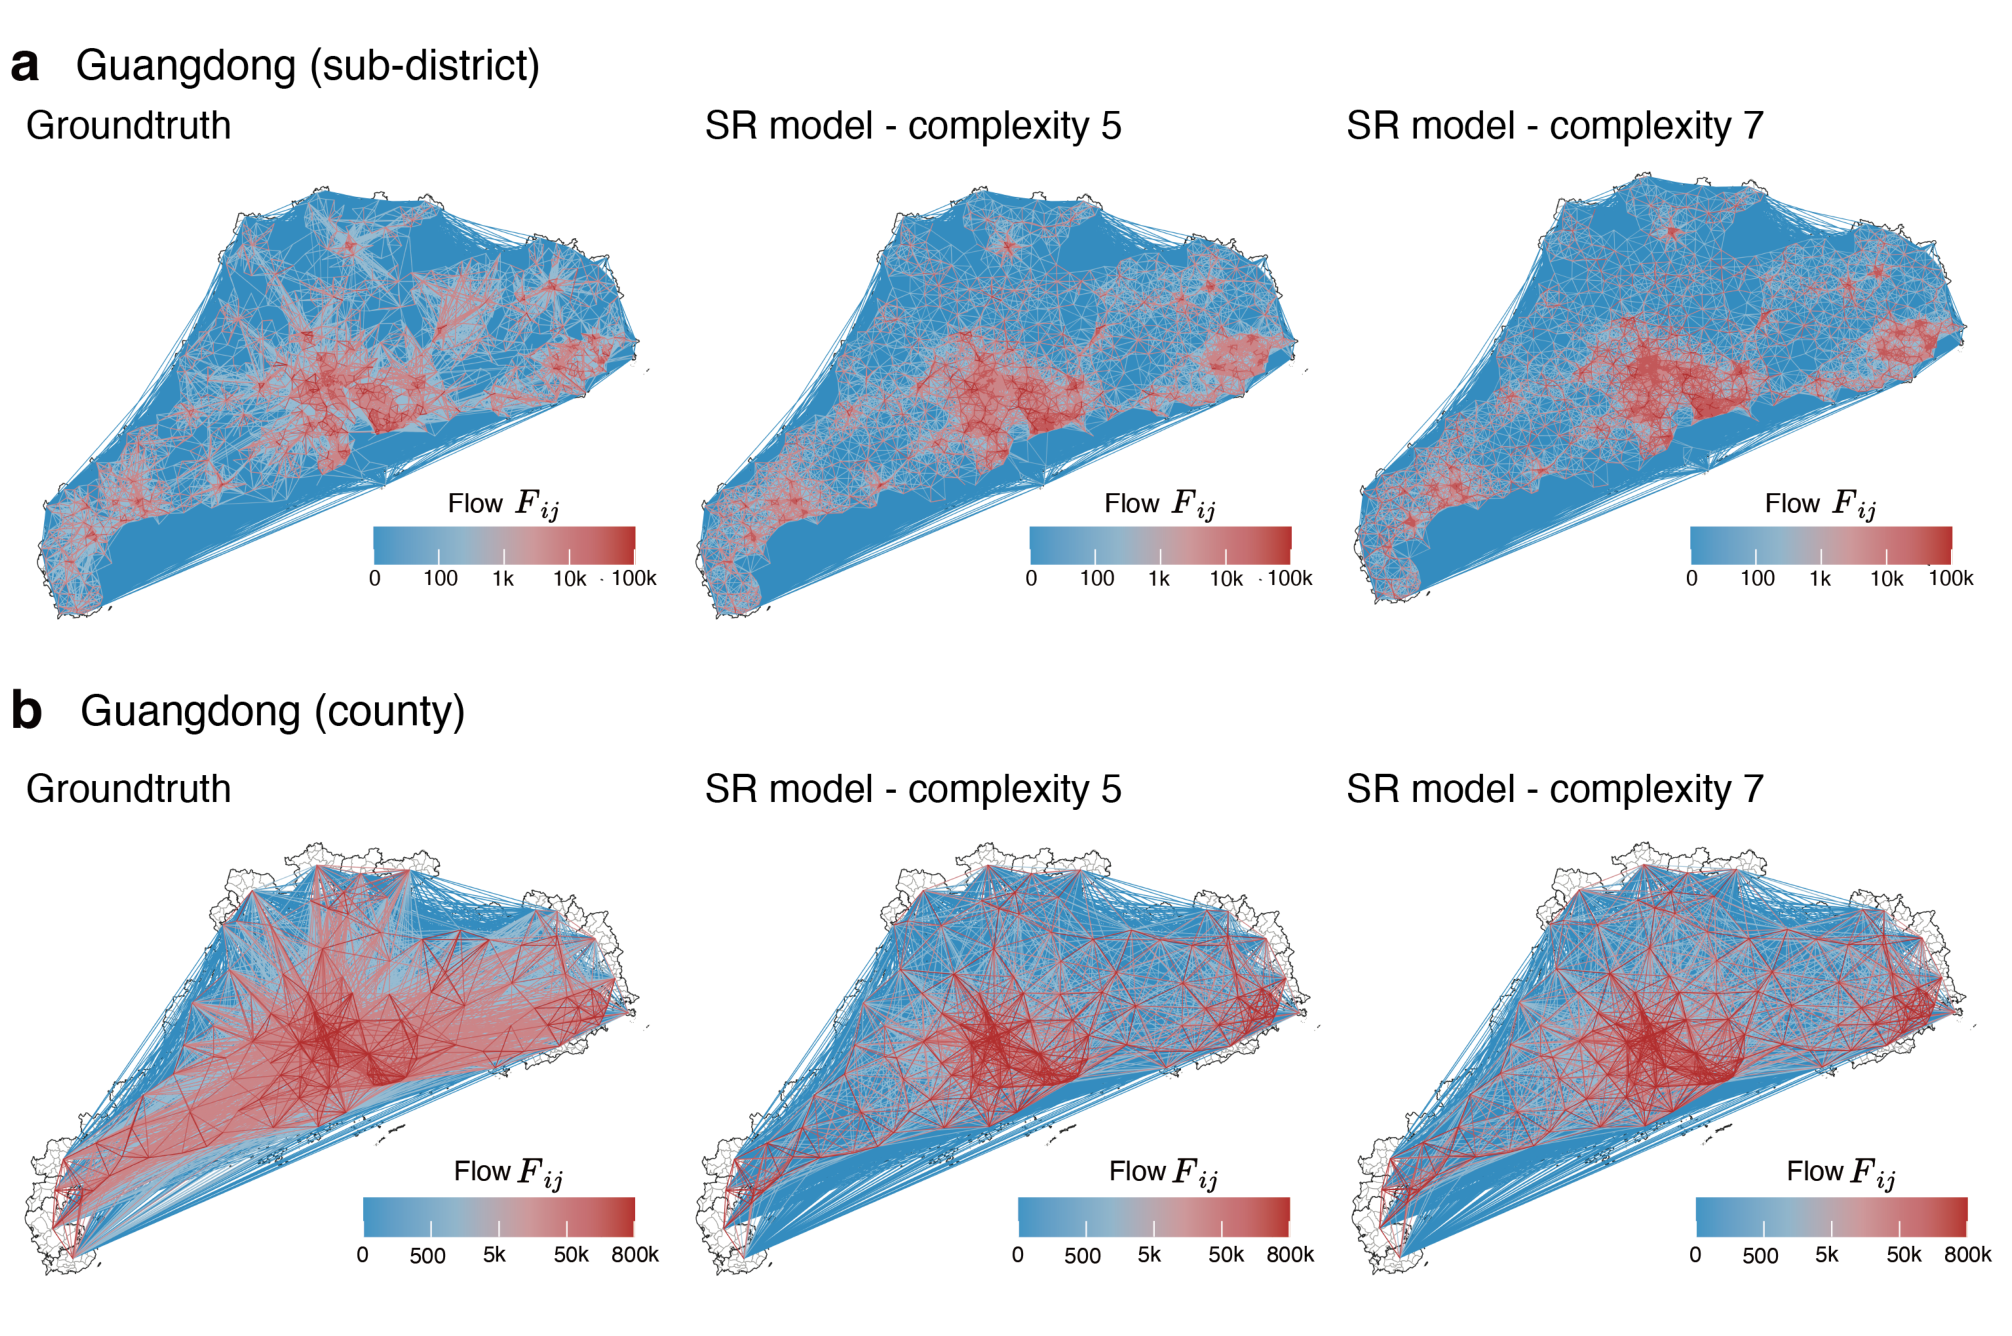
图 S5|一般移动与通勤都能用同样简洁的形式吗?
(a)广东街道/乡镇,(b)广东县级一般移动,各行左至右为实际、复杂度5、复杂度7;色标上限分别标至100k、800k。两种尺度的总体形态可由短公式捕捉,但一般移动的变量口径与通勤不同。来源:作者修订稿 Fig. S5。
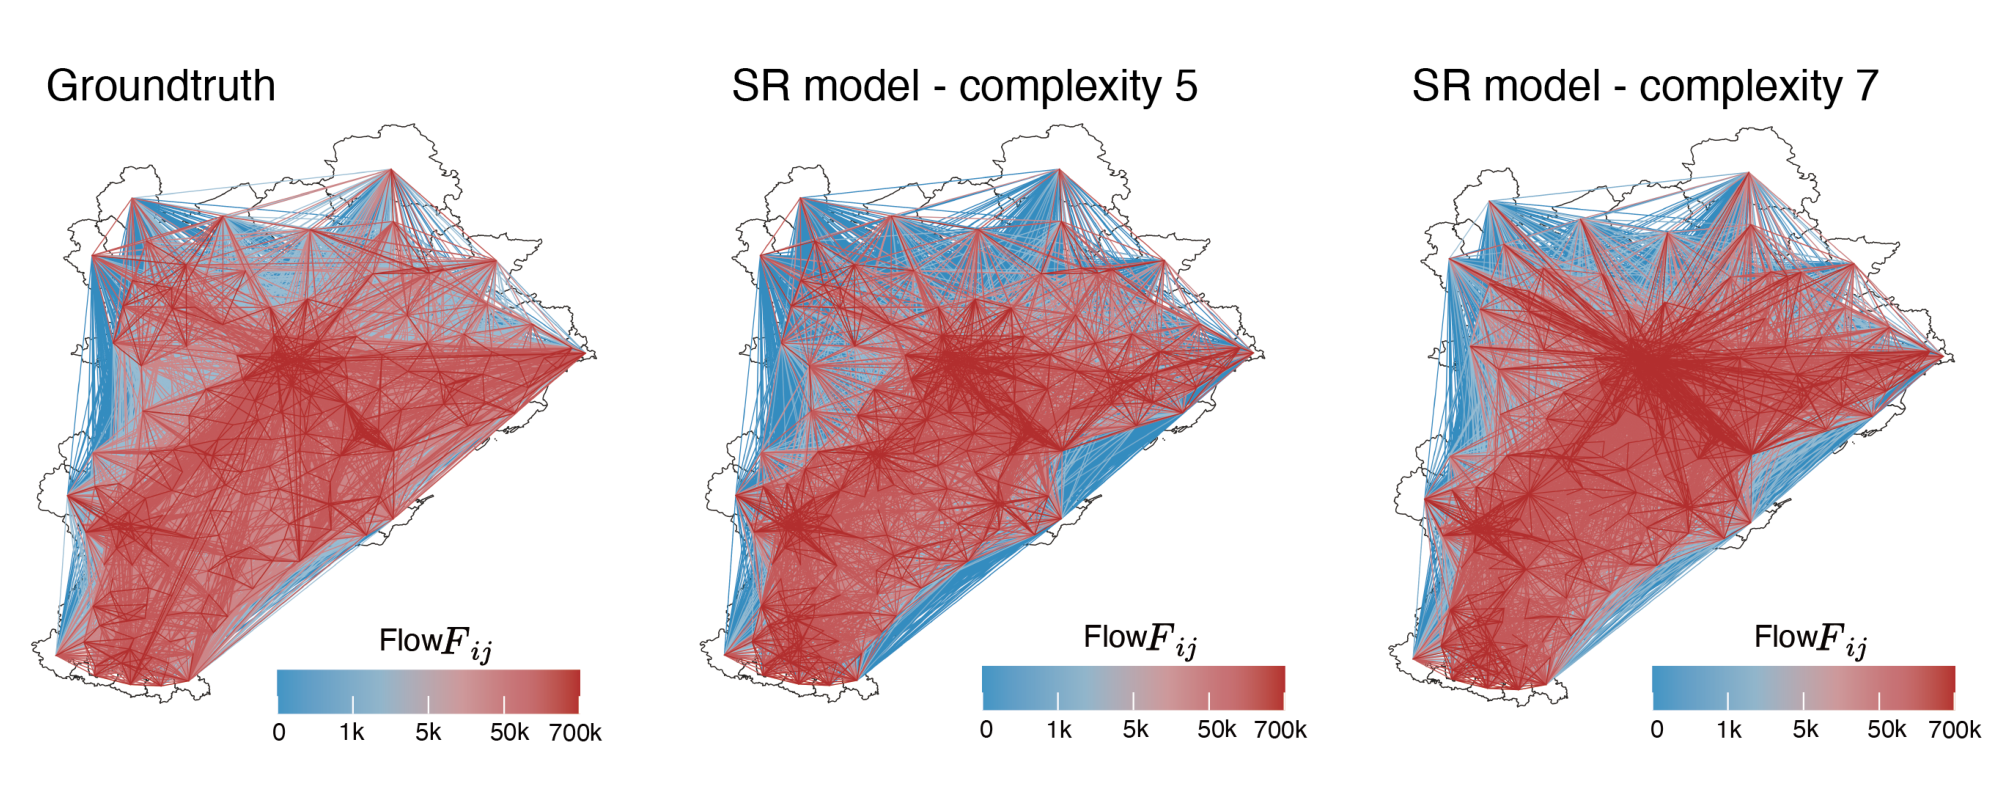
图 S6|京津冀一般移动的骨架能否被恢复?
无字母子图,左至右为实际、复杂度5、复杂度7,蓝红色标标至700k。主要高流量联系保留;不能把保留图形骨架等同于所有小流量都被正确解释。来源:作者修订稿 Fig. S6。
如果数据带噪声,机器还能找回真实生成式吗?
真实数据的生成机制未知,只看拟合无法判断是否找到原公式。研究据美国空间边界、就业人口和总流出,用指数重力、幂律重力、辐射模型生成期望流量,再加已知噪声,让SR反向寻找生成式。
修订版采用负二项分布,期望为μ、方差为μ+αμ²,α越大噪声越强。从接近0的10⁻⁸到2.0共9档,每档每种模型生成5份样本,共135份,独立搜索;低于3的合成流量在搜索中去掉。这与旧版对数高斯噪声实验不同。
以真实美国数据中指数重力模型的CPC=0.728作为参照,α=0.5时三类合成数据平均CPC分别约0.730、0.723、0.725,量级接近。这里比较的是流量偏离程度,不是证明真实观测噪声一定服从负二项分布或α恰为0.5。
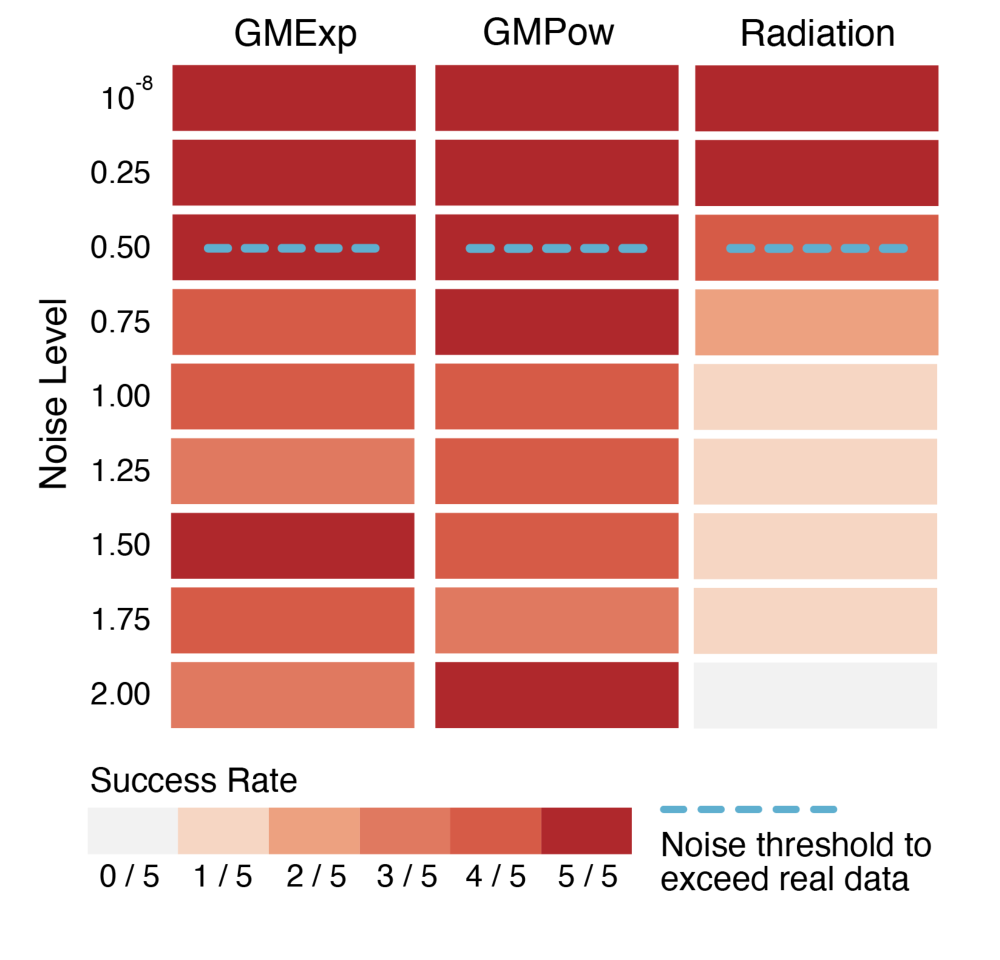
图 5|带噪声时,找回公式的成功率怎样变化?
无字母子图,三列分别为指数重力、幂律重力、辐射模型;纵轴为负二项离散参数α,颜色表示5次样本中的成功次数,蓝虚线标记接近真实数据CPC的参照噪声档。两类重力式在较强噪声下仍多次被找到,辐射式更不稳定;颜色不是实际流量预测准确率。来源:作者修订稿 Fig. 5。
辐射生成式没被找回的25种情形里,除1种外,替代SR公式的RMSE反而更低。这说明“拟合眼前的带噪声数据”与“识别噪声背后的生成机制”是两件事。误差更低不保证机制识别更真,尤其在表达式较长时。
公式越长,解释是否越可靠?
补充表S2—S6列出不同运行的候选式及RMSE、CPC,显示高复杂度表达式逐渐分化。广东县级通勤某复杂度11式RMSE为87.49、CPC为0.727,另一个相近候选RMSE为91.35、CPC仅0.648;即使RMSE差距不大,流量重叠性质仍可能不同。长公式里的人口、距离加减和幂不能逐项强行赋予真实社会机制。
补充表S9还试用贝叶斯机器科学家(Bayesian Machine Scientist,BMS),在美国和英格兰各用1,000个OD样本训练5条独立链、每条12,000步。其目标是描述长度,输出常更长;与本文在多复杂度上搜索的框架、样本及目标不同,不能只看表达式长短宣布一种方法普遍优于另一种。
研究最可靠的贡献是,把“在什么复杂度下,哪些变量与形式已足够”变成可重复搜索的问题。它仍受候选变量、运算符、空间划分、误差函数及启发式搜索制约;简单公式的反复出现值得重视,复杂公式的一次胜出则更需要独立验证。
一句话总结
让数据搜索公式后,指数距离衰减重力模型仍是有力的简洁基线,而更复杂衰减与跨大区例外提醒我们:好的总体拟合既不等于唯一机制,也不等于所有地区共用一条规律。
核心来源
- Geographical Analysis正式发表页面,核对正式题目、作者、发表时间与数据声明。
- 作者修订预印本v2,正文22页及其附带补充材料S1—S10;本文全部图像出自该版本,正文图1—5、补图S1—S6,补表S1—S9。
- FlowSR作者代码与数据入口。美国、英格兰、京津冀处理数据公开,广东数据需向作者申请;公开代码并不等于所有原始个人移动记录公开。
作者介绍
六位作者均署名北京大学地球与空间科学学院遥感与地理信息系统研究所,以下仅采用论文身份及贡献说明。
- Hao Guo:共同第一作者,参与研究设计、数据收集、实验、可视化与写作。
- Weiyu Zhang:共同第一作者,参与数据收集、实验、可视化与写作。
- Junjie Yang:参与实验。
- Yuanqiao Hou:参与数据收集。
- Lei Dong:修订稿及正式页面列为通讯作者,参与研究设计与写作。
- Yu Liu:参与研究设计与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
搜索规律时,可以把“在哪个尺度稳定”也作为目标。若同一公式只在某套分区下漂亮,换边界就改变,可能更多反映聚合方式;若在相近人口尺度、不同分区和独立年份中仍反复出现,才更接近可迁移的关系。这样得到的前沿将同时权衡误差、表达式长度与跨尺度稳定性。
另一个值得检验的方向是把RMSE与CPC共同放入搜索目标。美国指数幂衰减降低RMSE却略降CPC,说明单一目标已在挑选某种“好”。如果还要求小流量、长距离联系或弱势地区也得到保留,最终选中的简洁规律可能不同。这不是算法中立性的失败,而是提醒我们先讲清希望公式服务哪一种比较。