一个人的记录缺了很多,能从其他人的常走路线借到线索吗?
论文名片|Qingyue Long、Can Rong、Huandong Wang、Shaw Rajib、Yong Li,DiffMove: Group Mobility Tendency Enhanced Trajectory Recovery via Diffusion Model,arXiv:2503.18302v1,2025 年 3 月 24 日。预印本,DOI。
一个人的手机只在上午和傍晚留下位置,中间几个小时空白。直接连线可能穿过从没去过的区域;照抄过去同一时刻,又可能错过今天临时改变的行程。此时,其他人经常怎样在这些地点之间移动,能不能提供补充?
DiffMove 将群体地点联系、个人历史和当天已观测点放在一起,用扩散模型恢复缺失位置。实验支持这种组合在若干指标上的价值,但它恢复的是最有依据的候选轨迹,不是重新观测到了缺失时刻的真实生活。
先说结论
- 任务是在已有稀疏当天轨迹和个人历史条件下补回空格,可使用目标时刻前后的已知位置;它区别于只能利用过去信息的未来预测。
- 群体轨迹先形成地点转移图,并通过一阶、二阶邻近关系学习地点表示;个人模块再结合历史习惯和当天偏离,提供恢复条件。
- 表 III 中,DiffMove 在两套数据的 Recall、MAP 上最高,在 Tencent 的距离误差也最低;Geolife 的距离误差由线性插值更好。
- 人工随机遮蔽率增大时,模型仍优于所比较的 AttnMove,但这不等同于已验证长时间失联、设备偏差或全部真实缺失机制。
补回半小时地点,最初有多少数据可用?
研究把北京空间按道路划为 10,655 个街区,平均面积约 0.265 平方公里,每个街区是一个离散地点;时间划为 30 分钟,一天最多 48 格。位置恢复结果因此首先是街区身份,再以街区中心衡量空间误差,不是原始 GPS 点级重建。
| 数据 | 原始来源 | 过滤后实验规模 |
|---|---|---|
| Geolife | 微软研究院 182 名用户的长期 GPS 数据,2007—2012 年 | 40 用户、3,439 地点、896 条日轨迹 |
| Tencent | 北京 2018 年 6 月位置服务使用时产生的 GPS 记录 | 4,246 用户、8,998 地点、39,422 条日轨迹 |
Tencent 保留一天至少有 34 个已知时间格、且至少有五天记录的用户;Geolife 保留一天至少 12 格、至少五天记录的用户。两个样本的完整程度差异很大,Geolife 的长时段并不等于最后保留了大量完整日轨迹。
Table II 汇总这些样本,Table I 汇总符号。主实验在原本已经观测到的位置中再随机遮蔽 20%,把这些已知答案作为恢复目标;序列按时间顺序以 70%、10%、20% 分作训练、验证、测试。评分能够检验人工藏起的点,却不能直接检验原始记录中本来就未知的位置是否真实恢复。
群体图提供什么,个人历史又提供什么?
假如两个地点经常在多人轨迹中连续出现,它们之间的联系可以帮助信息稀少的用户。模型用地点作节点、观测转移次数作权重,建立无向群体图;无向表示并不保留全部起终点方向差异。
图嵌入采用 LINE:一阶邻近保存两个地点直接联系的强弱,二阶邻近保存它们与其他地点联系结构的相似性。两个地点即使少有直接转换,也可能因为邻居结构相近而获得相近表示。这里的群体倾向是轨迹统计,不是社会关系或从众心理的因果测量。
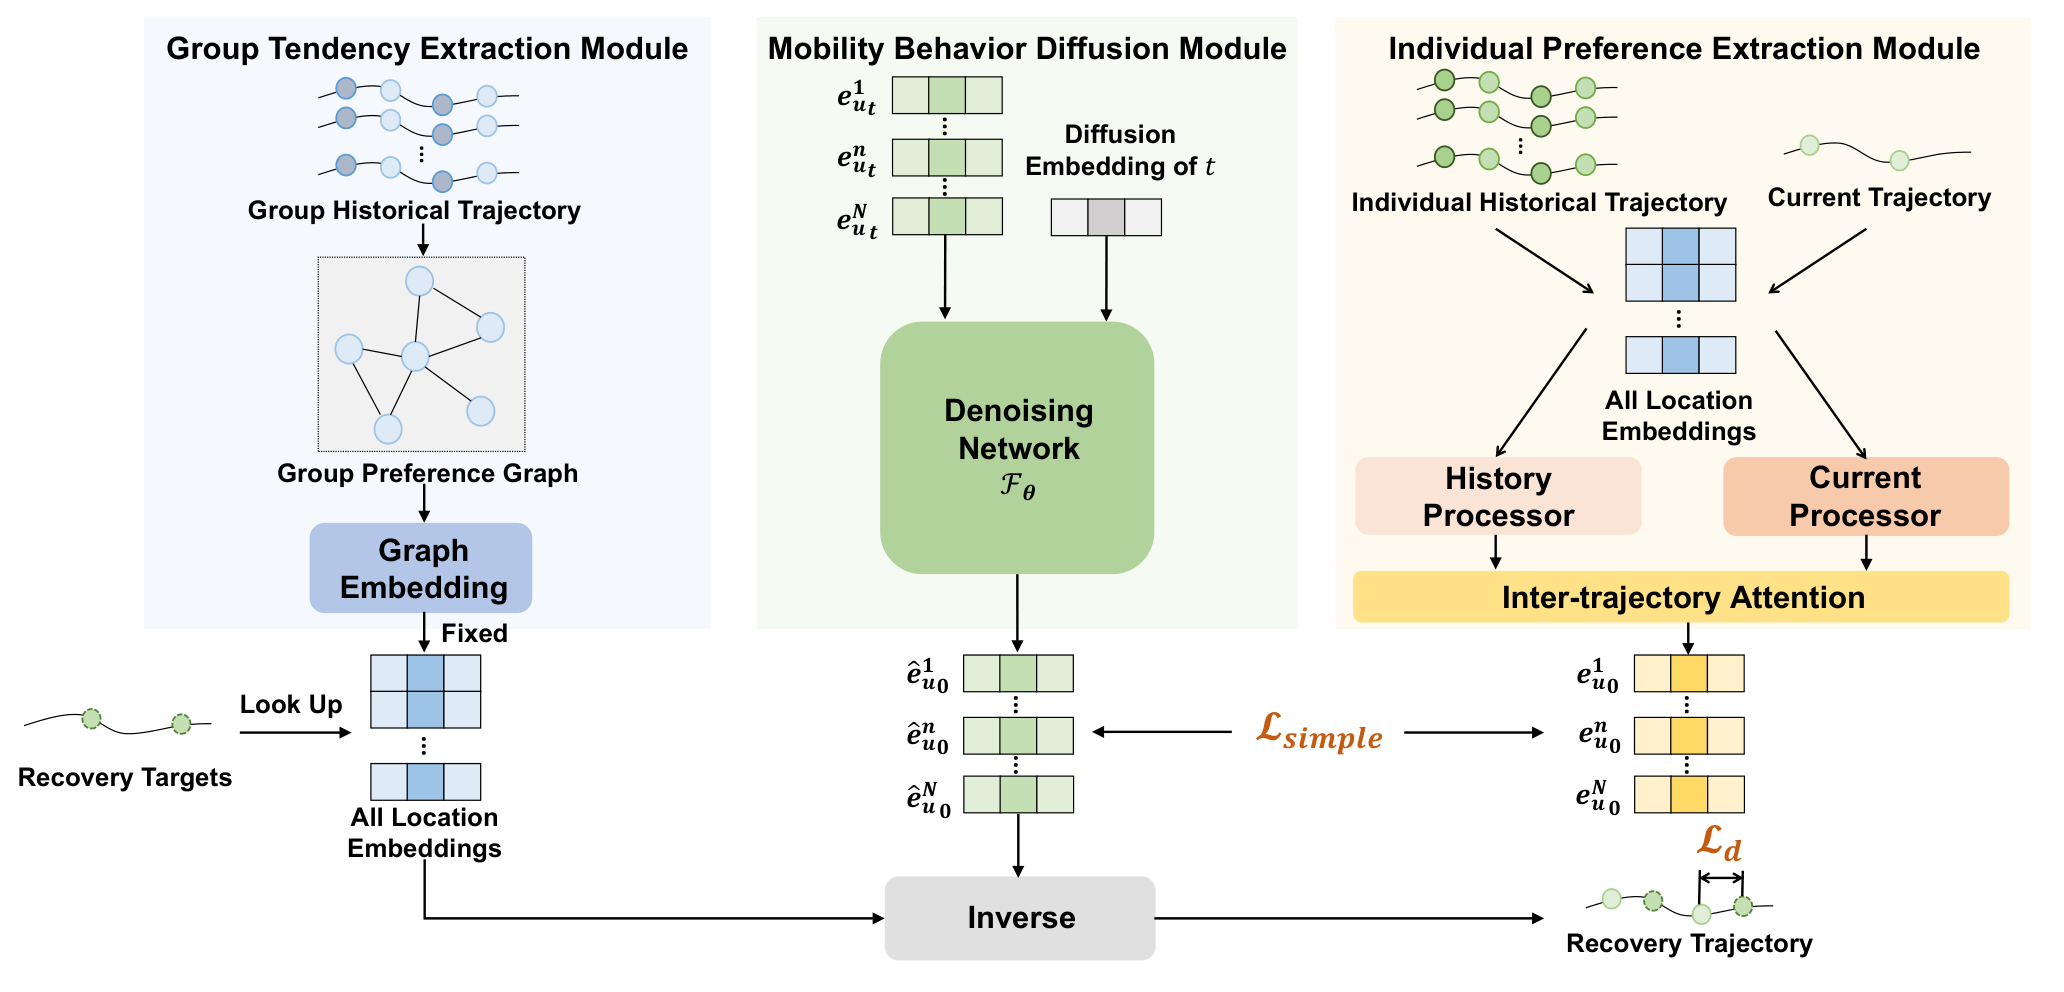
图 1|群体、个人和扩散恢复怎样结合?左侧蓝色模块由群体历史轨迹建立地点图,固定图嵌入后查表获得地点表示;右侧黄色模块分别处理个人历史和当前轨迹,再通过跨轨迹注意力整合;中间绿色模块逐步去噪,输出连续表示并映射回离散地点。下方简单重建损失与距离损失约束恢复结果。整张原图没有子图字母,按三个位置逐一说明。来源:原论文 Fig. 1。
个人历史先按同一半小时格取过去最常出现的地点,形成一条代表性日模式。注意力机制再从其他时间格提取关联;当前轨迹使用相似结构,捕捉今天已经出现的地点联系。跨轨迹注意力决定各时刻应借重过去的候选,还是更依赖今天的观测。
这种设计可以容纳习惯与变化,但一个按时段众数压缩的历史会丢掉少数却真实的日程。模型是否能保留夜班、临时远行或新地点,需要单独分组评估,不能只看总体指标。
群体图描述为使用可用轨迹构建,文中没有充分交代构图与图嵌入是否仅限训练期。严格评估时,需确保测试答案和人工遮蔽位置没有先进入图;时间顺序切分本身不能自动排除共享图中的信息进入。
为什么在地点表示上加噪,而不是直接挑一个最像的位置?
地点恢复可能有多个合理候选。扩散模型先在表示空间逐步加入高斯噪声,训练一个去噪网络逆向恢复干净表示;采样从噪声出发,多次预测与修正,再映射回离散街区。
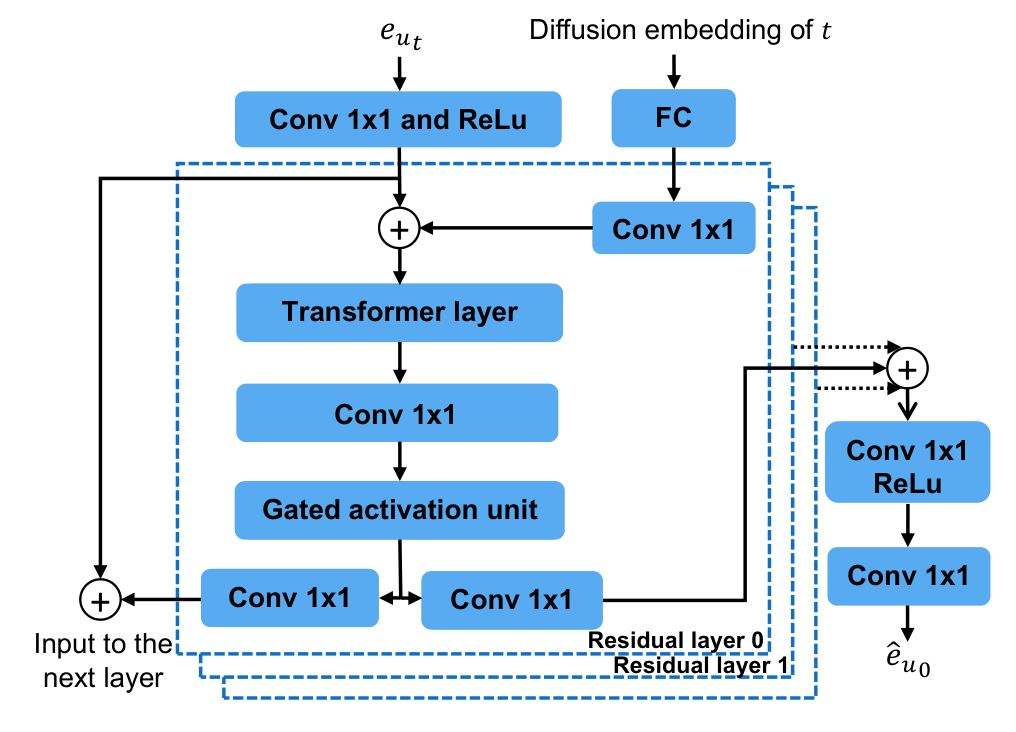
图 2|每次去噪怎样利用序列结构?输入是带噪地点序列表示与扩散步数 t;1×1 卷积变换特征,Transformer 层处理时段间关系,门控单元与残差连接保留和组合信息,右侧汇聚多层输出后估计干净表示。图中扩散步数不是一天中的半小时编号,两种时间需要区分。来源:原论文 Fig. 2。
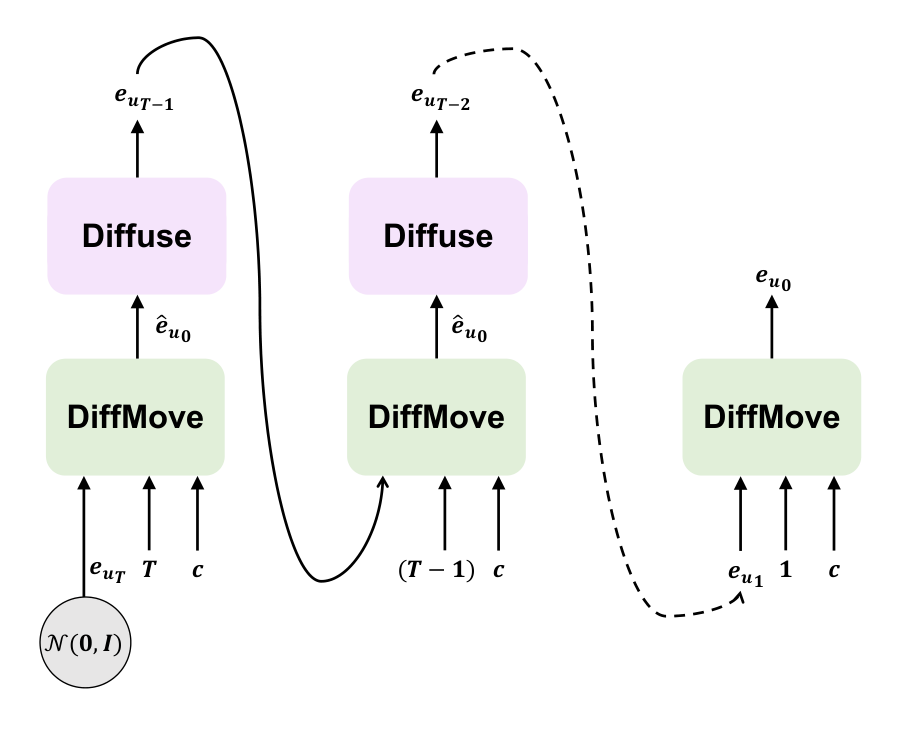
图 3|为什么一次恢复需要多轮?从左下高斯噪声开始,DiffMove 在当前扩散步和条件 c 下估计干净表示,再产生下一步输入,重复至最后输出。虚线省略中间重复步骤,不代表跳过缺失时段;条件包含模型提取的轨迹信息。来源:原论文 Fig. 3。
训练目标除了表示重建误差,还加入相邻恢复位置的距离约束,惩罚过大的连续跳变。它帮助空间连续性,却不是道路可达性、速度上限或旅行时间的完整约束;真实长距离出行也可能被过强的平滑压低。
表中的提升,究竟是百分点、相对比例,还是米?
Table III 比较线性插值、历史同刻、常去地点、随机森林以及 LSTM、BiLSTM、DeepMove、Bi-STDDP、AttnMove、PeriodicMove、TrajGDM。Recall 衡量恢复真实地点的能力,MAP 衡量候选排序质量,越高越好;Distance 为预测地点中心与目标位置的空间差距,单位米,越低越好。
文中未给出 Recall 的完整候选截断定义,因此不能擅自把它解释成任意 top-k,或直接称为每个半小时的精确坐标正确率。
| 数据与指标 | DiffMove | 相应强对照 | 按表内数值比较 |
|---|---|---|---|
| Geolife Recall | 0.4272 | PeriodicMove 0.4074 | 相对约提高 4.9%,绝对增加 0.0198 |
| Geolife MAP | 0.5017 | PeriodicMove 0.4805 | 相对约提高 4.4% |
| Geolife Distance | 3,126 米 | 线性插值 2,345 米 | 本方法误差更高,未获最优 |
| Tencent Recall | 0.8457 | PeriodicMove 0.7893 | 相对约提高 7.1% |
| Tencent MAP | 0.8945 | PeriodicMove 0.8501 | 相对约提高 5.2% |
| Tencent Distance | 681 米 | PeriodicMove 786 米 | 相对约降低 13.4% |
这些提升根据表 III 重算。正文叙述了更大的若干百分比,但与该表对应比较不一致,不能同时把两套百分比当成同一结果。以表内原始数值为依据,更容易判断收益到底多大。
Geolife 中地点命中或排序更好、平均空间误差却不如线性插值,并不矛盾。一个模型可能更多次选中正确街区,但少数错误跳得较远;另一个模型可能从不完全命中却多数落在附近。应用是关心位置类别还是近似距离,会改变对好模型的判断。
群体、个人与距离损失,谁贡献更明显?
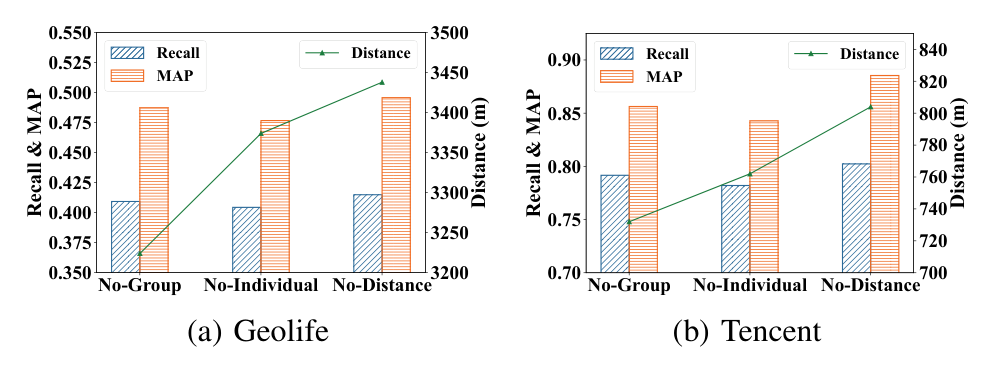
图 4|去掉一个模块会损失什么?(a)Geolife;(b)Tencent。横轴依次为去群体图、去个人模块、去距离损失,蓝色与橙色柱分别为 Recall、MAP,左轴越高越好;绿色线为米级距离误差,使用右轴,越低越好。去个人模块时命中与排序通常下降更明显,去距离损失时空间误差更高。图中没有完整模型柱,需要与 Table III 对照,不能只在三组删减模型中寻找完整性能。来源:原论文 Fig. 4。
例如 Tencent 完整模型 Recall 为 0.8457,图中去群体和去个人后的柱都较低;去距离损失后,米级误差明显高于 681 米。消融支持组合信息有帮助,却没有单独证明群体模块已消除稀有地点偏差或群体选择性。
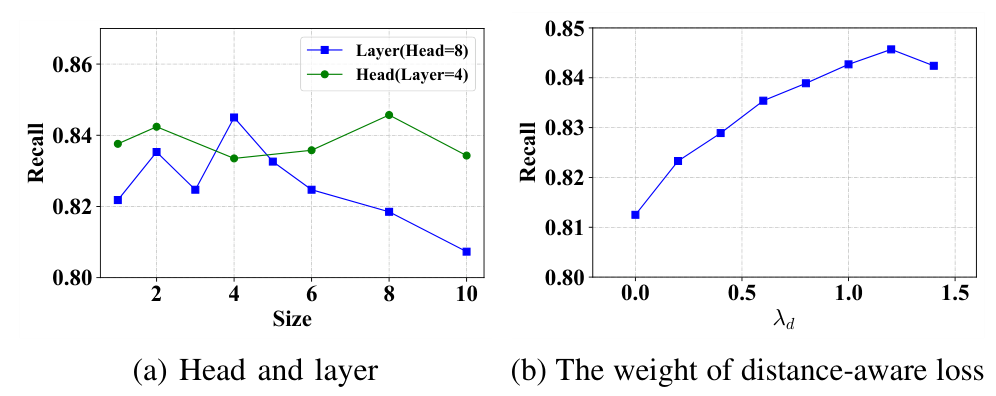
图 5|模型越深、距离惩罚越强,就越好吗?(a)蓝线固定 8 个注意力头改变层数,绿线固定 4 层改变头数,横轴为规模、纵轴为 Recall;蓝线在约 4 层较高,更多层并不持续改善。(b)改变距离损失权重 λd,Recall 先升、约 1.2 后略降。两幅保留完整坐标与图例;右图展示的是 Recall,没有展示 Distance 随权重的完整曲线。来源:原论文 Fig. 5。
预印本对最终层数和头数的文字选择,与图 5a 及前段最佳层数说明不完全一致。因此曲线可以支持敏感性判断,但不能据这份文字直接认定一个无歧义的最终复现配置。它也没有提供充分训练时长与采样成本比较,不能只凭采用扩散模型就断言效率优于全部对照。
遮掉八成观测,是否仍比别人遮掉两成更好?
Table IV 在 Tencent 上把人工遮蔽比例从 20% 提到 80%,对比 AttnMove:
| 遮蔽率 | DiffMove Recall / MAP / 米误差 | AttnMove Recall / MAP / 米误差 |
|---|---|---|
| 20% | 0.8457 / 0.8945 / 681 | 0.7646 / 0.8249 / 934 |
| 40% | 0.8301 / 0.8612 / 745 | 0.7502 / 0.8056 / 1,012 |
| 60% | 0.8076 / 0.8428 / 802 | 0.7267 / 0.7731 / 1,146 |
| 80% | 0.7823 / 0.8364 / 835 | 0.7145 / 0.7628 / 1,195 |
DiffMove 在 80% 人工遮蔽下,三项指标都优于 AttnMove 在 20% 时,说明这一对照下表现稳健。但 AttnMove 不是 Table III 中所有指标最强的基线;不能将结论改写为八成缺失也胜过全部方法的两成缺失。
这些人工遮蔽从已有观测中产生,起始样本又经过完整度筛选,与连续数小时失联、设备在特定场所失效、某类用户主动关闭定位等真实机制不同。随机缺失实验提供了一份证据,尚不足以覆盖所有高稀疏场景。
恢复出来的轨迹,该怎样使用?
DiffMove 证明了一条有用路径:群体地点关系可以补个人历史的不足,当前观测又能防止完全照抄常规日程。可是模型输出依然是条件估计;在观测极少时,热门地点与个人众数可能主导恢复,少见的真实活动恰好可能被抹掉。
若用于人流估计、规划或其他下游分析,还需比较完整分布和不确定性,而不仅输出一条看似完整的轨迹。原文也将地点功能语义留作未来方向,当前结果不能自动区分同街区内的工作、购物或居住活动。
一句话总结
群体地点图与个人当日、历史信息结合,能改善稀疏轨迹恢复,但优势依赖评分目标、构图信息边界与缺失机制,补出的地点不能当作重新测量到的事实。
核心来源
Qingyue Long, Can Rong, Huandong Wang, Shaw Rajib, Yong Li. DiffMove: Group Mobility Tendency Enhanced Trajectory Recovery via Diffusion Model. arXiv:2503.18302v1, 24 March 2025。原始版本,arXiv DOI。本文依据 v1 全文、Table I—IV 与方法公式,Fig. 1—5 均为完整原图。书目按 arXiv 官方版本记录,不将版式中的期刊模板字段当作已确认出版信息。
作者介绍
- Qingyue Long:论文署名为清华大学电子工程系、北京信息科学与技术国家研究中心(BNRist)。
- Can Rong:论文署名为清华大学电子工程系、BNRist。
- Huandong Wang:论文署名为清华大学电子工程系、BNRist。
- Shaw Rajib:作者列表以此顺序署名,机构说明采用 Rajib Shaw,署名机构为日本庆应义塾大学媒体与治理研究科。
- Yong Li:论文署名为清华大学电子工程系、BNRist。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
可以把测试分成反复到访的熟悉地点与少见、新出现的地点,再分别报告命中率和距离误差。如果总体提升主要来自热门地点,系统也许需要为低频活动保留更多候选,而不是更强地平滑成群体常走路线。
缺失设计还可以从随机删点改成连续时间块、整天缺失或特定地点缺失,并把群体图固定为训练期可见数据。若优势仍保留,才更有理由认为模型能够处理真实设备失联,而不是主要擅长恢复分散藏起的测试点。