两个人走过同样的生活片段,只是顺序不同,轨迹算相似吗?
论文名片|Toru Shimizu、Kota Tsubouchi、Takahiro Yabe,GEO-BLEU: Similarity Measure for Geospatial Sequences,ACM SIGSPATIAL 2022,Article 17,4 页,会议日期 2022 年 11 月 1–4 日。正式论文 DOI。本文同时纳入同名扩展预印本 arXiv:2112.07144v2,修订日期为 2022 年 10 月 31 日;真实轨迹与众包实验属于这个九页扩展版本。
假设一周里,两条轨迹都出现家到公司、公司到医院、家到商店的片段,只是发生在不同日期。若要求从第一步一直对齐到最后一步,它们可能很不相似;若关心是否保留常见活动片段,又可能觉得相当接近。
再换一种情况:预测轨迹与参考轨迹只差一格。把地点当作词语、要求完全相同,会让很近的地点也算完全不匹配。GEO-BLEU 要解决这两个问题:保留局部顺序结构,同时让空间距离进入匹配分数。
主要发现有四点:
- GEO-BLEU 比较连续地点片段,不要求整条轨迹从头到尾对齐;片段内部仍保留顺序。
- 地点略有偏移可以获得部分得分,避免传统 BLEU 的精确匹配让许多单条轨迹直接归零。
- 圆环示例说明,它对整体起点移位较宽容;这是指标所重视属性的展示,不是证明 DTW 在所有任务中都差。
- 扩展版的 12,000 次众包判断中,GEO-BLEU 与人类视觉判断的一致性加权均分为 0.699,高于归一化 DTW 的 0.550 和 BLEU 的 0.530;这不是 69.9% 的预测准确率。
为什么不能总把两条轨迹整段对齐?
动态时间规整(Dynamic Time Warping,DTW)允许两个序列以不同速度推进,寻找保持前后次序、连接起点和终点的低代价对齐。它可以处理长度不同的序列,并不只是按同一时刻逐点相减。
但它仍要求一种全局单调对应。如果两条轨迹中的相似出行片段发生顺序不同,整体对齐可能付出很大代价;这种代价是否符合研究目的,要看我们想保留什么。
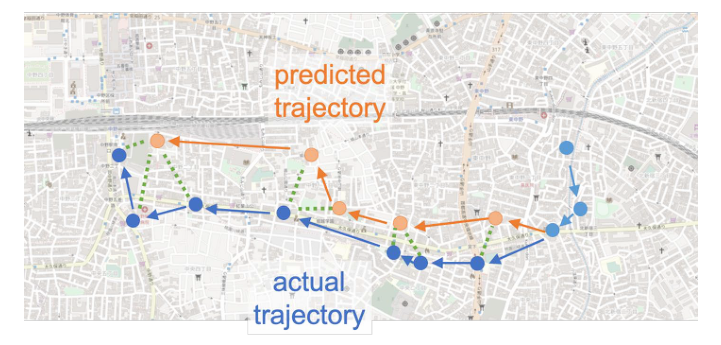
图 1|什么时候全局对齐是合理的?这张无子图字母的示意图中,橙色是预测轨迹、蓝色是实际轨迹,绿色虚线表示对应关系。短时间、简单路线的两条序列,可以给出有意义的整段对应,DTW 适合这种比较。它是概念示例,不是实验样本的准确率展示。
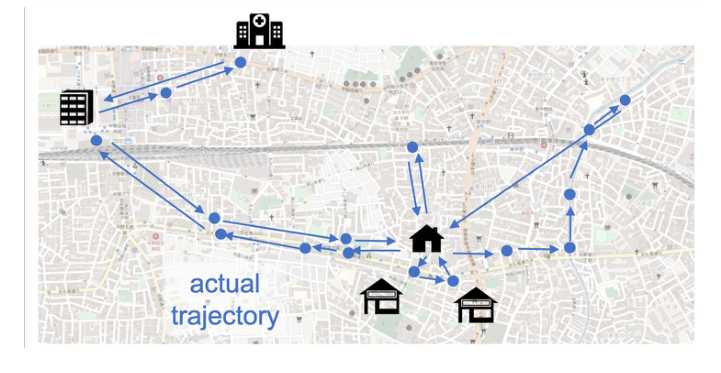
图 2|多天轨迹为什么需要另一种视角?无子图字母的示意图显示多个出发、返回和活动地点,箭头给出移动方向,图标用于帮助理解生活片段。此时也许更关心家—公司等片段是否出现,而不是每一段都按相同全局顺序发生。图标不代表研究已为所有真实数据识别了活动目的。
GEO-BLEU 选择后一个视角。它不是取消所有时间顺序,而是把需要严格保留的顺序缩短到局部片段。
把地点当成词,为什么还不够?
BLEU 原本用于机器翻译:把译文切成连续 n 个词的片段,比较候选与参考文本之间有多少精确匹配。对于轨迹,可以把地点当“词”,把连续两个、三个地点当作片段。
例如 家→公司→医院→家 的二元片段是 家→公司、公司→医院、医院→家。它们保留方向和局部先后,不是只统计去过哪几个地方。
但地点是有空间关系的。两个编码不同、相邻很近的网格,BLEU 仍判为不相同;单条轨迹只要某阶片段匹配全为零,几何平均就可能归零。原始 BLEU 主要面向整批文本,也并不是为单条短序列设计的。
GEO-BLEU 怎样给“很接近”打部分分?
对两个长度相同的 n-gram,GEO-BLEU 按位置一一比较距离,然后相乘:
片段相似度 = exp(−β × 各对应位置距离之和)。
完全相同得 1,越远越接近 0。β 控制距离衰减的尺度,必须与坐标距离单位一起解释;把公里改成米而不调整 β,会改变分数。本文实验设 β=1,但这不是脱离坐标表示的通用常数。
对某一阶 n,算法列出候选片段与参考片段的所有两两组合,按相似度从高到低贪心选择。选中一对后,双方这个片段实例都不能再次配对,避免同一个参考片段被反复利用。相同地点组合若在轨迹不同位置出现,仍是不同实例,不是把所有重复片段一律去重。
把选中相似度加起来,除以候选轨迹中的该阶片段总数,就得到 qn。随后取各阶 qn 的加权几何平均,再乘长度惩罚 BP:候选至少和参考一样长时 BP=1,候选更短时 BP=exp(1−参考长度/候选长度)。这样只生成很短、刚好匹配的片段不会轻易拿到高分。
论文使用 n=1、2、3,权重均为 1/3;BLEU 对照按其原始设置使用最高四阶。因而两个指标的比较还包含片段阶数设置的差异,不能把全部优势归给空间软匹配这一项。
这里还有几项使用边界。贪心匹配不保证全局最优配对;候选分母和长度惩罚也使它具有方向性,不能默认交换两条序列分数不变。对于短于所用 n 的序列、极远距离造成的数值下溢等情况,实际实现需要边界处理,“软匹配”不保证任意输入和数值精度下都严格非零。
绕同一个圆,只把起点移动,两个指标会怎样?
会议短文用一个可控示例突出指标差异:在半径 10 公里的圆周附近放 36 个边长 0.5 公里的网格,沿顺时针访问。将序列的起点与终点逐步向前移位,得到共享绝大多数局部片段的新序列。
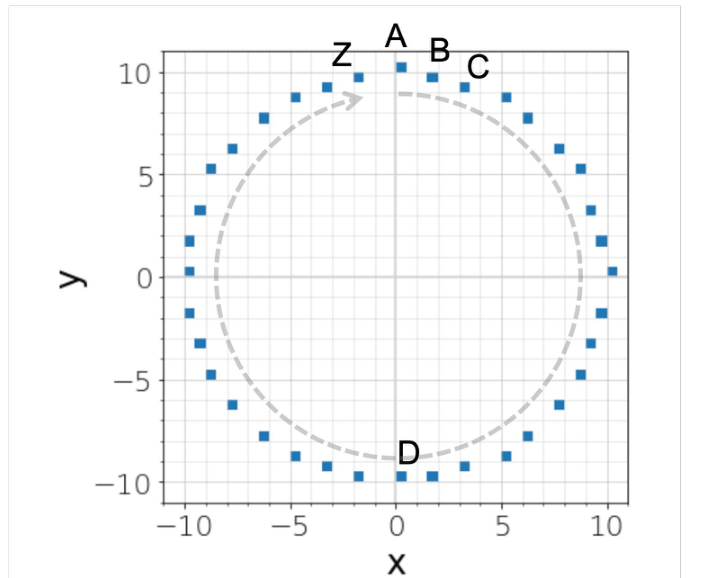
图 3|一条轨迹的起点改变,局部路径变了吗?无子图字母的图中,蓝色网格围成圆,x、y 以公里尺度表示空间,灰色箭头表示顺时针方向,字母标出部分位置。移位改变整体对齐的边界,却保留多数相邻访问组合。这是人工构造,不是 36 名受试者的实地行程。
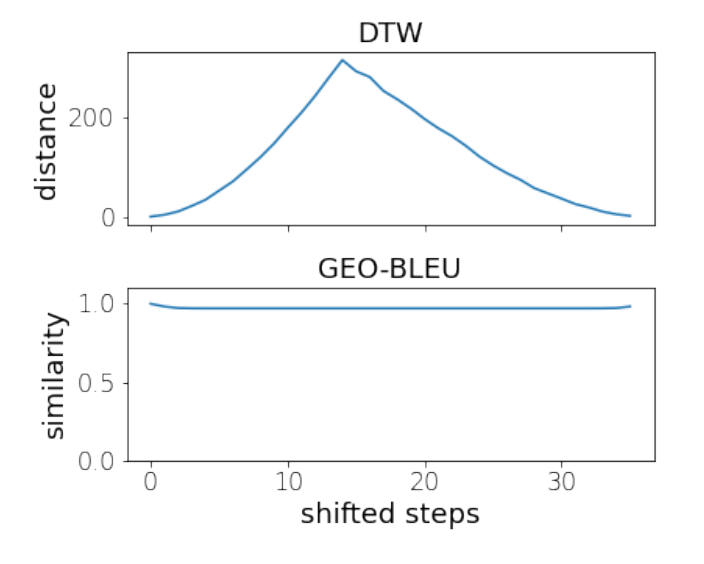
图 4|起点移到圆的对面,是否应该判为不同?上面板为 DTW 距离,下面板为 GEO-BLEU 相似度,原图没有字母;横轴均为移位步数。约移 18 步时,全局对应差异最大,DTW 显著增大;GEO-BLEU 仍接近 1,因为多数局部片段没有改变。DTW 越小越相似,GEO-BLEU 越大越相似,纵轴不能直接同尺度比较。
如果任务是检查某个时刻是否在正确位置,这种对移位的宽容未必是优点;如果任务是比较数天中常见活动片段是否保留,它就有意义。示例证明两个指标回答不同问题,并未建立唯一正确的相似性定义。
扩展版如何在真实生成轨迹上检验?
扩展预印本使用 Yahoo! JAPAN 的手机 GPS 记录,在东京都市圈生成轨迹对。每条记录含用户编号、时间戳、经纬度;位置按小时汇总为 500 米方格,保留两个时期都出现的用户轨迹,再取各时期处于都市圈内、没有未知地点的最长连续子序列。
两个时期分别为 2019 年 10 月 1 日至 2020 年 3 月 31 日,以及 2020 年 4 月 1 日至 5 月 25 日。研究用这一前后差异训练序列到序列模型,目的在于产生有真实背景的候选轨迹,本文没有据此识别疫情政策的因果作用。
数据共有 100 万对序列,不等于论文明确报告了 100 万名独立用户。训练集约 98 万对,验证、测试各 1 万对,词表有 10,584 个网格;前、后期平均序列长度分别为 90.5、124.5 个小时位置,通常跨数天。
生成器由两层 LSTM 编码器与两层 LSTM 解码器组成,训练十轮,选验证损失最低的模型,从测试集生成 500 条候选,与相应真实序列配对。这里比较的是评估指标,不是宣称该生成器已能精确预测人的生活。
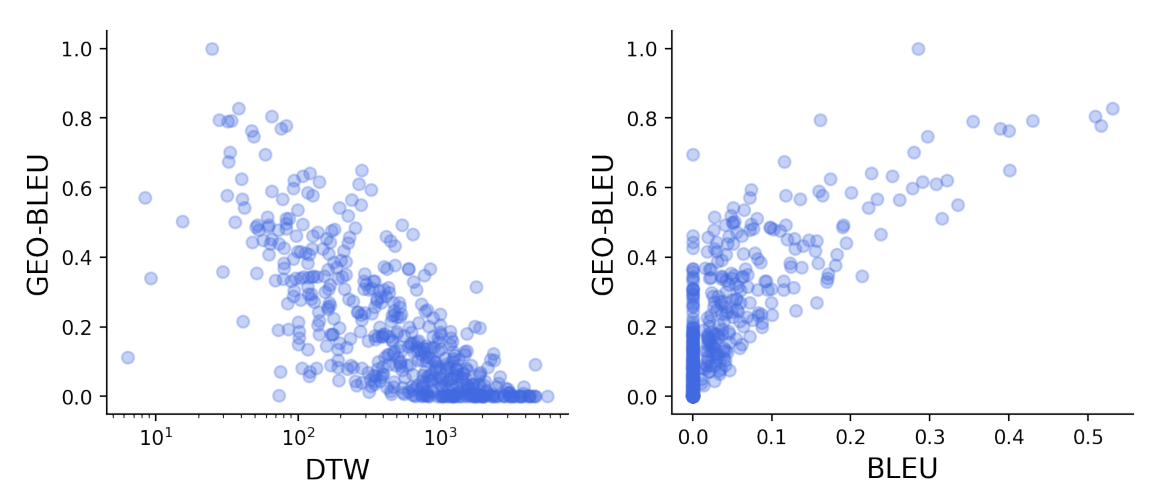
扩展版图 5|三个指标是否给出同样的排序?原图左右两幅无字母,纵轴均为 GEO-BLEU;左幅横轴为归一化 DTW,右幅为 BLEU。每点是一对生成与参考轨迹,总共 500 对。GEO-BLEU 与 DTW 总体负相关,与 BLEU 总体正相关;右图在 BLEU=0 处仍有一列不同 GEO-BLEU 得分,说明精确片段匹配归零后,空间软匹配仍可区分一些差异。文中未给出相关系数与置信区间。
扩展版将 DTW 总代价除以对齐长度进行归一化,以降低序列长度影响。不同指标的数值意义不同,不能将相似度 0.5 与距离 0.5 当成相同表现。
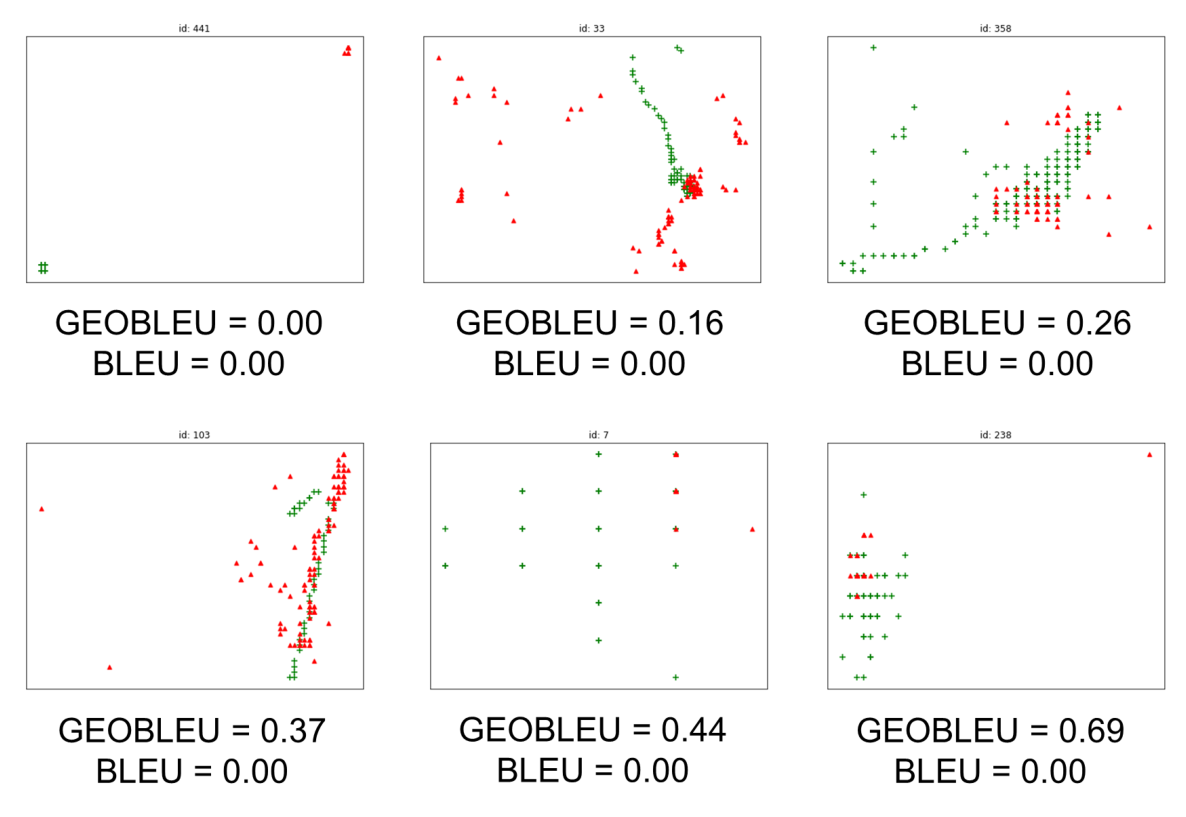
扩展版图 6|同样 BLEU 为零,是否仍有明显相似程度差别?六幅无字母面板按原顺序排列,红色为生成点、绿色为参考点。左上到右下的 GEO-BLEU 分别显示为 0.00、0.16、0.26、0.37、0.44、0.69,BLEU 均为 0。后几幅存在不同程度的空间贴近或重合,软匹配给予部分得分。这里的 0.00 是显示精度下的值,不应与理论上指数核为正的性质混淆;点图本身也没有完整展示所有时间顺序。
与人类直觉一致,具体怎样测?
扩展版让标注者在两个“生成—参考轨迹对”之间选择:哪一边内部的两条轨迹更相似。注意不是比较左边一条和右边一条,而是比较两个配对各自的匹配程度。
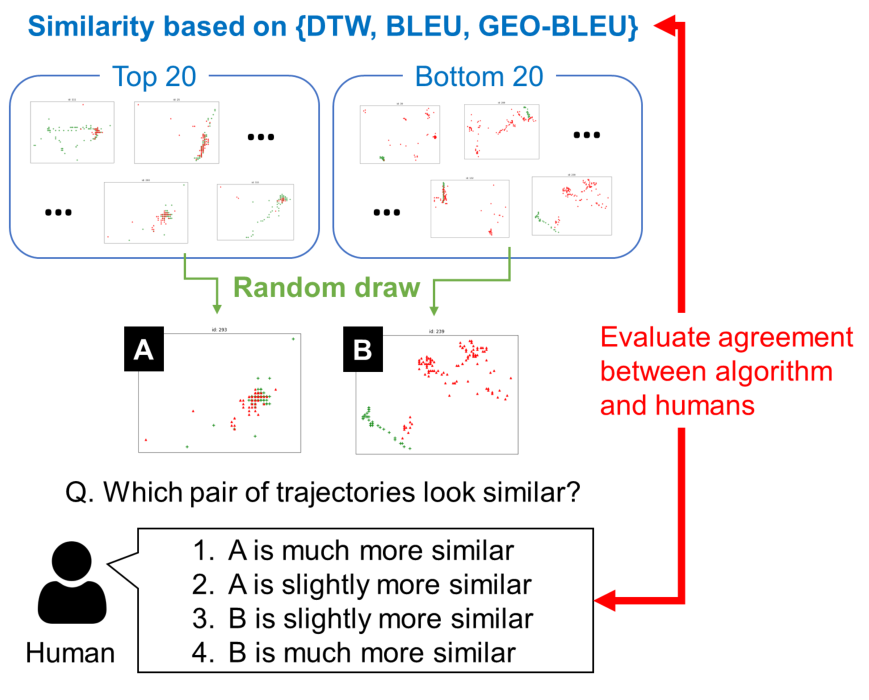
扩展版图 7|怎样把自动分数和人类判断放到同一道题里?无面板字母的流程图先按某指标对 500 对样本排序,取最相似 20 对与最不相似 20 对,构成比较题;A、B 是左右两道候选配对的标签。标注者有“左明显更相似、左略相似、右略相似、右明显更相似”四种选项,最后检查答案与指标排序是否一致。
每种指标有 20×20=400 种高低组合,每个组合由十名不同标注者判断。三个指标共获得 400×10×3=12,000 次判断,既不是 12,000 条独立轨迹,也不是论文报告了 12,000 名独立标注者。
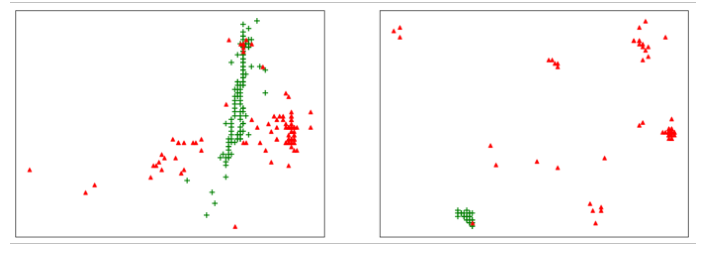
扩展版图 8|一题究竟让人看什么?原图左右两幅没有字母,每幅都包含红色生成点与绿色真实点。示例左侧来自指标最高的 20 对、右侧来自最低的 20 对;若人也觉得左侧内部更相似,就与指标判断一致。选择并没有“不确定”或“相同”的选项,且这里只检验排序两端,不是对全部 500 对进行任意两两评价。
评分不是简单答对记 1。与指标一致且认为差别明显记 +1,一致但仅略相似记 +0.5;与指标相反则分别记 −1 或 −0.5。其平均分范围为 −1 至 1。
| 指标 | 众包一致性加权平均分 |
|---|---|
| 归一化 DTW | 0.550 |
| BLEU | 0.530 |
| GEO-BLEU | 0.699 |
GEO-BLEU 在这个任务中的均分更高,与归一化 DTW 相差 0.149。它说明挑出的高、低相似样本,更容易获得与指标一致的视觉判断;它不是 69.9% 的地点预测准确率,也不等于对任意人类相似性定义都有优势。扩展版没有报告该差值的置信区间或标注者层面的显著性检验。
高一致性之外,人与算法也会分歧吗?
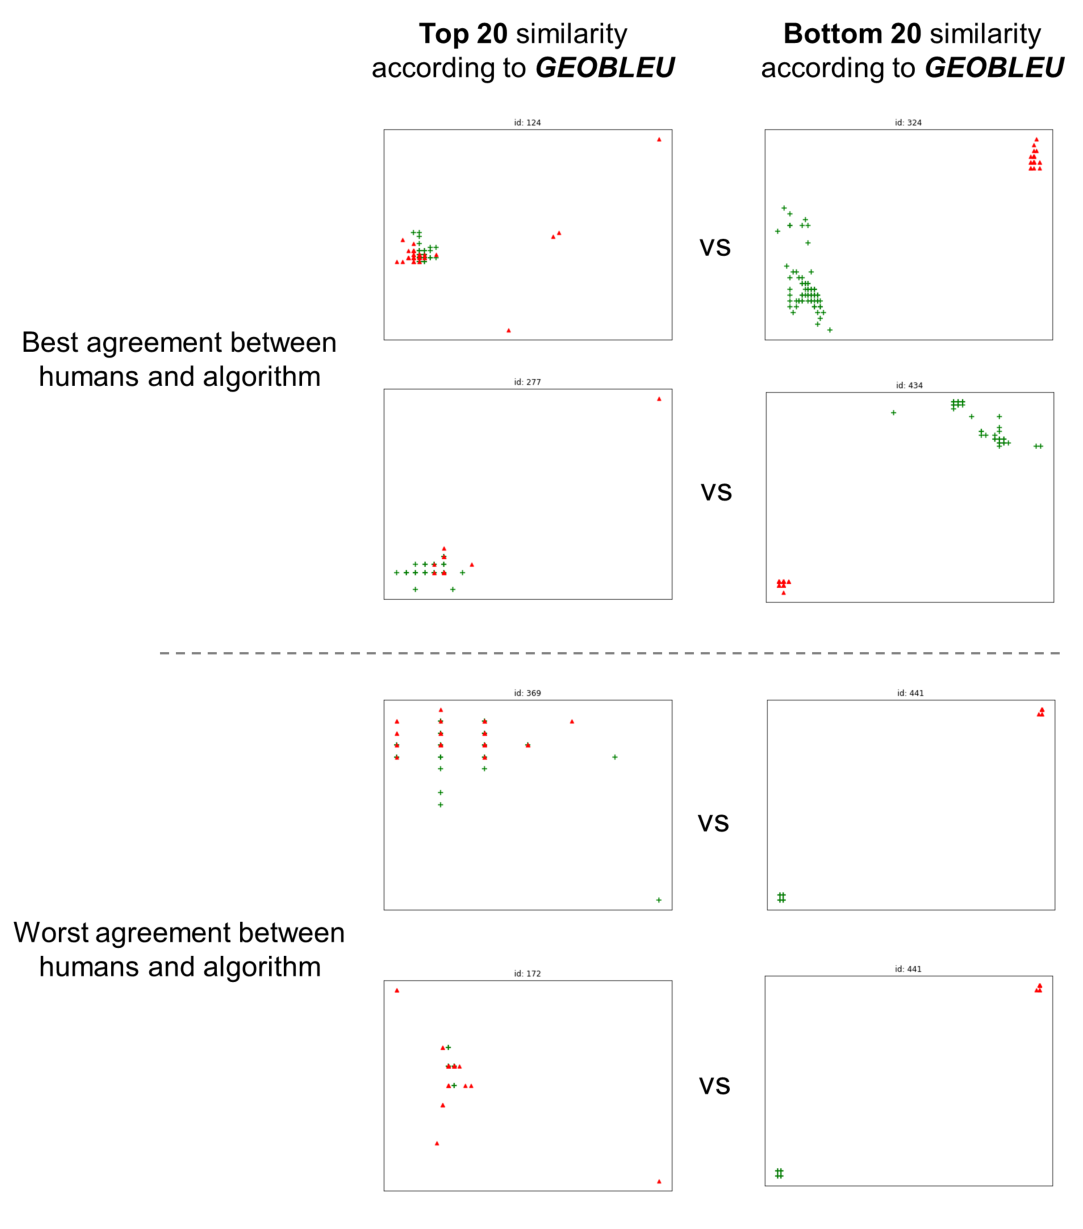
扩展版图 9|GEO-BLEU 的高分与低分,总能被人接受吗?这张完整组合图无面板字母,左列是按 GEO-BLEU 排名前 20 的轨迹对,右列是后 20;红色生成、绿色参考。上两行是人和指标高度一致的例子,下两行则是一致性最差的例子。它展示相同指标中既有容易判断的对照,也有视觉上容易引起分歧的情况,不能只凭上半部证明指标总是可靠。
作者猜测部分分歧是标注者误解了题意,但没有独立证据确认这一解释。也可能是人更重视整体覆盖、离群点或其他视觉特征,而算法更重视局部片段与计数;这些可能性需要额外研究。
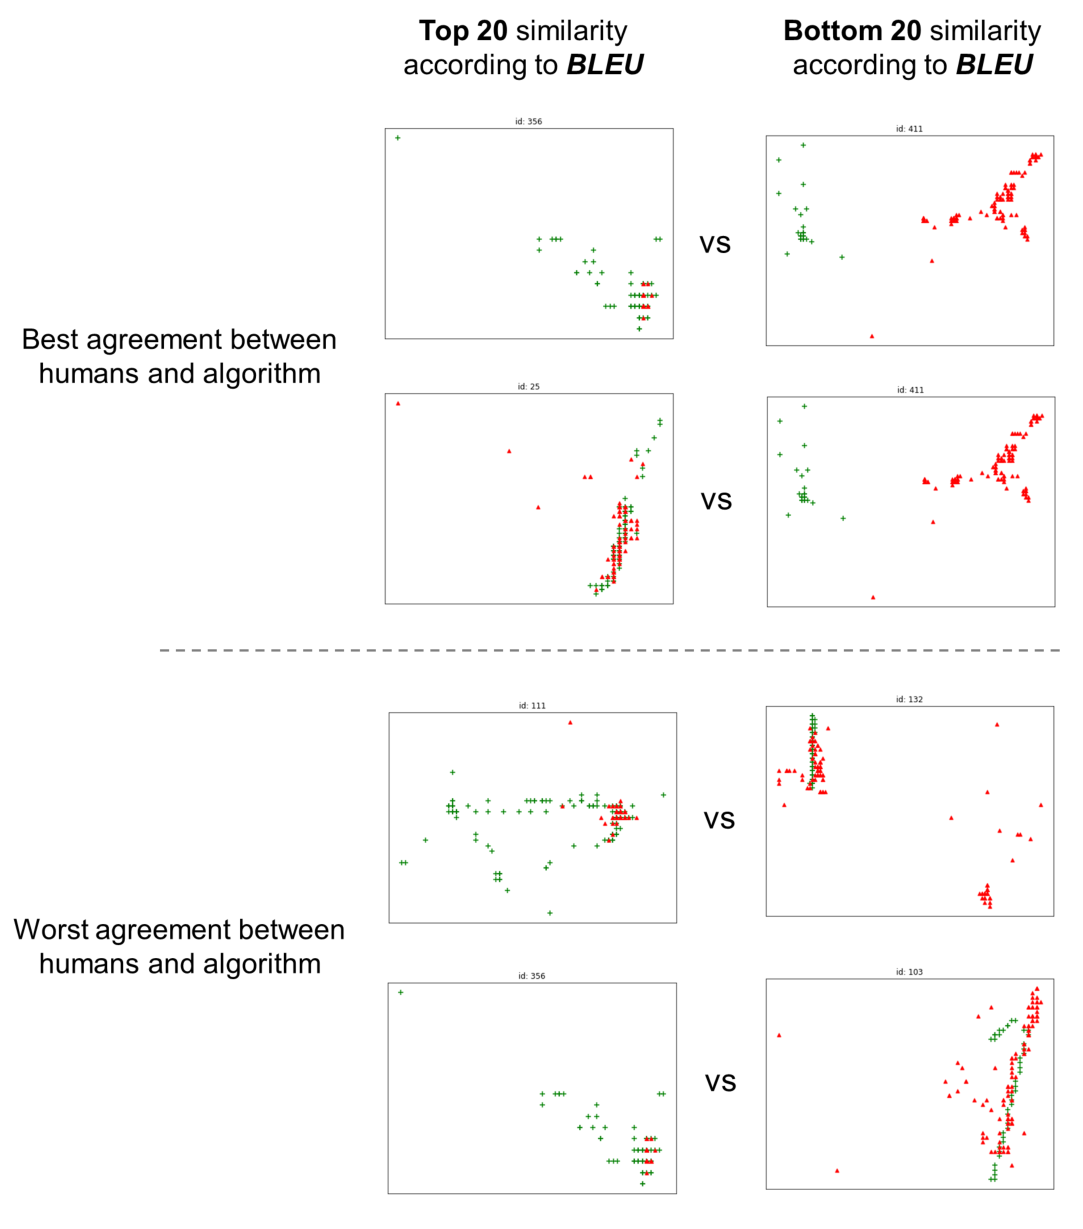
扩展版图 10|传统 BLEU 也会在哪些比较中失去直观对应?完整图同样没有字母,左列为 BLEU 前 20、右列为后 20;上两行高一致,下两行低一致,红绿含义不变。局部重合、范围和稀疏点云的区别,未必被精确 n-gram 匹配充分表达。它是案例说明,不是独立于表格之外的第二次大样本显著性检验。
一个指标,仍不能回答所有轨迹质量问题
GEO-BLEU 的优势来自明确选择:奖励空间接近的连续片段,对整体片段发生顺序较宽容。如果目标恰恰是准时到达、特定时间共处、路线安全或长程先后顺序,这种宽容可能掩盖重要误差。
它也没有直接使用道路连通、交通方式、停留目的或真实时间间隔。网格大小、坐标投影、β 与最高 n 都会改变结果;长序列中的两两片段配对还会增加计算成本,论文未报告大规模运行时间评估。
众包检验来自一套东京 GPS 数据、一种序列生成模型及高低分样本的比较,展示的是特定视觉任务下更高一致性,尚不等于所有城市、生成器、下游任务都已验证。论文讨论 LCSS、EDR 等其他轨迹比较方法,但并未把它们全部纳入这次定量实验。
因此,实际评估可以把 GEO-BLEU 与顺序敏感距离、逐时位置误差和任务相关统计一起看。不是为了凑更多分数,而是让每个指标对应一种明确、不能互相替代的质量要求。
一句话总结
GEO-BLEU 用空间软匹配的局部地点片段衡量轨迹相似性,在特定众包视觉任务中更接近人的判断,但它的高分并不保证全局顺序、时间安排或实际路线都正确。
核心来源
- Shimizu T, Tsubouchi K, Yabe T. GEO-BLEU: Similarity Measure for Geospatial Sequences. ACM SIGSPATIAL 2022,Article 17,4 页。DOI,MIT 正式版本存档。图 1–4 使用该版本的完整原图。
- 同名 扩展预印本 arXiv:2112.07144v2,2022 年 10 月 31 日修订,九页;真实数据、算法伪代码、众包表及扩展版图 5–10 来自这里。
- Papineni K et al. BLEU: A Method for Automatic Evaluation of Machine Translation. ACL 2002,311–318。DOI。
作者介绍
以下采用正式论文发表时的署名信息。
- Toru Shimizu:Yahoo Japan Corporation,Tokyo 署名作者、本文第一作者,参与地理空间序列相似性指标研究。
- Kota Tsubouchi:Yahoo Japan Corporation,Tokyo 署名作者、本文共同作者。
- Takahiro Yabe:正式论文署名 Massachusetts Institute of Technology 与 Purdue University,本文共同作者;扩展预印本首页仅列 MIT,因此不混写为现任机构。
延伸思考:先写下不能容忍的错误,再选相似度
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假设一个模型把一周的通勤片段都生成对了,却把周一上班换成周六、把上午就医换成深夜。若研究常见活动组合,它可能有用;若研究医院开放时段、同一时刻的人群暴露,就可能完全不合适。
选择评估指标前,可以先列几个应当受罚的反例:整体时间平移、地点只差一个网格、片段顺序交换、重复同一路线、遗漏罕见远行。看指标怎样响应这些改变,往往比只看排行榜上一列分数更能判断它是否适合自己的问题。
GEO-BLEU 的圆环示例尤其适合提醒我们:指标并不只是被动测量质量,它也在规定什么值得被模型保留。明确这个选择,才能避免训练出“分数很像生活,关键事情却发生在错误顺序里”的虚拟轨迹。