不只生成去过哪里,还要生成何时做了什么
论文名片|Yuan Yuan、Jingtao Ding、Huandong Wang、Depeng Jin、Yong Li,Activity Trajectory Generation via Modeling Spatiotemporal Dynamics,KDD 2022,4752—4762。DOI。
两条合成轨迹可以有相似的出行距离,却对应很不同的生活:一条在工作时间去了公司,另一条连续安排餐饮和娱乐。若要拿轨迹测试活动预测或接触网络,只像真实人那样移动还不够,时间、地点与活动类型也要配合。
ActSTD 用连续时间的隐状态描述活动之间的变化,再用对抗模仿学习生成事件。它在两类记录上改善了多项分布和下游任务,但分布相似、预测有用与真实疫情预测准确,是三个需要分别检验的层次。
先说结论
- 生成对象是带时间戳、活动类型与经纬度的活动事件序列,活动类别由地点类别代理;并非直接观测每个人真正进行了什么行为。
- 模型让隐状态在事件间连续演化、在事件发生时瞬时更新,再依次生成时间、类型和位置。这里的连续动力学是潜在表示,不是物理运动轨迹。
- 相比多种基线,ActSTD 在运营商数据五项分布指标中三项最好,Foursquare 中四项最好;部分预测步长与训练方式仍有其他方法更优。
- 合成数据能帮助小样本活动预测,并使某个固定 SEIR 实验更接近真实活动数据驱动的模拟。报告的疫情误差下降超过 50%,参照是另一种模拟,并非观测病例曲线。
两套数据,记录了什么样的活动?
第一套来自中国某大型移动运营商,覆盖北京 10,000 名用户一个月;第二套为 Foursquare 签到,覆盖 1,000 名用户一个月。每个事件含匿名用户、时间、地点类型与坐标。运营商筛除少于 50 次活动者,Foursquare 筛除少于 30 次签到者,筛选后的平均序列长度分别约为 82.92、58.56。
正文列出公司、餐饮、教育、购物等地点类型;附录 Table 4 报告两套类别数为 13 与 9,而正文列举及公开实现的类别表并不完全一致,当前公开实现的运营商映射为 14 类。因而跨实现复现时需要保留具体分类版本,不能把文中所有标签清单当作同一个已经统一的标准。
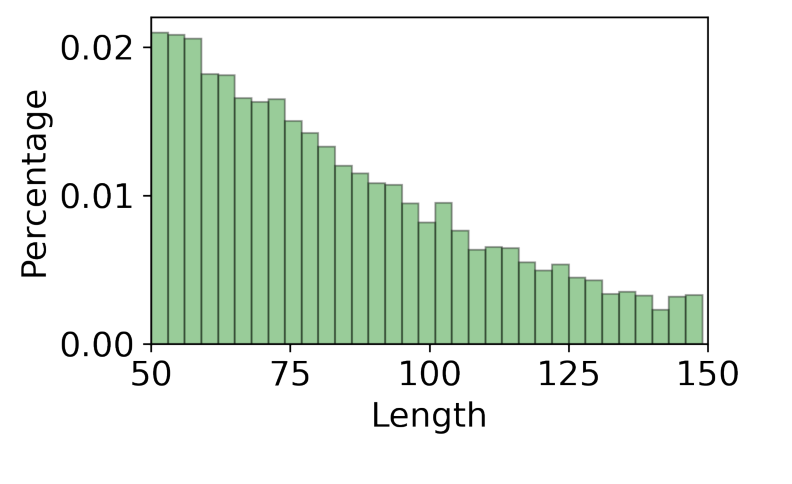
图 8|运营商用户留下了多少活动记录?单面板横轴为每人序列中的活动数,纵轴为该长度所占比例,图从筛选门槛 50 次开始,多数用户记录较少、长序列较少见。长度是事件条数,不是公里或观测天数。来源:原论文 Fig. 8。
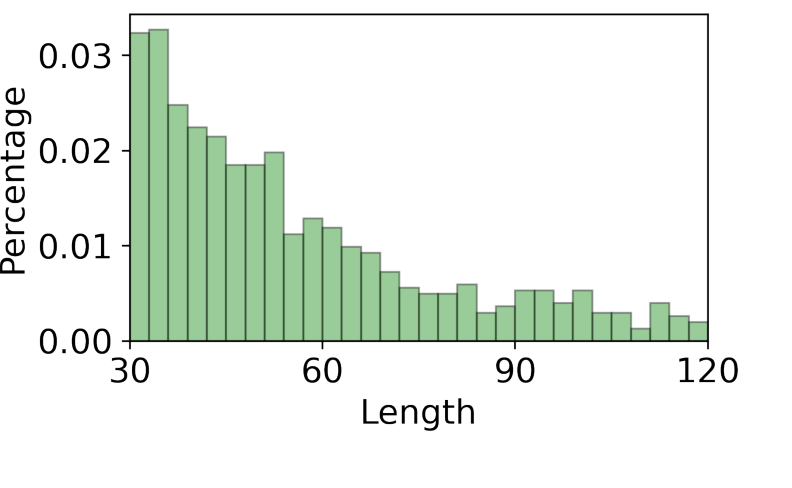
图 9|签到数据是否同样充足?横轴为每人事件条数,纵轴为比例,最低约 30 条,较长序列逐渐减少。签到次数与真实活动总次数不是一回事,记录稀疏也会改变相邻事件间隔。来源:原论文 Fig. 9。
官方代码按序列列表的前 60%、中间 20%、后 20% 划分训练、验证和测试,并用训练数据估计空间标准化参数。这个划分本身没有说明列表按日期前推,不能据此直接称为严格的未来日期外推验证;论文也没有在正文完整交代不同预测实验的位置匹配分辨率。
为什么不能给所有活动用同一个等待时间和空间范围?
同一个人上班、吃饭和旅行的重复节奏不同。固定时间格或统一等待时间分布,容易把不同活动的规律混在一起。
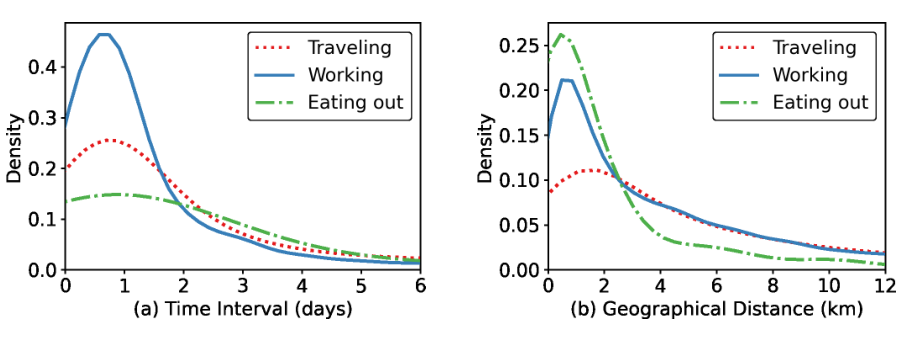
图 1|活动之间有哪些必须保留的差异?(a)同类活动再次出现的间隔,横轴天数、纵轴密度,工作蓝线较集中,外出就餐绿线更分散;(b)活动地点距家的距离分布,横轴千米,旅行红点线保留较长距离,餐饮绿线更集中在近处。时间间隔是重复同类活动的间隔,不是工作或吃饭持续了几天。来源:原论文 Fig. 1。
ActSTD 把事件视为带标记的时空点过程。给定历史,条件强度刻画某类事件在某时某地出现的倾向;事件间的不规则时间可以保留,而不必先压到统一小时格。
潜在状态怎样连续变化,又怎样被新活动打断?
模型以隐状态总结既有活动历史。两次活动之间,它按学习到的微分方程连续演化;新活动发生时,再用门控循环单元 GRU 瞬时更新。这样,离上次工作过去十分钟与过去五小时,可以对应不同状态,而非仅仅因为都还没出现新事件就保持不变。
空间部分通过连续归一化流 CNF 描述位置概率密度,在事件间连续改变,并用离散流响应新事件。时间与空间共享隐状态,将既有活动对后续时空分布的影响联系起来。概率密度的演化不代表人的身体按某条微分方程在道路上移动。
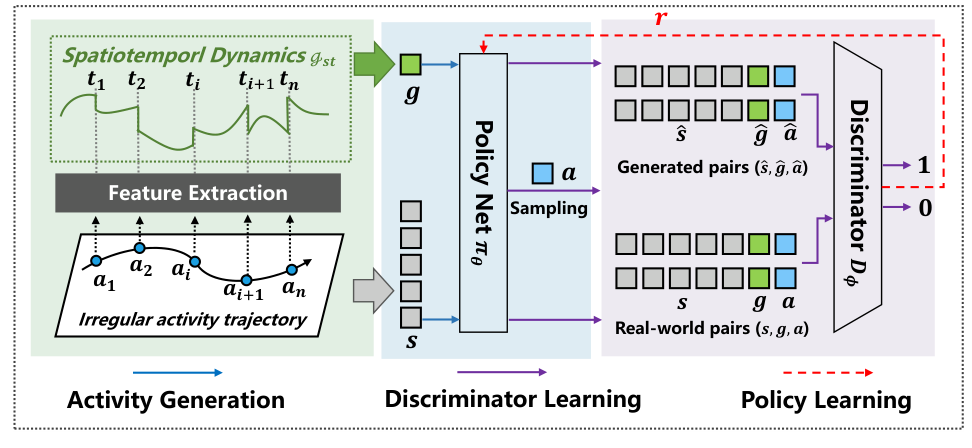
图 2|动力学、行动策略和判别器如何协作?左侧由不规则活动序列提取历史状态 s 与动态表示 g;中间策略网络根据二者抽样新行动 a;右侧判别器比较真实与生成的状态—动态—行动三元组。蓝箭头为活动生成,紫色为判别器学习,红虚线为奖励反馈。图中 1/0 是判别标签,不是某次生成被证明真实。来源:原论文 Fig. 2。
生成对抗模仿学习 GAIL 让判别器识别合成与真实样本,并用反馈训练生成策略。这里学到的是能模仿观测行为的奖励信号,不是研究已经发现了人类真实效用函数,也不必然识别个人为什么做某项活动。
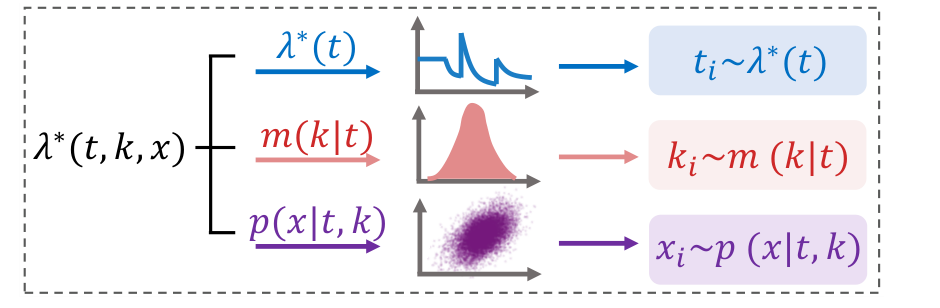
图 3|一次活动怎样被具体生成?上方蓝色分支决定事件时间,中间红色分支决定给定时间的活动类型,下方紫色分支决定给定时间与类型的位置。三部分相乘组成联合条件强度;所有分布都依赖历史表示,不能把它们理解为互不相关的三次随机抽签。来源:原论文 Fig. 3。
训练也采用两类目标:真实活动上的最大似然 MLE,帮助学习事件过程;对抗奖励与近端策略优化 PPO,帮助生成更像观测的序列。附录 Algorithm 1 交替更新动力学、策略与判别器;另比较先预训练再冻结动力学,以及把动力学与策略一起用 PPO 优化的做法。
哪些统计真的更接近,哪些没有?
Table 1 用 Jensen–Shannon 散度 JSD 比较真实与生成分布,越小越接近。五项分别是相邻活动移动距离 Distance、活动回转半径 Radius、相邻事件间隔 Interval、每天活动次数 DailyAct,以及整体活动类型频率 ActType。它们分别约束空间、时间和语义,不能用单一指标代替。
| 数据与指标 | ActSTD | 对照中的较好结果 | 说明 |
|---|---|---|---|
| 运营商 Distance | 0.071 | TimeGeo 0.056 | 本方法不是距离分布最优 |
| 运营商 Radius | 0.142 | TimeGeo 0.203 | 活动范围更接近 |
| 运营商 Interval | 0.0077 | Neural STPP 0.009 | 事件间隔有所改善 |
| 运营商 DailyAct | 0.0084 | Neural STPP 0.051 | 相对散度约下降 83.5% |
| 运营商 ActType | 0.004 | SeqGAN 0.003 | 类型频率由 SeqGAN 更优 |
| Foursquare Interval | 0.054 | Neural STPP 0.034 | 稀疏签到间隔仍有短板 |
| Foursquare Radius | 0.138 | SMM 0.244 | 活动范围差异明显减小 |
其余 Foursquare 指标中,ActSTD 的距离、每天活动数、活动类型 JSD 分别为 0.082、0.093、0.0063,也均为表中最好。两套数据上的优势分布不同,说明模型面对的不只是同一个任务换了样本量。
对照包括半马尔可夫模型 SMM、TimeGeo、LSTM、SeqGAN、TrajGAIL、MoveSim 与 Neural STPP;附录 B 说明其适配。不同模型原本侧重的目标并不相同,比较适用于本文的活动事件生成设置,不能将结果扩展成所有移动任务的模型排名。
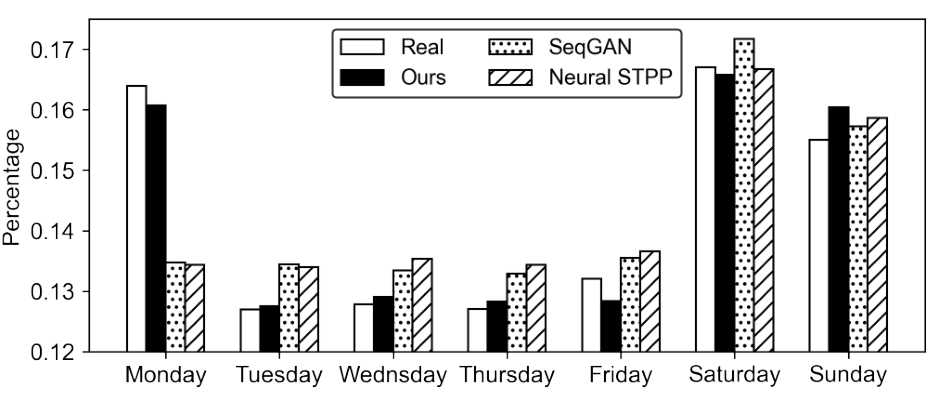
图 4|总体日程是否保留了每周节律?横轴为周一至周日,纵轴为事件份额;空白柱为真实、黑柱为 ActSTD、点纹为 SeqGAN、斜纹为 Neural STPP。ActSTD 较好接近多天的真实份额,但周日等仍有偏差。纵轴从约 0.12 起,柱高差异不能读成从零开始的巨大倍数变化。来源:原论文 Fig. 4。
Table 2 的训练比较进一步显示,混合训练在多数指标上更好,但 Foursquare 的回转半径 JSD 为 0.138,高于联合训练的 0.121 和预训练的 0.126。它体现多目标之间的取舍,不能概括为混合训练在十项比较全部第一。
附录实施说明使用小批量训练、学习率搜索与多轮交替更新,作者报告单 GPU 约十小时内可训练。该时间依赖文中实现和设备条件,不是任意数据量的固定运行预算。
生成总体像了,能接着个人历史往后预测吗?
个人层面给模型过去 10 次活动,再预测未来 1、2、5、10 步,分别评分活动类型和位置。这个任务检查条件生成能否接住一段历史,区别于从头产生整个人群的无条件统计。
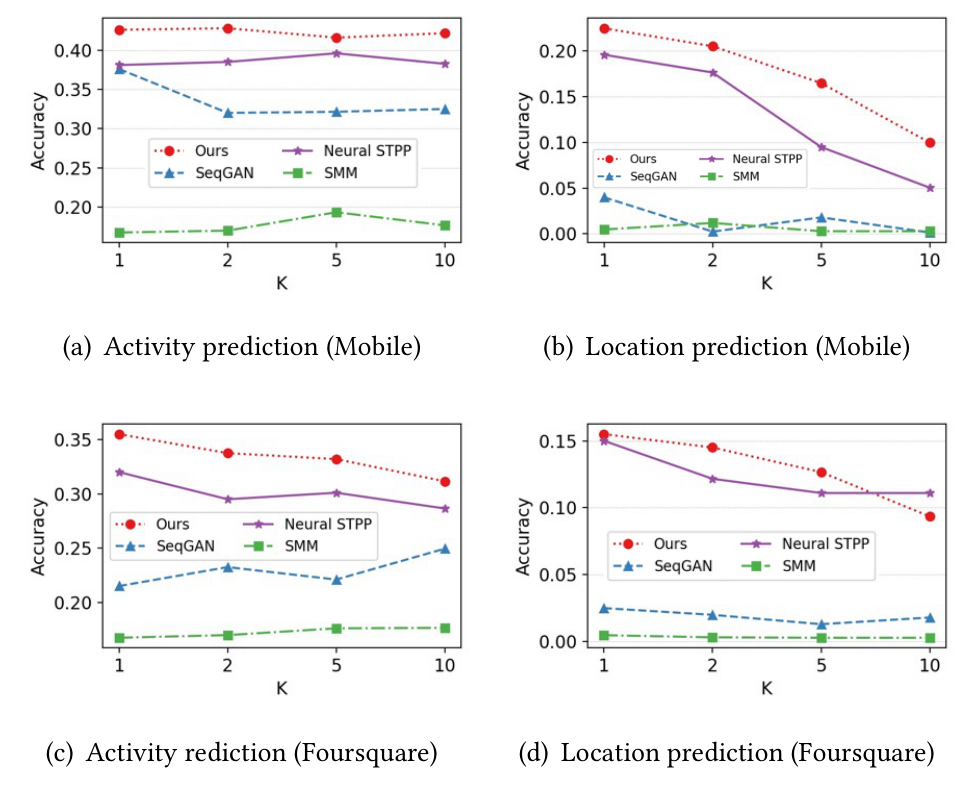
图 5|预测得越远,哪些能力先下降?(a)运营商活动类型;(b)运营商位置;(c)Foursquare 活动类型;(d)Foursquare 位置。横轴为未来步数 K,纵轴为 Accuracy;红点线为 ActSTD、紫星为 Neural STPP、蓝三角为 SeqGAN、绿方为 SMM。多数设置红线较高,但(d)10 步时紫线高于红线,不能照搬正文概括称所有预测都最优。各面板纵轴范围不同。来源:原论文 Fig. 5。
类型预测较稳定,位置预测通常随步数增加明显下降。Accuracy 是本文对目标值匹配的评分,不是坐标误差多少米;若要把位置结果用于具体服务,还需明确地点离散化或空间匹配容差。连续位置生成本身不能提供这个解释。
合成数据能帮小样本,是否也能替代真实数据?
另一个实验用带注意力机制的 LSTM 作为下游预测器。真实训练序列取 100、200、500、1,000 条,每种设置都额外加入 1,000 条生成序列,并在同一个测试集上评分,比较仅真实、加入 ActSTD、加入 Neural STPP 与加入 SeqGAN。
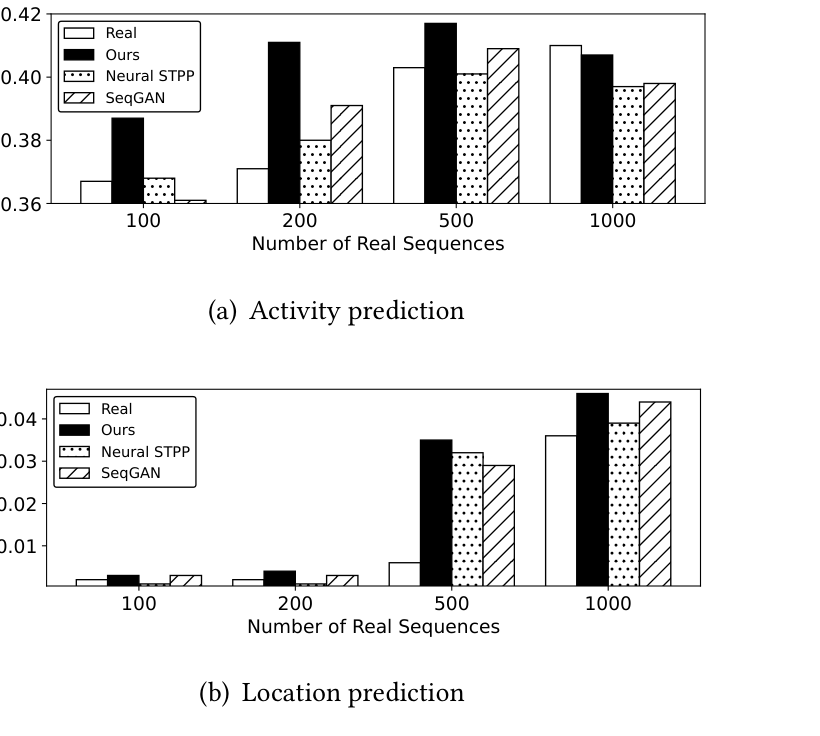
图 6|合成数据在什么样本量下有帮助?(a)活动类型预测;(b)位置预测。横轴为真实训练序列数,各组生成序列固定增加 1,000 条;空白柱仅真实、黑柱 ActSTD、点纹 Neural STPP、斜纹 SeqGAN。小样本类型预测收益较明显,但(a)1,000 条真实数据时黑柱略低于空白柱,说明增强并非总有益;(b)整体数值也较低,不能把类型收益当成位置收益。来源:原论文 Fig. 6。
在图示类型任务中,200 条真实序列加 ActSTD 生成数据,可以达到略高于 1,000 条真实序列单独训练的成绩。这个例子说明特定任务的数据增强价值,不等于合成样本与真实样本有固定的五倍兑换率;增加样本也不能自动补足代表性和标签偏差。
疫情模拟误差减少一半,参照究竟是什么?
最后实验用运营商活动建立接触网络:两个人出现在同一位置并采取同类活动,就形成联系,再在固定 SEIR 规则中模拟易感 S、暴露 E、感染 I 与移出 R 的变化。地点和活动的相同关系是模型构建的接触代理,并非实际面对面接触测量。
Table 3 使用固定参数:密切接触比例 0.2,传播期 5.8 天、潜伏期 5.2 天、感染期 11 天,基本再生数设为 2.2,再由这些量计算状态转移率。每次随机初始化 50 名暴露者,每个实验重复十次。它们定义了这个特定模拟环境,不是从本文两套轨迹中独立估计出的疾病参数。
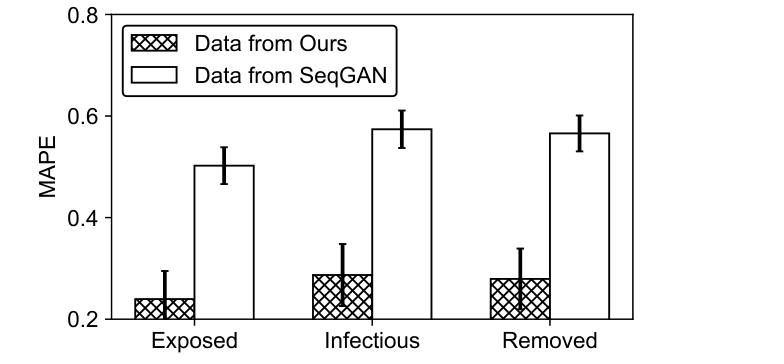
图 7|合成数据能否复现同一模拟器对真实活动的输出?横轴分别是暴露、感染、移出人数,纵轴为跨模拟期平均的 MAPE;网纹柱为 ActSTD,空白柱为 SeqGAN,保留原误差线。三项中 ActSTD 的柱较低,论文报告相对 SeqGAN 下降超过 50%。参照曲线是用真实活动记录驱动同一 SEIR 模型得到的结果,不是实际确诊、住院或死亡记录。来源:原论文 Fig. 7。
这个实验检验的是合成活动对一个下游接触与传播模型的保真度。它没有证明真实城市疫情预测误差降低一半,也没有验证改变政策后的因果效果。个体间相互影响仍被作者列为后续方向,因此独立生成的轨迹能否保留真实协同行为,需要另行检验。
生成数据还不自动等于隐私保护。本文的目标包含降低直接共享真实活动记录的需求,但没有展示正式差分隐私保证或完整的成员推断、轨迹重识别测试。保真度、实用性与隐私需要分别评估,不能由前两项推导第三项。
一句话总结
连续时空状态与对抗模仿学习,使活动类型、时间和位置更协调,并带来特定任务的数据增强收益,但生成质量、未来预测、疫情实证与隐私保证仍是不同的证据问题。
核心来源
Yuan Yuan, Jingtao Ding, Huandong Wang, Depeng Jin, Yong Li. Activity Trajectory Generation via Modeling Spatiotemporal Dynamics. KDD 2022, 4752–4762。DOI,官方实现。本文依据论文全文、文内附录 A—D,并核对官方 README、数据加载与评价实现。Fig. 1—9 均保留完整原图;各表、算法与版本差异在相应段落说明。
作者介绍
- Yuan Yuan:论文署名为清华大学电子工程系。
- Jingtao Ding:论文署名为清华大学电子工程系,列为通讯作者。
- Huandong Wang:论文署名为清华大学电子工程系。
- Depeng Jin:论文署名为清华大学电子工程系。
- Yong Li:论文署名为清华大学电子工程系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
可以用同一批合成轨迹同时测试不同接触定义:同一地点即联系、同地点同活动才联系、进一步要求时间重叠才联系。如果误差优势随定义明显变化,说明下游收益不仅取决于生成器,还取决于怎样从活动构造人与人的相遇。
数据增强也可以按稀有活动、远距离出行和低频用户分组评估。整体分类改善,可能只来自更好复制常见模式;若少数群体表现下降,继续增加合成数量反而可能放大原样本偏差。更有用的目标是明确哪些模式被补足、哪些被反复复制。