两次电话之间,能不能推断一个人走了哪条路?
论文名片|Zhihan Fang、Guang Wang、Desheng Zhang,Modeling Fine-Grained Human Mobility on Cellular Networks,Companion Proceedings of the Web Conference 2020,35–37,会议日期 2020 年 4 月 20–24 日,Taipei。这是一篇会议海报短文。DOI,作者论文目录。
一个人在两个地方各打了一次电话,中间相隔半小时。你知道起点、终点和总时间,却不知道走了哪条路,更不知道何时经过每个路段。即使有城市地图,可选路径也不止一条。
FineCell 的想法是把路线与旅行时间一起推断:哪条路线更像真的,取决于每段要花多久;每段多久,又可以借助许多稀疏行程共同估计。两者交替更新,再拼出更细的移动轨迹。
主要发现可以概括为三点:
- 系统把基站与道路组织成移动图,利用稀疏观测之间的总时间约束候选路线。
- 路线选择与边旅行时间作为两个隐藏因素,用期望最大化思路相互更新,最后组合成带时间的位置序列。
- 合肥信令数据上的评估报告,相比 WHERE,地点间人口流量的 MAPE 降低 9.8%;公开结果尚不能等同于逐人路线定位准确率提高 9.8%。
为什么只看通话记录不够?
通话详单(Call Detail Records,CDR)只在用户发生相关通信时记录位置。手机普及、数据覆盖广,不等于每个人的轨迹都连续:两次通信中间可能有很大的时空缺口。
另一类更丰富的信令还包括数据连接、路径切换、LTE 接入和断开等事件。本文用稀疏 CDR 建模,把同一网络的全量信令作为评估参考。这样不必为每个人额外部署 GPS,也能比较稀疏输入与高频记录的差别;但参考位置仍来自网络基站,并非独立 GPS 真值。
论文报告,合作网络位于中国合肥,包含 23,704 个基站,为 337 万用户提供服务,每天生成约 20GB 记录。每条记录有时间戳、用户编号、基站位置与服务类型。337 万是该网络服务用户规模,不是文中明确披露的独立测试人数;短文没有给出实际评估天数、筛选后人数与训练测试划分。
怎样把基站观测放到道路上?
FineCell 首先构造移动图:节点是基站,边根据道路拓扑推断。通过地图匹配,把基站关联到邻近道路;若相邻基站映射到同一道路且在路网中相连,就建立图边。
这一步让候选移动受道路结构限制,避免把两次基站记录之间简单画一条直线。图中的节点仍是基站代理位置,并不是每一个路口都被直接观测;地图匹配的结果也依赖基站覆盖、道路密度和算法。
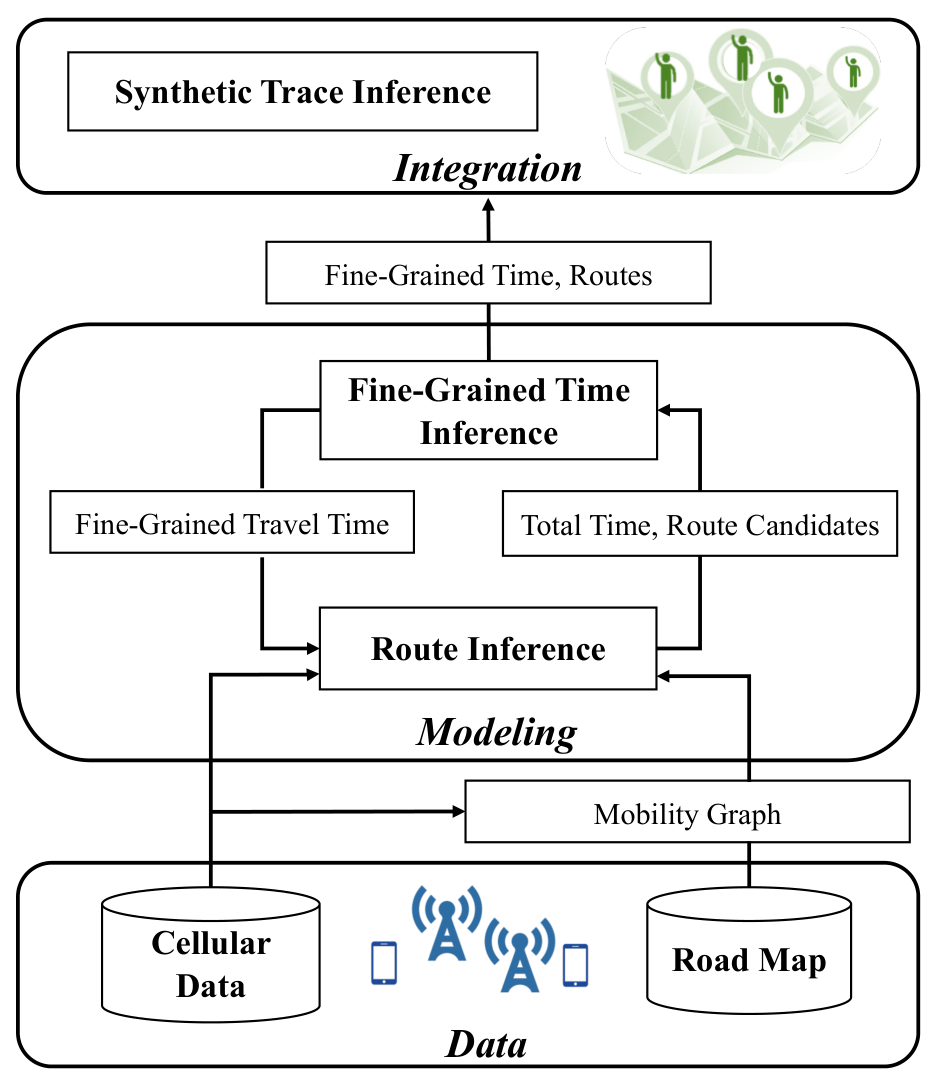
图 1|数据、路线和时间怎样相互连接?这张无子图字母的架构图从下往上读。数据层将 Cellular Data 与 Road Map 组织成 Mobility Graph;建模层中 Route Inference 与 Fine-Grained Time Inference 互相传递候选路线、总时间和细粒度旅行时间;集成层将路线与时间组合成 Synthetic Trace Inference。它是一条推断流程,不表示中间所有位置都已经被信令直接测到。
路线未知,路段时间也未知,怎样避免互相卡住?
在两个稀疏观测之间,系统先用深度优先或广度优先等搜索方式枚举路线,再以速度等现实约束裁剪不合理候选。
举个帮助理解的例子:同一个起终点有短而慢的路线甲、长而快的路线乙。只看路长,可能偏向甲;若观测总时间很短,乙反而更合理。而要判断“慢”还是“快”,又需要估计各图边的旅行时间。
论文把用户路线与边旅行时间设为两个潜在因素,将两个已知位置之间的总旅行时间视为观测量,采用期望最大化(Expectation–Maximization,EM)算法迭代。按文中的描述,一步依据候选路线更新时间估计,另一步利用更新后的边时间裁剪路线候选。
这是联合估计的基本逻辑。短文没有展开概率分布、完整似然函数、初始化、停止条件或全部参数,因此这里不能补写成某一种已确定的高斯噪声模型,也不能宣称每次迭代都得到真实路线。
路径与时间估计后,系统再判断用户处于移动还是停留。移动时,某一时刻的位置由估计路径与边旅行时间决定,生成更密的位置序列。论文未给出移动/停留判定阈值和最终统一输出间隔,不能把“细粒度”自行具体化为每秒定位或固定米级精度。
实验真正评价的是哪一种误差?
FineCell 与 WHERE 模型比较,输入使用 CDR,参考使用全量信令。评价指标是平均绝对百分比误差(Mean Absolute Percentage Error,MAPE):对每个比较单元,将预测人口流量与参考流量之差的绝对值,除以参考流量,再求平均并乘 100%。
这里的 y 是从一个地点移动到另一个地点的人口数量。换句话说,公开实验主要验证聚合流量与参考流量是否接近,并未直接报告每个人的路径匹配率、逐点距离误差,或边旅行时间的真实误差。
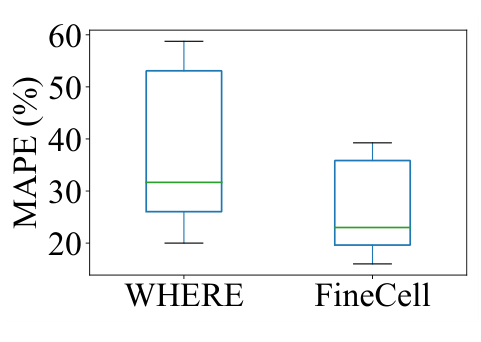
图 2|相同任务下,流量误差降低了吗?无子图字母的箱线图,横轴 WHERE 与 FineCell,纵轴 MAPE%,越低越好。FineCell 的箱体和中位线整体更低,分布也较集中;绿色横线位于箱体内部。原文未说明箱线各分位、须线定义与样本量,不能自行把它们标成置信区间。作者报告 FineCell 达到 9.8% lower MAPE。
这个 9.8% 是作者给出的误差改善表述;短文没有完整说明相对降低与百分点差的汇总计算口径。因此不宜改写为“准确率提高 9.8 个百分点”,更不能写成 90.2% 的个体轨迹正确率。
也要区分相对基线改善和绝对误差。图中 FineCell 的 MAPE 仍有明显幅度,说明任务并没有被完全解决。MAPE 对低参考流量比较敏感,参考流量为零时还需特别处理;论文未交代零流量单元的纳入方式,这会影响复现与跨研究对比。
什么时候比较容易补,什么时候更难?
一天中的流量与行为规律不同。如果上下班活动较稳定,候选路线可能更容易排除;夜间或非典型出行则可能更难。
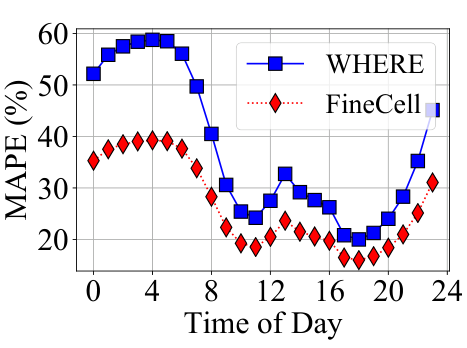
图 3|误差是否一天到晚都一样?无子图字母的折线图,横轴为一天内小时,纵轴 MAPE%。蓝色方块是 WHERE,红色菱形是 FineCell。FineCell 在图示各时段总体更低;凌晨误差较高,上午通勤后与傍晚附近较低。论文将高峰期较好表现解释为家与工作地之间移动较规律,但没有提供单独的因果检验或不确定性区间。
这些结果支持在该数据与流量口径下,联合利用道路路线和旅行时间的信息有帮助。它们不证明所有人、所有道路、所有小时都同样受益,也不能从日内均值推断非典型个体的恢复质量。
这篇短文的贡献与边界在哪里?
FineCell 提供了一个明确的联合推断方向:空间候选不能脱离时间约束,时间估计也不应脱离可能的路线。基站图、路线枚举、旅行时间估计与最终轨迹生成,被放进了一个连贯系统。
但它是一篇三页海报短文,公开实验只给一个城市、一个基线及流量 MAPE。缺少逐人路线误差、旅行时间误差、各组件消融、候选搜索复杂度与完整复现实验配置,因此证据更适合支持系统可行性与初步效果,尚不足以评价所有“细粒度轨迹”的细节。
同一网络的全量信令比 CDR 更丰富,也仍有定位误差、覆盖变化与事件采样偏差。模型生成的中间点应被视为推断结果,而不是新的直接观测。在交通或城市应用中,最好按实际目标追加验证:估计地点间流量、还原个人路线、预测路段时间,分别需要不同的真值与指标。
一句话总结
FineCell 用路线与边旅行时间的联合推断填补稀疏基站观测之间的空白,并改善了合肥数据上的聚合流量误差;个体路线精度仍需更直接的验证。
核心来源
- Fang Z, Wang G, Zhang D. Modeling Fine-Grained Human Mobility on Cellular Networks. WWW ’20 Companion, 35–37 (2020).DOI。图 1–3 与本文介绍的方法、数据、误差结果均来自该文。
- Desheng Zhang 的 Rutgers 作者论文目录,将本文列入 Conference Posters,核对短文类别。
- Isaacman S et al. Human Mobility Modeling at Metropolitan Scales. MobiSys 2012, 239–252,本文 WHERE 基线来源,见原文参考文献 2。
全部配图保留原论文 Fig. 1–3 的完整内容。原论文以 CC BY 4.0 许可发布。
作者介绍
以下采用原论文发表时署名身份,不推断各人的独立贡献。
- Zhihan Fang:本文第一作者,署名机构为 Rutgers University,Piscataway,参与这项蜂窝网络细粒度移动建模研究。
- Guang Wang:本文共同作者,署名机构为 Rutgers University,Piscataway。
- Desheng Zhang:本文共同作者,署名机构为 Rutgers University,Piscataway;其作者论文目录提供本文海报类别信息。
延伸思考:一个“恢复成功”的模型,可能只是流量对了
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假设两个算法都正确估计一百个人从甲地到乙地,但一个把所有人安排到同一条路,另一个正确区分了两条平行道路。城市对流量指标可能相同,路段拥堵与个人暴露过程却不同。
这提醒我们,评价重建系统应先说清用途。若目标是片区间需求,流量误差很重要;若目标是某条路的人流或某个人的路线,就需要更细真值。用一张分层成绩单区分群体、路线、路段时间和逐点位置,会比一个笼统的“轨迹准确率”更有助于实际选择。
还有一个可测试的问题:日常通勤是否带来了大部分改善,而非典型出行被平均值掩盖?按规律性、时段与原始缺失程度分组评估,可以帮助判断系统在哪些人群上值得信任,哪些场景仍应保留更大的不确定性。
