一天只有一两条定位,怎样估计没有被记录的出行?
论文名片|Yuan Liao、Kristoffer Ek、Eric Wennerberg、Sonia Yeh、Jorge Gil,A Mobility Model for Synthetic Travel Demand From Sparse Traces,IEEE Open Journal of Intelligent Transportation Systems,2022,3:665—678;2022年9月27日发表。DOI:10.1109/OJITS.2022.3209907,机构公开全文。
一个人早晨发一条带位置的推文,晚上再发一条,两点之间可能经过办公室、餐馆、超市,也可能一直待在同一区域。直接把两个记录连起来,既会遗漏实际访问,也可能把一天的复杂行程误当成一次跳跃。
这篇论文不试图恢复那个人真实经历的每一分钟,而是利用许多人的长期稀疏记录,生成一批在总体流量与距离分布上更合理的合成访问。它扩展探索与优先返回机制,在瑞典、荷兰和巴西圣保罗检验。结论有进展,也有明确例外:距离分布改善,不保证OD矩阵的每项指标都改善。
先说结论
- 模型将已知地点的访问排序、距离阻抗与新地点探索结合,再用官方出行调查校准。它仍依赖调查信息,不是完全摆脱传统数据。
- 按时间把稀疏记录分成校准与验证两半后,三个地区的合成距离分布均比“相邻记录间隔小于24小时就连线”的基线更接近调查。
- OD矩阵改善并不普遍:瑞典的Kendall相关从基线0.24降至0.19,SSI同为0.31;荷兰和圣保罗两项均提高。
- 多数跨地区参数转用保持了收益,但瑞典参数用于荷兰是失败例。结果支持有条件的可迁移性,不能解释为任意地区无需校准。
输入究竟有多稀疏?
研究先从2015年12月20日至2016年6月20日的Gnip带位置推文中找到较活跃的地理标记用户,再采集他们的历史记录。最终输入覆盖2010—2019年,但并非每个人连续记录九年。
预处理排除只在一个地点发帖的疑似机器人、使用地点中心而非精确坐标的推文、记录不足20条的用户,以及明显搬入研究区之前的记录;再用约100米阈值聚类位置。家按工作日夜间及周末最常出现的区域推定,属于操作性识别,不是核实过的住宅地址。
| 表5汇总地区 | 用户数 | 定位记录数 | 覆盖天数中位数 | 每用户每天定位数中位数 |
|---|---|---|---|---|
| 圣保罗 | 10,943 | 3,513,796 | 96 | 1.5 |
| 荷兰 | 5,375 | 1,479,674 | 100 | 1.4 |
| 瑞典 | 3,961 | 1,248,158 | 111 | 1.4 |
这些是预处理数据汇总,不能直接当作各校准、验证样本实际进入模型的人数。后面还限定工作日和可用记录。每天只报告一两次位置,也不表示每天只去过一两个地方;发帖本来就可能更偏向特别活动,而非按实际访问频次记录家与工作地。
模型怎样在“回熟悉地点”和“去新地方”之间选择?
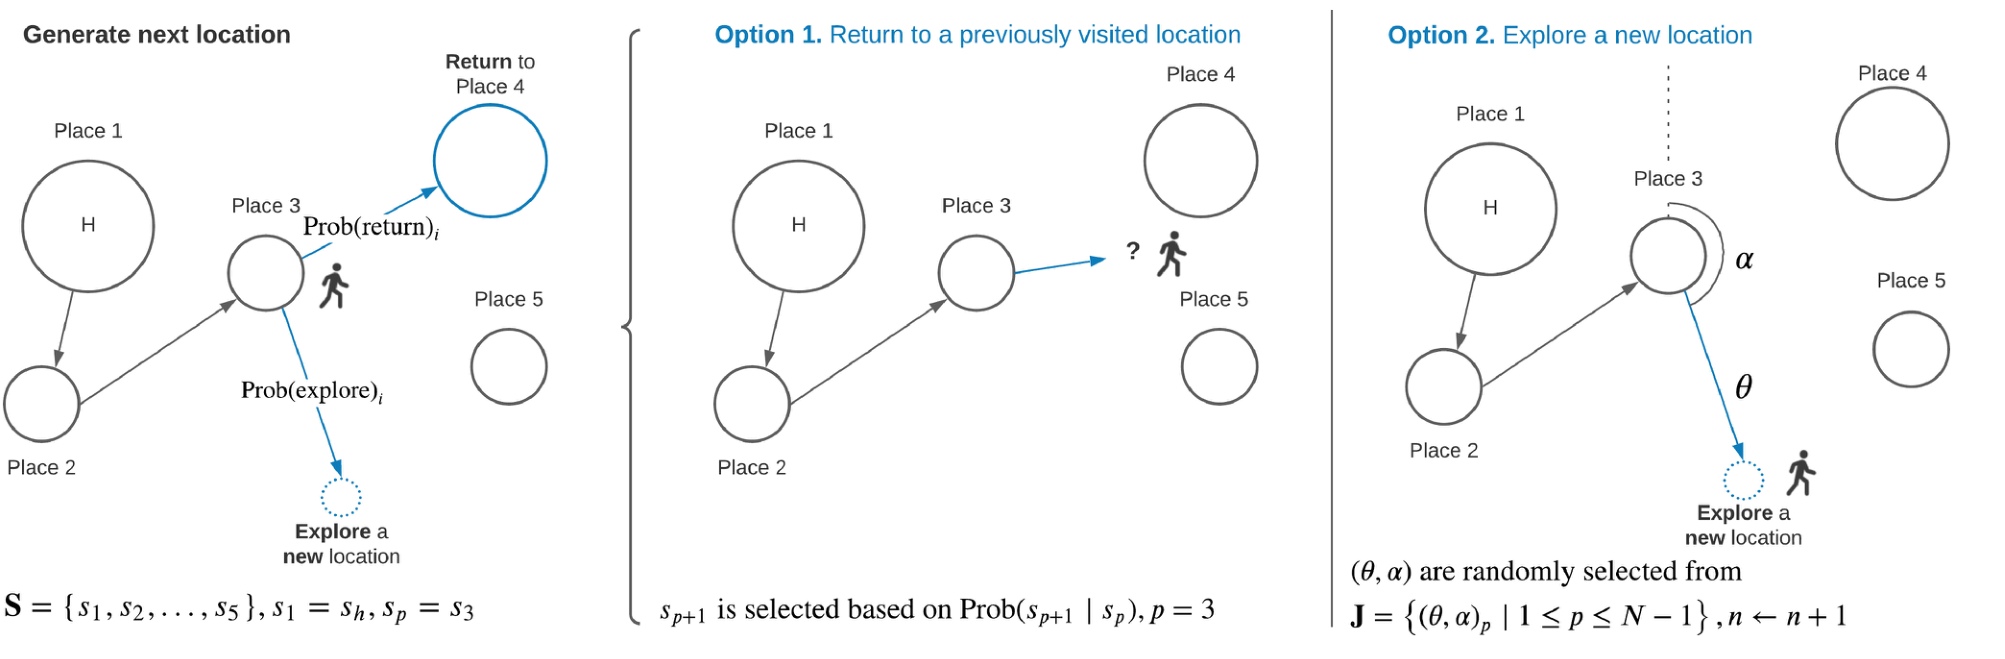
图 1|从当前位置出发,合成下一次访问需要哪些信息?
左侧展示有五个已观测地点的个体,目前位于地点3;中间Option 1表示返回旧地点,右侧Option 2表示根据距离θ和方向α生成新地点。原图没有a、b字母,全部选项保留在同一图中。来源:原论文 Fig. 1。
探索新地点的概率为ρn^(−γ),其中n为已有不同地点数量。ρ较大时更容易探索,γ较大时探索概率随地点增多下降更快。探索时,从本人相邻原始记录提取的“跳跃距离—方向”成对集合中抽取一个向量,把它平移到当前地点,生成一个合成坐标。
这不是填回两条真实记录之间唯一缺失的地点,也没有核实新坐标一定是可进入的场所。方向与距离来自个体历史,有助于保留其空间特征,但仍可能继承原始采样偏差。
若返回旧地点,模型不直接采用原始发帖频率,而按访问排名赋予约k^(−1.2)的权重,再乘上随距离增加而减小的指数阻抗。这样既偏向个人重要地点,也偏向当前位置附近的候选;归一化之后随机选择目的地。
该设计依赖一个关键假设:稀疏数据的访问比例可能有偏,但常去地点的相对排名仍保留一定真实性。这个假设并不必然适用于每个人,尤其日常地点几乎不发帖时,更需要检验。
合成一天,还需要知道一天去多少地方吗?
是的。论文按日生成访问序列,规定从家开始、最终回家;每日访问数从瑞典2011—2016年出行调查的经验分布中抽取。荷兰和圣保罗也使用这份分布,因此结果既来自稀疏定位,也来自外部调查与日循环假设。
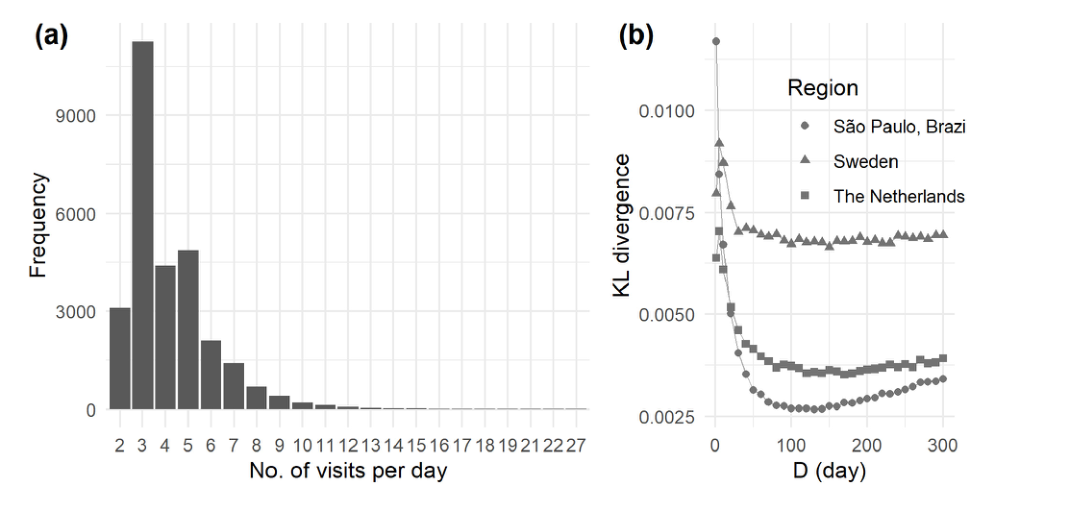
图 11|合成多少次访问、运行多少个模拟日?
(a)瑞典调查中的每日访问次数分布,横轴次数、纵轴频数;(b)模拟日数量D与KL散度的关系,不同符号表示三个地区。曲线趋稳后,研究选取D=260。来源:原论文 Fig. 11。
260天是为了让随机合成的总体统计稳定,不是补出了每个人真实的260天。模型也没有为每次访问生成完整时刻与活动目的;它更接近用于聚合需求的访问序列,而非已经可直接替代详细活动日记的时间表。论文指出过夜行程尚未纳入。
作者公开了代码。当前仓库的日循环与论文算法1在末尾回家等细节上并不完全一致;阅读论文结果应按发表的模型设定理解,若复现则需要进一步锁定对应版本,不能只凭仓库存在就声称已复现相同实验。
用什么标准判断“填得更合理”?
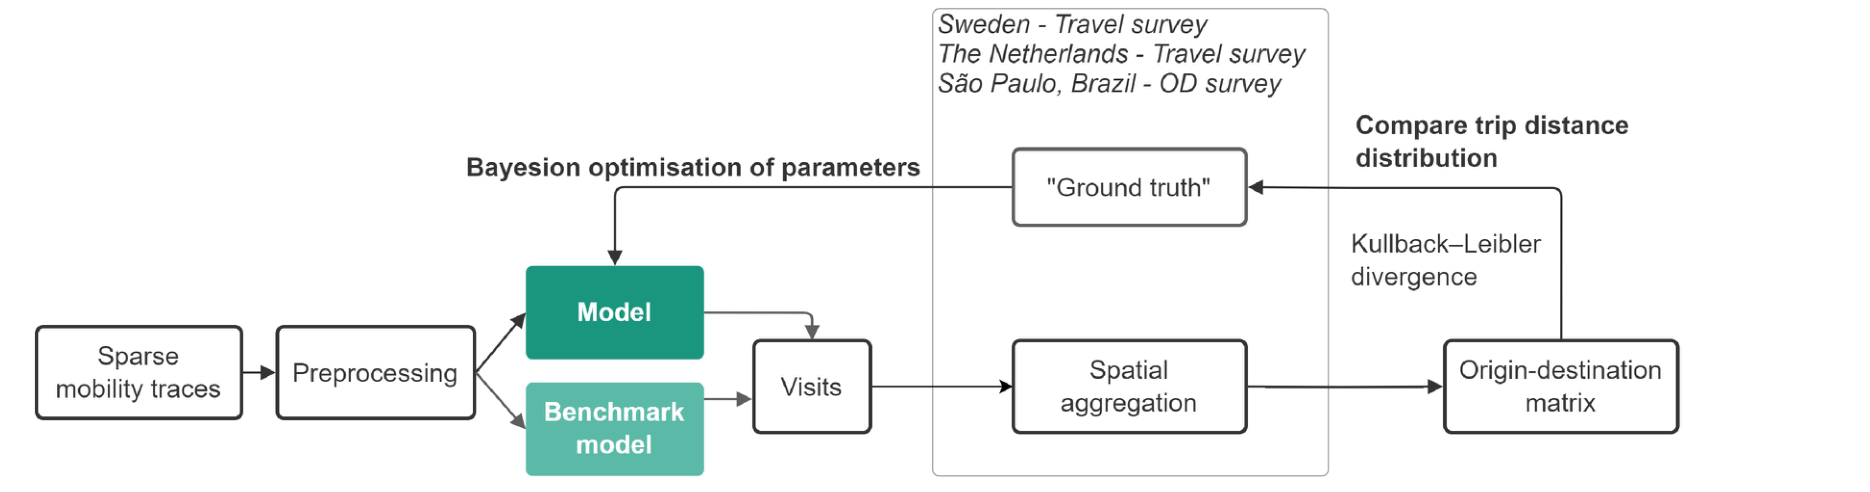
图 2|怎样从个体合成访问走到地区出行需求?
稀疏记录经处理后分别进入本文模型与启发式基线,生成访问并聚合为OD矩阵;距离分布与官方调查比较,KL散度反馈给参数优化。原图无子图字母。来源:原论文 Fig. 2。
基线把同一用户相邻、间隔小于24小时的定位连接为出行。本文模型则合成更多访问后再聚合,两者均与相同区域的调查参照比较。预处理记录按时间切成等长两部分,前一部分校准、后一部分验证。验证更换的是稀疏输入样本,调查参照并没有同步换成一份独立未来调查。
研究用贝叶斯优化寻找ρ、γ和距离阻抗参数β,使100组距离分箱中的KL散度尽量小。KL在这里比较调查距离概率分布与模型分布,越小越接近,不能换成“百分之多少行程正确”。
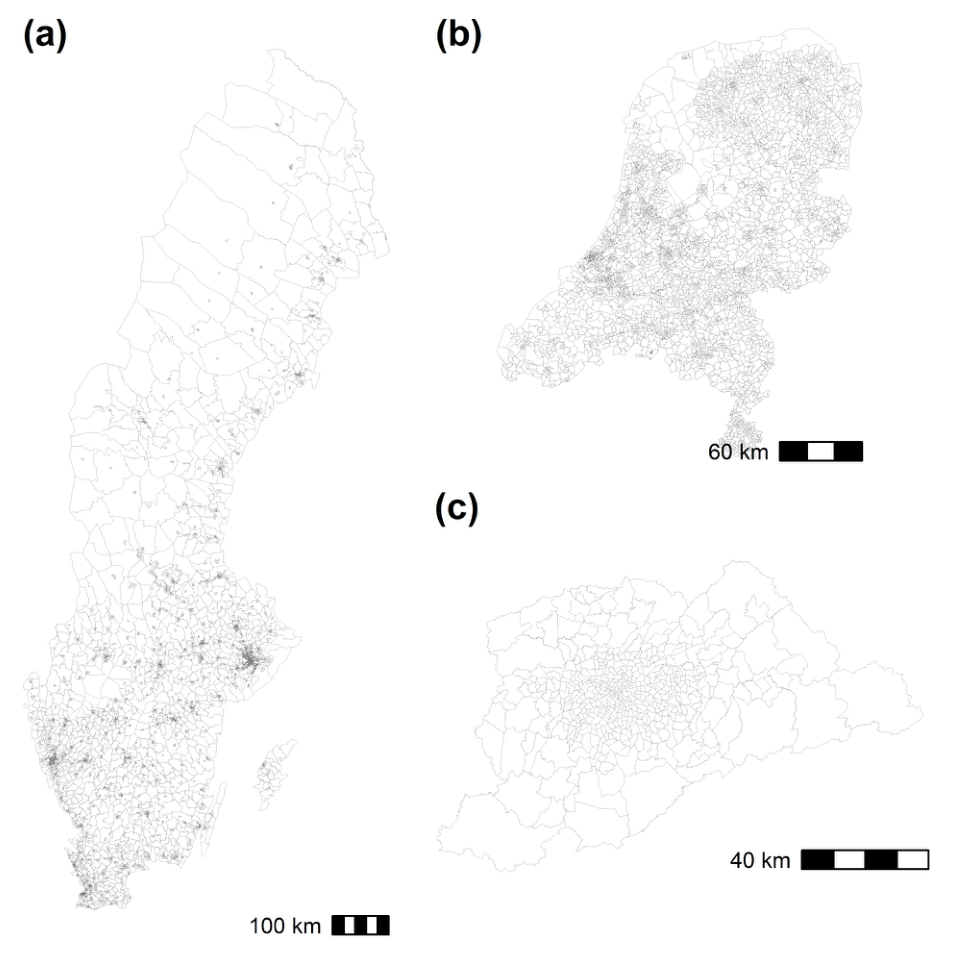
图 3|同一个OD矩阵,在不同地区对应多大的空间单位?
(a)瑞典5984个DeSO人口统计区;(b)荷兰4066个四位邮编区;(c)圣保罗517个调查区,包括周边市镇。原图比例尺分别展示不同地图尺度。来源:原论文 Fig. 3。
参照资料包括瑞典2011—2016年调查中的171,553次出行、38,258名参与者,荷兰2017年37,016名受访者,以及圣保罗2017年约32,000户、100,000人的调查。为保持比较一致,只分析工作日。
区域形状和大小不同,距离还涉及分区中心之间的Haversine距离。尤其圣保罗调查没有完整单次出行距离,使用起讫区中心估计。因此这里的距离拟合不等同于逐条核对真实道路里程,三个地区分数也不完全处在同一空间分辨率上。
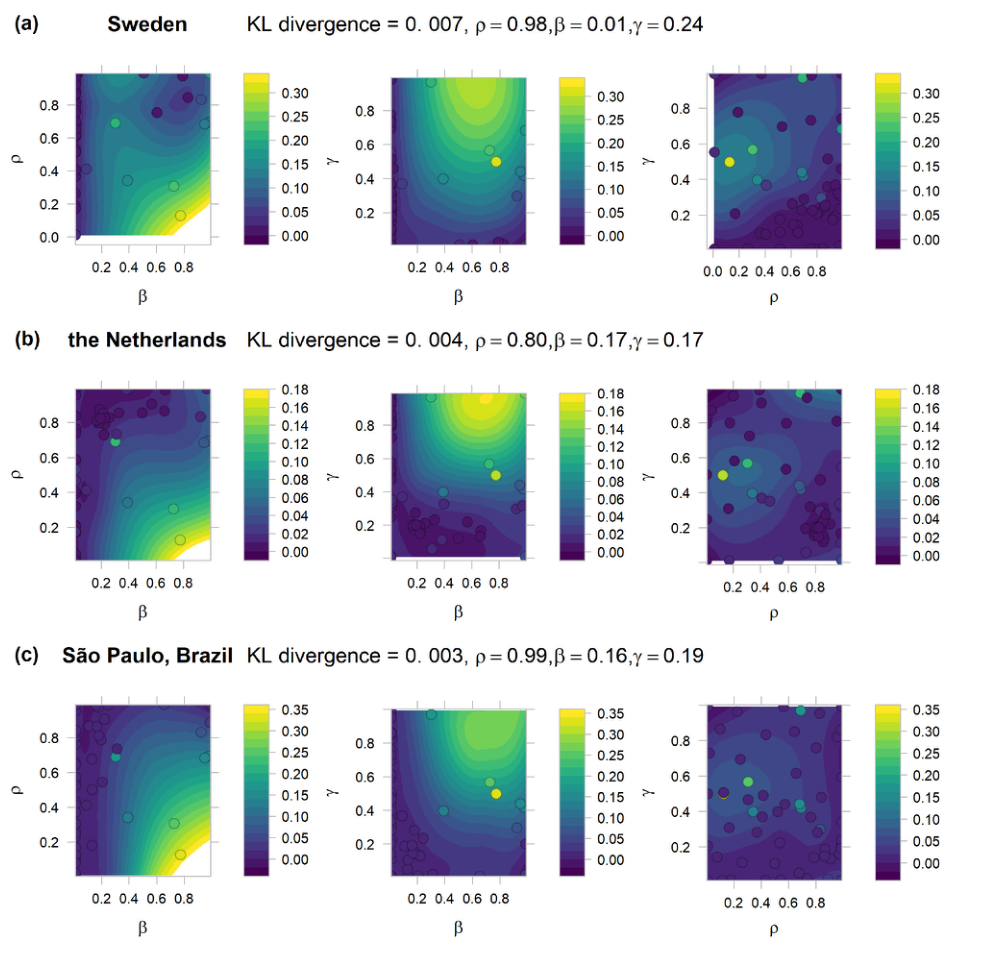
图 4|参数改动多大范围,距离分布仍然较接近?
(a)瑞典;(b)荷兰;(c)圣保罗。每行展示参数空间的多个二维投影,圆点表示实际尝试的参数组合,背景为插值得到的KL表面,颜色越冷表示散度越小。不能把未实际运行的全部背景区域当成逐点验证。来源:原论文 Fig. 4。
表1列明参数与固定设置,表4给出符号含义。表2按地区报告最优组合及性能,说明不同地区确实经过各自校准。参数寻优的广阔较好区域提示适度稳健,但不是对所有参数任意变化都不敏感。
生成更多访问,会不会只是把图画得更复杂?
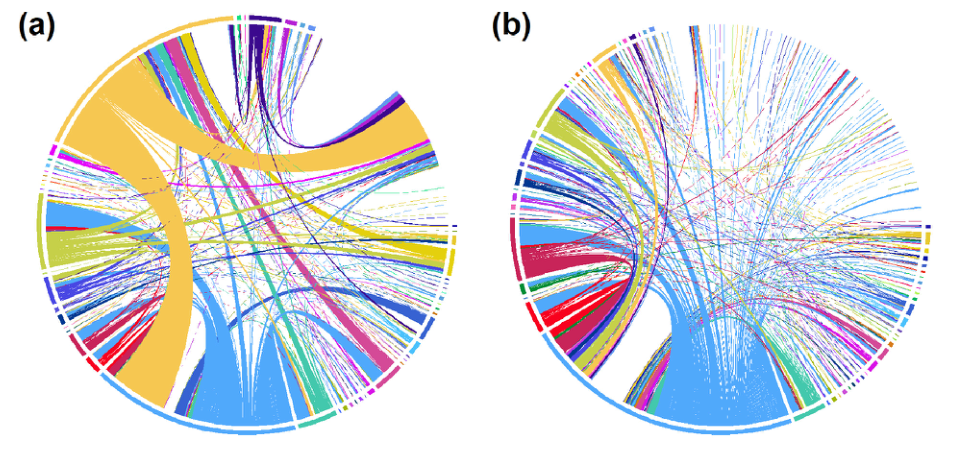
图 5|稀疏直接连线,与合成访问,怎样改变个体OD?
(a)基线覆盖64个分区;(b)本文模型覆盖123个分区。示例来自圣保罗一位记录覆盖315天的用户,圆周弧段表示区域,蓝色弧段对应推定的家。来源:原论文 Fig. 5。
模型使访问更分散,也增加了与家有关的连接。但这只是生成结果的示例,没有同一位用户完整真实轨迹可以证明123个区域都确实去过。是否改善,应看聚合数据与外部参照,而不是看圆图是否更丰富。
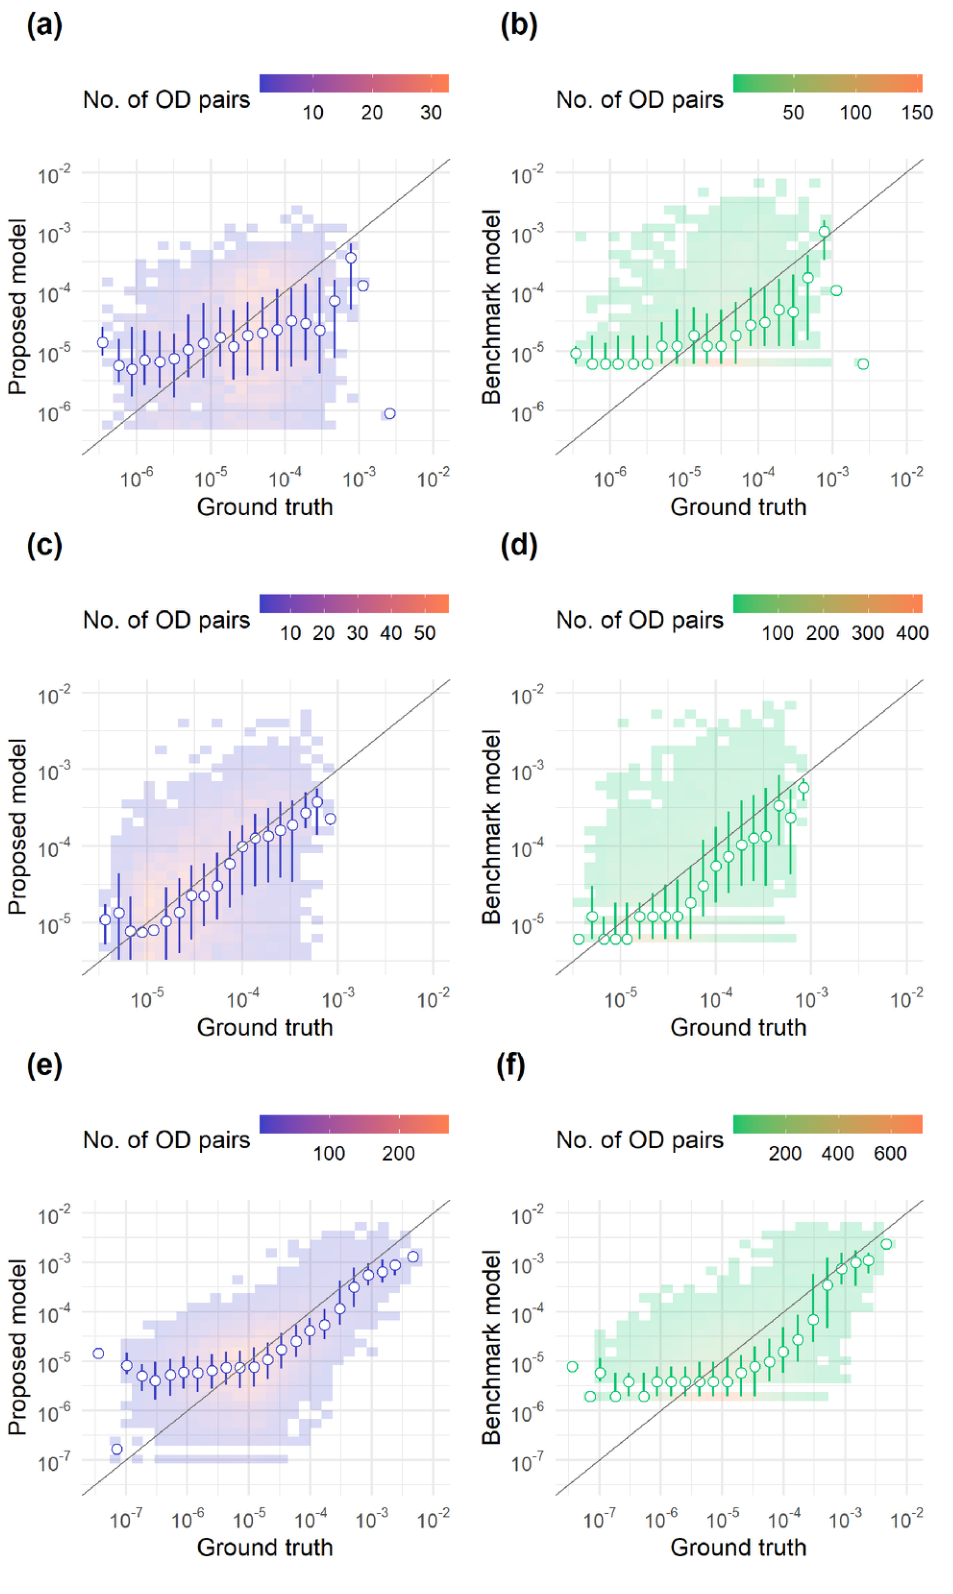
图 6|整体距离接近后,具体区域对也能对上吗?
(a、b)瑞典;(c、d)荷兰;(e、f)圣保罗。左列(a、c、e)为本文模型,右列(b、d、f)为基线;横轴为调查的OD出行频率,纵轴为相应模型频率,均为对数刻度。热度表示区域对数量,圆为分箱中位数,线为25%—75%分位区间;灰线表示完全相符。来源:原论文 Fig. 6。
高频连接总体较容易接近调查,低频连接仍有大幅偏差。表3将校准与验证的指标取平均,结果更能显示限制:
| 地区 | 本文模型Kendall τ | 基线τ | 本文模型SSI | 基线SSI |
|---|---|---|---|---|
| 瑞典 | 0.19 | 0.24 | 0.31 | 0.31 |
| 荷兰 | 0.44 | 0.37 | 0.43 | 0.39 |
| 圣保罗 | 0.45 | 0.33 | 0.54 | 0.45 |
Kendall τ衡量排序相关,SSI衡量矩阵相似程度,较高一般更好。瑞典相关降低、SSI不变,明确说明更好的距离分布不保证每条OD都更可信。原表的相关检验p<0.001,也只是这些相关不为零的证据,不是本文模型显著优于基线的检验。
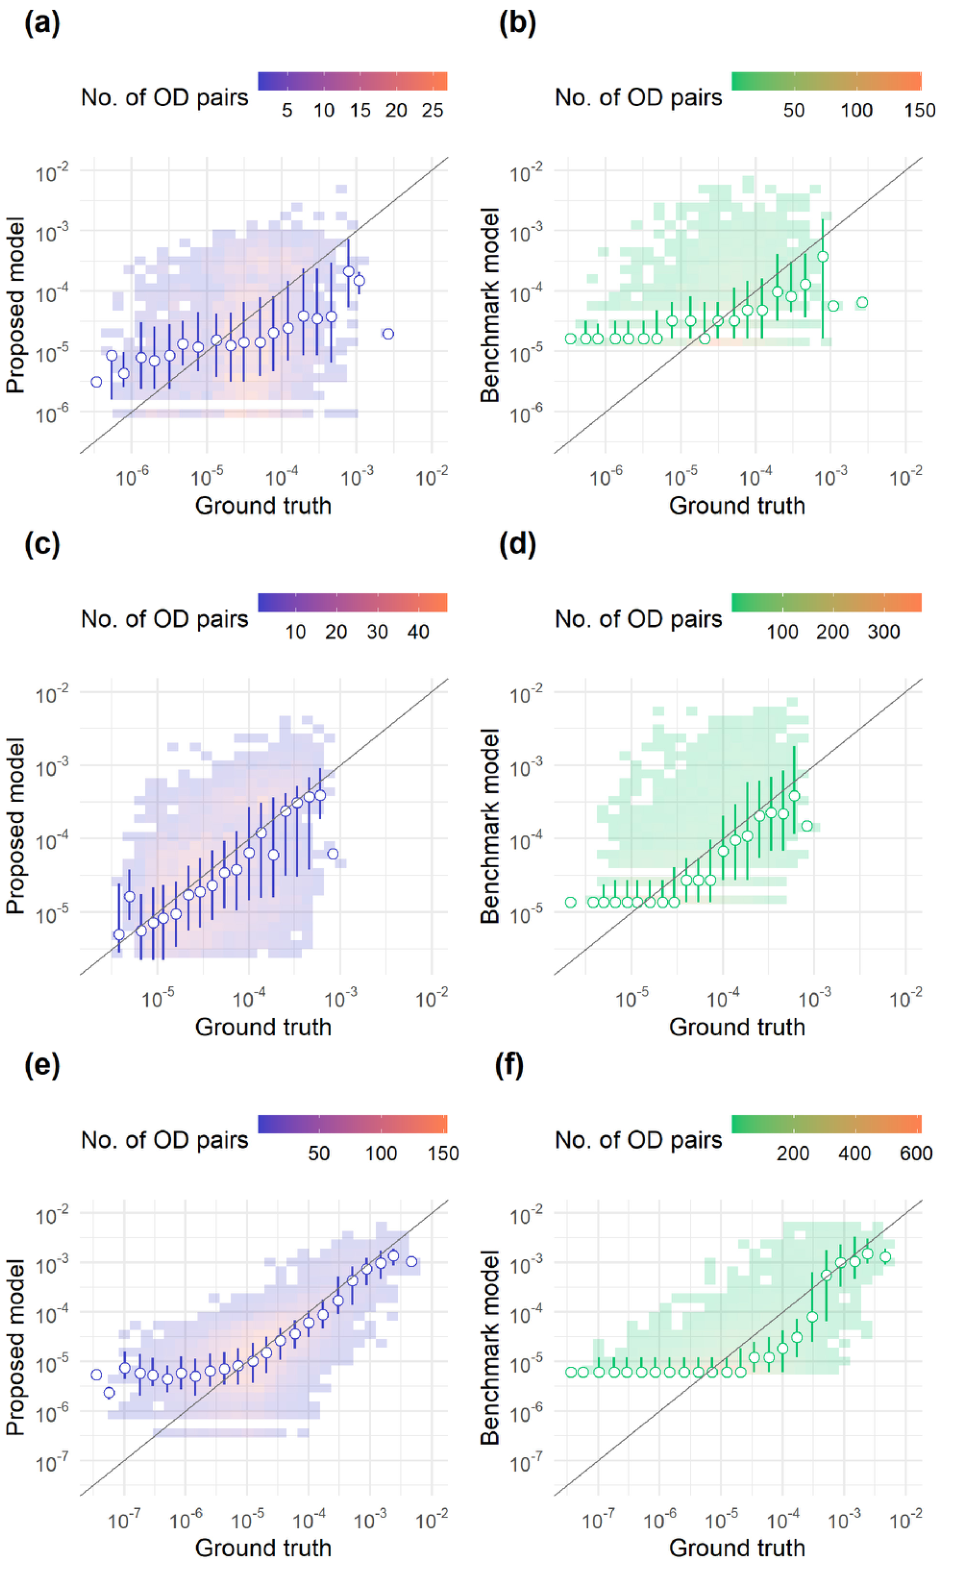
图 12|换到另一半稀疏记录,矩阵比较是否保持同样趋势?
(a、b)瑞典、(c、d)荷兰、(e、f)圣保罗,左列(a、c、e)本文模型、右列(b、d、f)基线;轴、热度和分位线与图6含义相同。验证结果呈现类似总体趋势,低频连接的误差仍在。来源:原论文 Fig. 12。
距离分布的改善,落在哪些区间?
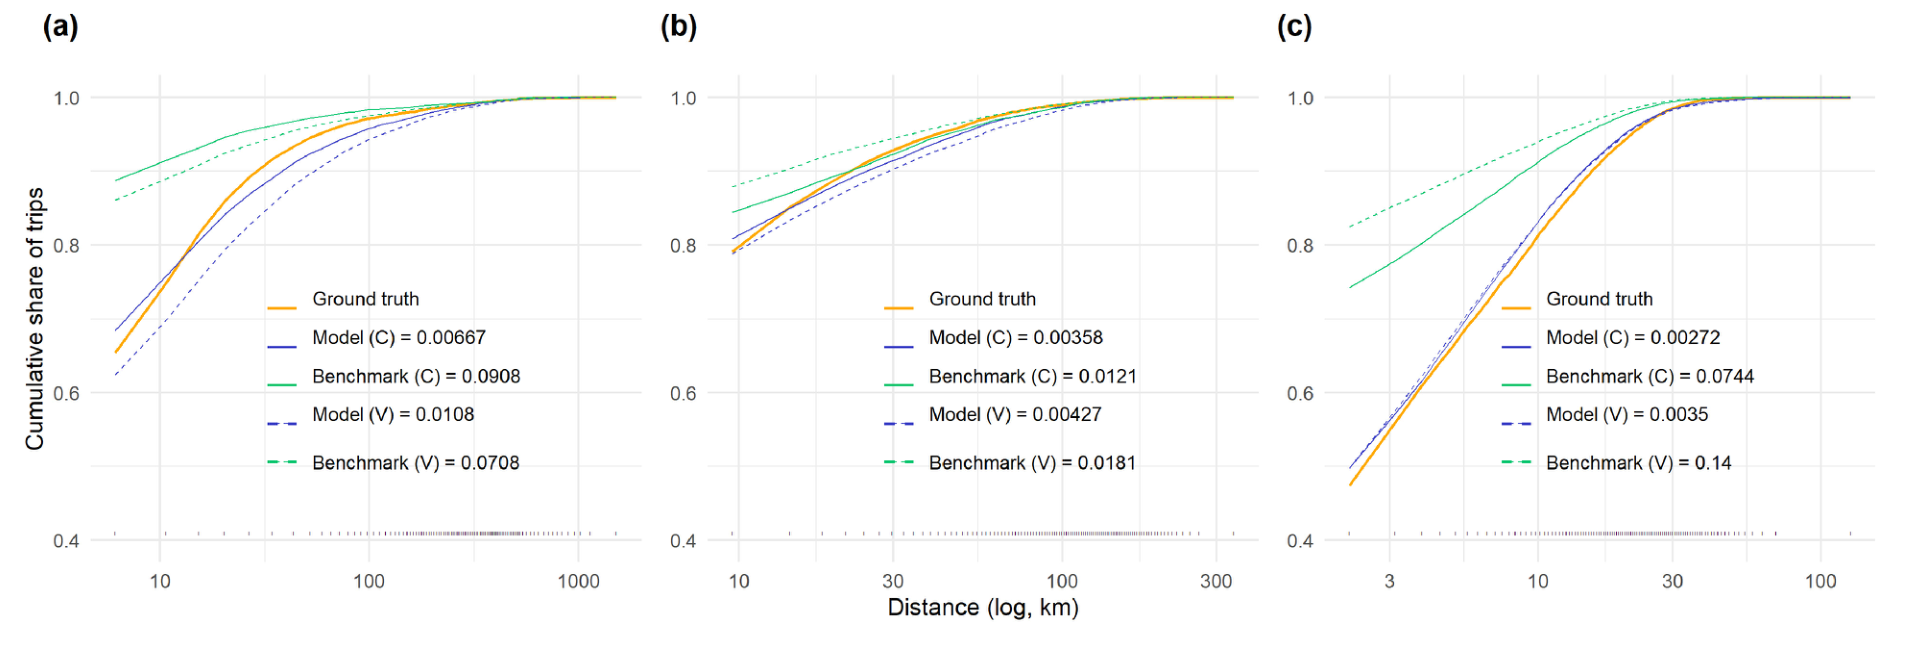
图 7|直接连稀疏定位,会低估还是高估长距离占比?
(a)瑞典;(b)荷兰;(c)圣保罗。横轴为公里距离的对数尺度,纵轴为累计出行份额;橙色调查参照、蓝色本文模型、绿色基线,实线C为校准、虚线V为验证。图例数字是相应KL散度。来源:原论文 Fig. 7。
基线在较短距离就积累了更高份额,倾向过度表现短距离;本文模型总体更接近调查。表2的KL值按三位小数报告为:瑞典校准0.007、验证0.011,荷兰均约0.004,圣保罗均约0.003。它们表示分布相似,不是接近100%的行程预测准确率。
瑞典验证基线在表2列为0.017,图7图例却为0.0708;这两处报告不一致,不能据此拼出一个统一的精确改善百分比。无论采用哪处基线,该组本文模型的散度较小,但改善幅度需进一步核对。
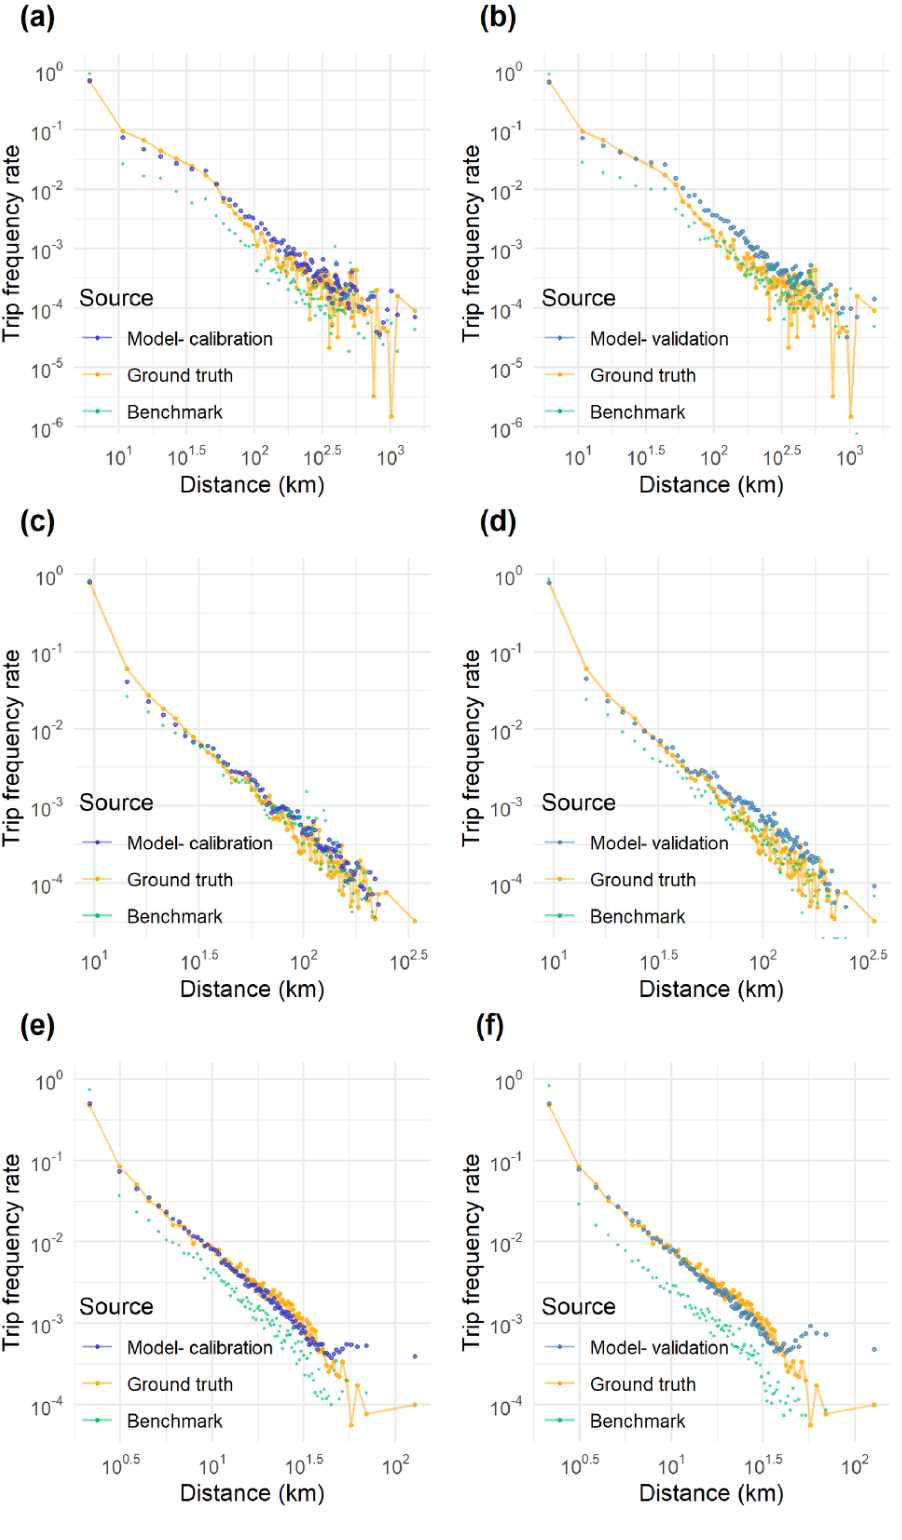
图 8|累计曲线接近,会不会掩盖长距离尾部的偏差?
(a、b)瑞典;(c、d)荷兰;(e、f)圣保罗。左列(a、c、e)为校准、右列(b、d、f)为验证,横轴为公里距离、纵轴为出行频率;模型蓝、调查橙、基线绿,坐标采用对数尺度。来源:原论文 Fig. 8。
圣保罗在约40公里以内较接近调查,但更长行程被高估。瑞典和荷兰部分中距离被低估,随后较长距离被高估;很长距离的调查频率本身也有起伏。因此,常见出行区间表现好,不能直接外推到跨国长途或过夜旅行。
更需要每人更多记录,还是更多人的少量记录?
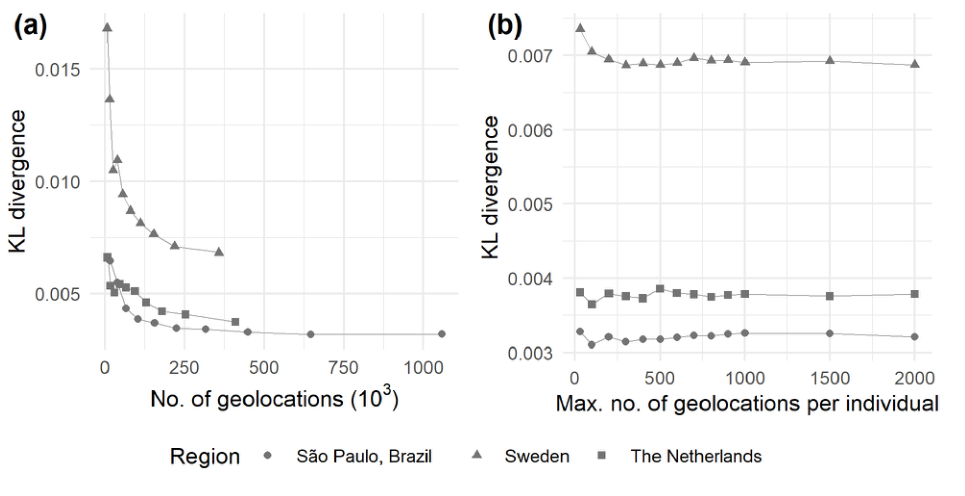
图 9|数据增加到哪一层,改善更明显?
(a)按记录较少用户到较多用户逐步增加总定位量,纵轴为KL;(b)改变每人最多使用的定位数,纵轴同为KL。符号区分三个地区,均采用各自优化参数。来源:原论文 Fig. 9。
总样本量增加,距离分布通常更接近调查,瑞典在研究范围内尤其尚未饱和;增加每人的记录上限,到约200条后增益却很小。它提示群体覆盖可能比把少数人记录得极密更重要,但不是“每人200条就足够”的通用门槛:许多人实际少于200条,空间覆盖与人口代表性也同时变化。
在一个地区调好参数,换地方还能用吗?
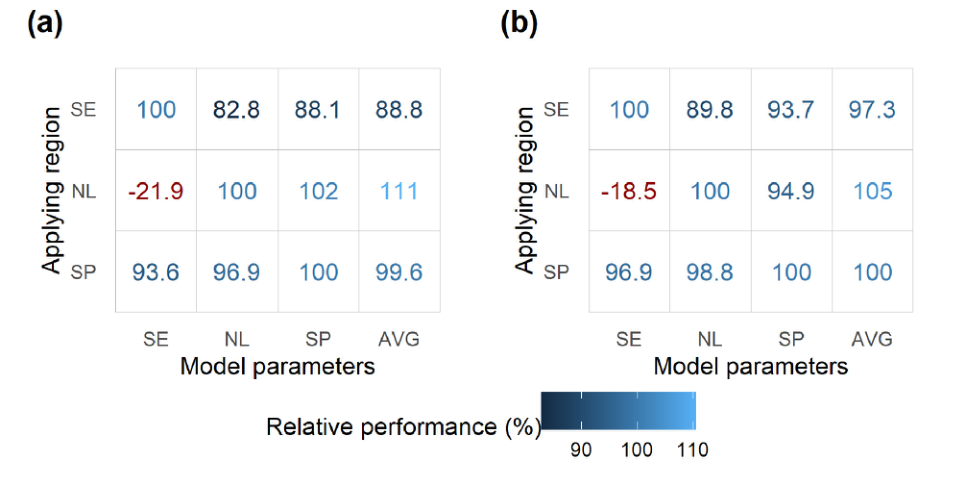
图 10|借用别处参数,收益能保留多少?
(a)校准;(b)验证。行表示应用地区,列表示参数来源,SE、NL、SP分别为瑞典、荷兰、圣保罗,AVG为参数均值。对角线按本地区收益归一为100;数值是相对基线改善收益的比值,不是准确率。来源:原论文 Fig. 10。
多数转用结果接近本地区收益。反例是荷兰使用瑞典参数:校准为−21.9%、验证为−18.5%,负号表示模型已比启发式基线更差。部分格超过100,也只表示另一组参数在当次比较更好,反映近似优化不保证找到全局最优,而不是预测准确率超过100%。
迁移结果值得继续验证,但只涉及三个地区。城市与国家的空间范围、分区尺度和Twitter用户分布都不同,可变空间单元问题可能影响比较。平均参数有潜力,仍应先检查新地区的误差。
什么时候可以用,什么时候还需要补证据?
这项研究证明,在群体层面,稀疏记录加上行为生成规则和调查约束,可以比简单连线产生更合理的某些需求统计。但没有相同用户的高质量轨迹作为真值,不能证明个人缺失行程已被恢复。
用户偏向城市、不同年代定位与调查不完全同步、地区分区不一致,也影响外推。论文还提醒平台已取消精确地理标记的部分功能,因此旧数据上的可行性不代表今后的同类数据同样可得。
合成与位置聚类减少直接展示真实路线的需求,但并未提供正式的差分隐私保证。若用来规划道路或公交,尤其应额外验证关键走廊和低频OD,不能让较小的距离KL掩盖局部流量误差。
一句话总结
许多人的少量定位可以支撑更合理的群体出行合成,但距离分布接近、OD矩阵可靠和个人行程真实,是需要分别验证的三个问题。
核心来源
- Liao, Y., Ek, K., Wennerberg, E., Yeh, S. & Gil, J.(2022). A Mobility Model for Synthetic Travel Demand From Sparse Traces. IEEE Open Journal of Intelligent Transportation Systems, 3, 665—678。论文DOI,机构全文,作者代码。本文依据完整正文、附录A—D、表1—5与全部图1—12,原图逐张保留完整面板。
作者介绍
按论文发表时署名与简介介绍,不推断当前任职。
- Yuan Liao:查尔姆斯理工大学空间、地球与环境系Physical Resource Theory方向署名作者,本文通讯作者;原文列出移动数据科学、城市大数据与可持续交通研究方向。
- Kristoffer Ek:瑞典Burt Intelligence AB署名作者,文末简介列为从事大数据与自动化分析的软件工程师。
- Eric Wennerberg:瑞典Einride AB署名作者,文末简介介绍其车辆路径与重型电动卡车优化工作。
- Sonia Yeh:查尔姆斯理工大学同系署名作者,研究涉及交通与能源系统、替代燃料及出行行为。
- Jorge Gil:查尔姆斯理工大学建筑与土木工程系Urban Design and Planning方向署名作者,研究包括城市分析与集成城市模型。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
可以用完整GPS轨迹先构建一份真实日活动,再人为按不同发帖倾向抽稀:偏向家、偏向娱乐场所或偏向旅途分别测试。同样是每天1.5条定位,缺失机制不同可能导致完全不同的结果。这样才能判断模型究竟修正了数据少,还是恰好适应了这批Twitter用户的发帖偏好。
还可在优化距离分布之外,加入少量独立交通走廊计数,检查能否同时减少局部OD偏差。如果距离分布不变却能得到许多截然不同的矩阵,就应给规划者一个可能矩阵的范围,而不是只交付一张看似确定的需求表。