没打电话的十几个小时,数据里的你去了哪里?
论文名片|Guangshuo Chen、Aline Carneiro Viana、Marco Fiore、Carlos Sarraute,Complete trajectory reconstruction from sparse mobile phone data,EPJ Data Science 8,30,2019 年 10 月 12 日发表。DOI。
早上在家打一通电话,晚上在另一处再打一通。运营商记录里,这一天可能只有两个位置。中间你待在办公室、去了商店,还是跨城出差?没有通信记录,既不能证明你没移动,也不能证明你一直停在上一个位置。
用这样的数据研究人的规律,会遇到两种麻烦:轨迹不完整,或者只挑频繁通信的人留下,结果又不代表多数人。这篇论文提出上下文增强轨迹重建(Context-enhanced Trajectory Reconstruction,CTR),利用夜间停留、日常重复和张量分解,补出每小时的位置,再检验补全会怎样改变一些经典移动结论。
主要发现有四点:
- 在 180 万人的通话数据中,即使把时间划得很粗,完整轨迹也极少;仅靠筛选高活跃用户会丢掉大多数人。
- 在 1,450 人、两周的高频通信参考轨迹上做缺失实验,CTR 的轨迹级误差中位数约为 1–2 个基站小区半径,即使只保留 1% 的小时位置。
- 对约 170 万人补全后,移动距离的截断重尾形态仍存在,但尺度、唯一性与理论可预测性发生变化。
- 补全结果仍是模型推断,不是 170 万人的连续观测真值;规律性先验、验证人群和缺失方式都会影响解释。
原始数据到底缺了多少?
研究的主体数据来自拉丁美洲一家运营商:180 万预付费用户,连续 90 天,7.78 亿条语音通话记录,覆盖数千平方公里与 4,200 座基站。国家未在数据介绍中明确公开,不能根据地理或经济描述补写。
论文表 1 展示了记录格式:用户和基站编码、事件时间、主被叫、方向与通话时长,并有基站坐标映射。记录所带位置是通信基站的代理位置,不是用户的精确 GPS。
完整性定义得很具体:把观测期 T 按 τ 划成时间槽,有至少一次位置观测的槽数,除以全部槽数。比如一周按小时划分,共 168 槽,若只知道其中 80 槽,完整性约为 0.476。同一个小时有十条记录,也只覆盖一个槽。
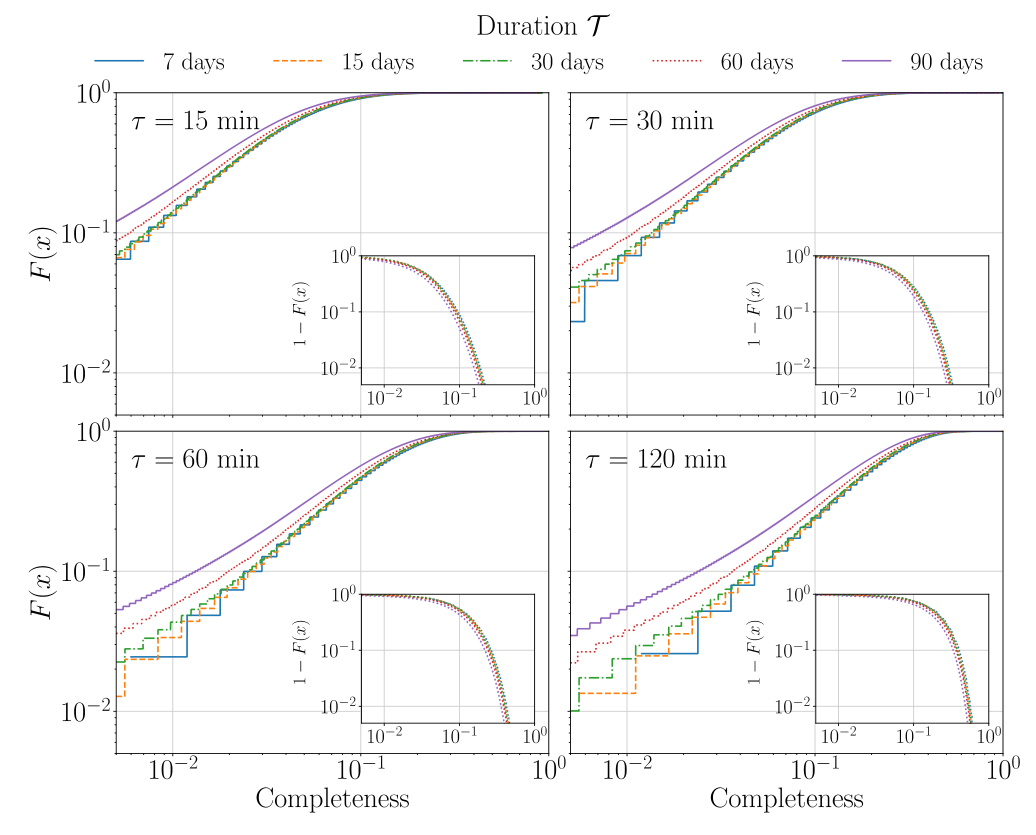
图 1|把一天切得更细,还能知道多少位置?原图四幅没有子图字母,左上、右上、左下、右下分别为 τ=15、30、60、120 分钟。横轴完整性,纵轴累计比例 F(x),插图显示互补累计分布;颜色为 7、15、30、60、90 天观测期。即使只看 7 天、每 2 小时记一个位置,也没有一条完全连续的轨迹,完整性超过 0.5 的用户不足 1%。时间槽越短,缺失越严重。
在 30 天观测期内,完整性超过 0.1 的用户比例,随着 τ 从 15、30、60 增至 120 分钟,分别约为 8%、26%、53%、75%。这不是更粗数据更准确,而是要求知道的位置变少了。
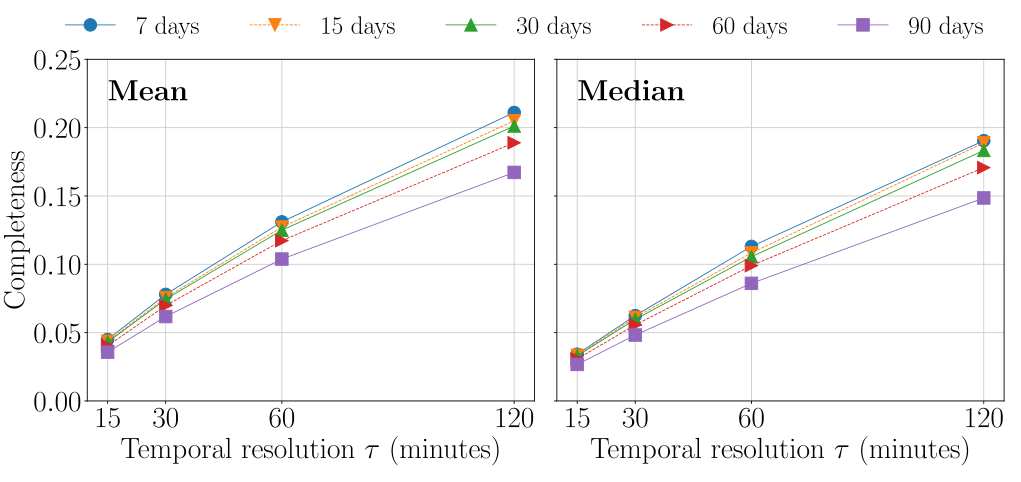
图 2|降低时间分辨率,能多覆盖多少?左图是全部用户的完整性均值,右图是中位数,原图均无字母。横轴 τ 为分钟,纵轴完整性,颜色区分观测期。两者随时间槽长度近似线性增加,报告的 Pearson 相关分别为 0.981、0.983。该关系描述这一数据的采样特征,不能把时间槽加大后覆盖更多,理解为找回了真实中间路径。
这种缺失能用一个分布描述吗?
论文还比较 Weibull、对数正态、Gamma、Pareto、Lévy 与幂律六类分布,用决定系数 R² 和 KS 分布距离评价完整性分布拟合。表 2 覆盖五种观测期与四种分辨率,两个评价标准合计 40 项比较,Weibull 获得其中 32 项最佳结果。
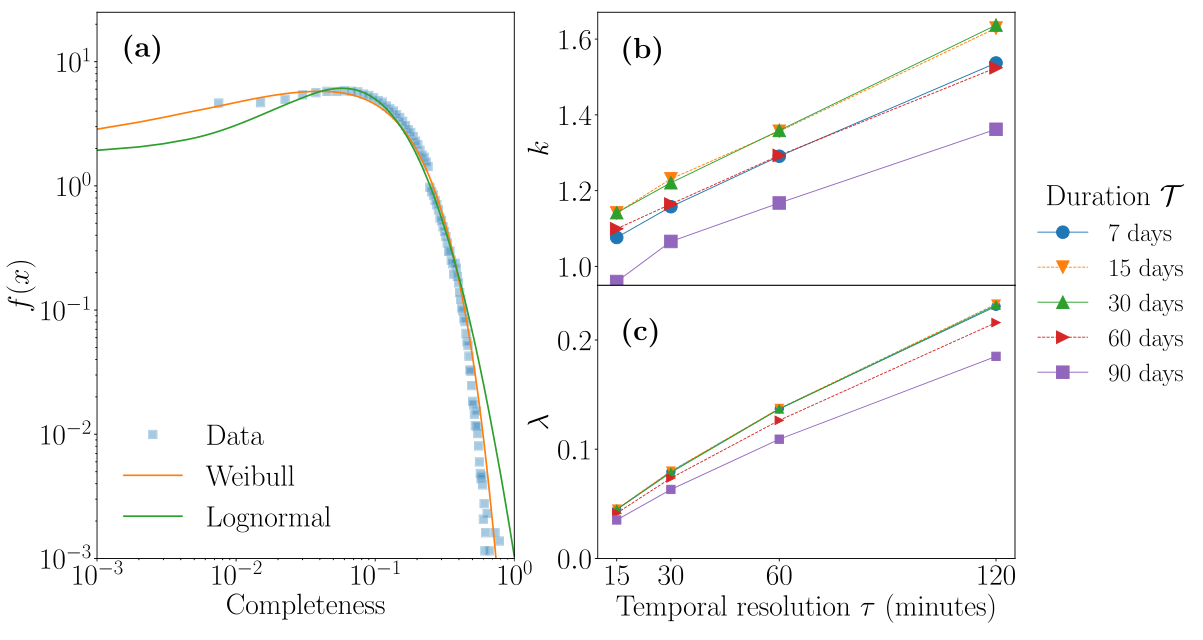
图 3|完整性分布怎样随采样尺度变化?(a)T=60 天、τ=60 分钟时,浅蓝为经验密度,橙色 Weibull、绿色对数正态。(b)Weibull 形状参数 k,(c)尺度参数 λ,横轴均为时间槽分钟数,颜色表示观测期。两参数大体随 τ 增长,T 改变带来偏移。此处 λ 是分布尺度,后文张量目标中的正则化 λ 是另一个参数。
例如 30 天、60 分钟条件下,Weibull 的 KS 距离为 0.0149、R² 为 0.9996。这个经验拟合可以帮助估计同类 CDR 数据的缺失程度,却不是人类移动本身的概率定律,也不宜不经检验移植到另一家运营商或更高频信令数据。
补齐轨迹,可以依靠哪些信息?
CTR 利用的是一个人的重复活动:长时间停在少数地点,很多夜晚在同一处,日常与每周存在重复。零散记录虽然不能完整描述某一天,若分散覆盖了很多天的不同小时,仍可能拼出典型模式。
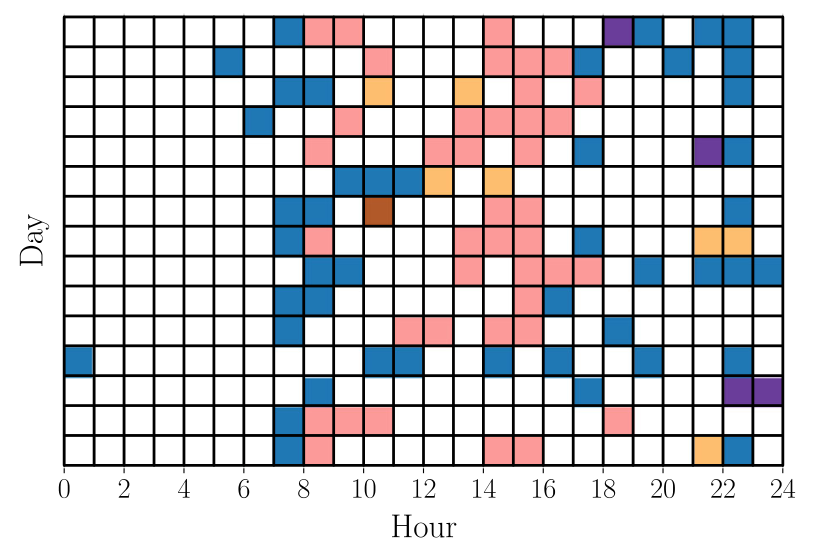
图 4|碎片里是否已经藏着重复?这张无子图字母的网格横轴为一天内小时,纵轴为天,展示 15 天、完整性 0.27 的单人轨迹。白格为缺失,颜色代表不同地点;粉色是最常见日间地点,蓝色是最常见夜间地点。相同颜色在相近时段反复出现,说明可以借助重复性补空,但白格不等于用户没有移动。
它的目标是小时级代表位置,不是复原两次定位之间每一条街道。对于一小时内有多条记录的情况,研究选择关联事件最多的基站作为该小时位置,以减少相邻基站快速来回切换造成的假移动。这仍不能完全消除定位和采样误差。
第一步:什么时候可以把夜晚补成家?
研究按当地作息,把夜间定义为 22:00 至次日 09:00。对每个人寻找夜间最常出现的地点,只有它占已观测夜间位置至少 80%,才将其视为较可靠的家;否则跳过这一阶段。
找到家后,还逐夜检查。只要该夜观测到其他地点,就不把整夜都补成家;只有未观测到异地位置的夜晚,才用家补缺失槽。主体数据约 72 万人被识别出符合要求的家,这些人的夜间槽平均有 82% 通过这一规则补齐。
“没观测到在外”依然不等于“肯定在家”。这是一项有条件的插补规则,可能漏掉没有触发通信的夜间活动;夜班、旅行或不稳定居住者也未必适用。未被该步骤处理的人,仍可进入后续张量补全。
第二步:把很多周的日程放进同一个张量
张量可以理解为多维数组。CTR 对每个用户单独建立“第几周 × 星期几 × 一天内的坐标序列”,让不同时段的重复结构成为补全依据,而不是把所有人的轨迹混成一条平均路线。
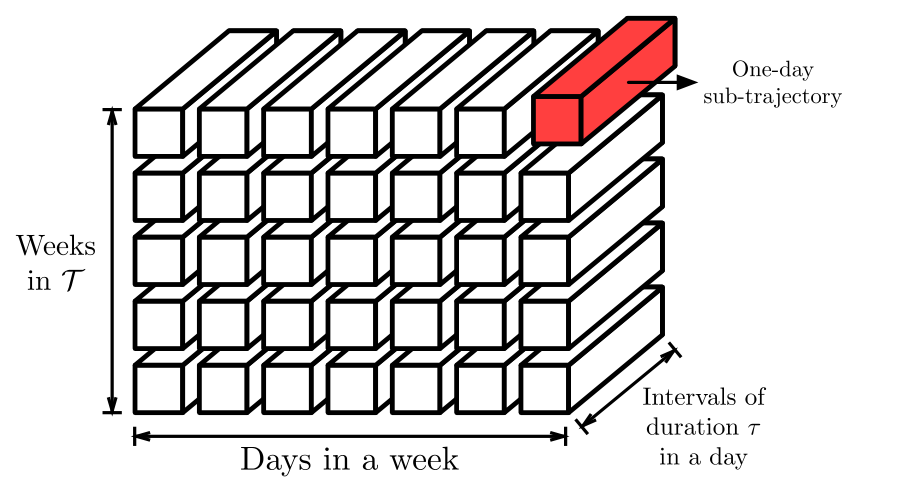
图 5|一天、一天之间和周之间,怎样放到一个结构里?这张无字母的立体图分别标出周、每周天数和一天内的时间槽,红色长块表示一天的子轨迹。每个小时含 x、y 两个坐标,因此实际第三维长度是 2Nτ,小时分辨率下为 48。已观测位置和第一步推断的夜间位置作为输入,其他位置保留待估计。
模型用典范多元分解(canonical polyadic decomposition,CPD)将这个数组近似成若干低秩因子的组合。低秩的含义是:很多周、很多天的位置变化,可以用少量重复结构描述。论文设秩 R 为三个维度长度中的最小值;在两周、七天、48 坐标的验证中,这一规则对应 R=2。
目标函数先要求重建值贴近已有坐标,再限制参数过大以防过拟合。但仅有低秩还不够,研究额外加入两种平滑惩罚:相邻天的同一小时不要差得过远;同一天相邻小时也不要随意跳动。
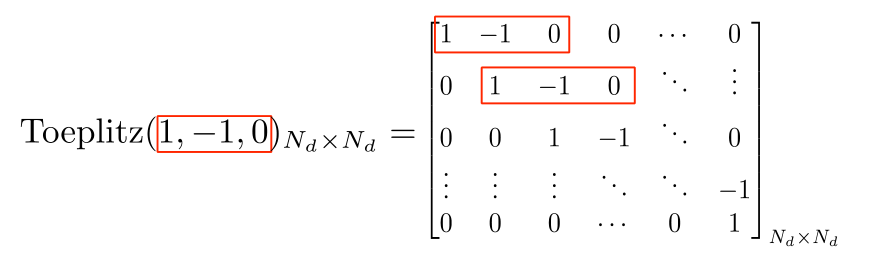
图 6|怎样把“相近时段不要差太远”写进优化?这张无字母的 Toeplitz 差分矩阵以对角线 1、上邻对角线 −1 构造,红框突出重复系数。它作用于日维度,比较相邻天的同一小时;另一个按 x、y 坐标交错方式构造的差分算子比较相邻小时。它们约束的是坐标差异,不是证明用户每天都按同一日程生活。
三个因子交替优化,使用交替最小二乘法求解,填出缺失坐标。原始观测位置最终保留,不被全部替换为平滑后的模型值。
第三步:连续坐标怎样回到基站口径?
张量分解输出实数坐标,不一定落在任何基站位置上。若直接用于后续研究,会与原始基站离散位置的统计口径不一致。因此 CTR 将推断坐标重新关联到实际基站。
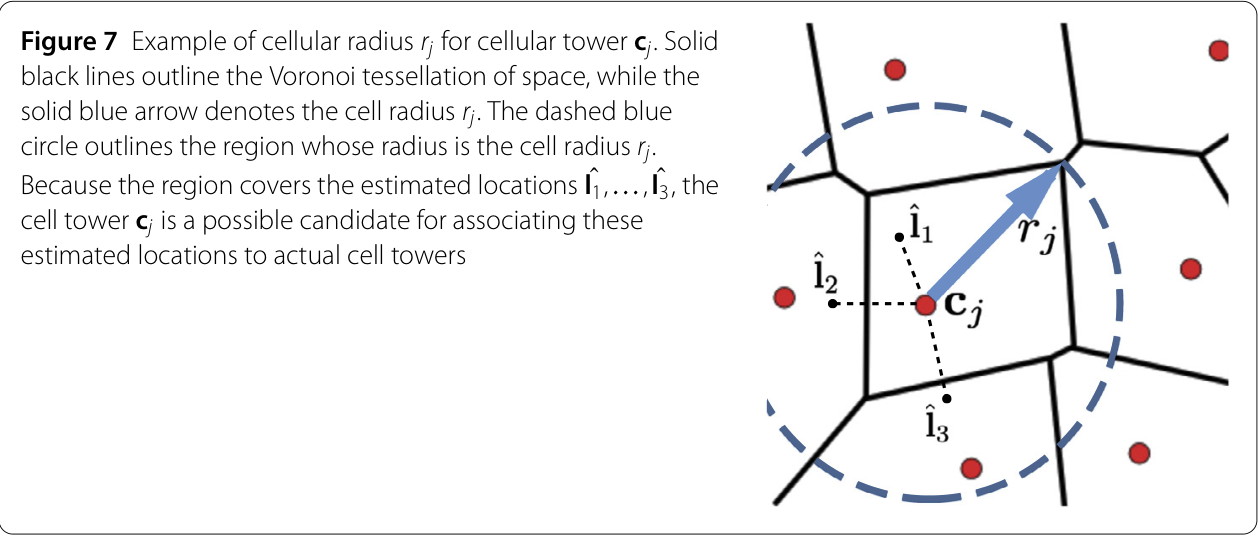
图 7|不是简单找最近基站,而是怎样选?这张无子图字母的图中,黑线是 Voronoi 分区,红点是基站,蓝箭头 rj 从基站指向该分区最远角点,虚线圆以此为半径。估计位置落在某座基站的半径圆内,该基站就成为候选;候选之间选择全体用户通信事件最多的基站。示例中三个估计点都可将 cj 作为候选,其中一个点可以位于 cj 的 Voronoi 多边形以外。
这一步同时利用空间范围与基站热度,不是把估计点机械吸附到最近塔。Voronoi 半径是几何近似,不等同于真实无线覆盖;偏向热门基站也可能让最终轨迹更集中。后续关于规律性和唯一性的结果,需要与这类方法假设一起理解。
真值从哪里来,只剩 1% 时又怎样验证?
验证数据来自主体用户中的一小部分:结合手机上网会话与 CDR,获得 1,450 人连续两周、每小时均有观测的基站代表位置,共有每人 336 个小时槽。这里的“真值”仍是高频通信推得的小时基站轨迹,不是连续 GPS 或人工逐时确认的位置。
研究按主体 CDR 的经验时段采样分布,故意删掉参考轨迹的一部分,保留完整性 0.01–0.5,生成约 30 万条不完整轨迹,再用 CTR 补齐。30 万是从 1,450 条参考轨迹反复构造的缺失样本,不是 30 万名独立受试者。
按经验时段分布删除,比均匀随机删点更接近通话采样;但仍不能完整复现每个人“为什么恰好此时打电话”的机制,也未必覆盖真实长空白、临时旅行等情况。
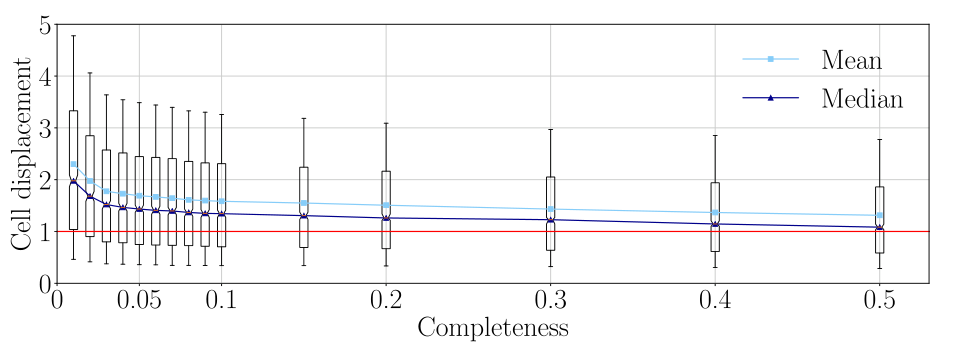
图 8|填出来的位置距离参考位置有多远?横轴为保留的原始完整性,纵轴为小区归一化位移。对每条重建轨迹,先只在原本缺失的小时计算“估计与参考坐标距离 ÷ 参考基站半径”,再对这些小时取平均;箱线汇总这些轨迹级误差。浅蓝为均值、深蓝为中位数,箱为第 25–75 百分位,须为第 10–90 百分位,红线为 1 个半径。中位数约在 1–2 之间,保留 5% 后已低于 1.5,更多已知位置继续改善结果。
这个指标不是“最多错两座相邻基站”,也不是“每个点都在两个小区内”。它以距离和基站半径归一化,且图中存在较宽的误差分布;半径又因城市、郊区而异,不能统一换算成固定米数。
已知位置不进入误差计算,因此不会靠把原始点原样保留就虚增成绩。这是验证设计的优点。但参考轨迹只有两周,不能直接证明三个月重建具有完全相同精度;论文也未给出系统的基线方法比较与各组件消融,不能据此声称 CTR 在所有稀疏条件下优于其他方法。
补齐后,经典的移动距离规律还在吗?
主体分析只重建原始完整性超过 1% 的用户,保留约 95% 人群,即约 170 万人,以小时为槽补齐 90 天。被保留多数人是覆盖范围上的进步,但这些“完整轨迹”主要包含模型插补,不能称为新增的直接观测。
第一个复查对象是移动距离与回转半径。回转半径 rg 衡量一个人各次位置相对活动中心的分散程度;Δr 是相邻记录或相邻小时代表位置之间的距离。
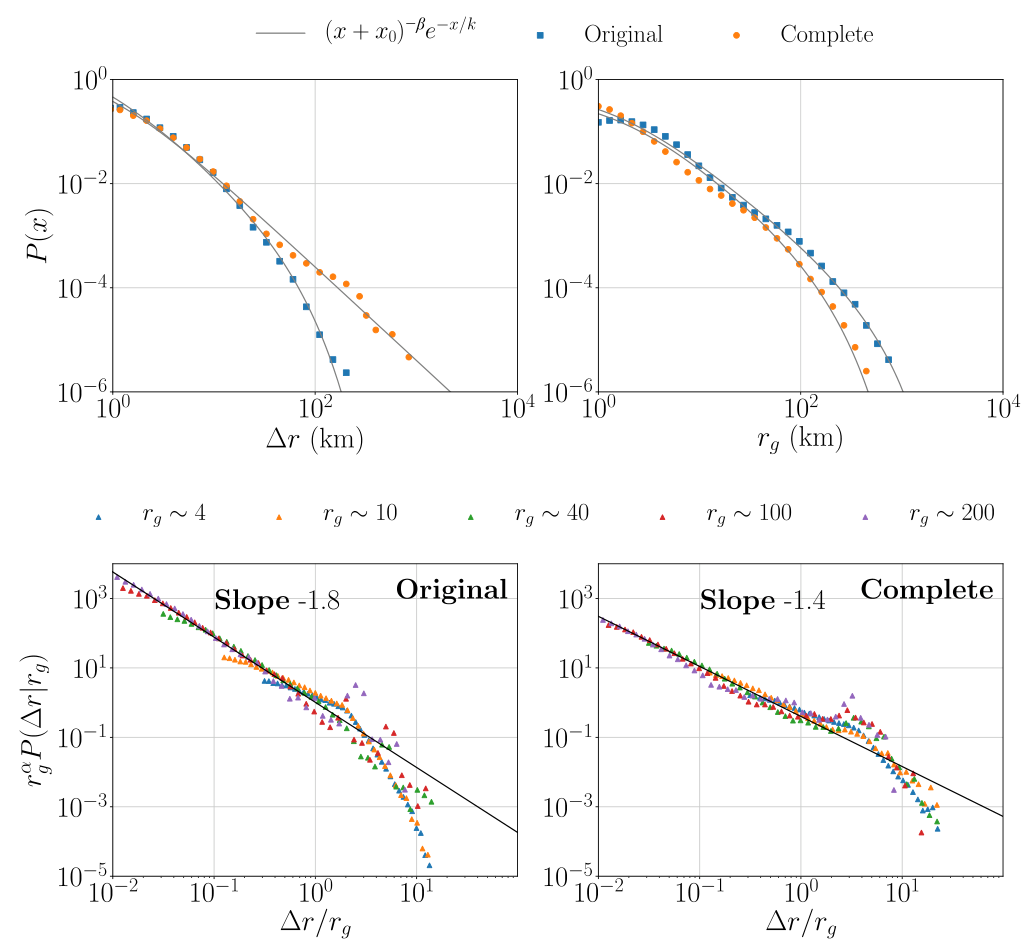
图 9|补全会改变移动距离的形态还是只改数字?原图四面板无字母。左上比较 Δr 的群体分布,右上比较 rg 分布,蓝色原始、橙色补全,灰线为截断幂律拟合。左下是原始轨迹、右下是补全轨迹在不同 rg 分组中的归一化距离分布,颜色代表活动范围组;参考斜率分别约 −1.8、−1.4。两者仍保留重尾后截断的结构,但截断与指数改变。
论文将结果视为对 González 等 2008 年定性规律的支持,而非推翻。群体拟合指数与旧研究接近,例如补全后距离指数约 1.78、回转半径指数约 1.68;回转半径截断尺度却从本数据原始轨迹的约 340 公里,变为补全后的约 175 公里。
比较时还改变了采样口径:原始 Δr 跨相邻通信事件,补全 Δr 跨相邻小时。差异既涉及补充位置,也涉及时间采样标准化,不能全部解释为发现了此前漏掉的真实长途出行。模型插补与数据地区差异都可能影响具体参数。
四个时空点能唯一识别人,是否依赖记录缺口?
轨迹唯一性衡量:知道一个人若干时间—地点组合后,数据中是否只剩一条轨迹与之匹配。它与把轨迹连接到实名身份有关,但不等于已经完成实名重识别。
经典研究中,少数随机时空点往往足以区分大量用户。CTR 论文提出,稀疏通信记录的“何时有记录”本身也会带来区分度,未必全来自真实路径不同。
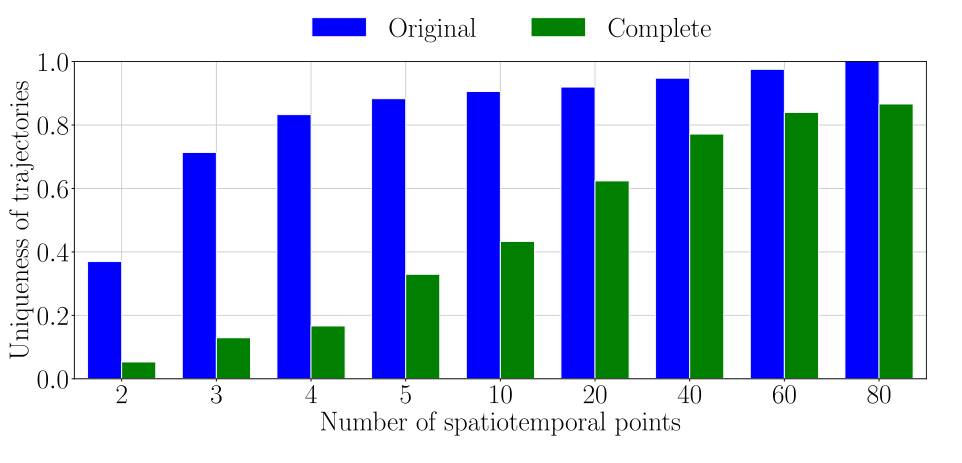
图 10|知道同样数量的时空点,仍有多少轨迹唯一?无子图字母的成对柱图,横轴已知时空点数,纵轴唯一轨迹比例,蓝色原始 CDR、绿色 CTR 补全。在本数据中,4 点时原始柱约 0.83、补全柱约 0.16,低点数下差异很大;补全后随已知点数增大,唯一性仍明显上升,80 点时接近九成量级。
这说明唯一性估计对采样缺失与数据处理很敏感。不过还应保留另一种解释:补全算法本身强调居家、日常重复和热门基站,也可能让轨迹更加相似。这部分并未用 170 万人的独立真实连续轨迹排除,所以“真实人类移动一定比过去认为的更不独特”仍需更多验证。
唯一性下降也不表示隐私安全。若攻击者知道更多点,或有更强辅助信息,仍可能识别;本研究并没有给重建数据提供匿名保护保证。
更完整的人群,为什么反而更容易预测?
最后一个复查对象是基于轨迹熵与 Fano 不等式推得的最大理论可预测性。它描述在给定统计与假设下的上界,不是某个算法已经达到的准确率。
按照经典研究的高活跃筛选条件,主体数据只留下约 8,000 人,约占 180 万人的 0.44%。这些用户原始轨迹的平均理论可预测性约 81%,与另一研究数据的 93% 不同;跨地区、时期和数据源的差别不能自动归因于补全。
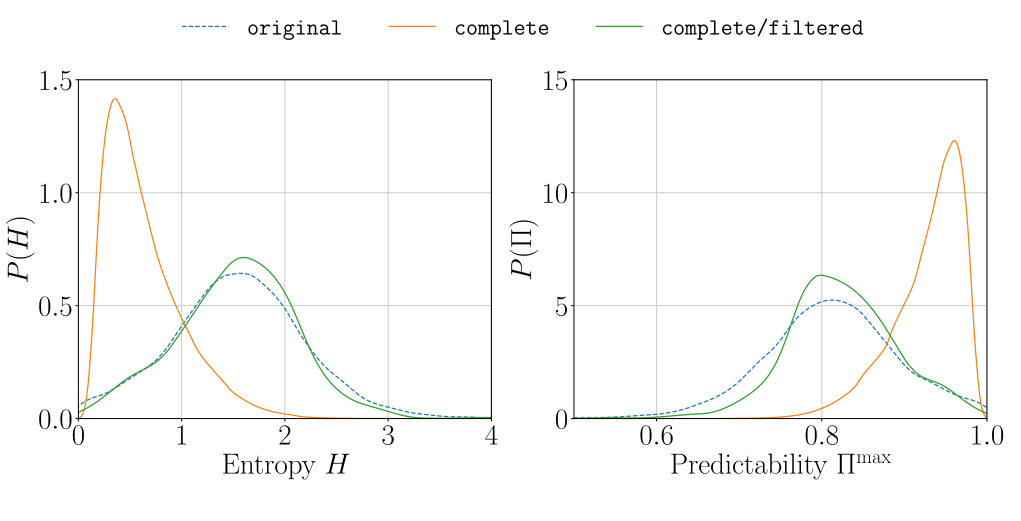
图 11|变化来自填空,还是来自终于纳入了不同的人?左图横轴为熵 H、纵轴为其密度;右图横轴为最大理论可预测性、纵轴为密度。蓝色虚线是筛选后 8,000 人的原始轨迹,橙色是约 170 万人的补全轨迹,绿色是同一批 8,000 人补全后的轨迹。橙色更低熵、更高可预测性,右图峰值约 94%;绿色仍接近蓝色,为人群选择起重要作用提供了对照。
作者解释为:频繁通信者往往更常移动,筛选他们会让样本偏向更难预测的人;扩大到多数较静态用户,整体上界就更高。匹配同一批人的对照比直接比较两种总样本更有说服力。
但它仍不是对所有插补偏差的彻底排除。特别是补全本来就利用规律性,轨迹低熵也可能部分受到模型约束。重建使用整段历史来补空,也不是在当时只用过去信息预测未来。约 94% 应读作该处理后人群的理论分布峰值,不能说已实现 94% 下一地点预测准确率。
补全的意义,是让遗漏与假设都变得可检查
这项研究最重要的提醒是:CDR 观测到的是通信事件,不是完整生活。把缺失直接当停留,或者只留下高活跃用户,都可能改变移动规律、隐私风险与可预测性的估计。
CTR 展示了一种可操作的补全框架和下采样验证。它保留更多用户,能在小时级、基站口径上产生相对接近参考轨迹的结果。但两周高频参考样本对三个月大人群的外推、居家与平滑假设、基站量化偏好,以及正则化参数选择,仍需要更完整的验证。原数据受保密协议限制未公开,也限制独立复现。
“完整”只是每个槽都有值。面对研究结论,还要继续检查这些值有多少是观测、多少是推断,以及换一套合理假设后结论是否稳定。
一句话总结
稀疏手机记录会同时遗漏位置和筛偏人群;CTR 能补出小时级轨迹并改变若干移动统计,但补全后的结果仍应作为带有模型假设的估计来检验。
核心来源
- Chen G, Viana AC, Fiore M, Sarraute C. Complete trajectory reconstruction from sparse mobile phone data. EPJ Data Science 8, 30 (2019).正式论文,DOI。全部图 1–11、表 1–2 与方法来自该文。
- González MC, Hidalgo CA, Barabási AL. Understanding individual human mobility patterns. Nature 453, 779–782 (2008).DOI。
- de Montjoye YA et al. Unique in the Crowd: The privacy bounds of human mobility. Scientific Reports 3, 1376 (2013).DOI。
- Song C et al. Limits of Predictability in Human Mobility. Science 327, 1018–1021 (2010).DOI。
图源集中说明:全部配图为 Chen 等原论文完整 Fig. 1–11,中文讲解按对应面板解释;原文以 CC BY 4.0 许可发布。
作者介绍
以下采用论文发表时的署名与贡献说明。
- Guangshuo Chen:INRIA、Université Paris-Saclay,以及 École Polytechnique、Université Paris-Saclay 署名作者,本文通讯作者;参与设计、数据收集分析及写作。
- Aline Carneiro Viana:INRIA、Université Paris-Saclay 署名作者;参与研究设计及写作。
- Marco Fiore:意大利 CNR-IEIIT,Torino 署名作者;参与研究设计及写作。
- Carlos Sarraute:美国 Grandata Labs,San Francisco 署名作者;参与数据收集分析及写作。
延伸思考:把推断位置和观测位置分开保存
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
设想规划者用补全轨迹估计夜间公交需求。算法把许多没有通信记录的夜晚补成家,结果可能低估夜班人群;若随后又用这批补全结果证明夜间出行很少,假设就被当成了证据。
一种值得采用的数据实践是,为每个位置保留来源标记:原始通信观测、规则补齐、张量估计,以及可用的不确定性信息。研究者可以分别报告只看观测、采用不同夜间规则、改变平滑强度后的结果,看看政策相关结论是否稳定。
模型让原本被排除的人重新进入分析,是有价值的;让他们以被算法过度规律化的方式进入,又可能产生新的误差。真正需要争取的,是既不因数据稀疏抹掉少数人,也不因补全方便抹掉少数人的非典型生活。