上班、求职和搬家,能用同一套目的地选择规则解释吗?
论文名片|Er-Jian Liu、Xiao-Yong Yan,A universal opportunity model for human mobility,Scientific Reports,2020,10:4657,2020年3月13日发表。DOI:10.1038/s41598-020-61613-y。
每天上班,远十公里可能意味着长期增加通勤负担;几年才搬一次家,远一点却可能换来更有吸引力的机会。两种选择都在比较目的地和代价,但“附近有什么”所起的作用未必一样。
这篇论文把差别写成两个参数,提出统一机会模型UO(universal opportunity model)。它把辐射模型、机会优先选择模型等作为特殊情形,用同一个公式家族拟合通勤、货运、求职、迁移和日常出行。这里的统一,是数学框架统一;14组数据各自寻找参数,并不是一组参数不经调整就适用于所有出行。
先说结论
- UO用两个受约束参数调节探索倾向与谨慎倾向,三个角点分别对应辐射模型、机会优先选择模型和仅机会模型。
- 14组数据涵盖不同地区与空间尺度。以SSI拟合地区间流量矩阵时,UO均取得最高分,但部分数据的改善很小,且模型已经包含对照模型的特殊情形。
- 在均方根误差RMSE上,UO多数较好,匈牙利通勤与中国城际出行两组却是OPS更低,不能写成所有指标全面胜出。
- 这些参数来自群体流量拟合,没有直接测量每个人的心理偏好;模型重现流量的表现,也不等于已经证明人的真实决策过程。
不只问目的地有多远,也问沿途有多少机会
介入机会(intervening opportunities)指比候选目的地更靠近起点的其他地点所提供的机会总量。假设两个人都考虑20公里外的工作,一人附近有许多潜在岗位,另一人附近几乎没有,两人的选择环境就不同。模型用这种机会布局补充单纯距离,而不是认为地理距离从此没有作用。
对起点i和目的地j,记起点机会数为mᵢ、目的地机会数为mⱼ,较近其他地点的机会总数为sᵢⱼ。机会的收益被假设来自同一分布,通过比较抽样得到的最高收益形成选择规则。这是模型假设,不是已经逐个调查过所有岗位的实际工资或居民的主观效用。
UO把一部分介入机会纳入需要被目的地超过的比较门槛,另一部分用于刻画“近处机会仍不及起点”的条件。两个参数α、β都非负,且α+β≤1。α越大,模型倾向保留较远的潜在目的地,称为探索倾向;β越大,近处满足条件的目的地更有优势,称为谨慎倾向。
为了把比较规则变成可计算流量,论文推导出未归一化权重:
Qᵢⱼ=(mᵢ+αsᵢⱼ)mⱼ ÷ { [mᵢ+(α+β)sᵢⱼ] [mᵢ+(α+β)sᵢⱼ+mⱼ] }。
将一个起点到所有目的地的Q相加,再各自除以这个和,就得到选择概率Pᵢⱼ。若已知从i出发的总流量Oᵢ,预测流量为Tᵢⱼ=OᵢPᵢⱼ。因此模型需要出发总量,并非只知道地理坐标就能推断所有地区产生多少次出行。
两个参数怎样连接三种旧模型?
| 参数组合 | 对应模型 | 比较规则的核心 |
|---|---|---|
| α=0,β=1 | 辐射模型 radiation | 目的地优于起点,而较近其他机会尚不及起点 |
| α=1,β=0 | 机会优先选择 OPS | 目的地优于起点及较近机会的最高比较门槛 |
| α=0,β=0 | 仅机会 OO | 比较起点和目的地,不纳入介入机会排序 |
补充材料S1—S3分别给出三种情况的积分推导。三种模型不是随意并列的算法,而是同一公式在参数角点上的结果。OO的权重仍为mⱼ/(mᵢ+mⱼ),不能简单改写成只与目的地人口成正比。
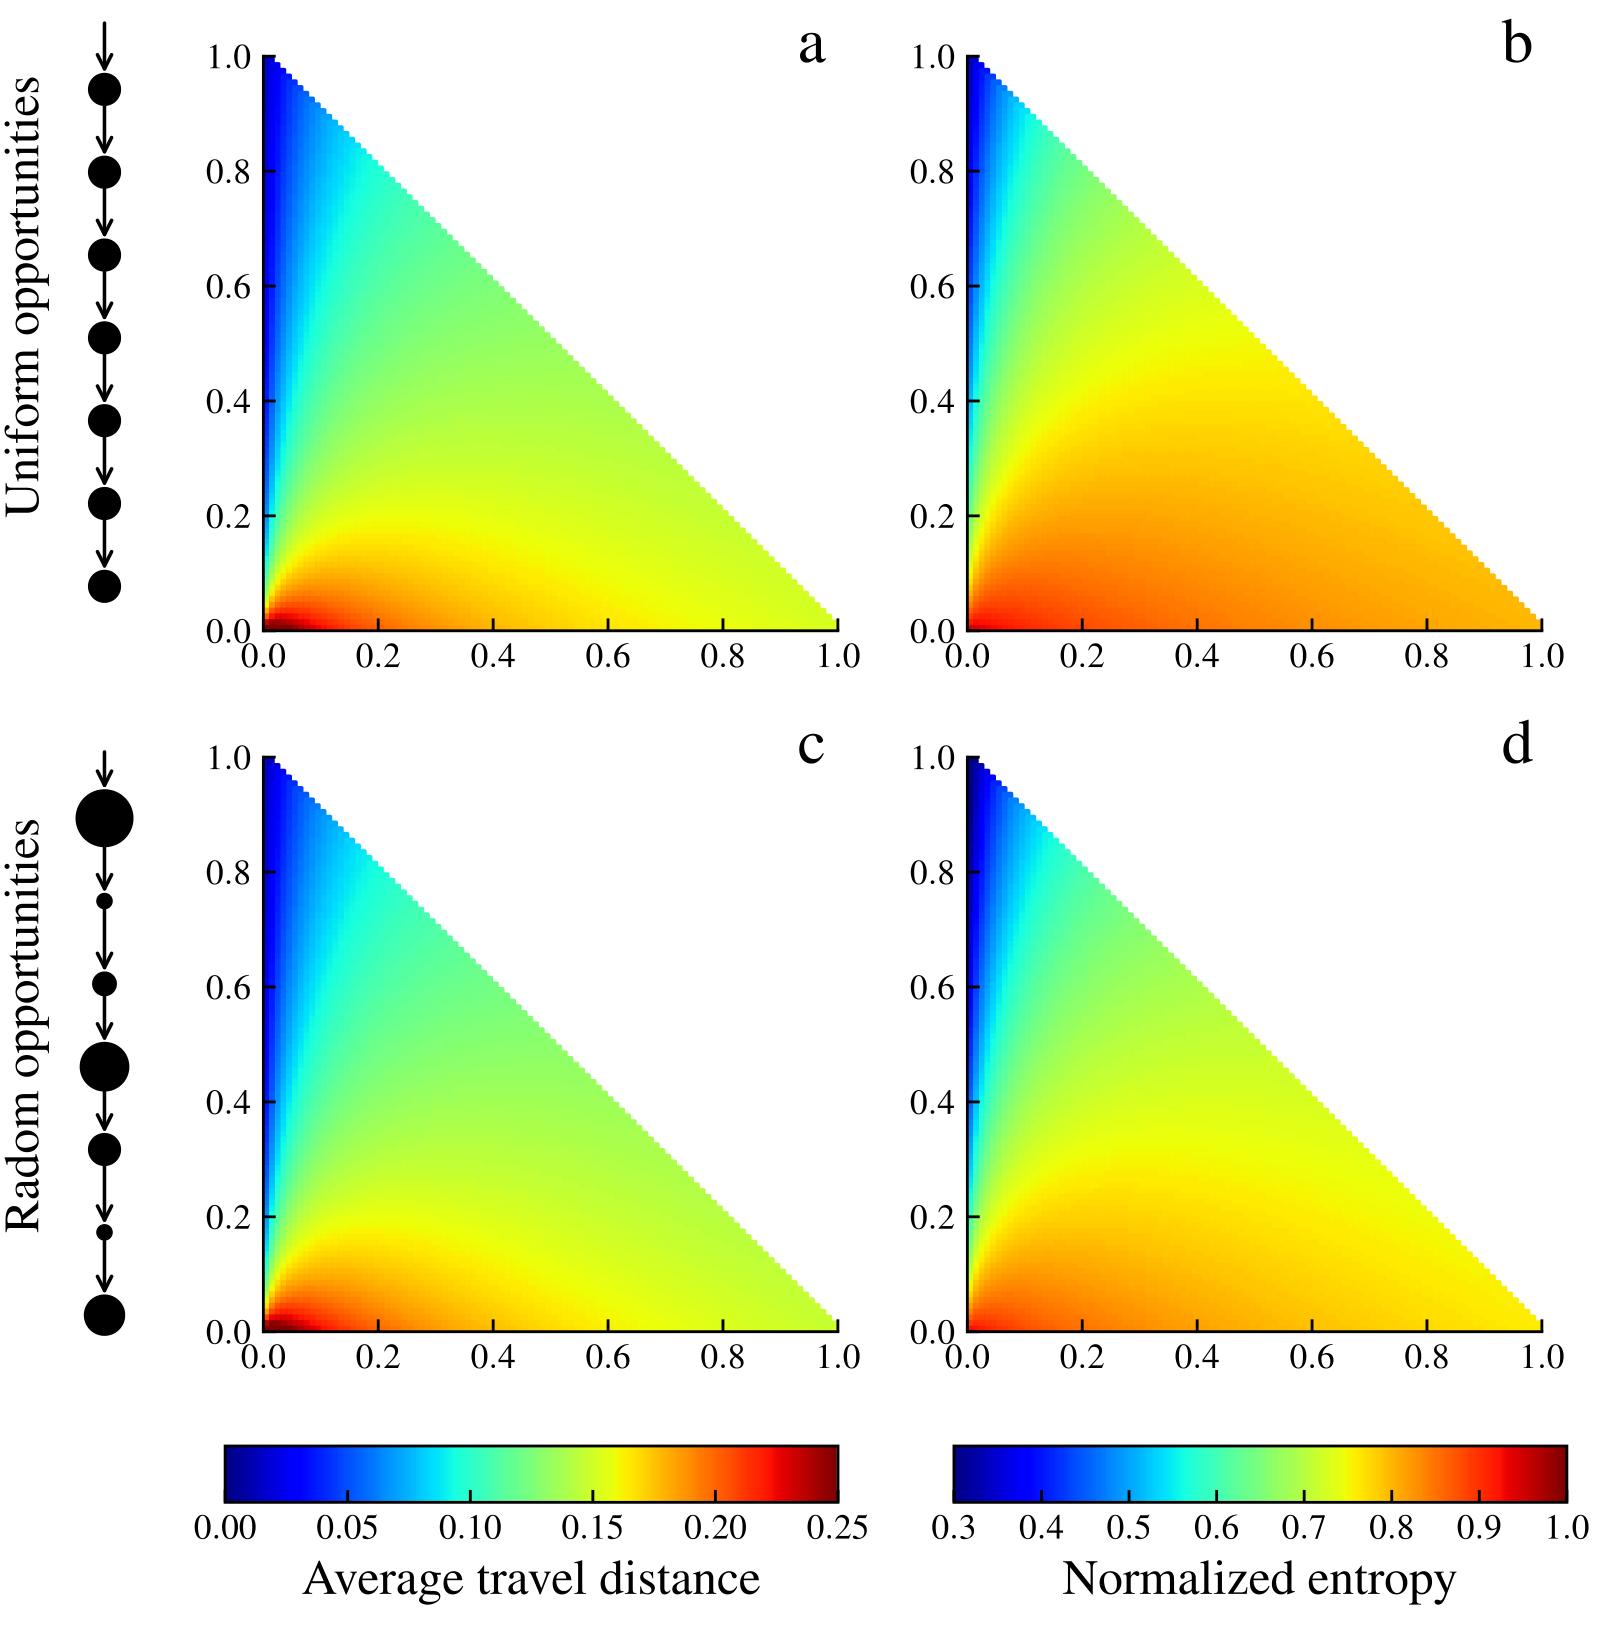
图 1|探索和谨慎会怎样改变距离与选择分散程度?
(a、b)机会数采用均匀分布,分别显示平均距离与归一化熵;(c、d)机会数改为随机分布,显示同样两个指标。各三角横轴为α、纵轴为β,可行区满足两者之和不超过1;颜色对应下方指标,熵较大表示目的地概率更分散。来源:原论文 Fig. 1。
在这组设定中,辐射角点附近平均距离最短,OO角点附近最长。增大探索参数可以增加远目的地被选择的机会,但最长距离并不出现在“探索参数最大”的角点:完全不考虑介入机会排序时,远近限制进一步减弱。这个结果提醒,两个参数需要联合解释,不能只按名字作线性联想。
原文归一化熵公式的分母写法存在不清楚之处,与图中正值尺度不能直接对应;这里依据图的比较方向解读,不把该排版公式当作可直接照用的计算定义。
14组数据,分别代表哪一种移动?
研究先从数据提取地区i到j的真实流量,构成OD矩阵,再比较模型生成的矩阵。不同数据源的一个单位记录并不相同,不能将所有流量直接加总。
| 类别 | 数据与缩写 | 主要记录或空间单位 |
|---|---|---|
| 通勤 | 美国USC、意大利ITC、匈牙利HUC | 县、省、次区域之间的居住地—工作地流量 |
| 货运 | 中国CNF | 2015年5月19—23日货车装卸GPS记录,聚合到城市 |
| 求职 | 中国CNJ | 2006—2016年招聘简历中的工作经历,聚合到城市 |
| 迁移 | 美国USM | 2011—2012年IRS税务迁移资料,聚合到州 |
| 城际出行 | 中国CNT、美国UST、比利时BLT | 微博、Foursquare、Gowalla签到,聚合到城市 |
| 城内出行 | 苏州SZT、北京BJT、深圳SHT、伦敦LOT、柏林BET | 手机记录、出租车上下客或签到,聚合到网格 |
中国求职资料称来自超过1.6亿份简历,不能把简历数量等同于经过独立去重的求职人数。美国税务迁移也只反映其统计覆盖的人群,不是对所有搬家的全量普查。
城内通常划分1公里网格,苏州使用0.01经度×0.01纬度网格。手机事件、出租车乘客和平台签到覆盖的群体及活动都不同。这样的多来源比较有助于考察公式的适用范围,同时也意味着参数差异可能包含观测方式和区域划分的影响。
拟合出来的差异,是否符合出行直觉?
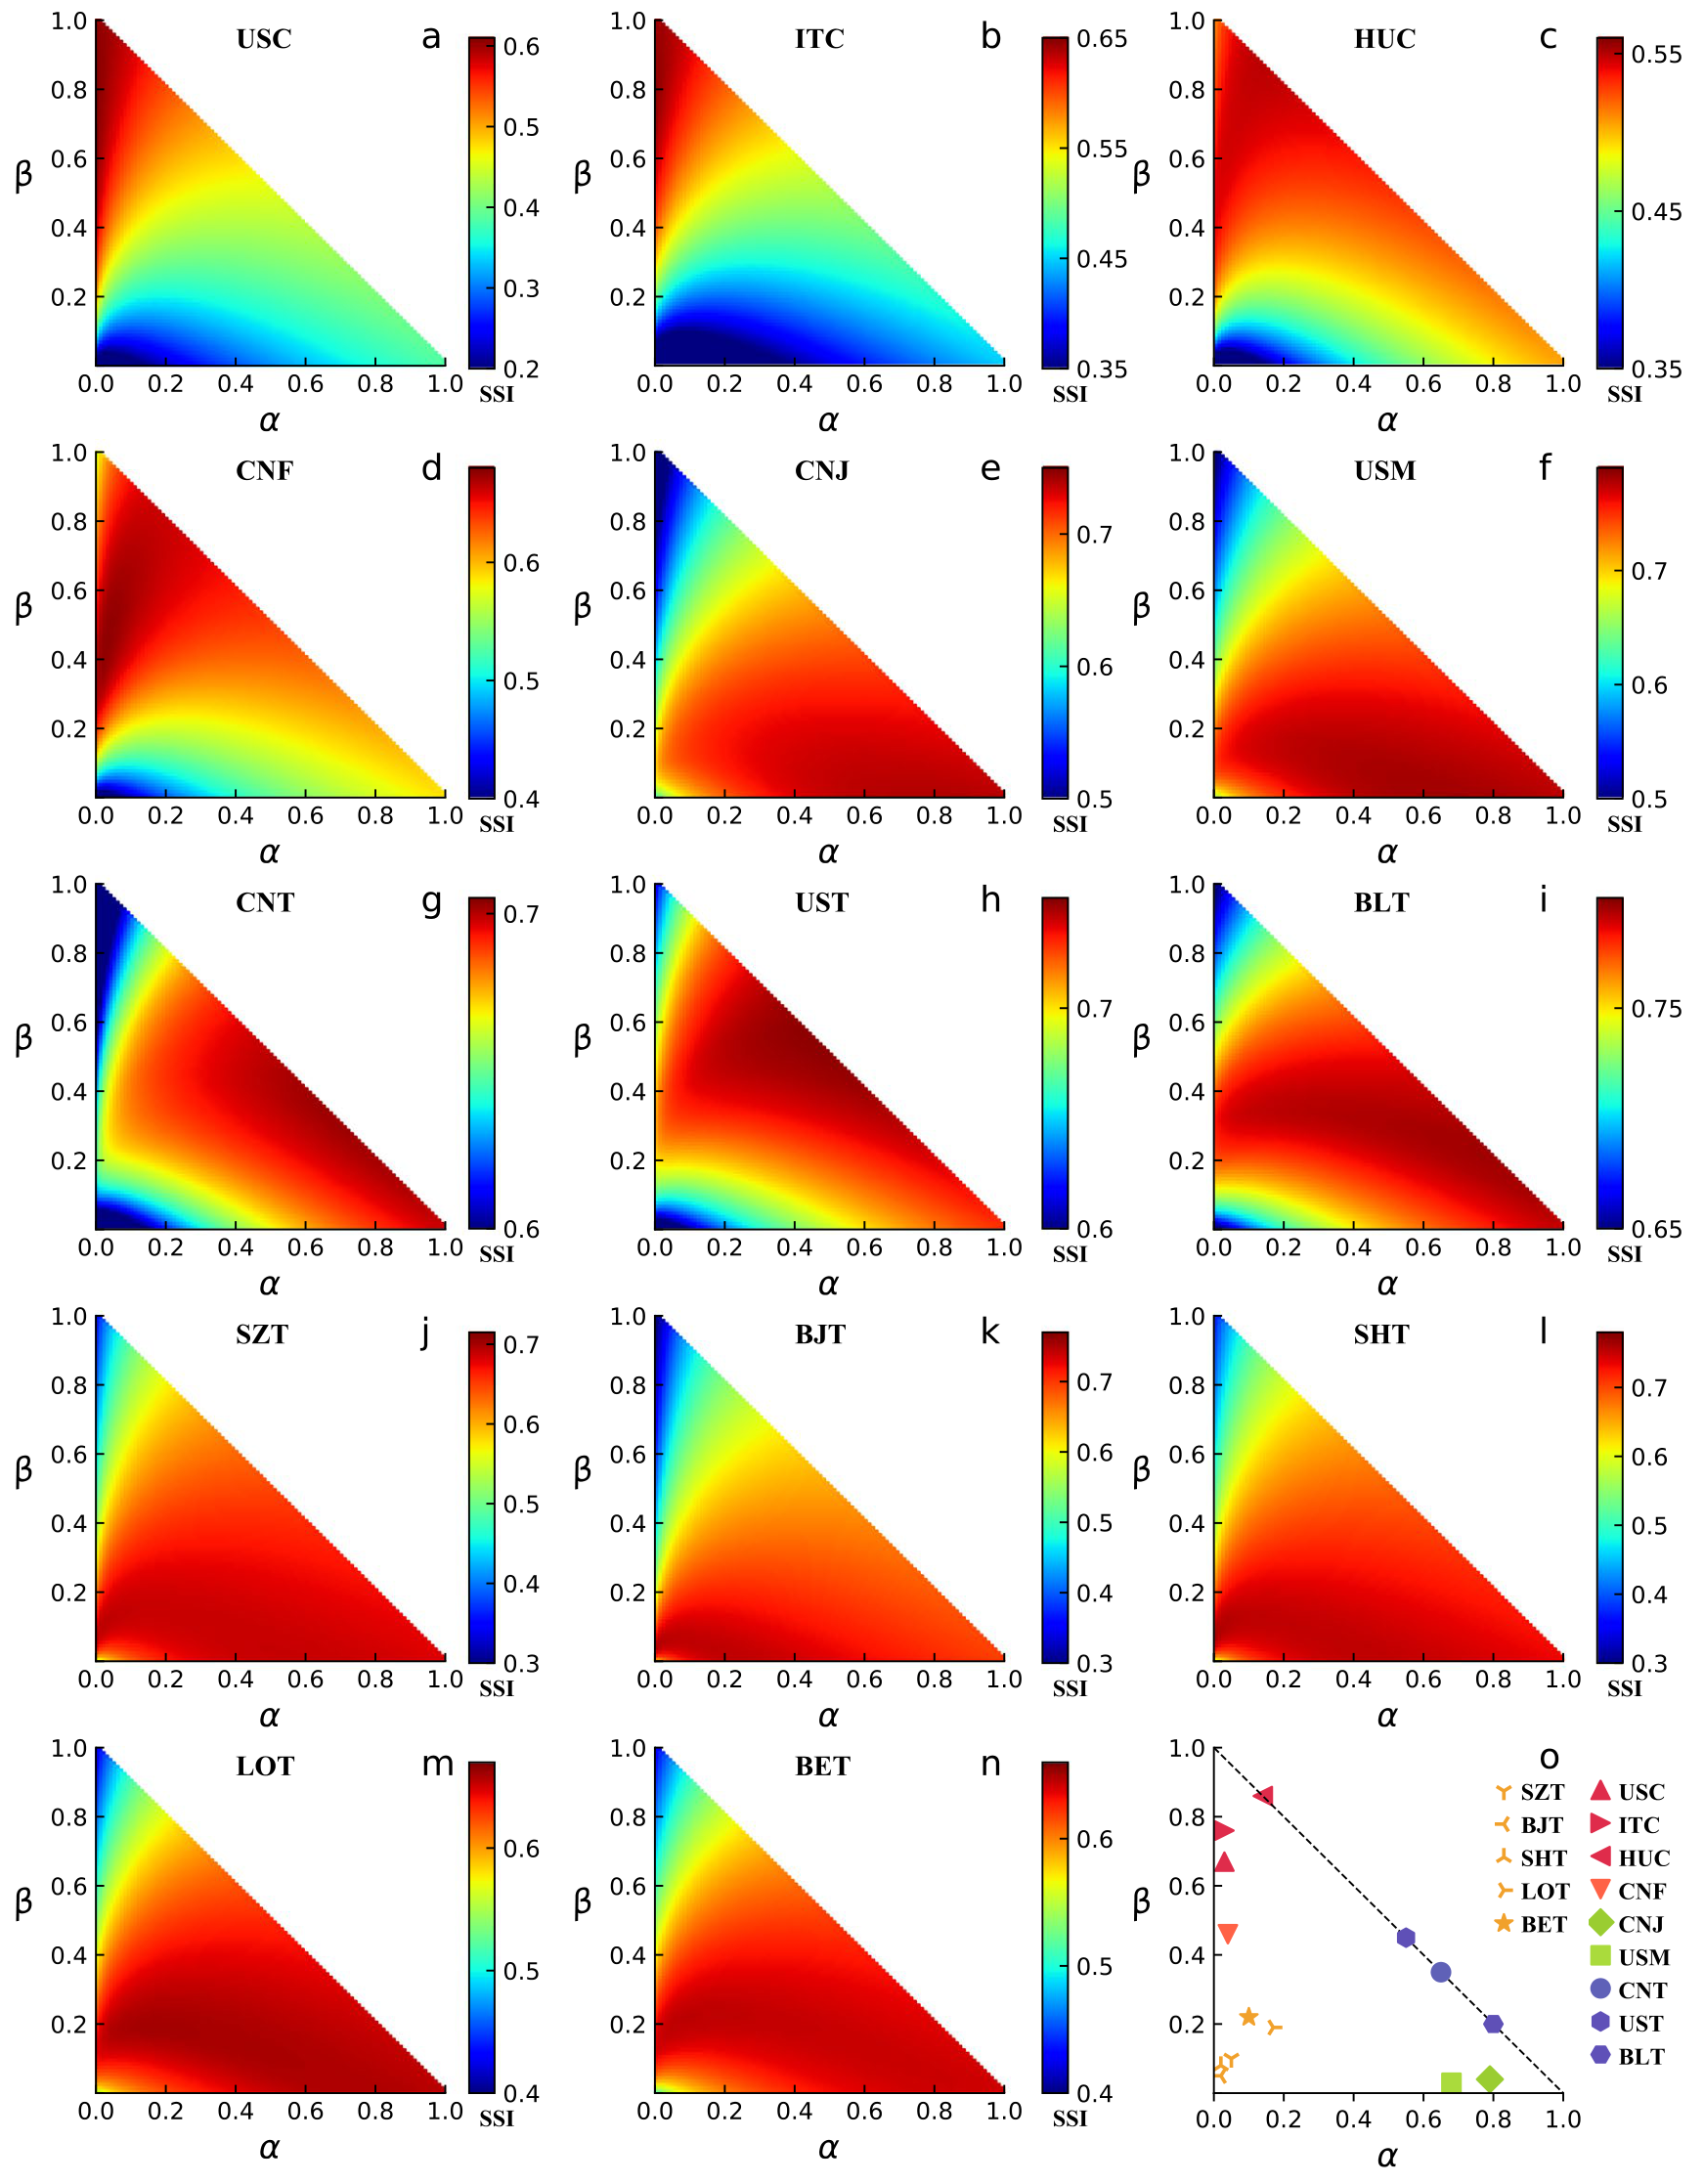
图 2|不同出行数据在同一个参数空间里落在哪里?
(a、b、c)美国、意大利、匈牙利通勤;(d)中国货运;(e)中国求职;(f)美国迁移;(g、h、i)中国、美国、比利时城际出行;(j、k、l、m、n)苏州、北京、深圳、伦敦、柏林城内出行。各面板横轴α、纵轴β,颜色为SSI,色阶按面板分别设置;(o)汇集各数据最高SSI对应的参数。来源:原论文 Fig. 2。
通勤与货运较靠近谨慎侧,求职和迁移更靠近探索侧,城际出行多在两者之间,城内数据的两个参数通常较小。论文解释,频繁通勤和货运对距离成本较敏感,迁移与求职更可能接受远处高收益机会。这是与结果相容的解释,而非通过问卷直接识别了个人的成本权衡。
特别是城内α、β都小,表示在当前机会代理、空间范围和数据来源下,弱介入机会效应较能拟合流量;不能由此推断城内居民不在乎路程、时间或费用。参数并未把这些因素逐一测量并排除。
这里使用的Sørensen相似性指数SSI,是对地区对之间的预测与真实流量重合度进行平均。每对的核心分数为2×较小流量÷两者流量之和,越接近1表示越相符。它与把全部流量先求和再算一个重合比例不同,也不是个体选择被猜中的百分比。原文未明确双零流量地区对的处理细节,精确复现时仍需统一该约定。
“全部最高”,是多大的改善?
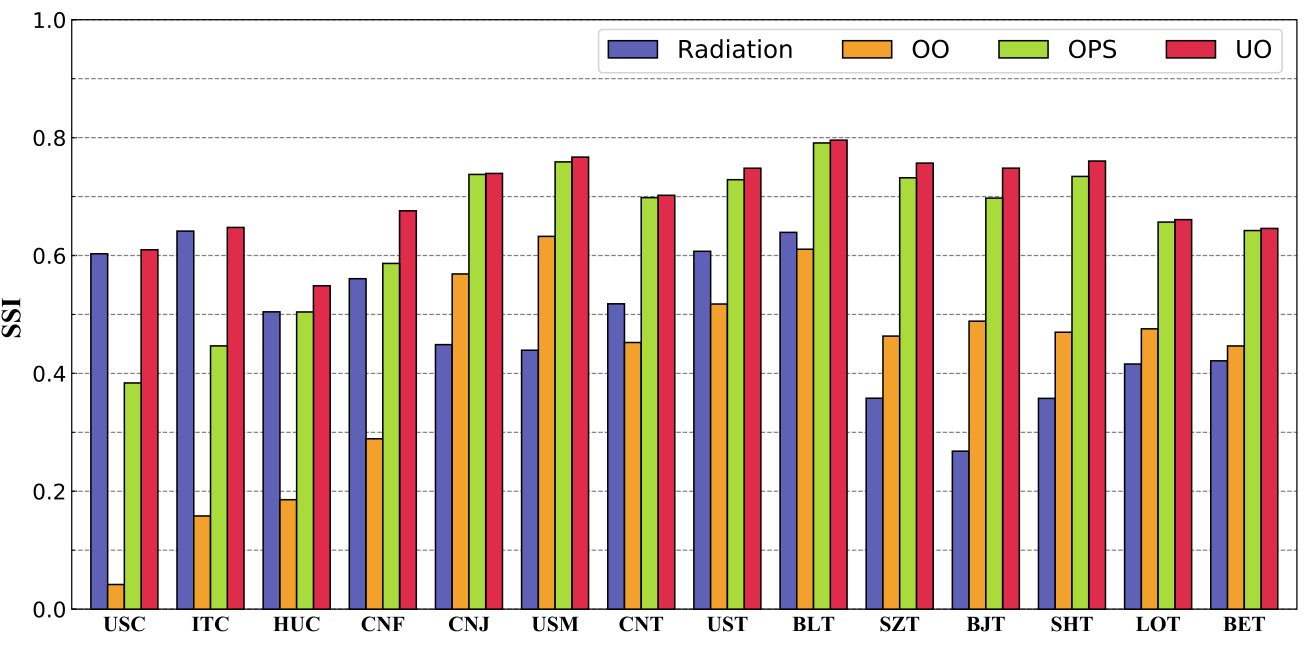
图 3|统一框架在哪些数据上增加得多,哪些只是略好?
横轴为14组数据缩写,纵轴为SSI,蓝、橙、绿、红分别为辐射、OO、OPS、UO;原图没有子图字母。UO各组最高,但相对最强对照的差距随数据而变。来源:原论文 Fig. 3。
表1提供了精确值。以下几组说明为何不能只看谁排第一:
| 数据 | UO SSI | 辐射 SSI | OPS SSI |
|---|---|---|---|
| 美国通勤USC | 0.610 | 0.603 | 0.384 |
| 中国货运CNF | 0.676 | 0.561 | 0.587 |
| 中国求职CNJ | 0.739 | 0.449 | 0.738 |
| 美国迁移USM | 0.767 | 0.434 | 0.759 |
| 北京城内BJT | 0.748 | 0.268 | 0.697 |
| 伦敦城内LOT | 0.661 | 0.416 | 0.657 |
与辐射模型相比,求职和部分城内场景增加很大;与更适合该场景的OPS相比,中国求职只增加0.001,伦敦增加0.004。未提供误差区间时,不宜把这些很小的分数差都解读成明确的实质性优势。
还有一个数学上重要的比较条件:UO已包含三种对照的参数角点,又按每组数据的SSI选择最优参数。如果在同一批数据上优化并比较SSI,它原则上至少可以回到某个对照角点。因此全部最高部分体现了更灵活的模型家族,不是完全独立的泛化检验。论文未在这里设置新的地区或时间留出集,也没有为参数自由度施加相同复杂度惩罚。
表1还报告RMSE,即预测流量与实际流量差的均方根。多数数据UO较低,但匈牙利通勤为477.254、OPS为429.377,中国城际出行为441.063、OPS为438.463,后者更低。优化SSI不保证同时最小化RMSE;二者关注的误差方式也不同,不能用一个指标覆盖另一个指标的例外。
平均分之外,流量大小分布是否也合理?
三张补图逐一比较地区对流量。每张都是完整的原组合图,横轴为模型流量、纵轴为观测流量,均用对数刻度;灰点表示地区对,蓝点和箱线概括分箱后的分布,斜线为两者一致的参照。绿色、红色区分箱线与参照线的相容情况。由于原图图注对分箱说明与轴向的表述不完全一致,下面依据实际坐标解读,不据此扩展未定义的分位数结论。
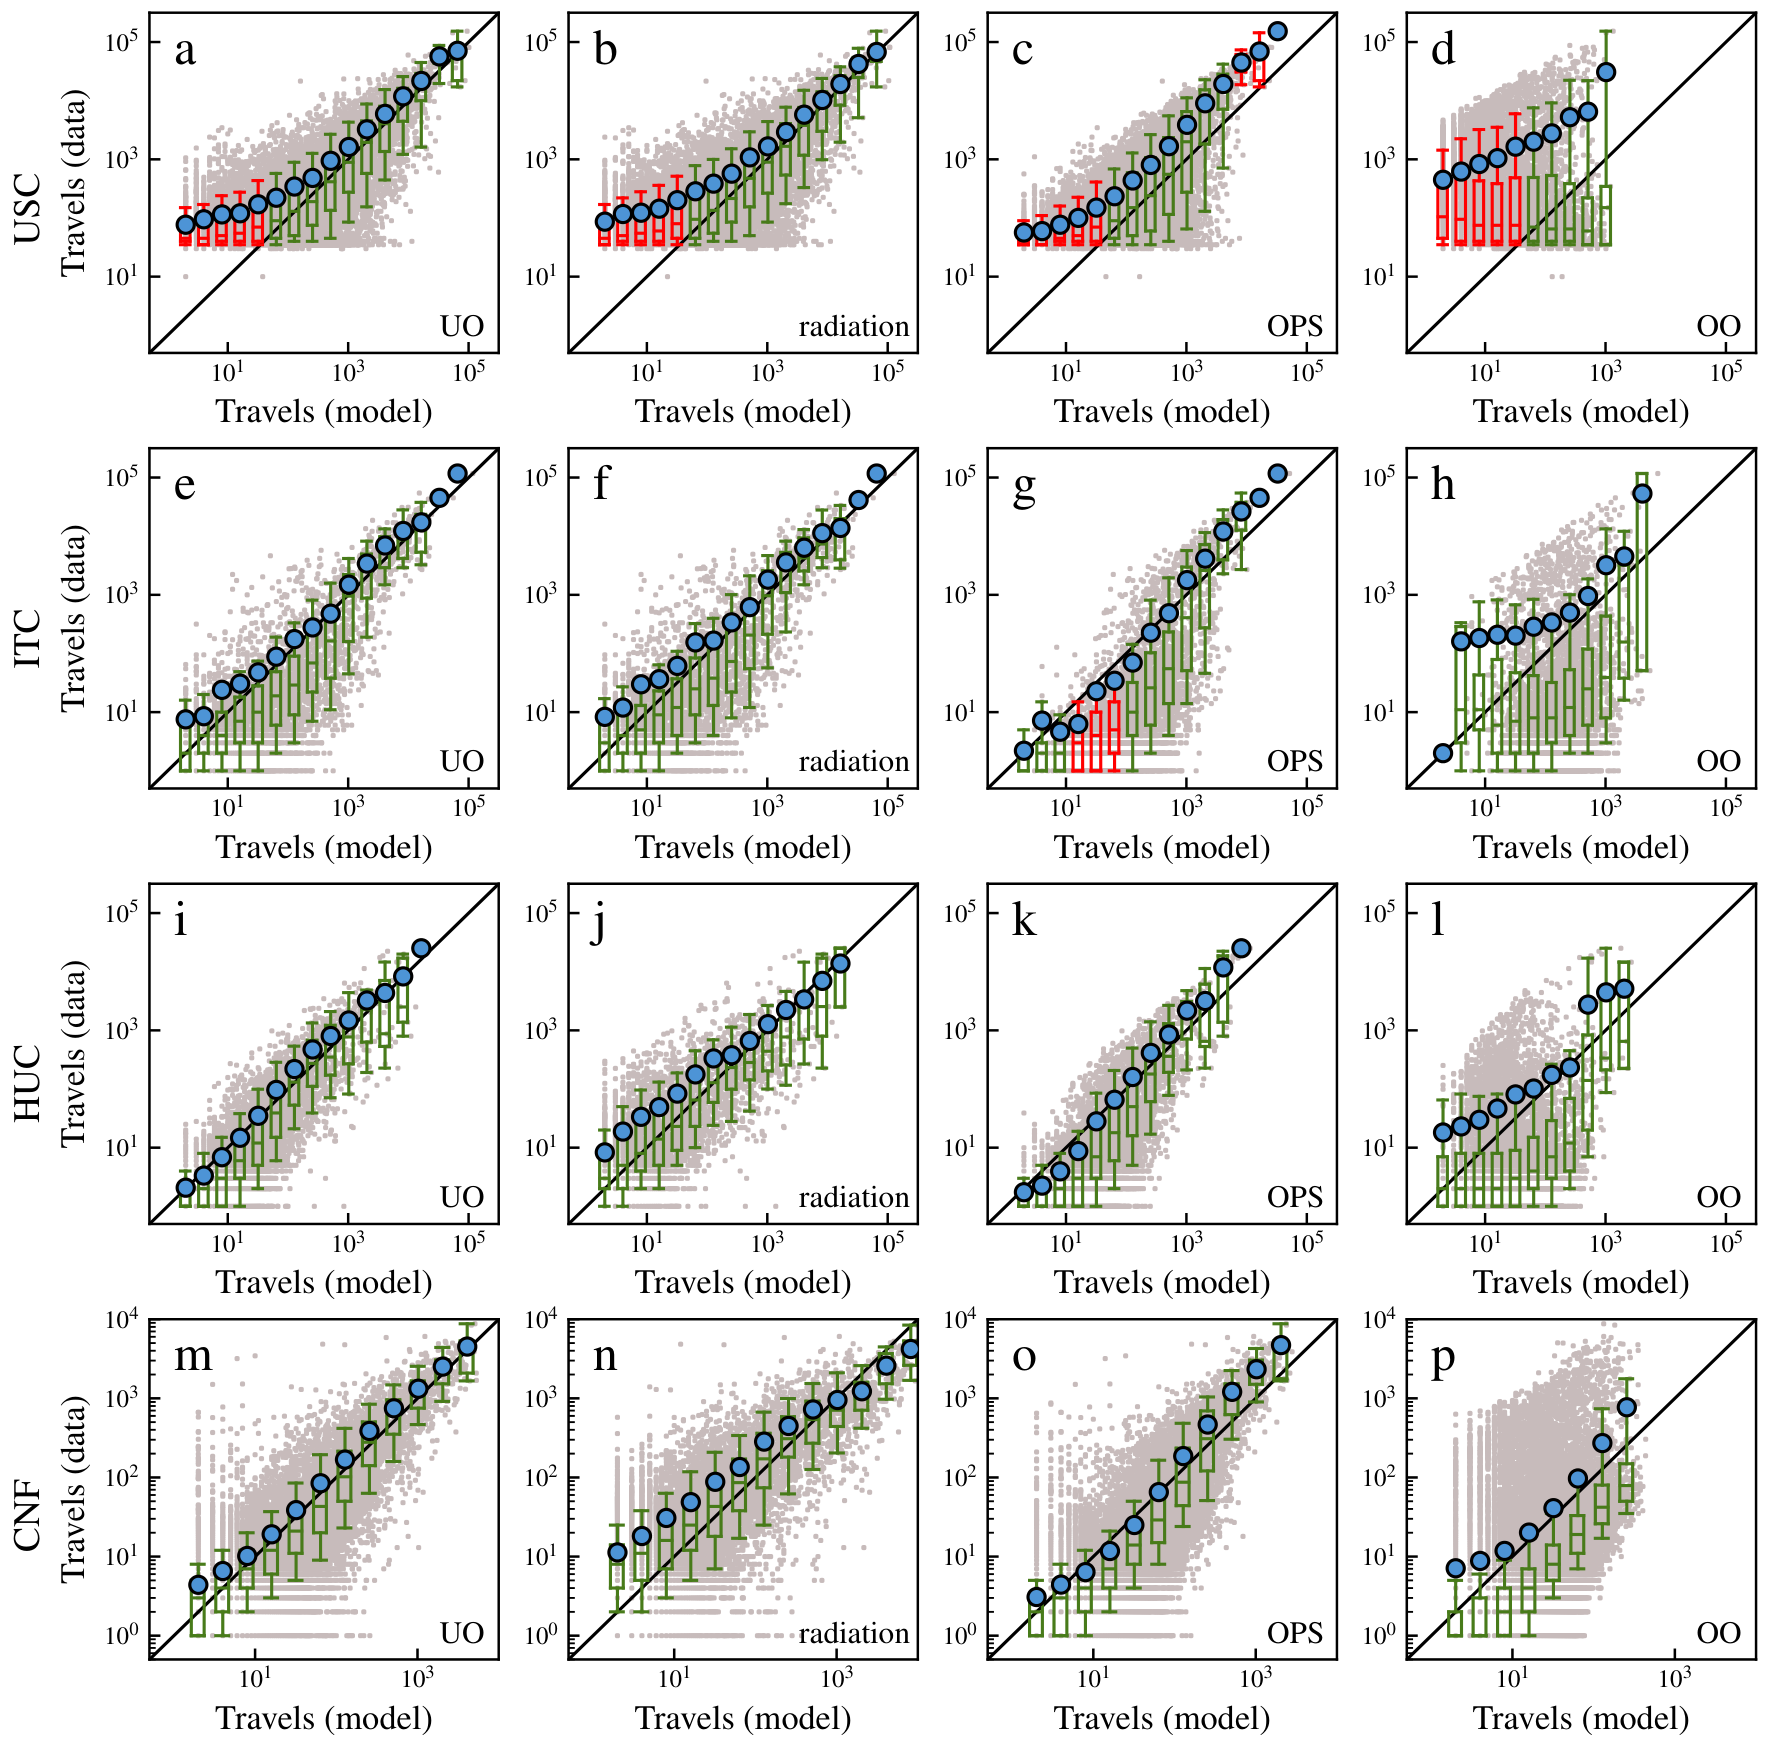
图 S1|通勤和货运中,四种模型的偏差在哪里?
四行分别为美国通勤(a—d)、意大利通勤(e—h)、匈牙利通勤(i—l)和中国货运(m—p)。每行依次为UO(a、e、i、m)、辐射(b、f、j、n)、OPS(c、g、k、o)、OO(d、h、l、p)。辐射在通勤中与UO较接近,OO有明显系统偏移;不同流量段仍存在散布。来源:原论文 Supplementary Fig. S1。
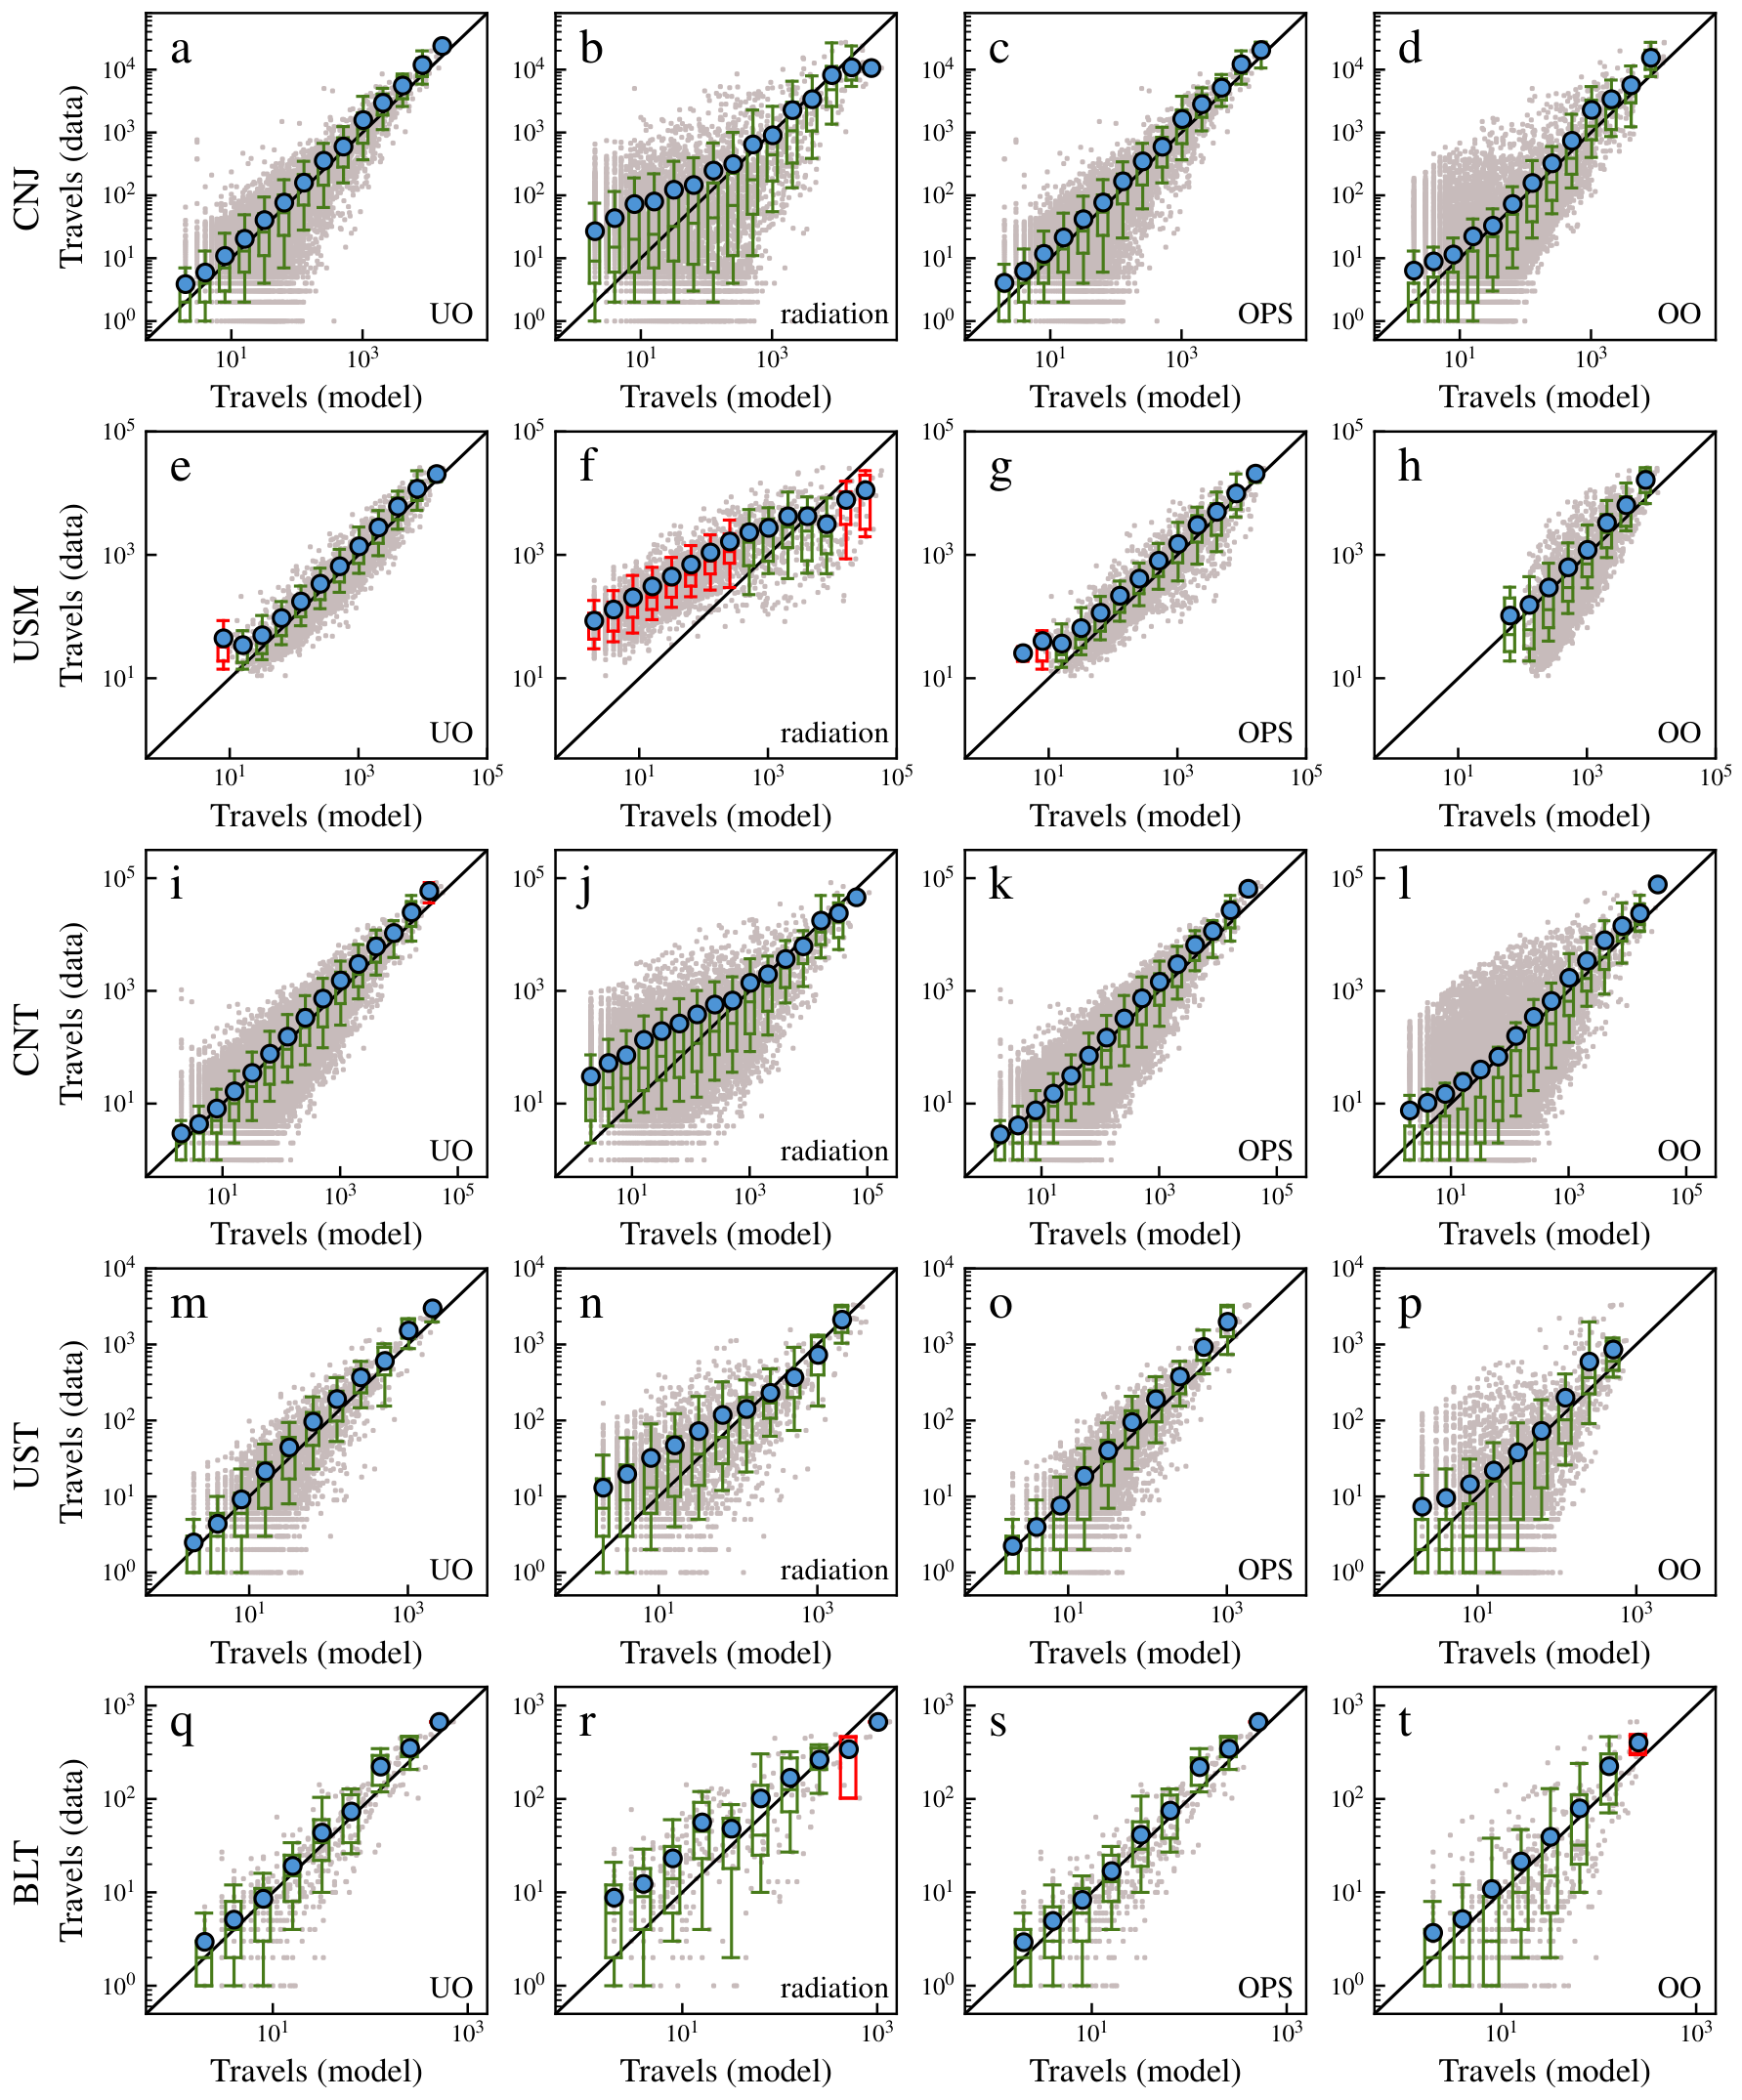
图 S2|为什么通勤表现好的模型不一定适合迁移?
五行依次为中国求职(a—d)、美国迁移(e—h)、中国城际(i—l)、美国城际(m—p)、比利时城际(q—t)。UO为(a、e、i、m、q),辐射为(b、f、j、n、r),OPS为(c、g、k、o、s),OO为(d、h、l、p、t)。UO与OPS在多组数据较接近,辐射在求职、迁移等组偏差较明显。来源:原论文 Supplementary Fig. S2。
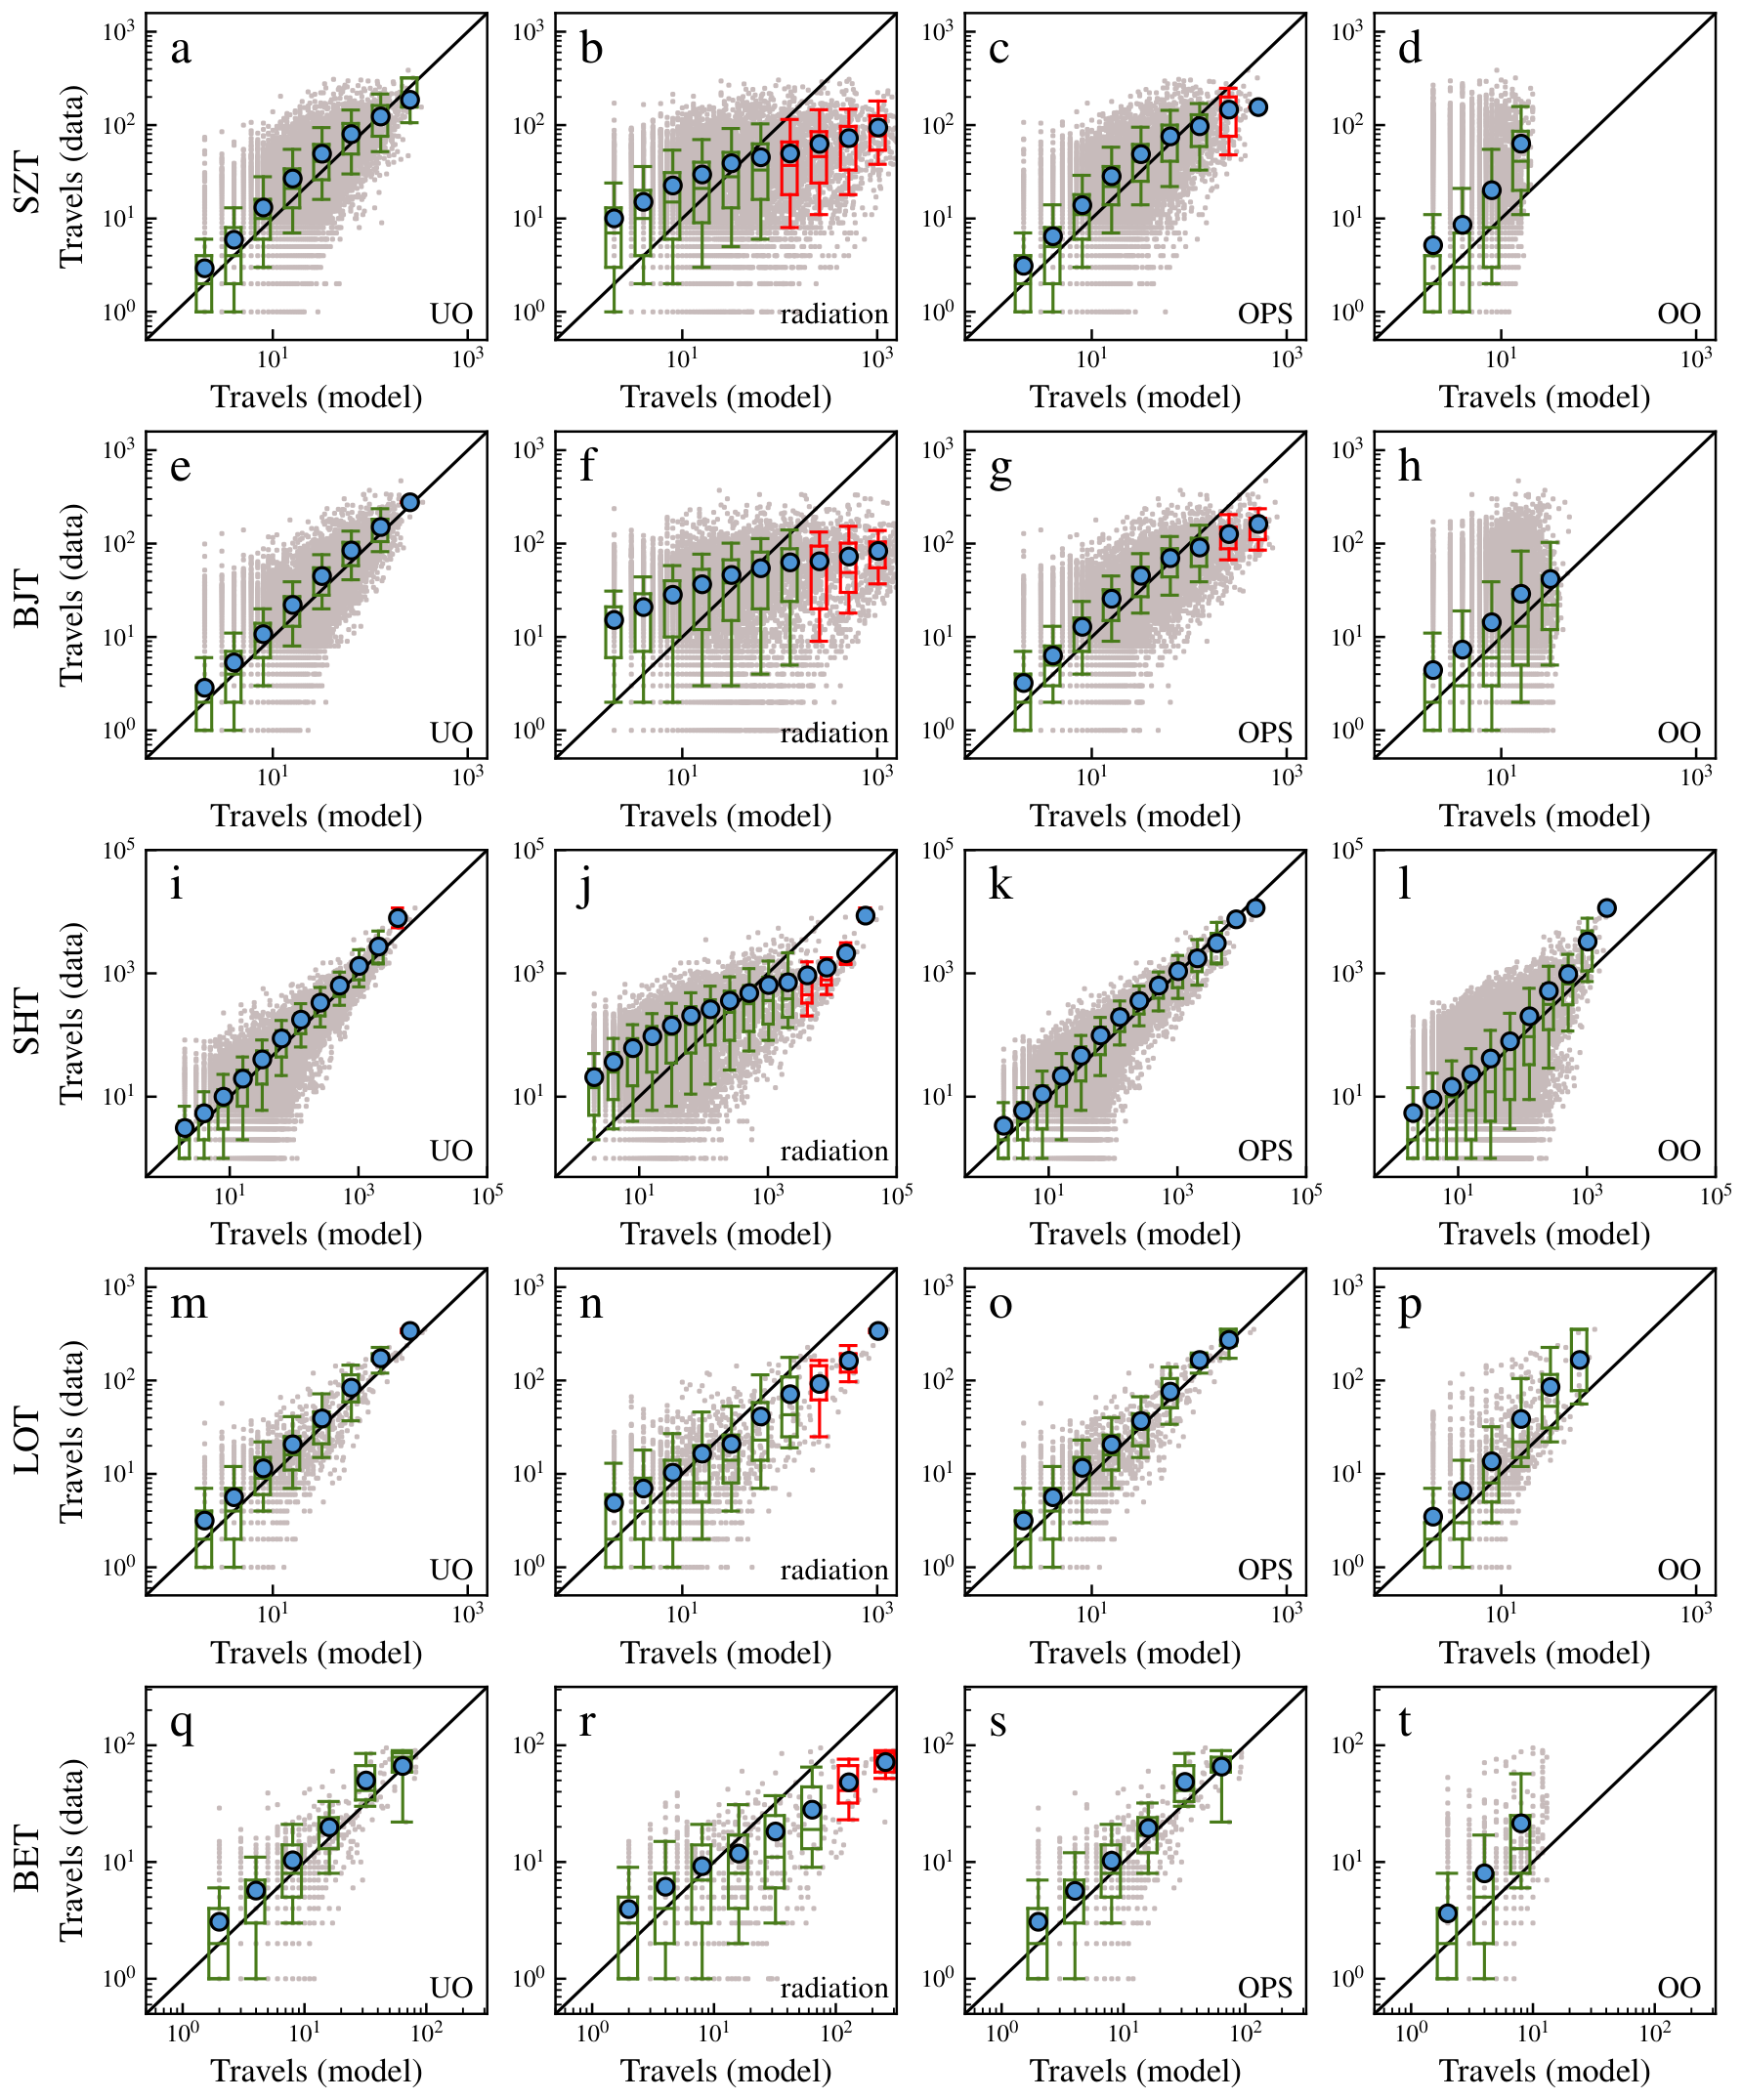
图 S3|城内不同数据源,是否都出现相同的拟合难点?
五行分别为苏州(a—d)、北京(e—h)、深圳(i—l)、伦敦(m—p)、柏林(q—t)。UO为(a、e、i、m、q),辐射为(b、f、j、n、r),OPS为(c、g、k、o、s),OO为(d、h、l、p、t)。UO的分箱概括较贴近一致线,但灰点仍显示同等模型流量对应的实际流量可有较大差异。来源:原论文 Supplementary Fig. S3。
补图支持的是平均或分箱层面的相符程度改善,不能推成每条OD连接都准确。大流量、小流量及稀疏连接的误差仍需按具体应用检验;若用来配置某个交通走廊,仅看整体SSI还不够。
这个“统一”,应该怎样使用?
UO给出的价值,是用同一个可解释公式连接不同机会比较规则,再让数据提示哪个区域更适合。它减少了为每类移动完全另造一套公式的需要,也让辐射模型在通勤中的长处、在其他场景的边界更清楚。
局限同样来自这种概括:每组数据由一个代表性主体和一组参数描述,没有显式表示个人偏好差异。机会量的代理、目的地集合和区域划分都会影响介入机会总数。模型名称中的普遍性应理解为本文检验的多场景框架,不能当作任意尺度、任意个体都已验证的定律。
论文讨论了疾病传播和社会关系选择的潜在应用,但没有在这里完成疫情干预或社交网络结果验证。它重现的是群体流动矩阵,这与证明社会行为机制、预测某个人的决定及评估政策效果之间仍有距离。
一句话总结
统一机会模型把不同目的地比较规则连成一个参数家族;多场景拟合更灵活,但其行为解释与泛化能力仍需独立数据检验。
核心来源
- Liu, E.-J. & Yan, X.-Y.(2020). A universal opportunity model for human mobility. Scientific Reports, 10, 4657。论文与补充材料,DOI。本文依据正文公式1—10、表1及补充推导S1—S4;主图1—3和补图S1—S3均保留完整原组合。
作者介绍
按原论文发表时署名介绍,不推断当前任职与职称。
- Er-Jian Liu:北京交通大学交通运输部综合交通运输大数据应用技术交通运输行业重点实验室及交通系统科学与工程研究所署名作者。
- Xiao-Yong Yan:北京交通大学交通系统科学与工程研究所、电子科技大学Complex Lab署名作者,本文通讯作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
可以把一座城市或一个年份完整留出,只在其余数据中估计参数,再看模型在新环境是否仍优于各个角点。这样的测试可以区分公式家族更灵活与参数确实具有可迁移含义,也能判断“同类出行共享参数”是否比逐组重新拟合更有用。
另一个检验是改变机会代理。例如同一组通勤,分别用总人口、工作岗位数和按行业筛选的岗位数构造机会。如果最优参数发生很大变化,就说明所谓谨慎或探索还混合了机会测量差异;比起直接解释人更大胆,先改善机会定义可能更有帮助。