一条看起来很真的虚拟轨迹,怎样才算真的有用?
论文名片|Vaibhav Kulkarni、Natasa Tagasovska、Thibault Vatter、Benoit Garbinato,Generative Models for Simulating Mobility Trajectories,NIPS 2018 的 Workshop on Modeling and Decision-Making in the Spatiotemporal Domain,Montréal;本文版本为 2018 年 11 月 30 日提交的 arXiv:1811.12801v1。原文,arXiv DOI。
要测试一个交通或地理信息算法,往往需要许多人的长期位置数据。真实轨迹难以公开,于是有人提出:让生成模型造一批虚拟居民,既保留移动规律,又不暴露原来的人。
难点是,“像真的”可能指好几件不同的事。一条线贴着道路,不代表一天的停留安排合理;常去地点比例相似,不代表相隔很远的两段行为仍有关联。更棘手的是,合成数据越像原始人群,也未必越容易保护参与者。
这篇短篇工作坊论文比较七种生成方法,把评估拆成统计相似性、时间依赖、可视化轨迹与攻击测试。它提出的是初步比较证据,没有完成可直接用于安全发布的通用方案。
主要发现有四点:
- 在本文一套瑞士移动数据的实验中,非参数 Copula 的分布距离最低,报告的拟合与生成时间也最短。
- 不同评估会给出不同印象:热门地点比例接近,并不保证位置—时间联合分布、长程依赖都同样接近。
- GAN、Copula 和 RNN-LSTM 的互信息衰减被作者解释为保留了长程依赖,但各曲线仍与真实样本不同。
- 隐私攻击得分与统计效用存在张力;本文没有差分隐私保证,也没有证明生成轨迹可以不经额外评估就公开。
旧模拟器的不足,为什么会引出生成模型?
论文表 1 将已有轨迹生成器分成四类:自由移动、道路网络、多环境与序列模型。自由移动方法设定速度、方向或分布;道路网络模拟器利用路长、通行能力与路径;多环境系统连接街道、建筑和行程;Markov 或半 Markov 方法根据状态转移与停留生成路径。
这些方法各有用途,但预先指定少数参数,不保证自动出现真实人群的长期序列规律。例如,每一段速度和转角都合理,不代表生成的人会按合理频率回到旧地点。本文因此从真实数据中学习,再生成新轨迹。
这不意味着所有传统模拟器都用同一种优化算法,也不意味着神经网络一定优于领域模型。论文的实验比较对象是七种学习式生成方案,并未把表 1 全部系统放到同一实验中重新跑分。
七种方法分别学什么?
实验使用瑞士采集的 Nokia mobile dataset,报告用 7,000 万个数据点训练模型。原始序列由经纬度和时间戳组成;研究先用 Google S2 空间编码投影到网格,以地点单元编号和时间戳表示轨迹,再把生成结果映射回坐标。
7,000 万是观测点数,不是人数或独立行程数。论文未完整报告实际纳入用户数、观测期、网格层级、生成轨迹总量与独立训练测试划分;不能把这些点默认当作独立样本。
| 方法 | 本文比较中的基本思路 |
|---|---|
| Char-RNN | 用简单循环结构处理地点与时间序列,以已有输出继续生成 |
| RNN-LSTM | 用长短期记忆单元保存与更新历史信息 |
| RHN | 循环高速公路网络,通过更复杂的循环变换处理序列 |
| PSMM | 指针—哨兵混合模型,将序列生成与复制历史元素的机制结合 |
| SGAN | 本文引用的序列生成对抗模型,生成器与判别器共同训练 |
| RGAN | 面向实值时间序列的循环生成对抗模型 |
| Copula | 将各变量自身的分布,与变量之间的依赖结构分开估计后再联合采样 |
SGAN 在这里按论文所引 SeqGAN 类序列生成模型理解,不应仅凭缩写认作另一种行人交互模型 Social GAN。
Copula 的直观做法是:先弄清地点编码、时间等变量各自如何分布,再学习它们怎样一起出现。将变量通过累计分布变换到 0–1 的范围后,依赖结构可以与原始量纲分离;生成联合样本,再通过逆变换回到原尺度。本文将核估计的非参数依赖结构与经验边缘分布结合,使用 rvinecopulib 的 vine 拟合程序。
这套描述仍未完整交代高维轨迹如何组织成 Copula 输入变量及序列窗口,因此不宜仅凭短文声称能够直接复现所有实验。
常去地点的比例,首先能对上吗?
若一个生成器把大部分访问放到真实人群几乎不去的地方,它很难服务于移动数据测试。论文先比较 286 个地点中,访问频率排名前 50 个地点的份额。
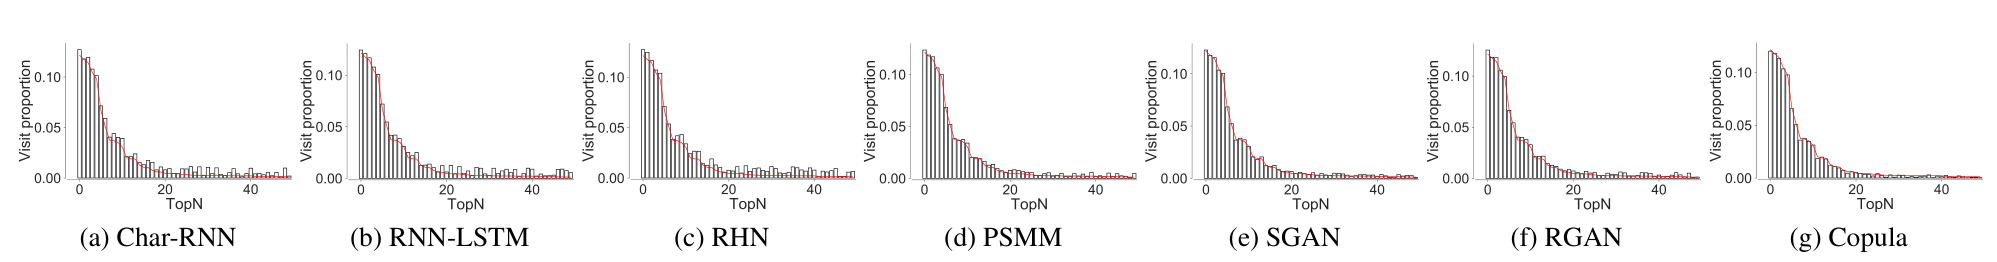
图 1|合成人群是否也集中在那些常去地点?(a)Char-RNN、(b)RNN-LSTM、(c)RHN、(d)PSMM、(e)SGAN、(f)RGAN、(g)Copula。七幅图横轴均为前 50 个热门地点的排名,纵轴为访问份额;红线是原数据,柱状分布是各模型输出。作者认为 Char-RNN、RGAN 与 Copula 对这项统计尤其接近。整体访问集中于少数地点,但仅这一幅图不能说明停留时长、活动目的或完整日节律都正确。
论文把这一类比较归入地理与语义相似性,但图中并没有家、工作、购物等活动标签。访问集中度是语义合理性的一个侧面,不是直接验证每段轨迹的行为含义。
访问份额相似,位置和时间的组合也相似吗?
两个模型可以把同样比例的访问分配给某个地点,却安排在完全不同的时段。因此研究继续看位置编码与时间戳的联合分布。
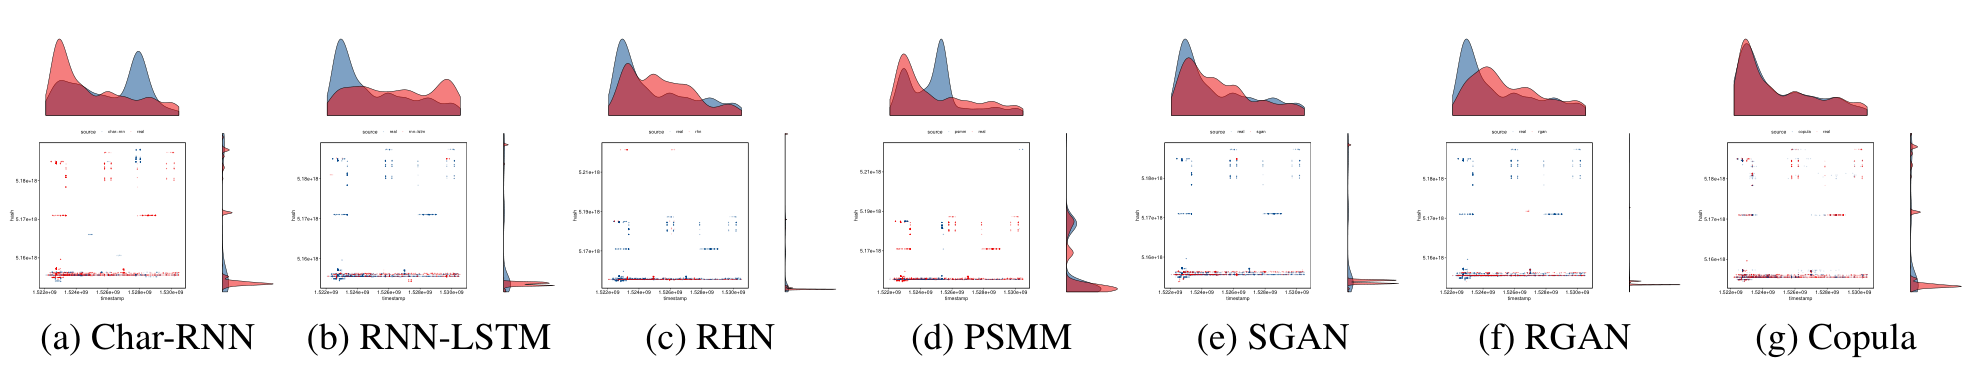
图 2|同一个地点是否在相近时段出现?(a)Char-RNN、(b)RNN-LSTM、(c)RHN、(d)PSMM、(e)SGAN、(f)RGAN、(g)Copula。每幅中央散点图横轴为 timestamp,纵轴为 hash,顶部与右侧显示相应边缘分布;真实与合成数据按各面板自身图例区分。Copula 的联合与边缘形状重合较好,部分神经模型有明显偏离。hash 是位置单元编码,纵轴数值差不能直接读成公里距离;时间戳也不能直接当作一天内的时刻。
为了避免只凭散点图判断,研究使用最大均值差异(maximum mean discrepancy,MMD)衡量真实与合成样本的分布差别。它把样本映射到核空间,再比较分布表示;在本文口径下数值越低越接近。
作者按时间轴对齐序列,并报告 30 次重复的均值与标准差。表 2 同时列出训练或拟合,以及生成的 CPU 时间:
| 方法 | MMD 均值 ± 标准差 | 训练/拟合秒 + 生成秒 |
|---|---|---|
| Char-RNN | 0.32 ± 0.001 | 约 9,000 + 10 |
| RNN-LSTM | 0.27 ± 0.0009 | 约 10,300 + 14 |
| RHN | 0.30 ± 0.001 | 约 12,700 + 15 |
| PSMM | 0.21 ± 0.0006 | 约 10,500 + 15 |
| SGAN | 0.19 ± 0.0007 | 约 11,200 + 15 |
| RGAN | 0.21 ± 0.0006 | 约 11,500 + 14 |
| Copula | 0.01 ± 0.0006 | 6.5 + 0.76 |
Copula 在这组实验中有明显优势:MMD 为 0.01,低于其他方法的 0.19–0.32,报告的总用时也短得多。但标准差反映重复实验中的波动,不是跨城市泛化误差。
这张表未提供完整硬件配置、统一调参预算与生成样本规模,因此不能据此保证 Copula 在任何规模或设备上都快同样倍数。MMD 也不是百分比准确率,0.01 不表示 99% 的轨迹真实;论文没有给出可据以确认分布完全相同的显著性检验阈值或 p 值。
长程依赖、攻击风险和地图观感,为什么要放在一起看?
即便位置—时间分布接近,生成器仍可能只学会短期局部关系。真实移动序列相隔很远的部分可能有关联,例如周期性返回;要检测这一点,论文计算不同序列间隔下的位置符号互信息。互信息衡量两处观察之间的依赖,间隔越大仍不迅速消失,表示长程关系可能被保留。
同时,生成数据可能保留足以让攻击者推断参与者或恢复路径的信息。论文使用 location-privacy and mobility meter,采用隐藏部分位置的扰动机制,测试位置序列恢复以及身份/成员相关推断。
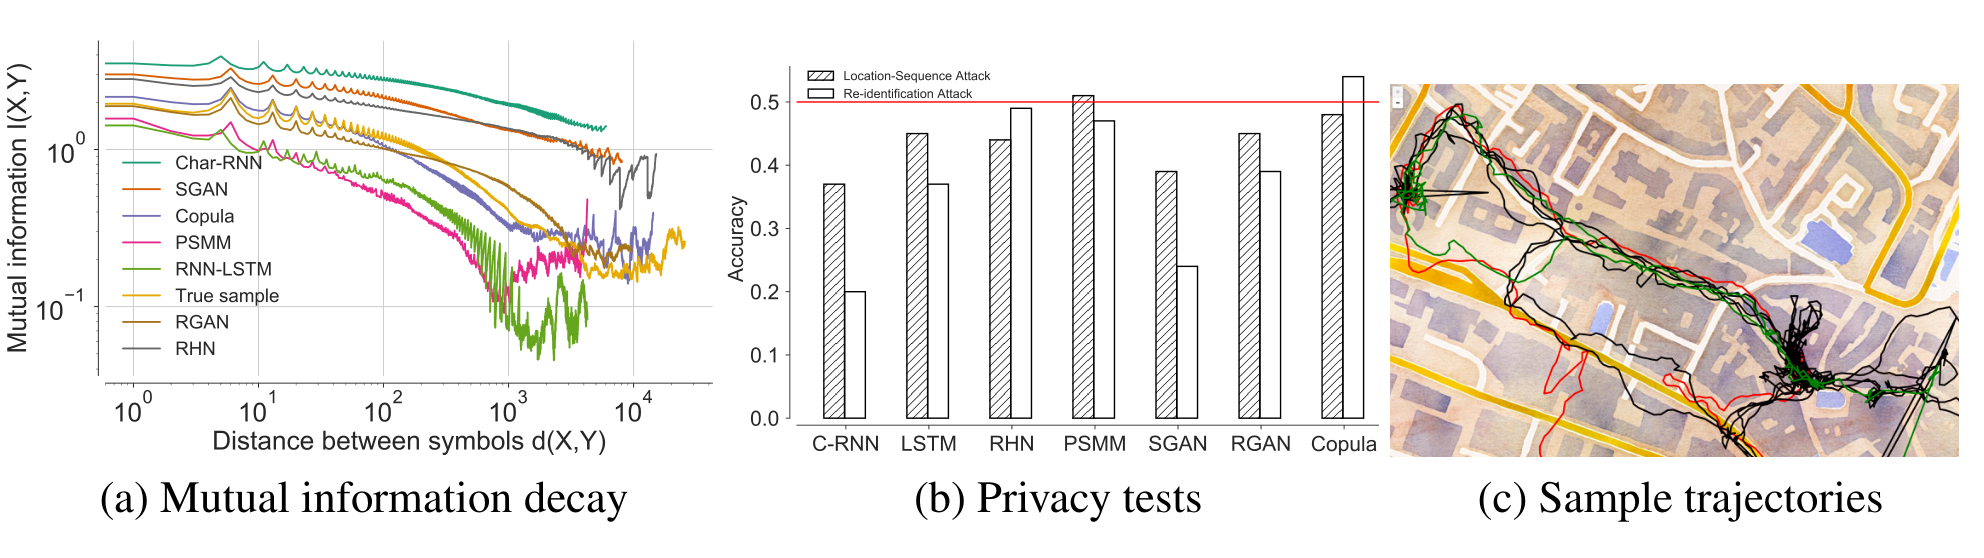
图 3|统计效用之外,还应看什么?(a)横轴为序列符号之间的间隔 d(X,Y),不是地理距离,纵轴为互信息 I(X,Y),双对数坐标;曲线比较真实样本与七种方法。作者将 GAN、Copula、RNN-LSTM 的衰减解释为保留长程依赖,但各自形状、尾部与真实样本并不完全一致。(b)横轴为模型,纵轴为攻击准确度;斜线柱是位置序列攻击,空白柱在原图标为 Re-identification Attack,红线 0.5 是作者给出的随机猜测参照。Copula 的空白柱约 0.54,部分方法的序列攻击也接近或超过该线,因此不能宣称所有攻击都降到随机水平。(c)黑线 Copula、红线 SGAN、绿线真实轨迹,展示同一区域的道路贴合与停留聚集,只是示例,不是路网约束通过率。
这里有一个解释隐私结果所必需的限制:正文将第二类测试称为成员推断,图例却写重识别,短文也未充分交代攻击者可见信息、样本平衡、训练测试划分与每种攻击的随机基线。两者本来是不同任务,所以不能把柱形高度直接泛化成统一的“身份泄露概率”。
作者进一步指出,一个完全随机、几乎没有效用的数据集,也可能让恢复准确度很低。由此,攻击越难并不自动表示生成器越好,它也可能只是把真实规律破坏得更多。本文的价值在于把效用与攻击放到同一张评估清单中,而不是给出一个已经解决的隐私—效用最优解。
合成轨迹也不自带差分隐私等可量化的保护保证。某次攻击没有成功,仍不能排除另一种背景知识、另一种攻击方法或对训练样本的记忆泄露;本文没有提供覆盖这些情形的正式证明。
结论能外推到哪些任务?
就本文实验而言,Copula 值得作为一个有竞争力的基线:热门地点分布、联合分布距离和计算时间都表现突出。只和复杂神经网络比较而忽略统计依赖模型,可能漏掉有效方案。
但这是单一数据集上的初步工作坊比较。大城市中更强的移动随机性、更广的空间范围、更长的序列、更大规模的生成,以及跨地区迁移,都被作者留给后续工作。摘要提到昼夜节律,正文却没有独立的按小时节律检验与完整结果,不能把它补写成已验证的优势。
论文也没有报告下游任务检验,例如用合成数据训练的查询或预测算法,在独立真实数据上是否仍有同样性能。分布相似只是效用证据的一部分;实际发布或研究应用仍需结合目标任务、生成规模与攻击场景检验。
一句话总结
合成轨迹要同时检查常去地点、位置—时间分布、长程序列关系和攻击风险;本文中 Copula 的统计与速度表现突出,但“生成得像”尚不能推出“公开后安全”。
核心来源
- Kulkarni V, Tagasovska N, Vatter T, Garbinato B. Generative Models for Simulating Mobility Trajectories. 2018,arXiv:1811.12801v1。论文版本,全文 PDF。所有图 1–3 和表 1–2 均来自该文。
- Laurila JK et al. The Mobile Data Challenge: Big Data for Mobile Computing Research (2012),本文 Nokia 移动数据来源,见原文参考文献 18。
- Gretton A et al. A Kernel Two-Sample Test. Journal of Machine Learning Research 13, 723–773 (2012),MMD 检验的基础来源,见原文参考文献 10。
作者介绍
以下仅采用论文署名身份。
- Vaibhav Kulkarni:本文第一作者,署名单位为 UNIL-HEC Lausanne 的信息系统系,参与移动轨迹生成模型比较研究。
- Natasa Tagasovska:共同作者,署名单位为 UNIL-HEC Lausanne 信息系统系。
- Thibault Vatter:共同作者,署名单位为 Columbia University 统计系。
- Benoit Garbinato:共同作者,署名单位为 UNIL-HEC Lausanne 信息系统系。
延伸思考:给虚拟居民发一张多科目成绩单
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假设一个团队要公开合成通勤数据。模型甲的热门地点比例很好,却总把人瞬间送到远处;模型乙的路径贴路,却把所有人安排成同一种工作日;模型丙两者都像,但会复现训练者的罕见路线。只看一个分数,很容易选错发布方案。
更有用的做法是按用途列出几类独立门槛:路线与速度是否可行、访问与停留是否合理、长期关系是否保留、下游算法是否受益,以及在明确攻击者能力下泄露多少。不同任务可以接受不同误差,却不宜把某一项优秀当成其他项自动过关。
尤其是罕见轨迹:它可能只占总体分布的一小部分,几乎不影响平均 MMD,却恰好最容易指向某个人。一个值得进一步测试的问题是,在保持常见移动模式的同时,能否对稀有、可识别序列给予更强的保护,并明确报告这种保护损失了哪些效用。