一条像真的轨迹,为什么既要会选地点,也要会看时间?
论文名片|Luca Pappalardo、Filippo Simini,Data-driven generation of spatio-temporal routines in human mobility,Data Mining and Knowledge Discovery,32,787—829,2018;2017 年 12 月 27 日在线发表。DOI。
假设一个模拟器生成了很多短途、少数长途,还让人反复回到熟悉地点。看起来很像真实出行,但如果这些人凌晨三点和早高峰一样活跃,拿它检验通信网络或城市情景,结果仍可能偏离现实。
Ditras 的思路是把日程与选址分开:先决定何时停留、何时换地方,再决定这些地方在地图上的位置。这样既能检验时间机制,也能检验空间机制,并观察它们如何共同塑造合成轨迹。
先说结论
- Ditras 生成的是一群合成人的轨迹,目标是复现真实样本的统计分布,不是预测某个真实用户明天下午会出现在哪里。
- 数据驱动的日记生成器 MD 能复现昼夜出行节律;只抽等待时间,或者每小时强制换地点,都难以保留这一节律。
- 结合地点热度、距离衰减与个人优先返回的 d-EPR,较好复现多种空间统计。日程与选址要一起建模,才能兼顾访问频次、熵与地点数量。
- MD 与 d-EPR 的组合总体较好,却没有赢得每个指标:电话样本中仍明显高估人均不同地点数,车辆数据中的部分指标由其他组合拟合得更好。
先写日记,再把地点放到地图上
轨迹生成有两个相互关联的问题:什么时候去另一个地方,以及那个地方在哪里。移动日记只描述抽象地点的到访与停留,不立即赋予经纬度。比如在日记里写一个地方待两小时、另一个地方待一小时,之后才选择具体位置。
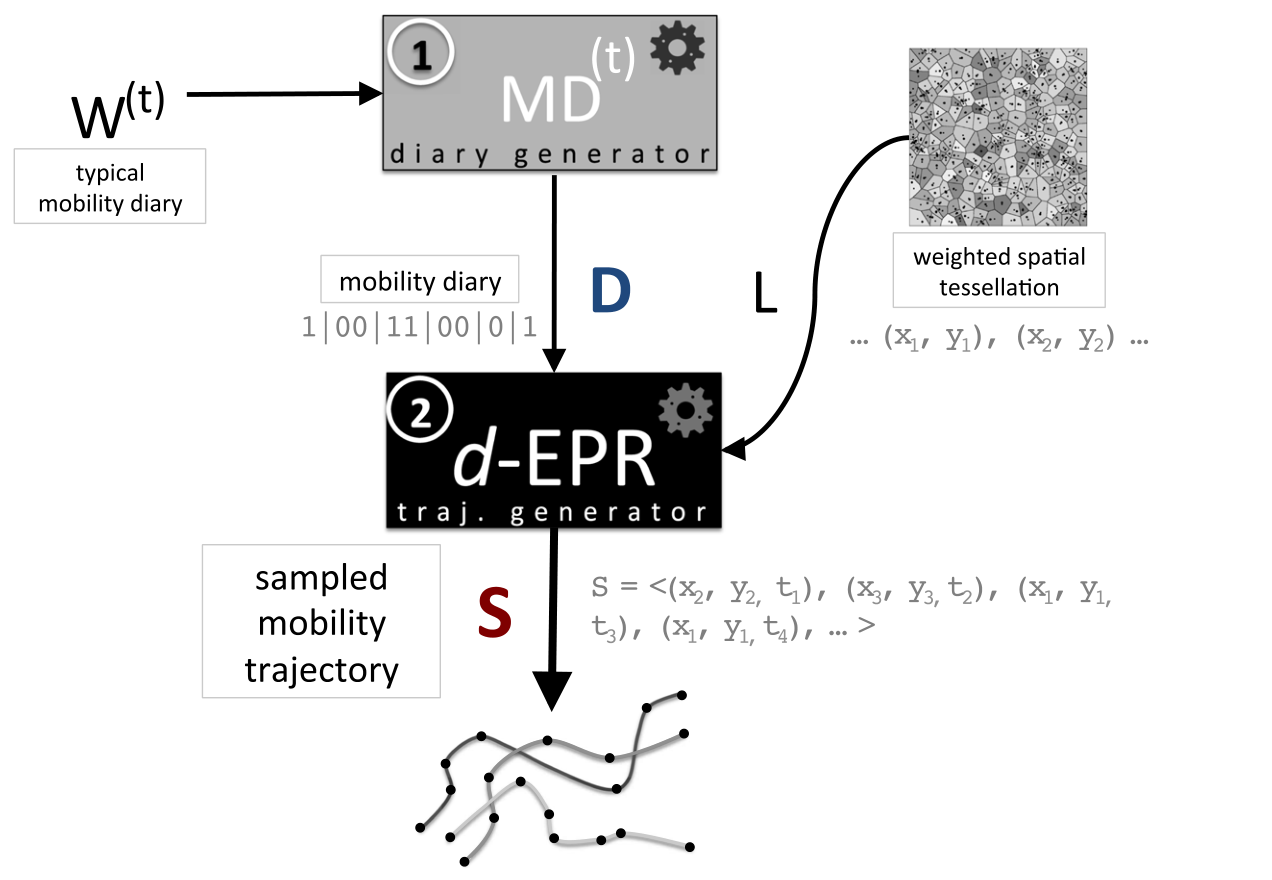
图 1|时间和空间怎样接起来?上方第一阶段 MD 由典型日记 W 产生移动日记 D;右侧带权空间分区 L 给出候选地点与重要性;下方第二阶段 d-EPR 把日记转换成带时间的位置序列 S。图中 1、2 是两个阶段编号,箭头表示输入与输出关系,不是两个独立的人群。来源:原论文 Fig. 1。
论文使用最简单的典型日记:每个时段的默认地点都是家。真实或模拟日程可以偏离这个默认地点,因此这不等于假设所有人一天都在家。符号 1 表示位于该时刻的典型地点,0 表示其他地点,竖线表示换地点。例如 11|00|0|1 依次表示在家两格、在某个非典型地点两格、在另一个非典型地点一格,再回家。
典型地点(typical location)与偏好地点(preferred location)也不同。前者构成默认日程,后者可以是偶尔反复去的餐馆或影院,不要求固定时段出现。把外出统称偏离日程,是此处二元编码的定义,不能据此将日常上班理解为异常行为。
MDL,即移动日记学习算法,从真实轨迹估计一个马尔可夫模型。状态包括一天中的时段,以及是否处于典型地点;转移不仅描述回家或离家,也包括在一个非典型地点连续停留多少格。Table 1 给出四类转移的经验频率公式;Algorithm 2 给出计数与归一化方法。它使用人群规律生成不同日记,不是逐人照抄原始时间表。
学习时,多个位置落入同一时间格,优先选其中最常出现的位置;若并列则看总体访问频率。没有记录的时间格沿用上一格位置。这能形成完整小时序列,但也把未观测时段解释为停留,因此学到的日程继承了事件数据的缺失处理假设。
为什么可以用一个家作为默认日程?
论文附录检查车辆样本的典型周:对每人每周 168 个小时,分别找最常出现的位置,再用编辑距离比较这些符号序列并聚类。这里的每小时最常见位置是跨周汇总的众数,不是一周真实行程的逐项拷贝。
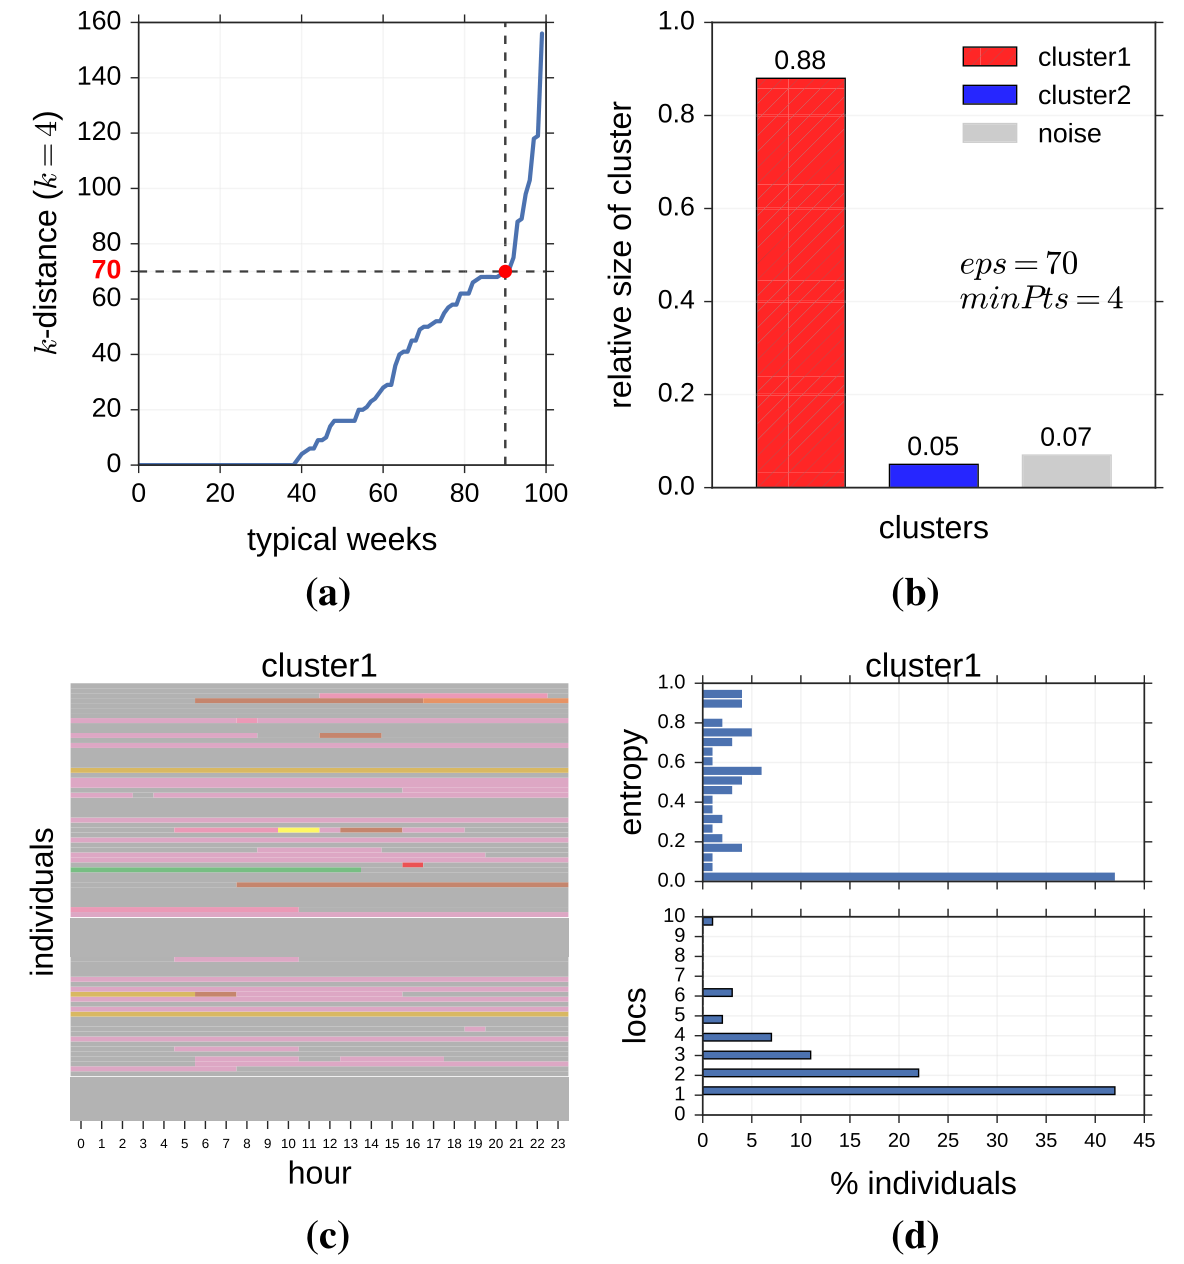
图 8|典型周有多相似?(a)到第四近邻的距离排序,曲线拐点用于选择 DBSCAN 的 eps=70;(b)三类结果的比例:主簇 0.88、第二簇 0.05、噪声 0.07;(c)主簇 100 人典型周中一天的时段图,不同颜色为不同抽象地点,每行一人;(d)主簇的地点熵及地点数分布,横轴为人数比例,纵轴分别为熵与地点数。eps 在这里是日记序列的距离阈值,不是地理米数。来源:原论文 Fig. 8。
主簇的代表日记只含一个地点,支持用单一默认地点作为简化起点。它不说明 88% 的人实际整天不出门,也不说明主簇每个人都只有一个地点;图 8d 中仍有很多含两处及更多地点的典型周。
附录使用 minPts=4、eps=70,轮廓系数约 0.50;改变最低点数至 2—5 没有显著改变聚类结果。这是对当前样本的合理性检验,仍不替代对工作地、学校、轮班与周末日程的显式建模。
去过的地方,和第一次去的地方,怎样选择?
d-EPR 是密度驱动的探索与优先返回模型(density-Exploration and Preferential Return)。当日记要求选择外出地点时,它有两种机制:探索一个地点,或返回曾经去过的地点。
探索概率为 0.6×N⁻⁰·²¹,N 为已经访问的不同地点数。见过的地方越多,继续探索的概率越低;返回时按个人此前访问频率加权,常去的地点更容易再去。
探索的空间权重结合候选地点重要性与距离平方衰减。地点重要性由真实记录的总体访问量估计,热门地点更容易被选中,距离远的地点受到惩罚。典型地点的初始位置也按重要性抽取。因此,它同时利用个人记忆与人群对城市空间的偏好。
但模拟忽略两地点间旅行时间,不在道路网络上求路线。输出是定时采样的位置序列;图中连线不能直接当成已验证的行车路线,也不能用同一小时内跨越很远的生成位置证明真实可达。
对照不是一个模型,而是时间与空间的九种组合
研究使用两类真实数据,分别学习与校准模型,再在相同空间分区上生成 10,000 个体的轨迹。
| 数据 | 原始覆盖与过滤 | 用于生成和比较的时间与空间 |
|---|---|---|
| 欧洲某国电话详单 CDR | 约 100 万用户,11 周;去掉个人访问份额≤0.005 的地点,删除只剩一处地点者,并要求平均每小时至少 0.5 次通话,剩约 50,000 活跃用户 | 选取 10,000 用户比较;模拟 1,848 小时即 77 天,基站为空间位置 |
| 托斯卡纳车辆 GPS | 2011 年 5 月,约 159,000 辆私人汽车、980 万次旅行;去掉只访问一处地点或平均每天不足一次旅行者,剩 46,121 辆 | 选取 10,000 辆比较;模拟 744 小时即 31 天,停车点映射到人口普查小区 |
电话详单(Table 2 展示记录结构)在通话时才定位,并非连续观测。车辆设备行驶时约每 30 秒上传,停车后不上传;研究用超过 20 分钟的观测间隔划分旅行,测试 5—40 分钟阈值未见所述统计的显著变化。电话样本和汽车样本代表不同人群、方式与采样机制,不能把两者当作同一群人的跨设备对照。
两套实验都用一小时作为时间格。每套将三种日记生成器与三种轨迹生成器交叉,共九种模型:
- MD 从数据学习时段与停留;RD 每格要求选择新位置;WT 从带截断的重尾分布抽等待时间,缺少钟点偏好。
- d-EPR 同时有热度、距离与优先返回;SWIM 结合地点热度与距家的距离偏好;LATP 偏向离当前位置近的地点,没有热度与优先返回机制。
WT 使用 β=0.8、截断时长 17 小时的参数;d-EPR 的 0.6、0.21 也沿用既有估计。所谓日记学习非参数,是指转移矩阵按经验频率估计,不等于不需要校准数据、不受数据偏差影响,或者天然免于样本外检验。
距离分布像了,人的活动范围就像了吗?
比较覆盖九类指标:旅行距离、回转半径、归一化地点熵、地点访问排名频率、各地点总访问次数、每人不同地点数、按小时出行份额、每天出行次数和停留时长。Table 3、4 使用分布间的均方根误差 RMSE 与 KL 散度;通常越小越好,破折号代表分布无法按该方式比较,而非误差为零。
下面六组九面板图统一读法:黑色方点虚线是真实数据;第一列红色是 MD,第二列绿色是 RD,第三列蓝色是 WT;各列内用实线、点线与短虚线区分 d-EPR、SWIM、LATP,具体以原图图例为准。纵轴为相应统计分布或时段份额,多数空间分布使用对数轴。
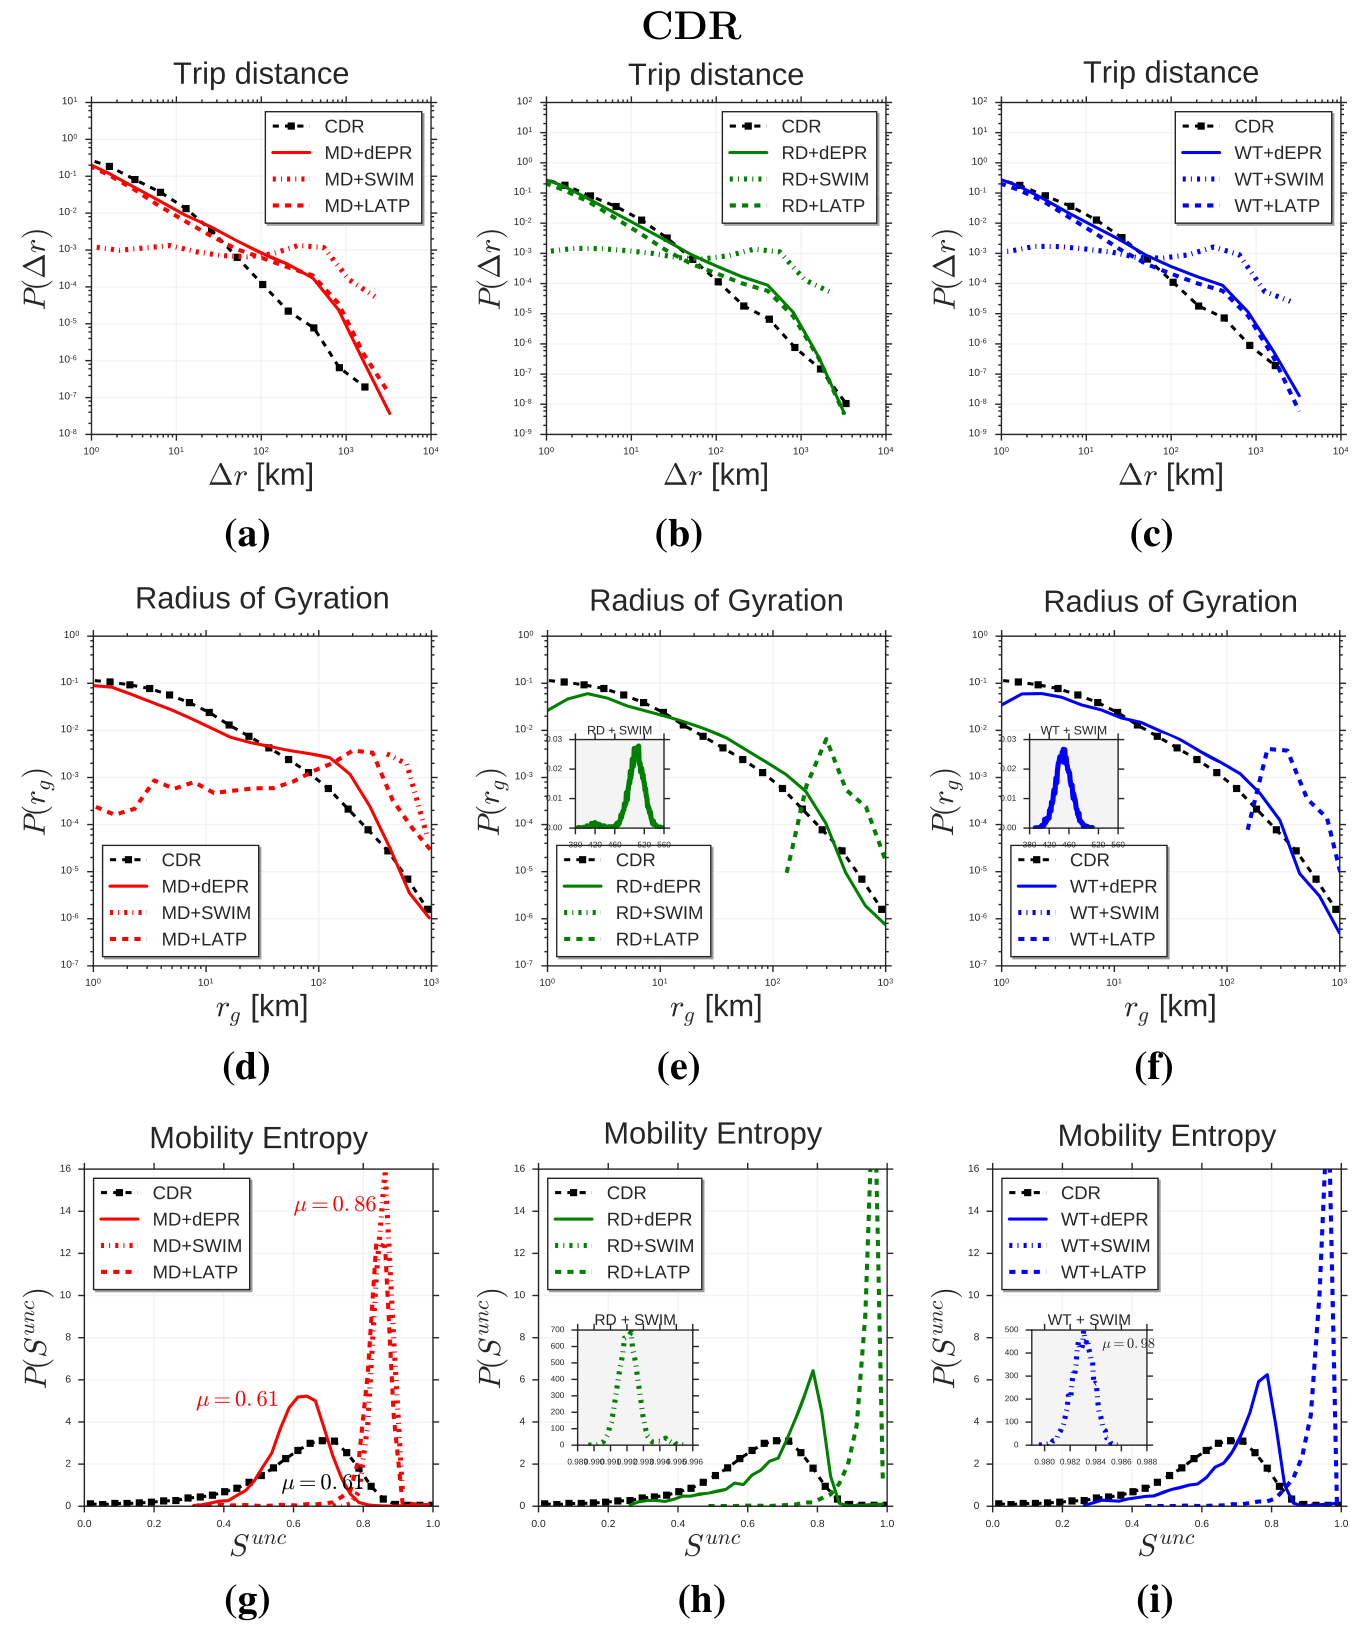
图 2|电话轨迹的空间范围与访问分散程度能一起复现吗?(a、b、c)分别为 MD、RD、WT 下的旅行距离分布,横轴距离千米;(d、e、f)对应回转半径分布,横轴千米,衡量围绕个人活动中心的空间展开;(g、h、i)对应归一化地点熵,横轴 0—1,越高表示访问越均匀。d-EPR 较好保留回转半径的形状,但 MD 与优先返回结合才较好复现熵;RD、WT 中部分模型把熵推到接近 1。插图保留集中分布的细节。来源:原论文 Fig. 2。
电话样本中,d-EPR 与 LATP 的距离分布较接近真实数据;SWIM 则明显偏离,说明仅仅偏好短途不一定足够,距离相对家还是相对当前位置也有影响。d-EPR 仍高估部分长途和大回转半径。
地点熵依据个人对不同地点的访问比例计算,并按地点数归一化,忽略访问先后顺序。它描述访问是否集中,不等同于考虑历史序列的熵率,也不是某个下一站预测器的准确率。电话样本的平均熵与 d-EPR+MD 都约为 0.61,但后者分布更窄;平均值一致仍不能证明个体差异一致。
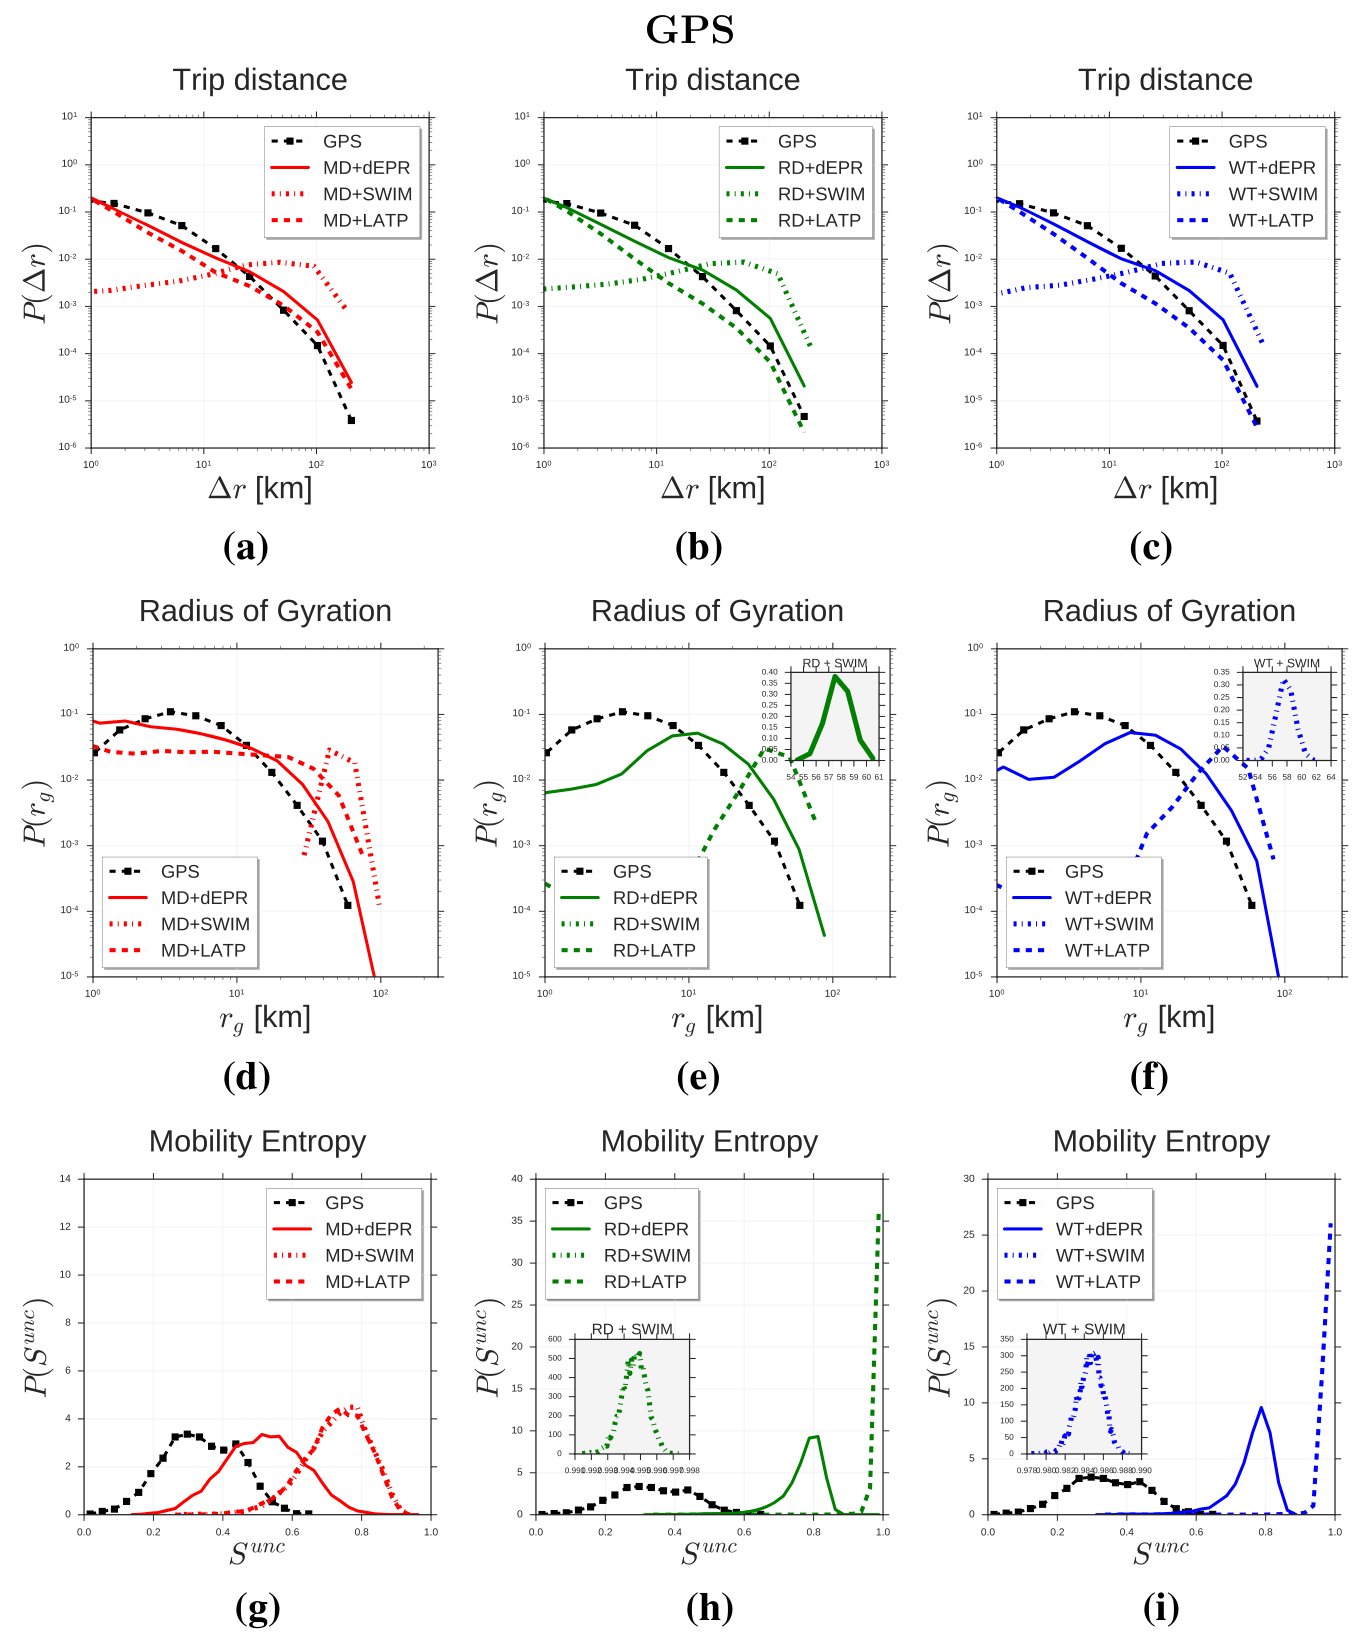
图 3|换成私人汽车,结论是否保持?(a、b、c)为 MD、RD、WT 的旅行距离分布;(d、e、f)为对应回转半径分布,距离单位均为千米;(g、h、i)为对应地点熵分布。黑色车辆数据与电话样本形状不同,MD+d-EPR 总体较合理,但(g)红实线的熵分布仍有偏移;(h、i)中的高熵集中也再次出现。来源:原论文 Fig. 3。
车辆实验里,d-EPR+MD 在回转半径上最好,但单看旅行距离,Table 4 中 d-EPR+RD 的 RMSE 为 0.0031,低于 d-EPR+MD 的 0.0254。随机日程虽然不真实,也可能碰巧把某一个边际分布拟合得更好,所以不能只挑一个指标决定生成器是否可信。
会返回熟悉地点,为什么仍会探索得太多?
访问频率与个人地点数提供另一种检验:一个模型可能把人送到合适距离,却让每个人去了过多不同地点,或者没有足够频繁地回到主要地点。
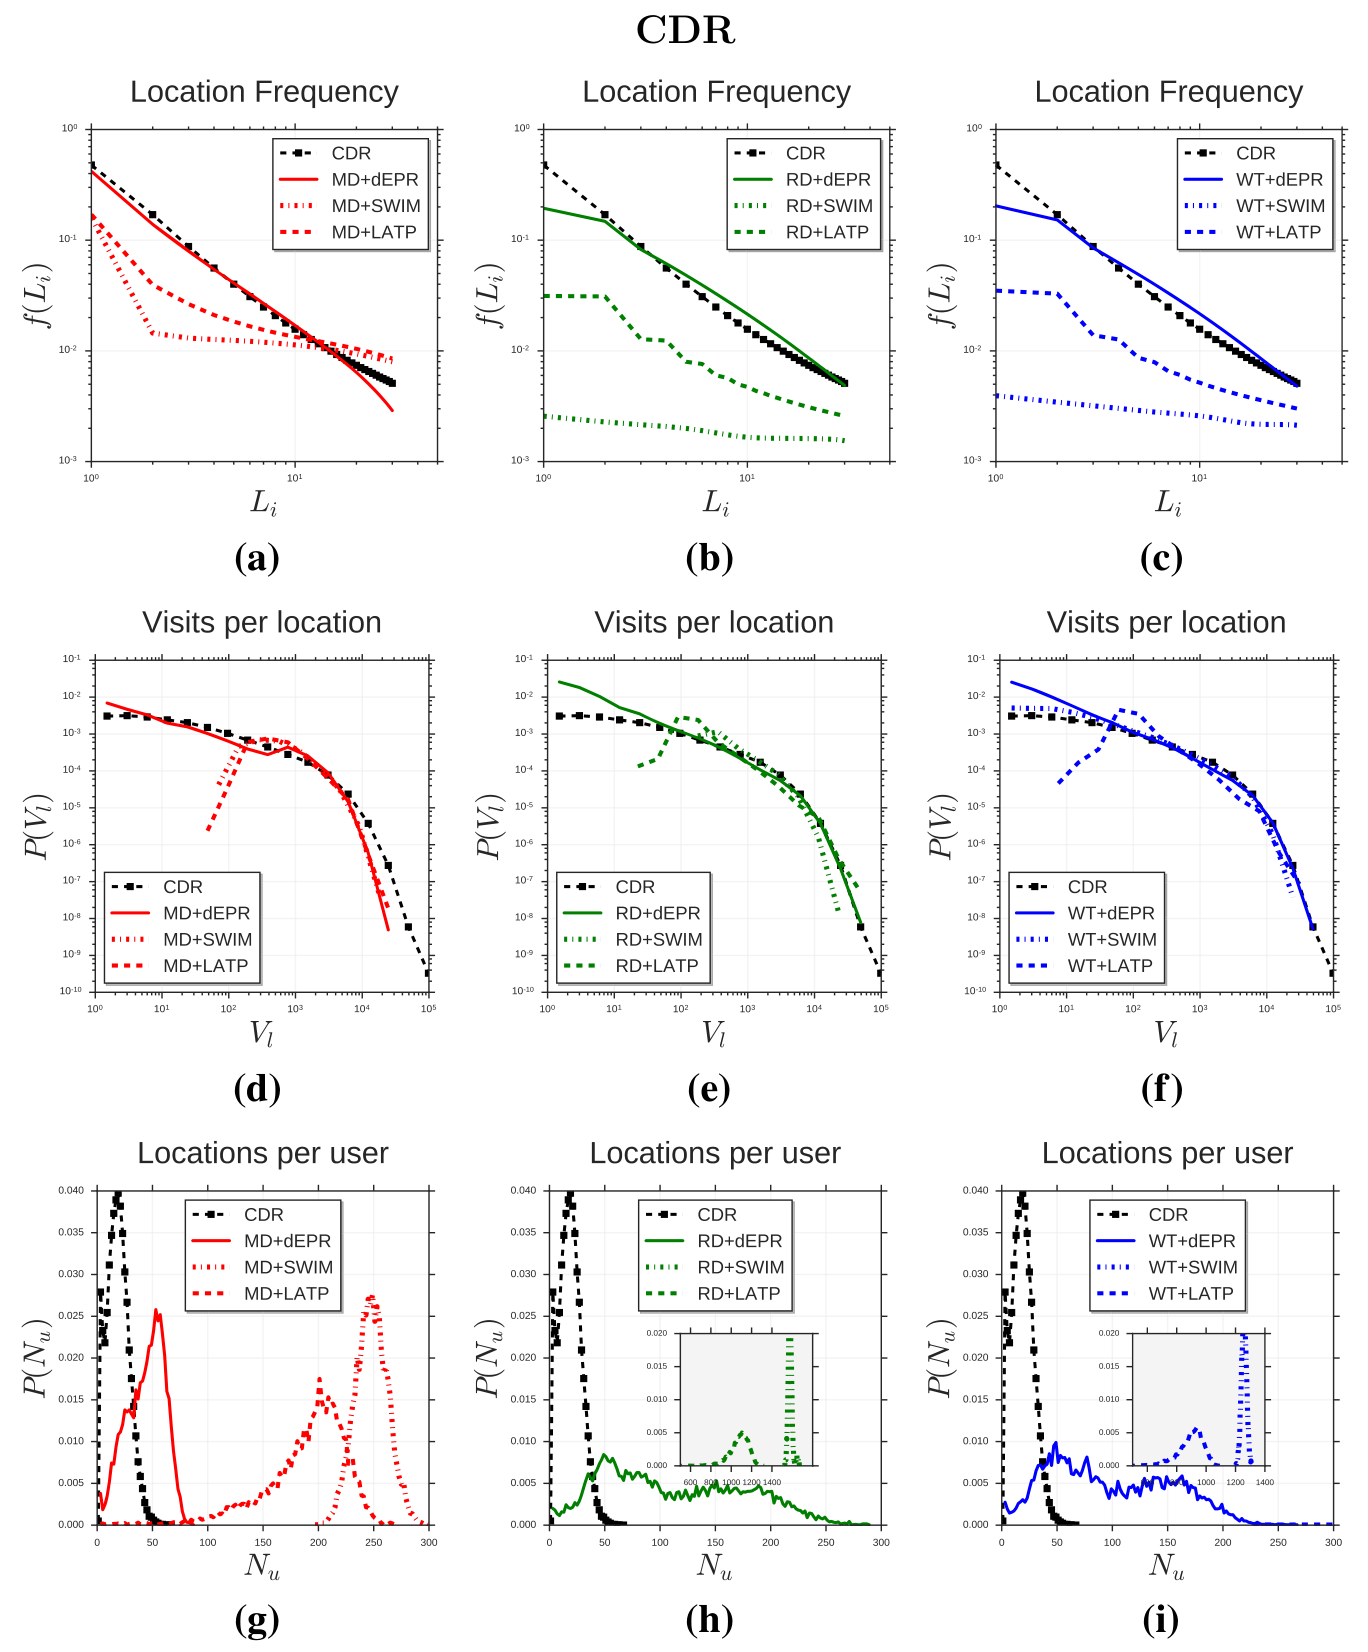
图 4|电话样本里,访问次数落到了谁身上?(a、b、c)为三类日记下,按个人访问次数排名的地点频率,横轴地点排名、纵轴访问份额;(d、e、f)为各地点获得的总体访问次数分布,横轴为次数 V;(g、h、i)为个人不同地点数 N 的分布。d-EPR+MD 较好复现排名衰减,但(g)红实线仍向更多地点偏移;换成 RD 或 WT 后,偏离通常更大。来源:原论文 Fig. 4。
电话样本的地点排名频率,d-EPR+MD 的 RMSE 为 0.0122,SWIM+MD 为 0.0669,LATP+MD 为 0.0625,反映优先返回的重要性。各地点总访问次数则还取决于地点热度及空间位置;有热度机制的 d-EPR 与 SWIM 通常优于不含它的 LATP。
但 d-EPR+MD 的每人不同地点数平均仍约为电话真实样本的两倍;SWIM+MD、LATP+MD 超过十倍。这是明确的未解决问题,而不是细节误差。短停留过多可能带来过度探索,说明较好的排名分布与较好的探索数量不是一回事。
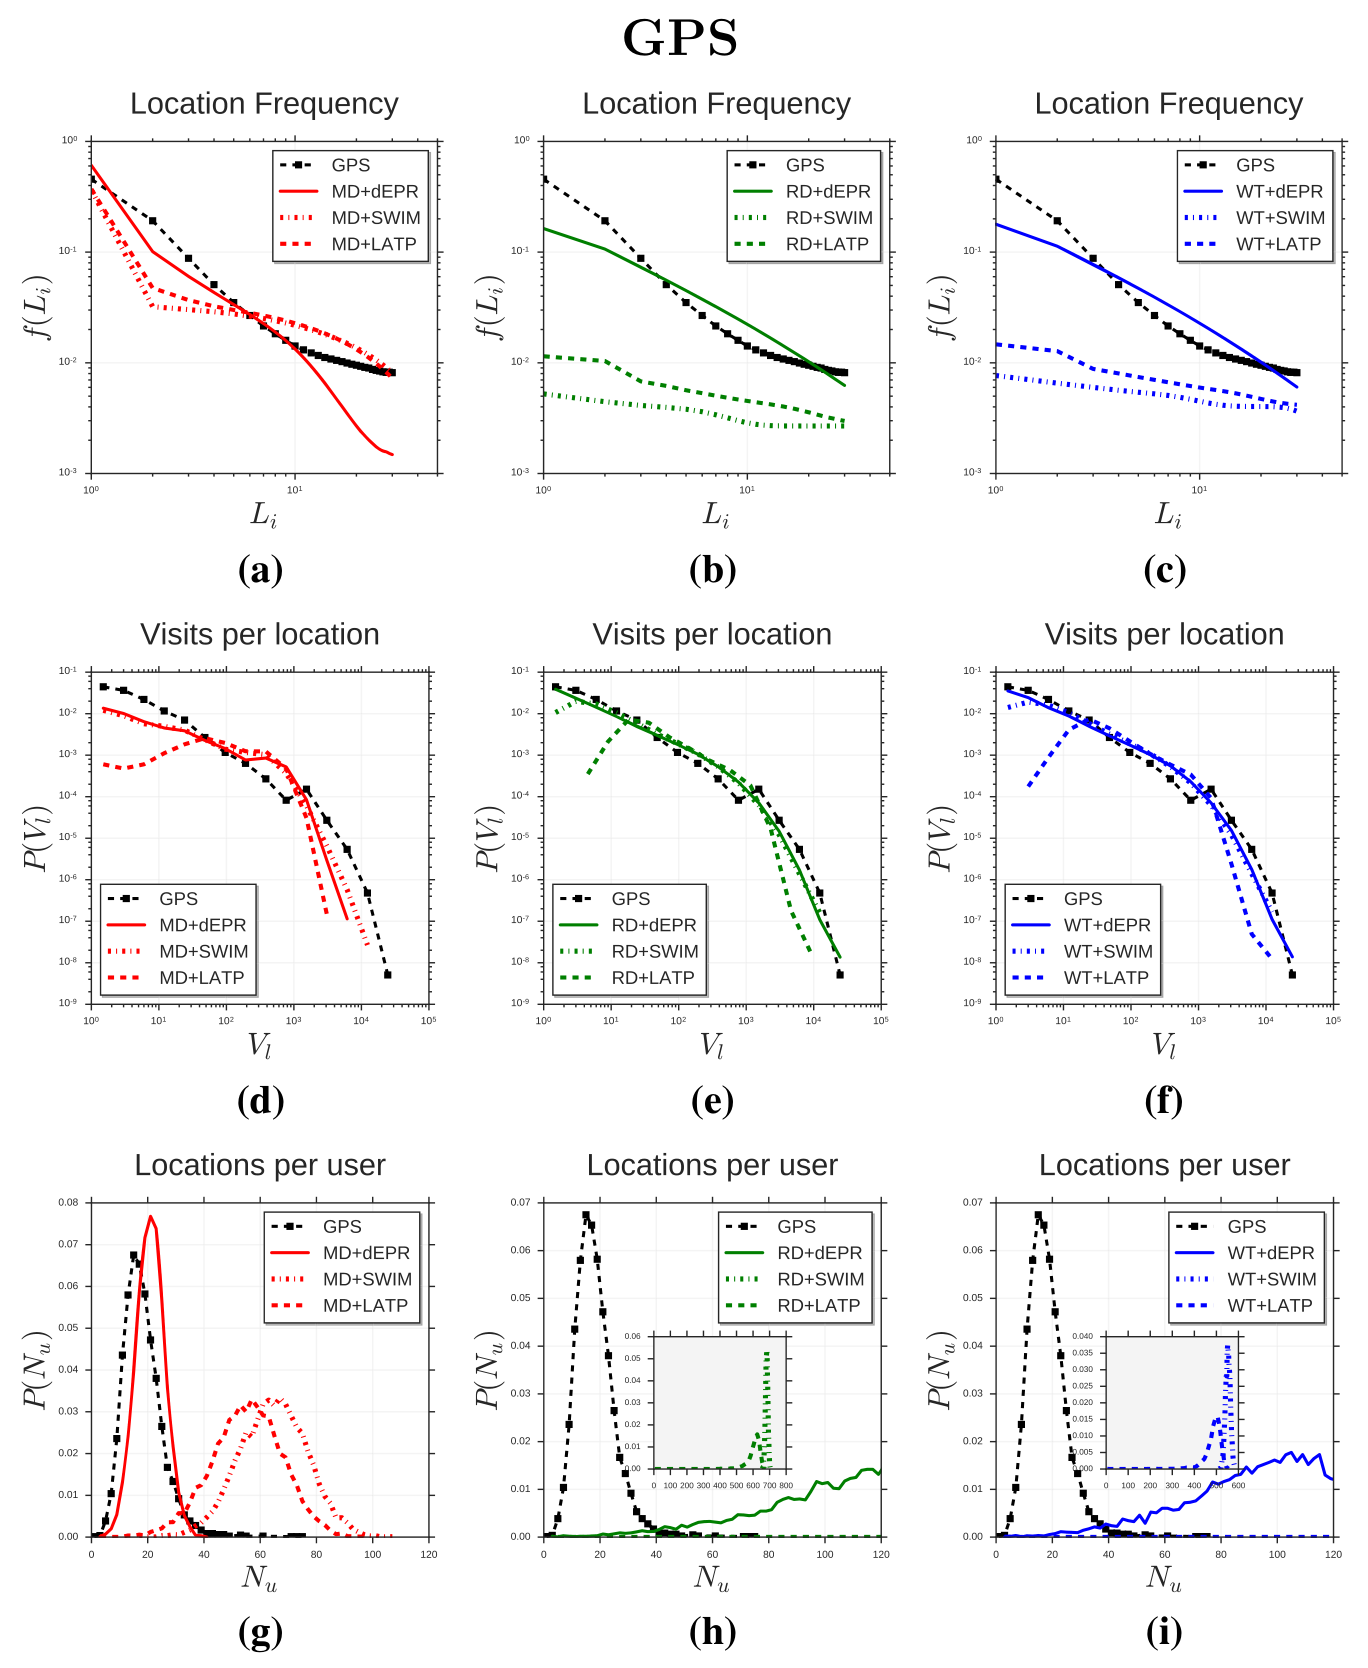
图 5|汽车样本中的过度探索有多严重?(a、b、c)为 MD、RD、WT 下的地点排名频率;(d、e、f)为地点总访问次数分布;(g、h、i)为每车不同地点数分布。MD+d-EPR 的(g)红实线与真实数据较接近;其他空间生成器、或更换日记后,地点数分布大幅偏离。各面板坐标和插图保持原样,不能把插图中的高地点数集中忽略。来源:原论文 Fig. 5。
车辆样本中,MD+d-EPR 的地点数拟合比电话样本好,也优于其他组合。不同数据上的同一模型仍有不同短板,提示评估必须保留数据类型,而不能把两个总体分布合并成一个通用成功率。
为什么等待时间分布正确,仍会在凌晨模拟出高峰?
WT 能抽出短停留较多、长停留较少的等待时间,却没有决定这些停留落在一天的哪个钟点。MD 则直接学习小时与日程状态之间的联系,这正是复现昼夜节律的关键。
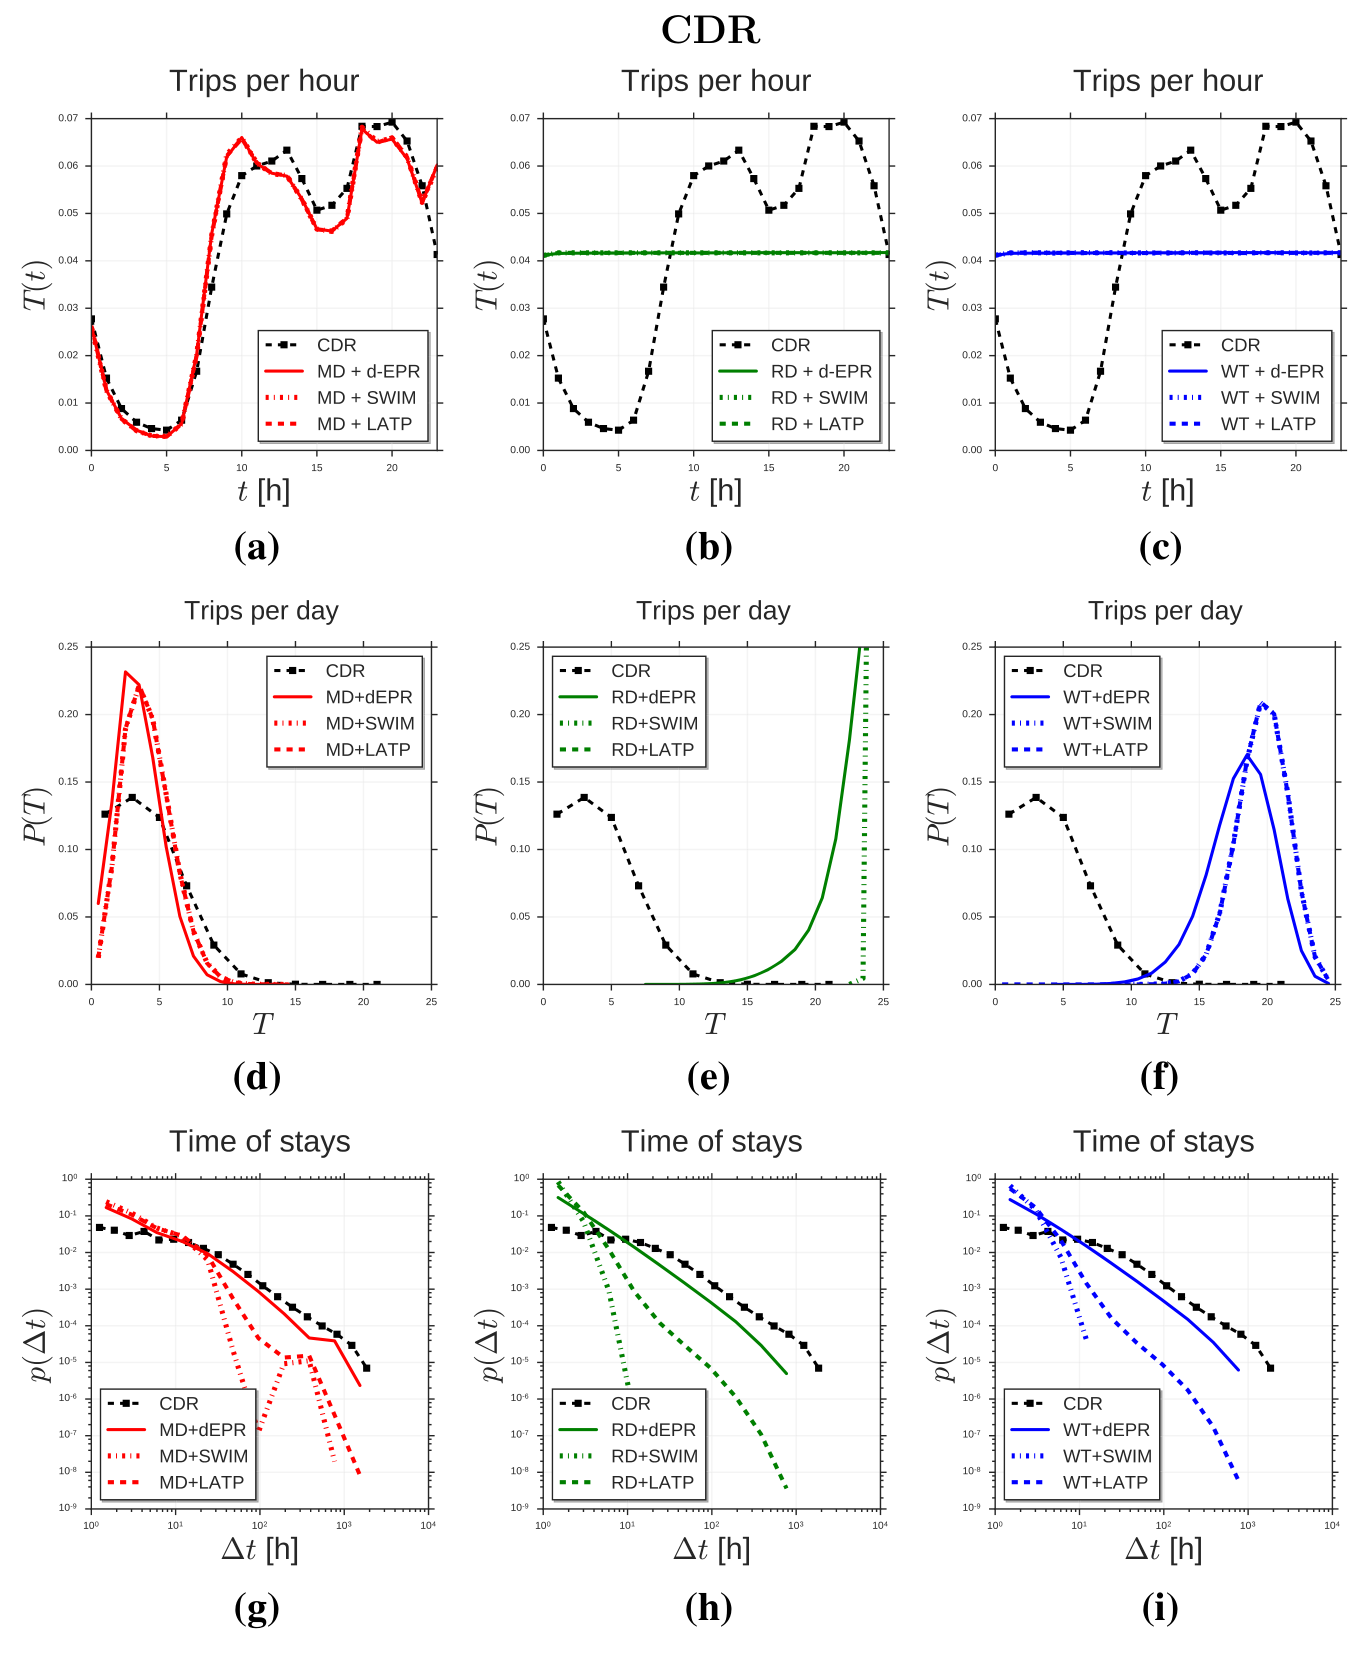
图 6|电话样本的日程何时最明显地影响结果?(a、b、c)为每小时出行份额,横轴 0—23 小时,MD 捕捉到夜间低谷和白天起伏,而 RD、WT 接近水平;(d、e、f)为每日出行次数分布,MD 更接近真实量级;(g、h、i)为停留小时数分布,展示不同空间与时间组合的差异。注意第二行原图轴符号写作 T,但按标题与图注它表示每天次数,不是第一行的钟点。来源:原论文 Fig. 6。
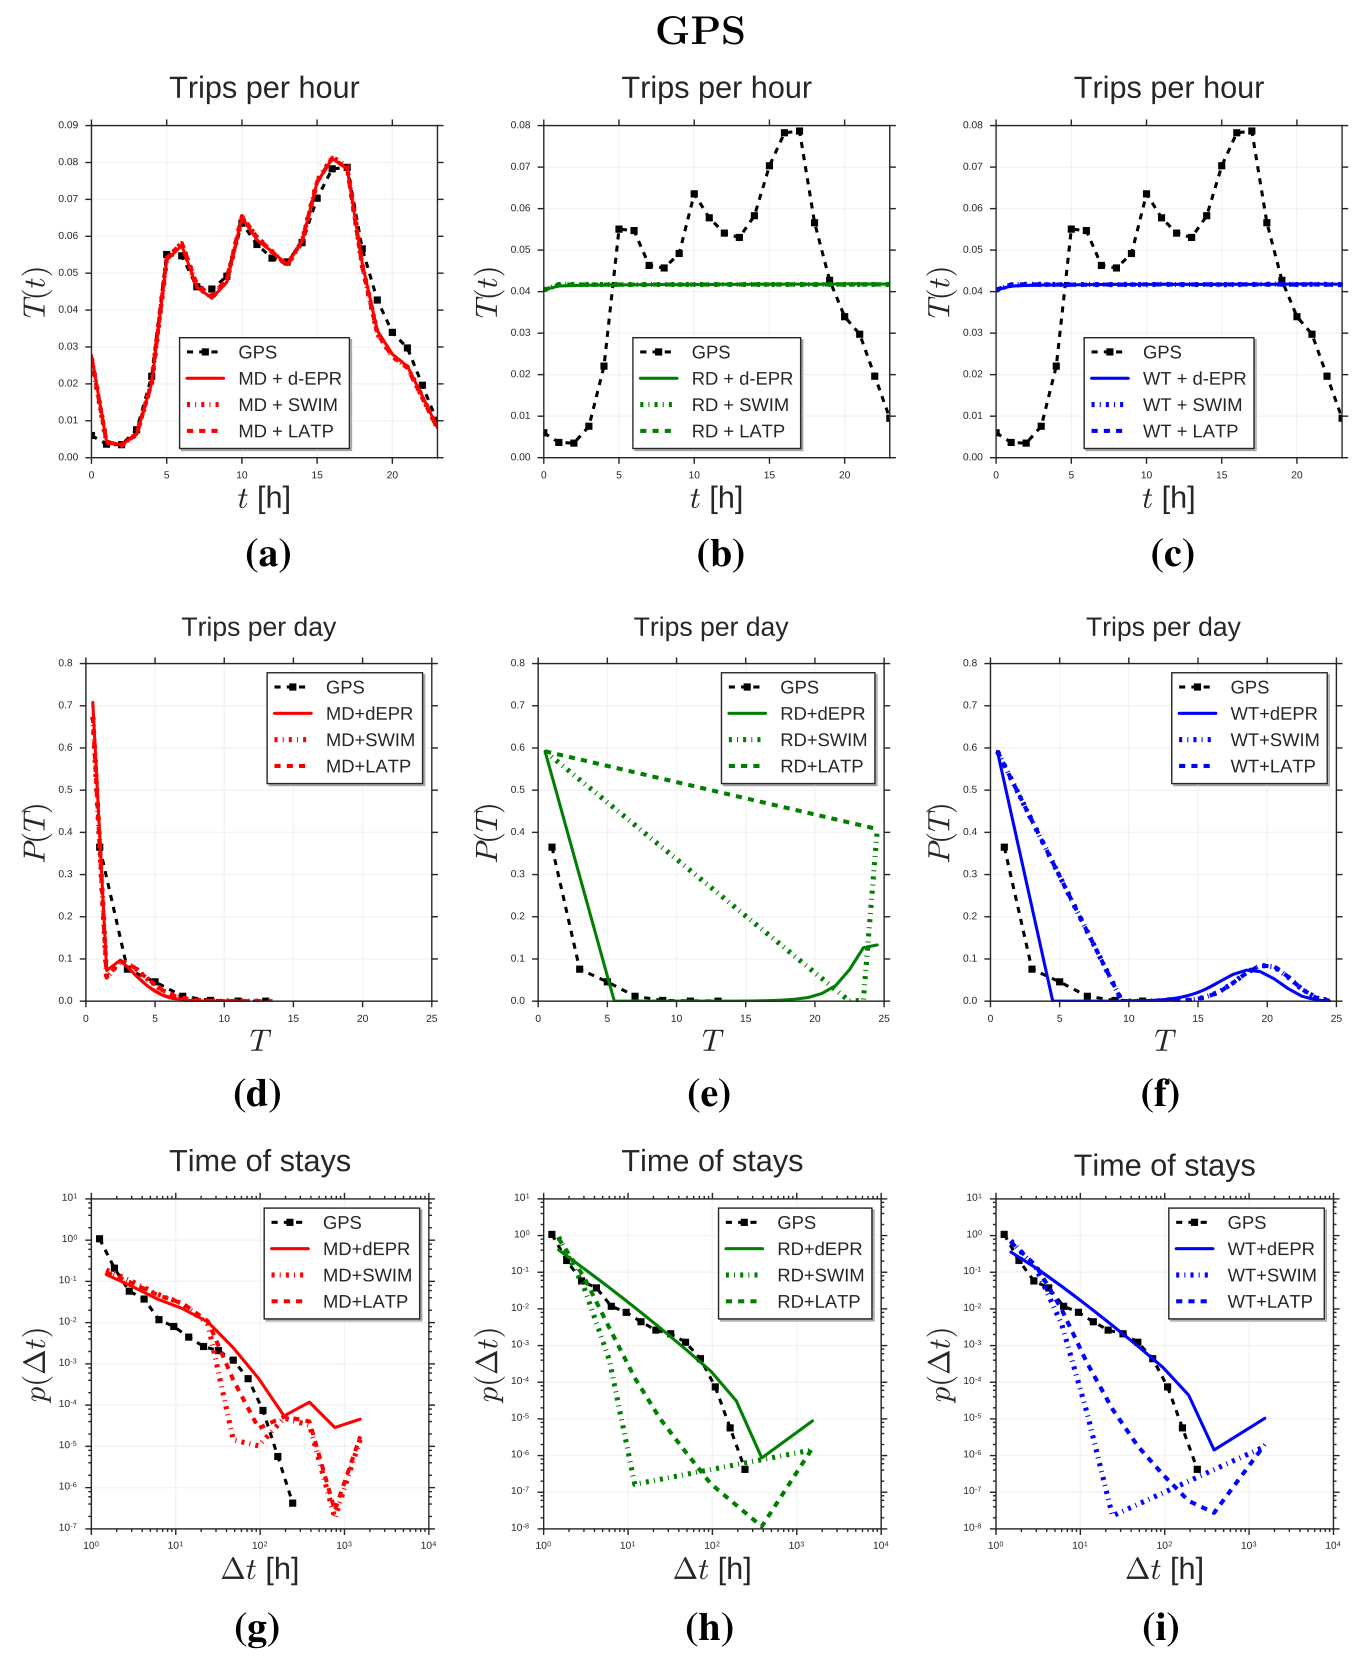
图 7|汽车活动的日程也能从数据中学到吗?(a、b、c)为三类日记的小时出行份额,MD 较好跟随黑色实测曲线,其他两类近似平坦;(d、e、f)为每日旅行次数分布,包含零次的日期,并不与按全期平均每天至少一次的车辆筛选矛盾;(g、h、i)为停留时长分布。MD 的时段优势清楚,但部分停留时长与每日次数的误差仍存在。来源:原论文 Fig. 7。
在电话样本中,MD+d-EPR 的小时出行份额 RMSE 为 0.0061,而 RD+d-EPR、WT+d-EPR 均为 0.0232。车辆样本对应为 0.0053 与约 0.0231。这是对分布的拟合误差,不能写成位置预测错误率为 0.53%。
Table 3、4 的最佳组合也说明总体较好不等于处处第一:电话回转半径的最小 RMSE 出现在 d-EPR+WT;车辆停留时长的最小 RMSE 也由 d-EPR+WT 得到,地点总访问量则有 SWIM+WT 更优。时间与空间模块影响不同指标,完整组合的价值在于同时保持多种重要特征。
从统计相似到城市情景,仍隔着哪些步骤?
论文展示了在两类数据中校准、生成并比较统计分布,没有用一项真实基础设施变化验证反事实预测。把新地点或热度放入地图,可以生成新情景,但不保证人的日程与偏好会按照同样规律响应政策改变。
其余边界也直接影响应用:出行时间被忽略,尚未映射道路和速度;典型日记只用一个默认地点;优先返回未直接惩罚远距离;没有显式加入社会关系。通话活跃者与安装保险设备的私家车,还各有样本选择性。合成轨迹能匹配边际统计,不代表已准确复现人与人的相遇、家庭协同行程或具体道路流量。
附录 B 给出实现代价:日记学习约 O(Nn),空间概率矩阵构造 O(L²),朴素轨迹生成最坏约 O(LNn),N 为时间格数、n 为模拟人数、L 为地点数。因而规模增大仍需考虑地点矩阵和抽样成本。模型结构简洁,并不等于任意城市、任意分辨率都无需计算取舍。
一句话总结
生成可信的移动轨迹,需要同时安排何时行动与去哪里;Ditras 让这两种机制可以拆开检验,也暴露了只匹配少数统计量会遗漏的日程与探索偏差。
核心来源
Luca Pappalardo, Filippo Simini. Data-driven generation of spatio-temporal routines in human mobility. Data Mining and Knowledge Discovery, 32, 787–829, 2018。DOI,论文提供的代码仓库。本文依据全文和文内附录 A、B,Fig. 1—8 均保留完整原图;Table 1—4 与 Algorithm 1—3 的定义及比较融入正文。
作者介绍
- Luca Pappalardo:论文署名为意大利国家研究委员会信息科学与技术研究所,以及比萨大学计算机科学系,列为通讯作者。
- Filippo Simini:论文署名为英国布里斯托大学工程数学系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果合成轨迹用于机会通信网络,验证指标可以加入相遇次数、接触持续时间与两次接触间隔。两个生成器即使拥有相同旅行距离和日出行次数,也可能因为出发时刻彼此错开而产生完全不同的接触网络。
对新建交通设施的情景模拟,可以先区分两类变化:只改变地点吸引力,以及同时改变到达时间、日程与可达范围。若两种设定导出的结论差距很大,说明规划结果依赖行为响应假设,应优先收集变化前后的出行证据,而非只增加合成人数。