同样从一个地方出发,早晨和晚上该猜同一站吗?
论文名片|Yuanyuan Qiao、Zhongwei Si、Yanting Zhang、Fehmi Ben Abdesslem、Xinyu Zhang、Jie Yang,A hybrid Markov-based model for human mobility prediction,Neurocomputing,278(2018):99—109;2017年9月5日在线发表。DOI:10.1016/j.neucom.2017.05.101,作者公开正式版。
早晨经过一个交通热点,你可能正在去上班;晚上到同一个地方,你可能准备回家。只记住“上一次在哪”容易忽略时刻,只记住很长的历史,又可能遇到从没出现过的路线组合。更棘手的是,当个人记录里没有可匹配的模式,预测器只能空手而归。
这篇论文把三个办法接在一起:按个人常见序列调整历史长度,按出现时刻给候选加权,个人历史失效时再参考轨迹相似者。研究用一个中国大城市的LTE网络记录,把下一热点预测准确率从简单马尔可夫基线的44.02%提高到56.39%。这个结果说明怎样利用规律,也留下两个要紧边界:地点是经筛选的城市热点,最佳对照方法并非本文模型。
先说结论
- 数据包含3474人的21天记录。前两周发现模式,最后一周测试;原始基站位置经处理后转为101个热点中的位置序列。
- 变阶马尔可夫模型为48.81%,加入小时分布后为53.42%,再在个人模式不足时参考相似者达到56.39%。比44.02%基线提高12.37个百分点。
- “地理朋友”是算法按共同移动模式选出的相似用户,没有实际友谊证据,也不能把相关性写成朋友导致行为变化。
- 模型优于图中的若干马尔可夫衍生方法,但HMM-ST准确率更高。论文没有完成运行时间、内存和能耗的定量优势检验。
网络记录告诉我们的,是人在何处,还是手机连到哪里?
数据采自2013年10月的一段21天观测期。监测装置位于LTE基站与移动性管理实体之间,捕捉控制面信息,形成用户编号、关联基站编号和时间三元组。活动时记录较密,未主动使用网络时按文中网络配置约每12分钟获得更新。
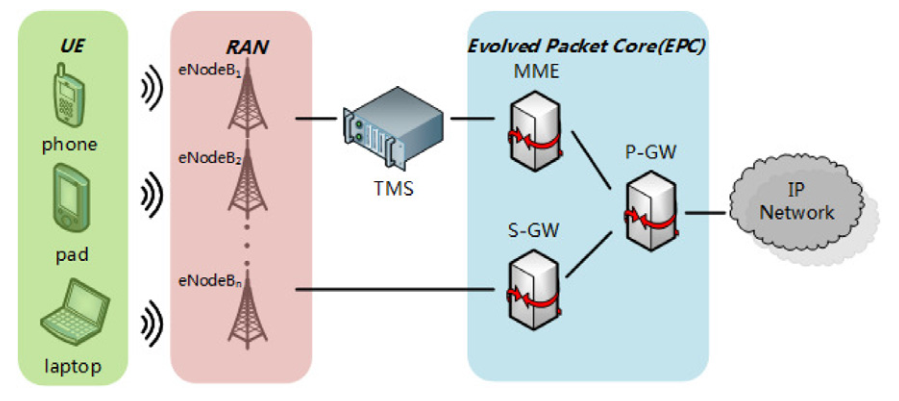
图 1|用户的位置记录从网络哪个环节得到?
左侧为用户设备UE,中间为无线接入网络RAN中的基站,右侧为分组核心网EPC;TMS为部署的流量监测装置。无子图字母。它记录基站关联信息,并不是直接测得人的精确GPS位置。来源:原论文 Fig. 1。
这个区别限制了后面的解释。短于12分钟的往返可能没被观察到,基站切换也不完全等于真实地点变化。用户编号经过哈希处理,只是替换直接标识,不足以证明整段位置历史已经无法关联。
研究进一步提取101个城市热点,用热点编号替代原始基站编号构造预测序列。热点是人口活动集中的区域,故预测任务并没有包含每一个任意地理位置,也不能理解为对整座城市所有人的每一次目的地都作了预测。
人的活动有哪些规律,值得模型记住?
先看活动尺度。回转半径(radius of gyration)衡量记录点相对个人位置中心的分散程度;在同一个小圈里反复走,累计路程可以很长,回转半径却不会无限增大。因此它与真实出行总里程是不同指标。
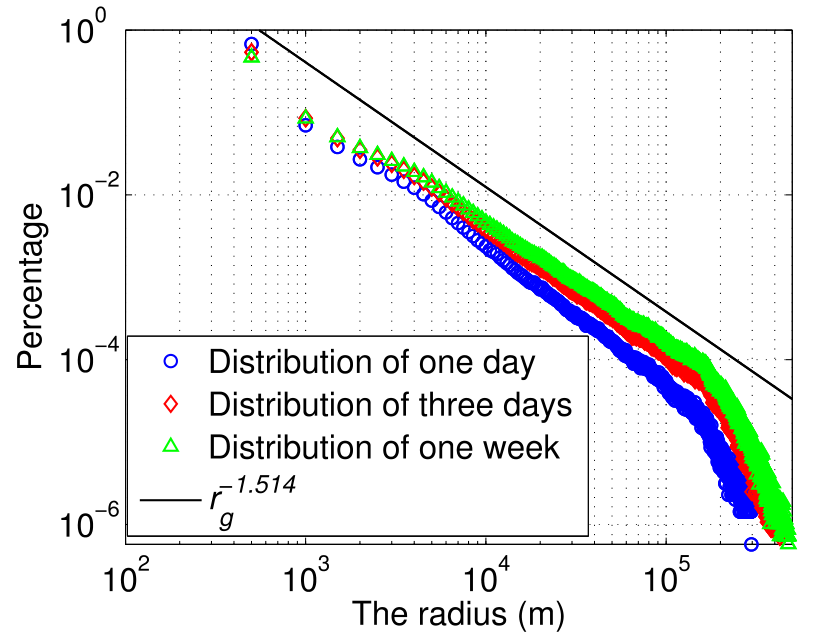
图 2|大多数人的活动范围,与少数人的大范围活动如何共存?
横轴为以米计的回转半径,纵轴为相应比例,均用对数刻度;蓝圆、红菱形、绿三角分别对应一天、三天、一周,黑线标示指数约1.514的参照。无子图字母。来源:原论文 Fig. 2。
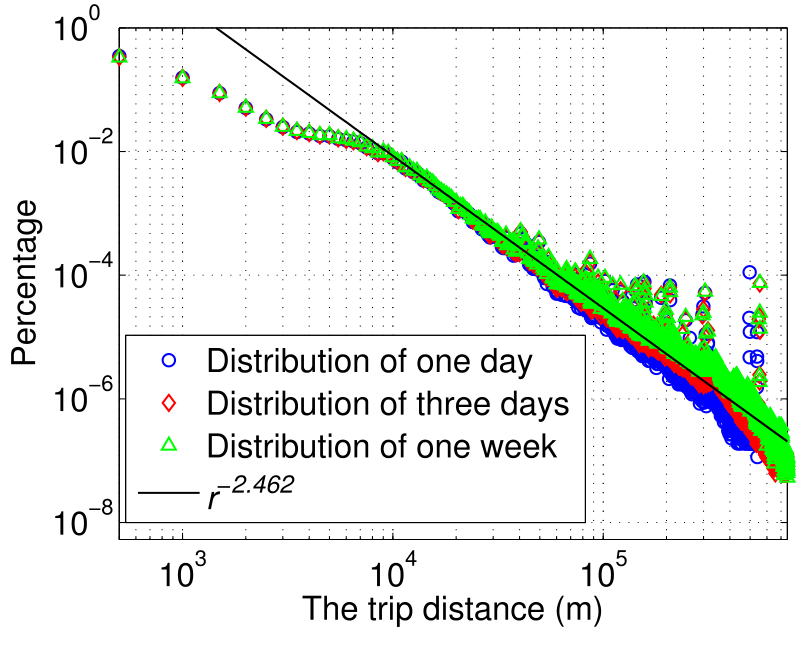
图 3|小位移与长位移出现得一样频繁吗?
横轴为位移距离、单位米,纵轴为比例,均为对数刻度;符号对应一天、三天、一周,参照指数约2.462。无子图字母。相邻记录位移不等于沿道路行走的完整路线长度。来源:原论文 Fig. 3。
这两组分布体现短距离常见、长距离少见。论文以非高斯分布概括这些特征,但对数坐标中的参照直线不能独立证明所有距离都满足严格幂律,更不能由此推出每个人下一站都好预测。模型真正用到的,是个人会重复访问有限地点与路线,以及这些重复有时间结构。
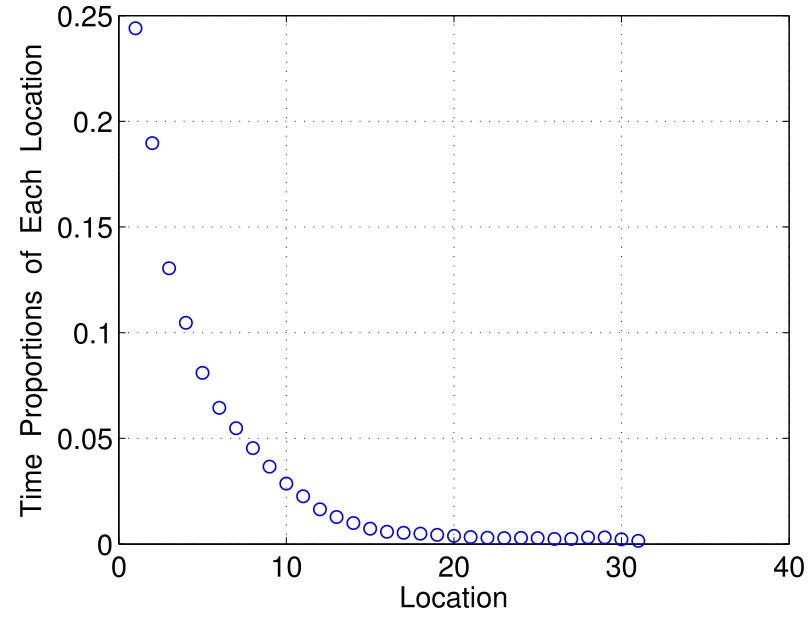
图 4|个人的活动时间主要集中在哪里?
横轴为按访问频次排序的地点,纵轴为各地点的时间占比;前几个地点明显高于后面的长尾,无子图字母。论文称前两个地点合计约占40%时间,但没有在这张图上把它们直接核实为家和工作场所。来源:原论文 Fig. 4。
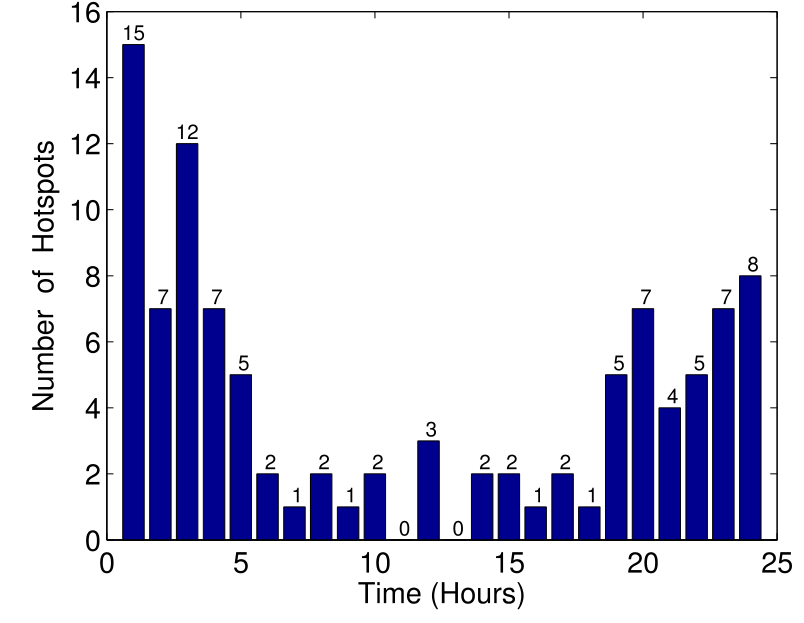
图 5|热点会持续一整天吗?
横轴为热点持续时间、单位小时,纵轴为热点数量,柱顶标出计数,无子图字母。既有短时热点,也有持续19—24小时的热点,说明城市热门区域具有不同时间形态。来源:原论文 Fig. 5。
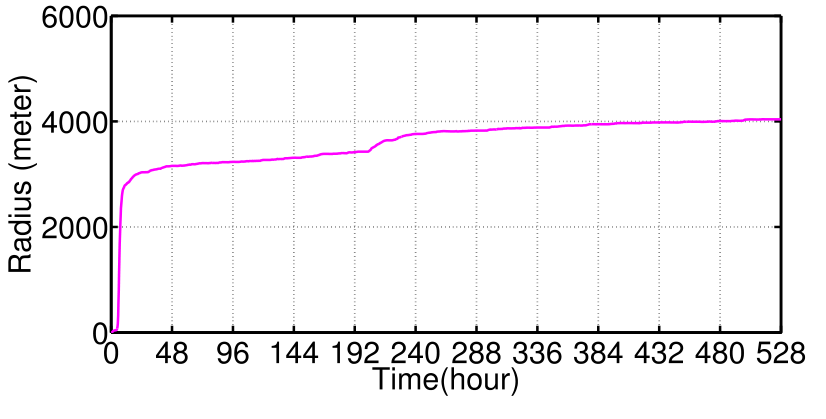
图 6|观察更多天,活动范围会一直等速扩大吗?
横轴为小时,纵轴为米计回转半径,曲线初期增长较快、之后放缓,无子图字母。这是在本次观测窗中的变化,不能解读为一生都不会离开一个固定边界。来源:原论文 Fig. 6。
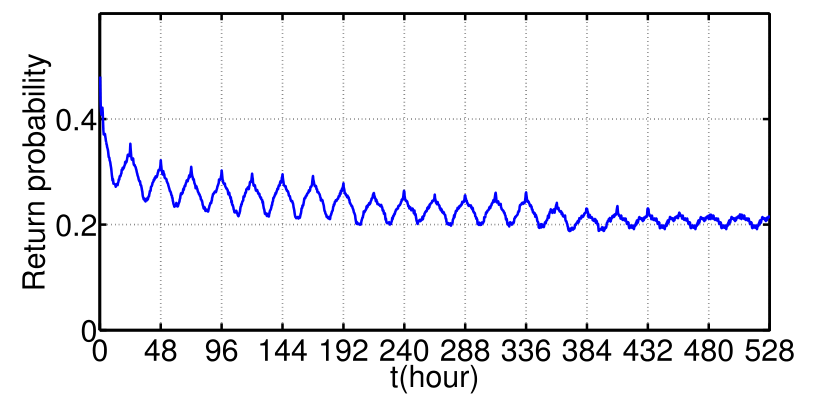
图 7|相隔一天后,人是否更容易回到相同位置?
横轴为相隔小时数,纵轴为返回概率,在约24小时及其倍数附近出现周期性起伏,无子图字母。它支持利用日周期信息,不代表每位用户每天严格重复相同安排。来源:原论文 Fig. 7。
历史要看多长,为什么不统一规定?
一阶马尔可夫预测只根据当前地点判断下一站;更高阶会查看最近多个地点。例如同样到了热点B,从A过来与从C过来,后续可能不同。历史越长,可能区分更多上下文,但完全相同的长序列也越稀少,存储与匹配更困难。
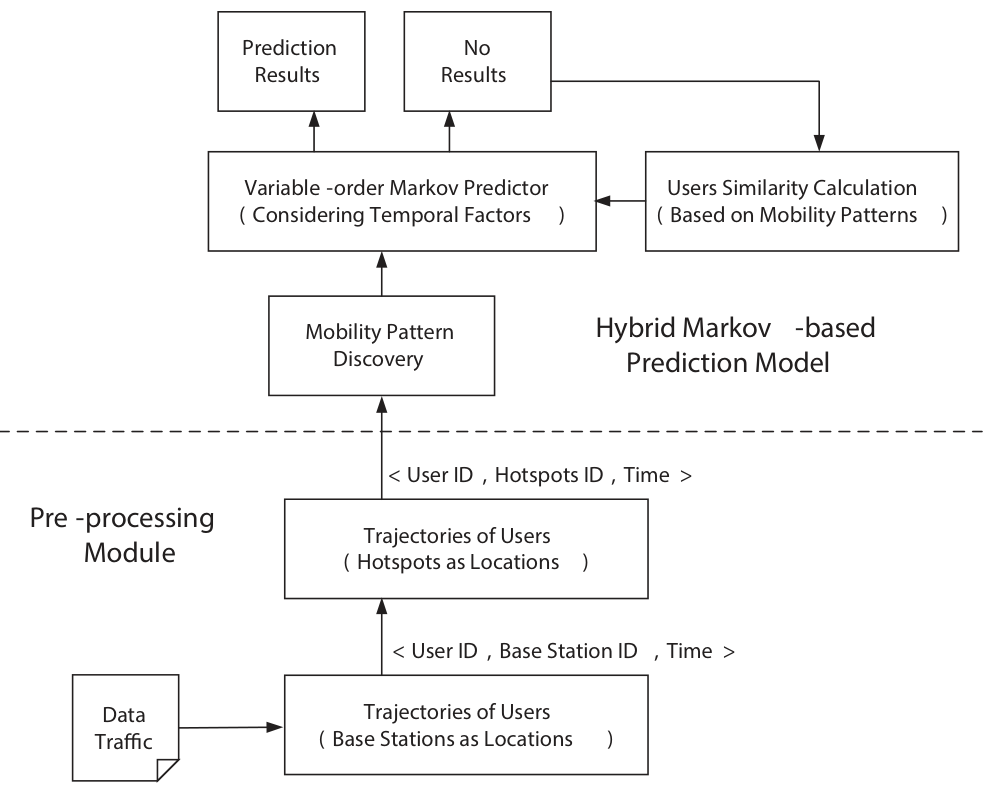
图 8|个人模式、时刻与相似用户怎样接在一起?
正式版流程由下向上:基站轨迹转为热点轨迹,发现移动模式,进入考虑时间的变阶马尔可夫预测;没有结果时,用户相似度模块提供补充。无子图字母。来源:原论文 Fig. 8。
算法1改造Apriori方法,寻找频繁出现的连续地点序列。支持度(support)是含有某序列的轨迹数除以轨迹总数。例如10条轨迹中有6条出现该序列,支持度为0.6。只有超过门槛的候选序列才保留,逐步扩展直到不能找到更长模式;表1给出支持度、候选集、模式集等符号。
预测时优先匹配最长的频繁历史,匹配不上则回退到较短子模式。因此“变阶”不只是每个人设一个不同常数,也可以在不同预测上下文使用不同历史长度。
这种设计缓解稀疏问题,但没有让新模式凭空变成已知模式。它仍依赖前两周记录中的重复性;搬家、换班或临时活动后,过去最常见的路线可能失去作用。
知道路线常见,还要知道它通常几点出现吗?
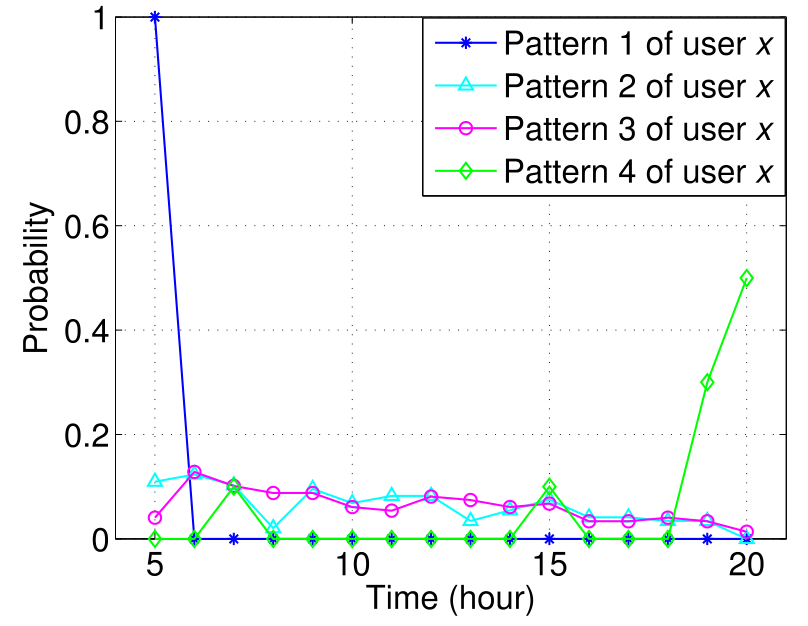
图 9|同一个人的不同模式,发生时刻是否相同?
横轴为一天中的小时,纵轴为模式出现概率,四条曲线对应用户X的四种模式。模式1集中在较早时段,模式4集中在晚间,另两种较分散,无子图字母。这是一个用户示例,不能把全部曲线直接命名为上下班。来源:原论文 Fig. 9。
模型把一天划成一小时的时段,统计每个模式在各时段出现的频率占比。在候选转移的原有概率上,乘以该模式对应的小时权重,再按所得分数选下一热点。这里的乘积用于排序;不应未经归一化就解释为经过校准的最终概率。
同一个地点序列即使整体很常见,若很少在当前时段发生,其得分也会降低。这样就把“历史上接下来常去哪”变成“当前这段历史与当前时刻下,接下来更可能去哪”。
个人记录找不到答案,为什么别人可能有帮助?
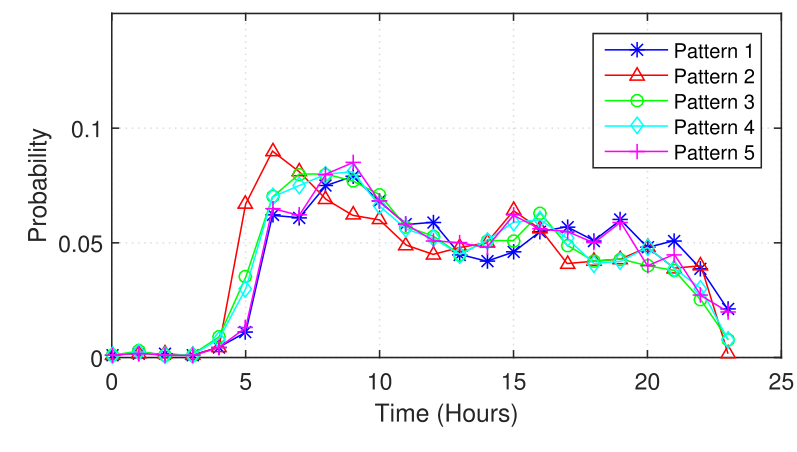
图 10|许多人共有的路线,是否也有共同时间结构?
横轴为小时,纵轴为出现概率,五条曲线代表群体中较常见的五种模式,早晨上升较明显,无子图字母。群体重复为寻找轨迹相似者提供动机,并没有直接确认用户之间的社会关系。来源:原论文 Fig. 10。
研究采用协同过滤(collaborative filtering)的思路:如果两个人已有许多相似移动模式,个人历史不能作答时,可以参考对方的模式。这里的地理朋友(geo-friend)只是轨迹相似者,不是通讯录好友,也不是被实测共同出行的朋友。
算法2用最长公共序列衡量两个模式的相似程度:共同序列越长,相对两个模式总长度所占比例越大,就越相似。为避免短模式在多个长模式中重复贡献,用户比较采用最大模式集;模式配对分数由支持度加权,再把两个方向的相似度平均,得到对称的用户相似度。表2说明相应符号。
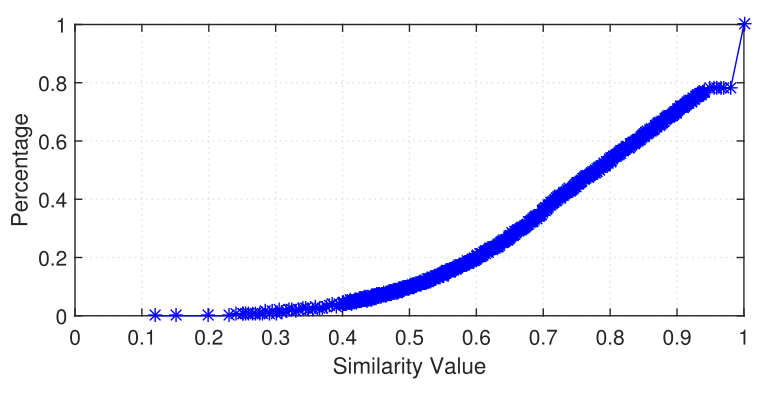
图 11|每个人找到的最佳轨迹相似者,到底有多相似?
横轴为相似度,纵轴为累积分布,约一半用户的最佳相似者得分达到0.8、约80%达到0.6,无子图字母。它表示算法所定义的模式重合程度,不能读成80%准确率或80%的人有真实好友。来源:原论文 Fig. 11。
对相似者的依赖发生在个人模式无法提供结果时。它可以补充个人未充分出现过的上下文,但不能据此宣称模型能预测从未出现于任何数据中的地点,更不能恢复该地点的精确坐标。
56.39%是怎样算出来的?
研究以前两周记录发现模式,用最后一周测试。准确率定义为正确预测数除以全部预测机会;“没有预测”也计作错误。文中先按地点计算再汇总平均,因此没有给出足够明细将其改成所有事件简单合并后的准确率。
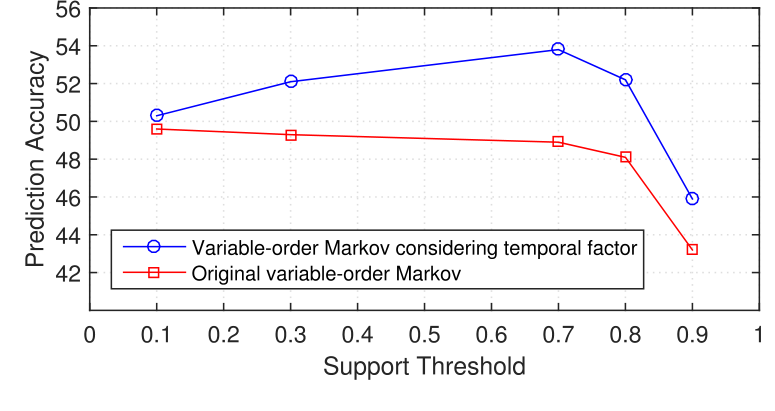
图 12|过滤过松或过严,预测都会更好吗?
横轴为支持度门槛δ,纵轴为百分比准确率;蓝线加入时间因素,红线为原始变阶模型,无子图字母。加入时间的曲线在δ约0.7附近较高,两条曲线并不具有完全相同的变化方向。来源:原论文 Fig. 12。
论文选择δ=0.7,报告原始变阶模型48.81%、加入时间后53.42%。门槛过高会丢掉可用模式,过低又可能保留许多弱重复。这里展示了在本批数据上选择门槛的过程,未明确另设独立验证集;因而这不是完全独立于调参的数据检验。
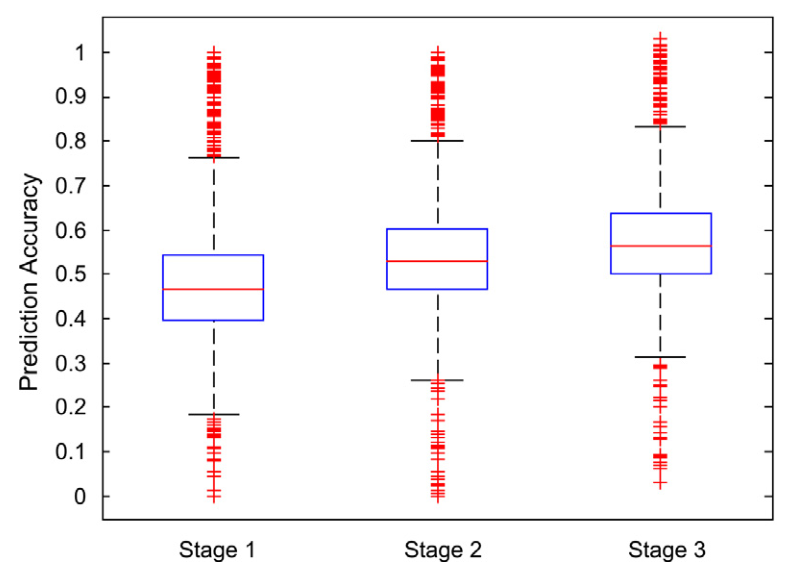
图 13|增加模块后,准确率分布怎样移动?
横轴Stage 1—3依次为变阶、加入时间、再加入地理朋友,纵轴为准确率;蓝箱、红中线和须线展示分布变化,原图无子图字母。第三阶段整体较高,同时仍有很大的分散性。原图个别标记延伸至1以上,不能把那些标记解读为超过100%的有效准确率。来源:原论文 Fig. 13。
| 模型 | 报告准确率 | 相对前一步变化 |
|---|---|---|
| 简单马尔可夫基线 | 44.02% | — |
| 按频繁模式变阶 | 48.81% | +4.79个百分点 |
| 进一步加入小时分布 | 53.42% | +4.61个百分点 |
| 个人模式不足时参考相似者 | 56.39% | +2.97个百分点 |
这些结果支持三部分在这套实验流程中有增益,但没有逐阶段给出随机重复或置信区间,不能把百分比差直接称为已经经过统计检验的显著因果效应。尤其参考相似者带来的改善,既可能包含新增作答,也可能改变错误分布,不能推出所有陌生路线都得到解决。
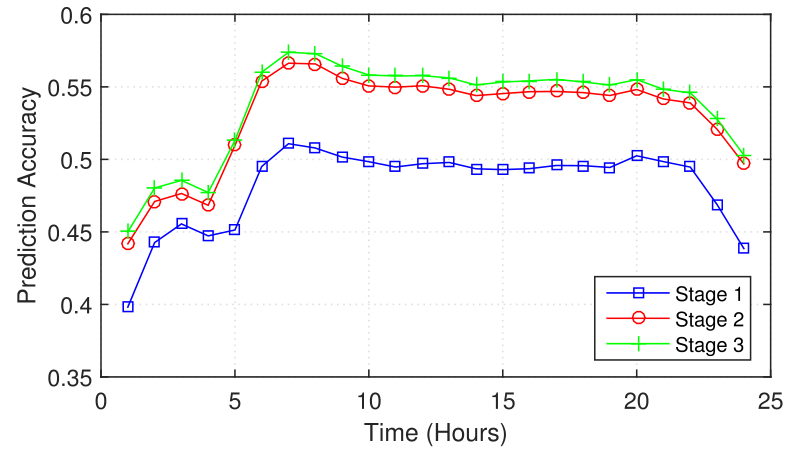
图 14|整天的平均改进,会均匀发生在每个时刻吗?
横轴为小时,纵轴为准确率;蓝、红、绿分别表示三个阶段,无子图字母。约6—7时较高,深夜和晚间有所下降,加入相似者后的曲线通常高于仅加入时间的曲线。来源:原论文 Fig. 14。
晨间可能有较重复的通勤活动,这是论文的解释;图本身并未逐条核实通勤目的。若周末、节假日或作息改变,时间规律能否继续使用,仍需另行验证。
这是不是所有对照里最好的模型?
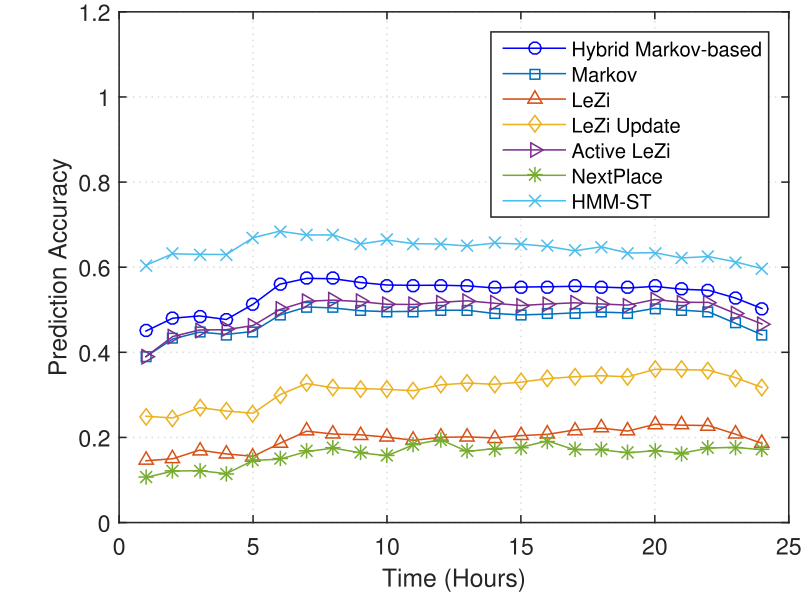
图 15|提高马尔可夫预测,是否等于超过所有方法?
横轴为小时,纵轴为准确率;图例比较混合马尔可夫、普通马尔可夫、LeZi、LeZi Update、Active LeZi、NextPlace和HMM-ST,无子图字母。HMM-ST曲线整体更高,本文混合模型处在中间较高一组。来源:原论文 Fig. 15。
论文认为隐马尔可夫模型HMM可能消耗更多时间和空间资源,因而希望在简单模型上提高准确率。但没有在此提供配套的运行耗时、内存、能耗实测,结尾也把这些量化比较列为未来工作。因此,可以说本文提高了所比较马尔可夫方案的效果,不能说它已经证明最优准确率或最佳资源效率。
此外,数据只有一个城市的3474人、三周时间,又经过热点筛选;LTE早期用户和网络观测方式都可能影响代表性。非高斯分布、日周期和相似轨迹是有用线索,却不足以保证换一座城市、换一种人群后保持同样数字。
一句话总结
按个人重复路线选择历史长度、按小时调整权重、再借助轨迹相似者,可以提高下一热点预测,但效果必须放回地点筛选、测试划分和真实对照中理解。
核心来源
- Qiao, Y., Si, Z., Zhang, Y., Ben Abdesslem, F., Zhang, X. & Yang, J.(2018). A hybrid Markov-based model for human mobility prediction. Neurocomputing, 278, 99—109。论文DOI,作者公开正式发表版。本文公式、算法1—2、表1—2与图1—15据原论文,全部主图各保留一张完整原图。
作者介绍
按原论文署名及文末简介介绍发表时身份,不推断当前任职。
- Yuanyuan Qiao:北京邮电大学署名作者、本文通讯作者之一,原文所列方向包括流量测量与分类、移动互联网流量及大数据分析。
- Zhongwei Si:北京邮电大学署名作者,研究方向包括无线通信、信息论与数据挖掘。
- Yanting Zhang:北京邮电大学署名作者,研究方向为人类移动分析与大数据分析。
- Fehmi Ben Abdesslem:瑞典SICS的Decisions, Networks and Analytics实验室署名作者,本文通讯作者之一。
- Xinyu Zhang:北京邮电大学署名作者;本文依据其论文身份介绍。
- Jie Yang:北京邮电大学署名作者,研究方向包括宽带网络流量监测、用户行为及互联网与电信大数据分析。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
参考相似用户是否会让少数人的活动被多数人的规律覆盖?可以把个人模式失效的情形分成“本人去过但组合陌生”和“本人完全没去过的热点”,分别计算补充预测的收益与错误。这样比只报告平均增加2.97个百分点,更能判断相似者到底补了哪类信息。
另一项有价值的测试是人为改变某些用户的作息,再看模型需要多少天才能适应。如果小时权重一直沿用过去规律,原本提高准确率的机制也可能延迟适应。让时间权重随近期证据更新,并独立测试新作息阶段,才更接近持续使用的预测服务。