只有人口统计表,能造出一座有家庭、学校和同事的北京吗?
论文名片|Yuanzheng Ge、Rongqing Meng、Zhidong Cao、Xiaogang Qiu、Kedi Huang,Virtual city: An individual-based digital environment for human mobility and interactive behavior,SIMULATION,2014,90(8):917—935;2014年5月9日首次在线发表。DOI:10.1177/0037549714531061。
设想要在计算机里研究城市中的人际接触:孩子白天去学校,父母去单位,晚上回到同一个家庭。如果手头只有各年龄人口有多少、家庭规模如何分布,以及某区有多少学校,缺失的恰好是最关键的连接:谁和谁住一起,谁去哪所学校,又会遇见谁。
这篇论文的回答是,用统计数据约束生成规则,补出一套能彼此连接的虚拟居民、设施和关系。研究者以2010年前后的北京统计数据构造约1961.9万名虚拟居民,让每个人都有家庭、社会角色和相关地点。它提供大规模计算实验的初始环境,理解其价值也需要分清:哪些来自统计,哪些由规则补出来。
先说结论
- 框架把人口、城市设施、人与地点的分配关系、社会网络整合起来,生成约1961.9万人和496.1万户,而非只有彼此孤立的虚拟个体。
- 年龄、性别、家庭规模与输入统计相近;父母、孩子及祖辈的年龄关系通过规则保持基本合理。这支持特定统计与逻辑的一致性,尚不能证明每个家庭或联合分布都逼真。
- 最细真实空间信息到街道层级。设施在街道内部随机落点,通勤距离的一项检验也是与输入的对数正态分布比较,不能读成对真实北京通勤轨迹的独立验证。
- 家庭、学校、单位形成不同关系网络,便于以后模拟互动;本文没有进一步验证疫情干预效果,也没有纳入交通运输系统。
怎样让虚拟人口成为家庭,而不只是一串年龄?
合成人口(synthetic population)指按统计约束生成的一组虚拟个体。个体具有年龄、性别、家庭编号和角色,但不对应被识别出来的真实居民。表1所需的输入包括人口总量、年龄性别分布、家庭规模、人口空间分布及家庭子女数量等。
如果分别随机抽年龄和家庭编号,很容易得到逻辑冲突的家庭。因此,模型先决定一户有多少人、含几代人,再生成长辈及其配偶、子女。家庭角色包括祖父母、父母、孩子。论文只考虑最多三代人的结构,这是一项简化,不能覆盖所有现实家庭。
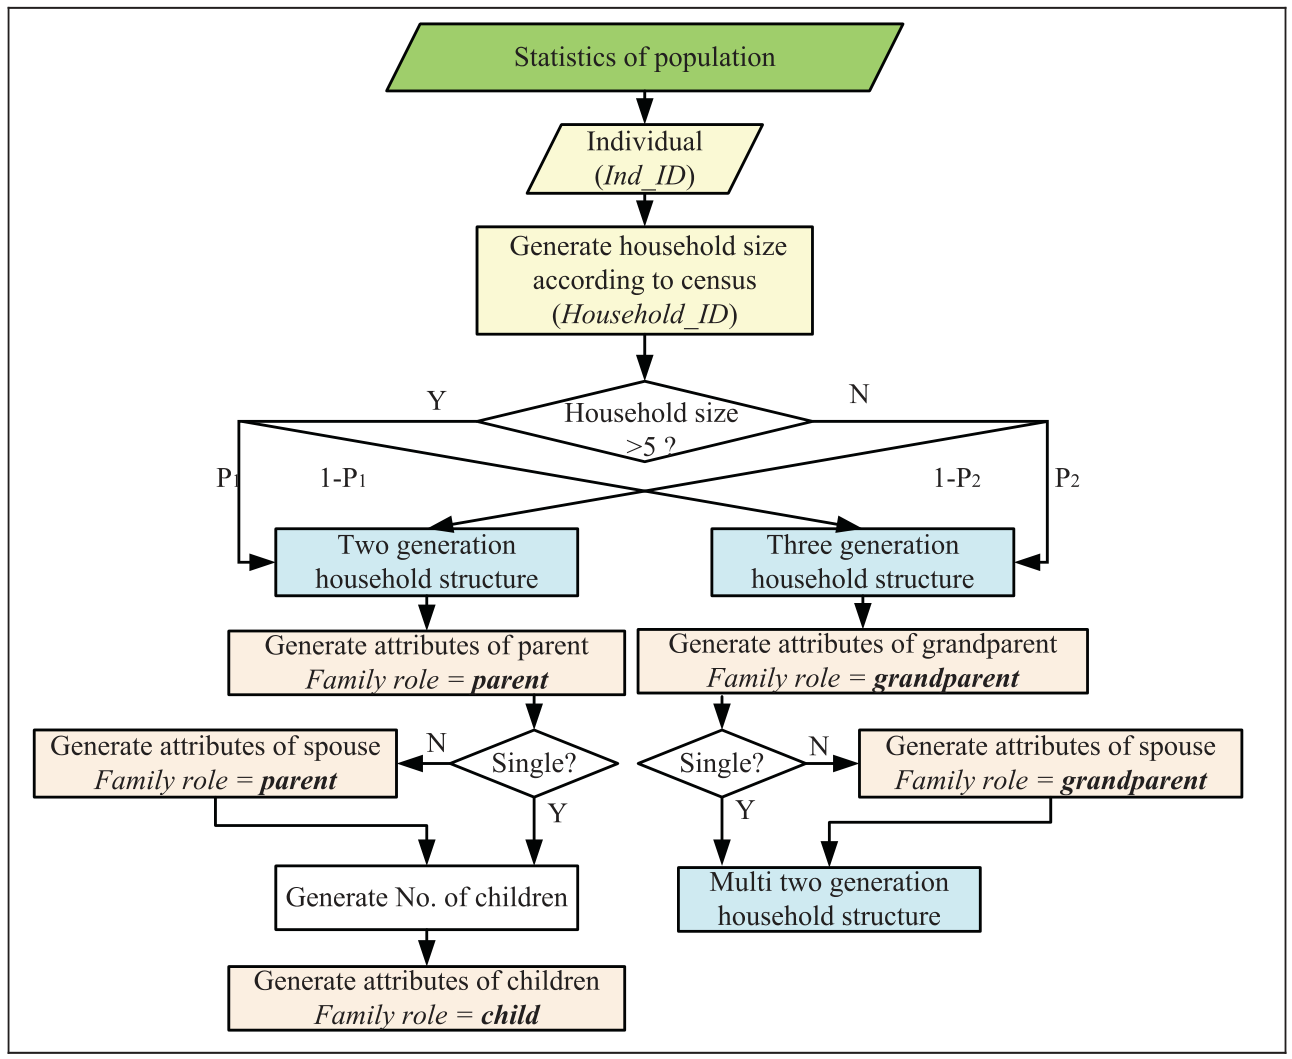
图 1|怎样把人口总量变成内部有关系的家庭?
流程由人口统计和家庭规模出发,通过结构选择与概率参数,区分两代、三代等家庭安排,再生成配偶和子女。原图没有子图字母。它展示的是建模规则,而不是从真实家庭资料中恢复关系。来源:原论文 Fig. 1。
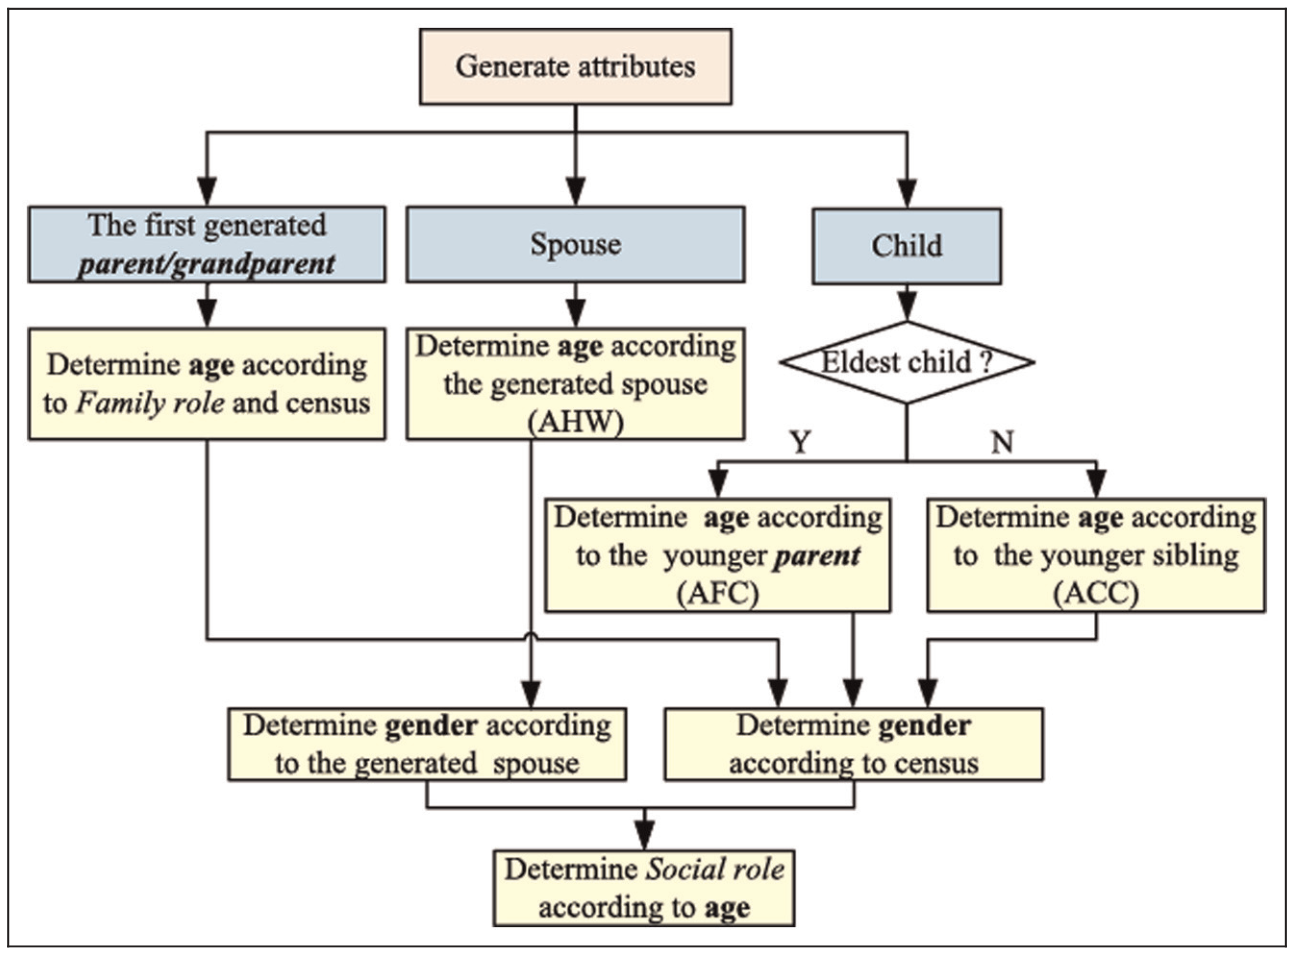
图 2|同一户里的成员,年龄怎样相互约束?
先生成父母或祖辈的属性,再根据配偶年龄差、初育年龄和相邻子女年龄差生成其余成员;最后按年龄分配社会角色。图中箭头表示生成顺序,无子图字母。来源:原论文 Fig. 2。
表2、表7把这些关系写成参数。北京案例的配偶年龄差采用限制在0—10年的正态形式,母亲与最年长孩子的年龄差限制在18—35年,相邻子女年龄差取1—5年的均匀分布。这些设定避免明显不合理的搭配,也会直接影响模拟家庭的形态,不能拿生成出来的年龄差分布反过来证明设定就是现实规律。
表3进一步把年龄映射到婴幼儿、学生、劳动者、老年人等社会角色,再按失业率从劳动者中抽出失业者。年龄与社会角色的对应是简化规则;真实教育和就业经历远比固定年龄段丰富。
人造出来以后,房子、学校和工作岗位放在哪里?
人口能活动,需要有相关场所。框架区分住宅、教育机构、工作场所、消费场所、娱乐场所、医疗机构六类环境,用来支撑休息、学习、工作、出行、就餐、消费、娱乐和住院等活动。教育与医院同时也可以是工作场所,不能把每类设施简单当作互斥名单相加。
表4要求学校数量、师生比、年级数量和班级规模;表5要求工作场所类型和可容纳员工数。容量很重要:离家最近的学校如果已满,不能继续无限分配学生。企业规模还参考齐普夫形式的规模分布。缺失的微观信息便由这些统计与假设共同补齐。
| 北京案例中的输入或生成规模 | 论文所列数值 |
|---|---|
| 人口 | 1961.9万人 |
| 男性、女性 | 1013.0万、948.9万人 |
| 家庭 | 496.1万户 |
| 住宅建筑 | 44,745处 |
| 工作场所,其中企业 | 101,829处,其中11,431处企业 |
| 幼儿园、小学、中学 | 1,305、1,090、635所 |
| 中等职业学校、大学 | 91、73所 |
这些数字来自表7、表8。各类设施的地理坐标却不直接来自真实地址:北京案例可获得的最细人口信息到街道层级,设施数量按人口分配到街道,再在相应范围内随机放置。模型中的一个住宅点也可能容纳许多家庭,不是每户一座独立房屋。
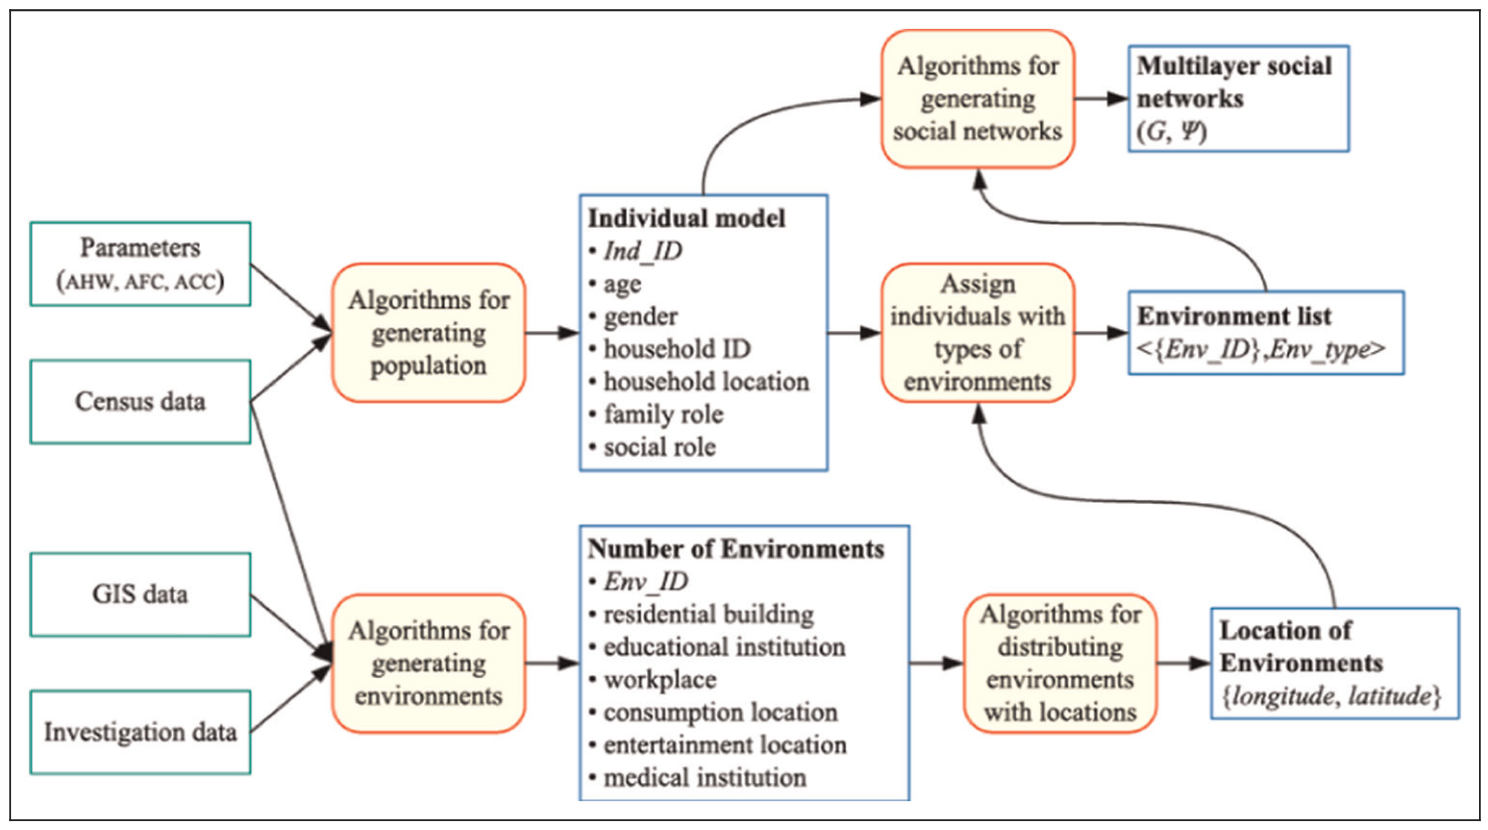
图 4|居民、设施和社会关系,靠什么连接起来?
左侧统计、地理与调查数据分别进入人口和环境生成过程;中间个体属性决定可关联的设施类型;右侧输出个人地点清单、设施位置与多层关系网络。无子图字母。来源:原论文 Fig. 4。
所以,“带有经纬度”不等于“找到了真实楼宇”。随机落点没有识别实际用地、道路、河流和建筑轮廓,街道内部的微观空间细节仍然是假设。论文也指出,加入土地利用信息有望改善这种安排。
怎样决定一个孩子去哪所学校、一个成年人去哪里工作?
论文提供三类分配办法:在容量允许时选最近场所;按给定距离分布抽一个距离,再找符合条件的场所;或在指定区域内随机分配。表6具体写出了按距离分配学校时的循环:选中学校若满员,就换候选;该距离范围没有可用学校,则重新抽距离。
北京案例中,幼儿园、小学和中学的分配主要采用就近与学区限制。劳动者到工作场所的分配则采用对数正态距离规则。市场、餐馆、公园等还能给一个人关联多个候选地点。这些是可访问地点或固定地点的关联,不等于已经生成连续一天里每一次出门的时间与实际行程。
但千万级人口若逐人与所有设施计算距离,计算量会非常大。模型先把城市划成1公里网格,再查指定距离的网格环带,在有空余名额的网格和设施中选择。
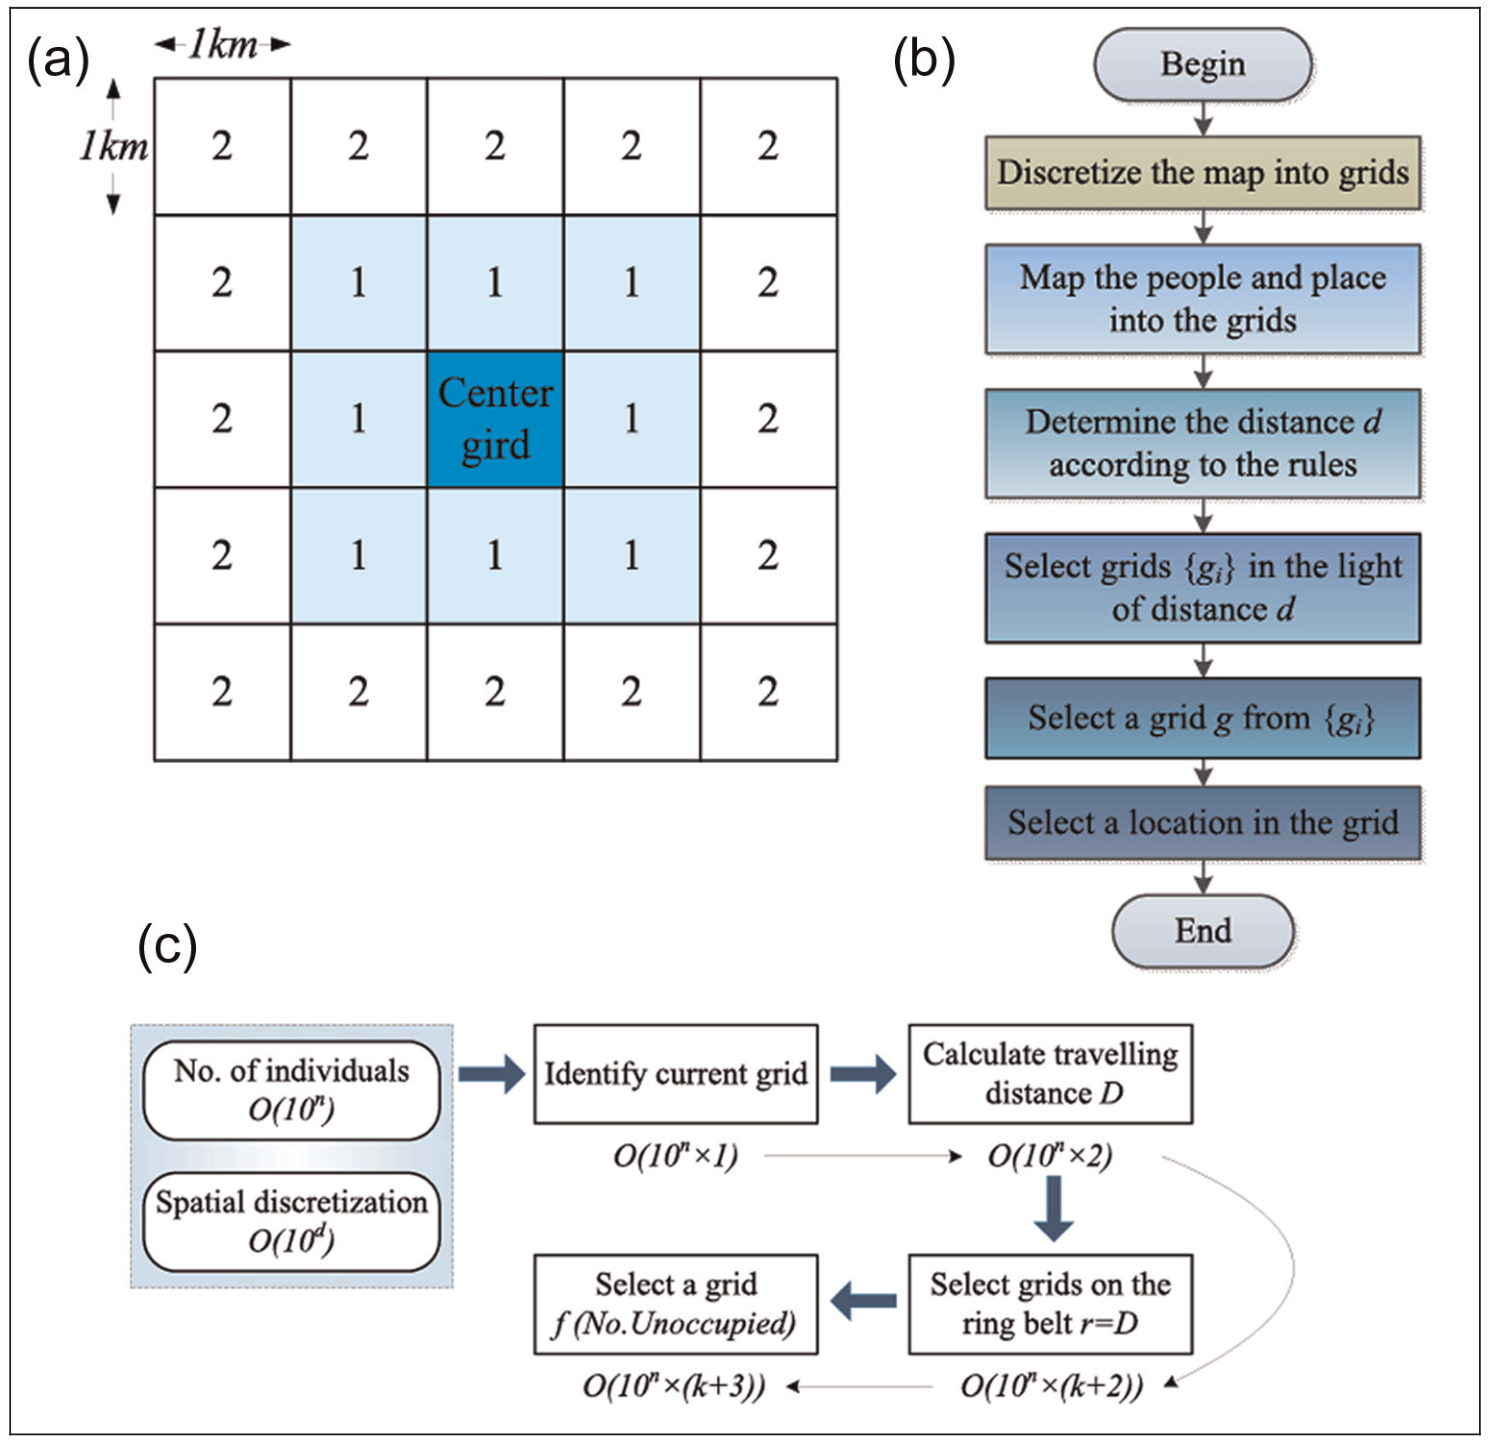
图 3|为什么先找网格,再找具体场所?
(a)中心格周围的方形环带把空间分成不同距离层;(b)流程先确定距离和候选网格,再找网格内的地点;(c)说明这种搜索怎样减少逐一比较所有设施的开销。来源:原论文 Fig. 3。
网格环带是对距离的粗化处理,不是道路网络最短路,也不代表坐车时间。名额多的网格更容易被选中,用空余岗位或学位表示吸引力。由此生成的分配仍受设施位置、容量与抽样规则共同影响。
整个北京案例用C++在四个计算节点和一个数据库节点组成的集群上生成,约耗时15小时。这个结果说明当时硬件下构建全量初始环境可行,不能直接解释为城市能被实时更新或逐秒仿真。
数字对得上,就说明虚拟居民足够真实吗?
首先要检查基本约束是否保住。图5把生成的年龄、性别和家庭规模,与输入统计直接比较。若这些基础量就大幅走样,后面的家庭与地点安排也无从谈起。
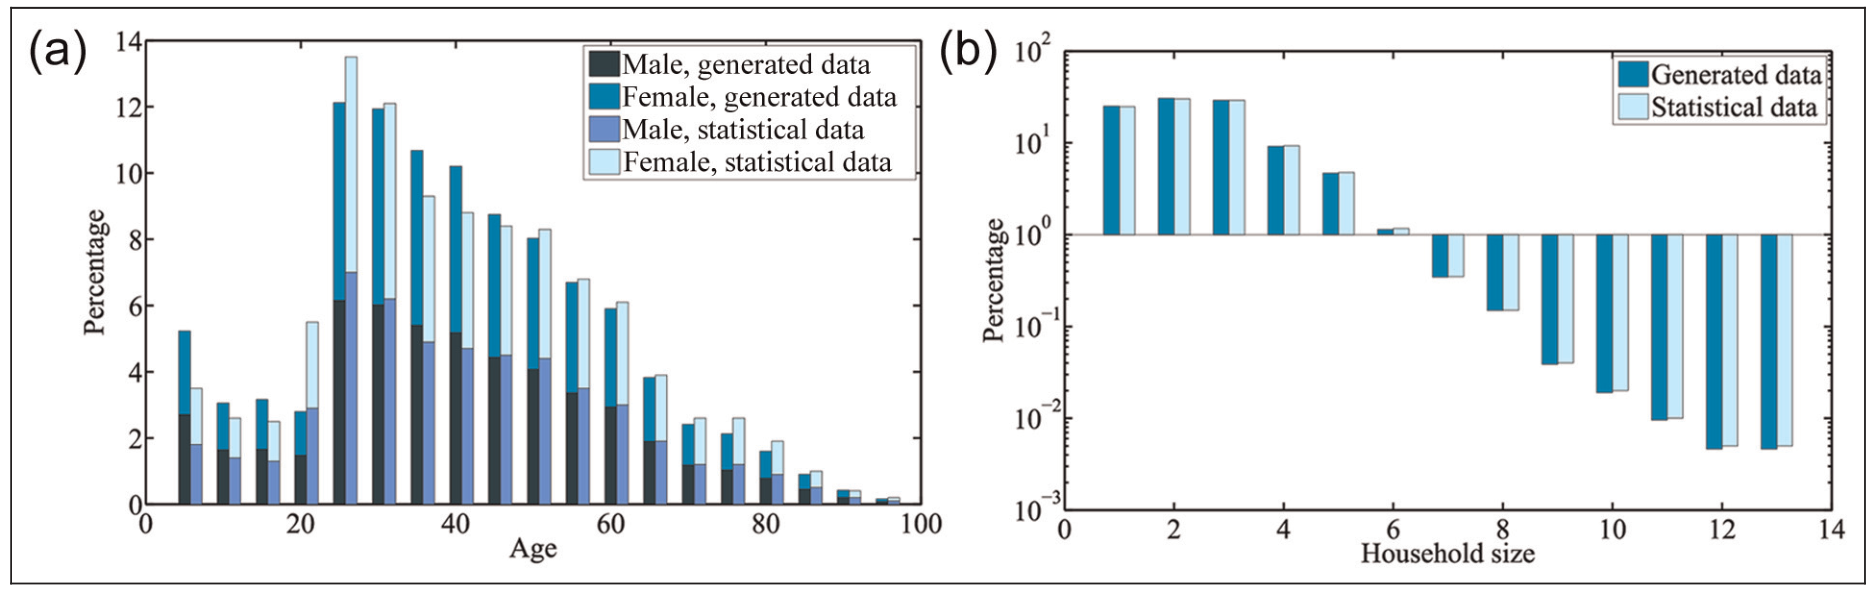
图 5|生成后的人口,保住了哪些输入特征?
(a)按年龄比较生成与统计数据中的男女比例,横轴为年龄、纵轴为百分比;(b)比较不同家庭人数所占比例,纵轴为对数刻度。不同颜色、深浅对应图例中的生成数据与统计数据。来源:原论文 Fig. 5。
这些曲线相近,说明生成方法能较好保持所选边际统计。但校验对象也是生成时使用的目标分布,属于内部一致性检验。家庭角色与社会角色没有同等细致的公开真实资料供独立比较,因而需要继续看结构是否符合规则,而不能称为已经恢复现实家庭。
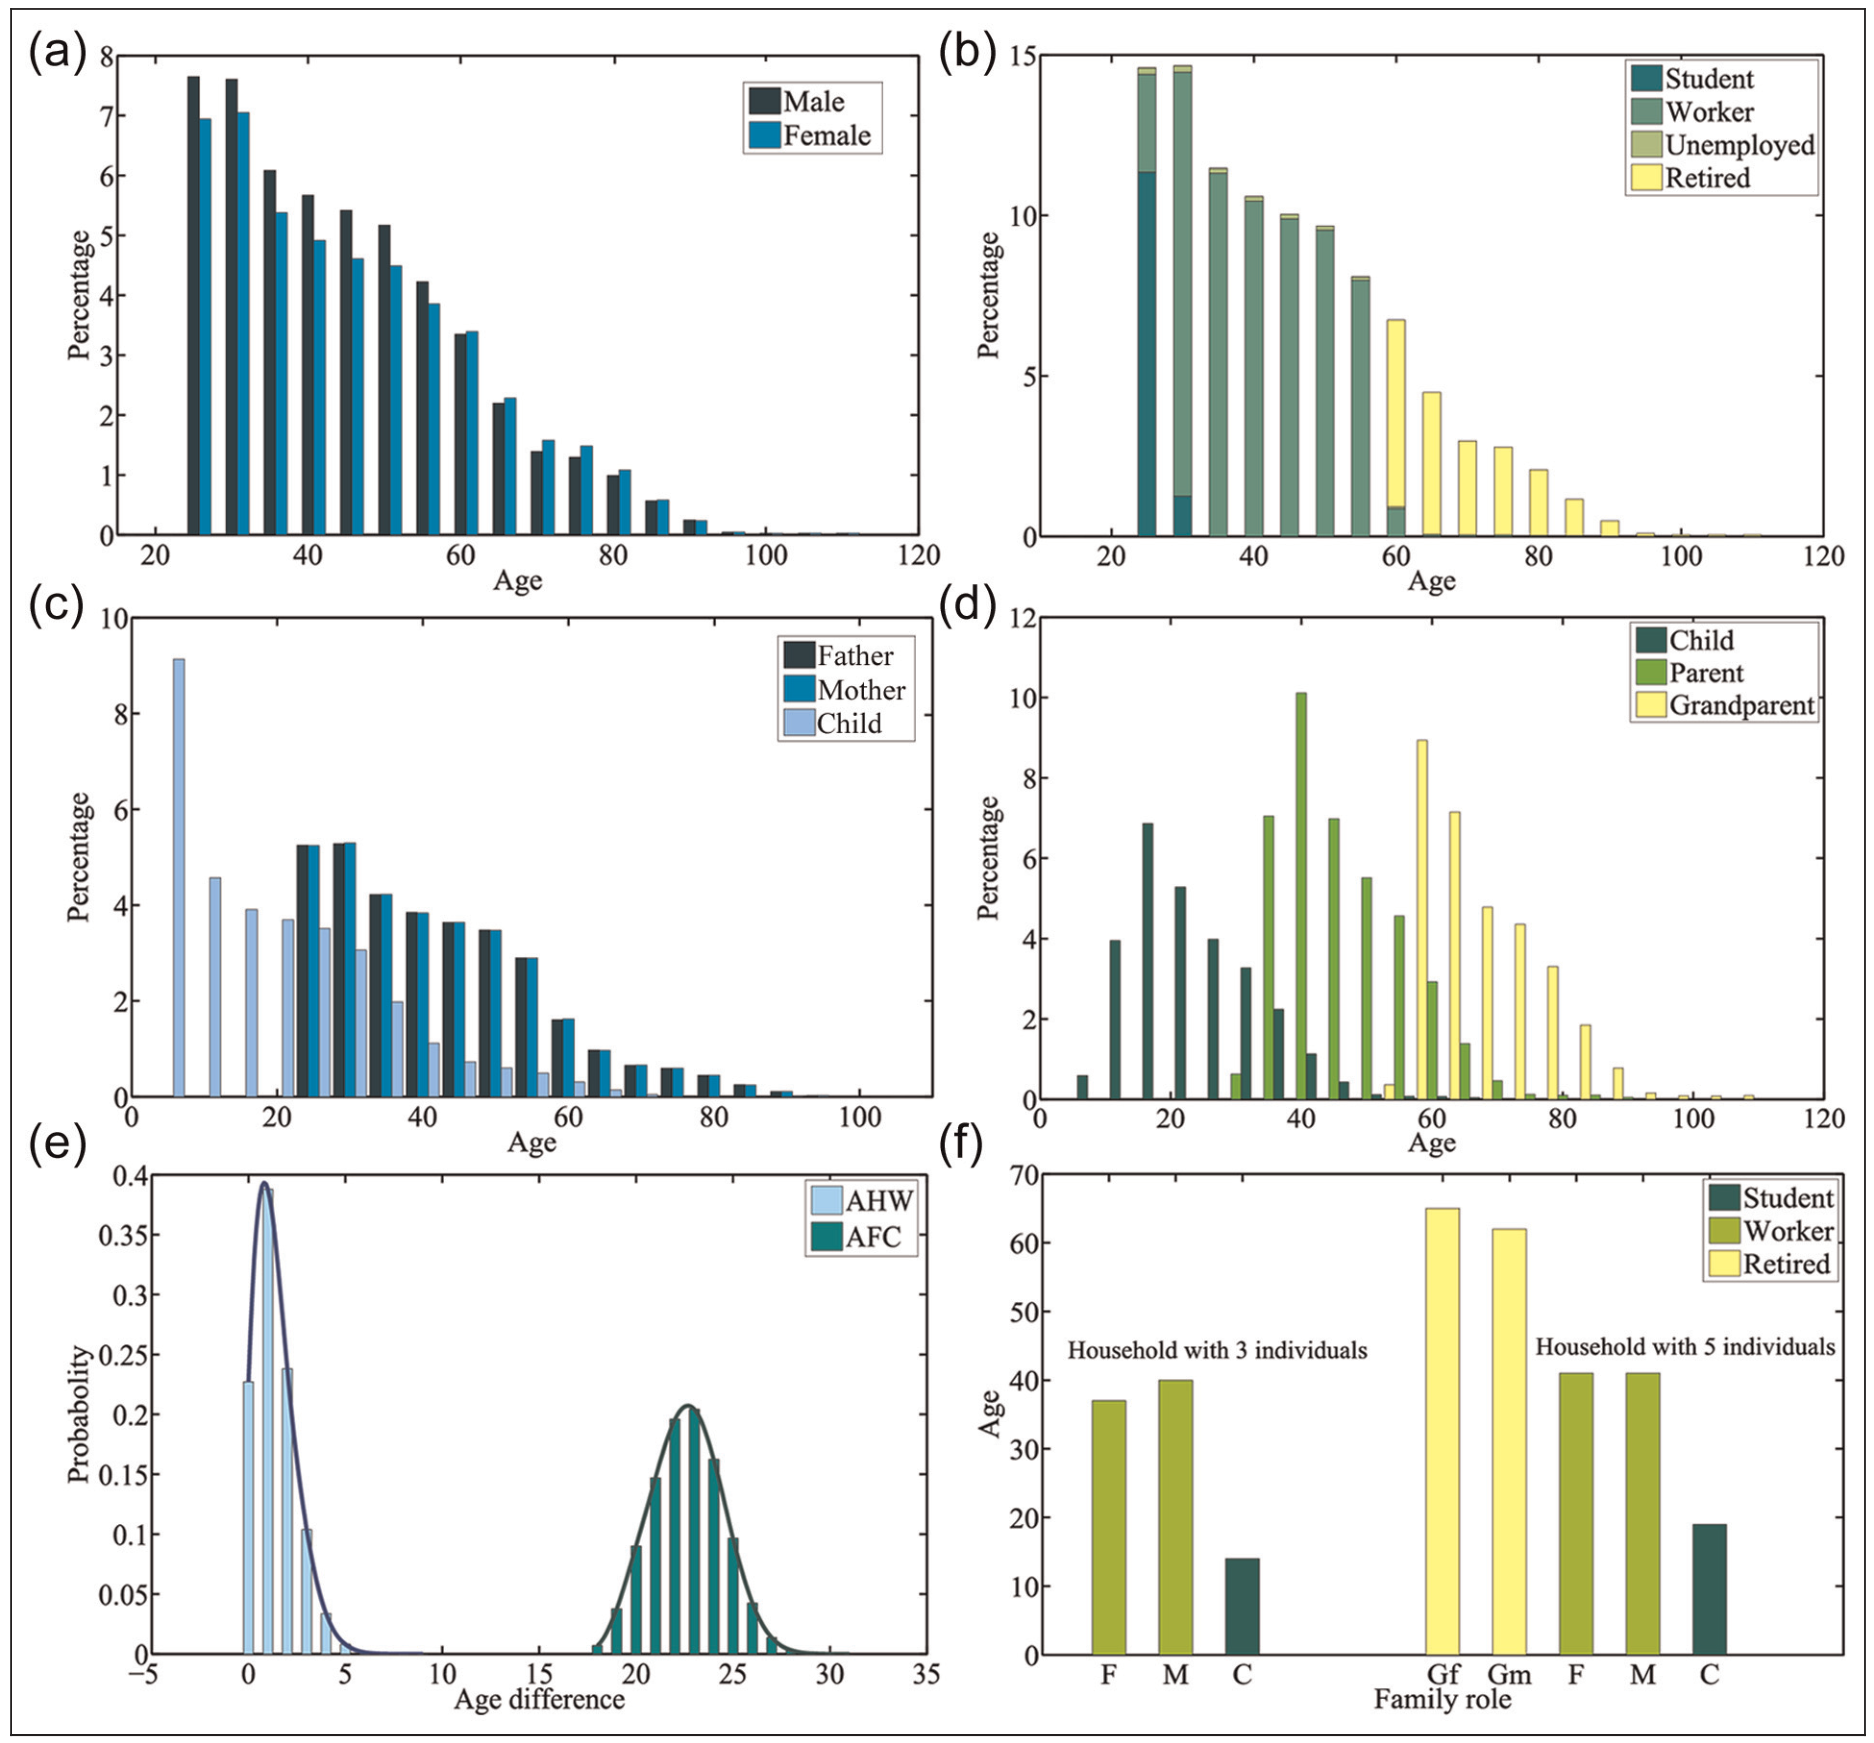
图 6|家庭结构的合理性,表现在哪些具体地方?
(a)单人家庭成员的年龄、性别分布;(b)同类家庭不同年龄段的学生、劳动者、失业者和退休者比例;(c)三人家庭父亲、母亲和孩子的年龄分布;(d)五人家庭祖辈、父母、孩子的年龄分布;(e)配偶年龄差AHW与母亲和最年长孩子年龄差AFC的概率分布;(f)各选一个三人、五人家庭展示成员年龄和社会角色。来源:原论文 Fig. 6。
父母与孩子曲线分离、三代家庭出现年龄间隔,说明规则避免了一些明显的逻辑错误。图6中的具体家庭只是生成样例;配偶年龄差与初育年龄形态本来就受输入参数规定,不能把图上的合理外观当成全体微观家庭关系的外部证据。
地图上的集中分布,是模型发现了什么,还是沿用了什么?
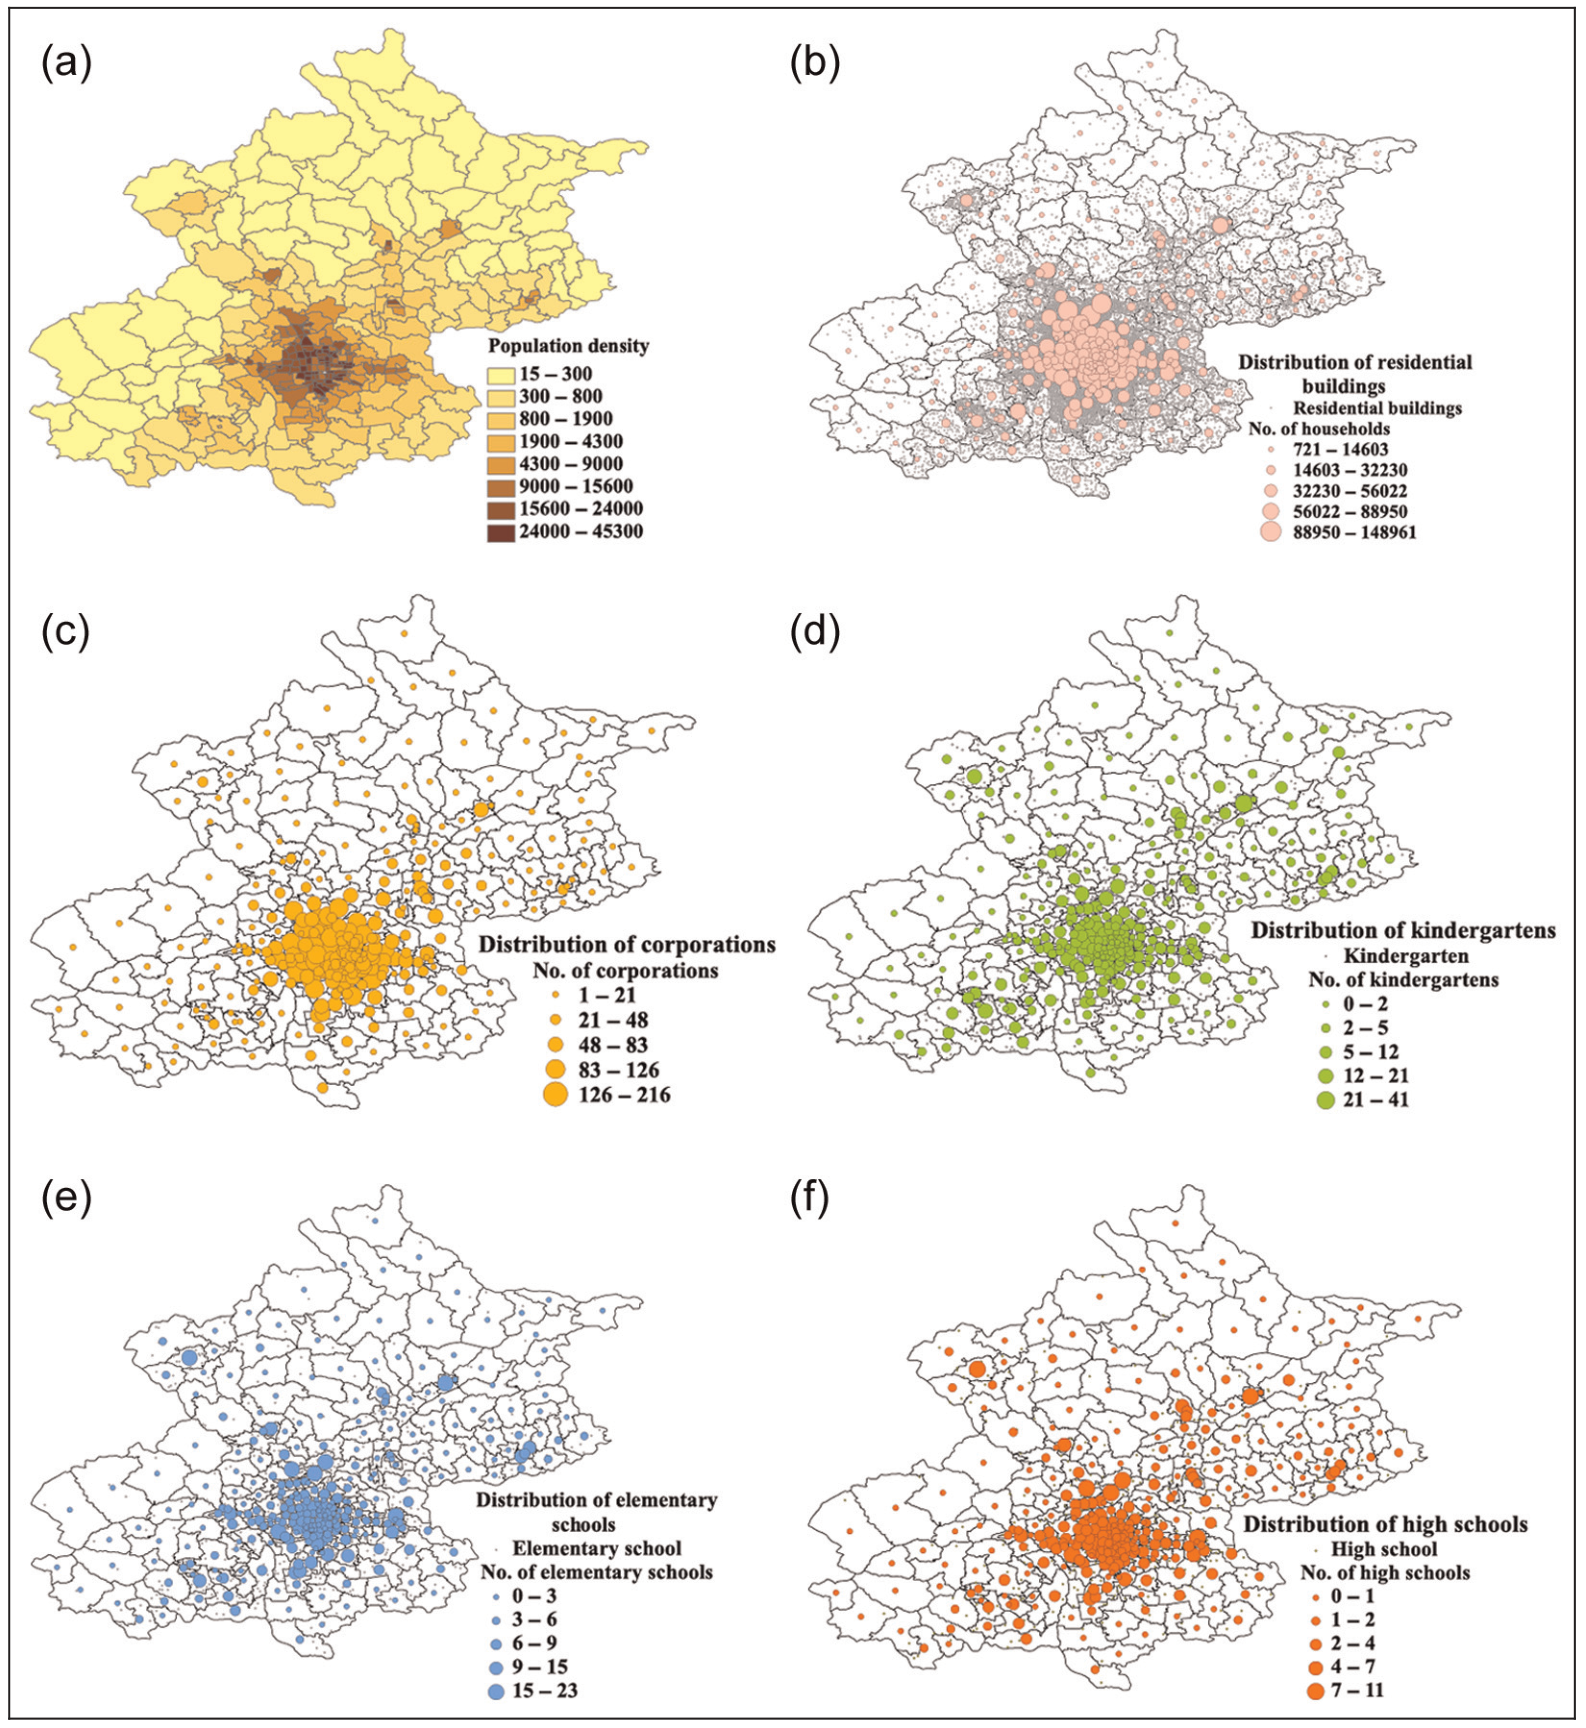
图 7|各类场所为什么都向人口密集区集中?
(a)街道层级人口密度,颜色越深表示越密;(b)住宅建筑点及街道家庭数的分级圆;(c)企业位置与街道企业数量;(d)幼儿园;(e)小学;(f)中学。后四类设施同样用点表示位置、圆大小表示相应数量。来源:原论文 Fig. 7。
图中人口和设施的集中趋势相近,与设施按人口分配的生成方式一致。它可以让后续模型在一个空间上不均匀的环境中运行,却不能独立证明现实学校、企业与居住人口恰好这样分布。尤其工作岗位不一定与居住人口成比例,混合用地、产业集聚和学校布局都可能使真实分布偏离这个基线。
这条边界也直接影响出行距离。就近规则会让设施更密的区域更容易出现较短距离;如果设施放置有偏差,模拟的中心与外围差异也可能随之变化。
生成的出行距离,究竟验证了哪一层?
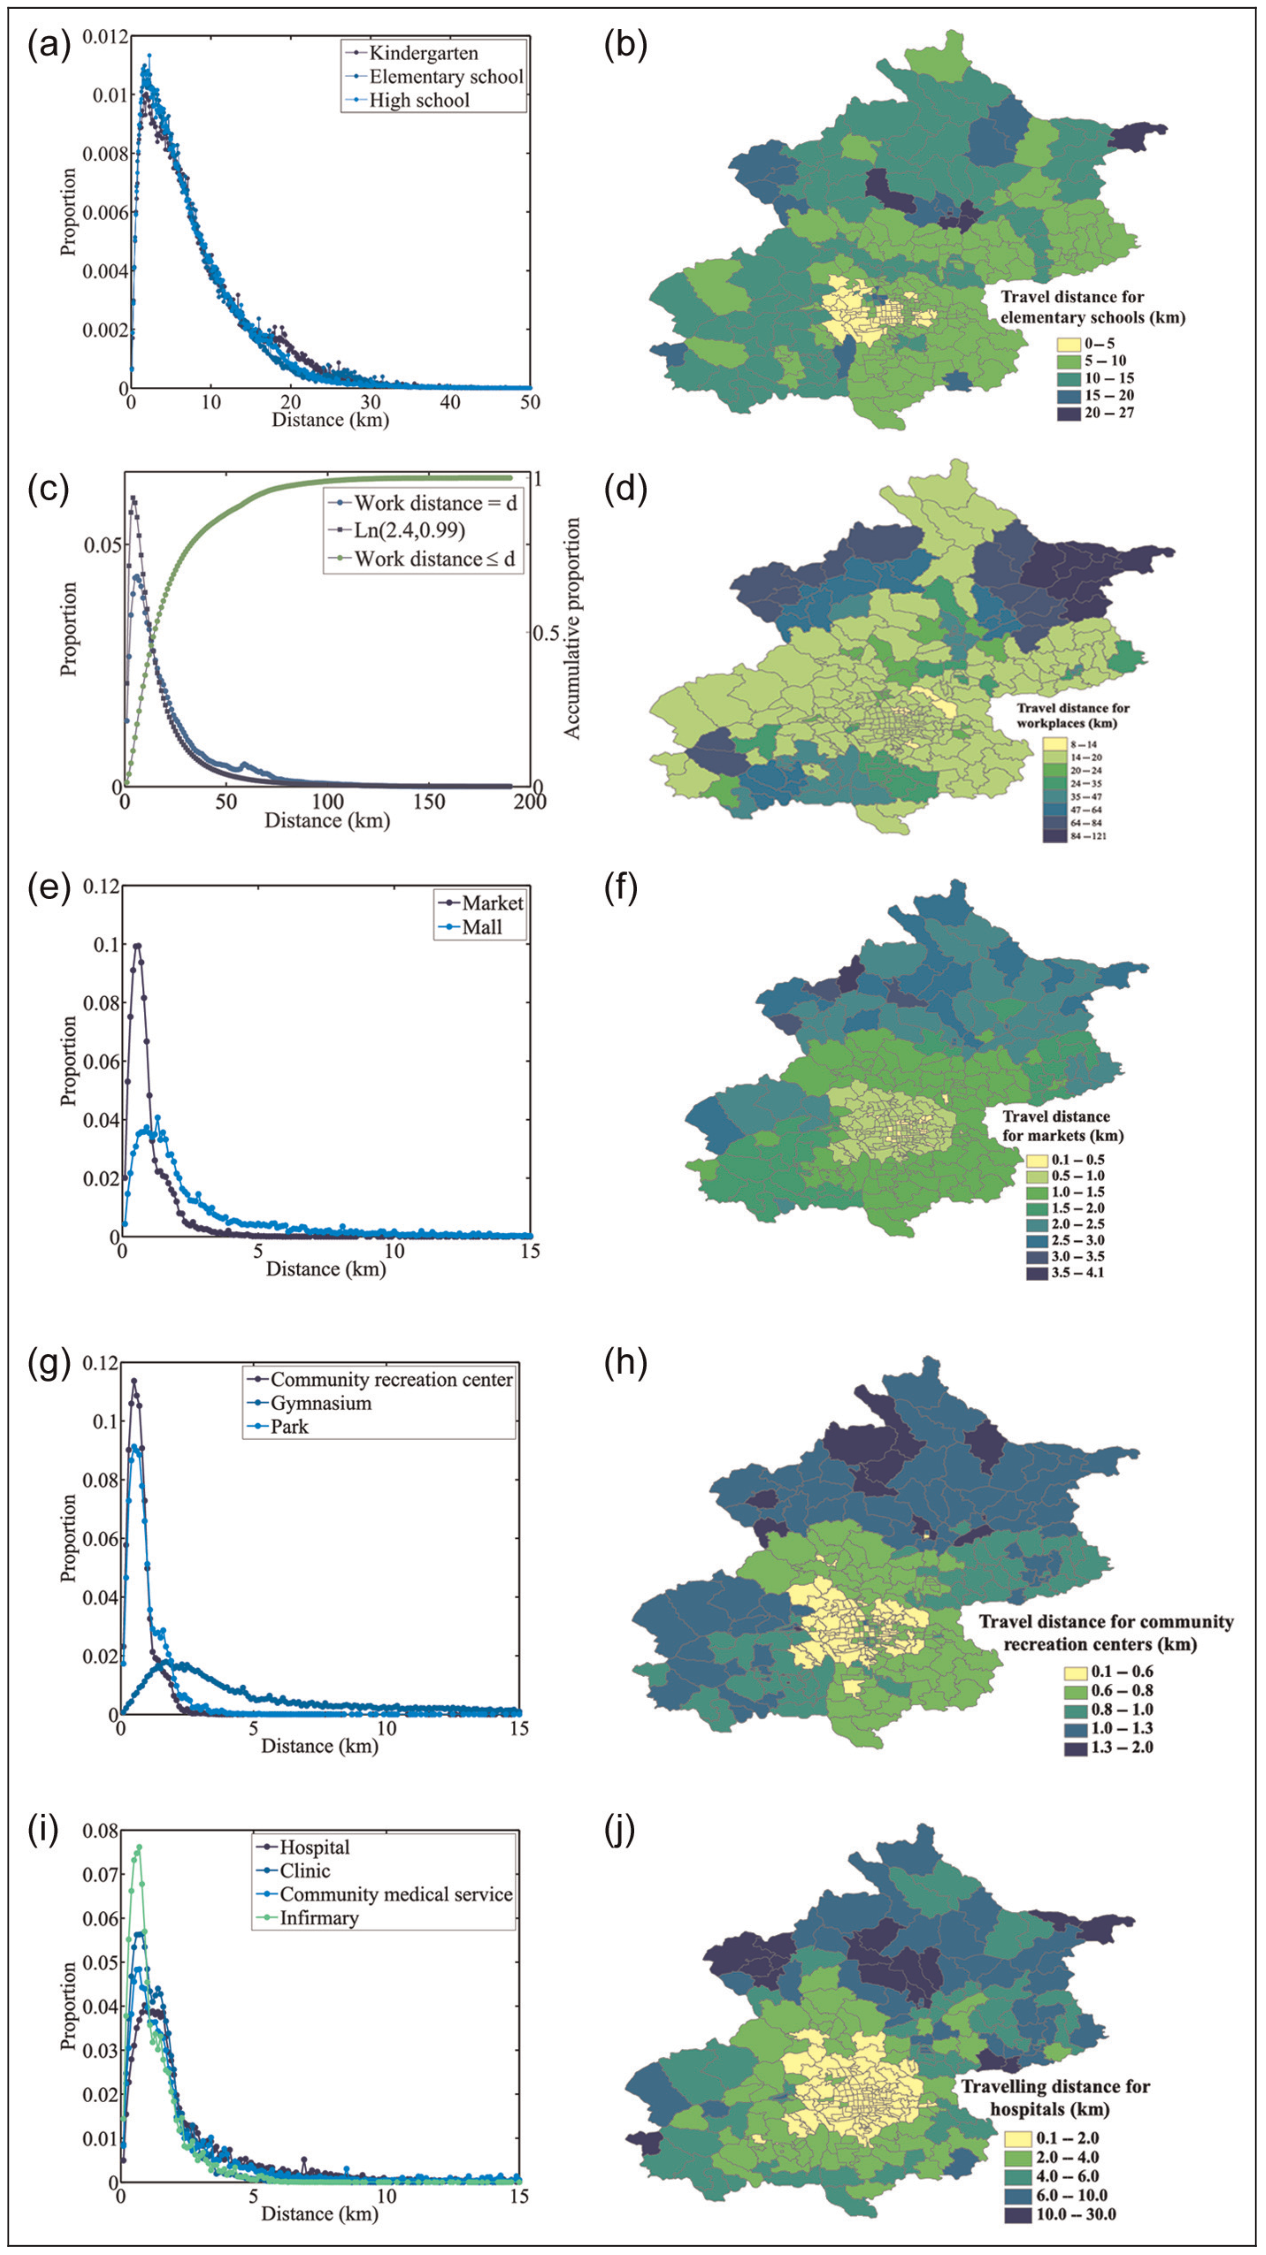
图 8|同一座虚拟城市,不同活动的距离为什么不同?
(a)幼儿园、小学和中学学生的居住地—学校距离比例分布;(b)各街道小学生平均距离;(c)劳动者居住地—工作地点距离及所用对数正态规则,含比例与累积比例两个纵轴;(d)各街道平均工作距离;(e)消费地点中的市场与商场距离分布;(f)居住地—市场平均距离;(g)社区活动中心、体育馆和公园距离分布;(h)居住地—社区活动中心平均距离;(i)医院、诊所、社区医疗点和医务室距离分布;(j)居住地—医院平均距离。曲线横轴为公里,地图色阶表示街道平均距离,面板色阶各不相同。来源:原论文 Fig. 8。
学生距离多在10公里以内,模拟的中心区域通常更短。市场比商场密,因而就近安排时前往市场距离往往更短;社区活动中心比公园分布更广,模拟居民到前者通常也更近。这些对比说明设施布局和分配规则能共同形成不同活动的距离差异。
劳动者的距离生成采用Ln(2.4, 0.99)对数正态规则。图8(c)生成分布约在6公里达到峰值,与输入分布比较的误差平方和为0.0021。这是在检验分配程序能否实现规定的距离形态。输入规则引自既有研究,并非本文用独立北京轨迹估计;较小误差不能转写成“已准确预测北京人的通勤”。
同样,医疗地图里的较短距离表示在这套生成位置和就近关系下距离较短,没有同时衡量床位竞争、道路通行、医疗质量或实际就医选择,不能直接当作完整的医疗可及性评价。
家庭之外,虚拟居民会和谁形成关系?
如果只把两个人分配到同一所学校,仍需要决定他们是否相识。论文用多层社会网络(multilayer social networks)把家庭、邻里、学校和工作关系加进去。表9明确区分社会角色:学生有家庭、邻里、学校朋友与师生关系;劳动者还有同事关系;失业者和退休者在此模型中主要保留家庭与邻里关系。
底层小群体采用完整连接,例如家庭成员相互相连。向更高层扩展时,再以概率添加不同小群体之间的边;概率取决于已有关系数相对上限的比例,并随层级提高而衰减。学校可从班级扩展到年级、全校,企业也有更高层组织。这里的层级指生成规则中的组织范围,关系数是算法赋予的连接数量,并非直接记录的面对面接触频率。
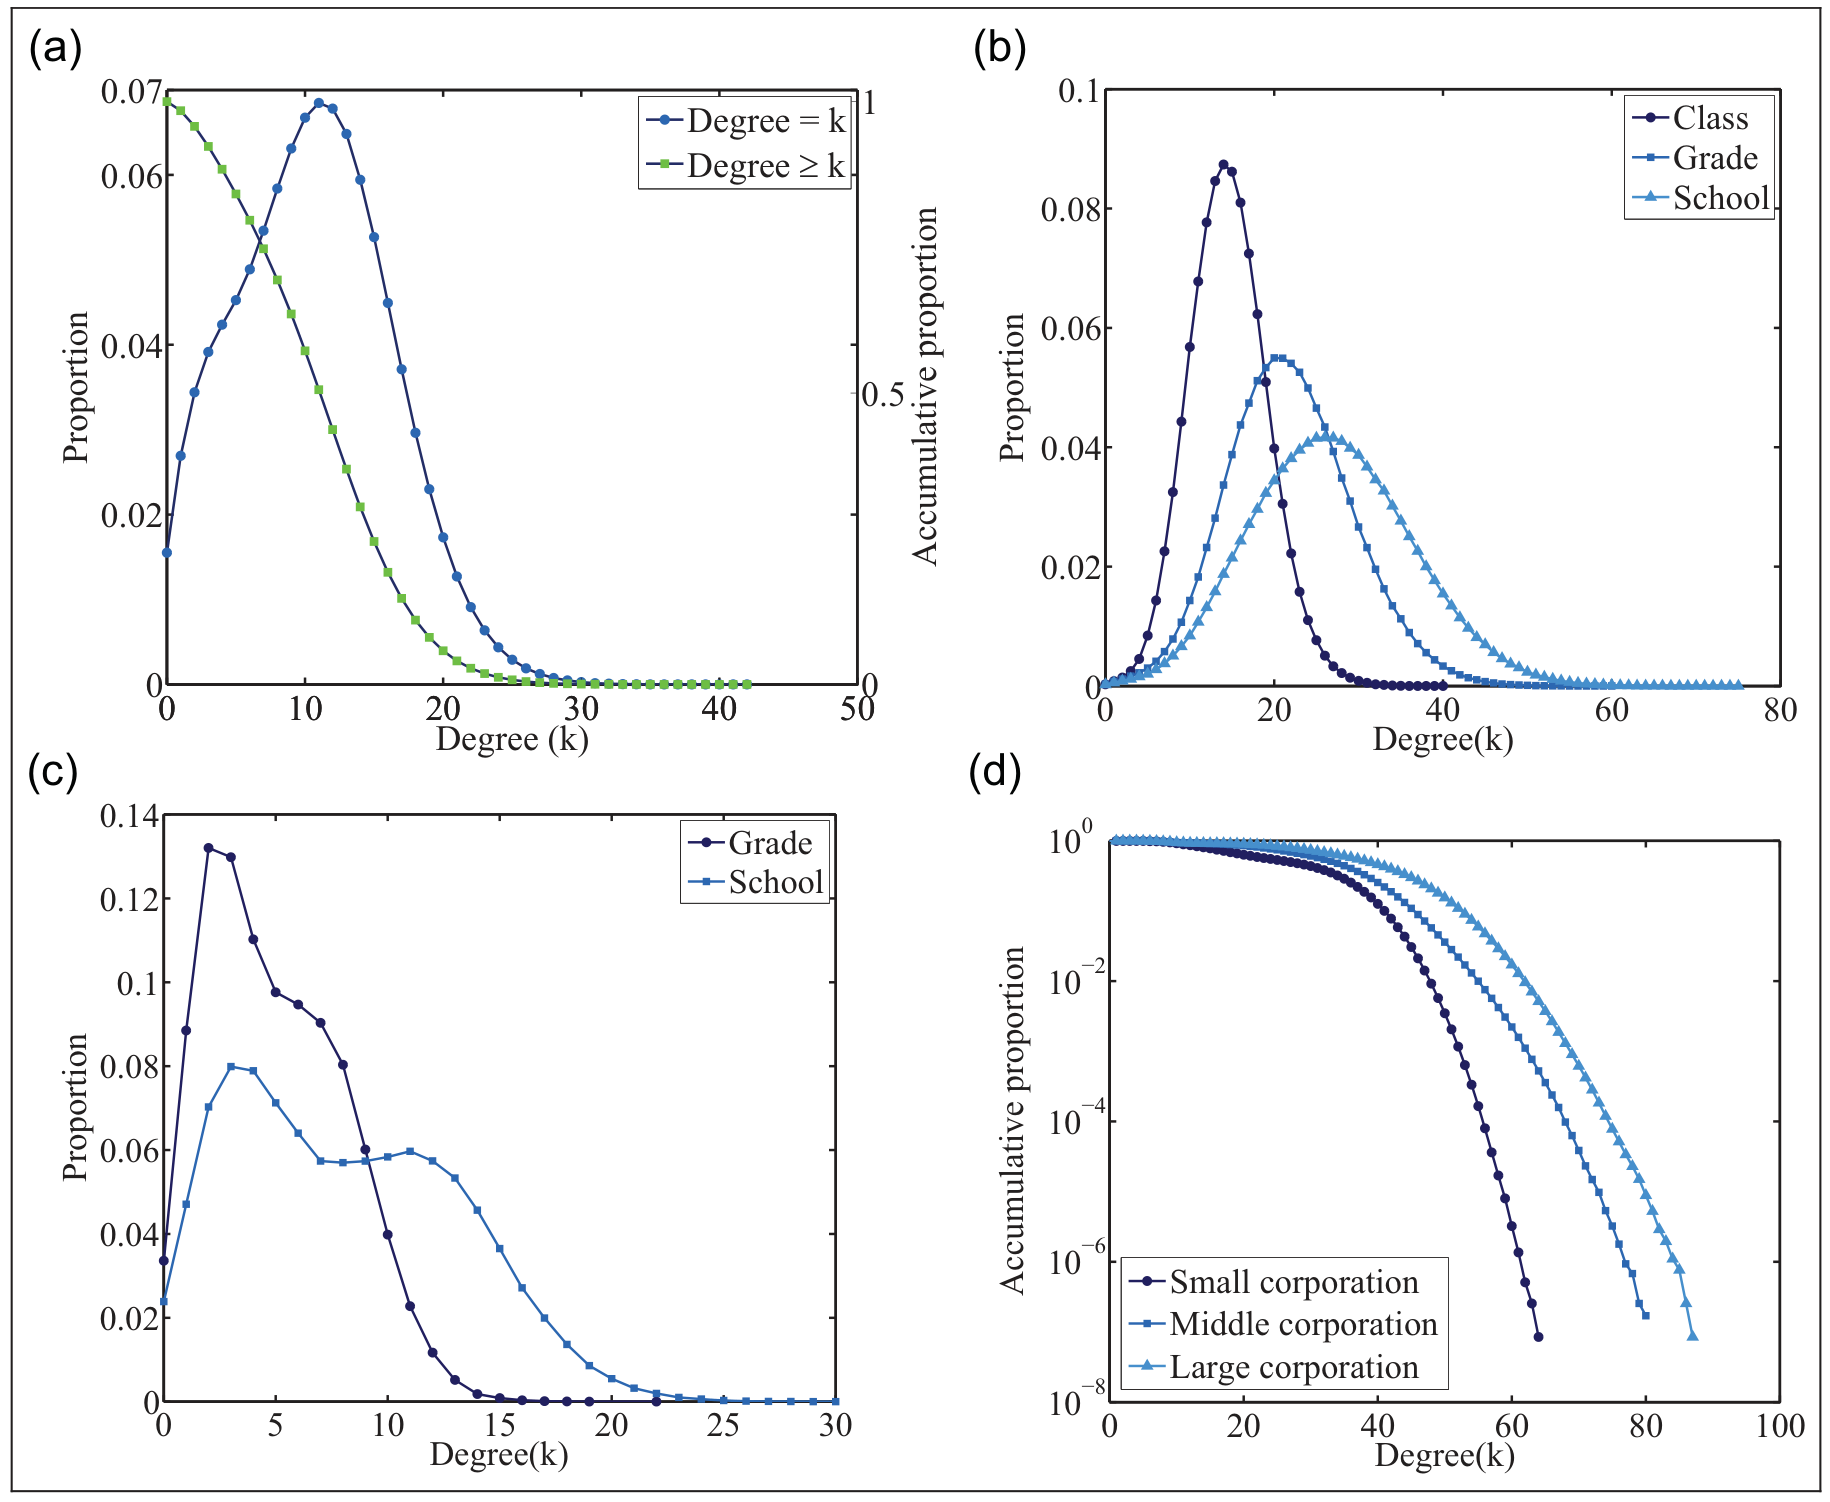
图 9|扩大组织范围后,一个人会多出多少关系?
(a)邻里网络的度分布和右轴所示“度至少达到k”的累积比例,注意这条累积曲线随k递减;(b)学生班级、年级、全校层级的朋友数量分布;(c)教师在年级和全校范围的同事数量分布;(d)不同规模企业员工的同事数量累积比例,纵轴为对数刻度。来源:原论文 Fig. 9。
更大组织范围对应更多潜在关系,但关系数不会随企业规模同比增加,模型因而呈现局部聚集。这个输出适合作为后续互动实验的网络基础,却还没有经过真实学校友谊或工作接触名单检验。模型中失业者和退休者没有某类工作关系,也不意味着现实中他们只有家庭和邻里交往。
这座虚拟城市,能用来回答什么问题?
它最直接的贡献是提供一致的初始对象:研究者可以在同一框架中找到某个人的家庭、工作或学校、候选活动地点及社会关系,再叠加具体行为或事件模型。人口不是只有一个总量,设施也不是孤立的地图点。
但本文没有交通运输系统,不能直接回答拥堵、公交换乘或疏散路线问题;没有在这里完成疫情传播及干预效果验证,也不能把潜在应用写成已经证明的政策收益。作者还明确承认,粗空间数据、行为量化不足和随机生成过程会带来误差。
因此使用时应同时保留两张清单:输入统计已经约束了什么,规则又额外假定了什么。前者相符,是模型应达到的基本要求;后者是否适合某项应用,还需要新的数据和检验。
一句话总结
少量统计可以支撑一座内部相连的虚拟城市,但它的可信范围由保住的统计、补入的假设和独立验证共同决定。
核心来源
- Ge, Y., Meng, R., Cao, Z., Qiu, X. & Huang, K.(2014). Virtual city: An individual-based digital environment for human mobility and interactive behavior. SIMULATION, 90(8), 917—935。论文DOI,出版社当期目录。本文方法、表1—9及全部图1—9据原论文,图均保留完整原组合。
作者介绍
以下按原论文署名与文末简介介绍发表时身份,不推断当前任职。
- Yuanzheng Ge:国防科学技术大学信息系统与管理学院署名作者,论文简介所列方向为基于智能体的建模、人工社会与复杂社会网络。
- Rongqing Meng:同学院署名作者、本文通讯作者,研究方向包括人工社会、合成人口与系统仿真。
- Zhidong Cao:中国科学院自动化研究所复杂系统管理与控制国家重点实验室署名作者,文末列出社会计算、公共卫生、应急管理与空间分析方向。
- Xiaogang Qiu:国防科学技术大学信息系统与管理学院署名作者,研究方向包括并行与分布式系统、应急管理和知识工程。
- Kedi Huang:同学院署名作者,研究方向包括并行与分布式系统、云计算、高性能计算及基于智能体的建模仿真。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同一组人口统计可能对应许多不同的微观城市。如果把设施在街道内重新随机放置,多生成几十座城市,某项结论是否仍然成立?若结果对随机种子非常敏感,就需要把这种范围作为不确定性报告,而不只展示一张最像现实的地图。
还可以故意构造几种都符合人口统计、却具有不同职住分离程度的城市。若某项政策在这些城市里方向一致,其结论才更有稳健性;若方向相反,最值得补采的数据便不是更多人口总量,而是住宅、岗位和活动之间的连接。