摄像头看见了很多人,就等于完整记录了他们怎样使用广场吗?
论文名片|Nils Wolff、Layne Perry、Titus Venverloo、Geertje Slingerland、Jessica Wreyford、Paolo Santi、Fábio Duarte,Pedestrian Trajectory Dataset of Public European Squares,Scientific Data,2026,13:402。2026 年 2 月 10 日首次在线,3 月 18 日正式版本。论文 · 数据 v1.1 · 处理代码 v1.0.1。
广场上,一位行人直穿而过,另一位在树荫下坐了很久。摄像头可能在许多帧中都成功识别出两个人,却把坐着的人反复分配为新的 ID。结果看起来像许多人短暂停留,而不是同一个人长时间休息。
这正是理解这份数据必须跨过的一道门槛。论文公开 39 个欧洲广场、约 34.8 万条机器提取的行人轨迹及处理方法,为跨地点比较提供共同材料;它同时坦率展示,检测准确、轨迹完整、地理位置准确,是三件需要分别验证的事。
四点主要发现:
- 公共网络摄像头与统一处理流程,可以低成本收集多地广场轨迹,但地点与录制时段经过选择,并不代表全部欧洲公共空间。
- 在 50 帧人工检查中,行人检测总体精确率 93.8%、召回率 92.8%;这不是整条轨迹的完整率。
- 200 条分层抽样轨迹中,移动轨迹约 56.5% 完整,静止轨迹没有一条被评为完整;停留研究尤其要防范碎片化。
- 地理配准在两个广场表现不同,且轨迹总量、日期和部分表格分母存在文档不一致,使用者必须固定数据版本核对。
39 个广场,是怎样被选中的?
研究从公开网络摄像头目录选择能拍到广场、可以录制、至少 15 帧/秒、没有明显延迟压缩瑕疵且行人清晰可见的画面。这是一种受摄像头位置和图像质量限制的便利样本,不是城市广场的随机抽样。
比较性采集计划为每个广场四个半小时:工作日 8:00–8:30、12:30–13:00、18:00–18:30,以及星期六 12:30–13:00。比较组避开雨天、集市和游行等改变常态使用的情况;季节组则在 Assisi、Biberach、Celanova、Varberg 四处额外录制,允许不同天气。
论文描述的是夏季比较组与春夏季节组;公开 v1.1 统计文件的日期为 2024 年 7 月 3–20 日,以及 2025 年 3 月 25 日至 7 月 2 日,与论文写作时的日期说明有所不同。做季节或天气分析时,应固定下载版本,并以该文件实际列出的日期为准。
公开 v1.1 统计表中,比较组有 147 条录制记录、覆盖 39 个广场,季节组有 244 条、覆盖四处,合计 391 条。比较组并非每处都有四条,因此跨广场比较时不能假设观测时段完全平衡。论文整体报告约 193 小时视频;具体分析还应按所用文件的实际时长标准化。
所有视频统一为 1280 × 720,帧率降到 15 帧/秒,再通过多边形排除邻近道路、停车场等非研究区域。表 1 另记录广场面积、城市人口、温度、风速和湿度。这些是背景变量,本篇没有给出座椅、天气对广场活力的因果估计。
一条红色轨迹,经过了哪些推断?
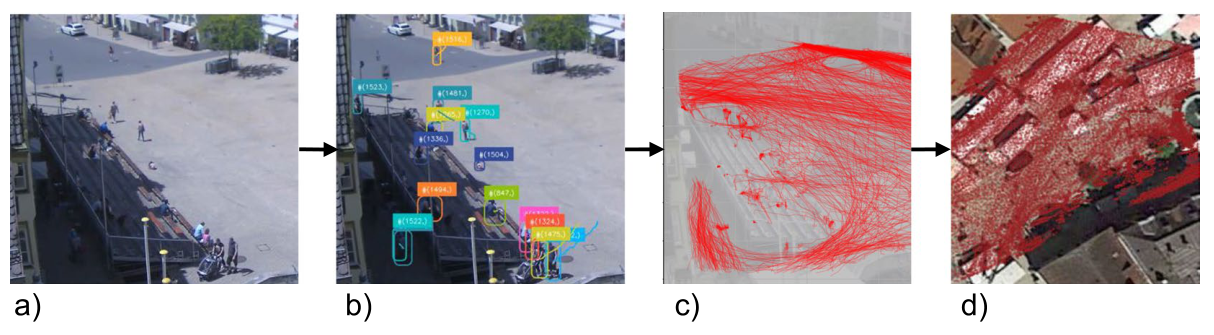
图 1|从视频画面到地图上的运动路径,中间有哪些步骤?
(a)原始视频场景。(b)逐帧行人检测框。(c)将同一人的检测连接成像素坐标轨迹。(d)经过地理配准后,把轨迹放到地理坐标中。红线是处理结果,不是人工逐点标注的真实路径。来源:原论文 Fig. 1。
检测使用自定义训练的 YOLOv10l,训练数据为 CrowdHuman,训练 300 轮。表 2 比较九种模型配置。与原始预训练 YOLOv10l 相比,自定义模型在该验证集上的精确率由 0.679 升至 0.871、召回率由 0.419 升至 0.684,分别增加 19.2 和 26.5 个百分点。与 CrowdHuman 预训练的 YOLOv8m 比,精确率略低(0.871 对 0.876),但召回率更高(0.684 对 0.661)。
因此,选型不是所有指标都胜出,也不能把文章正文所写的相对改善百分数直接当作百分点。表 2 的 mAP(50) 为 0.787、mAP(95) 为 0.528,均高于对应 YOLOv8m 的 0.725 与 0.509;这些是检测框任务的评价,尚未检验长期身份保持。
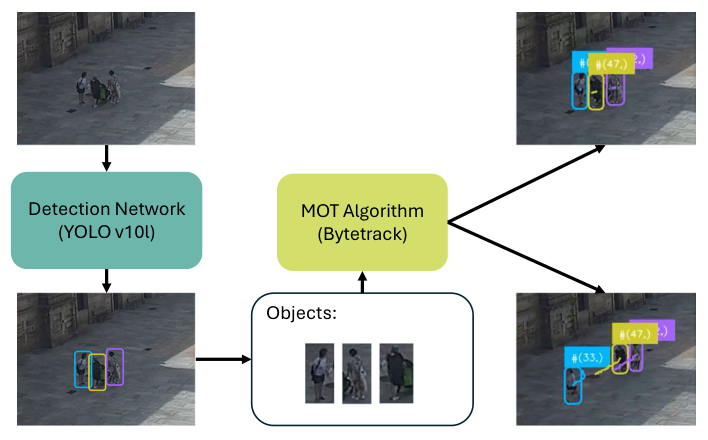
图 2|每帧找到人以后,怎样判断还是同一个人?
图中检测网络先产生人的候选框,ByteTrack 再根据连续帧位置和外观关联,为对象赋予并延续 ID;右侧示意同一对象如何在画面变化中保留编号。原图没有子图字母。来源:原论文 Fig. 2。
跟踪最难处理遮挡、误检与身份混淆。一个人被树挡住后可能拿到新 ID,称为轨迹碎片化;一个 ID 也可能先后粘到不同人身上,形成 ID 合并。表 3 的参数包括激活阈值 0.30、丢失缓存 125 帧、匹配阈值 0.95、至少连续检测 3 帧。125 帧在 15 帧/秒下约 8.3 秒,这是缓存设置,不保证遮挡 8 秒都一定能找回同一个人。
像素距离为什么不能直接叫步行距离?
画面近处走一米跨过很多像素,远处走一米可能只移动几个像素。若直接按像素变化算速度,同样的步行会因离摄像头远近而不同。
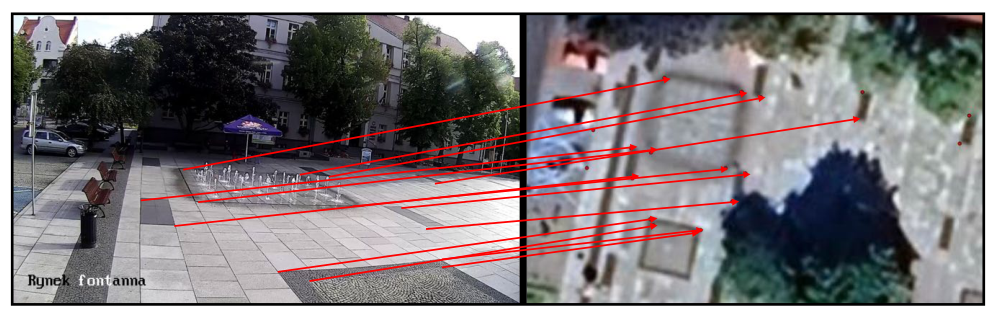
图 3|如何把倾斜摄像画面映射到地图?
左侧是摄像画面,右侧是同一地点的卫星底图,红色箭头连接可识别的同一特征。每个广场单独选点并求变换。来源:原论文 Fig. 3。
由于网络摄像头的镜头、安装高度和旋转参数未知,论文使用单应性变换(homography):假设广场地面近似同一平面,借助两种视角下对应的固定特征估计变换矩阵。QGIS 用于选点,OpenCV 用于计算与应用变换。
行人的位置使用检测框底边中心,近似脚踩地面的位置。变换先进入 EPSG:3857,再提供经纬度坐标。坡度、台阶、远处细节与不准确的对应点都会影响结果,因此坐标存在不意味着每个点都有相同的米级精度。
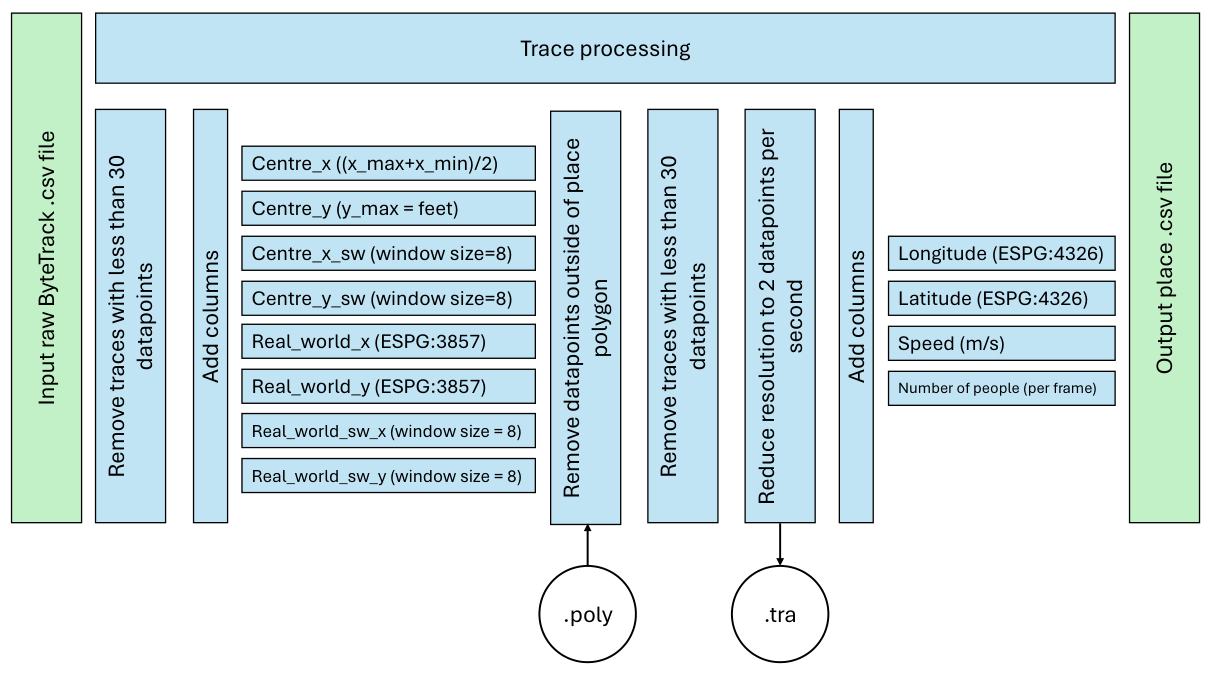
图 4|公开轨迹的哪些特征来自处理规则?
流程先删除少于 30 个原始点、约 2 秒的轨迹,计算脚点及窗口为 8 的平滑坐标,删除广场边界外点,再次清理短轨迹,降到每秒 2 点,最后补充坐标、速度和逐帧人数。下方圆形表示边界和轨迹等资源。原图无子图字母。来源:原论文 Fig. 4。
删除短段能减少误检,也会删除真实短暂经过边缘的人;平滑能减轻抖动,也会改变急转弯与局部速度。研究停留或避让时,需要考虑这些规则是否抹去了关心的行为。
表 4 的原始字段包括检测框、置信度、tracker_id 和原始帧号。表 5 的处理字段增加像素脚点、平滑坐标、地理坐标、速度与逐帧 ID 数。原始帧率是 15,但最终位置点是每秒 2 个,不能把相邻输出行一概当作 1/15 秒。逐帧 ID 数也首先是算法当前跟踪的数量,不是经过人工核实的真实人数。
93.8% 的精确率,为什么仍可能跟不完整?
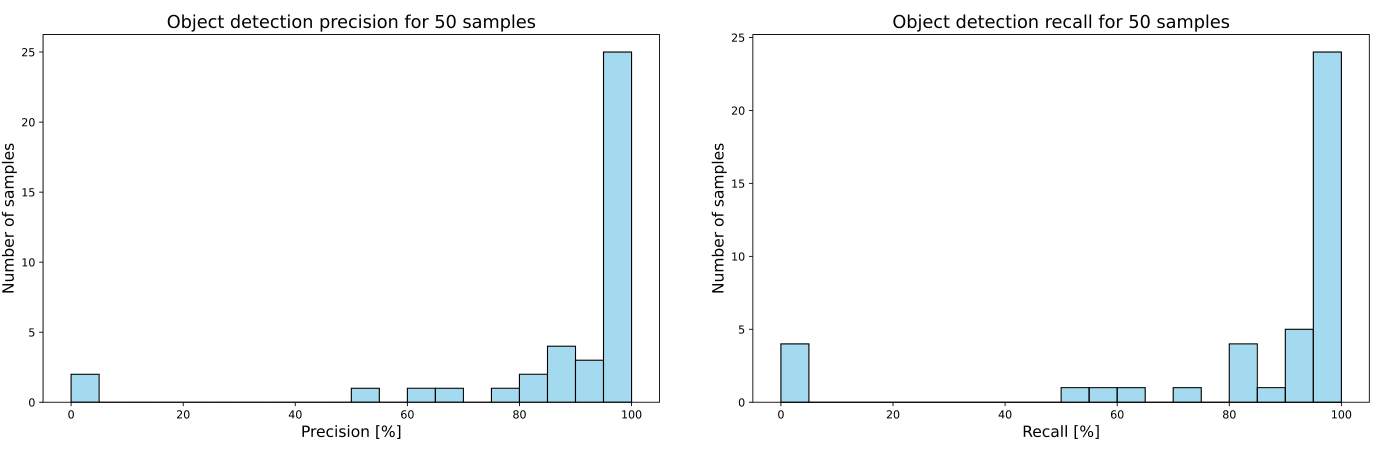
图 5|逐帧检测表现是否在所有画面都一样?
左图横轴为精确率、右图为召回率,纵轴都是样本帧数,合计抽取 50 帧且每个广场至少一帧。多数帧表现较好,但两图都有接近零的个别帧。来源:原论文 Fig. 5。
总体精确率 93.8% 表示预测为人的对象中有多少真的为人,召回率 92.8% 表示真实行人中找到了多少。雕像可能被认作人:若空广场只有这一项误检,该帧精确率就是零;只有一人的画面漏掉此人,召回率也是零。总体指标不能代替每处每种场景的可靠性。
ByteTrack 的 MOTA 80.3%、HOTA 63.1% 来自既有 MOT17 基准引用,不能当成本文 39 个广场的跟踪评分。本文没有制作完整逐帧人工真值,而是另外抽取 200 条轨迹检查。
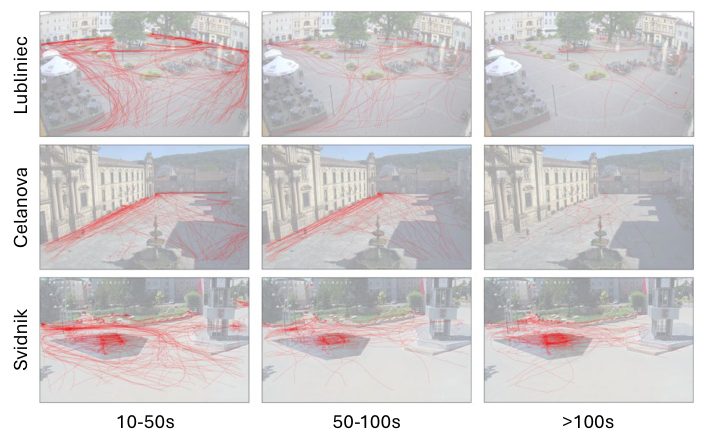
图 6|长短轨迹在空间上呈现什么差别?
上、中、下三排依次为 Lubliniec、Celanova、Svidnik;左、中、右三列依次为 10–50 秒、50–100 秒、超过 100 秒。红线是对应时长组的机器轨迹。九面板作为一张原组合图共同展示,不足以单凭线条长度判定真实完整性。来源:原论文 Fig. 6。
表 6 才给出更直接的检查。研究将 2–10 秒、10–50 秒、50–100 秒、超过 100 秒四层各取 50 条,因此长轨迹在审核样本中被明显过采样。不能把下面比例直接当作全库按轨迹数量加权的比例。
| 检查项目 | 论文报告值 | 解释 |
|---|---|---|
| 人工检查轨迹 | 200 条 | 四时长层各 50 条 |
| 误检 ID | 9% | 树木、雕像等,并非真实行人轨迹 |
| 有效轨迹 | 合计列 182 条 | 按表中汇总列报告 |
| 静止轨迹 | 51 条 | 没有一条被评为完整 |
| 移动轨迹 | 131 条 | 完整率 56.5%,对应约 74 条 |
| 全部有效样本完整率 | 40.7% | 与移动组完整率不是同一分母 |
| 至少发生一次 ID 合并 | 21 条 | 表中 16.0% 实际对应 21/131,不是 21/200 |
| 平均完整度 ID recall | 77.4% | 估计单个 ID 覆盖真实路径的比例,不等于完整轨迹比例 |
这里需要保持分母一致:报告的移动轨迹完整率对应约 74/131,ID 合并比例对应 21/131,不能将后者解释为全部 200 条的发生率。表内部分分层有效数量与汇总不完全一致,因此不再据此推算更细的总体比例。
静止者容易断轨,是这份数据最重要的适用边界。一个坐着的人反复拿到新 ID,既会夸大访客数,又会缩短单个 ID 的停留时长。逐帧检测看起来很好,也不能自动消除这种偏差。50–100 秒组的移动完整率最高为 71.4%,超过 100 秒又降到 51.7%,长轨迹也并非越长越可靠。
地理坐标精确到什么程度?
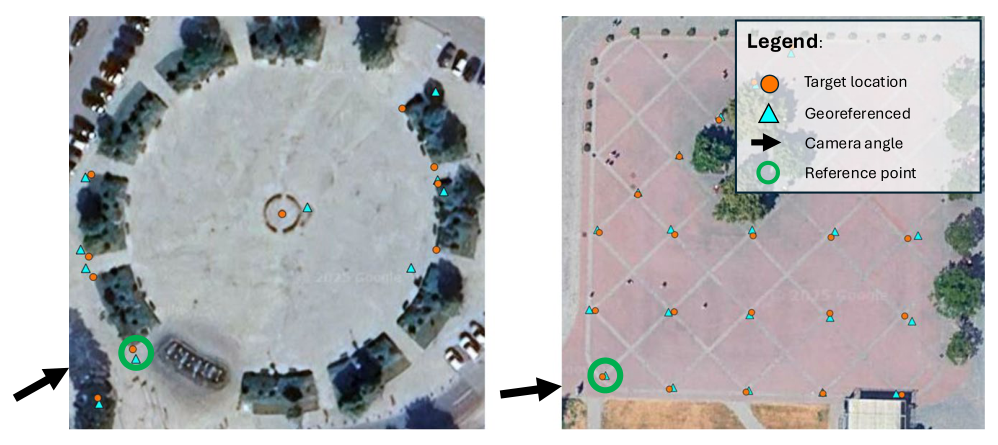
图 7|参考特征好坏怎样影响位置变换?
左为 Ozórkow,右为 Zlín。橙点是目标位置、蓝色三角是变换位置、绿色圆为参考点,黑箭头示意摄像方向。Zlín 有规则铺装网格,特征对应更清晰;Ozórkow 的特征不规则、远处偏离更明显。来源:原论文 Fig. 7。
验证比较特征点相对同一参考点的距离,以减轻底图更新的平移或方向变化影响。表 7 报告 Zlín 总误差平均 0.3 米、范围 0–2.2 米,Ozórkow 平均 2.58 米、范围 1.5–10.9 米。只检验两个广场,不能据此保证全部轨迹每一点都达到 0.3 米。
可复现的数据,为什么还要核对版本与字段?
公开材料包含原始和处理后的 CSV、GeoJSON、每个广场的变换矩阵、研究边界多边形、场景图片与统计表,允许研究者按自己的问题重新处理。它并不是完整人工真值标注的所有人行径。
论文与公开配套文件中的轨迹总数和日期存在版本或统计口径差异,因此正文用约 34.8 万表示论文所报告规模。复现时,应记录文件版本、有效录制、筛选规则与统计单位;轨迹 ID 的数量尤其不能直接当作唯一自然人数。
这篇论文最大的价值,是让跨广场视频处理可以被检查和重用,同时暴露算法在哪些行为上不够可靠。它尚未证明座椅使人停留更久,或某个广场比另一个更有活力;这些分析需要独立设计,并特别处理静止者断轨、不同录制条件和地点选择。
一句话总结
统一的视频流程让跨广场的行人轨迹可共享,但看见人、跟住人和定位准必须分别验证;研究停留、人数和交互时,不能把机器 ID 当作稳定的真实个体。
核心来源
- Scientific Data 正式论文:图 1–7、表 1–7、方法、验证和使用说明。本文图片均来自正式版对应完整原图。
- Zenodo 数据 v1.1:README、stats_comparative.csv、stats_season.csv 与资源;文中统计表复核数仅指这个版本。
- 处理代码归档:用于进一步检查处理、坐标与速度字段的实现依据。
作者介绍
按正式版署名机构及贡献声明介绍。
- Nils Wolff:MIT Senseable City Laboratory、代尔夫特理工大学建筑与建成环境;通讯作者,参与研究设计、采集与处理,负责准备文稿。
- Layne Perry:MIT Senseable City Laboratory、瓦赫宁根大学地理信息科学与遥感实验室,参与轨迹采集与处理。
- Titus Venverloo:MIT Senseable City Laboratory、阿姆斯特丹高级都市解决方案研究所,监督数据工作并参与修订论文和数据集。
- Geertje Slingerland:代尔夫特理工大学建筑与建成环境,参与研究及采集计划制定,监督数据工作。
- Jessica Wreyford:瓦赫宁根大学地理信息科学与遥感实验室,参与研究及采集计划制定,监督数据工作。
- Paolo Santi:MIT Senseable City Laboratory,监督文稿并共同修订论文和数据集。
- Fábio Duarte:MIT Senseable City Laboratory,通讯作者,监督文稿并共同修订论文和数据集。
延伸思考:一个更适合停留研究的质量指标是什么?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果目标是评估座椅带来的停留,检测精确率未必是最关键的指标。更贴近问题的检查,是人工选出一批真正坐下的人,比较其真实连续停留时长与被算法分成多少个 ID、累计保留了多久。这样可以直接估计长停留被截短的程度。
还可以分别用逐帧在场人数、ID 去重人数和人工抽样修正后人数评价同一广场。如果前者稳定而后者差异很大,就说明主要误差来自身份延续。跨广场比较前先做这种任务相关验证,比给整个数据集贴上一个“约 94% 准确”的标签更有帮助。