当全球出行变化只剩PDF曲线,怎样把它救成一张数据表?
论文名片|Ho Fai Chan、Ahmed Skali、Benno Torgler,A Global Dataset of Human Mobility,CREMA Working Paper No. 2020-04(2020),工作论文。EconStor存档,作者OSF数据与代码。本文核对了全文、公开CSV、Stata处理脚本及验证数据;不把工作论文称作已发表的同行评审期刊文章。
2020年4月,研究者急着知道人们是否减少去商店、车站和工作场所。Google刚公开一批移动报告,地图与曲线看得见,却最初没有可直接分析的数值表。要比较不同地区的日期变化,研究者得先解决一个很朴素的问题:怎样把曲线里的数值取出来?
这篇短文没有提出新的定位技术,也没有重新追踪每个居民。它把已有PDF图像中的移动指数提取、校准、归并成日度表格,让一份只能看的报告成为可复用的研究资料。贡献发生在数据整理这一环,而理解它能做什么,必须把整理误差与源数据偏差分开。
先说结论
- 数据覆盖2020年2月16日至3月29日,共43天;131个国家和地区的国家层级表有5,633行,36个国家的次国家层级表有830个地区、35,276行。
- 摘要写818个地区,与方法、数据记录部分不一致;作者公开CSV实际可核对出830个地区,本文采用这一口径。
- 五个Google Trends主题的复核显示,图像提取值与原始值平均相关约0.987,平均绝对百分比偏差约2.5%。这证明的是转录流程较准确,不是移动指数无偏地代表所有居民。
- 指数是相对基线的变化,不提供绝对访问人数;住宅类别测量停留时长,其他类别测量访问变化,两者不能直接加总或简单平均成总出行量。
一张“−10”的曲线,究竟少了什么?
Google的基线是2020年1月3日至2月6日期间,对应星期几的中位水平。某个周一的值为−10,表示相对于基线中的周一,该类活动指标下降约10%,不是全体居民去公园的概率下降10个百分点。原论文示例用概率和百分点解释得较宽,实际复用应以源指标定义为准。
星期几匹配是为了避免把正常的周末与工作日差异都读成行为变化。但天气、节假日、季节、学校安排仍能改变曲线。更不能因为某地指数下降,就直接断言某项政策造成同样大小的效果。
源记录来自主动开启位置历史的用户,之后进行汇总与隐私处理。它不是全体居民的随机抽样,也不公布每个地点实际多少人。住宅指标又与其他五类不同:它反映停留时间变化,而不是用住宅访问人数抵消工作地访问人数。Google指标解释。
把像素变成日期和指数,中间有哪些步骤?
作者使用WebPlotDigitizer识别曲线。先标定横轴日期与纵轴数值,指定曲线颜色,再把像素坐标映射为数值点。由于共有5,766幅分类曲线,逐图人工操作既慢又容易错位,作者用AutoHotKey控制重复加载、坐标校准与导出,再用Stata整合。
提取参数采用1×1像素检测,识别蓝色曲线的RGB值为(65,133,244)。一天附近平均会得到约30个曲线点,这并不是一天测量了30组独立人群,只是同一条线被细密采样,需要归并成一个日值。
归并时,距离整数日期越近的点权重越大。原文把权重写成“绝对差的三次方”,这会与前述方向相反;公开的国家与地区Stata脚本实际采用:
权重 = (1 − |横坐标 − 四舍五入后的日期|)³
这个公式才与“日期越近、权重越大”一致。读取代码在这里帮助消除了文字歧义,但图像数字化仍受到线宽、坐标标定、曲线断点与平滑的限制,导出很多小数位不会自动提高真实测量精度。
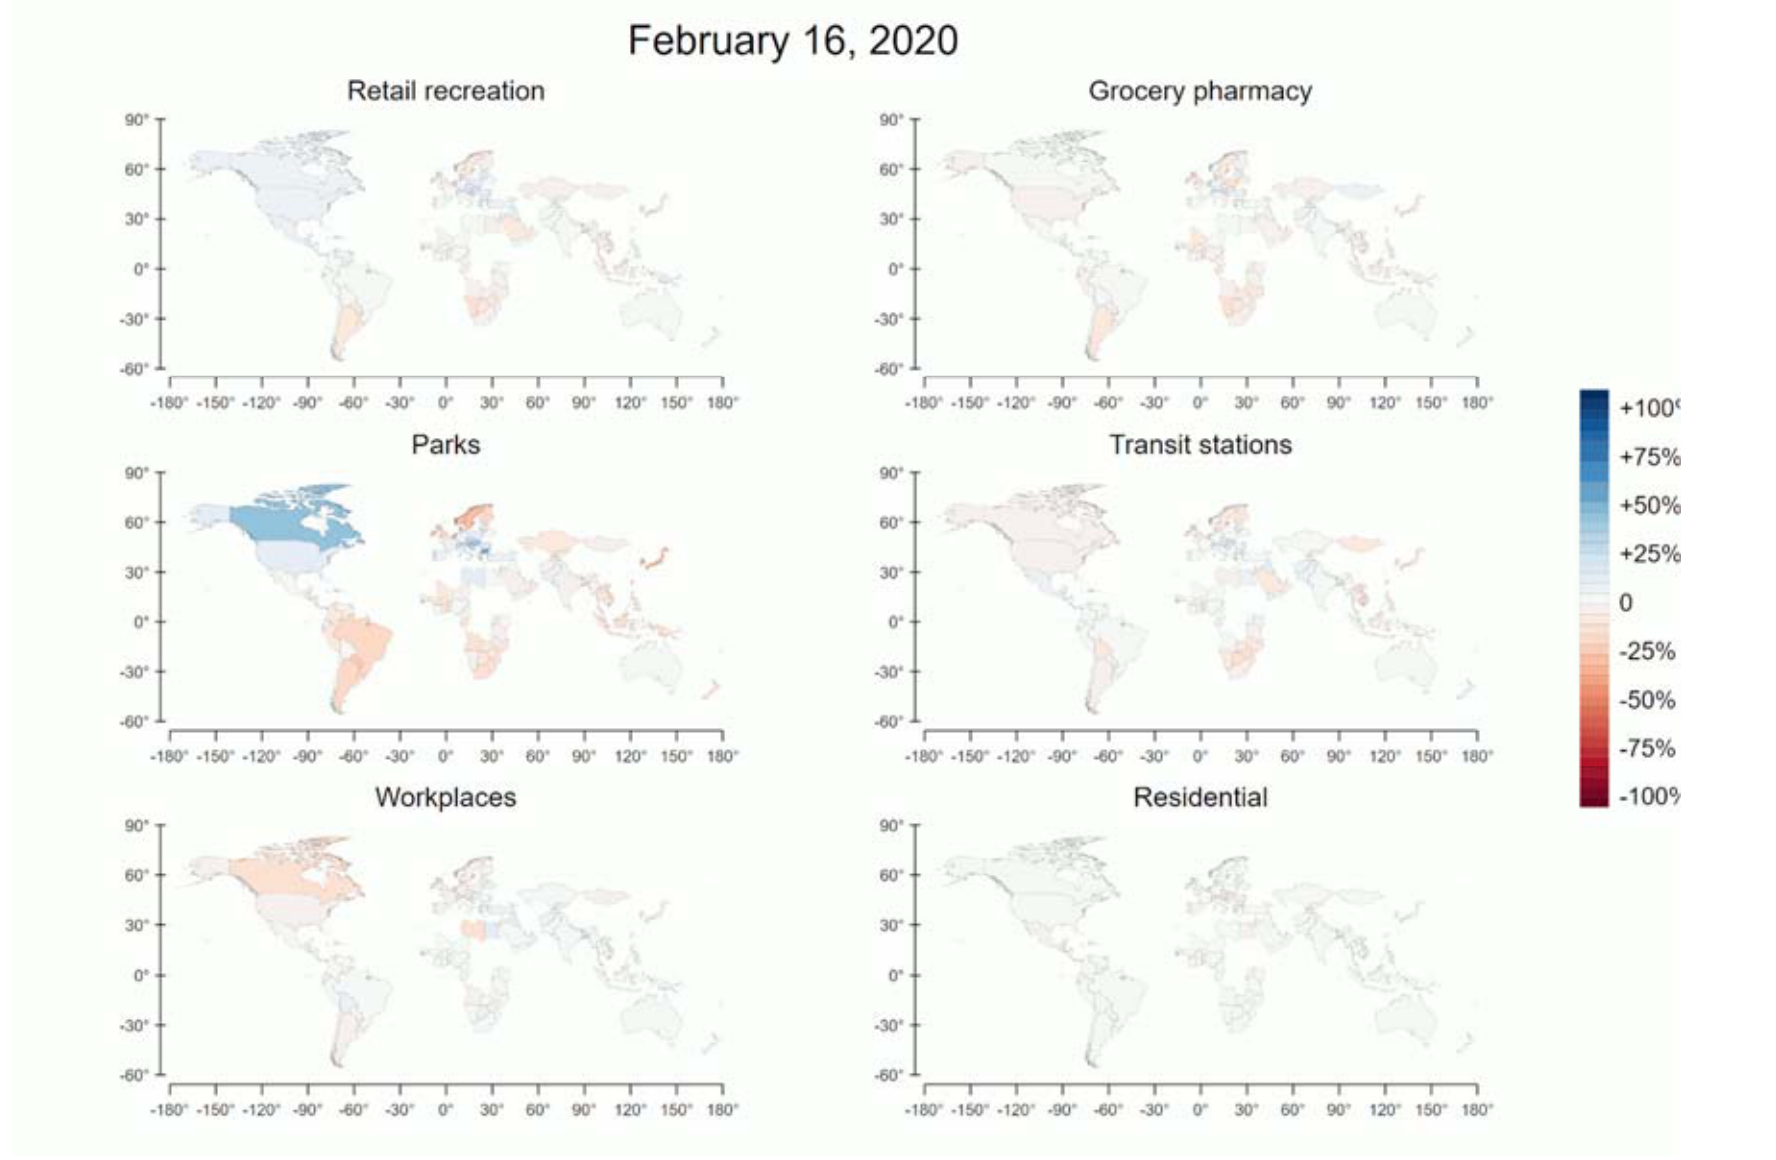
图 1|同一天,不同活动类别的变化能放在同一张地图上看吗?
原图没有a—f字母,六面板依次为:左上零售休闲、右上食品杂货与药房、左中公园、右中交通站点、左下工作场所、右下住宅。图顶日期是2020年2月16日,蓝色为相对基线增加,红色为减少,右侧共用百分比色阶;坐标为经纬度。它展示提取数据的可视化形式,不是3月底的状态,也不能单凭这一静态图判断各国谁最早响应疫情。住宅和其余类别即使共用颜色,测量含义仍不同。来源:原论文 Fig. 1,Chan、Skali与Torgler(2020)。
数据表的完整,是否等于每一天都可靠?
国家表是131×43=5,633个国家日记录。地区表有830个地区,其中782个覆盖43天,48个不完整,完整地区约占94.2%;这与论文数据记录部分一致,也能从作者发布CSV复核。地区表35,276行少于830×43,不能把它当作完全平衡的面板。
表中有国家代码、地区名、日期和六个类别指数,并提供not_enough_data标记。但核对本次下载的原始地区CSV,已有行中的这个标记都为0,而有些地区仍缺日期。因此,不能只筛标记就宣称时间序列完整,还需实际检查地区—日期组合、各类别缺值和原始报告。
这里至少有两种缺失:原报告因数据或隐私阈值不满足而未发布,以及提取后某个日期没有形成有效行。本文没有逐一确定所有缺失的来源。缺失不能填成0,因为0表示与基线接近,而不是不知道发生了什么。Google对缺口的说明。
0.987的相关,验证的是哪一层准确性?
当时没有直接公开的同一批移动原始数值,作者用图形风格相近、又能下载真实数值的Google Trends做测试。选择音乐、政治、体育、技术和天气五个主题,把图导出PDF,运行相同提取流程,再与真实序列比较。
论文报告平均Pearson相关约0.987、最低约0.983,平均绝对百分比偏差约2.5%,标准差约3.09。公开的Validation.dta含46个日期、五组主题;按作者脚本复核,合并误差平均约2.53%、标准差约3.09,与报告一致。作者验证脚本还提醒极端值可能被过度平滑。
这支持“图线转换数值”的流程可用,却没有验证Google样本对老人、低收入群体或无位置历史用户的代表性,也没有证明所有国家和所有曲线的误差相同。Google Trends为正值指数,测试中的百分比误差也不能直接搬去解释接近零、可以正负变化的移动指数。
因此,需要把三个问题拆开问:图里读对了没有,Google指标本身测到了谁,以及研究设计是否能识别政策效果。第一层做好,不会自动回答后两层。
今天复用这份数据,还应保留它最初的时间语境
本文解决的是疫情初期“只有PDF、缺数值表”的紧迫问题。如今Google已提供历史CSV,并在2022年10月15日停止更新移动报告;历史数据继续公开。Google官方说明与下载入口。因此不能把2020年的背景写成今天仍只有PDF可用。
若研究目标只是复用这一历史截面,作者OSF表格、提取脚本与验证资料仍有价值;若需要更长序列,应记录具体下载版本并与后续官方CSV核对,避免把不同版本、日期覆盖和提取方式静默拼接。OSF还提供标注2020年4月5日的后续文件,它们不应与本文截至3月29日的初始版本混为一谈。
这份数据尤其适合描述不同活动类别在疫情早期的相对变化,或作为其他研究中的输入。它没有OD起讫点、真实道路路径、个人接触网络或感染结果,因此不能从中直接计算居民走了多少公里、谁接触了谁,或某项封控减少了多少感染。
一句话总结
把PDF曲线转成规范表格,可以迅速释放已有数据的研究价值,但数字化精度、样本代表性和因果识别仍是三层不同的证据。
核心来源
- Chan, H. F., Skali, A. & Torgler, B.(2020). A Global Dataset of Human Mobility. CREMA Working Paper No. 2020-04。工作论文存档。图1及论文方法、数据范围、验证结论据此。
- 作者OSF项目:原始国家与地区CSV、Stata脚本、五主题验证数据和代码;本文对地区数与权重的澄清据这些文件。
- Google官方指标定义及历史数据入口,用于区别类别单位、缺失与目前更新状态。
作者介绍
以下机构与研究分工据论文署名,不推断作者当前职称。
- Ho Fai Chan:昆士兰科技大学经济与金融学院、行为经济学社会与技术研究中心(BEST)署名作者,本文通讯作者;参与方法、软件、验证、数据整理和写作。
- Ahmed Skali:迪肯大学经济系署名作者;参与构思、方法、验证、资源与写作。
- Benno Torgler:昆士兰科技大学经济与金融学院、BEST及瑞士CREMA署名作者;参与构思、方法、研究执行与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
数据整理也可以产生很有价值的研究问题:一个图像提取误差,会不会改变政策响应的先后排序?可将数字化版本与官方CSV对齐,比较哪些日期和地区偏差最大,再检验这些偏差是否足以改变结论。这样既能评价整理质量,也能发现早期报告与后续发布版本的变化。
对全球比较,还可以把“同样下降20%”放回各地基线。两个城市原本访问规模不同,同样相对变化意味着的实际人数就可能完全不同。若研究结论依赖绝对流量,下一步应寻找相应尺度的人口或访问量信息,而不是把百分比直接当成人数权重。