大模型怎样读懂一串签到,而不只是记住地点编号?
论文名片|Letian Gong、Yan Lin 等,Mobility-LLM: Learning Visiting Intentions and Travel Preferences from Human Mobility Data with Large Language Models,NeurIPS 2024。官方论文 PDF,DOI。
同样是上午去医院,可能是上班,也可能是临时就诊;随后去了餐馆,也不一定意味着接下来就回家。地点编号能记录访问顺序,却不直接说明人为什么去,以及哪些近期行为更可能影响下一步。
Mobility-LLM 尝试把地点、时间和一组带语义的提示词,转换成预训练语言模型能够处理的向量序列。它不是让聊天机器人读一段完整出行日记再自由回答,而是训练一个适配签到数据的预测框架,分别完成下一地点、到达时间和轨迹所属用户的判断。
先说结论
- 在 Gowalla、WeePlace、Brightkite、FourSquare 四份签到数据上,框架的地点预测和轨迹用户关联指标整体较好;时间预测提升较小,部分指标由基线领先。
- 模型一边学习近期访问的时间联系,一边从活动、职业、生活方式三组提示词中选择线索。消融实验支持这些模块有用,但提示词命中不等于测得真实职业或心理意图。
- 少样本实验使用完整训练集的 1%、5%、20% 重新训练,仍需学习参数;它与只给大模型几条自然语言示例的情境学习不同。
- 数据先随机打乱样本再按 6∶2∶2 划分,结果不能直接当作严格未来留出、陌生城市或新用户零样本预测的成绩。
签到序列里的三个问题,分别预测什么?
每次签到包含 POI 标识、经纬度、类别与时间。POI(point of interest,兴趣点)可以是餐馆、医院或学校。序列按访问时间排列,但签到是选择性记录,不等于全天每次移动都被捕捉。
研究处理时最多保留 120 天历史,过滤记录少于 10 条的用户,以及访问少于 10 次的地点。附录 Table 7 的实际实验规模如下;这些是处理后的数据,不能与原平台数百万条签到的总量混用。
| 数据集 | 样本数 | 用户数 | POI 数 |
|---|---|---|---|
| Gowalla | 413,563 | 5,853 | 52,032 |
| WeePlace | 104,762 | 1,028 | 9,295 |
| Brightkite | 44,716 | 431 | 3,554 |
| FourSquare | 60,734 | 703 | 11,117 |
地点预测(LP)判断下一次签到的地点;时间预测(TP)估计下一次到达时间;轨迹用户关联(TUL)把一段签到序列归给已有候选用户。TUL 输入不含用户身份信息,而另外两项任务可利用用户嵌入。它不是从任何陌生人的匿名轨迹推断现实姓名。
实验重复五次,主要表格报告均值。随机样本划分意味着训练与测试不构成严格的时间前后分界,也没有以整座城市或整名用户为隔离单元。因此,性能首先描述同一数据环境下的留出样本判断,外推能力还需要另设实验。
第一层翻译:地点编号怎样获得语义?
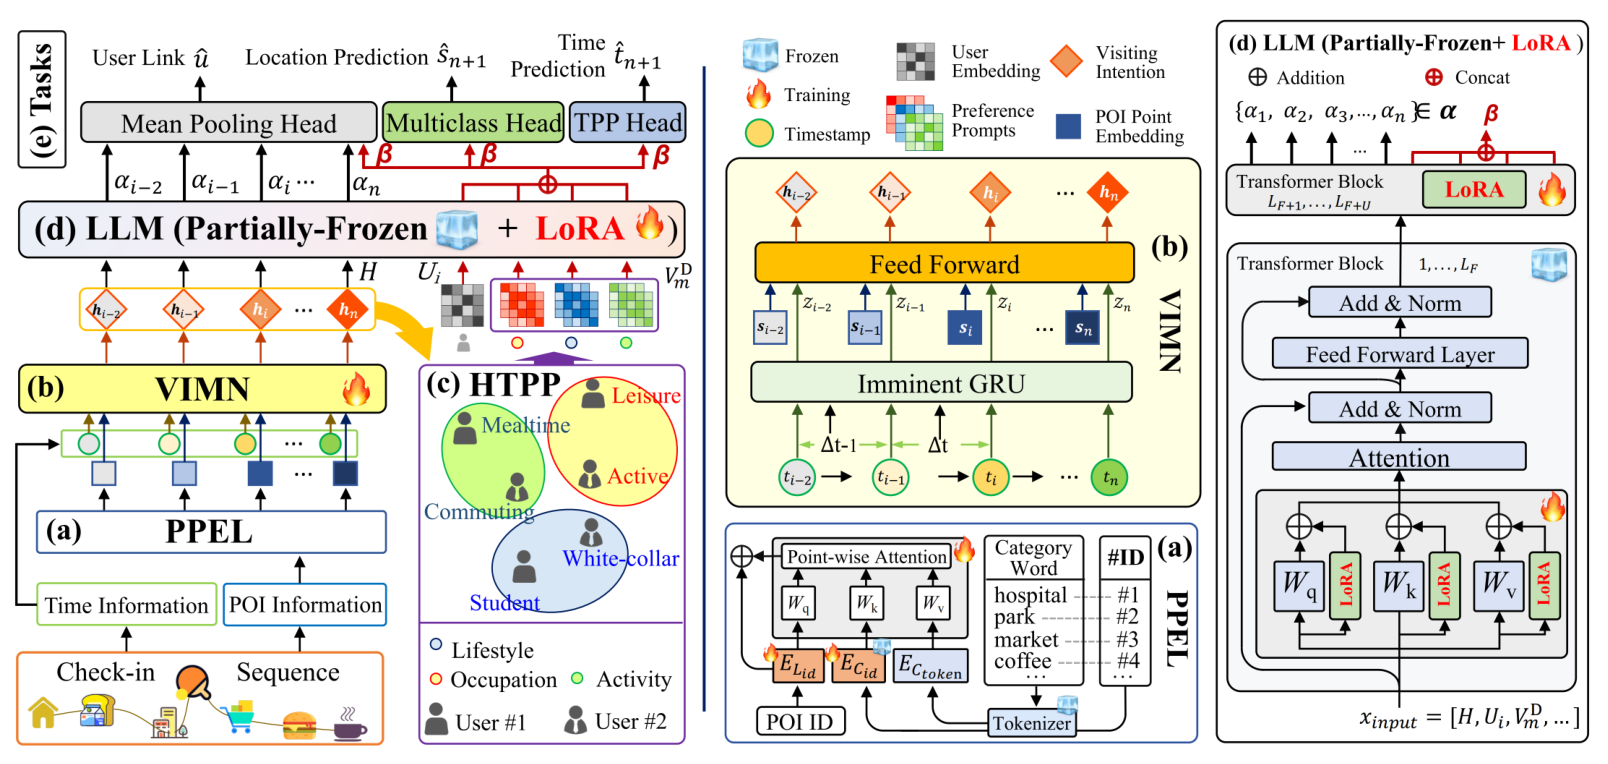
图 1|签到怎样进入语言模型并完成三个任务?(a)PPEL 将 POI 编号与类别词关联,并加入地理编码;(b)VIMN 融合时间与近期访问,形成访问意图表示;(c)HTPP 选择偏好提示;(d)部分冻结的语言模型结合 LoRA 适配输入;(e)不同输出头预测用户、地点与时间。中列和右列展开相应模块,雪花与火焰区分冻结和训练部分。来源:原论文 Fig. 1。
地点编号本身没有自然语言含义。POI 逐点嵌入层(PPEL)让可学习的地点向量去匹配类别词,并取语言模型词元的向量表示,再加入 Geohash 地理编码。附录 H 说明,经纬度先编码为空间字符串,再映射为向量;附录 I 列出类别词池。
这让地点不只依赖一个独立编号,还可借助医院、咖啡馆、车站等类别词的语义。与此同时,类别匹配本身也经过学习:它不是问卷证明这个人去了医院,更不自动解释此行是工作还是看病。
第二层翻译:隔了半小时和隔了半天,记忆应该一样吗?
访问意图记忆网络(Visiting Intention Memory Network,VIMN)处理时间戳和相邻访问的时间差。时间戳用周期编码表达日程规律,间隔用 log(1+时间差) 编码影响门控,再与最近 r 个地点表示融合。
直观上,刚离开的地点可能比很久以前的地点更能解释当前活动。但模型学习的是对预测有用的隐表示,论文并没有直接观测人的计划或意图。把表示命名为访问意图,并不等于已经用独立心理或活动调查验证了它的含义。
偏好提示则从更长的序列角度补充线索。人类出行偏好提示池(Human Travel Preference Prompt,HTPP)包括活动、职业、生活方式三个领域,每组 16 个词。模型计算序列中访问表示与各提示键的相似度,汇总后每组取前 K 个提示的向量。
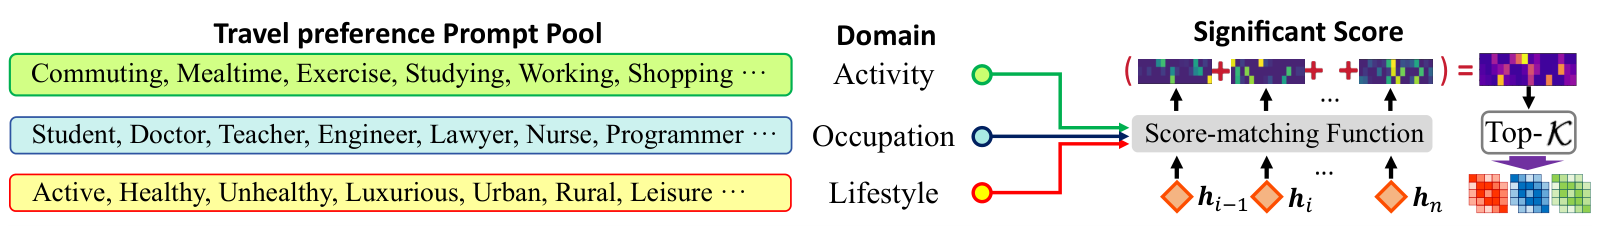
图 2|一串签到怎样选出一组提示?左侧列出活动、职业、生活方式词池,右侧根据各访问表示与词的匹配分数,选出每组前 K 个。图中没有子图字母;绿色、蓝色、黄色对应三个词池。职业词等属于模型输入词汇与潜在线索,不是经独立核实的个人身份标签。来源:原论文 Fig. 2。
最终,访问表示、用户向量及提示向量沿序列维度拼接,进入部分冻结的 TinyLlama 主干。通过保留一部分预训练层、调整后部注意力及引入 LoRA,模型适配签到任务,避免从头训练整个语言模型。输出端使用分类头或时间分布预测头,而不是依靠自由生成一段解释文字。
地点与用户预测,提升有多大?
Acc@1 表示第一候选就正确的测试比例;Acc@5、Acc@20 允许前 5、20 个候选中的任一个命中。MRR 是正确答案排名倒数的平均值,越大越好。论文分类表使用 e−2 单位,例如 11.87 对应 11.87%,不能读成 0.1187%。
下面分别取 Table 1、2 中每份数据的 Acc@1,与该列最好的基线比较,避免把跨任务平均改善率当成一个统一准确率。
| 数据集 | 地点 Acc@1:最佳基线→本文 | 变化 | 用户关联 Acc@1:最佳基线→本文 | 变化 |
|---|---|---|---|---|
| Gowalla | 11.47%→11.87% | +0.40 个百分点 | 68.75%→80.43% | +11.68 个百分点 |
| WeePlace | 19.66%→20.47% | +0.81 个百分点 | 74.31%→79.03% | +4.72 个百分点 |
| Brightkite | 51.42%→53.18% | +1.76 个百分点 | 73.85%→83.06% | +9.21 个百分点 |
| FourSquare | 16.92%→17.29% | +0.37 个百分点 | 58.18%→72.08% | +13.90 个百分点 |
地点的单一答案仍然很难,尤其在候选地点多的 Gowalla 和 FourSquare。增加候选会提高命中率,例如 Gowalla 的 Acc@20 为 36.36%,但那不是第一候选的准确率。用户关联改善更突出,说明签到模式能够帮助区分数据集内的用户,也提醒我们轨迹包含可识别的行为差异。
到达时间的误差,并没有随地点成绩一起消失
时间预测使用混合分布描述到达间隔,并以平均绝对误差(MAE)和均方根误差(RMSE)评价,单位为分钟。Table 3 的本文 MAE 在四份数据上分别为 353.89、28.28、346.44、309.78 分钟。
WeePlace 的误差远小于其他数据,不能仅凭一个总体均值宣布所有签到场景都能精确到几分钟。Brightkite 的 NSTPP MAE 为 345.74 分钟,略优于本文 346.44;FourSquare 的 IFLTPP RMSE 为 503.01 分钟,也优于本文 505.03。论文支持多数设置中的竞争力,不能概括为三项任务每个指标都最好。
少量训练数据仍有效,是哪一种少样本?
少样本实验保持原来的验证与测试划分,只取训练样本的前 1%、5%、20% 训练模型。Table 4 给出 5% 的结果,附录 Table 11、12 补充 1% 和 20%。
例如 Gowalla 在 5% 训练数据下,本文地点 Acc@1 为 9.98%,高于同设置最好的基线 PLSPL 的 8.27%;用户关联为 55.75%,高于对应基线中的最高值 32.13%。但与本文使用全部训练数据的 11.87%、80.43% 相比,性能仍下降,尤其是用户关联。
这说明预训练及适配模块在有限标注数据下有帮助。它没有证明无需目标数据训练,也没有把所有新城市的地点编号自动统一起来。论文明确承认,不同数据集的 POI 与输出类别不同,零样本迁移受到嵌入层和预测头的限制。
模块真的有用,还是只给大模型换了个名字?
Gowalla 消融实验(Table 5)中,移除偏好提示 HTPP 后,用户关联 Acc@1 从 80.43% 降至 72.02%;移除近期记忆 VIMN 后,地点 Acc@1 从 11.87% 降至 11.01%。把语言模型换成普通 Transformer 后,地点降到 10.06%,用户关联降到 70.79%。
附录 Table 8—10 把这些比较扩展到其他数据,也显示多数地点和用户关联指标下降。但时间任务并非每个模块都逐项改善,例如 WeePlace 移除 VIMN 的 MAE 为 28.22 分钟,略低于完整模型的 28.28。由此更稳妥的结论是模块对主要分类任务有贡献,不能强推为每个指标都必需。
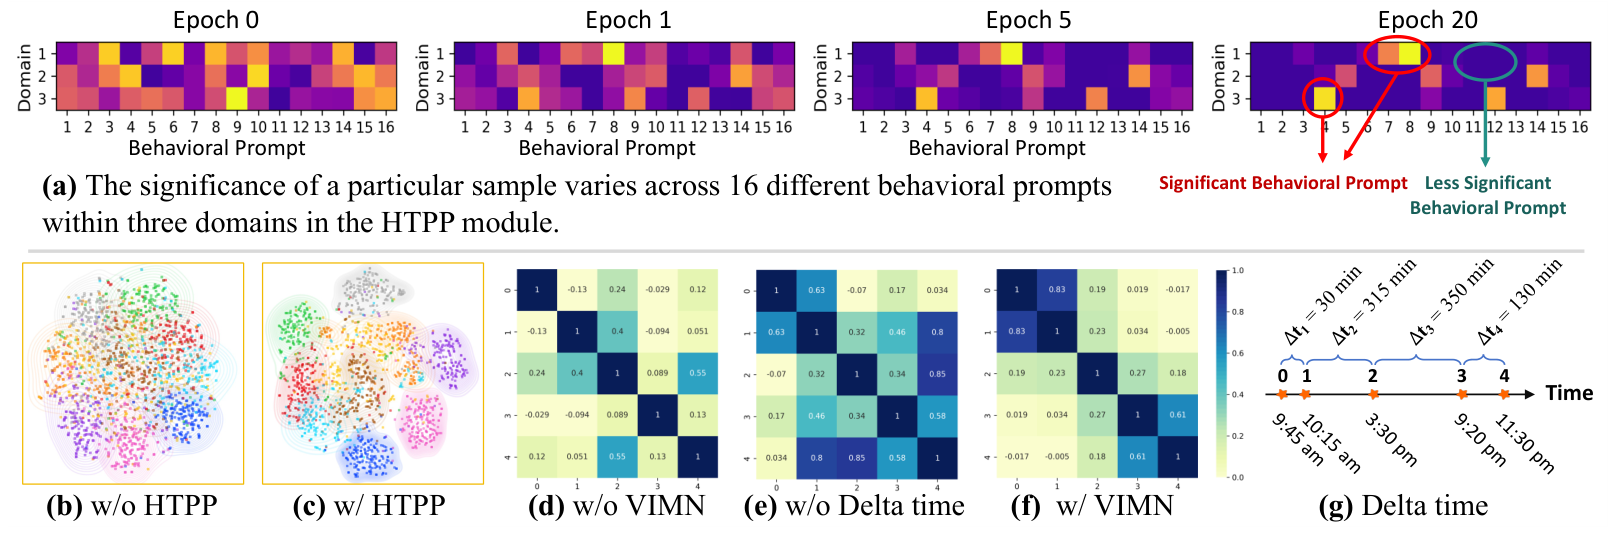
图 3|模型内部的变化能提供怎样的线索?(a)同一样本在训练第 0、1、5、20 轮的提示分数,横轴为 16 个词、纵轴为三个领域,颜色由紫到黄表示分数增大;(b、c)分别是不使用与使用 HTPP 时,10 个用户样本的 t-SNE 投影;(d、e、f)分别比较无 VIMN、无时间差、完整 VIMN 的五个输出表示相关矩阵;(g)给出五个事件及 30、315、350、130 分钟的相邻间隔。来源:原论文 Fig. 3。
提示分数集中、用户样本在投影中更分开,以及近时间事件的表示相关性变化,都与模块设计一致。不过 t-SNE 是投影案例,相关矩阵也来自模型表示;它们不能证明模型读出了真实职业,或给出了人类行为的因果解释。
提示越多、记忆越长,就一定越好?
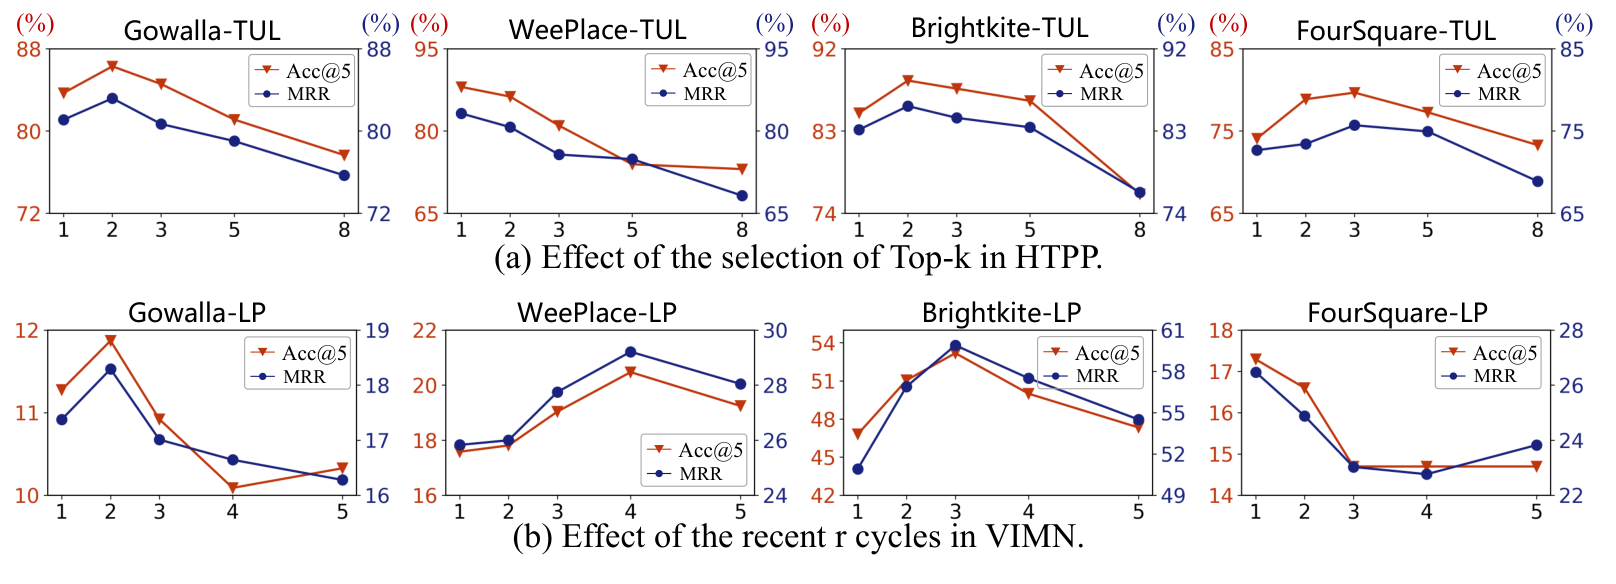
图 4|每个数据集需要同样的提示与记忆长度吗?(a)上排四图依次展示四份数据的用户关联任务,横轴为 HTPP 选择的提示数 K;(b)下排依次展示四份数据的地点任务,横轴为 VIMN 最近事件数量 r。两排均用红蓝曲线表示原图标注的 Acc@5 与 MRR,各自使用左右纵轴;不同面板刻度不同。多组曲线在中间取值达到较好表现,继续增大可能下降。来源:原论文 Fig. 4。
图 4 支持按任务与数据分布调整超参数,而不是固定多保留历史就能更准确。还需注意,下排红线图例虽然标为 Acc@5,其数值范围更接近 Table 1 的 Acc@1;因此这里仅据图讨论参数变化趋势,不把图中的红线数值另作精确指标比较。
主干也不是越大越好。Table 5 和附录的比较中,TinyLlama、LiteLlama、Pythia、GPT-2 各有强项,聊天微调版并未持续优于默认版。替换主干时,预训练方式、参数容量和适配方法都同时变化,实验不足以单独证明语言语义知识是全部增益的来源。
成本和迁移边界,也应算进效果
WeePlace 地点任务中,Table 6 的默认模型共约 1.07B 参数,可训练比例 3.72%,显存 11.3 GB,总训练时间 5.45 小时;普通 Transformer 替代版本约 12M 参数、显存 3.23 GB、训练 2.42 小时。用户关联默认版本训练约 13.24 小时,替代版本约 4.95 小时。实验使用 RTX A40 等指定硬件,数值不能直接当成任意设备上的运行承诺。
少训练一些参数有助于适配,但并未消除主干的显存和运行成本。与此同时,普通 Transformer 替代版与默认版容量差距很大,所以消融既反映了主干替换,也混入容量与预训练的差别。
在实际复用中,更需要验证的是时间前推、新用户、新城市和不同签到频率下的稳定性。本文给出一个有效的多任务适配设计,证明的范围仍然是所设基准与划分协议,尚不能泛化为大模型已经理解了每个人的真实出行目的。
一句话总结
Mobility-LLM 用地点语义、近期记忆和偏好提示提高签到预测,但预测成绩、行为解释与跨城市泛化,仍需要分别验证。
核心来源
Letian Gong, Yan Lin, Xinyue Zhang, Yiwen Lu, Xuedi Han, Yichen Liu, Shengnan Guo, Youfang Lin, Huaiyu Wan. Mobility-LLM: Learning Visiting Intentions and Travel Preferences from Human Mobility Data with Large Language Models. NeurIPS 2024,Advances in Neural Information Processing Systems 37。官方论文及附录,会议条目,作者代码仓库。图 1—4 均来自原论文完整组合图,数值依据正文与附录表格。
作者介绍
- Letian Gong:署名为北京交通大学计算机科学与技术学院、北京市交通数据分析与挖掘重点实验室,与 Yan Lin 共同第一作者。
- Yan Lin:署名为丹麦奥尔堡大学计算机科学系,与 Letian Gong 共同第一作者。
- Xinyue Zhang:署名为北京交通大学计算机科学与技术学院及上述重点实验室。
- Yiwen Lu:署名为北京交通大学计算机科学与技术学院。
- Xuedi Han:署名为北京交通大学计算机科学与技术学院。
- Yichen Liu:署名为北京交通大学计算机科学与技术学院及上述重点实验室。
- Shengnan Guo:署名为北京交通大学计算机科学与技术学院及上述重点实验室,为本文通讯作者。
- Youfang Lin:署名为北京交通大学计算机科学与技术学院及上述重点实验室。
- Huaiyu Wan:署名为北京交通大学计算机科学与技术学院及上述重点实验室。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把职业、生活方式提示词替换成没有语义的随机符号,并保持参数量和训练预算相同,成绩会下降多少?如果几乎不变,增益可能更多来自可学习的提示选择结构;如果明显下降,才更有理由讨论预训练语义本身提供了什么。这比仅展示一张提示热图更能区分结构优势与语义优势。
另一个检验是把切分方式改成严格的时间前后分界,并让最后一段时间出现一批新 POI。这样能够更接近推荐系统面对新活动地点的实际情形,也能观察哪些模块依赖熟悉的地点编号,哪些模块真正借助类别与地理信息迁移。