每天擦肩而过的人,怎样慢慢连成一张网?
论文名片|A. P. Riascos、José L. Mateos,Emergence of encounter networks due to human mobility。PLOS ONE 12(10),e0184532,2017年10月12日。DOI:10.1371/journal.pone.0184532。本文结合正文、数学方法、完整主图与两段补充模拟视频解读。
每天去同一家早餐店,你可能反复遇见同一批人,却叫不出他们的名字。换一条通勤路线,又会进入另一组熟悉的陌生人之间。城市不仅把人从一个地点送往另一个地点,也在不断生成“谁可能与谁相遇”的网络。
这篇论文把这个过程拆成两层:先看纽约和东京的签到轨迹,再让一批互不交往的随机行走者在固定地点间移动,检验仅靠空间移动与重复共现,能形成怎样的网络。它研究的是遭遇机会,不是用签到识别朋友,更没有直接模拟疾病传播。
先说结论
- 纽约和东京的签到位移、间隔分布具有相似的长尾形态,但由共同出现构造的网络仍有不同结构。相似的个人移动统计,不意味着相同的集体接触格局。
- 主分析把同一小时内、相距不超过100米的签到视作共现;要求共现一次、两次或三次才连边,会显著改变网络,尤其纽约样本。
- 简单的局部移动加远距离跳跃,可以生成随时间增长的遭遇网络;若只记住最近一段时间,旧联系会消失,整体指标可进入稳定状态。
- 真实数据与模型主要呈定性一致。它没有证明人们都按某个最优随机策略行动,也不能把纽约与东京样本差异直接解释为居民社交方式的因果差异。
签到轨迹告诉我们什么,又没告诉我们什么?
资料来自2012年4月12日至2013年2月16日的Foursquare签到:纽约1,083名用户、227,428次记录;东京2,293名用户、573,703次记录。每次记录带时间、地点坐标和地点描述,涉及餐馆、酒吧、大学、健身房等。
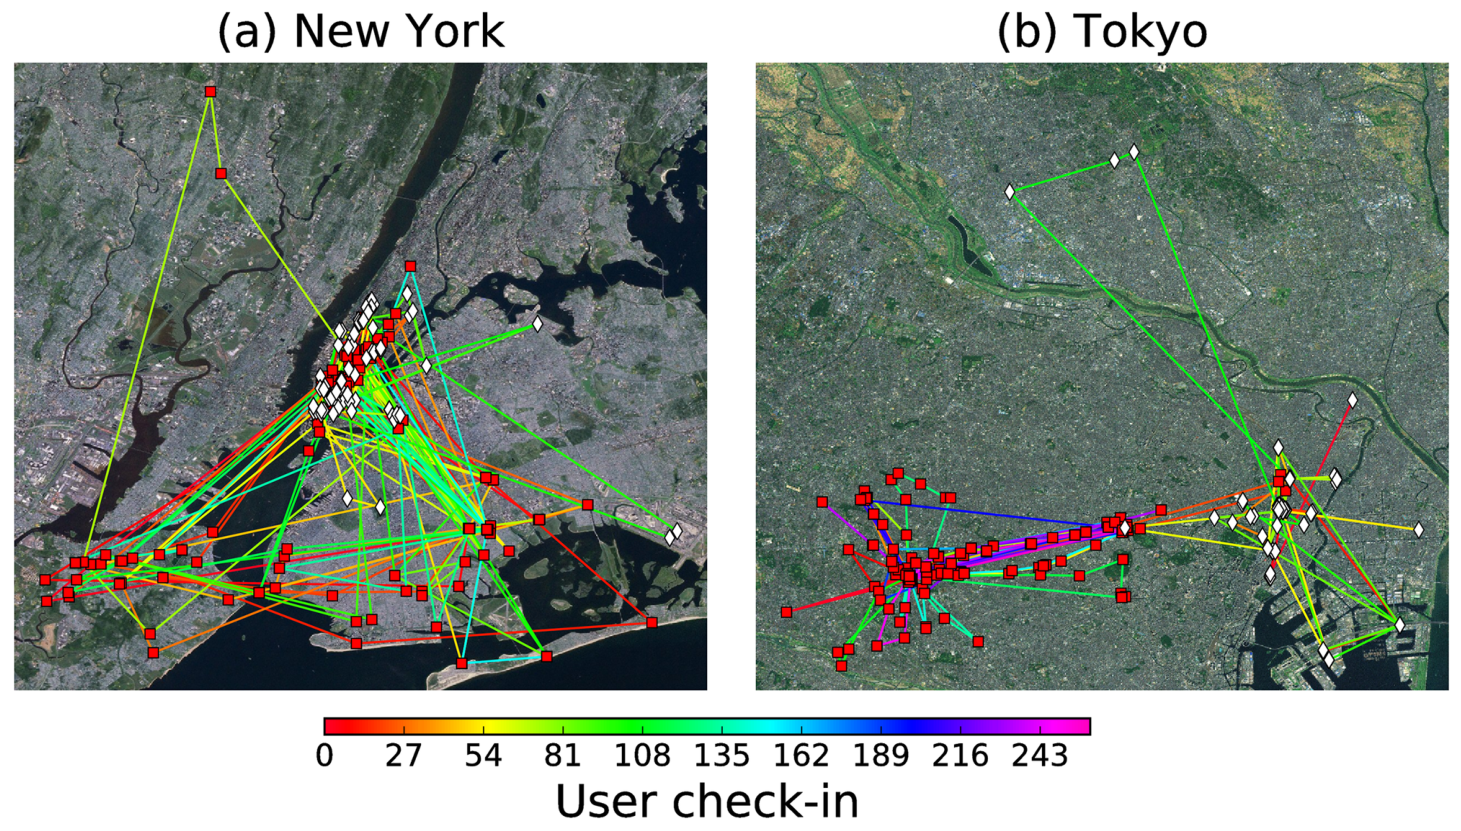
图 1|一串地点,怎样变成可分析的移动记录?
(a)纽约,(b)东京,各展示两名用户;方形与菱形区分用户,连线颜色对应签到顺序,色条为序号。线连接前后签到点,不表示真实走过的道路。来源:原论文 Fig. 1。
签到是主动留下的记录,不是连续GPS。两次签到之间可能经过许多地方,间隔还受到使用软件习惯影响。因此,后文的“位移”是两个记录点的直线分离,“等待时间”是签到间隔,都不能无条件等同于完整旅程或实际停留时长。
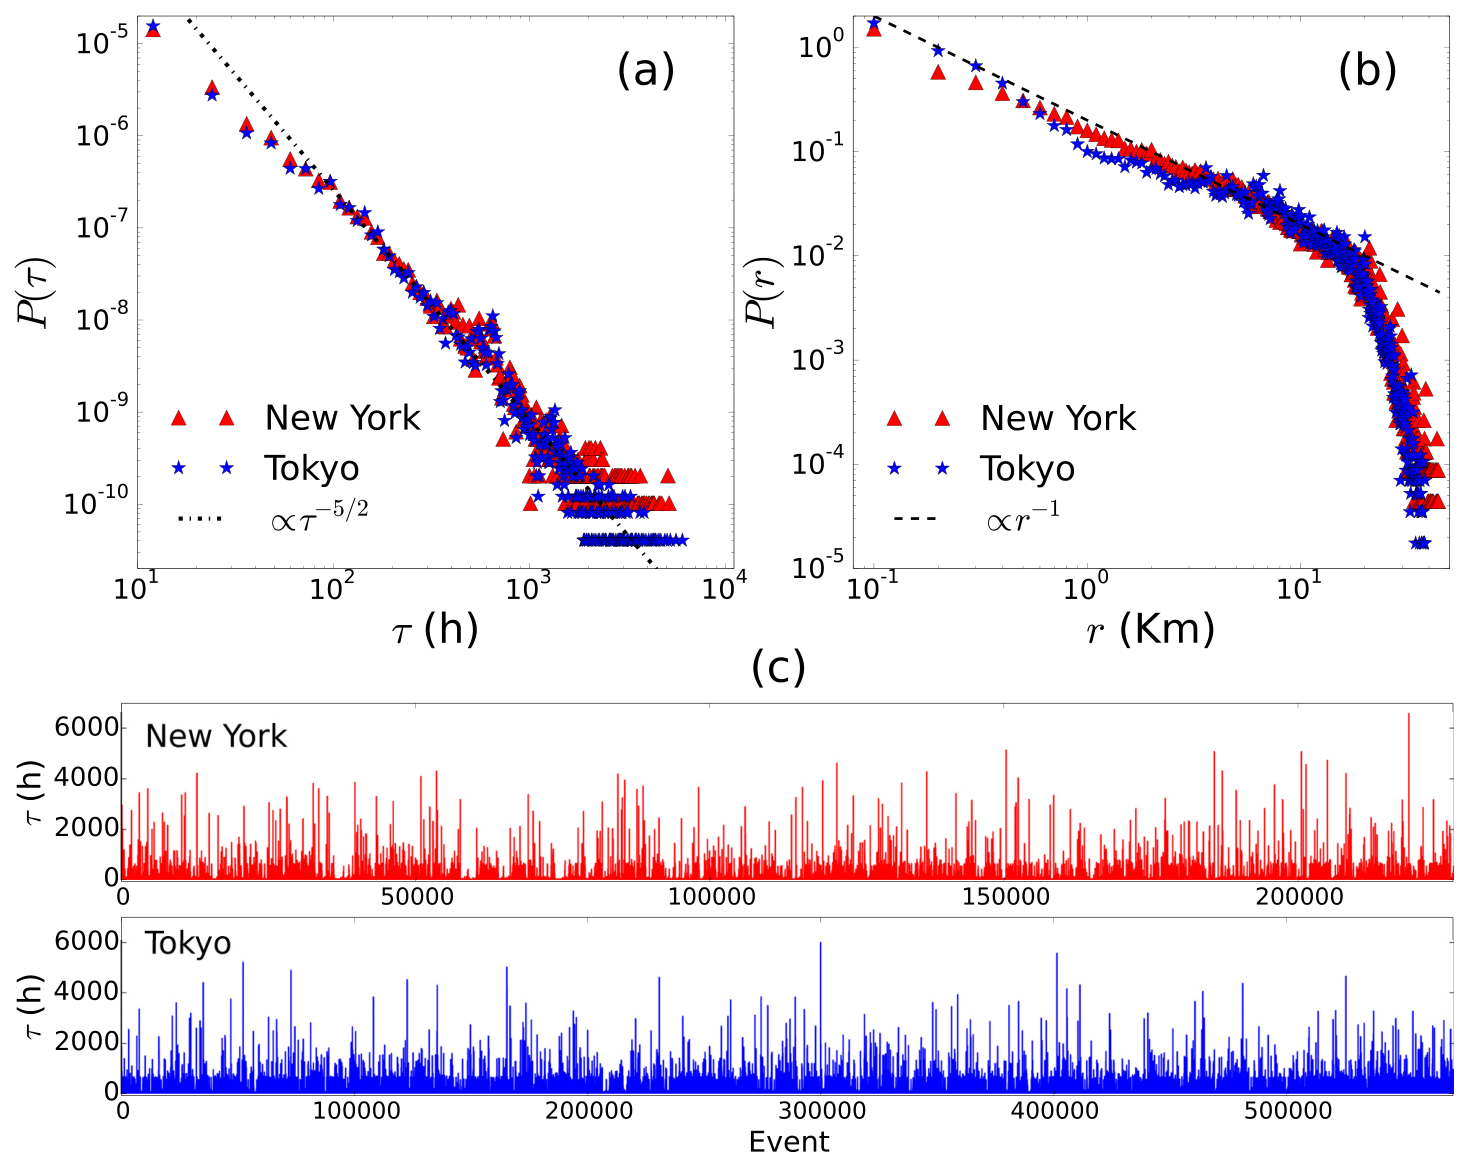
图 2|两个城市的单人移动统计有多相似?
(a)相邻签到间隔τ的分布,单位小时;(b)相邻签到位置距离r的分布,单位公里;(c)按时间排序的间隔事件序列,上纽约、下东京。红、蓝区分城市,虚线为参考幂律。短间隔与少量极长间隔并存,显示突发性;不是每一段τ都属于同一个幂律范围。来源:原论文 Fig. 2。
时间尾部拟合给纽约指数约2.37,起点约85.5小时;东京约2.45,起点约107.7小时。空间上,在1米至10公里的拟合区间,指数约1.147与1.150。相似性是这组数据的经验结果;极短距离还可能受地点重复与定位误差影响,不能理解成测准了每一步1米移动。
把“同一小时在附近”变成一条边,需要几道选择?
作者规定:两个用户在同一个小时内签到,位置间距不超过Δr,就记一次共现。累计达到c次,才在两人之间连边。这里的“同一个小时”没有证明两人同时停留了多久,更不证明发生交谈或感染所需的近距离接触。
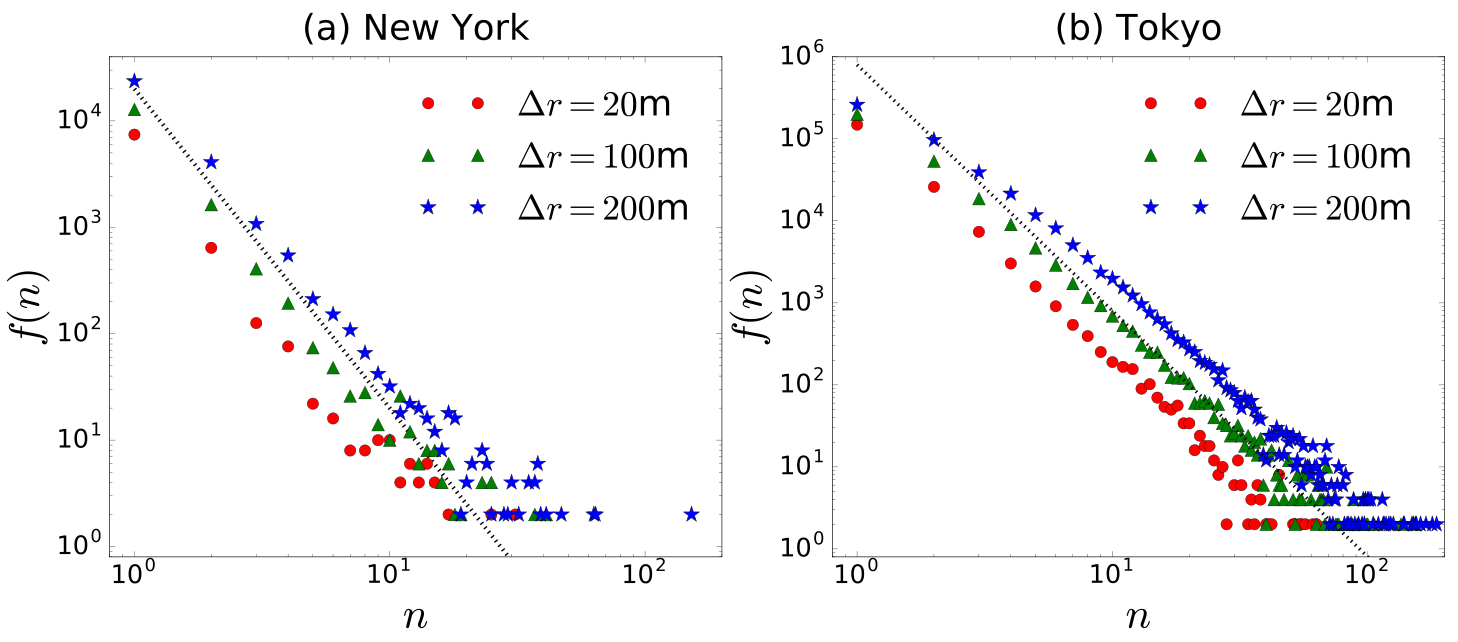
图 3|大量配对只出现一次,少数配对为何反复出现?
(a)纽约,(b)东京;横轴共现次数n,纵轴有该次数的配对频数f(n),双对数显示。不同颜色为20、100、200米距离阈值,虚线为约n⁻³参考关系。大多数配对共现少,频繁共现者较少;形态相似不表示不同阈值生成完全相同的边。来源:原论文 Fig. 3。
主分析采用100米,并比较c=1、2、3。这样可减少仅一次偶然经过带来的联系,但重复共现仍可能只是乘同一班车、去同一商场。与此同时,低频签到者即使真实经常见面,也可能达不到阈值。
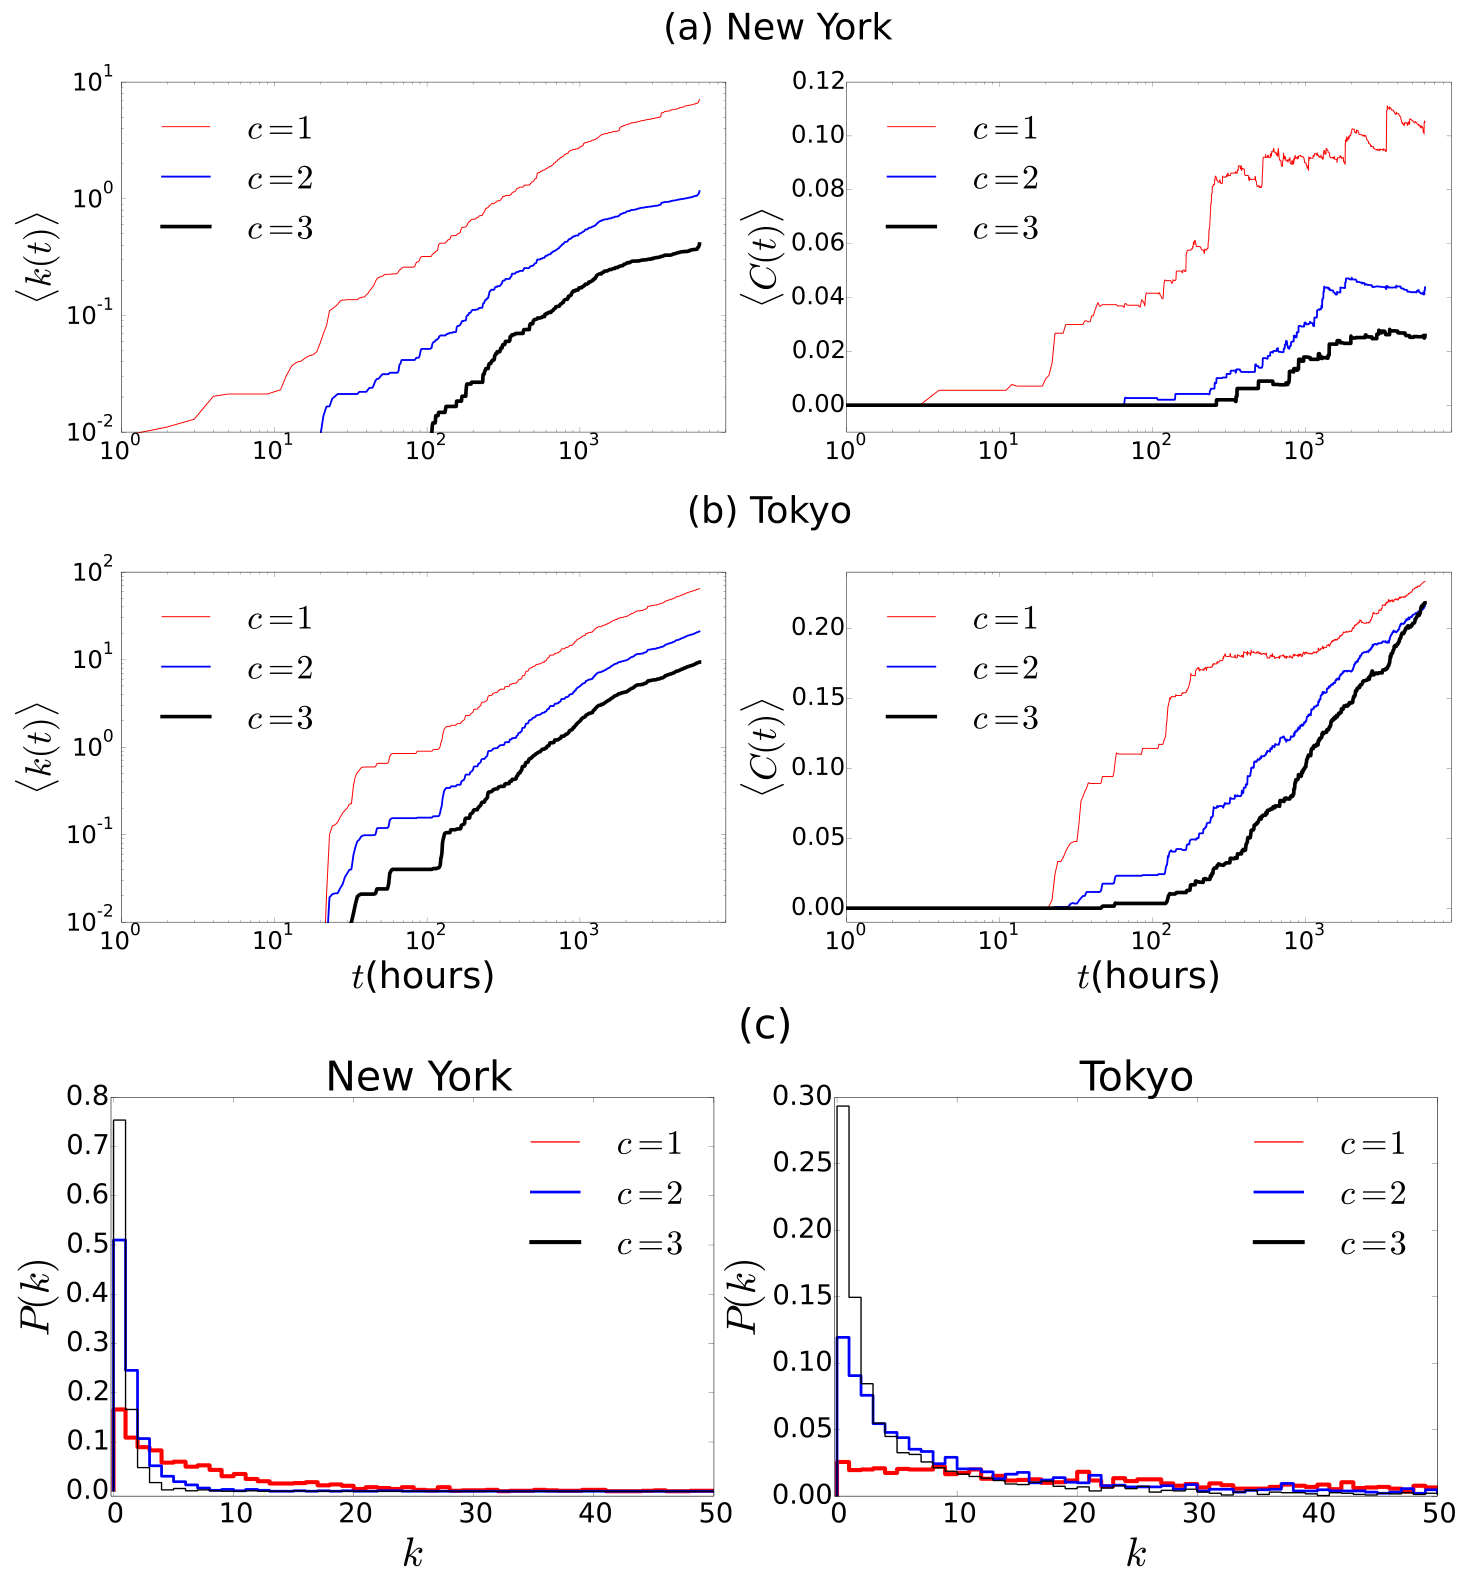
图 4|边不断积累,网络会朝哪里变化?
(a)纽约的平均度与平均聚类系数;(b)东京的相同指标;(c)观察期末两城的度分布。红、蓝、黑分别代表至少1、2、3次共现才连边。度是某用户连接多少人,聚类系数衡量其联系人之间互相连接的比例。横轴时间以小时计。来源:原论文 Fig. 4。
纽约的聚类系数在数周后趋于相对稳定,c=1时约0.1;东京在该观察期内仍继续增长。这是样本网络的差异,不足以判断纽约所有人的社交圈更固定。东京用户约为纽约的两倍,记录总量也更大;签到密度、覆盖地点和被观察时间的不同,都可能参与结果。
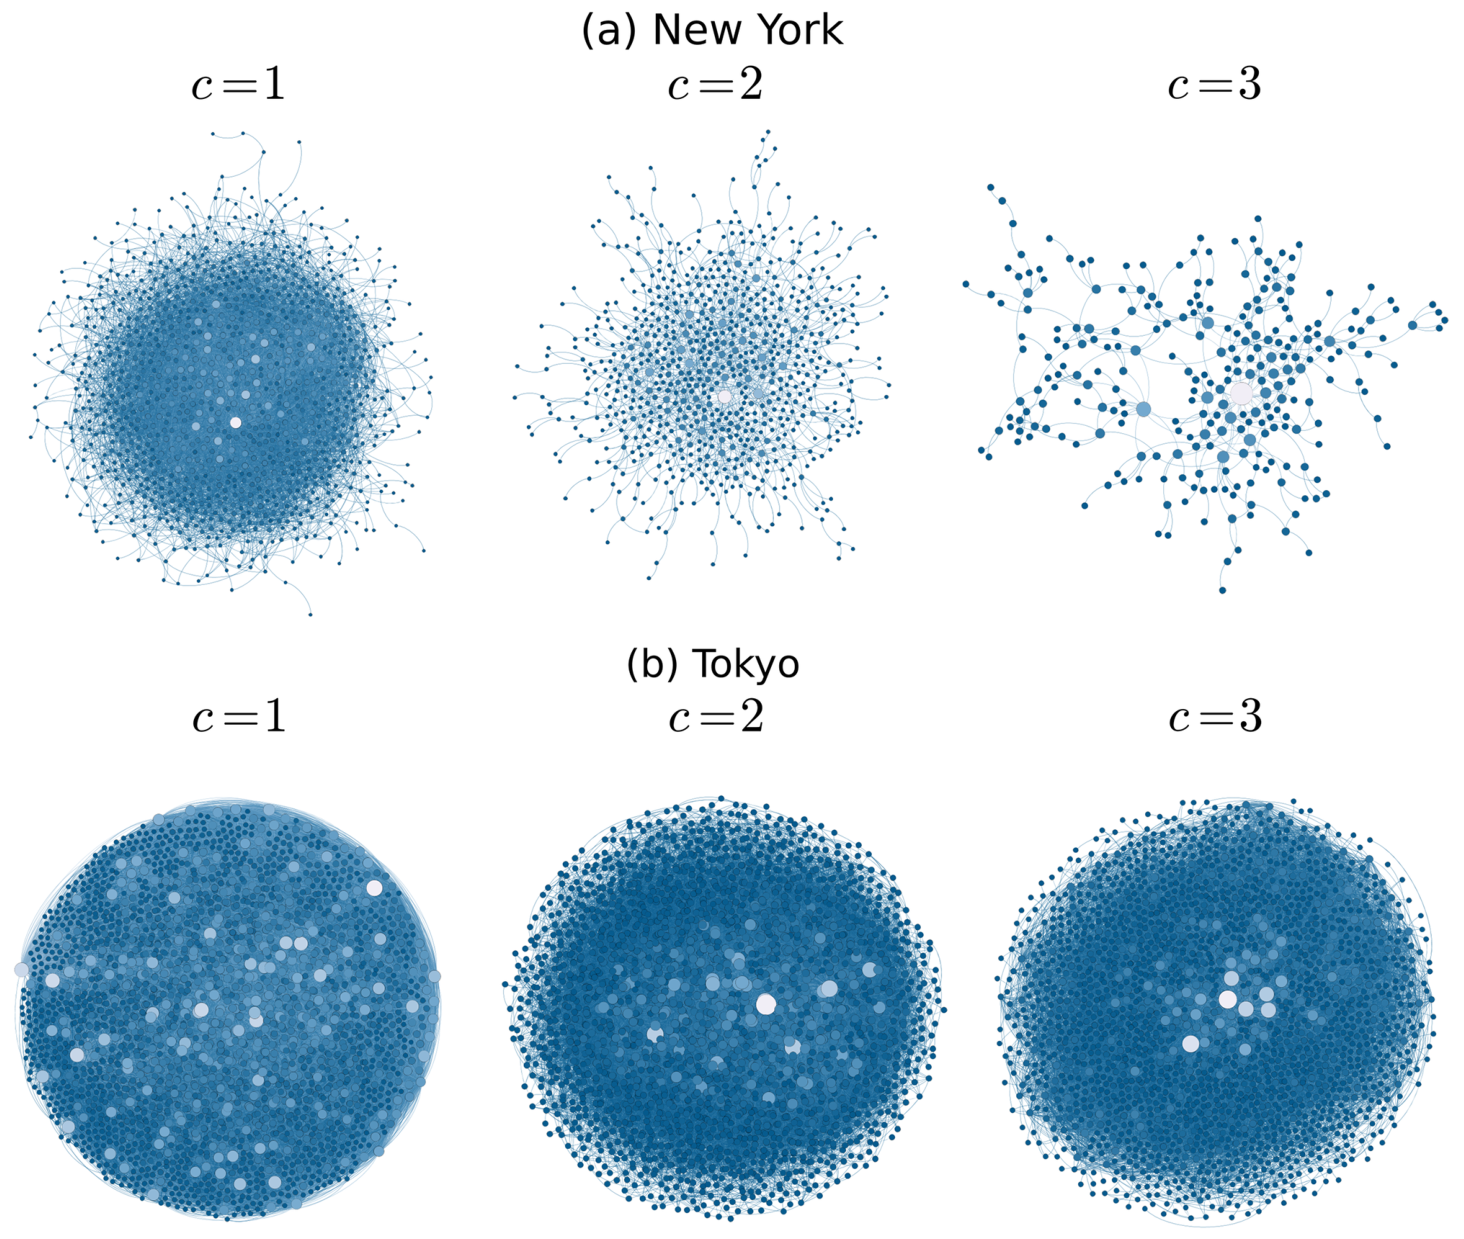
图 5|把连边要求从一次提高到三次,会留下怎样的结构?
(a)上排纽约,(b)下排东京;每排从左至右c=1、2、3,展示各自最大连通分量。节点大小和颜色与度相关,布局用于看连接结构,不是城市地图。纽约严格阈值下明显稀疏,东京仍保留较大连接群。来源:原论文 Fig. 5。
原文表1让这个差别更具体。在100米、c=1时,纽约最大分量含1,037人,平均最短路径约2.97;东京含2,291人,约2.07。到c=3时,纽约最大分量降至261人、平均路径约6.32;东京仍有2,006人、约2.91。这些路径是在最大连通分量内计算,不包含被排除的孤立点;不能把它读成全城任意两人只隔两三个人。
不认识彼此的人,也能生成有结构的遭遇网络吗?
作者让行走者在二维平面上的固定地点间移动。给当前位置周围半径R内的地点相同权重1,半径外的地点权重按(R/距离)的α次方衰减,再把全部权重归一化为转移概率。
这个归一化很关键:只要远处权重仍非零,圈内某地点的概率就不单是“1除以圈内地点数”。α越大越偏向附近;趋于无穷时成为纯局部策略;α趋近0时则近似均匀选择所有地点。R控制局部范围,α控制远跳的抑制强弱。
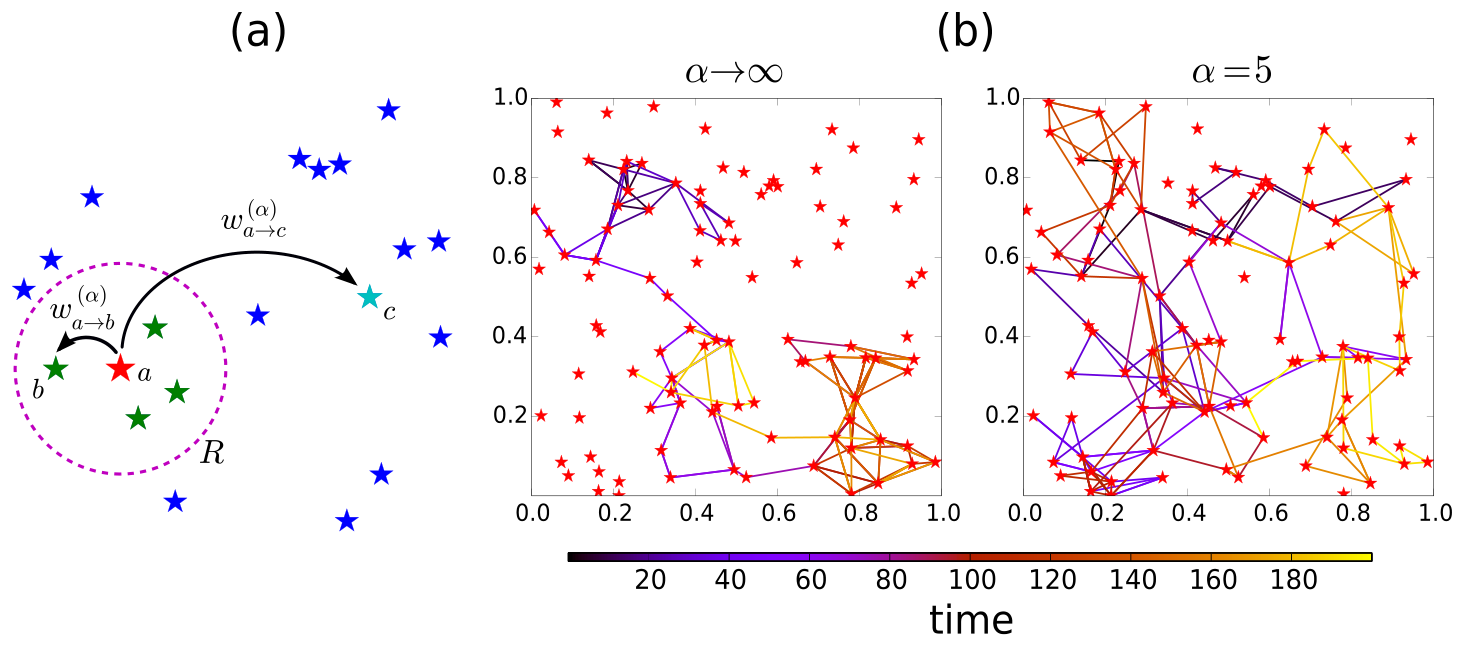
图 6|只改一条距离规则,探索范围会怎样变?
(a)20个地点的规则示意,圆内等权、圆外随距离降低;(b)100个地点上的200步轨迹,比较α趋于无穷与α=5,R=0.17。色条表示模型步数,不是现实分钟。长程跳跃帮助跨越局部区域,但这还没有加入人的目的、道路或出行成本。来源:原论文 Fig. 6。
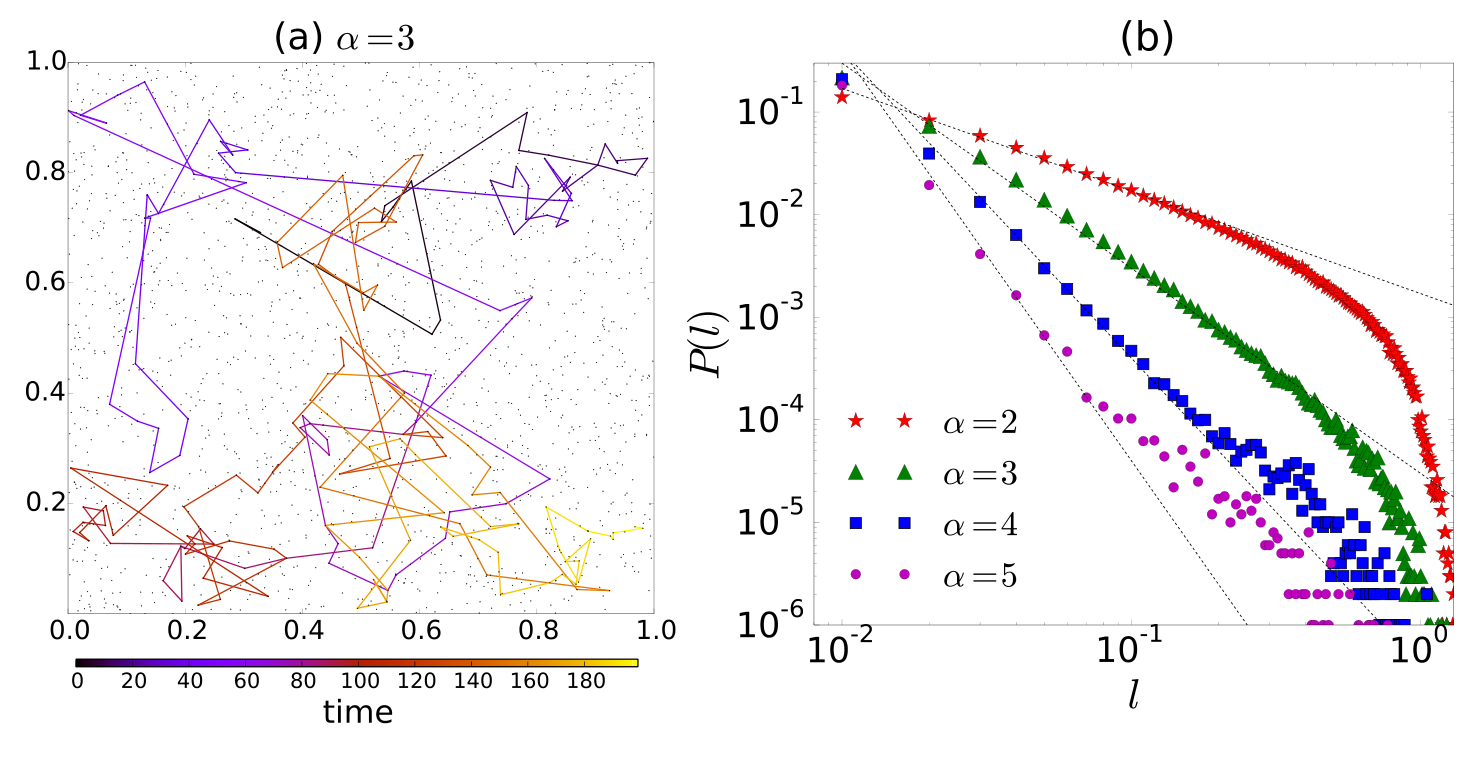
图 7|远跳规则怎样变成可比较的位移分布?
(a)2,000个随机地点上,α=3、R=0.01的200步示例;(b)不同α下,由100万次位移统计的长度分布,虚线为l^(1−α)参考关系。大距离端受有限空间截断。来源:原论文 Fig. 7。
为什么指数不是直接−α?在二维空间,距当前位置同样远的一圈,半径越大可选地点越多。单个地点的权重按l⁻α减少,而圆环里的地点数约按l增长,合起来才是l^(1−α)。这一几何解释使模型能产生接近经验的位移分布,但同一个分布也可能由其他行为机制产生,不能唯一反推出人的决策规则。
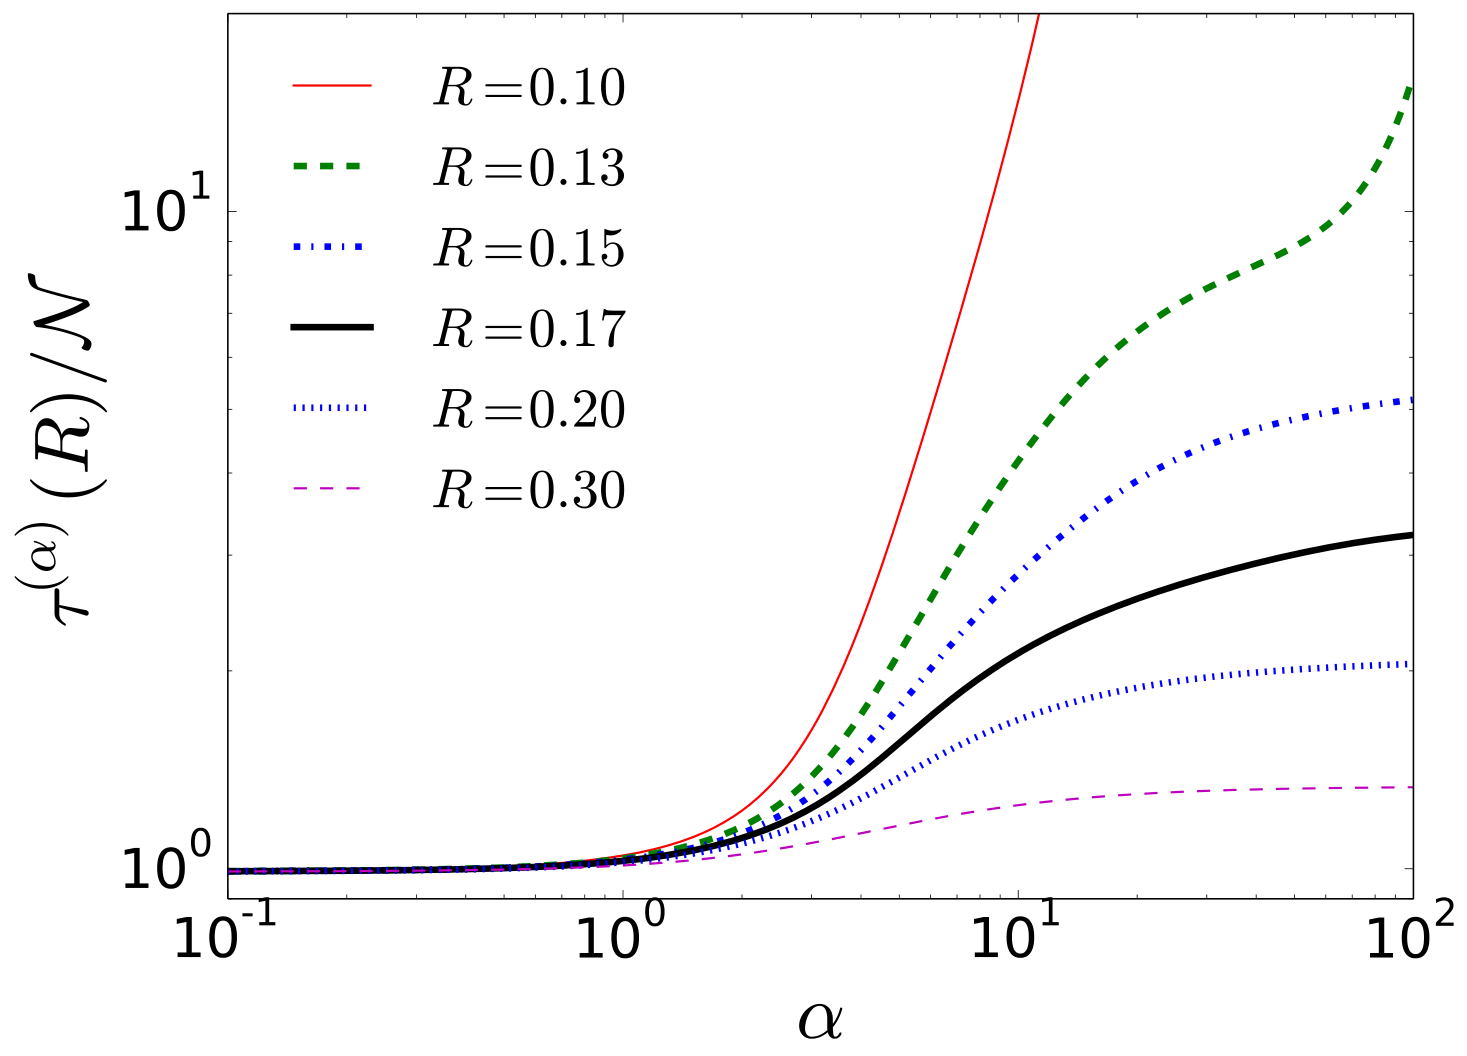
图 8|更容易远跳,是否更快到达目标地点?
整图无字母面板。横轴α,纵轴为全局平均到达步数除以地点数,不同线表示R,地点数100。指标由转移矩阵的谱性质计算;较局部的策略可能需要更多步。它是对随机起点、目标平均的到达时间,不是依次走遍全部地点的覆盖时间,也没有对长距离步计入更多交通成本。来源:原论文 Fig. 8。
因此,“长程更高效”有明确前提:在这个把一次远跳也算一步的指标里。它不能直接推出城市居民应尽量远距离出行。纯局部规则还可能因地点分布而困在局部;允许远跳改变可达性,首先是数学机制的结果。
网络为什么会长出来,又为什么会停止增长?
模型中的每个人独立移动,没有先验友谊、邀约或同行。作者再加一条读出规则:只记住最近M步的共现,窗口内达到c次就连边,跌到c次以下则删边。
这里要与前面的真实数据区别开:经验网络累计观察开始以来的共现;有限记忆窗口主要用于模型。经验聚类稳定和模型因删边达到平衡,可以看起来相似,却不能据此断言现实中的稳定一定来自相同机制。
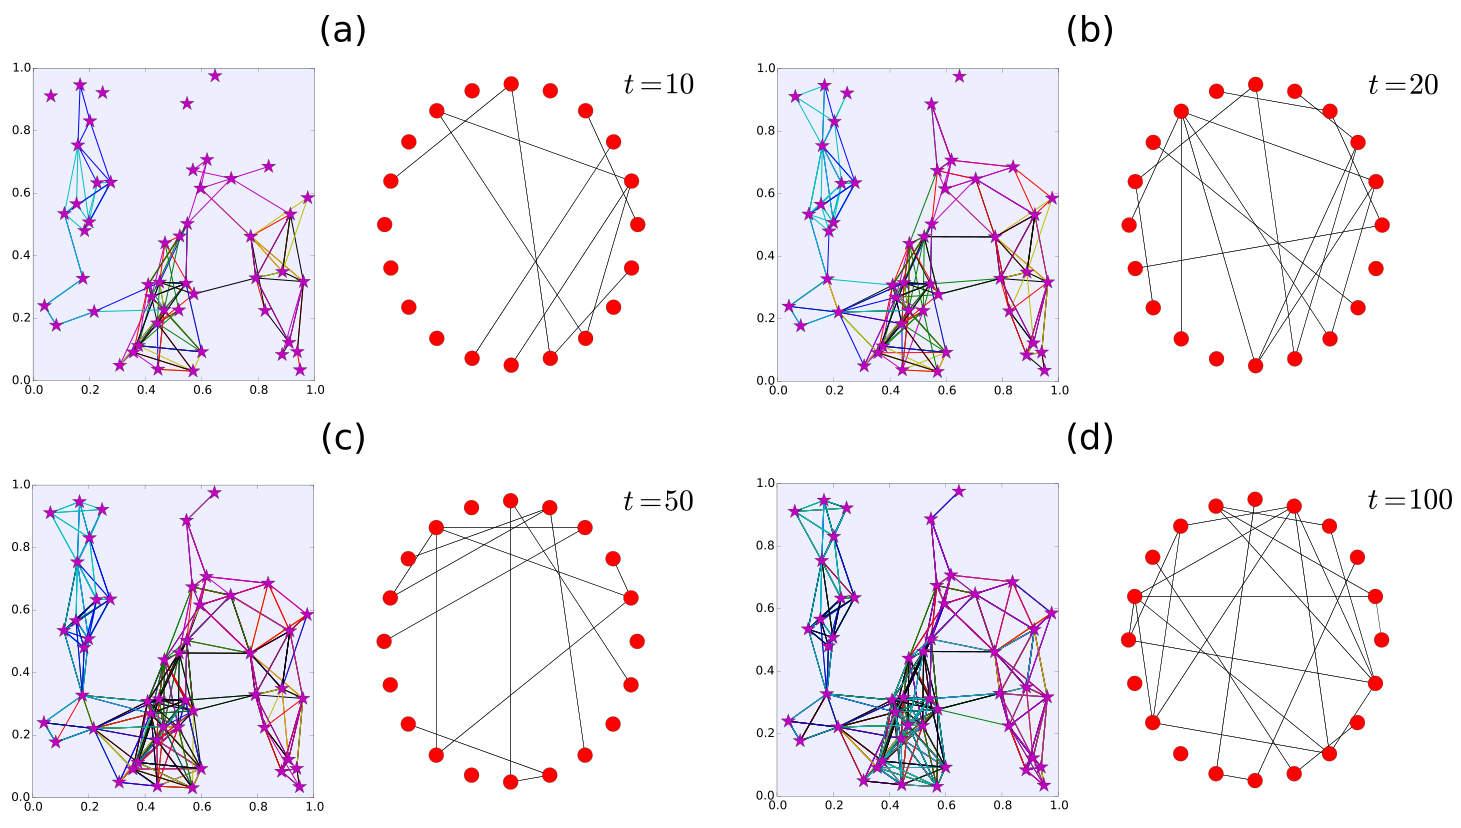
图 9|没有交朋友的规则,边也会出现吗?
(a)t=10,(b)t=20,(c)t=50,(d)t=100;每个面板同时含左侧空间轨迹与右侧遭遇网络。20名行走者独立访问50个地点,R=0.25,α趋于无穷,M=20,c=2。右侧圆形排列只为看边,红点不是地点而是行走者。两段补充视频分别演示局部与α=5的长程策略。来源:原论文 Fig. 9及S1、S2 Video。
这个设定中,地点的共享和重复访问已经足以形成非平凡网络。t超过记忆长度后,先前的共同出现会移出窗口,某些边消失;新边形成与旧边退出共同决定长期状态。网络边的消失是统计规则,不是证明两个人现实中忘记彼此。
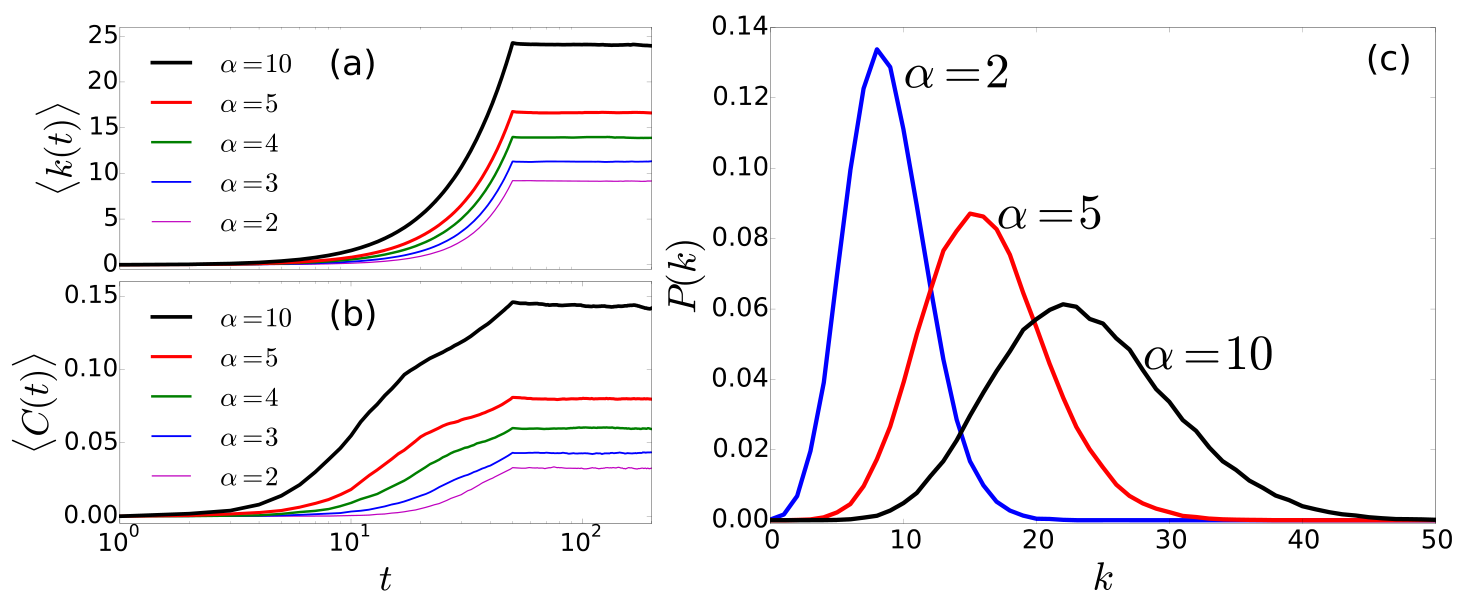
图 10|不同移动策略,会生成不同的长期联系结构吗?
(a)平均度,(b)平均聚类系数随步数变化;(c)稳定阶段的度分布。500名行走者访问100个地点,R=0.17、M=50、c=3;结果平均100次模拟,度分布在t=200检查。较局部的策略在这组设定下得到更高平均度与聚类,而不同α的度分布也不同。来源:原论文 Fig. 10。
直觉上,留在局部让同一批人更容易反复遇见;远跳扩大探索,却未必在固定记忆窗口里累积足够的重复接触。因此,到达地点更快与重复遭遇网络更稠密,并不是同一个目标。作者也明确指出,结论会依赖地点分布、R、α、M和c,不能推广成所有城市的普遍排序。
从遭遇机会,到朋友和传播,中间还缺什么?
本文最清楚的贡献,是把移动轨迹、共现判据、边的记忆和全局网络统计接到一起。它提醒我们,单看某人走了多远,会漏掉“他和谁在什么时候重叠”。但从机会到实际互动,还有几层证据缺口。
首先是测量:一次签到不说明停留时长、室内外、楼层或是否真正近距离交流;100米和一小时也不是感染接触的通用定义。其次是机制:真实朋友会约好地点、同行、改变行程,模型中的独立随机行走者没有这些反馈。最后是验证:模型与真实网络主要作定性比较,论文并未对个人未来接触、疾病传播或友谊形成给出独立预测评估。
因此,遭遇网络可以为传播或行为扩散研究提供结构线索,却不能把这里的每条边直接当成一次可传播接触。要研究具体疾病,还需要停留时长、接触强度、环境和时间顺序;要研究友谊,则需独立的关系资料。
一句话总结
移动不仅生成路线,也生成重复共现的网络;局部访问、远跳和记忆窗口共同塑造这张网,但共现机会仍需与真实互动、朋友关系和传播过程区别开。
核心来源
- Riascos, A. P. & Mateos, J. L.(2017). Emergence of encounter networks due to human mobility. PLOS ONE 12(10): e0184532。论文、完整数学方法、表1和两段模拟视频。本文全部主图及数值据原文,原图按开放署名许可转载,每张保留完整组合与原有面板。
作者介绍
以下按论文发表时署名介绍,两位作者贡献相同,并共同参与构思、数据、方法、分析与写作。
- A. P. Riascos:哥伦比亚帕斯托Universidad Mariana土木工程系署名作者,本文通讯作者。
- José L. Mateos:墨西哥国立自治大学物理研究所署名作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
比较两座城市的遭遇网络之前,可以先把人数、每人签到量和观察时长匹配,再统一改变距离、时间与重复次数阈值。如果“城市差异”只在某一种阈值或采样密度下出现,就应先解释测量机制,而不是急着解释文化与生活方式。
另一种有用的检验,是保留每个人常去地点和活动时间分布,却打乱不同人的具体日期。这样可构造只由空间热点和作息重叠形成的基线,再看真实重复共现超过基线多少。超出部分仍不等于友谊,但会比直接把全部共现都看作社会关系更接近问题本身。