每天同一班公交,怎样织出一张看不见的城市网络?
论文名片|Lijun Sun、Kay W. Axhausen、Der-Horng Lee、Xianfeng Huang,Understanding metropolitan patterns of daily encounters,Proceedings of the National Academy of Sciences,2013,110(34):13774–13779。期刊正式版,2013 年 8 月 5 日在线发表。DOI · 开放全文及补充材料入口。
公交车上的某张脸,你叫不出名字,却几乎每天都能看见。这种熟悉的陌生人(familiar stranger)未必和你交谈,也未必知道你在留意他。两个人只是被各自的作息,反复送进同一辆车。
如果把整座城市里这样的重复同车都连起来,会得到一堆彼此隔开的通勤小圈子,还是一张覆盖很多乘客的大网络?这篇论文用新加坡一周公交刷卡记录,把个人的出行规律与城市尺度的共同在场联系起来。
主要发现有四点:
- 重复同车具有明显的日节律,相邻两次相遇间隔在 24、48、72、96 小时附近出现峰值,早晨比傍晚更突出。
- 单次同车时间受到行程约束,但累计重复相遇时长和个人重复相遇量差异很大。
- 重复相遇率高的人通常乘车时刻更规律;反过来,时刻规律并不保证一定遇到很多固定乘客。
- 对筛选出的高重复相遇乘客,周内累积网络高度连通、路径短、聚类较高。它记录的是共同在场,尚不能当作友谊、交谈或实际传播的网络。
刷一次卡,怎样知道谁和谁同车?
补充材料说明,数据来自 2011 年 4 月 11 日至 17 日,共 21,814,448 条公交乘车记录、2,895,750 个匿名卡号。刷卡系统覆盖超过 96% 的公共交通出行,但论文只分析公交,因为地铁列车较大,同列车更难代表接近。
一条记录包含卡号、车牌、线路、上下车站和刷卡时间。两张卡在同一辆车中的乘坐时间重叠,就构成一次相遇(encounter)。关系从后上车者上车开始,到先下车者下车结束。这里的 trip 是一次乘车阶段:换乘另一辆车会生成新记录,不能直接等同于完整的家到单位行程。
这个定义能重建有起止时间的共同在场(co-presence),却不知道座位距离、是否看见对方、是否谈话。匿名卡号也首先是卡的标识,论文将其用作个体代理。文章所称覆盖约 55% 人口是规模比较,并不说明样本是人口的随机抽样。
为判断代表性,补充材料还对照人口普查和 2008 年家庭出行调查。后者包含 10,641 户、35,122 名受访者。公交使用随年龄、收入和住房类型而变化:低收入人群的公交份额更高,青少年使用也较多。因此,这是城市里一项广泛活动的接触网络,外推全部居民时仍要注意选择性。
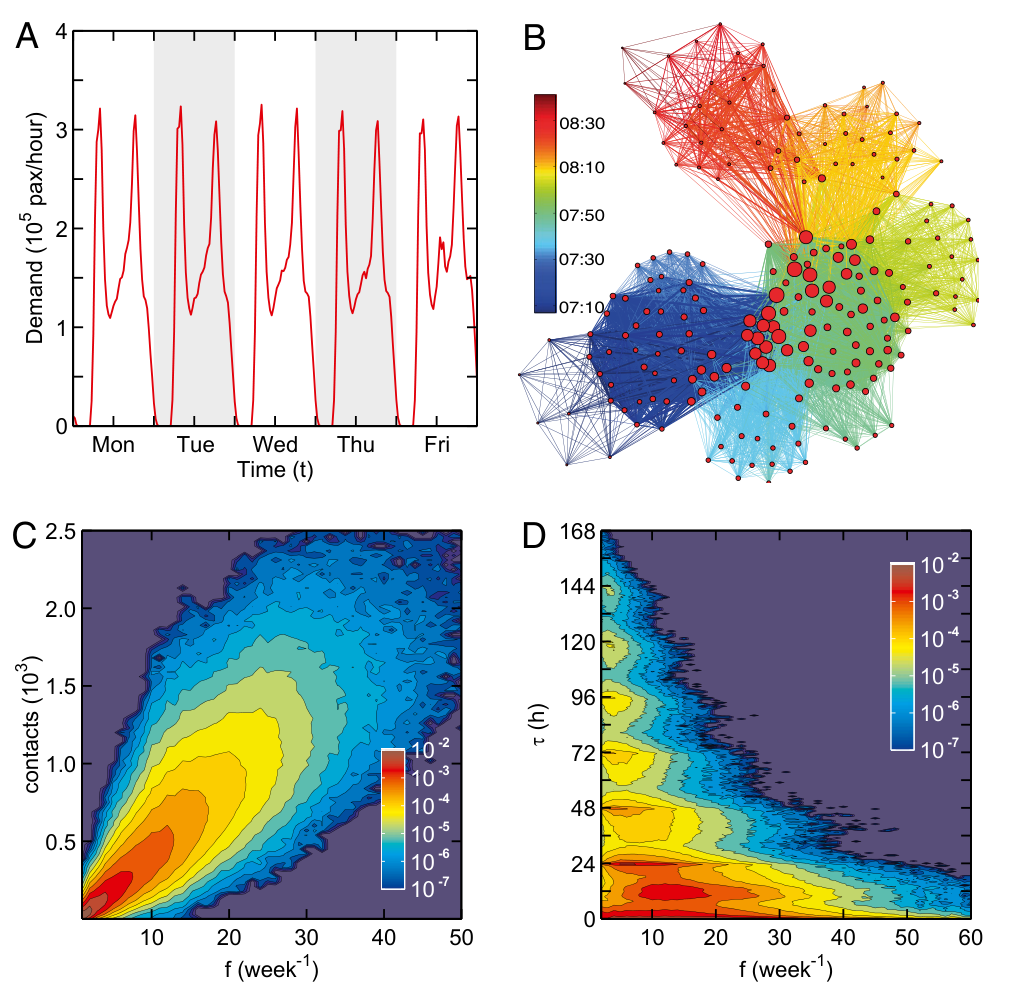
图 1|日常乘车记录怎样转成相遇结构?
(A)周一至周五的公交出发需求。纵轴单位为每小时十万人次,每天相似的早晚峰显示集体出行节律。
(B)一趟车辆服务中 214 名乘客形成的时间网络。节点大小表示遇到的人数,边颜色表示相遇开始时刻、粗细表示持续时间;这不是同一瞬间 214 人同时挤在车上。
(C)每周乘车阶段数 f 与累计相遇量 n 的联合概率密度。暖色为更高密度,主要分布围绕 n/f ≈ 50;按原文 n = 各次乘车相遇量之和的口径,同一个人在不同车次再次出现可能重复计入。
(D)f 与连续两次乘车间隔 τ 的联合概率密度。横轴为每周阶段数,纵轴为小时,显示出行频繁程度不同的人,乘车间隔结构也不同。来源:原论文 Fig. 1。
图 1C 的约 50 不是说每次必然新增 50 个不同朋友,也不是随机城市居民的相遇率。它描述的是记录中的公交阶段相遇规模。补充图 S4–S5 显示,单阶段平均时长约 14.5 分钟、标准差 12.7 分钟;每卡一周阶段数平均 7.5、标准差 6.6。时长和次数的尾部近似指数下降,人的公交活动受有限时间与线路条件约束。
瞬时网络又有一种天然结构:同一车上乘客按定义两两相连,不同车辆之间在那个瞬间没有边。补充图 S6 展示的完全连接小块,部分来自相遇定义本身,不能单凭这种团块认定乘客形成了社会社群。
为什么昨天见过的人,今天又在差不多的时刻出现?
分析重复相遇时,论文在工作日聚合网络中得到 18,724,388 对重复相遇者及其 27,892,055 个相邻相遇间隔。这个分母只包含已经重复相遇的设备对式个体组合,不包含所有可能的乘客配对。
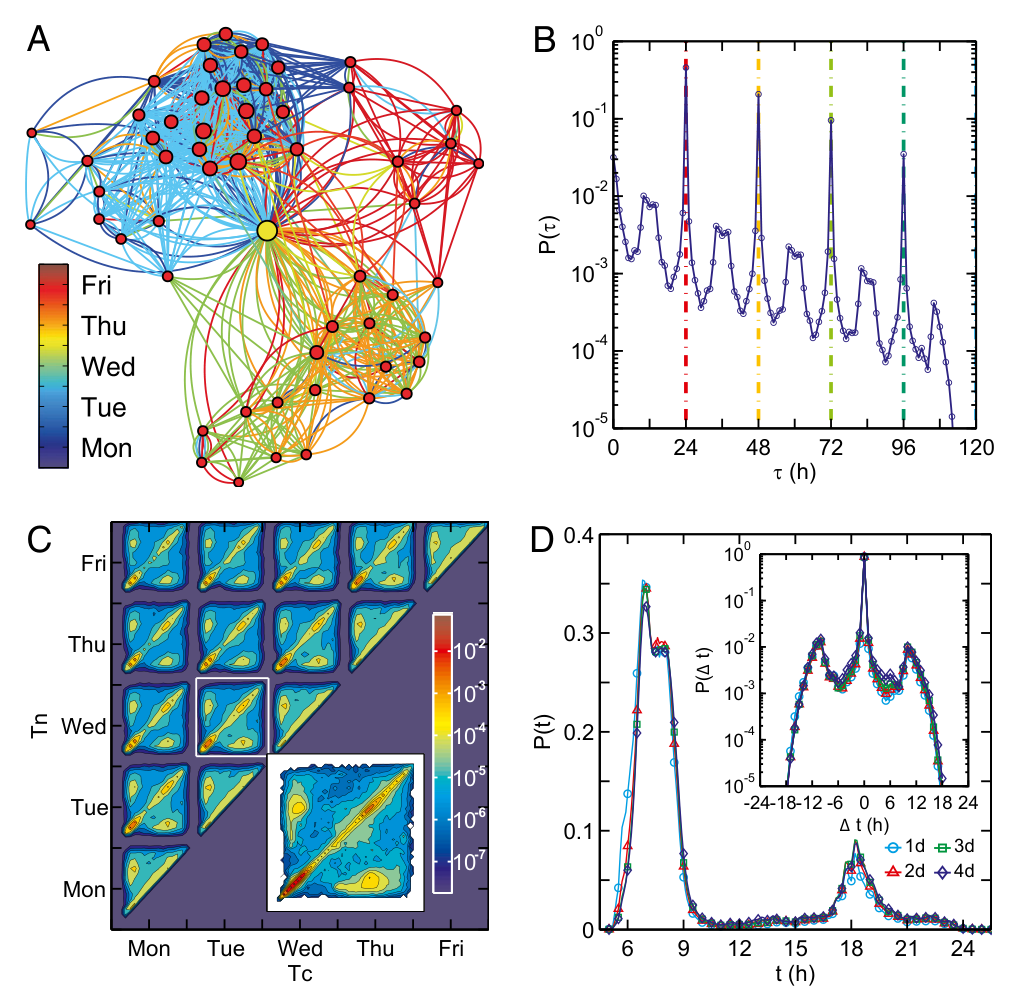
图 2|熟悉的陌生人是否沿着固定时刻再次出现?
(A)一名乘客与其重复相遇者的示例网络。颜色表示周一至周五,邻居之间也可能在其他时刻同车;单个示例用于展示结构,不能单独验证全城连通性。
(B)同一对乘客相邻两次相遇间隔 τe 的概率密度,对数纵轴;24、48、72、96 小时峰值突出,较长间隔的频率总体下降。
(C)本次相遇时刻 Tc 与下次 Tn 的联合密度。横纵轴均跨工作日,放大框显示某一日期组合内接近相同时刻的高密度对角带。
(D)按两次相遇相差 1、2、3、4 天分组后,将日期去掉,只比较一天内时刻。四组曲线接近,早晨峰高于傍晚;插图的时刻差 Δt 在零附近最突出。来源:原论文 Fig. 2。
图 2B 的每日峰附近覆盖约 75% 的间隔。图 2C 的放大框里,23–25 小时的对角带覆盖该比较范围内约 85% 的情况;不能把这个局部比例写成全部乘客中 85% 每天固定见同一个人。
相隔多天的峰较低,有一部分原因是观测窗口:一周里能观察到四天间隔的起止组合本来就少。论文因此比较当前和下一次相遇的联合日期分布,并以成功概率约 0.33 的伯努利过程描述人口层面的再相遇。这个概率是简化的总体描述,不是对任意两名乘客明天必然有三分之一机会再见的承诺。
更有意思的是早晚差异:公交总体出行的下午峰更宽、更高,但重复相遇在早晨更集中。晚上的下班、购物与其他安排可能分散同车组合,不过这些具体动机并非刷卡数据直接观察到的原因。论文证据支持的是早晨重复相遇的时间规律更突出。
由这些间隔数除以重复配对数再加一,得到每对在观察期内平均约 2.5 次相遇。这个数只对已重复相遇的配对成立,不能拿来描述任意一对公交乘客。
相遇次数多,是坐车久,还是作息更合拍?
如果一个人整天待在车上,重复碰见别人更多并不奇怪。论文先定义个人重复相遇权重 w:对每位遇到的人,把相遇次数减一后再求和,首次相遇不计入重复量。
例如,同一人见三次,贡献两次重复相遇;另一个人只见一次,贡献为零。熟悉的陌生人数 k 则统计见过至少两次的不同人,两者不是同一个指标。再把 w 除以个人总乘车小时 T,得到 r = w/T,单位是每小时重复相遇次数。这只是按时间标准化的经验率,不是介于零和一之间的概率。
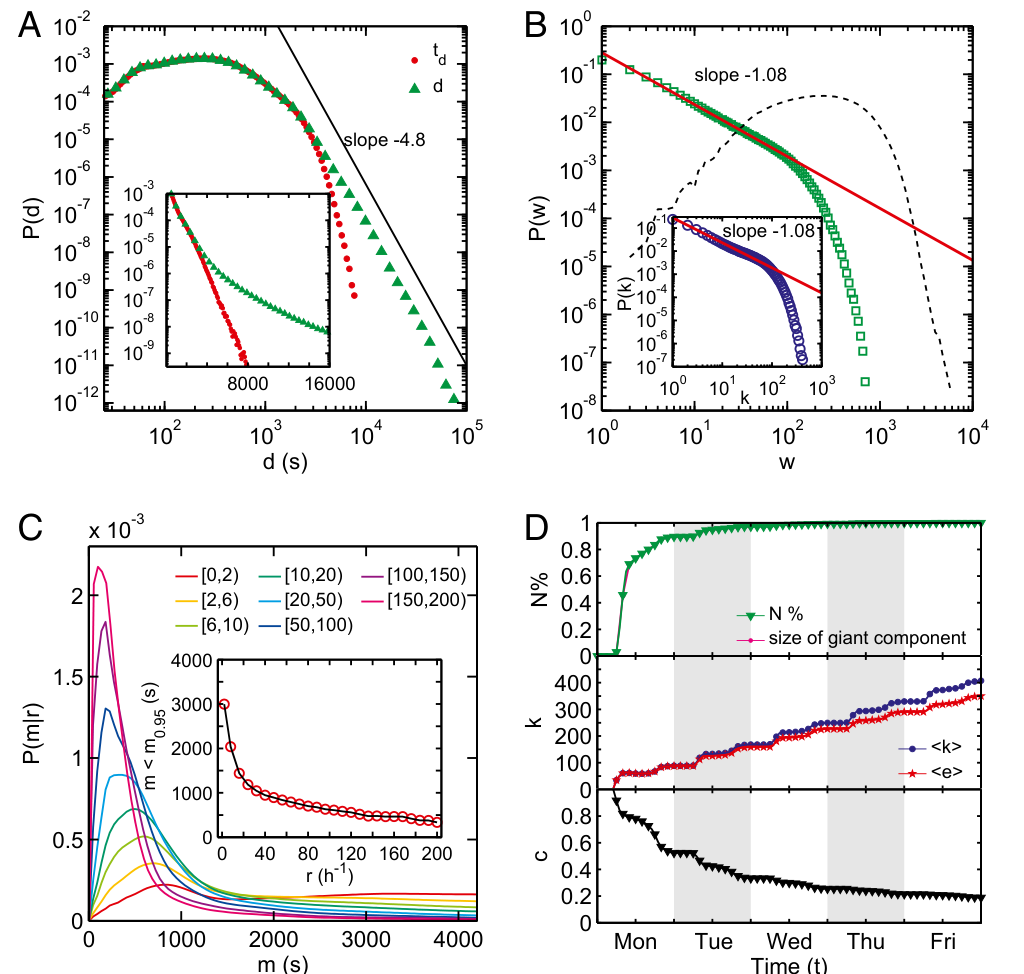
图 3|个人作息怎样对应重复相遇与集体连接?
(A)单次相遇时长 td 与每对乘客累计相遇时长 d 的分布。横轴为秒,主图双对数、插图半对数;累计量尾部更长,原文幂律近似指数约 4.8 ± 0.1。
(B)1,626,040 名至少有一次重复相遇者的 w 分布,插图为熟悉的陌生人数 k 分布。二者在一段范围内近似幂律、远端有截断,参照指数约 1.08 ± 0.02;虚线为全部相遇量 u 的对照。
(C)按 r 分组的个人乘车时刻偏差 m 分布。m 越小代表时刻越集中,颜色表示不同 r 区间;插图给出各组剔除 m 最高 5% 后的平均趋势。
(D)783,247 名 w ≥ 10 乘客的累积网络。上层比较已出现节点比例与最大连通分量,中层比较累计相遇次数和不同相遇者数量,下层为平均聚类系数随工作日的变化。来源:原论文 Fig. 3。
图 3A 告诉我们,单次同车时间有界,并不妨碍重复积累形成少数很强的共同在场联系。图 3B 又说明,不同乘客拥有的重复相遇量很不均匀。这里的幂律近似是有限观察范围的分布描述,不能反推出每个个体长期遵循同一种机制。
个人规律性 m 使用每次乘车起止时刻的中点,将出行时刻分组,再计算相对组中心的平均绝对偏差。补充材料还尝试识别不规则阶段:若被判异常的阶段合计占个人乘车时长不到 10%,才予以移除,以免删掉重要的日常活动。m 衡量的是乘车时刻集中程度,不包含目的地、路线、职业或日程约束的全部信息。
正文图 3C 的截尾平均显示:r < 4 次/小时者,m 约 50 分钟;r ≥ 80 次/小时者,m 低于 15 分钟。注意这不是所有人未经筛选的平均,也不是以调整作息为干预得到的因果效应。
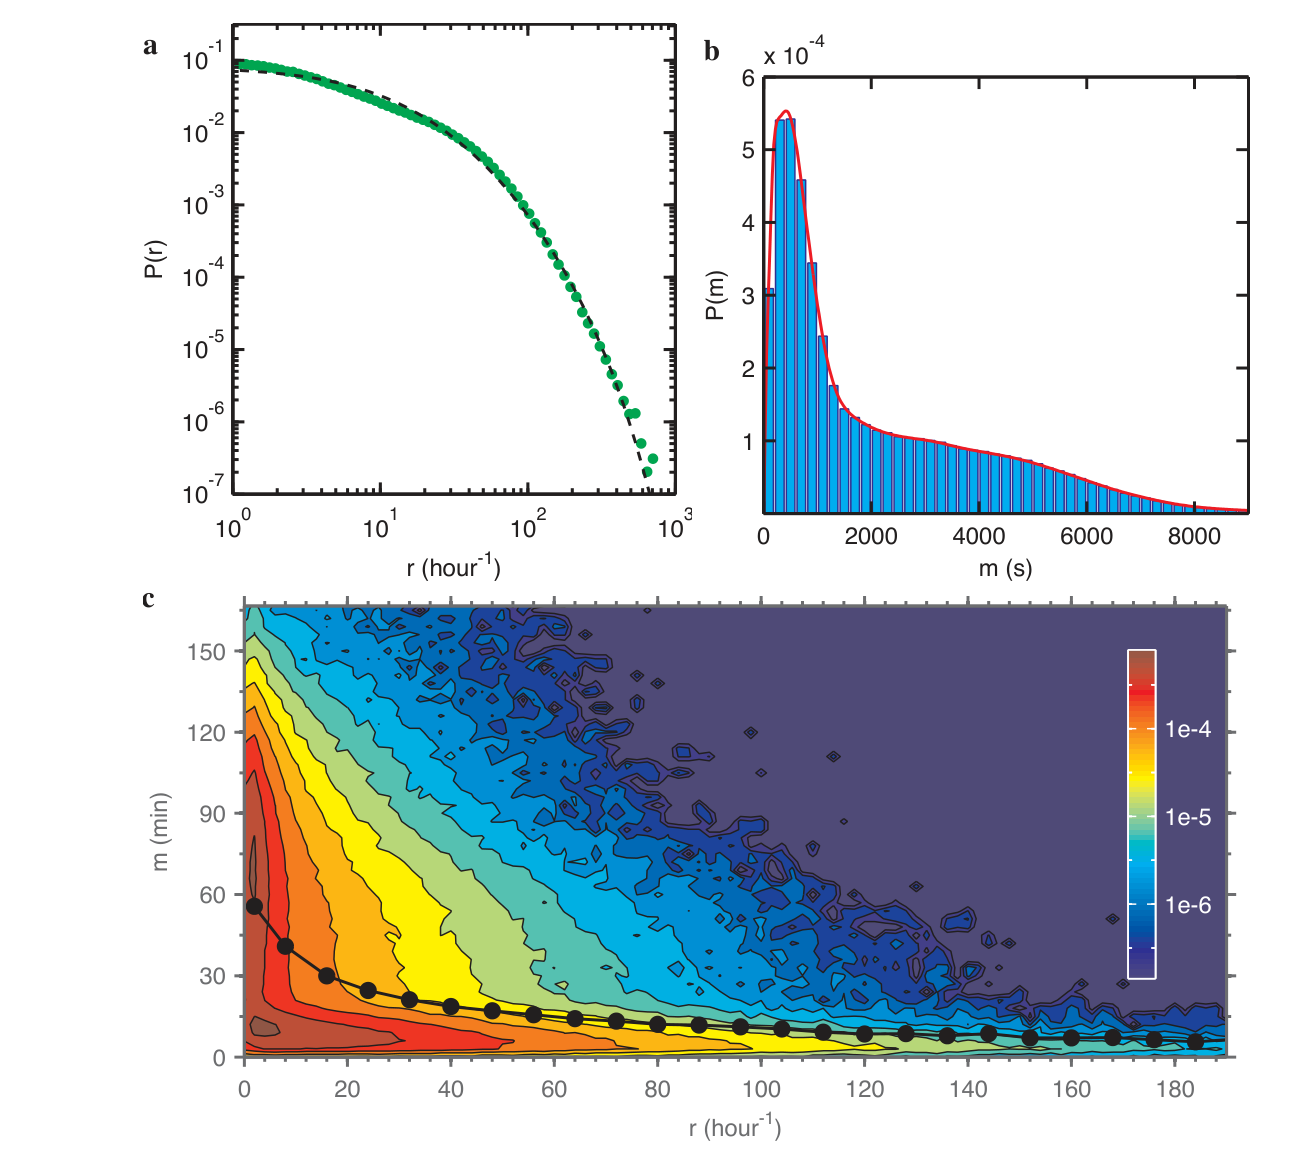
图 S9|规律乘车是否必然带来高重复相遇率?
(a)r ≥ 1 的乘客重复相遇率分布,横轴为次/小时,双对数展示截断重尾。
(b)m 的概率密度,横轴为秒,尖峰之后仍有较长尾部,显示研究样本中也包含时刻不规律的乘客。
(c)r 与 m 的联合密度,纵轴改用分钟,暖色表示较高密度,黑色点线表示 m 低于组内 95 分位数者的平均趋势。低 m 区域横向覆盖很宽,意味着规律的人也可能只有很低 r。来源:原论文补充 Fig. S9。
这张补图给出重要的非对称性:高 r 的人通常 m 小,但 m 小的人未必 r 高。即使每天固定时刻乘车,若所在线路少有其他固定乘客,或者人流组合变化很大,也可能没有太多重复相遇。数据中的相关关系因而不能改写为“越规律,必然越会认识人”。
车厢里的小圈子,怎样连接到全城?
一辆车的瞬时团块,可以被先后换车、换时段的乘客在周内连接起来。图 3D 对 w ≥ 10 的 783,247 名乘客累积联系,到周一末约 90% 已出现在网络中;出现节点的比例与最大连通分量比例几乎重合。这说明该筛选群体的大部分已出现乘客很快属于同一个巨大连接结构。
一周内,累计相遇量和不同相遇者数量均继续增加;重复量增加更快,说明关系反复出现的同时,新组合也不断加入。但一周内尚未饱和,不能证明无限延长观察也永远不会饱和。
该聚合网络的平均最短路约 2.95,对照随机网络估计值 2.63,直径为 6;平均聚类系数约 0.19,对照随机网络约 0.00045。路径相近而局部聚类高很多,支持作者所说的小世界结构(small-world):局部有团聚,整体又不需要很多步就能连接起来。
这些数字来自特定筛选和累计网络,不能说成全部新加坡居民之间只有三步。累积图中有路径,也不意味着疾病或消息能沿着它及时传播:一条边如果发生在下一条边之后,传播就无法按那条静态路径前进。本文没有实施传播模拟或测量真实感染与信息流。
补充图 S11 还从不同常客比例的群体各抽取 50 万人比较,发现节点出现速度、平均度和平均聚类系数会随构成变化。全局三角闭合率的周末值更接近,约 0.1095 ± 0.0093;平均局部聚类系数则约 0.2649 ± 0.0660。二者权重不同,这些抽样网络也不能与正文 0.19 不加区分地合并。图 S12 进一步展示,个人联系人数增加时,局部聚类通常下降。
这张网络意味着什么,又没有告诉我们什么?
论文把个人出行的规律性与城市尺度的相遇结构放到同一套观测里:平凡的重复乘车,可以让一群并不相识的人反复共处,并通过其他车次的人连接到更大的网络。
但共同在场只是社会联系的一层基础条件。熟悉是否被双方感知、是否产生信任、是否发生交谈或传播,都需要新的观测。年龄收入差异、公交线路和班次、居住就业布局、个人职业日程也可能同时塑造作息与相遇,时间标准化本身不能排除这些共同原因。
这项研究只覆盖一周,无法判断熟悉的陌生人关系是否持续数月,或假期、线路变更后会怎样。它最可靠的贡献,是展示了一种从大规模交通记录重建时序共同在场、区分个人和集体规律的方法,而非证明同车就能发展成友谊。
一句话总结
熟悉的陌生人来自反复重合的日常乘车时刻,这些共同在场可以累积成广泛连通的网络;但网络中的边首先表示同车,作息规律也不是高重复相遇的充分条件。
核心来源
- PNAS 正式论文:图 1–3、工作日相遇间隔、个人指标与聚合网络结果。
- 开放全文与补充材料:SI Appendix I–VIII,数据字段、代表性、计算细节、补充图 S1–S12 及表 S1–S4。
- 补充材料学术镜像:上述 Supporting Information Appendix,本文图 S9 出自该附录。
作者介绍
按论文署名机构和贡献声明介绍,不延伸为作者当前任职。
- Lijun Sun:新加坡–ETH Centre 未来城市实验室及新加坡国立大学土木与环境工程系。参与研究设计、执行、数据分析与写作。
- Kay W. Axhausen:未来城市实验室及苏黎世联邦理工学院交通规划与系统研究所,本文通讯作者。参与设计、执行、分析与写作。
- Der-Horng Lee:新加坡国立大学土木与环境工程系,参与研究设计。
- Xianfeng Huang:未来城市实验室及武汉大学测绘遥感信息工程国家重点实验室,参与数据分析。
延伸思考:线路更方便,会增加还是减少熟悉的陌生人?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
公交班次加密可能缩短候车时间,却也让固定时刻到站的人分散到更多车辆。相同的个人作息,未必仍对应相同的同车组合。因此,出行便利与重复相遇可能朝不同方向变化;不能把某种相遇网络密度直接当作交通服务好坏的指标。
若要检验,可以比较班次调整前后同线路、同时段乘客的期限重复相遇率,并同时控制客流、换乘、学校假期和观察天数。进一步把“重复次数”和“不同重复相遇者数”分开,就能辨别是同几个人更频繁地见面,还是每个人拥有了更广的熟悉面孔集合。最后仍需要自愿参与的调查,确认数据里的重复同车是否真的对应人的熟悉感。