球赛前的堵车,为什么不能只看汽车速度?
论文名片|Nicolas Tempelmeier、Yannick Rietz、Iryna Lishchuk、Tina Kruegel、Olaf Mumm、Vanessa Miriam Carlow、Stefan Dietze、Elena Demidova,Data4UrbanMobility: Towards Holistic Data Analytics for Mobility Applications in Urban Regions,Companion Proceedings of the 2019 World Wide Web Conference,2019,137–145。会议论文正式版,WWW ’19 Companion,2019 年 5 月 13–17 日,旧金山。DOI。
设想球赛一小时后开场。体育场周边有几条道路已经变红,附近公交站的路线查询也开始增多。只看道路速度,你不知道乘客是否正在改乘公交;只看公交查询,你又不知道谁真的上了车,更看不见步行接驳和骑车的人。
Data4UrbanMobility 试图把这些各有盲区的数据放进同一分析框架,并用 Move in the City(MiC)手机应用补充个人跨交通方式的出行链。它是一篇介绍正在推进的平台、应用和早期试用的论文,不能读成一套已完成大规模效果验证的城市治理系统。
四点最值得记住:
- 一次完整出行可能穿过多个服务商的数据边界,单一汽车或公交数据很难保留步行、骑车与换乘关系。
- 平台的关键设计是把异构数据在空间、时间和语境上对齐,而非仅把文件集中存放。
- MiC 的封闭试验只有 5 人、5 天、41 次原始行程;按交通方式拆成 58 段后,正确识别 50 段,准确率约 86.2%。
- 球赛案例说明多源观察的必要性,但没有对照日、因果识别或预测误差,查询增多不能直接等同客流增加。
什么叫跨交通方式,而不是把几种交通工具放在一张表?
多方式出行(multimodal mobility)可以泛指多种交通方式共存;本文强调的跨方式出行(intermodal mobility),是同一次出行中串起不止一种方式,例如步行到车站、乘公交、再骑车到目的地。
传统数据往往停留在某一环节。汽车浮动车数据能反映路段速度,公交服务掌握班次和查询,网页与社交媒体描述活动和事故。若不把同一时间、同一地点的记录连接起来,研究者很难判断不同方式如何互相补充,或者只是各自同时变忙。
D4UM 以德国汉诺威、沃尔夫斯堡和不伦瑞克地区为重点,面向三种时间尺度:市民短期获取出行服务,运营者中期调整服务,规划部门长期评价交通网络。跨城市迁移是目标,本文没有用其他城市验证可迁移效果。
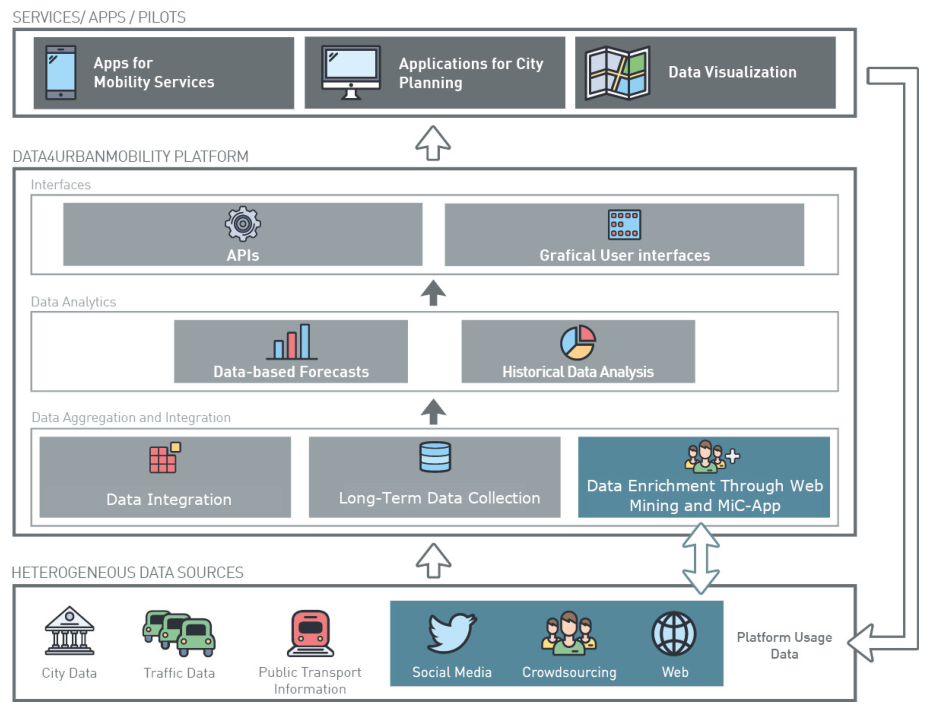
图 1|不同来源的数据怎样到达同一个城市问题?
底层是城市、道路、公共交通、社交媒体、众包和网页数据。向上依次经过数据整合、长期采集、网页挖掘与 MiC 补充,再进入预测和历史分析,通过 API 与图形界面服务应用及规划。右侧回路表示平台使用产生的数据也可返回分析链。原图无子图编号。来源:原论文 Fig. 1。
架构中最容易被忽略的一步是数据模型:例如,把交通速度记录匹配到 OpenStreetMap 路段,才能把不同数据源放在同一条路上比较。长期采集也有独立作用:临时的事故 RSS、警方社交媒体消息若不留存,过后就无法回看事件前后的变化。
图 1 是功能组织与研究方向,不是计算性能或预测能力的实验结果。论文没有给出整个平台比单源方法提高多少准确率,也没有对各模块开展消融实验。
这份数据目录,哪些能回答需求,哪些只提供背景?
表 1 汇总了截至论文写作期的资源。以下数量与时间都按 2019 年论文记录,不表示这些接口如今仍按原方式开放。
| 来源 | 论文中的规模与粒度 | 实际能观察到什么 |
|---|---|---|
| 道路浮动车数据 | 每路段每 15 分钟平均速度,2017 年 9 月至 2019 年 1 月 | 路段汽车运行状态,不直接给全部人的出行链 |
| 交通通知 | 约 2.5 万条,2017 年 6 月至 2019 年 1 月 | 事故、警告等事件信息 |
| EFA 公交查询 | 约每月 400 万次,2016 年 10 月至 2019 年 1 月 | 起终点与出发时刻的查询意向 |
| GTFS 时刻表 | 约 8,800 站、2,600 路线、200 万条站点时刻 | 计划服务,不是实际到站与实际乘坐 |
| 降雨 | 每小时、每平方公里一条,2005–2019 年 | 天气背景 |
| Twitter 与活动网页 | 德语消息流、汉诺威约 2.2 万个活动 | 活动及交通事件线索,存在平台和采集偏差 |
| 网页标注与 EventKG | 活动网页子集约 2.63 亿事实;EventKG V1.1 约 69 万事件、230 万时间关系 | 不同地域与时期的语义背景,不能都算作本地客流记录 |
| OpenStreetMap 区域子集 | 约 260 万事实,至 2019 年 1 月 | 路网和场所的地理结构 |
这些规模使用的单位不同:事实、通知、查询、站点和乘车都不能相加成为一个样本量。表中也混合商业数据、开放数据和提供者特定条款,因此“整合平台”并不意味着所有原始数据成为公开下载集。
目录里仍缺少步行、自行车和跨方式出行链。MiC 的作用,就是尝试让自愿参与的市民补充这块缺口。
手机怎样把一条轨迹拆成几段出行?
MiC 使用手机操作系统提供的活动识别接口与细粒度位置记录,尽量把处理移到服务端,减少设备端计算。公共交通部分还查询当地交通信息系统,补充上车站、下车站和线路。减少能耗与跨平台是设计目标,本文没有给出电池消耗的量化对照。
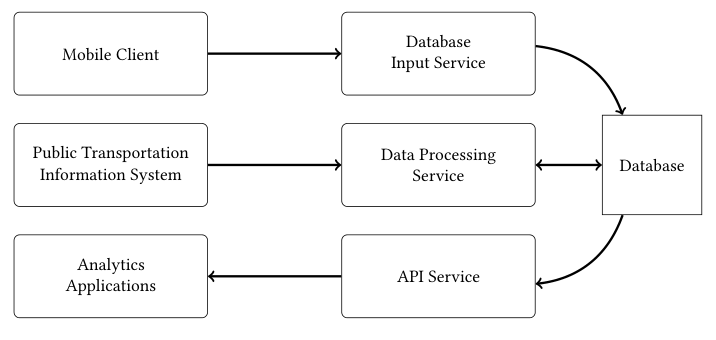
图 2|位置记录怎样成为可分析的交通方式记录?
移动客户端把记录送到输入服务和数据库;处理服务同时连接公共交通信息系统,对轨迹进行补充;分析应用通过 API 服务读取结果。箭头表示数据与服务之间的连接,原图无子图编号。来源:原论文 Fig. 2。
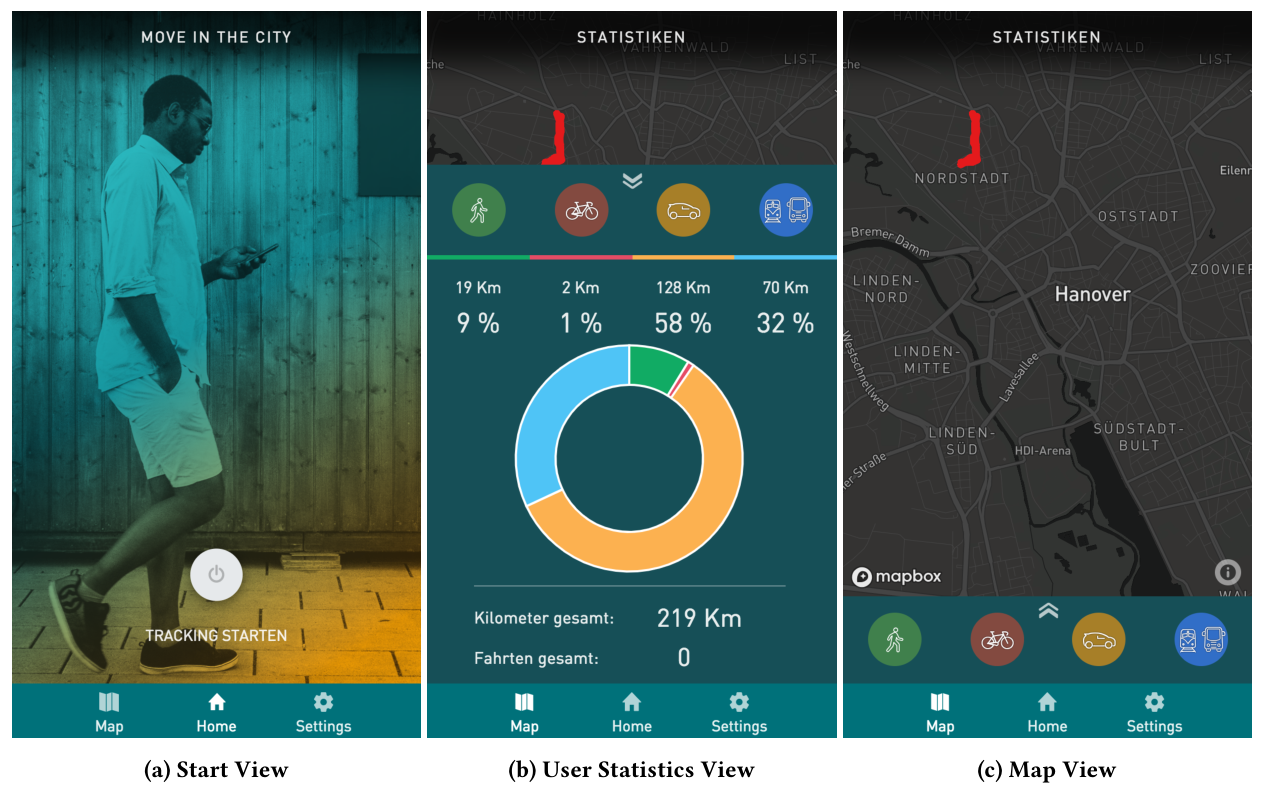
图 3|市民付出记录数据的成本,得到什么反馈?
(a)开始界面,一键启动或停止记录。
(b)个人统计界面,给出各交通方式的里程、比例和环形图。示例屏幕是界面展示,不是试验群体的平均方式份额。
(c)地图界面,显示用户的轨迹位置。三屏一起展示记录、反馈和回看这一参与流程。来源:原论文 Fig. 3。
这种公民科学(citizen science)设计以自愿贡献和个人反馈换取参与。它解释了如何招募数据贡献,却没有证明界面反馈能长期留住参与者,更未比较参与者与全体市民是否具有相同的出行模式。
86.2% 准确率,到底测了多少人、多少段?
封闭测试由 5 名参与者在 5 天内完成,记录 41 次原始行程,原始行程时长中位数 24 分钟。参与者写详细出行日记,作为识别结果的参照。地下列车因 GPS 受限被排除。
若一次原始行程含多种交通方式,会拆成单方式阶段。表 2 因而使用 58 段,中位数为 11 分钟。两个中位数并不冲突,分别对应完整原始行程与拆分后的阶段。
| 方式 | 阶段数 | 阶段时长中位数 | 识别准确率 | 按表中比例对应的正确段数 |
|---|---|---|---|---|
| 自行车 | 16 | 10 分钟 | 100% | 16 |
| 汽车 | 14 | 9.5 分钟 | 92.9% | 13 |
| 有轨电车 | 13 | 7 分钟 | 76.9% | 10 |
| 公交车 | 15 | 12 分钟 | 73.3% | 11 |
| 合计 | 58 | 11 分钟 | 86.2% | 50 |
公交和有轨电车的判定更严格:交通方式、上车站、下车站、线路都正确才算正确。自行车与汽车不承担同样的站点线路要求,因此各方式准确率并非同等难度的任务比较。自行车的 100% 只来自 16 段,不代表现实骑车识别永不出错。
这组测试没有展示步行准确率,也未单独报告“换乘边界识别”的误差。样本来自五个人,同一个人的多段行程也并非独立市民样本。论文未给混淆矩阵、置信区间、其他应用或算法基线,不能据此认定系统适用于所有年龄、机型与城市。
另一次公开测试仍在进行。表 3 记录 78 名用户、218 次记录行程、平均时长 69 分钟、92,550 个 GPS 点。这里的用户数和轨迹规模只说明采集进展,没有人工真值核验;不能把它当作扩大到 78 人后的 86.2% 准确率结果。
球赛案例说明了什么?
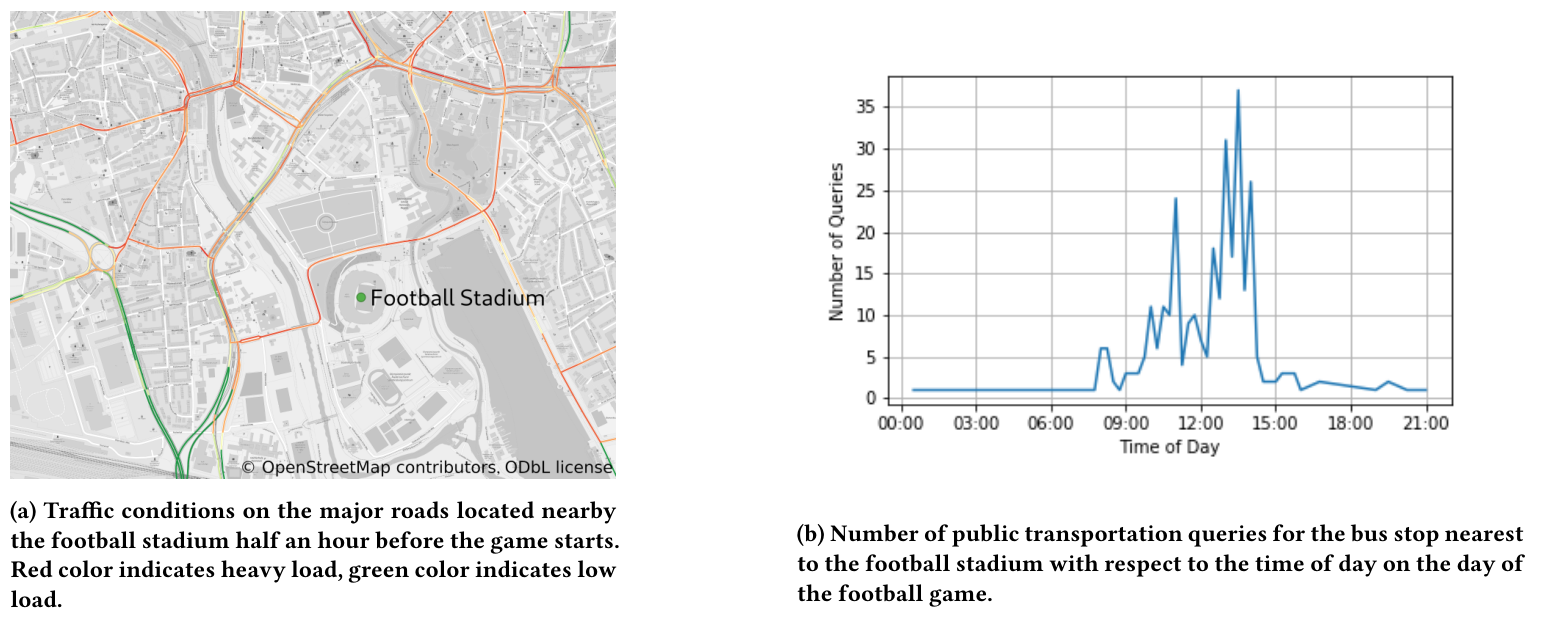
图 4|同一场球赛,汽车状态和公交查询是否呈现不同线索?
(a)2017 年 12 月 17 日汉诺威球赛,15:30 开场前半小时的体育场周边道路。红色表示高负荷、绿色表示低负荷,邻近道路并非均匀拥堵。
(b)当天体育场附近公交站的查询次数。横轴是一天内时刻,纵轴是查询数,约 9 点后上升,在约 14:30 达到峰值,早于开场一小时。来源:原论文 Fig. 4。
这组图提出一个合理问题:活动、路网结构、停车和公共交通如何共同影响出行?两种数据同时观察比单看一个渠道更有信息,但文章没有普通周日、其他比赛或天气调整后的对照。图中的关联不能确定比赛造成了多少额外需求,也不能证明公路拥堵让人改乘公交。
查询日志尤其需要谨慎。一名用户可能反复查询,也可能查过后不出行;不查询的乘客也会直接上车。因此查询峰是需求意向的线索,不是乘客到站曲线。图 4 的纵轴也未给可直接换算成每小时客流的口径,不能凭高度推算车辆容量。
论文的第二个场景是基础设施分析:识别典型模式、服务需求、交通方式依赖与公交覆盖不足。这些是平台预期支持的问题,没有在本文给出线路优化后等候时间下降、拥堵减少或出行公平改善的实证结果。相关工作中引用的预测算法与其他城市案例,也不能算作 D4UM 已实现的验证。
数据整合的另一半,是让参与者保有控制
论文还把数据治理放进架构:用户同意、隐私政策、假名化处理以及共同控制者之间的安排。应用说明数据类型、采集目的、存储共享和访问、删除、撤回同意等权利。
假名化(pseudonymisation)在这里指去除姓名、邮箱、设备标识等直接标识,同时保留实施数据主体权利所需的关联能力;这与不可逆匿名化不同。本文描述的是项目当时的设计,不是对所有轨迹发布方式的合规认证,也没有提供重识别攻击或隐私风险的量化评估。
综合来看,D4UM 的贡献在于提出一个跨方式、跨来源、兼顾参与和数据治理的整合框架,并提供初步应用试验。最主要的下一步,是扩大且多样化参与者、补足步行与换乘评估,再用真实任务验证整合比单源分析多解决了什么问题。
一句话总结
要看懂城市里一趟跨方式出行,需要把运行状态、查询意向、服务供给和个人轨迹接起来;D4UM 给出了平台与早期 MiC 试验,但尚未证明整合后能稳定改善全城预测或规划效果。
核心来源
- 正式论文与 DOI:平台架构图 1、MiC 图 2–3、球赛图 4;数据目录表 1、封闭测试表 2、公开测试进展表 3。四张图片均出自原论文对应完整图。
- 证据范围为论文所报告的 2019 年研究状态。论文未列独立补充材料,平台后续发展不计入本文已验证结果。
作者介绍
以下仅按论文署名机构介绍,未将机构身份推断为具体模块分工或当前任职。
- Nicolas Tempelmeier:莱布尼茨汉诺威大学 L3S Research Center。
- Yannick Rietz:PROJEKTIONISTEN GmbH。
- Iryna Lishchuk:莱布尼茨汉诺威大学法律信息学研究所。
- Tina Kruegel:莱布尼茨汉诺威大学法律信息学研究所。
- Olaf Mumm:布伦瑞克工业大学可持续城市主义研究所。
- Vanessa Miriam Carlow:布伦瑞克工业大学可持续城市主义研究所。
- Stefan Dietze:GESIS 莱布尼茨社会科学研究所。
- Elena Demidova:莱布尼茨汉诺威大学 L3S Research Center。
延伸思考:整合的数据更多,什么时候反而会误导?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假设比赛日查询增加,平台同时看见道路减速,就断定很多人正在改乘公交。可是同一批观众可能一边堵车一边替朋友查询路线,两个信号并不来自两群独立出行者。数据源更多,只能增加观察角度,不能自动消除重叠计数和行为含义的歧义。
更有说服力的检验,可以固定一个明确任务,例如预测未来一小时某公交站的实际上车人数,再逐步加入活动、天气、道路与查询数据,比较各组合在不同日期的预测误差。最后加入自愿贡献的完整出行链,看是否专门改善步行接驳和换乘人群。这样才能从“数据能接起来”走到“接起来确实更有用”。