没有出行调查的城市,能从卫星图里推算出上班路线吗?
论文名片|Can Rong、Jingtao Ding、Meng Li、Yong Li,A Global Intra-city Commuting Origin-Destination Flow Dataset for Urban Sustainable Development,Scientific Data 13,1269(2026)。DOI:10.1038/s41597-026-07279-z。本文结合正式论文、模型说明、跨洲验证附件及逐地区结果表解读。
假设一座城市要调整公交线路。规划者知道居民住在哪,也能从地图上找到办公区,却缺少最关键的一张表:每片住宅区到底有多少人去每个工作区?临时做一轮调查成本很高,手机位置记录又常被商业与隐私门槛挡住。
这篇论文尝试把问题改写成生成任务:先让模型在已有通勤统计的地区学习,再根据其他城市的人口、卫星影像和兴趣点,生成居住地到工作地的联系。它提供的是有依据的合成通勤流,适合填补数据空白;怎样避免把合成结果当成实测,正是理解这项工作的关键。
先说结论
- 数据覆盖6大洲、179个国家、2,358座城市,但不是对这些城市逐一做过通勤调查。全球覆盖与全球逐城验证是两回事。
- 模型在美国训练,对英国的跨国测试CPC为0.485;在美国留出地区为0.593。CPC衡量流量重叠,不能解释为48.5%或59.3%的人被正确追踪。
- 和四组手机位置参照相比,Spearman相关从0.477到0.816不等,表明结果具有可用结构,也存在明显地域差异。
- 数据只包含城内、跨分区的静态通勤。矩阵对角线存成0,却应读为“未估计”,不是区内无人通勤;跨城通勤、购物休闲和逐小时变化也不在其中。
第一步不是画路线,而是决定城市和街区怎么切
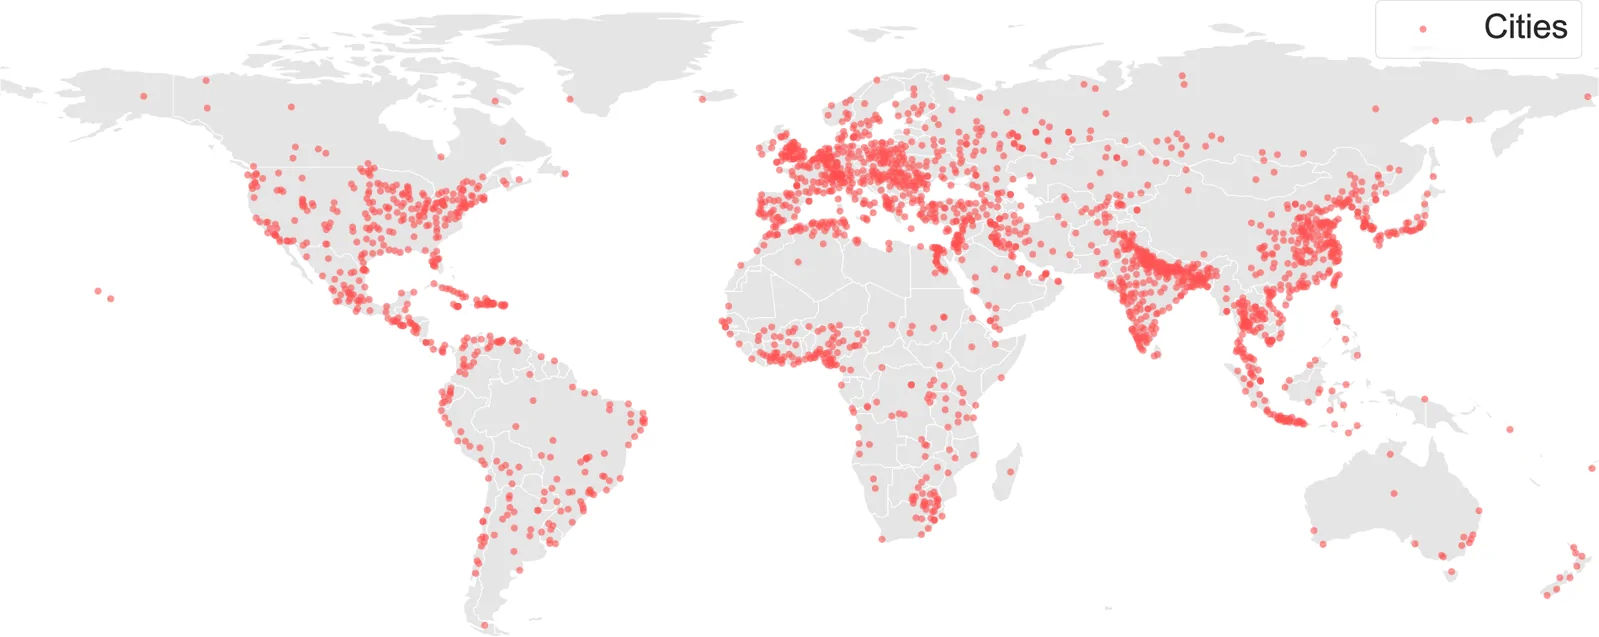
图 2|哪些地方进入了这张全球通勤图?
红点表示纳入的城市,整图无字母面板。覆盖广泛提供跨区域比较的可能,但点的分布不代表各地数据精度相同。来源:原论文 Fig. 2。
作者整合Who’s On First、GUI与GHS-FUA等边界来源,并去除重复。随后按城市范围自适应划网格,网格尺度限制在500米至5公里之间。小城市保留更细结构,大城市降低计算负担。因此,这不是全世界都采用相同的500米网格;跨城比较时,分区尺度本身也会影响流量分布。
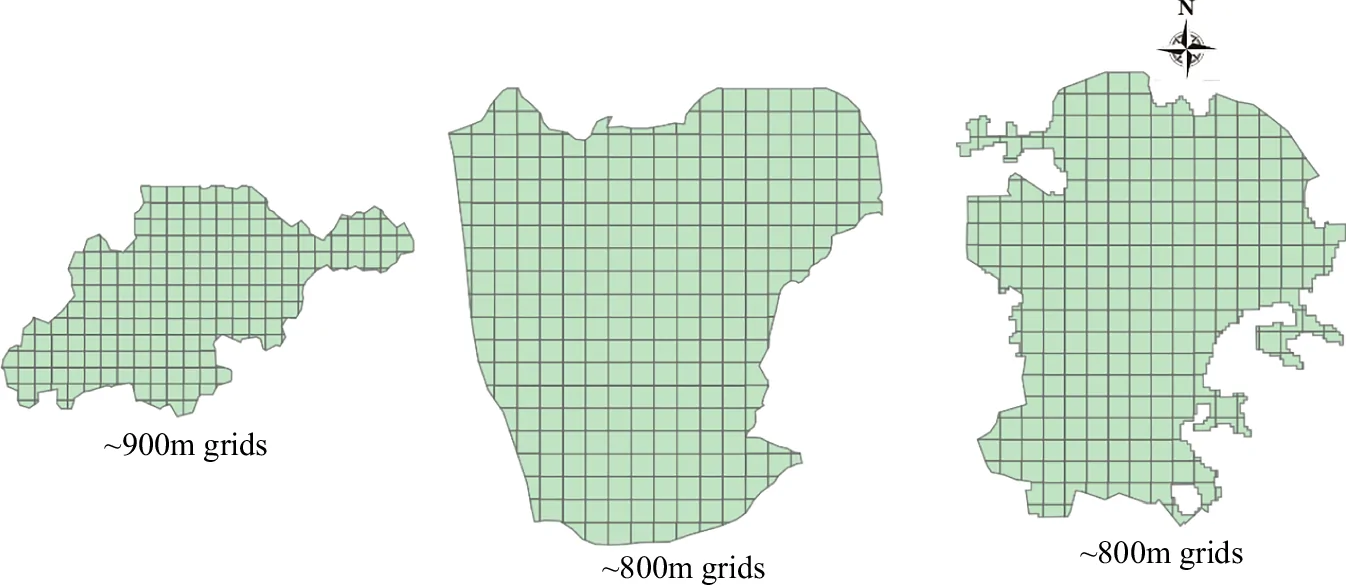
图 3|一张网格,能否同时适应不同大小的城市?
三个并列边界示例展示约900米、800米、800米的分区,原图没有a/b/c标记。绿色网格保留城市边界内部分,北箭头提供方位参照;它说明划分方式,不提供逐格通勤真实性验证。来源:原论文 Fig. 3。
边界选择还有实际后果:居住在城外、进城上班的人可能不在矩阵里;同一城市若换成更广的功能区边界,也会改变“城内”的含义。缺失的边界外联系不能靠把矩阵内部流量加总来补回来。
住宅区与工作区的差别,模型从哪里学?
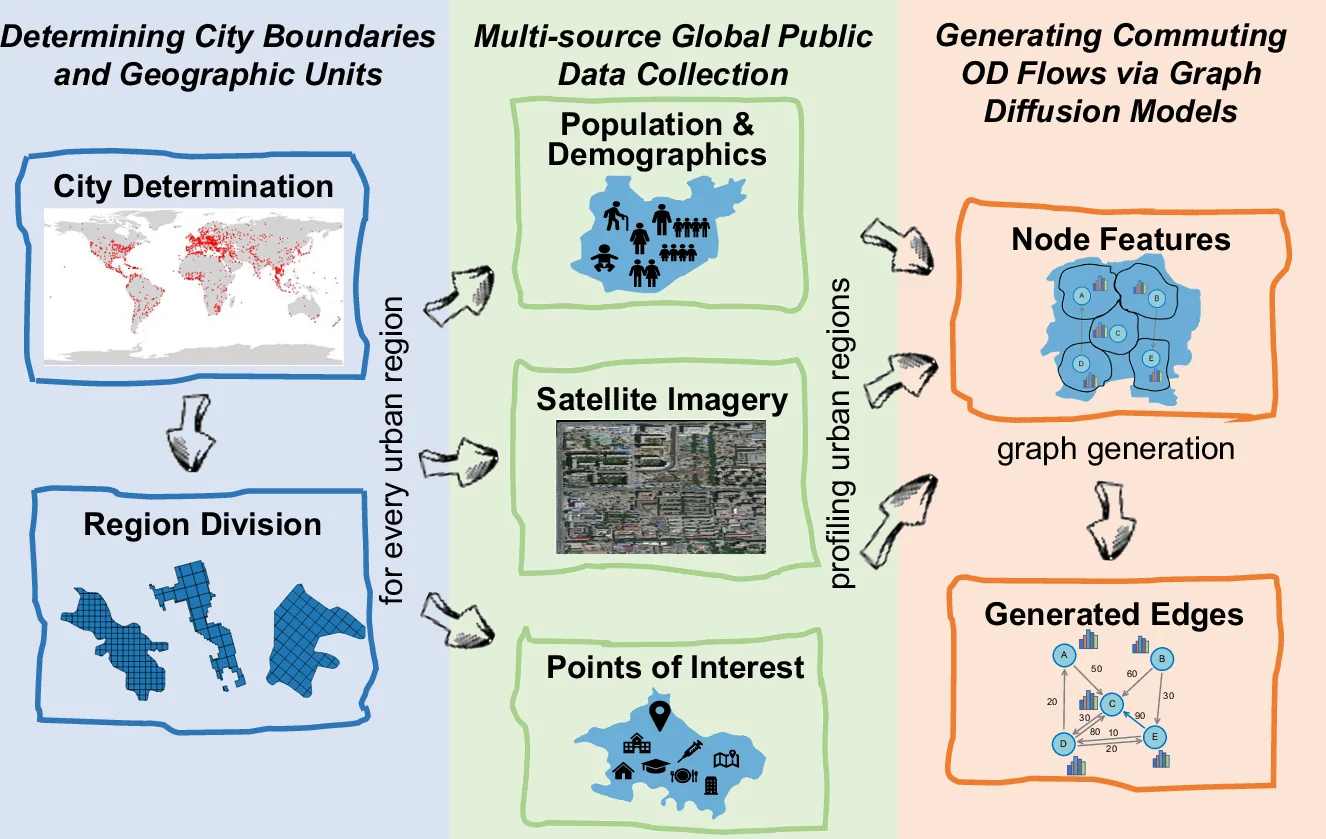
图 1|从城市外观到通勤联系,中间经过什么?
整图无字母面板,左侧确定边界与分区,中间用人口和人口结构、卫星影像、POI描述每个区域,右侧将这些描述作为节点特征,生成带权有向边。箭头表示处理流程,不是个体出行轨迹。来源:原论文 Fig. 1。
每个区域用1,094维特征表示:36维人口及年龄性别结构、1,024维RemoteCLIP影像语义、34类POI计数。人口提供“哪里可能产生通勤者”的线索,建筑形态和设施则帮助区分住宅、商业、工业等功能。
输入日期并不一致:WorldPop采用2020年人口资料,OSM使用2024年1月版本,影像时间因地点而异。因此,结果没有一个可以精确对应所有输入的统一观测日,不能作为某一天实时通勤实况。
模型采用已有研究的WEDAN,而本文的主要贡献是把全球公共地理信息接到这一生成流程。区域作为节点,区域间通勤人数作为边权。训练时,把真实OD矩阵逐步加入噪声,学习在给定区域特征和距离信息时去掉噪声;生成新城时,从随机噪声逐步还原出符合所学规律的矩阵。
补充模型说明进一步交代:边权先做log(1+流量)变换;图Transformer联合更新节点与边,并用区域间距离和位置编码辅助去噪。这样做能兼顾少量大流量与大量小流量,但并不保证每条生成的边都是真实存在的联系。
拿到文件后,哪一个“零”最不能直接相信?
每座城市提供分区Shapefile与NumPy矩阵。行是居住地,列是工作地,索引应与分区标识严格对应,不能把网格的行列坐标误当成矩阵索引。雅典的数据结构示例有96个分区,对应96×96矩阵。
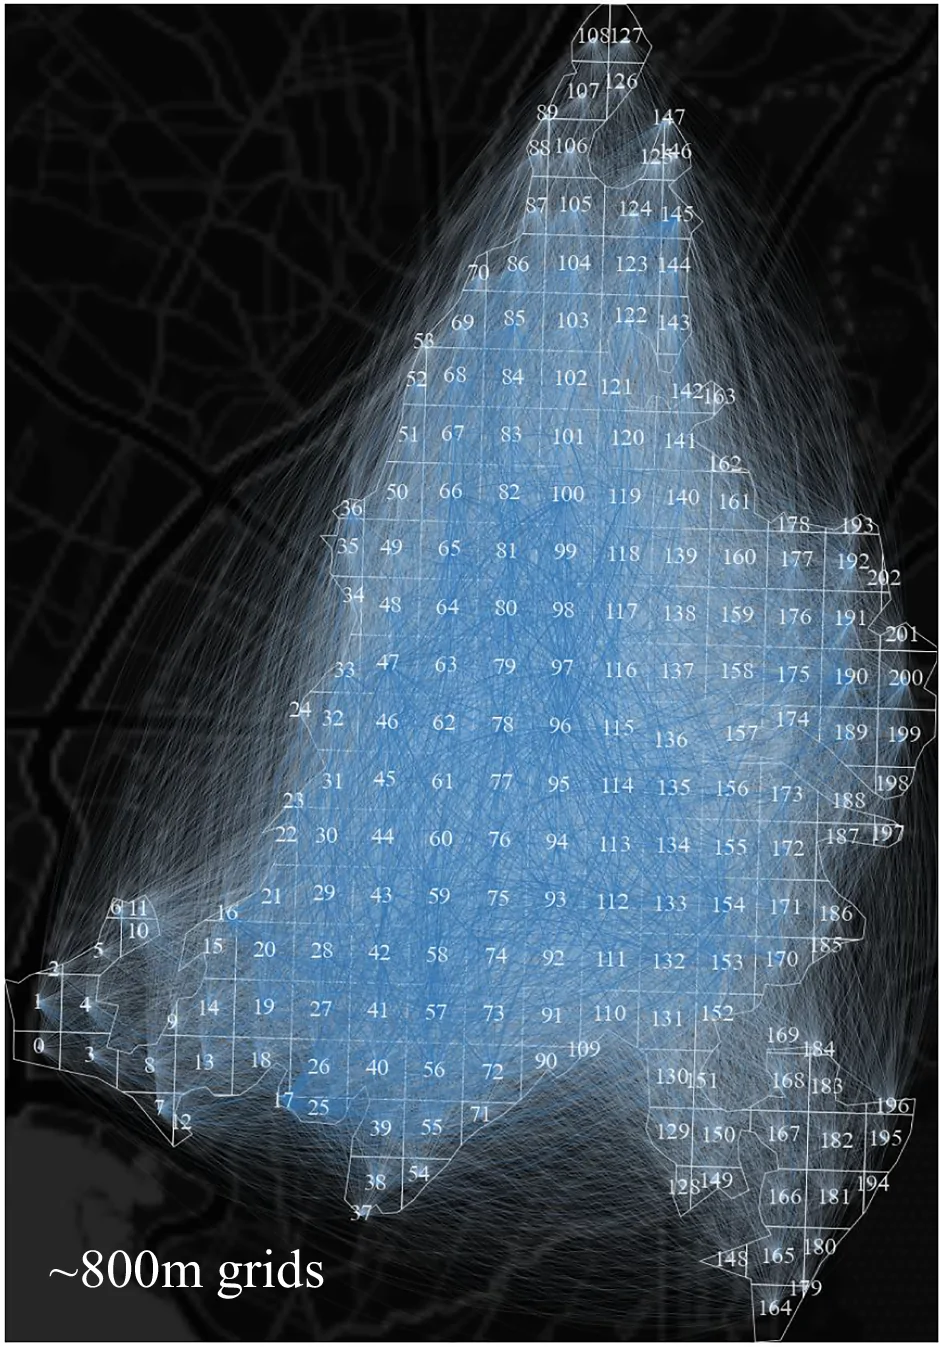
图 4|地图上的编号,怎样对应矩阵里的行列?
原图无字母面板,白色编号标记区域,蓝线示意区域联系,标注网格约800米。这里用于理解索引与空间的对应。论文总图注称其为雅典,但底图形态和超过200的编号与正文96区的雅典示例不一致,因此不据此断言雅典的具体空间格局。来源:原论文 Fig. 4。
最容易产生严重误用的是对角线。作者没有估计同一区内的通勤,在.npy中用0占位;这些值应按NA处理。若直接计算“本地就业比例”,就会错误地得到每个区域都没人就近工作;若汇总通勤总量,也会遗漏区内通勤。
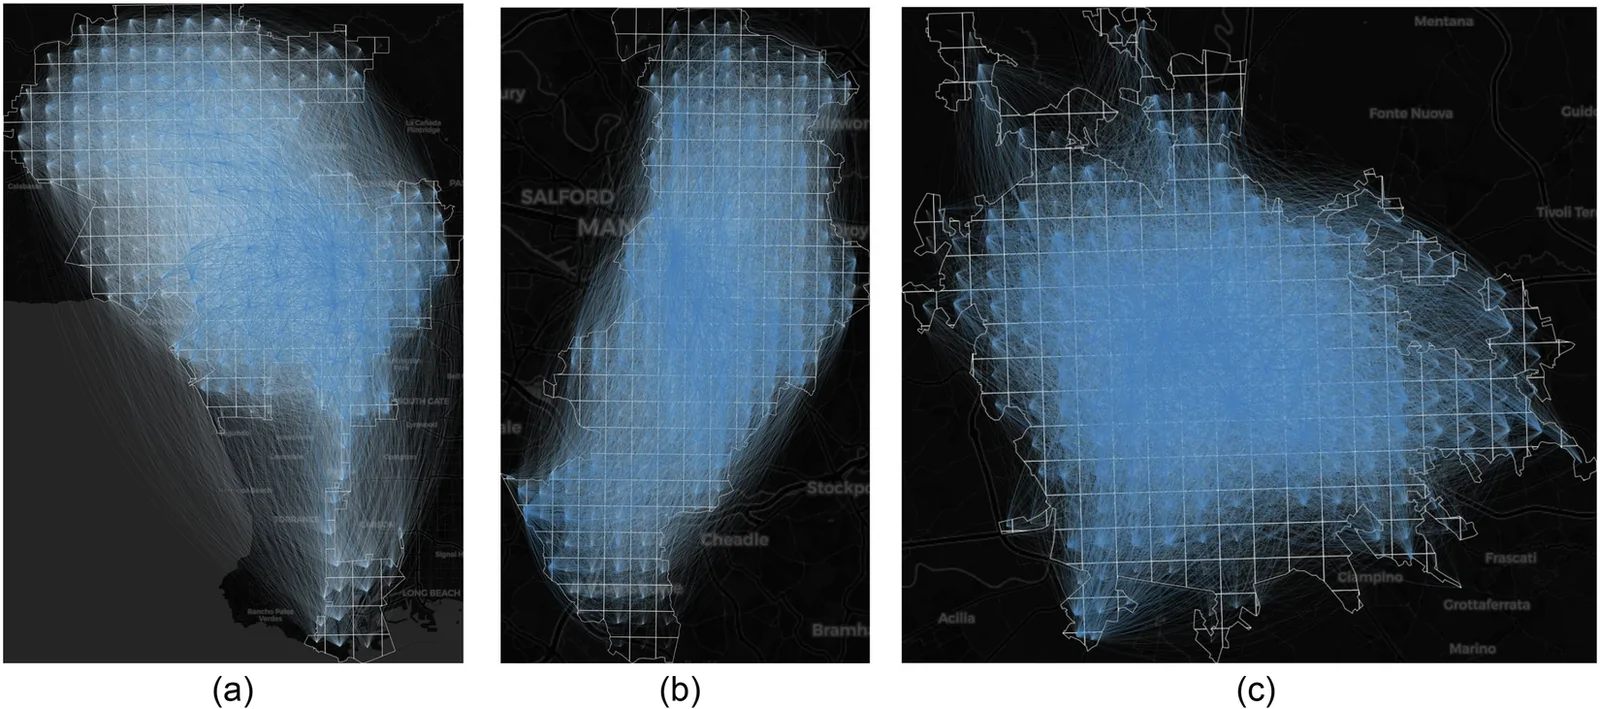
图 5|同一种模型,会把所有城市画成同一种形状吗?
(a)洛杉矶,(b)曼彻斯特,(c)罗马。蓝色联系分布体现各自分区和城市形态;这些线表示分区之间的OD关系,不是实际道路路径,也不能直接拿来判断某条路的拥堵。来源:原论文 Fig. 5。
没有全球真值,作者怎样检验生成结果?
最直接的一层是与手机位置数据比较。北京使用2019年位置服务数据,上海使用2016年移动网络访问记录,里约参照来自CDR聚合后构造的数据,塞内加尔使用D4D移动记录。来源、采样人群和年份都不同,不能把它们视作完全一致的普查金标准。
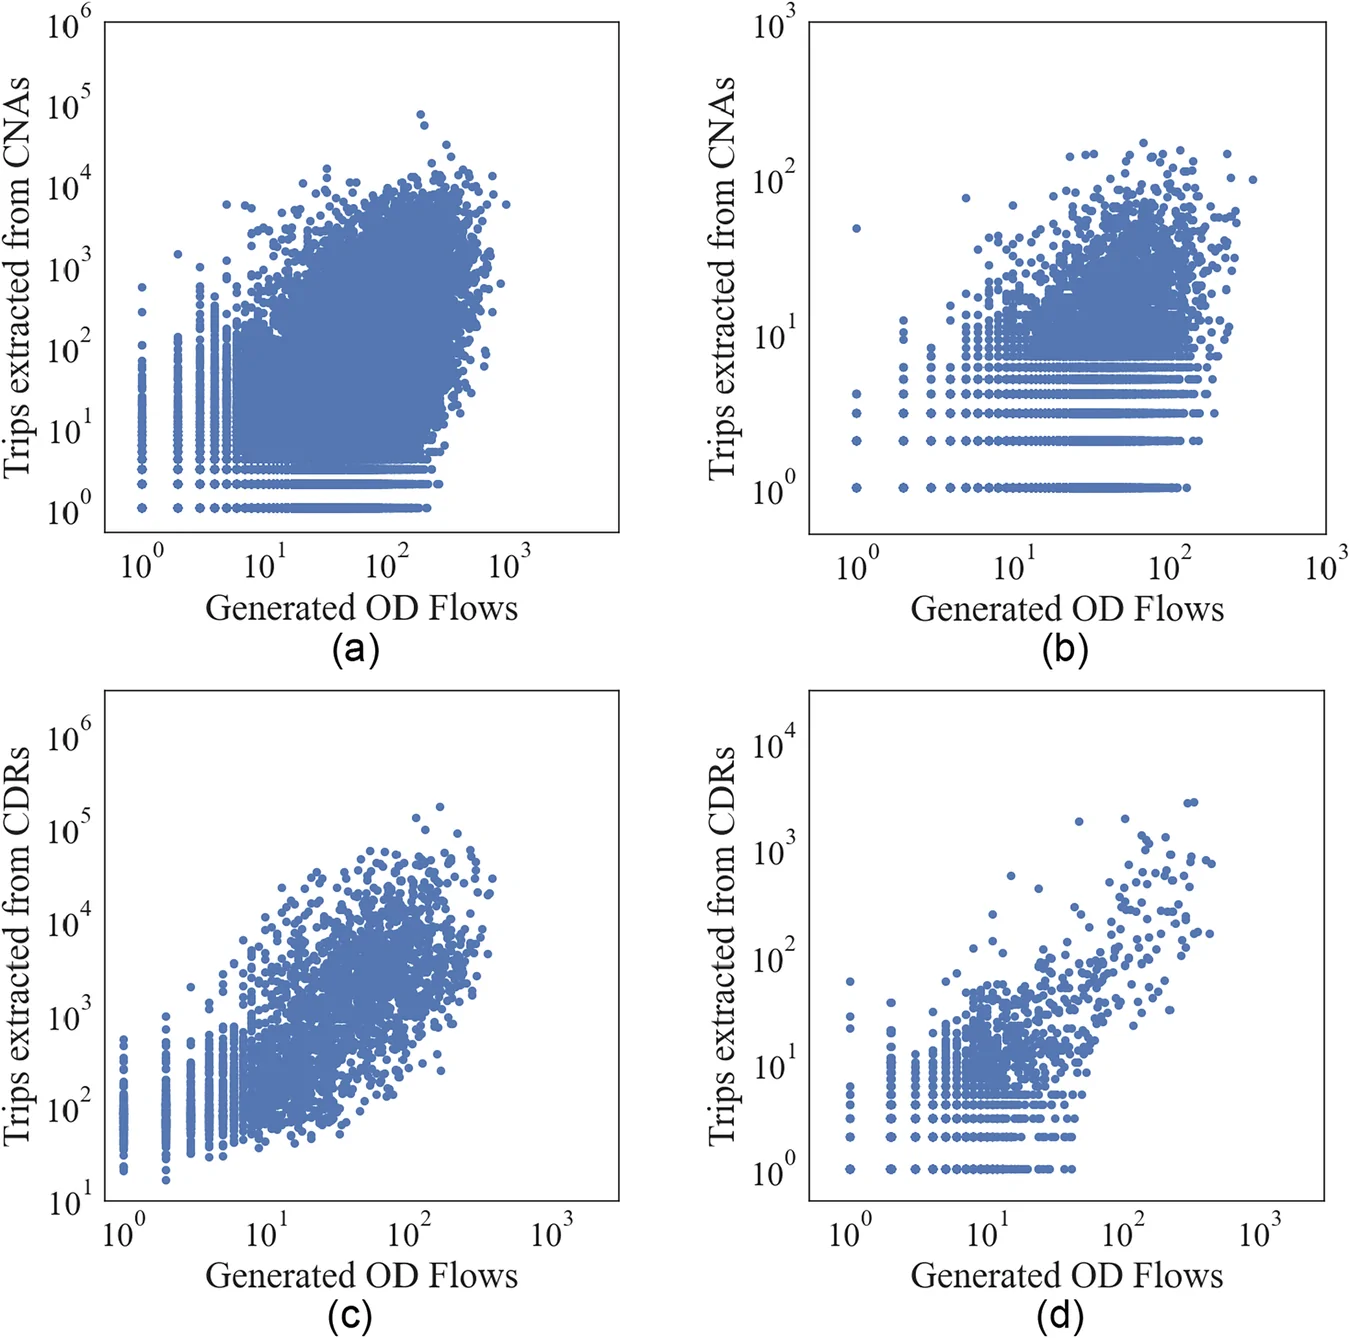
图 6|联系强弱的排序,是否接近独立数据?
(a)北京,(b)上海,(c)里约热内卢,(d)塞内加尔;横轴为生成流量,纵轴为手机数据提取的流量,两轴均用对数刻度。对应Spearman相关为0.741、0.641、0.816、0.477。相关考察排序一致性,不等于人数绝对值准确。来源:原论文 Fig. 6。
原文概述用较高的相关范围概括结果,细看四组完整数字更能看到异质性。塞内加尔较低的相关可能与手机覆盖、数据偏差或模型迁移误差有关,仅凭这一比较无法分离各自贡献。
作者还分别比较网络连边的Jaccard相似度,以及每个起点目的地比例向量的余弦相似度。它们回答“连了哪些地方”和“份额怎样分配”,与人数误差是不同问题,不能合并成一个笼统的百分之多少准确率。
更接近系统检验的是美国和英国通勤统计。美国包含3,333个县或都市区域,采用2018年数据;英国采用2021年LAD/MSOA资料。美国内部按8:1:1划分训练、验证和测试,另做美训英测、英训美测。
| 测试方式 | CPC越高越好 | RMSE越低越好 | NRMSE越低越好 |
|---|---|---|---|
| 美国内部留出地区 | 0.593 | 68.6 | 0.876 |
| 美国训练、英国测试 | 0.485 | 32.14 | 0.921 |
| 英国训练、美国测试 | 0.530 | 75.5 | 0.953 |
这些是正文同一组实验报告。CPC用两矩阵逐项较小值之和除以总流量规模,衡量流量重叠;RMSE受人数尺度影响,不能只比较不同国家的RMSE大小就判断谁更容易预测。英国2021年还处于疫情期,居家办公和限制措施使它与通常通勤状态有额外差异。
补充跨洲实验比较了重力、辐射、随机森林、DeepGravity、GMEL与NetGAN等方法,WEDAN的CPC为0.485,高于该表各基线的0.240—0.362。但附件采用326个LAD及另一训练划分,RMSE等也不同,不能与上表混用;而且基线主要用人口与距离,WEDAN获得更丰富输入,优势不能全部归因于网络架构。逐地区CSV另有324条记录,亦不应直接当作正文200个英国地区的同一汇总。
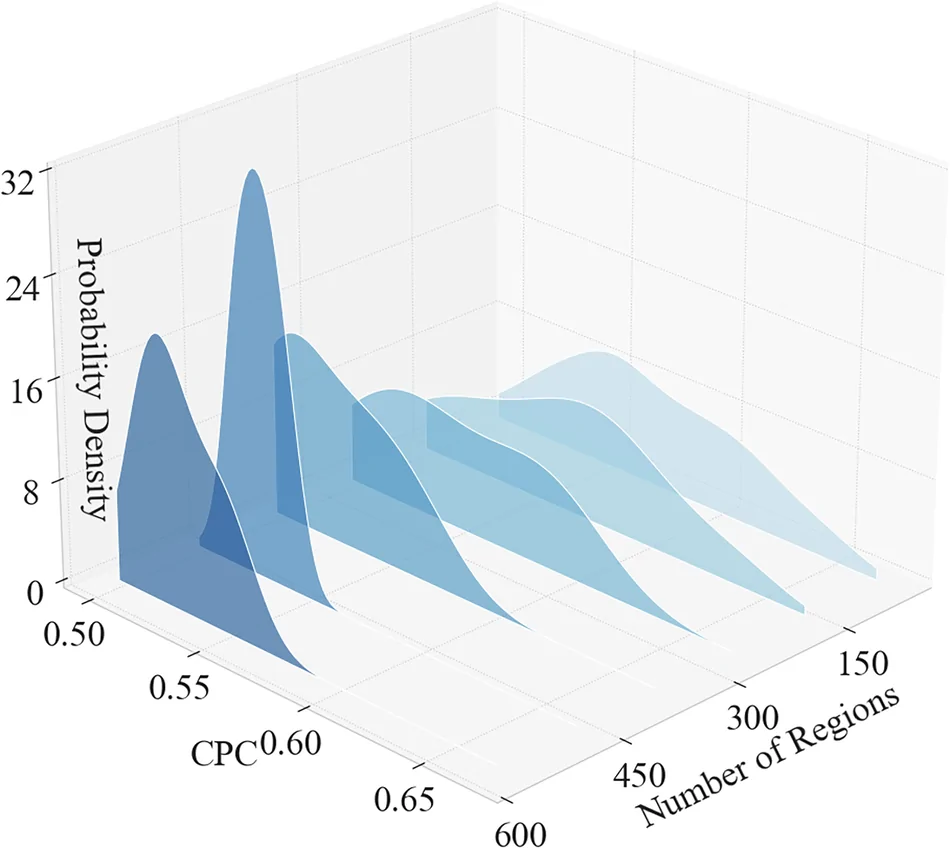
图 7|城市规模改变时,误差是否也改变?
整图无字母面板,横向两轴为分区数量与CPC,竖轴为概率密度。分区数较多的组趋向集中在约0.55附近,小规模组波动较大;这是测试集分布,不保证任意大城市都能达到相同质量。来源:原论文 Fig. 7。
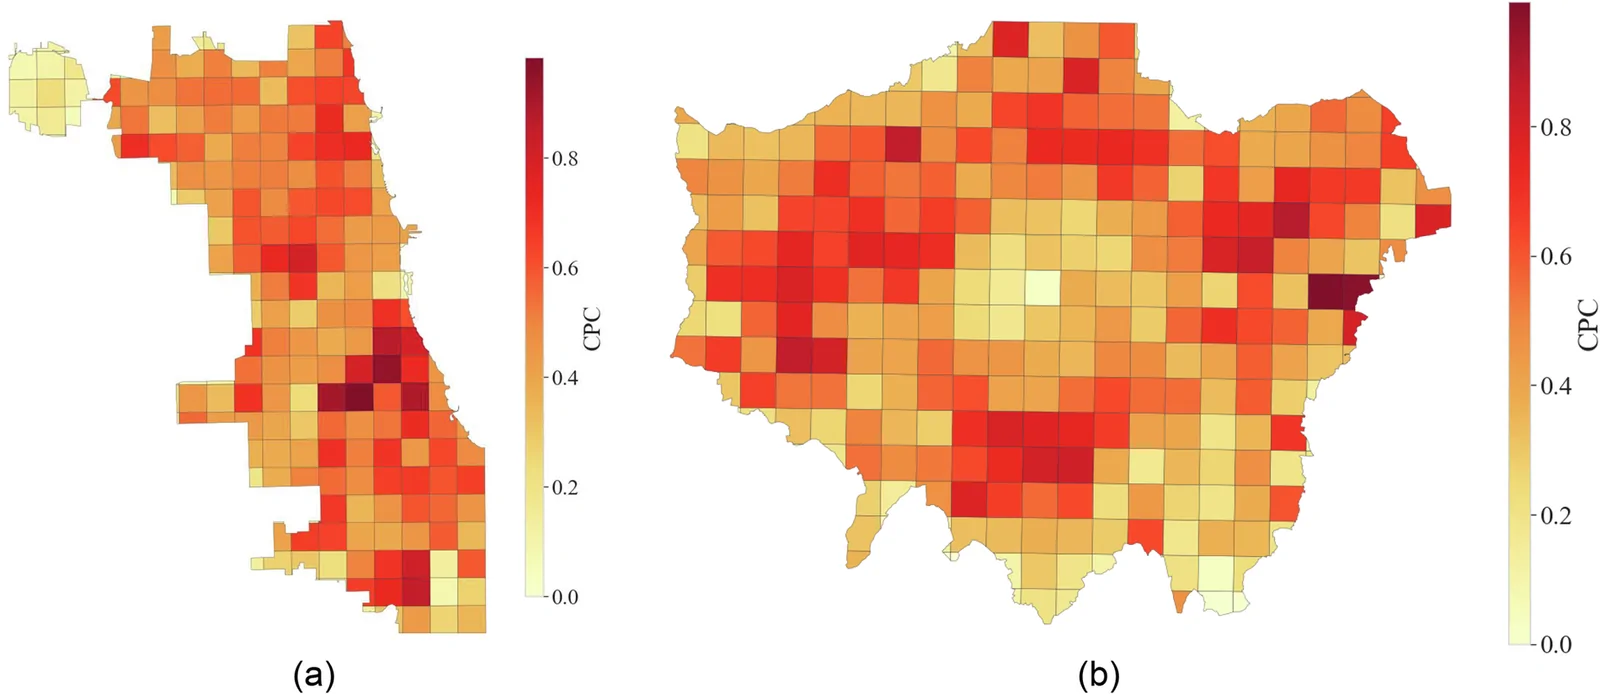
图 8|同一座城市,哪些区域更容易生成?
(a)芝加哥,(b)伦敦;色阶表示以某区域为起点、面向全部目的地计算的CPC,深色更高。它展示空间误差异质性,不能将一个全城平均值分配给每个街区。来源:原论文 Fig. 8。
看着相似的地图,究竟能证明多少?
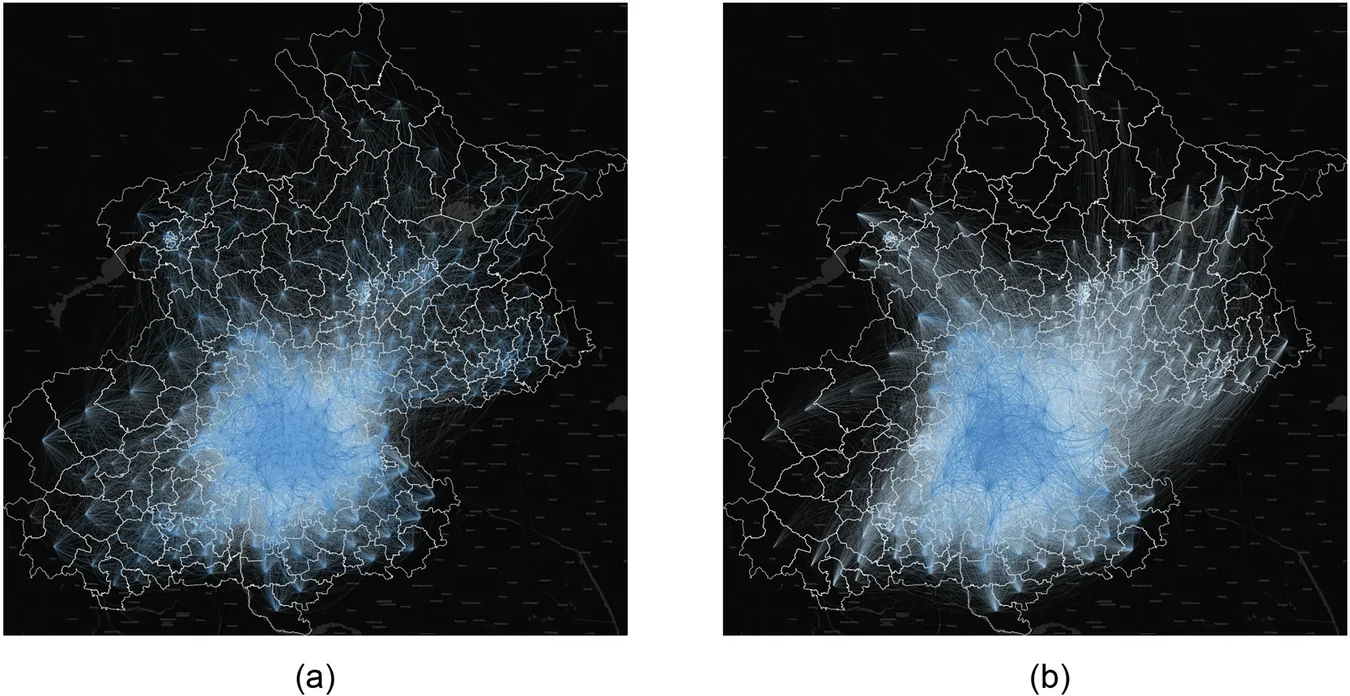
图 9|北京的主要联系是否落在相近位置?
(a)位置参照提取的联系,(b)生成联系。中心集聚与外围联系可作结构对照,但线条重叠和亮度受绘制方式影响,不能替代逐OD误差。来源:原论文 Fig. 9。
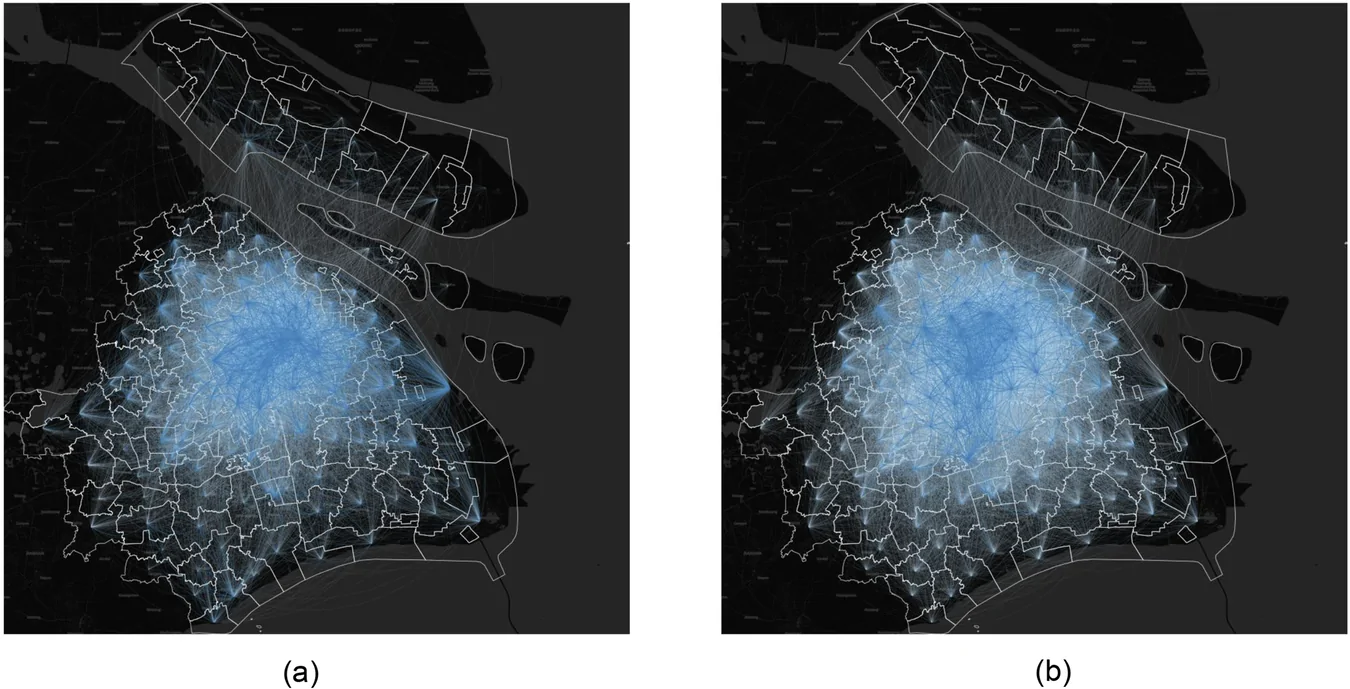
图 10|上海的空间结构能否迁移重现?
(a)手机网络参照,(b)生成通勤。两幅完整地图用于比较主要集聚和连接格局,不表示每条蓝线的通勤人数一致。来源:原论文 Fig. 10。
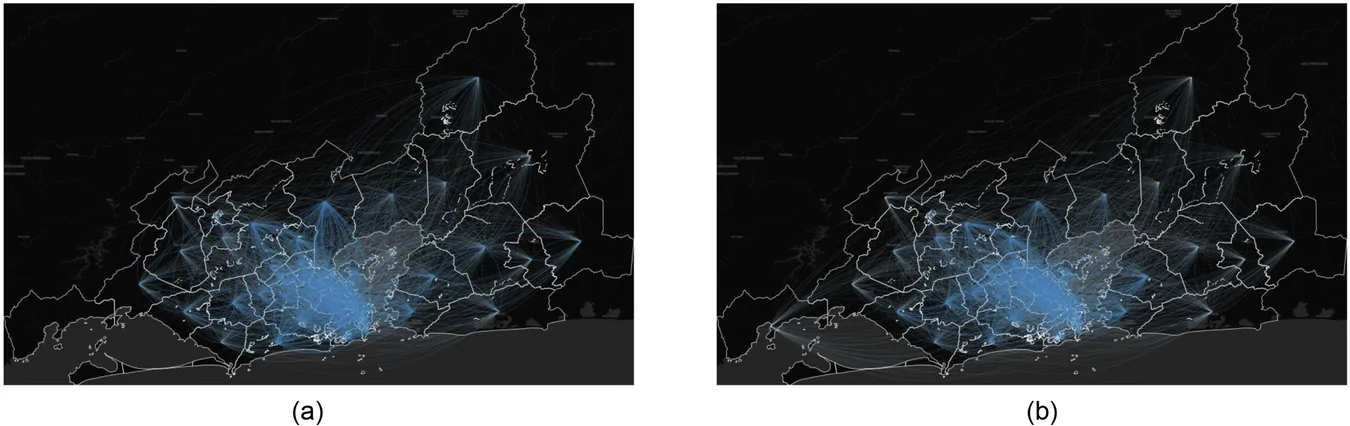
图 11|狭长沿海城市的形态会怎样进入结果?
(a)参照联系,(b)生成联系;里约的地形与城市轮廓限制了联系分布。参照自身来自经过处理的移动数据,不能据视觉相似直接认证真实个体路径。来源:原论文 Fig. 11。
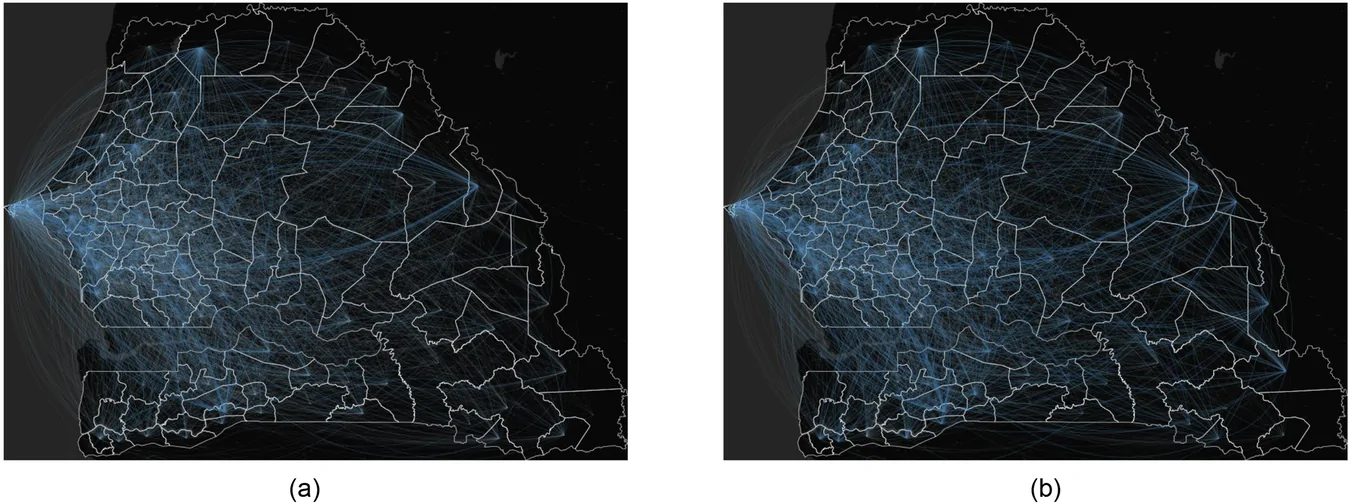
图 12|在手机参照较稀疏的地方,结构与人数能否分开看?
(a)移动记录提取的联系,(b)生成联系。主要集聚位置相近可以与流量排序相关较低同时成立;这也是应同时看多种指标的原因。来源:原论文 Fig. 12。
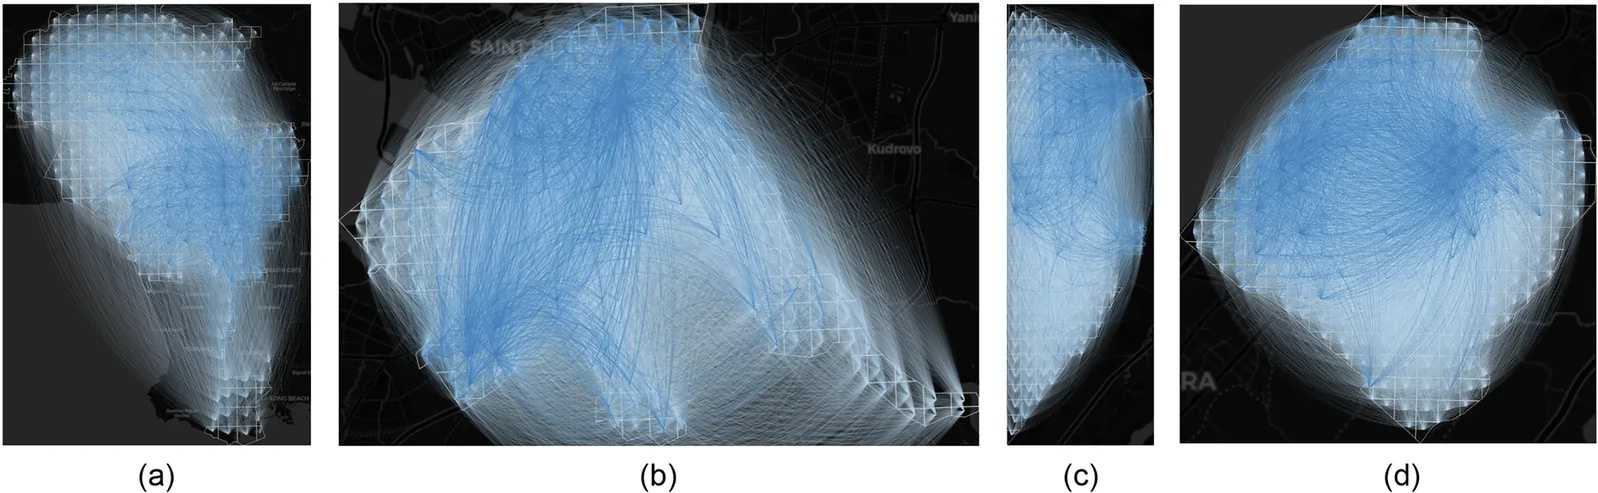
图 13|多中心结构会不会被模型抹平?
(a)洛杉矶,(b)圣彼得堡,(c)霍巴特,(d)拉巴特。不同中心和外围联系展示方法对多种形态的适应性;此图没有逐城独立真值对照,因此主要是结构展示。来源:原论文 Fig. 13。
如果把它用于白天人口、碳排放和韧性,会发生什么?
作者把夜间住宅人口与通勤转移相结合,预测工作时段人口,再与2024年9月9日百度人口热力图经缩放得到的参照比较。这比仅看通勤矩阵更接近实际用途,但它检验的是到达端汇总结果,不是每个起讫点都准确。
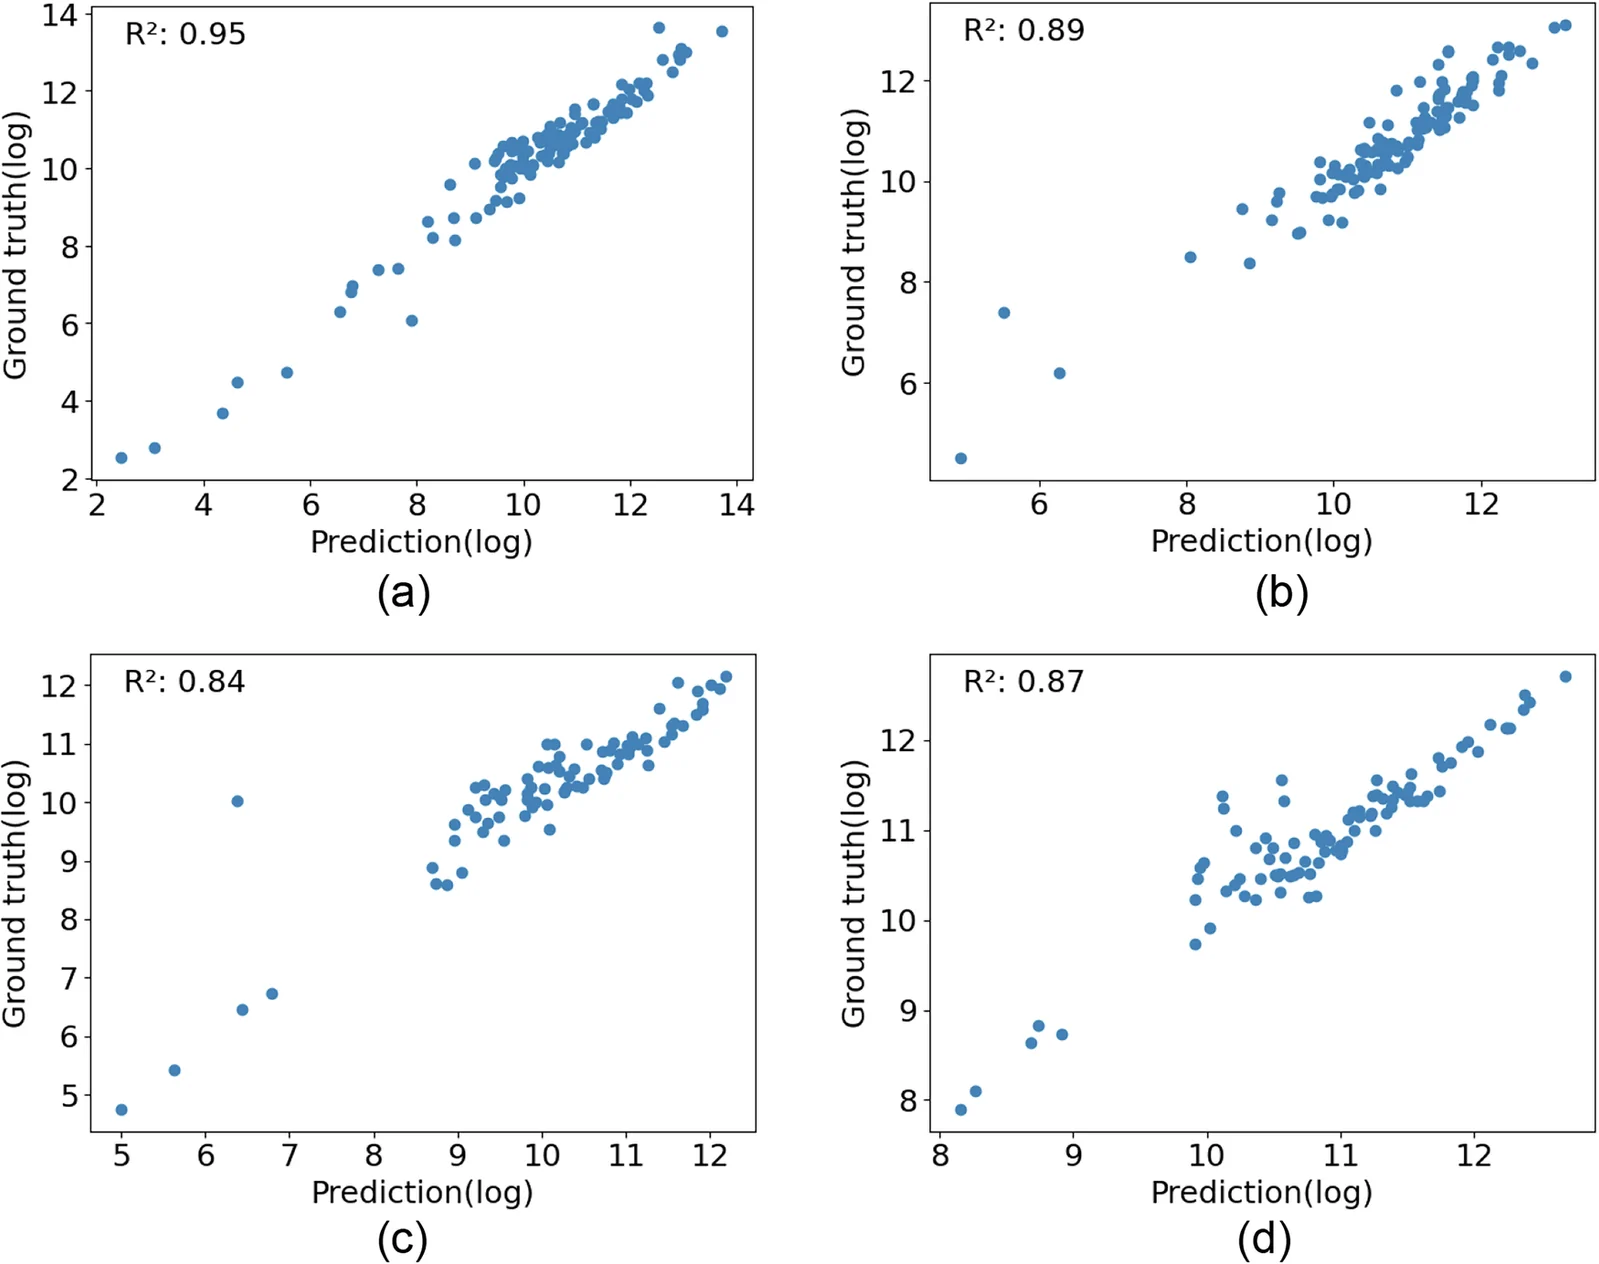
图 14|加入通勤后,白天的人口地图更接近参照吗?
(a)成都,(b)广州,(c)济南,(d)青岛。横轴预测、纵轴参照,均为对数;R²依次0.95、0.89、0.84、0.87,高于直接用夜间人口的0.71、0.66、0.63、0.65。热力图也依赖平台覆盖与缩放假设。来源:原论文 Fig. 14。
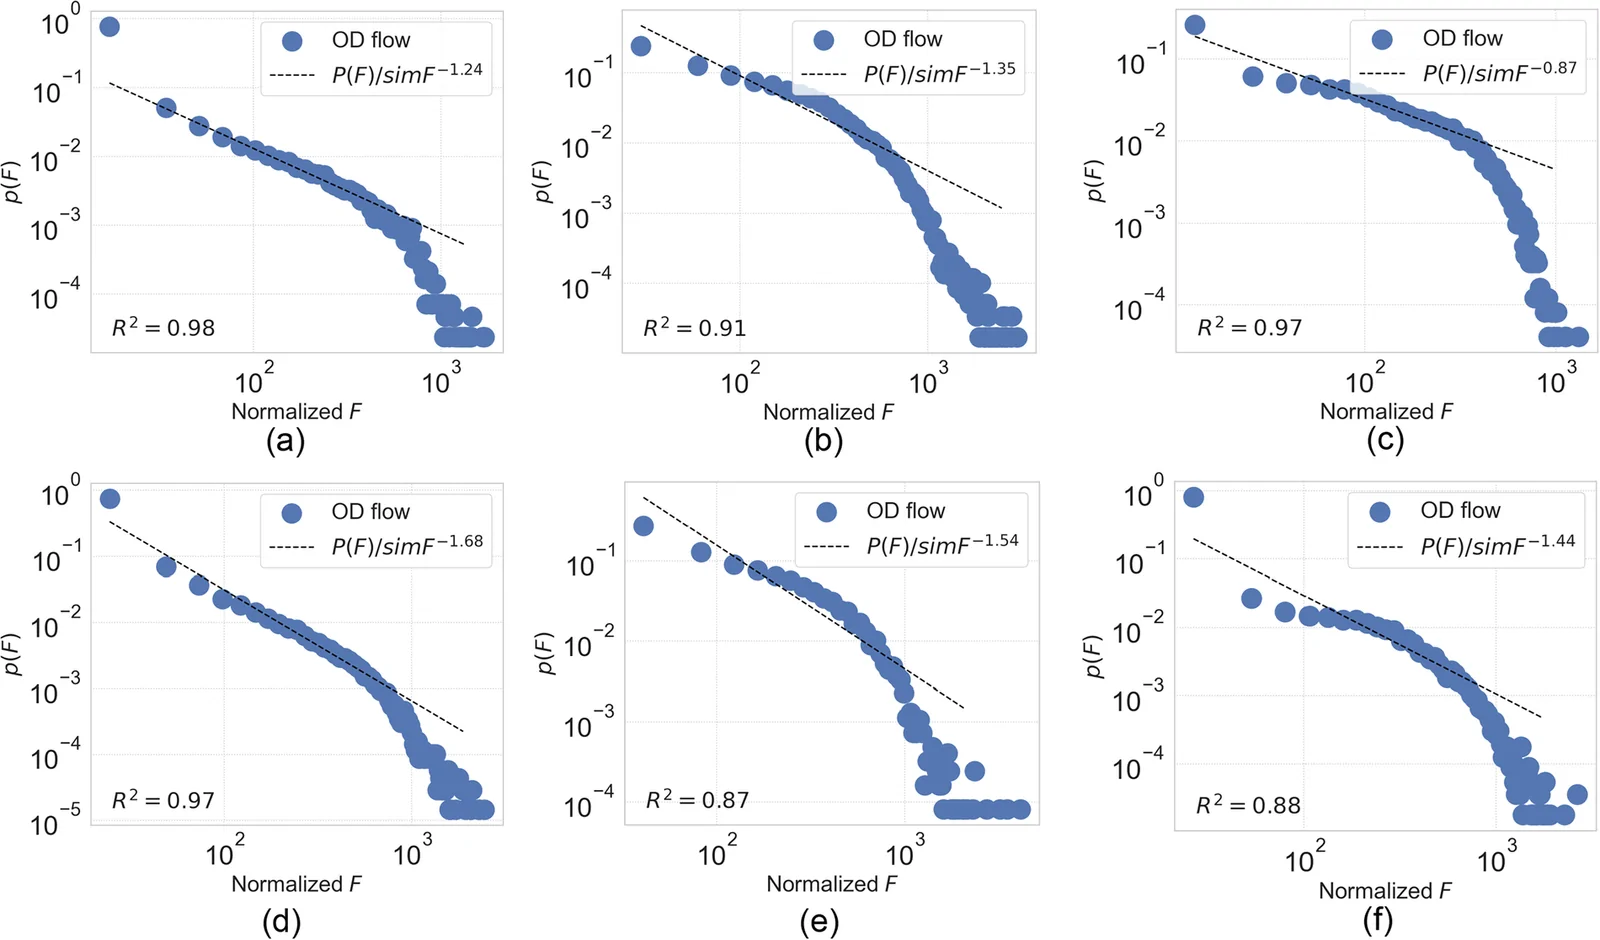
图 15|大多数联系弱、少数联系强,这种异质性保住了吗?
(a)成都,(b)广州,(c)青岛,(d)香港,(e)东京,(f)新加坡。图展示归一化流量与出现概率的双对数关系及拟合线。长尾形态与已知通勤特征相容,但线性拟合本身不足以严格证明普适幂律,也不能证明每条边的空间位置正确。来源:原论文 Fig. 15。
碳排放例子把通勤距离、城市绕行系数、方式份额和单位里程排放因子相乘。方式份额固定为私家车60%、公共交通35%、步行骑行5%,排放因子分别171、104、0克CO₂/公里。对出行方式差异很大的城市,这些共同假设本身就可能造成偏差。
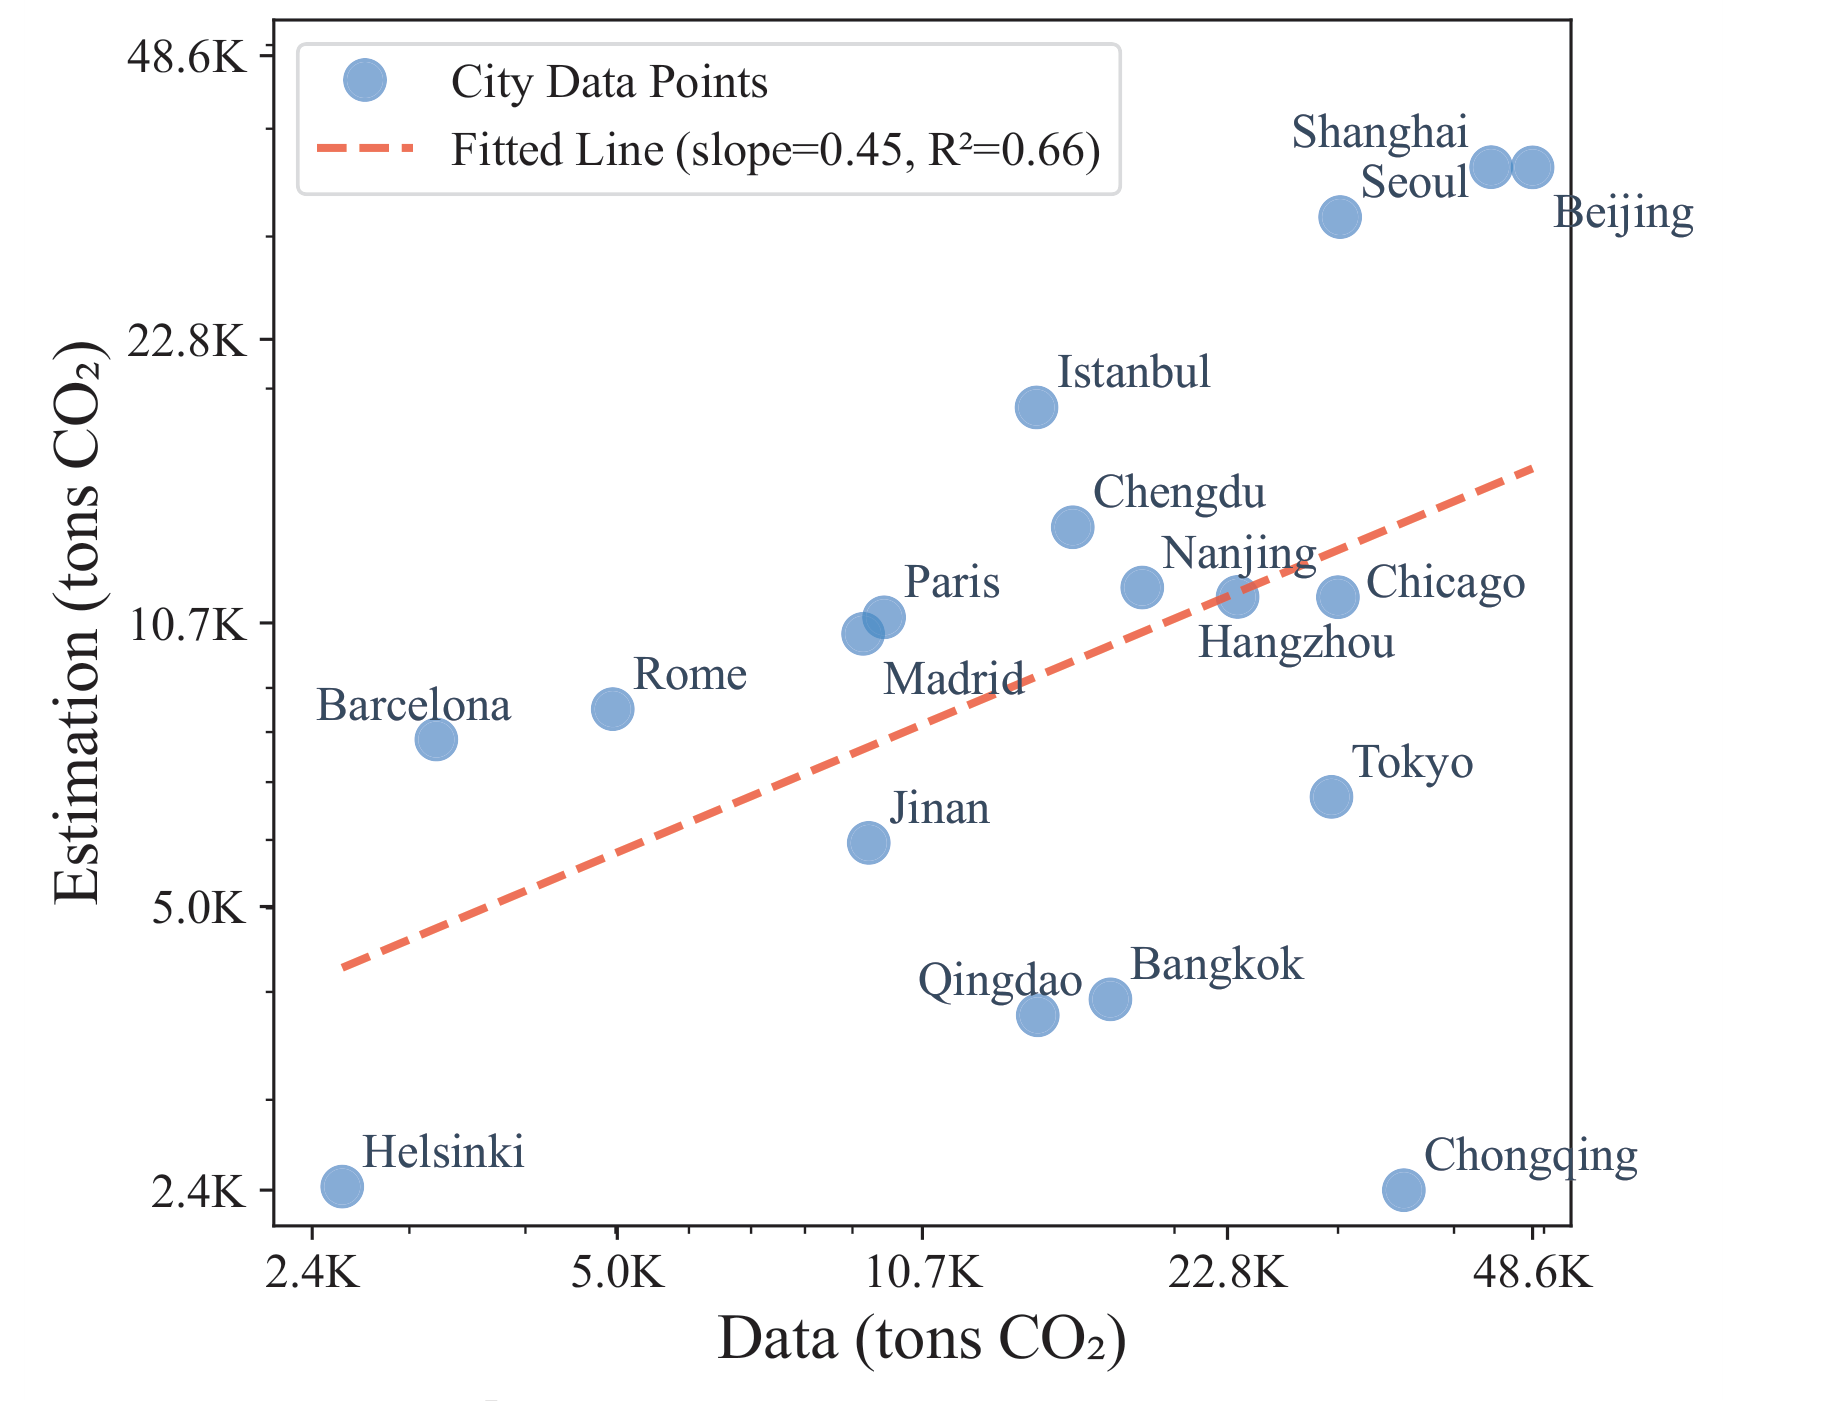
图 16|一张合成OD表,能否支持城市排放粗估?
整图无字母面板,横轴为Carbon Monitor Cities参照,纵轴为估计,单位吨CO₂;虚线为拟合线。图例标R²=0.66,正文称“相关系数0.66”,两种统计量表述不一致,此处不将它们互换。斜率约0.45且部分城市偏离明显,说明趋势相关不等于排放量无偏。来源:原论文 Fig. 16。
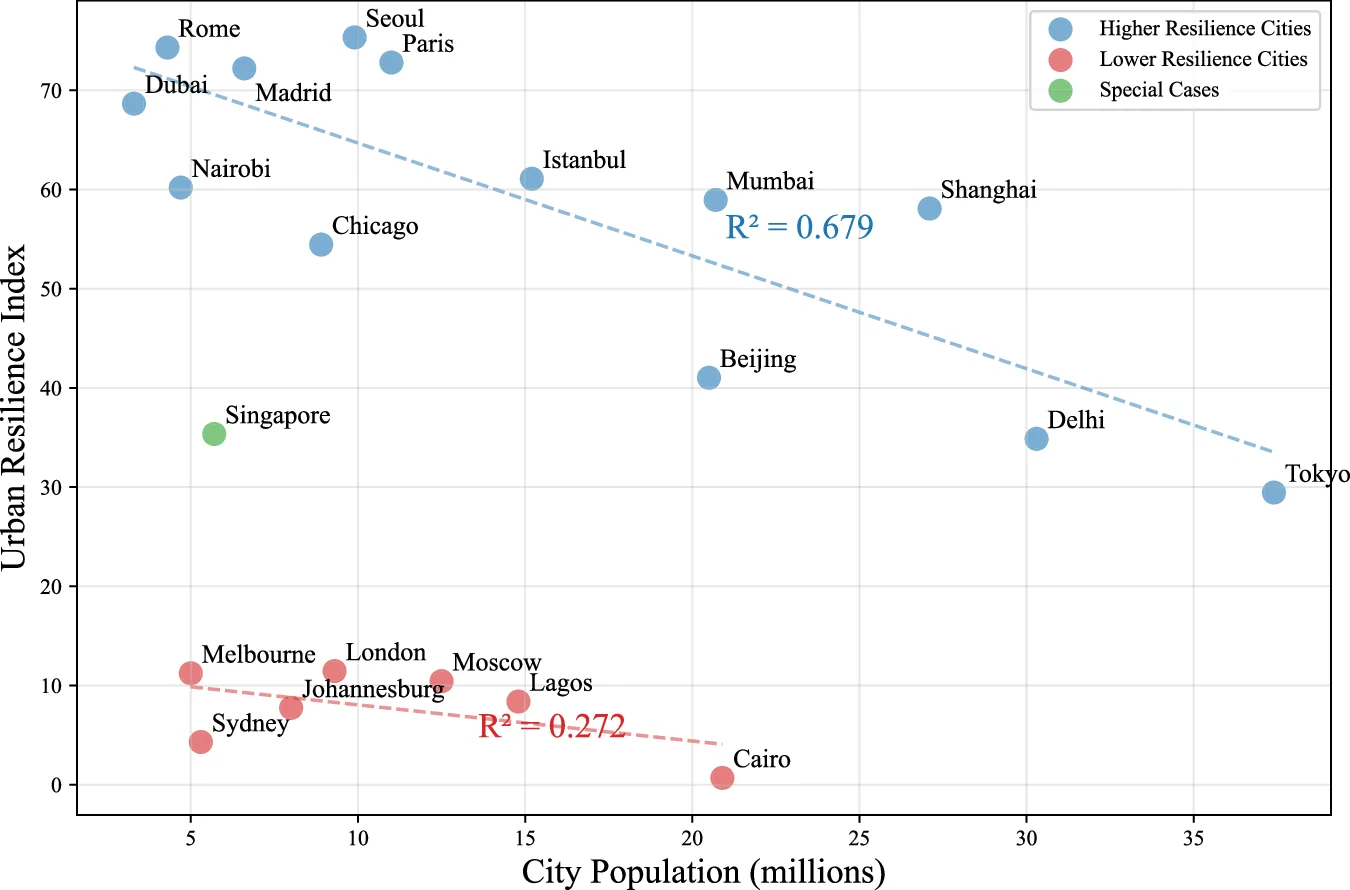
图 17|联系网络能否提供脆弱性筛查线索?
整图无字母面板,横轴城市人口(百万),纵轴为作者构建的韧性指标;蓝、橙两组由聚类划分,绿色为特殊情况。拟合R²约0.679与0.272。指标综合连通、节点失效、替代联系等模拟信息,不是城市经历灾害后实测的恢复能力,也不能据此证明人口增长导致韧性下降。来源:原论文 Fig. 17。
哪些输入最重要,哪些限制始终要带着走?
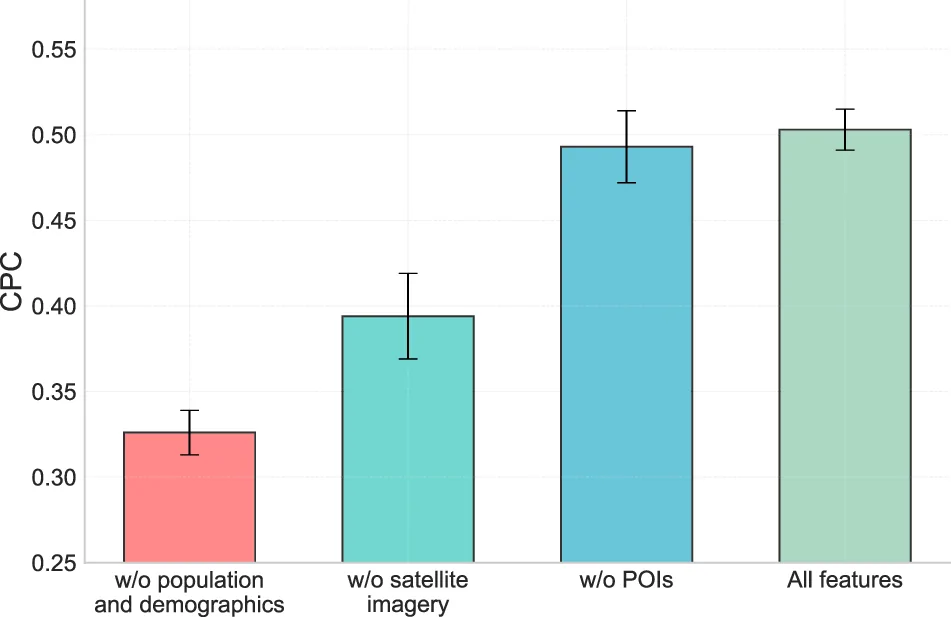
图 18|没有人口、影像或POI,模型会损失多少?
整图无字母面板,四根柱分别把人口结构、卫星影像、POI替换成随机噪声,以及保留全部特征。纵轴为英国测试CPC。人口信息损失最大,影像次之,POI影响较小;误差线未在该图注中明确界定,不能擅自称为置信区间。来源:原论文 Fig. 18。
这些结果支持将生成数据作为缺数据地区的初始估计,但还有几条边界:训练主要来自美国,系统定量验证集中在美英;低收入地区的道路、就业和手机覆盖结构可能不同。模型未明确给出每条流量的不确定区间,不能因为输出了精确小数就认为同样精确。
连续生成还会把真实零流量涂成很小正值,或漏掉真实的小联系;极大流量也可能被压低。因此,基于“是否大于零”的网络连通性分析、关键通勤走廊排序,都需要检查阈值敏感性。与实地公交刷卡、交通调查或雇佣地统计交叉验证后,才更适合支持具体资源分配。
数据和流程可从Figshare存档、项目仓库获得,另有区域生成界面。仓库旧简介仍写1,625城,本文采用正式论文的2,358城口径;复用时应记录下载版本、边界、分区尺度与输入年份。
一句话总结
全球公共地理信息能够生成有用的城内通勤结构,但它提供的是需按地区、尺度和用途检验的合成估计,不能替代所有真实出行调查。
核心来源
- Rong, C., Ding, J., Li, M. & Li, Y.(2026). A Global Intra-city Commuting Origin-Destination Flow Dataset for Urban Sustainable Development. Scientific Data 13, 1269。正式论文及三份补充材料。本文全部原图、实验与作者信息据此。
- Europe PMC开放原文镜像,用于核对正式版本与附件。
- 原图保持完整组合与原始面板,按原文CC BY-NC-ND 4.0非商业转载并署名;许可说明。
作者介绍
以下机构与分工据本文署名及作者贡献声明,不推断作者目前职称。
- Can Rong:清华大学电子工程系、北京信息科学与技术国家研究中心署名作者;编写数据采集处理、模型训练、生成与验证代码,参与论文写作。
- Jingtao Ding:同属清华大学电子工程系与该研究中心;参与研究构想、数据集流程设计及论文写作。
- Meng Li:清华大学土木工程系署名作者;提出生成数据验证策略,参与论文写作。
- Yong Li:清华大学电子工程系及该研究中心署名作者、通讯作者;参与研究构想、流程设计与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
对缺乏调查的城市,合成OD最有价值的一步,也许是帮助决定下一次去哪里调查。可以优先在模型反复生成仍不稳定、又影响公交或就业可达性结论的区域补采样,再用少量本地资料校准,形成生成与实测互相修正的循环。
另一个值得单独测试的问题是跨城比较的公平性。若一座城市用500米格网,另一座用5公里格网,后者更多通勤被压入未估计的对角线。比较平均通勤距离或网络韧性前,可将多个城市统一到一组共同尺度,检验排序是否稳定;若排序随分区剧烈变化,结论应先归于尺度,而不是城市治理水平。