地图上不只有楼的轮廓,还能知道它多高、多旧、做什么吗?
论文名片|Yecheng Zhang、Huimin Zhao、Ying Long,CMAB: A Multi-Attribute Building Dataset of China,Scientific Data 12,430(2025)。原论文 · DOI:10.1038/s41597-025-04730-5。
如果要评估一片街区的更新需求,只有建筑轮廓还不够。同样大小的一块屋顶,下面可能是低层厂房,也可能是住宅;外墙破损、建成年代和实际功能,又会影响完全不同的规划判断。过去这些信息分散在地图、街景、房产资料和遥感影像里,很难一栋栋连起来。
CMAB尝试把这些来源汇成建筑实例层面的多属性产品。重要的变化是每个建筑多了几列可分析的属性;同样重要的边界是,这几列来自不同模型、年份和代理测量,并不具有相同的准确性。
先说结论
- 数据在3,667个空间城市范围内识别约3,100万栋建筑,屋顶面积约236亿平方米。这里的空间城市是识别出的城市实体区域,并非3,667个行政市,也不等于完整覆盖全国乡村建筑。
- 屋顶分割的验证F1为89.93%,高度按行政类型分组建模,分组RMSE约5.3—7.9米;这些属于不同任务的评价,不能合并成一个全属性准确率。
- 功能识别对住宅较好,对商业与公共服务较弱;街景人工审查中,功能分类一致率为88%。模型赋给整栋建筑的主要功能,也无法表达所有底商、混合使用与楼层差异。
- 年代主要依据不透水面首次出现年份,质量主要依据附近街景里的外观问题。它们适合提出研究线索,不能直接替代竣工档案或建筑结构安全鉴定。
为什么先圈出城市实体,而不是对全国每一块地都跑模型?
研究采用面积超过2平方公里的3,667个空间城市边界,总面积95,670平方公里,约占全国陆地面积1%。这种边界依据连续城市实体划定,行政市却可能包含大片乡村和非建成区。限制识别范围可减少无关区域的计算,也更贴合街景、兴趣点等城市数据的集中分布。
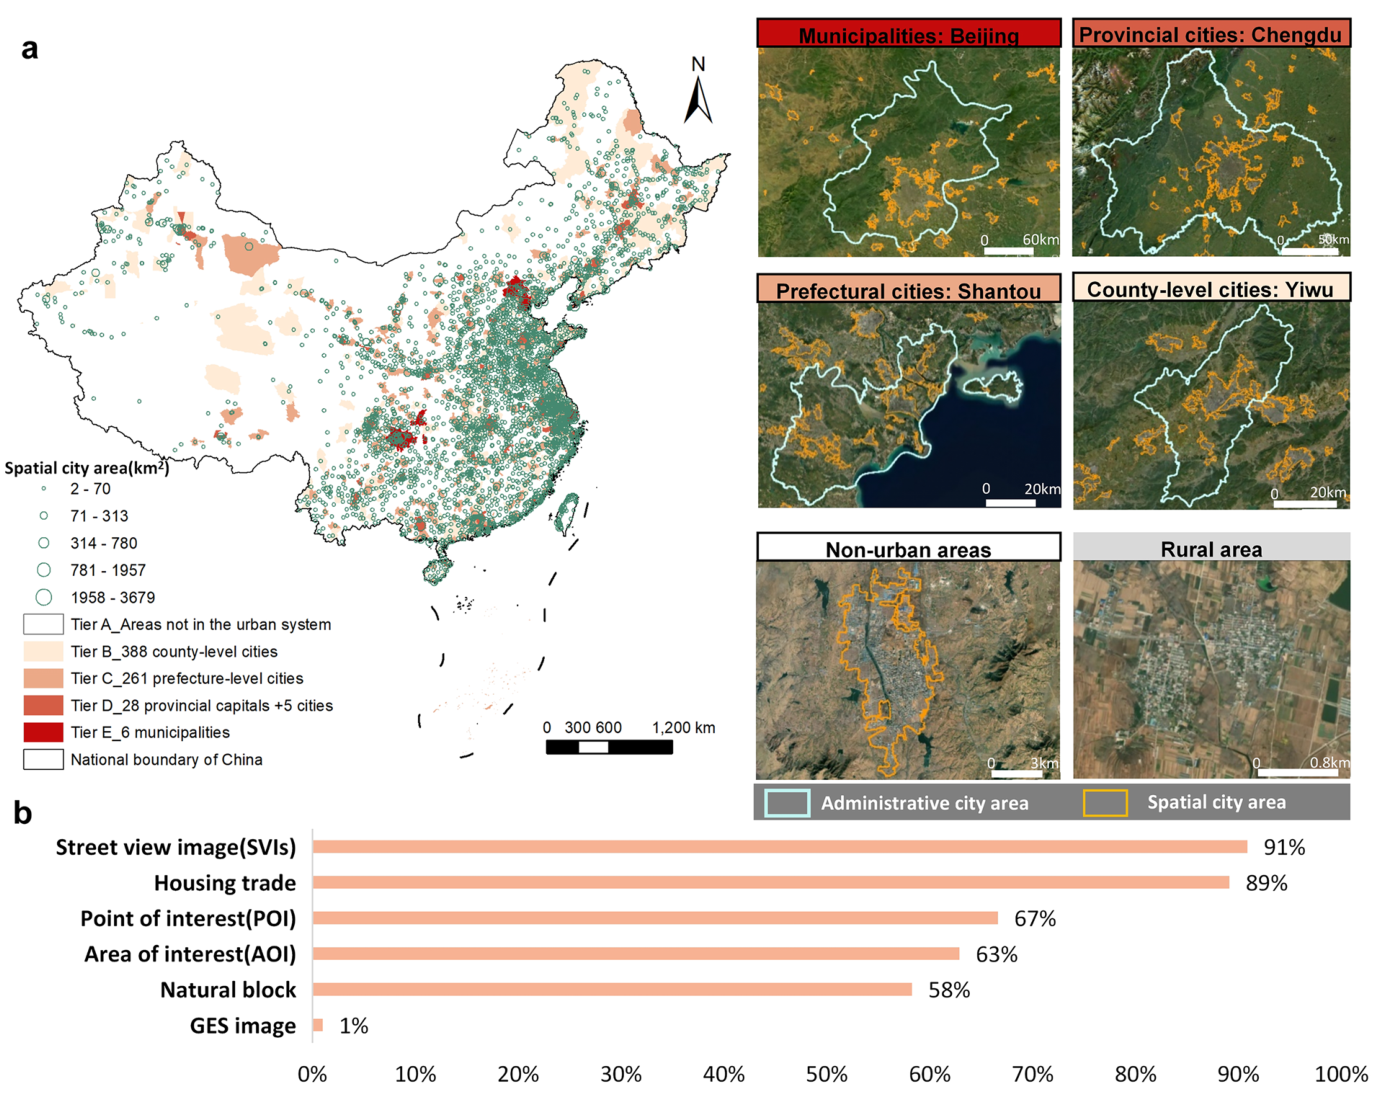
图 2|全国尺度的数据,具体覆盖到哪里?
(a)左侧为全国空间城市与行政等级分布,右侧案例对比行政边界和空间城市边界,包括北京、成都、汕头、义乌及非城市、乡村情形;(b)比较各源数据落在空间城市内的比例。街景约91%、房产资料约89%、POI约67%、AOI约63%、自然街区约58%,GES面积约1%。这些比例的分母各属不同数据源,不能都读成全国建筑覆盖率。来源:原论文 Fig. 2。
这项取舍提升了城市内部的数据可用性,也让未覆盖的乡村建筑成为重要边界。城市实体与数据覆盖一致,不能证明源数据偏差已经消失;高质量街景和地图记录通常仍更集中于可进入、较活跃的街道。
多源资料也并非来自同一年。遥感影像在2024年3月下载,各地选择较近且少云的版本;POI主要为2021年,AOI和地图建筑数据主要为2023年,街景跨2014—2023年,年代来源GAIA覆盖1985—2018年。下载日期不能替代影像拍摄日期。
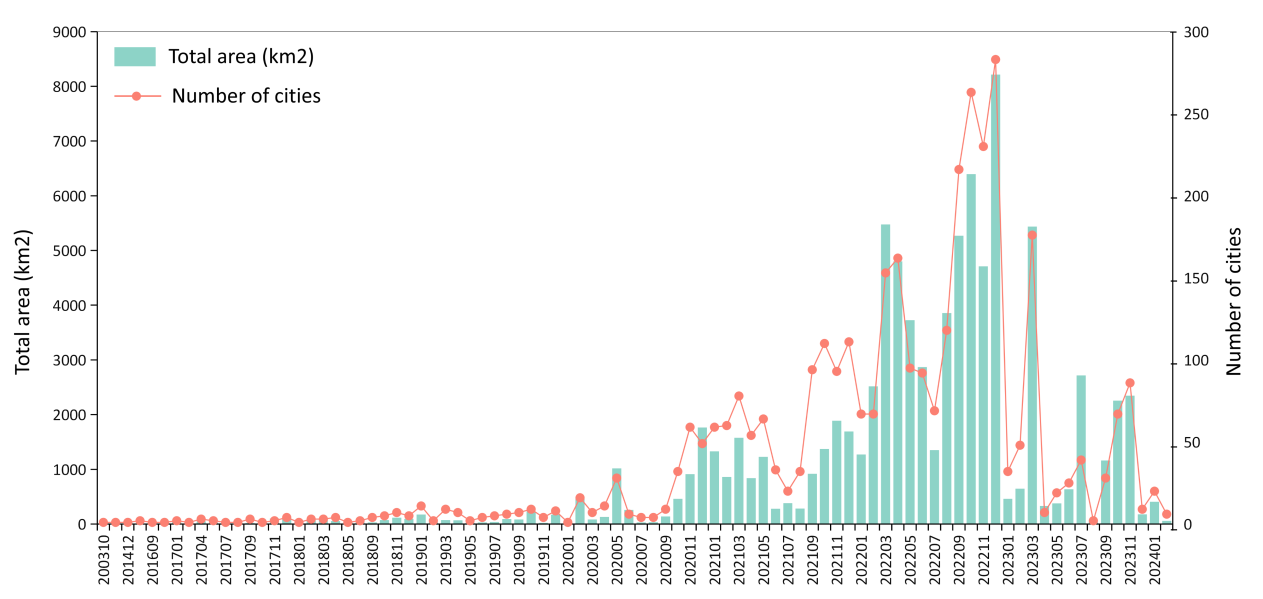
补图 S1|同一张全国建筑图,是否代表同一个观测时刻?
单幅图横轴为年月,柱形读取左轴的影像覆盖总面积,折线读取右轴的城市数量。近期年份较多,但仍有较早影像。论文报告约70%影像来自2022—2024年,这不等于其余属性也同步更新到2024年。来源:补充材料 Fig. S1。
每栋楼的几列属性,为什么需要不同的方法?
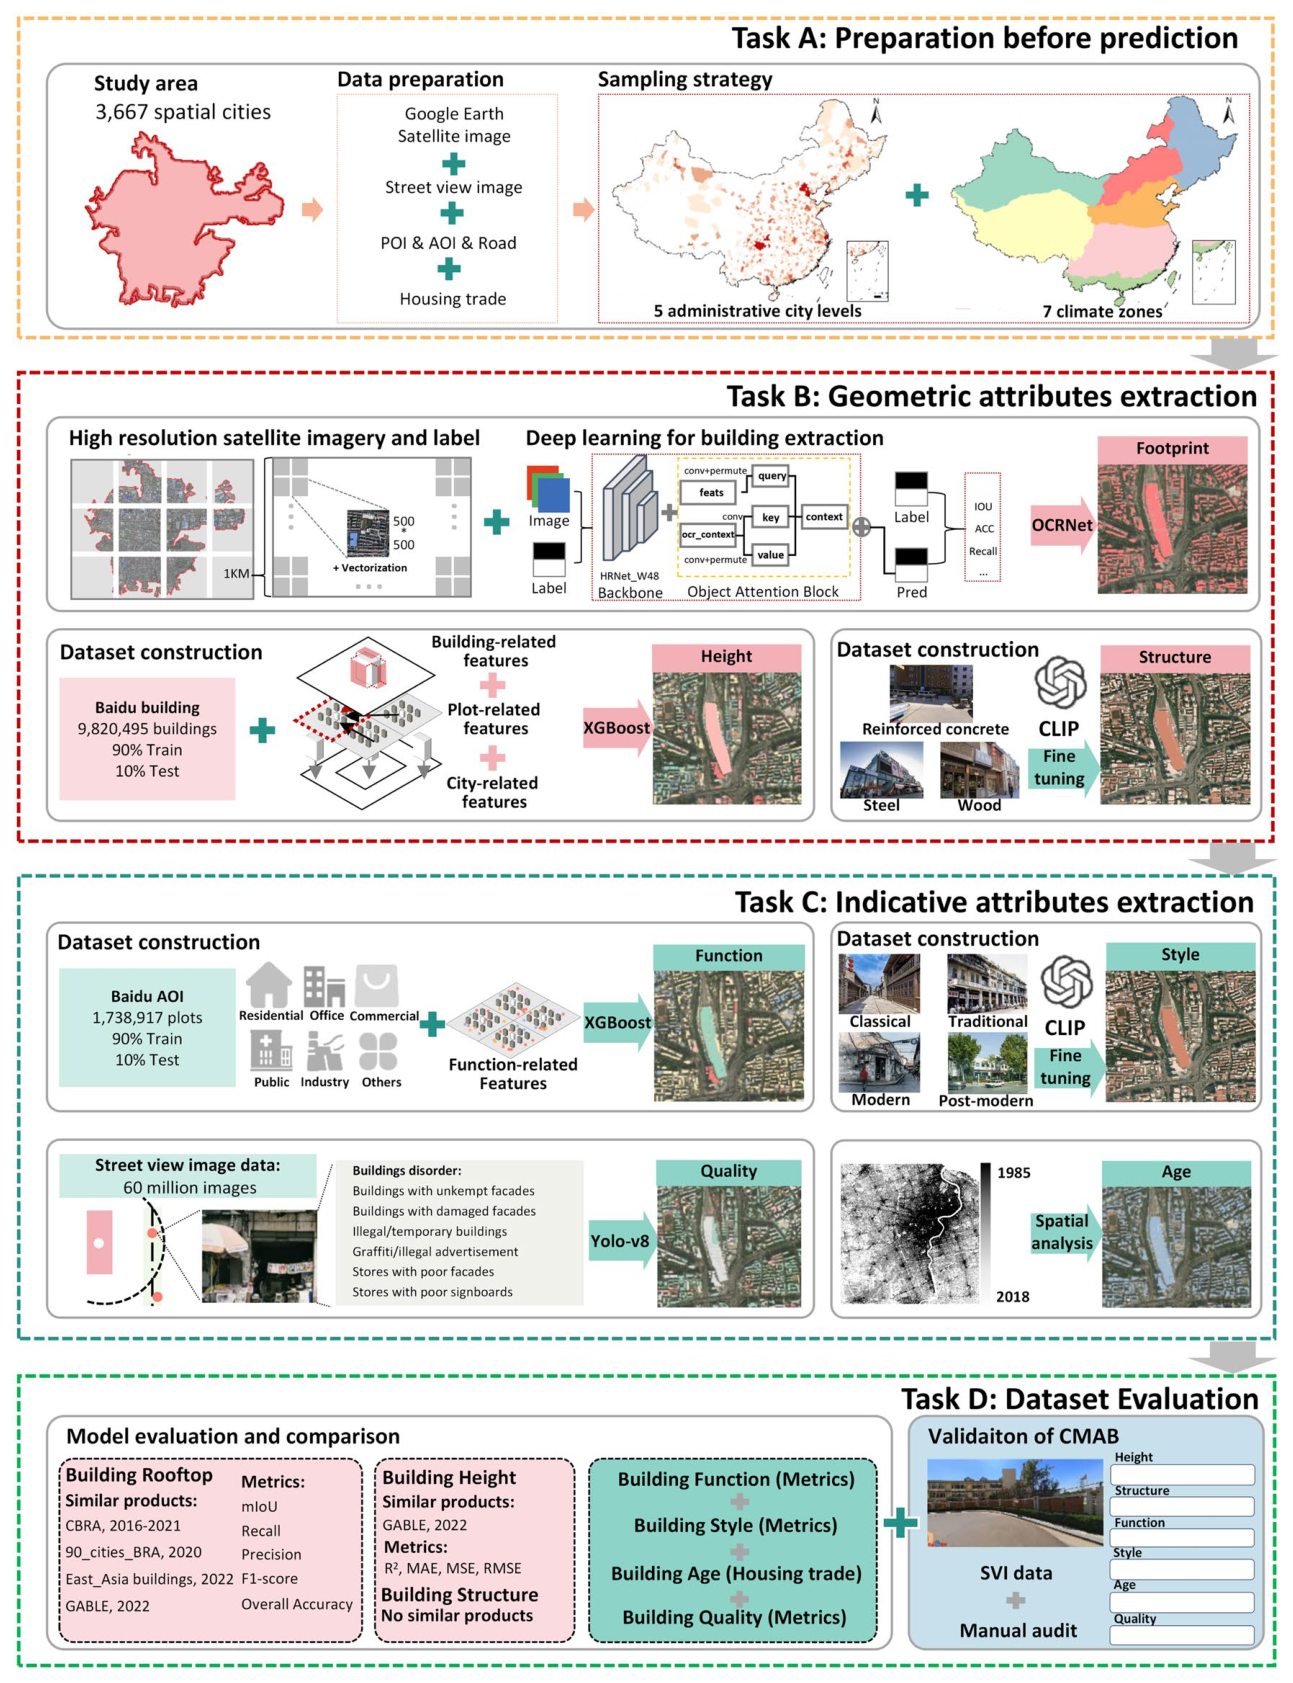
图 1|从多源影像到建筑属性,哪些环节连接在一起?
整张图保留Task A—D四部分:A准备研究边界、资料与抽样;B识别屋顶、估计高度并探索结构;C估计功能、风格、外观质量与年代;D通过模型指标、相关产品和街景人工审查验证。不同属性使用OCRNet、XGBoost、YOLOv8或多模态模型,不是一个模型同时直接看见全部真实属性。来源:原论文 Fig. 1。
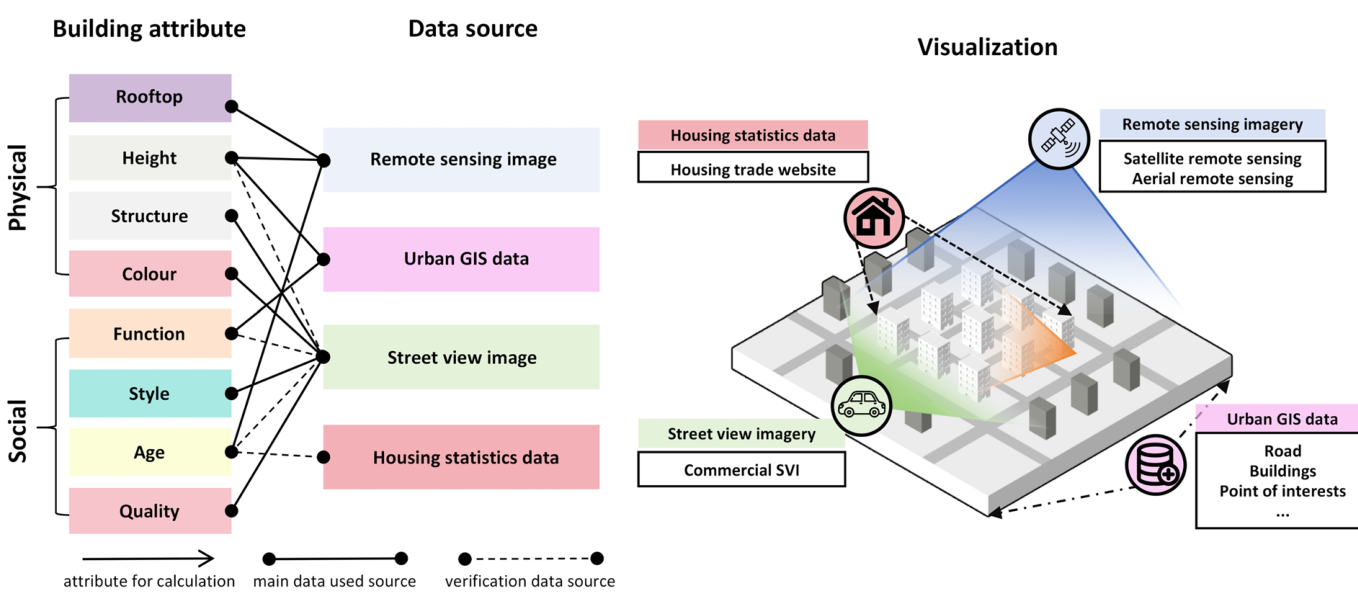
图 3|一项属性的依据来自天上、街上,还是已有统计?
原图无字母。左侧列出屋顶、高度、结构、颜色、功能、风格、年代与质量,实线、虚线区分主要计算与验证来源;右侧示意遥感、街景、城市GIS及房产资料的视角。图中的属性清单是方法框架,不代表每个字段都在每栋建筑上同样完整。来源:原论文 Fig. 3。
表1比较已有建筑产品的覆盖、年份、方法和属性类型,表2列出本研究源数据。CMAB的特点是把几何与解释性属性连接起来。论文主体发布说明和补充表3可直接核对屋顶、高度、功能、年代与质量等字段;结构、风格则另有多模态模型实验,应与已经完整验证的几何产品分开理解。
先找到屋顶,再把一片片分割结果接起来
屋顶训练从BITC的7,260张切片、63,886栋标注建筑出发,额外加入不同气候区与高密度街区,最终为8,760张切片、114,783栋建筑,其中6,973张训练、1,787张验证。补图S2展示气候区与城市抽样、不同密度标注和建筑样式,目的是减少只学会少数大城市屋顶的风险。
OCRNet把0.3米级影像分成屋顶与背景,再用Douglas–Peucker方法矢量化。切片边界可能把同一栋建筑断开,因此后处理使用缓冲、合并和收缩修补。这样改善拼接,也会影响相邻对象是否被合成一栋;数据库中的实例数因分割规则而变,不宜直接当作官方楼栋登记数。
屋顶验证集包含23,415个手工标注屋顶。正文报告像素分类Accuracy为91.59%、平均交并比mIoU为81.95%、F1为89.93%;表3显示补充标注前后的对照。F1平衡查准率与召回率,不是每栋楼有89.93%的概率完全正确,更不是其他属性的精度。
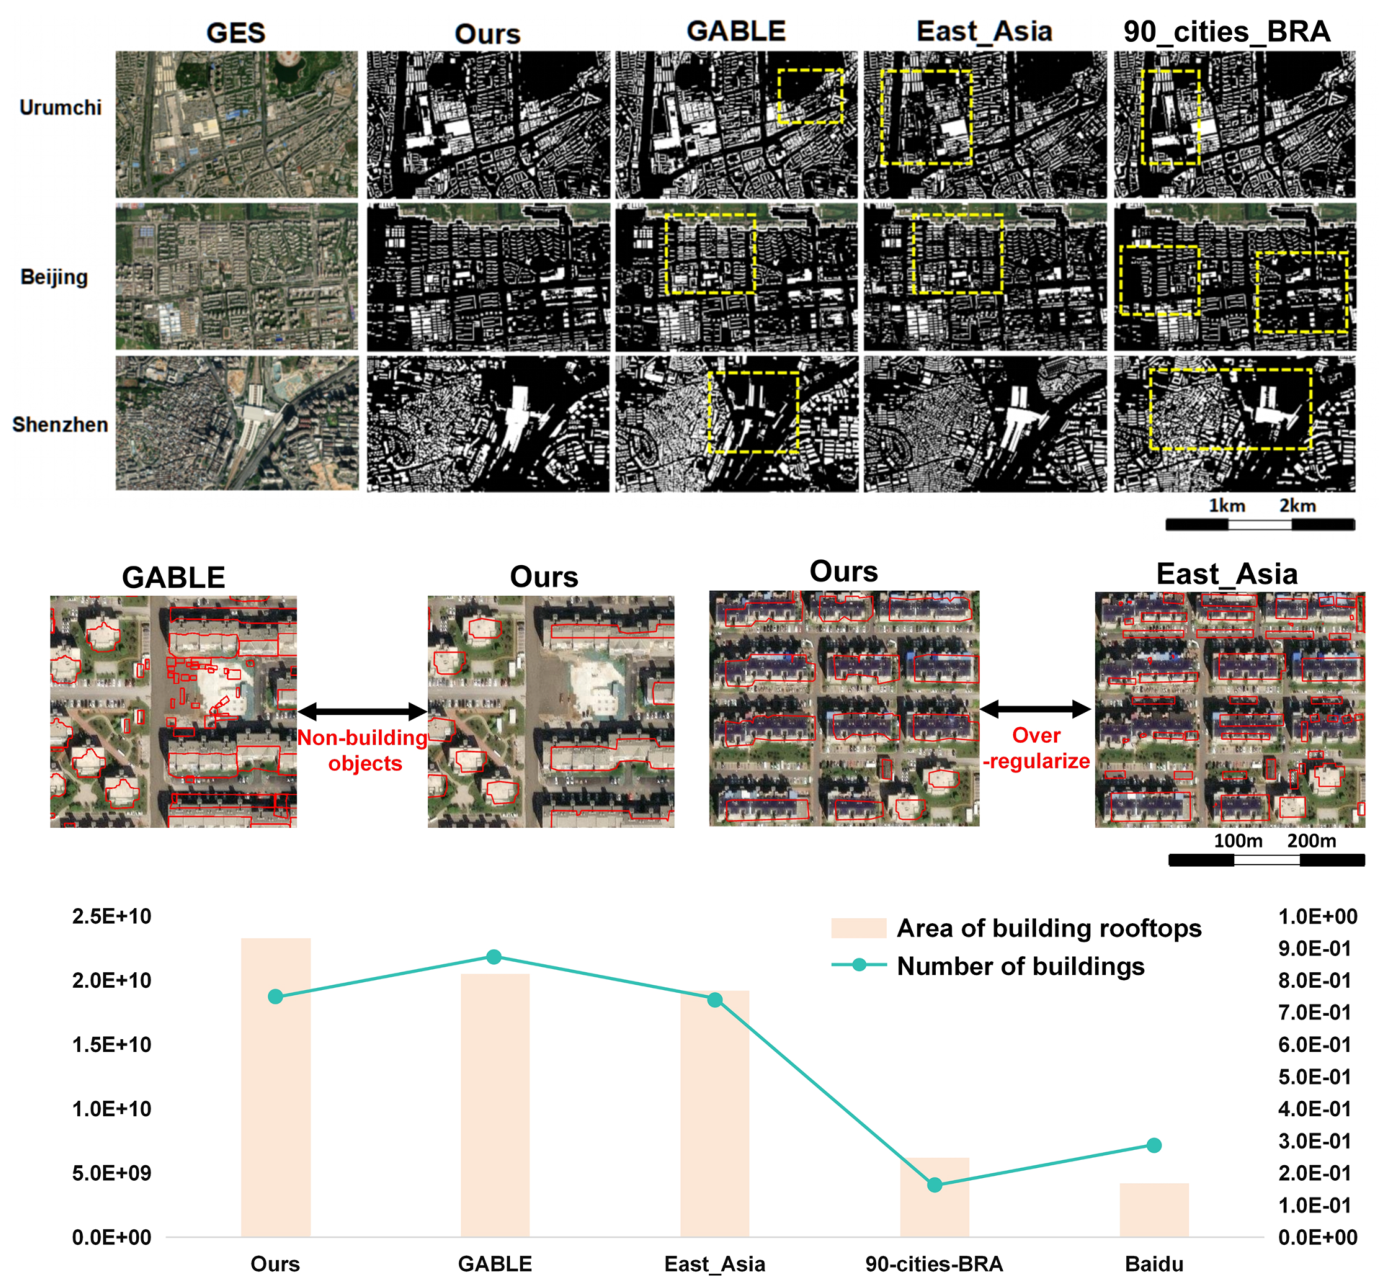
图 8|同一批影像里,模型会漏什么、又会多认什么?
原图无子图字母。上部三行对比乌鲁木齐、北京、深圳,列为GES、本文、GABLE、East Asia与90_cities_BRA;中部放大示例说明非建筑对象误认和过度规则化;下部柱形为屋顶面积、折线为实例数量,读取不同纵轴。更多实例不自动表示更完整,可能也受多屋顶拆分和小构筑物识别影响。来源:原论文 Fig. 8。
屋顶投影还不总等于地面建筑轮廓。倾斜拍摄、高层屋顶位移、屋檐与相邻遮挡都会影响空间匹配,后续把高度或功能接到多边形上时,需要保留这一几何误差来源。
不用激光扫描,怎样估计建筑高度?
研究将建筑自身形态、邻里密度、街区、道路和城市位置等变量作为特征。百度建筑资料最初含96城、12,772,156个带楼层信息的实例;补图S3显示剔除样本较少城市及缺失、异常特征后,保留85城、9,820,495栋,10%留作测试。地图楼层信息是训练参照,不是对全部建筑逐栋实测高度。
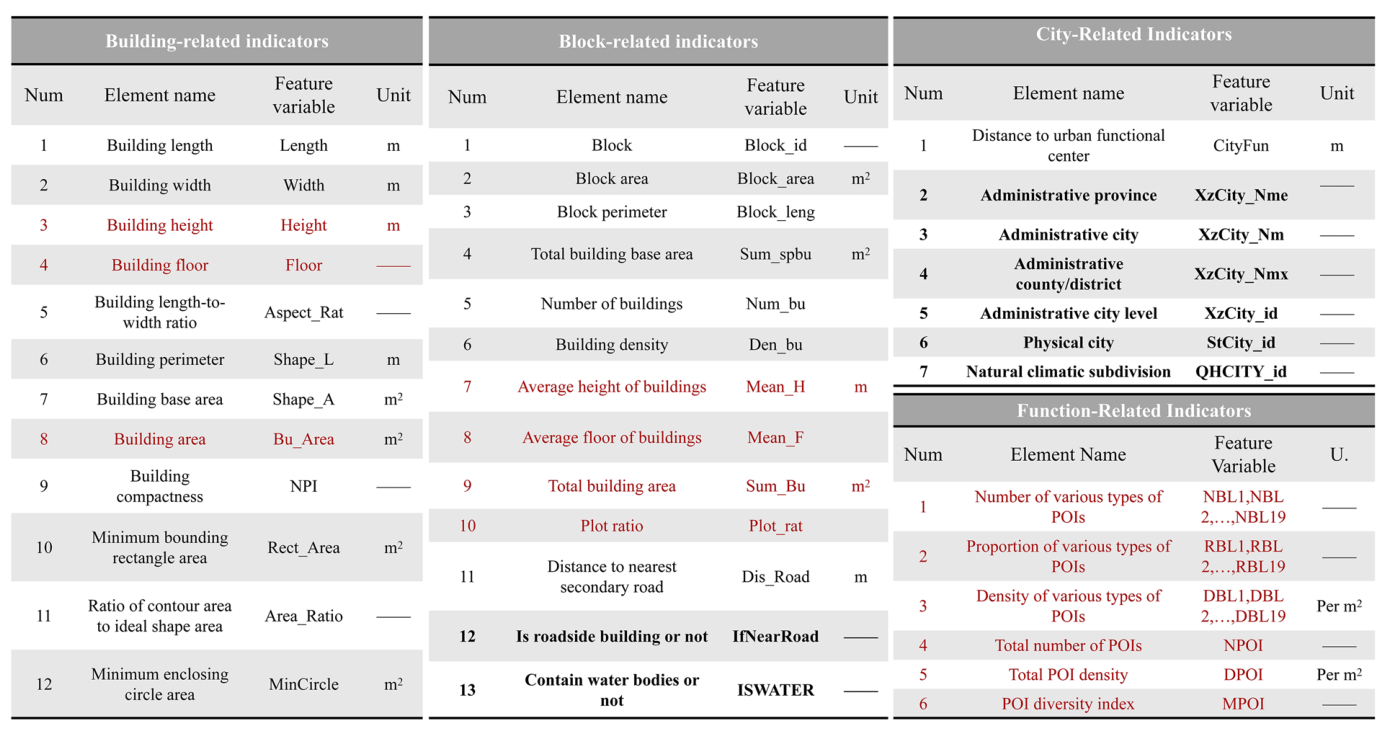
图 4|模型能利用哪些与建筑高度和用途相关的线索?
原图无字母,表形框分为建筑、街区、城市及功能相关指标。包括长宽、形状与紧凑度、周围建筑密度、道路距离、行政类型、气候区,以及POI数量、密度与多样性;红色为功能模型相对高度模型新增的特征。红色高度、楼层等变量进入后续功能估计,而不是作为未知高度预测的真值输入。来源:原论文 Fig. 4。
补充说明给出沿街判定的凹包与道路退界方法,以及由POI核密度峰识别城市功能中心的方法(补图S4)。它们是模型可重复计算的空间特征,并非直接观测到居民认为哪里是中心。
高度采用Bootstrap Aggregated XGBoost:有放回抽样建立多个训练子集,训练100组模型,平均其预测。按行政类型分组可适配不同建设条件,但行政类别只是统计分层,不能直接证明某种制度造成了建筑高度。
| 模型组 | 类别 | MAE(米) | RMSE(米) | R² |
|---|---|---|---|---|
| A | 非城市区域 | 2.5 | 5.6 | 0.84 |
| B | 县级市 | 2.4 | 5.3 | 0.81 |
| C | 地级市 | 3.3 | 6.5 | 0.74 |
| D | 省会 | 3.9 | 7.7 | 0.71 |
| E | 直辖市等 | 3.6 | 7.9 | 0.68 |
| 合并 | 全部样本 | 3.8 | 7.6 | 0.71 |
来源:原论文表4。MAE为平均绝对误差,RMSE更强调大偏差,R²为拟合程度。分组并非每项都胜出,例如E组RMSE高于合并模型;不能把分组方法写成无条件改善。
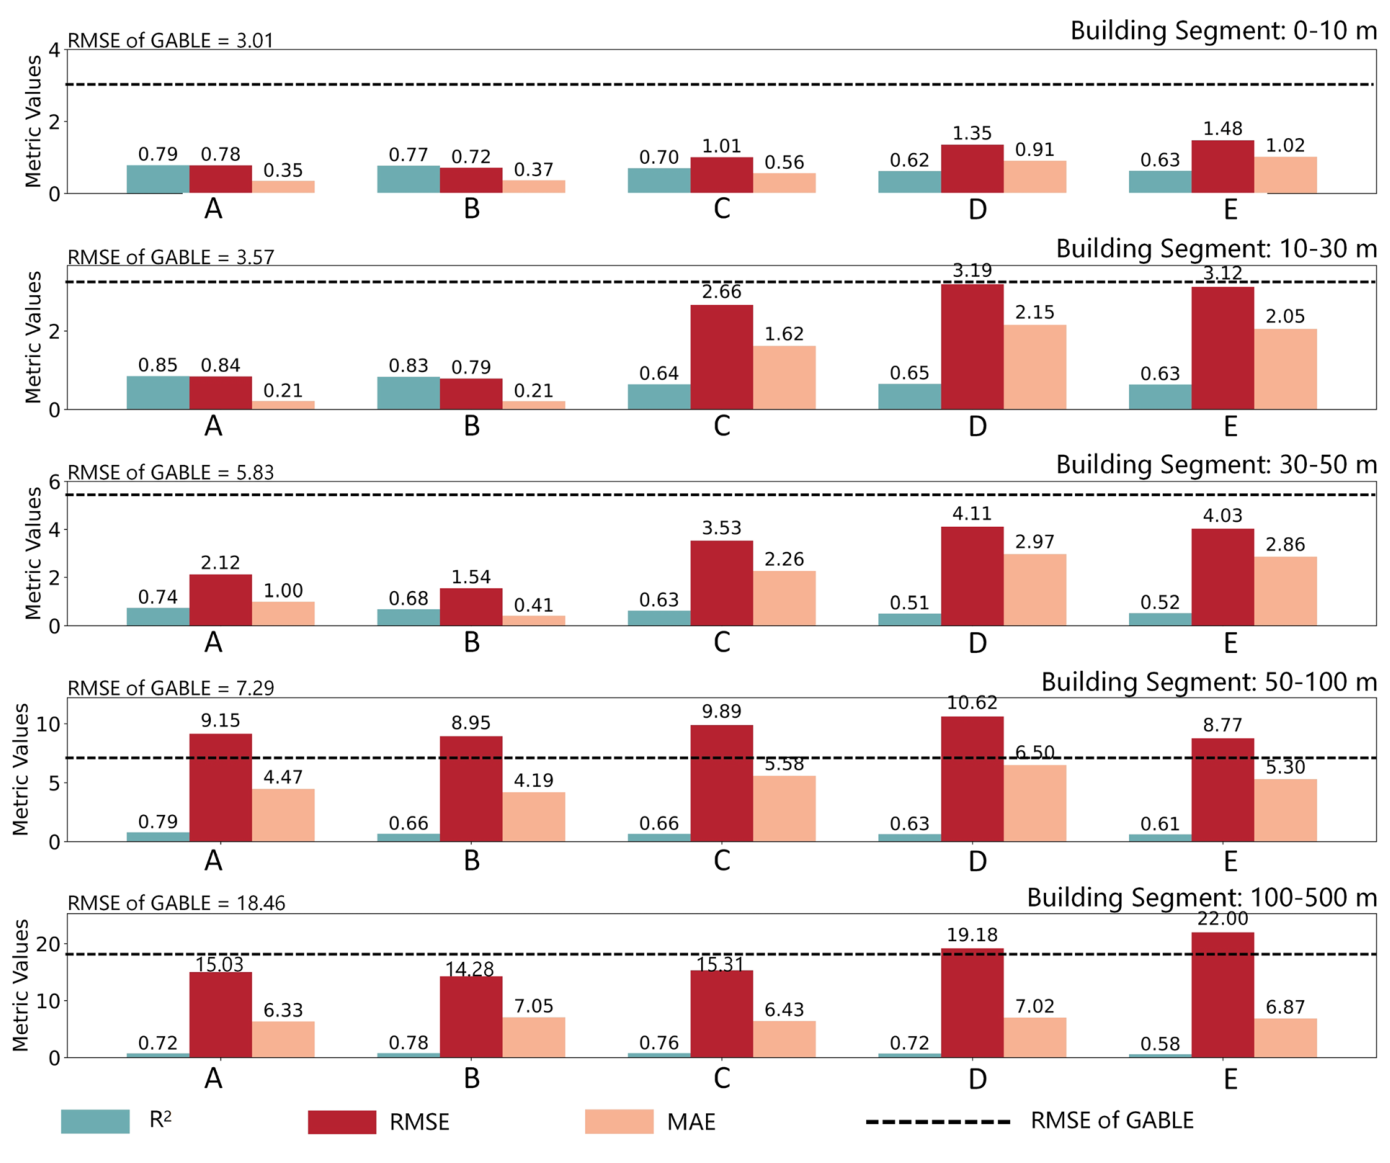
图 9|低层建筑的好成绩,会不会掩盖高层误差?
原图分五行,分别是0—10、10—30、30—50、50—100与100—500米。每行A—E沿用表4行政分组;青色R²、红色RMSE、浅红MAE,虚线为GABLE所报RMSE。较低建筑区间的误差较小,高层区间误差增大;R²没有米单位,不能把三种柱高当作同一物理量。跨产品误差比较还依赖各自验证样本与参照的一致性。来源:原论文 Fig. 9。
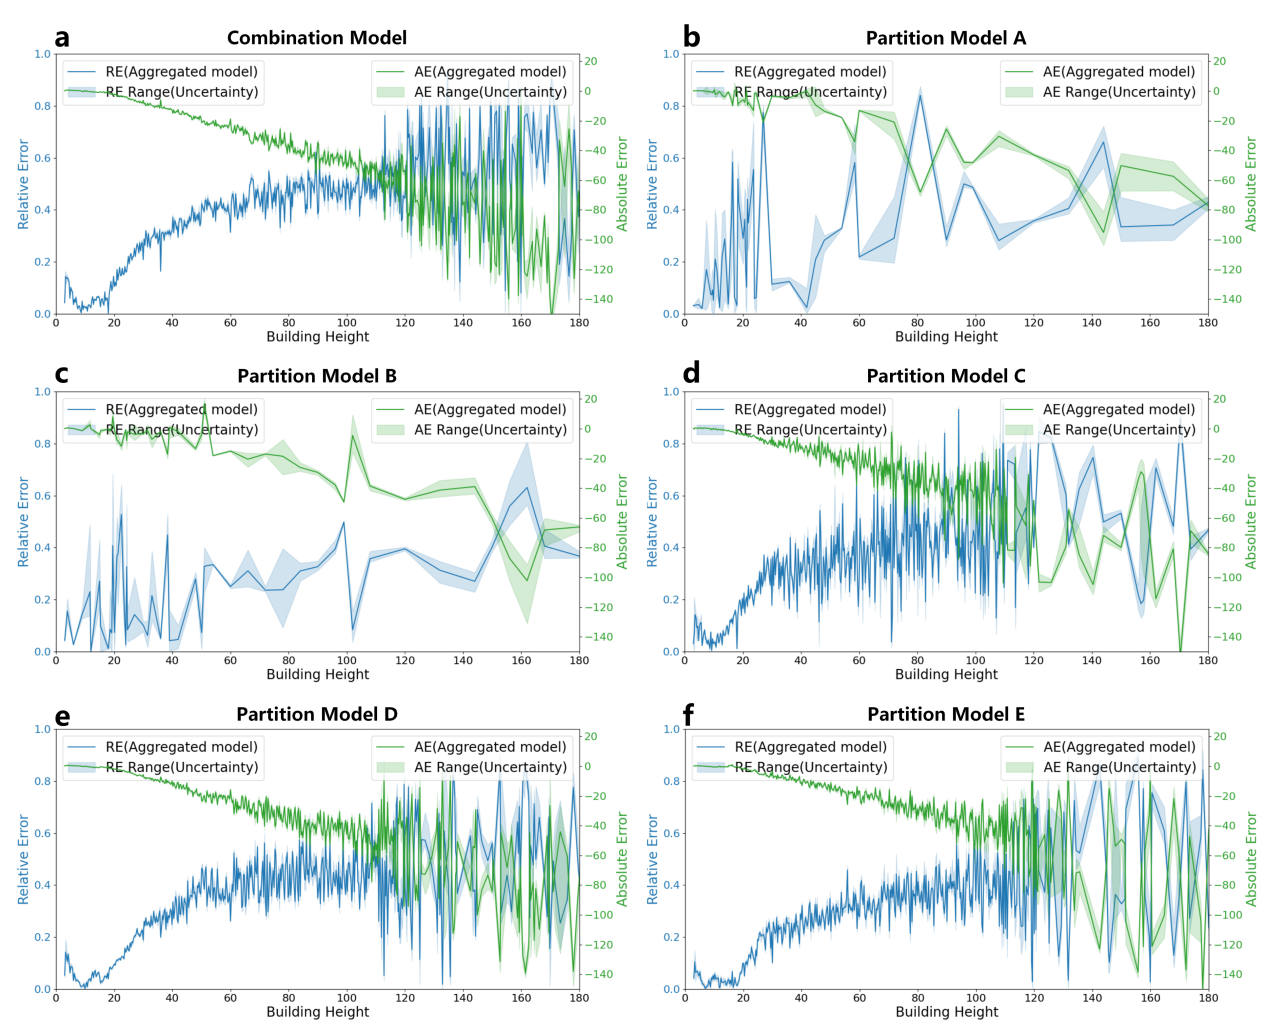
补图 S5|重复训练很稳定,是否就表示高度准确?
(a)合并模型;(b)A;(c)B;(d)C;(e)D;(f)E。横轴为真实高度,蓝、绿分别按左右轴展示相对与绝对误差,阴影反映多组模型结果范围。较高建筑往往更难估计;范围窄表示对抽样和参数的敏感性较低,不能排除所有模型共享的系统偏差,也不是覆盖真实高度的校准置信区间。来源:补充材料 Fig. S5。
一栋楼的功能,是否可以从周围设施猜出来?
功能模型利用AOI地块类别构建标签,把地块内建筑赋予与地块一致的主要用途,再结合形态、高度、街区、位置及19类POI特征,总计91个变量。补充表1、2明确由原始AOI重分为住宅、商业、公共服务、工业、办公与其他六类。
这个标签便于扩大样本,也包含假设:同一地块可能有住宅、底商和办公混合使用,楼层功能也可能不同。所以,模型输出首先是这一分类体系下的建筑主要功能,不是全楼逐层的真实用途普查。
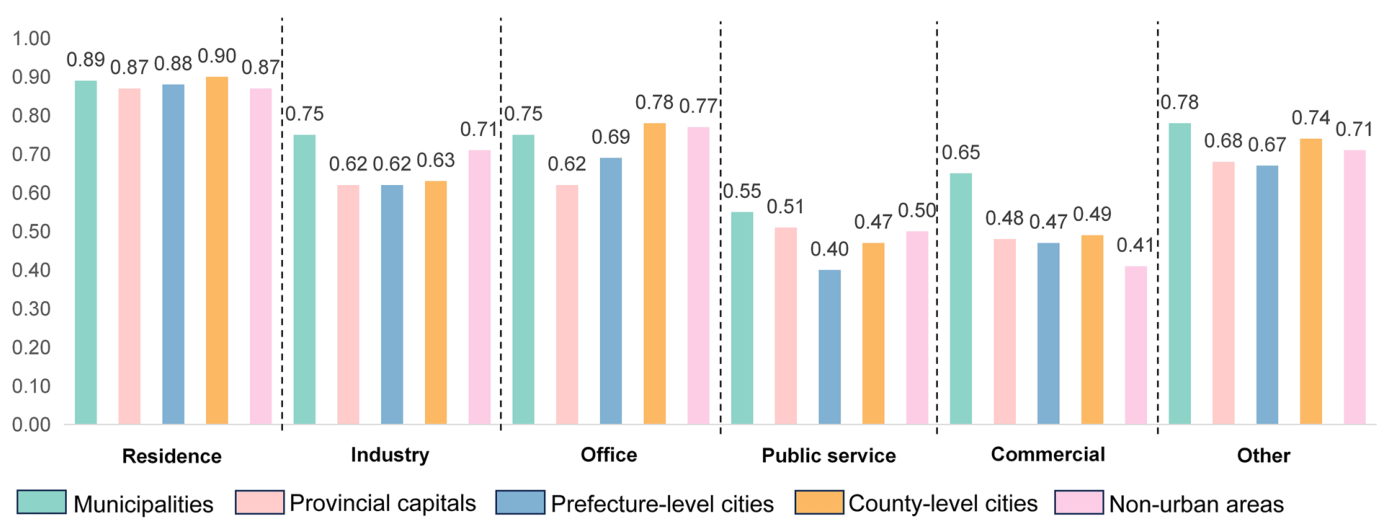
图 10|哪种用途比较好分,哪种更容易混淆?
原图无字母,横轴依次为住宅、工业、办公、公共服务、商业、其他,颜色区分五种城市类型。住宅得分约0.87—0.90,公共服务约0.40—0.55,商业在多数分组约0.41—0.49,个别组较高。正文将这些表现概括为相应F1水平,不能把住宅成绩推广到所有类别。来源:原论文 Fig. 10。
功能错误也可能与高度错误相关,因为估计高度是后续功能模型的一部分输入。把两个预测字段同时放进城市模型,不能默认它们的误差互相独立。
外墙看着破旧,是否就说明建筑质量差?
质量指标使用YOLOv8从街景识别六类可见问题:外墙凌乱、外墙损坏、违法或临时建筑外观、涂鸦或广告、店铺立面较差、招牌较差。以建筑形心100米范围内的街景点为邻域,对每类问题汇总平均,再求六类总分,理论范围0—6,越高表示可见问题越多。
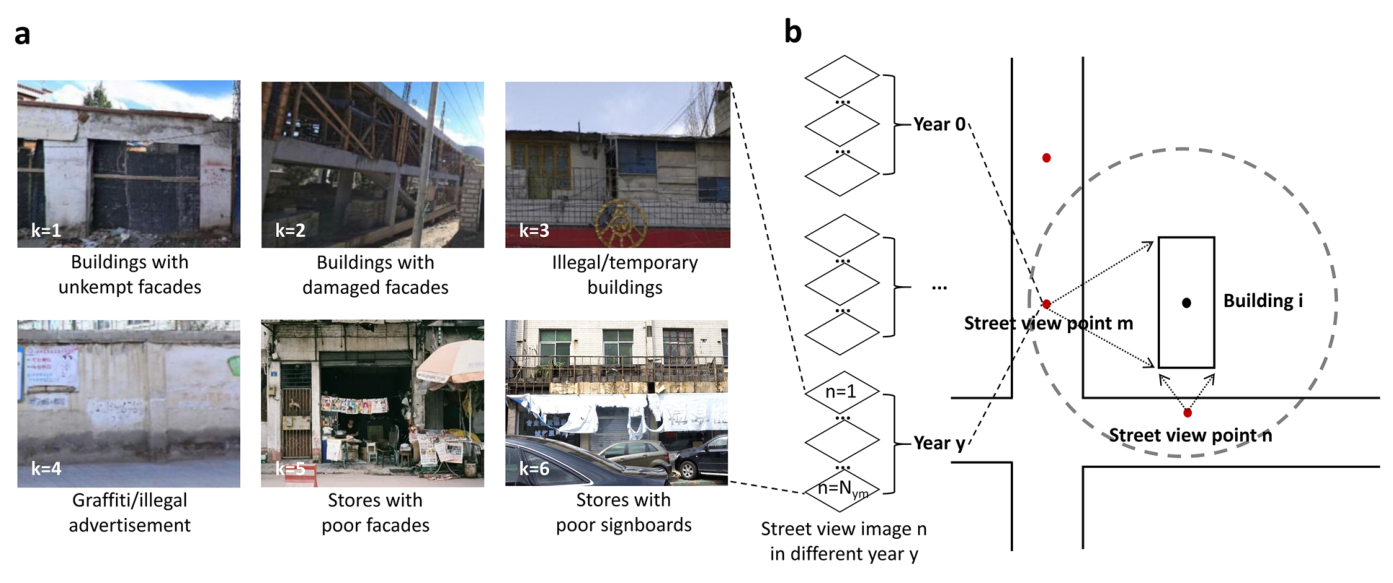
图 5|这些问题来自哪张街景,又怎样赋给一栋楼?
(a)展示六类外观问题的图像例子;(b)说明一个建筑周围缓冲区内,不同街景点与年份的图像怎样汇总。邻域赋值可能同时反映周边街面,不能保证每个被识别对象都属于目标建筑。它衡量外观与空间失序,不是抗震能力、承重状况或违法建设的正式认定。来源:原论文 Fig. 5。
街景覆盖3,224个空间城市,质量数据主要针对沿街可观测建筑,补充说明将其约记为全体建筑的29.4%。使用最近有街景的年份,也使不同建筑的最终质量分对应不同时间。没有观测点、该年无街景与真正没有识别到问题,需要分别编码;缺失不能填成零分。
表5列出目标检测模型的mAP@50,六类约71.6%—89.2%。mAP是检测性能,不是每栋建筑质量正确率。论文另以人工质量严重度评分进行比较,报告R²为0.78;这也没有把外观分数验证为工程安全指标。
道路先铺好了,建筑年代会不会跟着被算早?
年代字段把建筑形心与GAIA逐年不透水面相交,找首次出现年份。其核心假设是该位置不透水化与建筑建成大致同步,但先铺路、后建楼、拆旧重建都可能破坏这一关系。
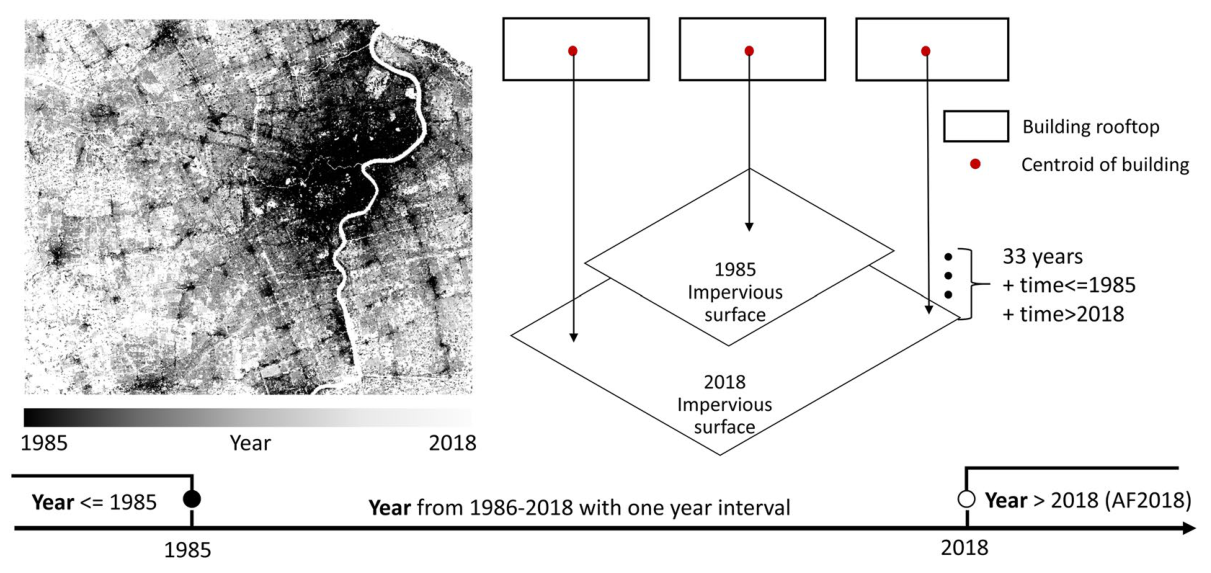
图 6|年代字段记录的是哪一种时间?
原图无字母。左侧为1985—2018年不透水面信息,右侧用建筑形心对应逐年图层,下方给出1985年及以前、1986—2018逐年,以及2018年之后的分组。最晚一类AF2018不能当成某个精确竣工年份;图记录的是依据地表变化推断的年代。来源:原论文 Fig. 6。
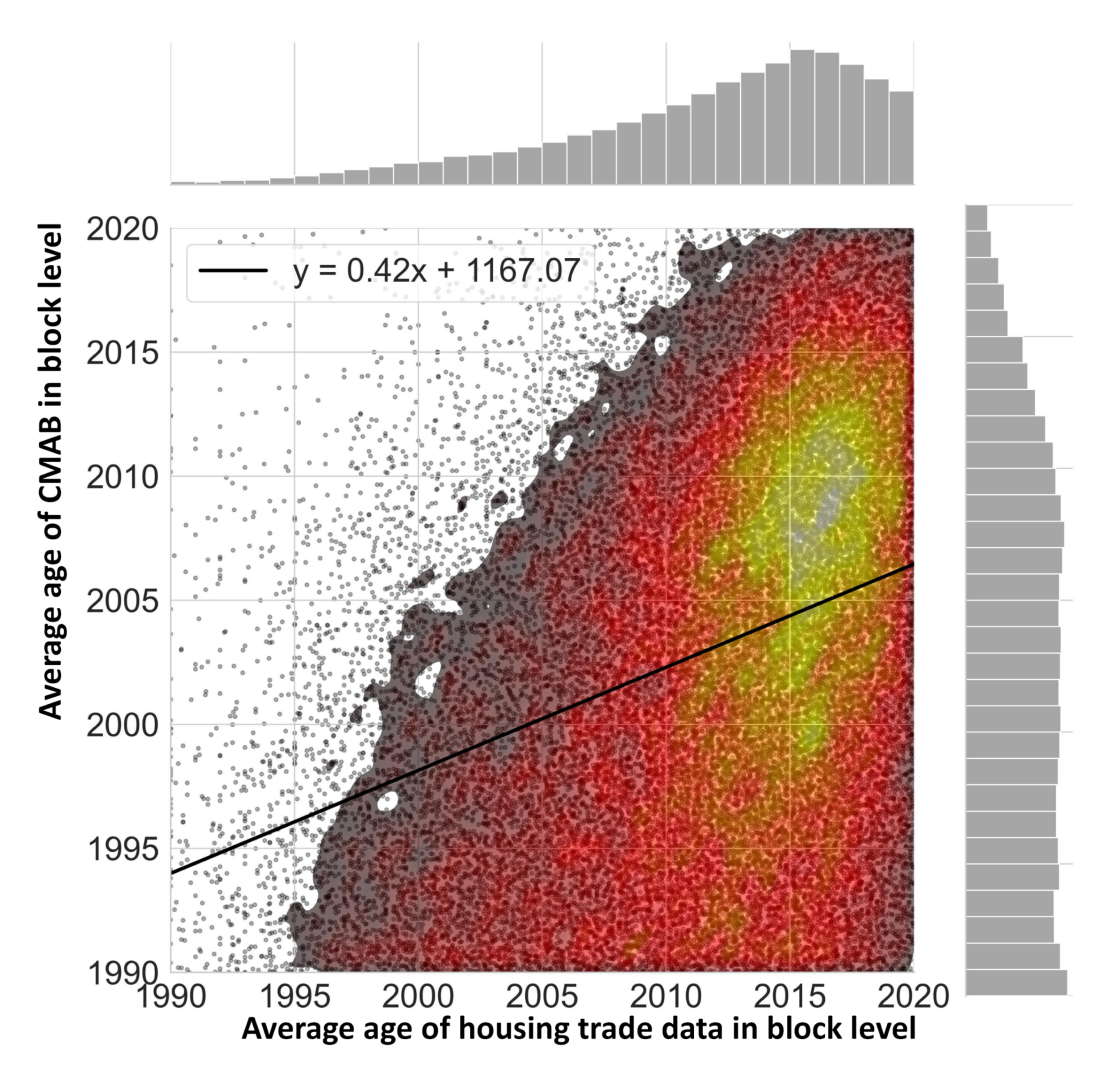
补图 S7|两种年代在聚合层面相关,是否说明逐栋年份相同?
单幅联合分布图,横轴为房产资料的街区平均年代,纵轴为CMAB对应平均年代,边缘为各自分布。图中线性拟合斜率约0.42,远非逐点一致;正相关不等于两者相等。来源:补充材料 Fig. S7。
验证使用约377万条房产记录、约61万条小区资料,覆盖2,490个城市标识;社区级年代与单栋建筑并非相同单位。论文报告GAIA推定年代平均比房产记录早8.7年。补图S8分省对照也显示正相关,但不能据此宣称逐栋竣工年误差很小。
人工审查有没有真正看见这些建筑?
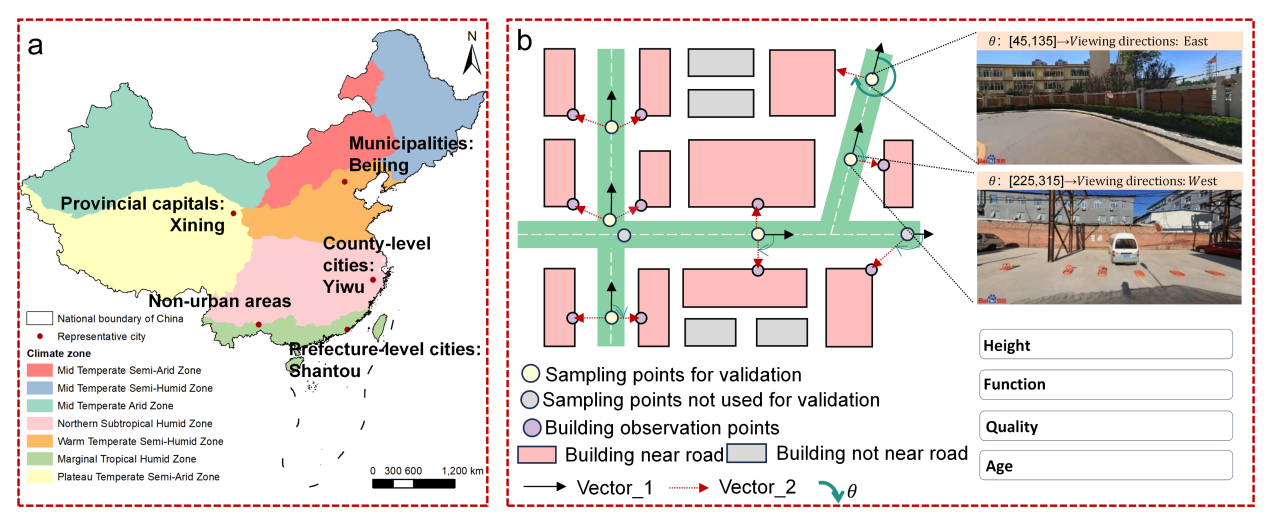
补图 S6|验证样本与自动赋值怎样对应?
(a)验证地点覆盖北京、西宁、义乌、汕头及非城市样本等行政与气候情形;(b)以建筑边界观察点、街景位置和拍摄方向配对,选择左右视角并建立审查界面。黄色点为可用于验证的街景采样,灰点为未使用点。这个设计提高可见建筑与影像的对应,但仍主要验证沿街可观察样本。来源:补充材料 Fig. S6。
人工审查共2,500个建筑样本,以可见楼层估高并与产品比较,高度R²为0.72;功能一致率88%;粗年代类别一致率82%。这些是不同属性、不同评价尺度的结果,不能把82%改写成精确建成年份正确率。街景楼层换算也有测量假设,并非测绘仪器真值。
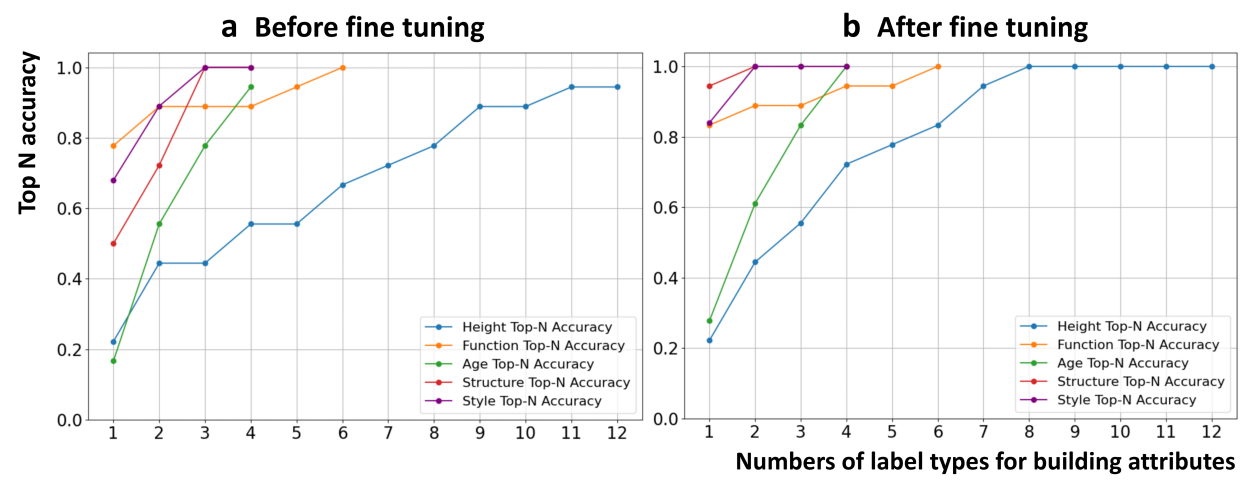
补图 S9|通用视觉语言模型是否能替代全部专门方法?
(a)微调前;(b)微调后。横轴为Top-N候选数,纵轴为正确标签进入前N名的比例;曲线区分高度、功能、年代、结构、风格。结构与风格在Top-1较高,而高度和年代明显更低。候选数增加后的高命中率,不等于Top-1预测准确。来源:补充材料 Fig. S9。
主文对CLIP微调后Top-1的概括与这张分属性曲线不完全一致,因此不把笼统单一百分比用于所有属性。更稳妥的结论是:结构和风格可以探索视觉语言模型,精细高度与年代仍需专门特征及外部资料。本文没有证明通用模型能够替代工程调查。
拼成三维城市之后,哪些结论最容易被高估?
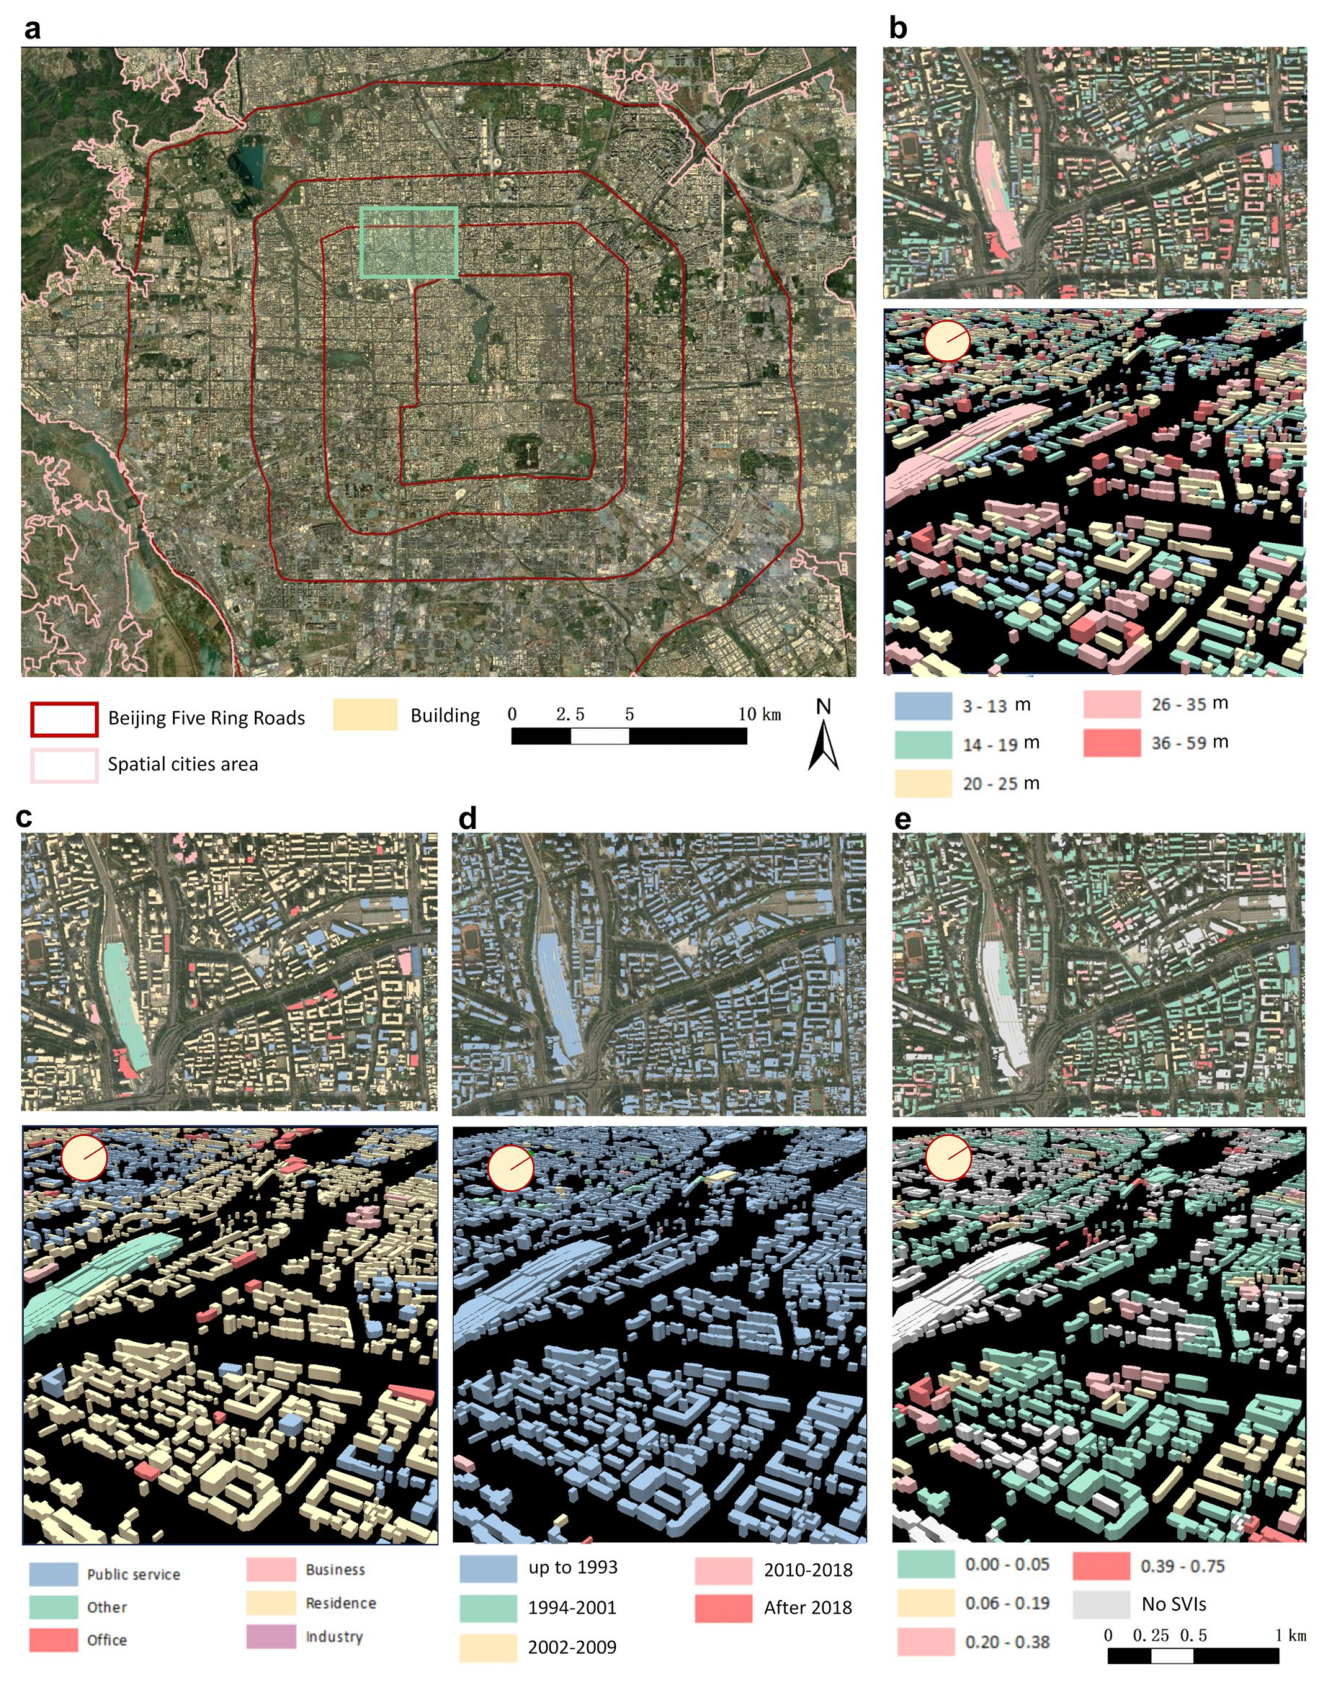
图 7|同一片街区怎样同时呈现多种预测?
(a)北京样本区与环路位置;(b)高度,以米为单位分色;(c)主要功能;(d)年代分组;(e)外观质量问题分数,并单列无街景情形。每项都有平面或立体视图,比例尺与图例保留原样。三维视觉展示的是多属性拼接结果,外观逼真不意味着各字段都经过逐栋实测。来源:原论文 Fig. 7。
补图S10—S13另展示几何存量、功能、质量和年代的全国及省级分布;主要作用是描述产品所反映的空间格局。屋顶面积、高度推算体积、功能计数与沿街问题比例具有不同分母,尤其不能将沿街样本外推为所有建筑的质量排名。本文不把这些图扩大为全国所有建筑完整、同年且同精度的普查。
对实际应用,有三类边界最关键。第一是覆盖与时间:城市实体之外、街景不可见处,以及较早影像区域,信息不均。第二是标签:AOI、楼层、街景与不透水面都是有自身误差的参照,模型拟合好不等于完整实物真值。第三是误差传递:屋顶边界影响空间匹配,高度影响功能,邻域街景可能影响多栋建筑,聚合分析不能假定这些误差彼此抵消。
它仍然是一项有价值的数据工程:把零散的城市资料连接到建筑实例,降低提出新问题的成本。用于太阳能、城市热环境、更新优先级或碳核算时,研究者需要再验证与具体用途最相关的字段,而不是拿摘要中的一个准确率覆盖全部任务。
一句话总结
CMAB让建筑从轮廓变成多属性对象,但这些属性是各有依据与误差的估计,读懂它们的生成方式,才能把三维地图用在合适的问题上。
核心来源
- Zhang, Y., Zhao, H., & Long, Y.(2025). CMAB: A Multi-Attribute Building Dataset of China. Scientific Data 12, 430。论文与补充说明、表格、图。本文十幅正文图及五幅补图均来自该研究。
- CMAB数据及代码,版本v2。复用字段可对照原文补充表3。
作者介绍
- Yecheng Zhang:清华大学建筑学院署名作者,与Huimin Zhao共同第一作者。
- Huimin Zhao:清华大学建筑学院署名作者,与Yecheng Zhang共同第一作者。
- Ying Long:清华大学建筑学院,以及恒隆房地产研究中心、教育部生态规划与绿色建筑相关实验室署名作者,为本文通讯作者。以上机构据论文发表时署名列示。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
多属性地图可以增加决策依据,也可能制造一种每栋楼都已被充分了解的错觉。用于更新筛选时,可以把结果分成可直接观测的线索、模型推断的属性与缺失状态,让现场核查优先关注高影响且不确定的对象,而不是只按一个总分从高到低处理。
进一步可以检验结论对误差是否敏感:给高度、功能和年代按已知误差范围生成多组合理版本,重复计算某片区域的更新或能源需求。若优先区域在不同版本中稳定,证据相对扎实;若名次频繁改变,就应补充测量,而非让漂亮的地图替代不确定性讨论。