不看火车和人流,企业投资能画出怎样的中国城市网络?
论文名片|Tianheng Shu、Shuo Yang、Taofang Yu、Guangyu Cheng、Yitian Ren、Fangchen Shi、Ben Derudder、Xia Liao,An intercity investment network dataset of China based on the enterprise registration records (2000–2020),Scientific Data,2025,12:369,2025 年 3 月 3 日发表。论文原文 · 数据与代码。
假设上海一家企业投资了合肥一家企业。两座城市之间不一定因此立刻增加一列火车,却已经形成了一条可辨认的经济联系。如果把许多企业的投资关系汇总到注册城市,地图上会出现怎样的网络?它与我们熟悉的人口流动网络相似吗?
这篇数据论文提供了 2000、2005、2010、2015、2020 五个时点的中国城市间投资网络。它的重要性在于把企业关系转成可复用的城市连接,而不是只根据两地规模推算交互。阅读时最要紧的区别是:网络权重计数投资关系的频次,不是投资金额,也不是城市之间全部资金流量。
先说结论
- 研究从约 1,727 万条企业登记记录中整理出约 1,195 万条企业间投资记录,再按企业注册地汇总至 367 个城市单元。
- 北京、上海、深圳等城市持续位于网络中心,连接最密集的地区集中于京津冀、长三角和珠三角等城市群。
- 与人口流动网络比较时,2020 年城市对散点拟合的 R² 为无向 0.33、有向 0.26;分布分位数拟合更高,二者回答的是不同问题,不能混成“准确率接近 100%”。
- 数据适合研究投资联系结构,但五年间隔、注册地代理、频次替代金额以及公开文件与部分表格的数值差异,都需要在复用时核对。
从企业登记到城市连线,经过了哪些选择?
作者通过企查查汇集企业基本登记、对外投资和股东信息,再利用实缴信息日期确定投资年份。数据清洗去重,排除中国内地之外的注册城市;缺城市字段时,依次从地址提取、地理编码和人工检索补全,仍无法确定的记录删除。
城市统一到 2020 年行政区划代码,共 367 个单元,包括直辖市、地级市、自治州、地区、盟和部分省直管县级单位。因此,节点不是同一种面积或同一种人口规模的纯建成区。
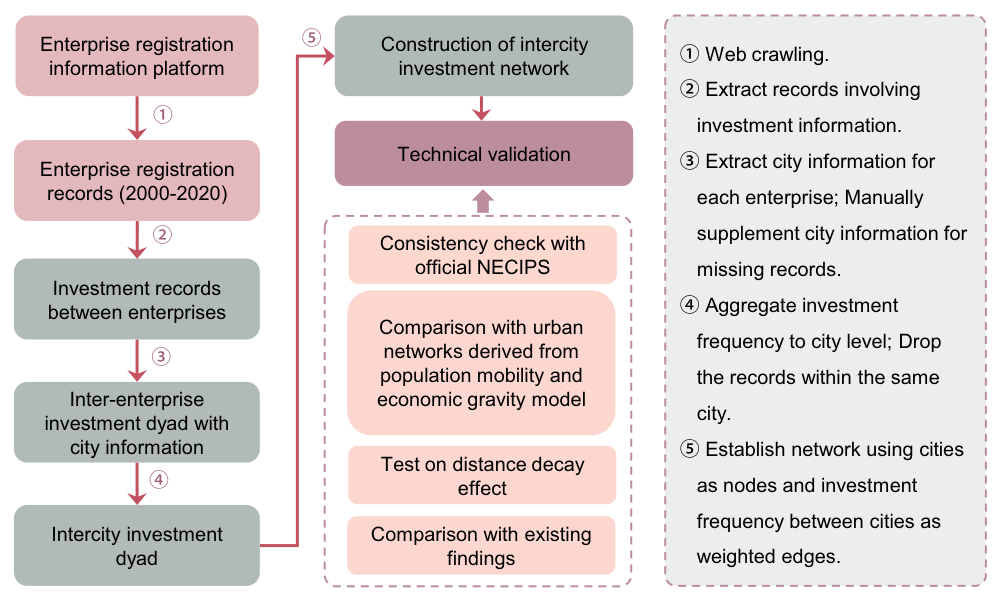
图 1|一条企业投资怎样变成一条城市连接?
这张流程图没有字母子图。左侧依次得到企业登记、投资关系、城市属性和城际关系,中间构建网络并进行四类验证,右侧解释抓取、筛选、补齐、聚合和建网步骤。登记关系需先正确匹配企业与城市,不能把最后的线条当作不经处理就存在的原始观测。来源:原论文 Fig. 1。
投资者注册于 A 城、被投资者注册于 B 城,就为 A→B 增加一次投资联系。无向网络再把 A→B 和 B→A 的频次相加。主要版本排除同城关系,另提供包含同城投资的版本,以研究本地化。
这也解释了为什么不用金额加权。早年实缴金额缺失较多,部分城市对还存在极大异常金额;作者选择频次以减少这些问题。代价是一次小额投资与一次大额投资在计数中可能同样贡献一个单位,不能直接将边权解释为资金规模。
五张地图讲的是连续二十年,还是五次截面?
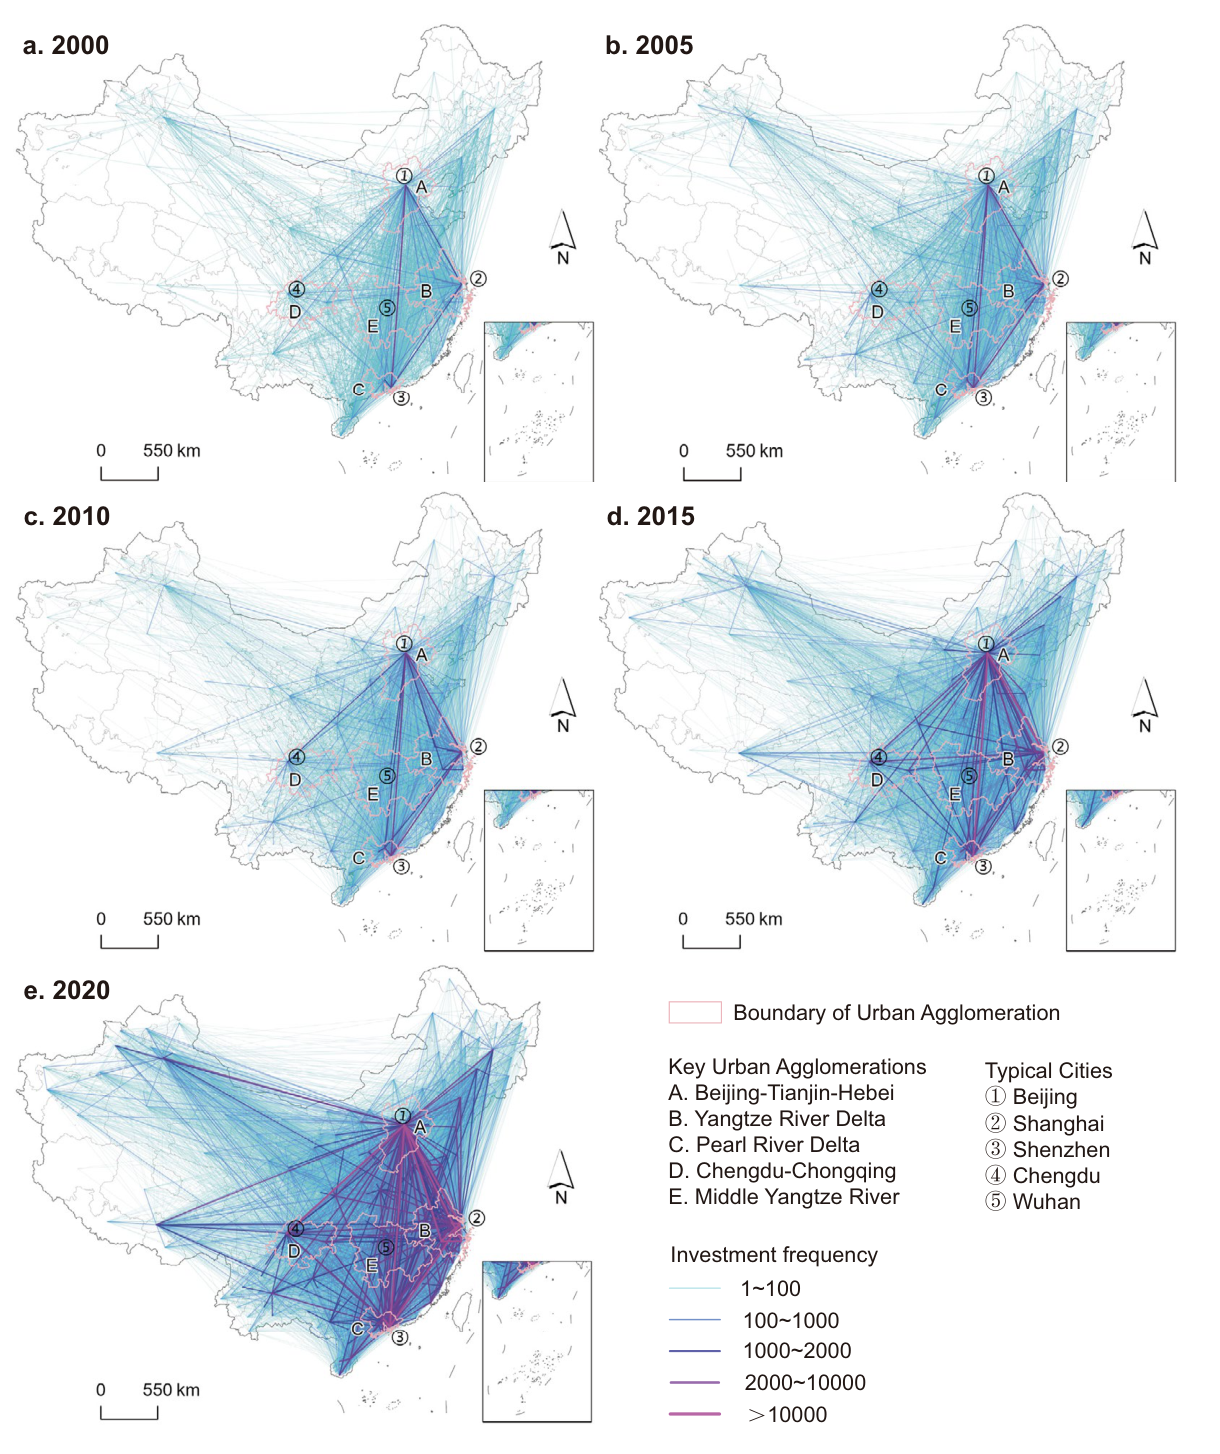
图 2|哪些联系加密,哪些地区长期处于中心?
(a)2000 年、(b)2005 年、(c)2010 年、(d)2015 年、(e)2020 年。线条按投资频次分级,颜色越接近图例中的紫红色代表更强联系;图中另标注主要城市群和北京、上海、深圳、成都、武汉等城市。五幅面板使用同一频次分级,可以观察连接增强,但它们不是逐年完整时间序列。来源:原论文 Fig. 2。
论文概括,网络形成以北京、上海、深圳、成都为主要顶点的菱形格局,东部城市群连接尤其密集。这样的图说明登记投资联系在空间上的集中,不表示所有产业、所有资本类型都按同一结构组织。
原论文表 1 中,有向城市对从 2000 年的 10,671 组增至 2020 年的 51,584 组,频次总和分别为 76,186 和 1,808,636。它们都是特定时点、排除同城后的统计。文中汇总的 134,666 条有向边与 92,994 条无向边,是五个年份的边数相加,不是全期去重后不同城市对的数量。
公开仓库的 Excel 还能提供一项复用提醒:逐表加总得到的 2005 年无向频次为 149,491,论文表 1 则写 149,071;公开表的 2015、2020 年频次总和分别为 608,039、1,808,650,也与论文表中的 608,031、1,808,636 略有不同。这些是论文表数与可下载文件之间的差异,应保留版本和核算口径,不能悄悄把两者混合成同一套精确总量。
投资发起者与接受者,怎样在图上区分?
论文把向外投资频次总和称为 outdegree,把接收投资频次总和称为 indegree,两者相加为 node degree。按常见网络术语,它们更接近加权出强度、入强度和总强度,而不是连接了多少座不同城市的非加权度数。
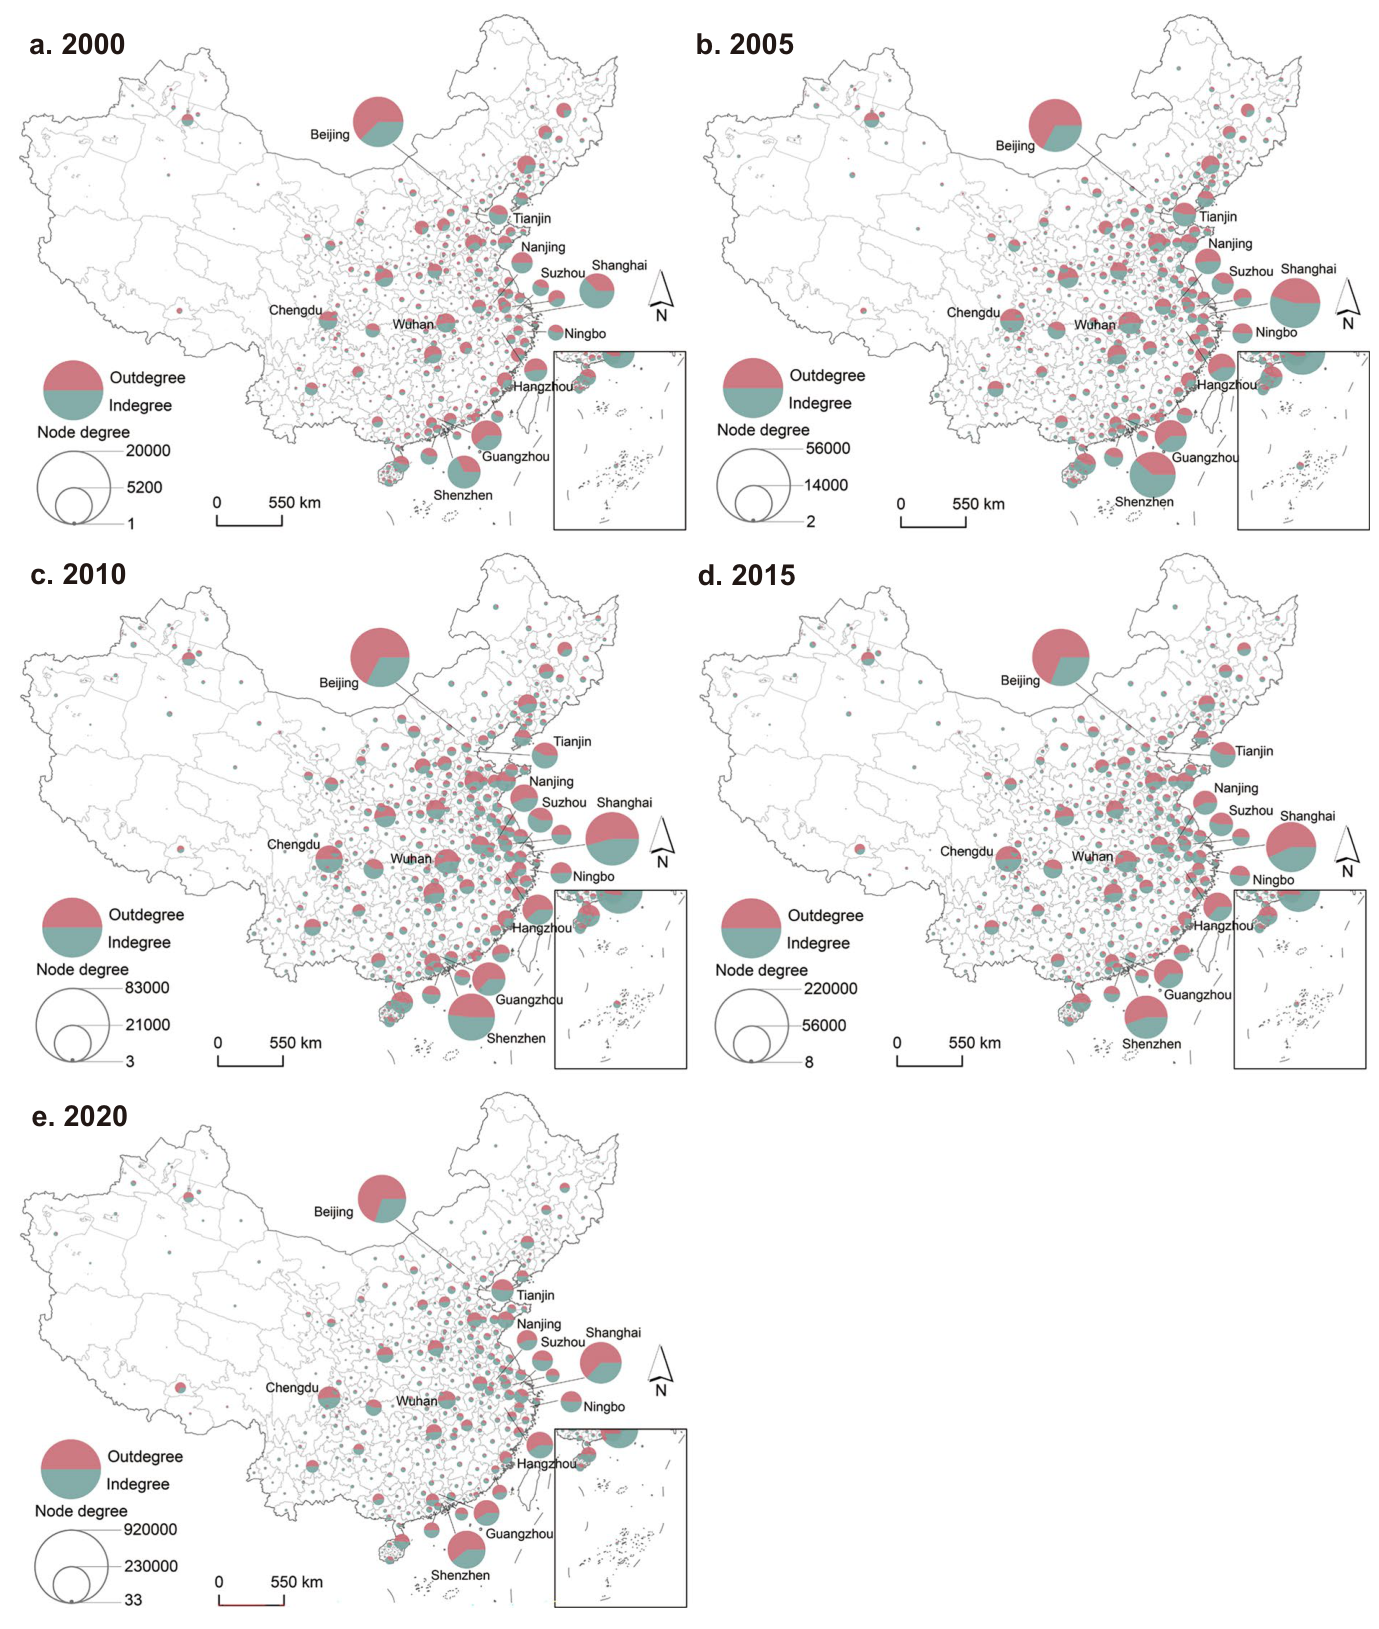
图 3|一座中心城市,是输出多,还是接收多?
(a)2000 年、(b)2005 年、(c)2010 年、(d)2015 年、(e)2020 年。圆的大小表示频次总强度,红色和绿色扇区分别表示向外与流入的构成。北京、上海、深圳等节点长期突出,部分较大东部城市的向外份额更高。各年份圆大小图例数值不同,应先读图例,不能直接把视觉半径当作跨年的统一绝对尺度。来源:原论文 Fig. 3。
这里的方向以论文文字定义和数据字段理解。原文公式(2)、(3)的箭头下标与出入度文字说明存在相反表述,复用代码或自行计算时应核对投资者与被投资者字段,避免把“流入”与“流出”交换。
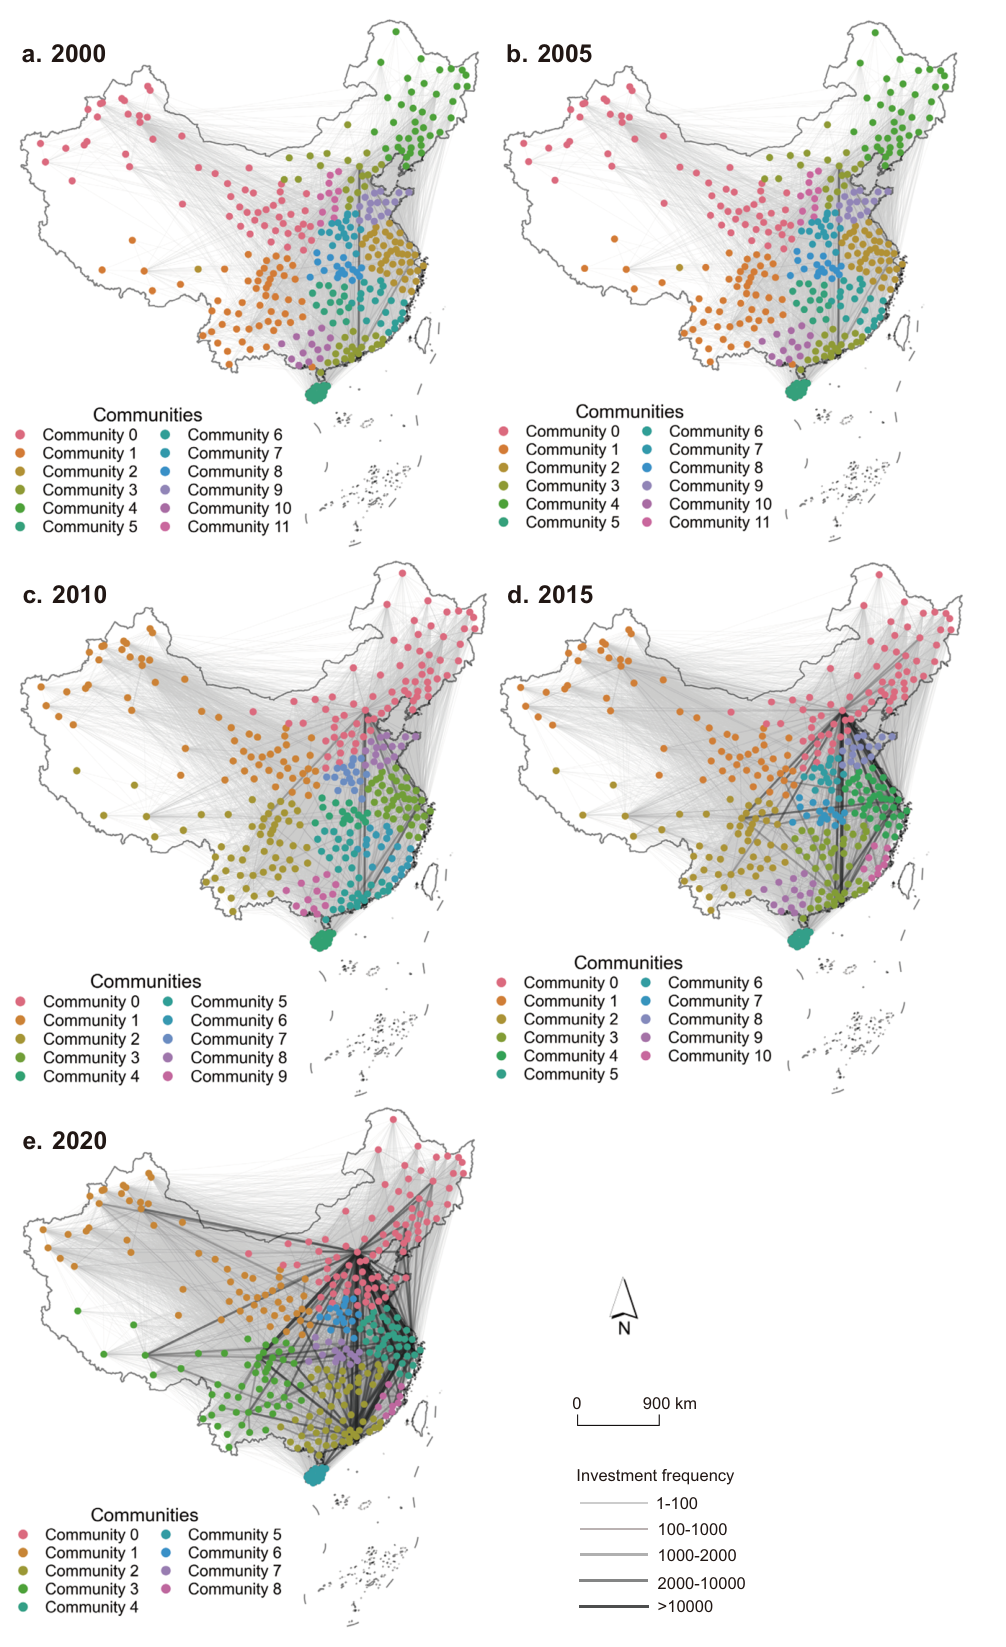
图 4|哪些城市更容易形成联系紧密的组团?
(a)2000 年、(b)2005 年、(c)2010 年、(d)2015 年、(e)2020 年。Leiden 算法按无向投资联系识别社群,点的颜色表示同一图中的社群归属,线条表现频次。论文报告社群数从 12 个变为 9 个,京津冀、长三角和珠三角持续形成突出组团。不同年份颜色是算法类别标记,不能仅凭颜色相同认定它就是跨年完全相同的一组城市。来源:原论文 Fig. 4。
社群减少可与网络整合的解释相容,但也受算法、参数和整体网络加密影响;不是单独证明某项区域政策奏效的证据。
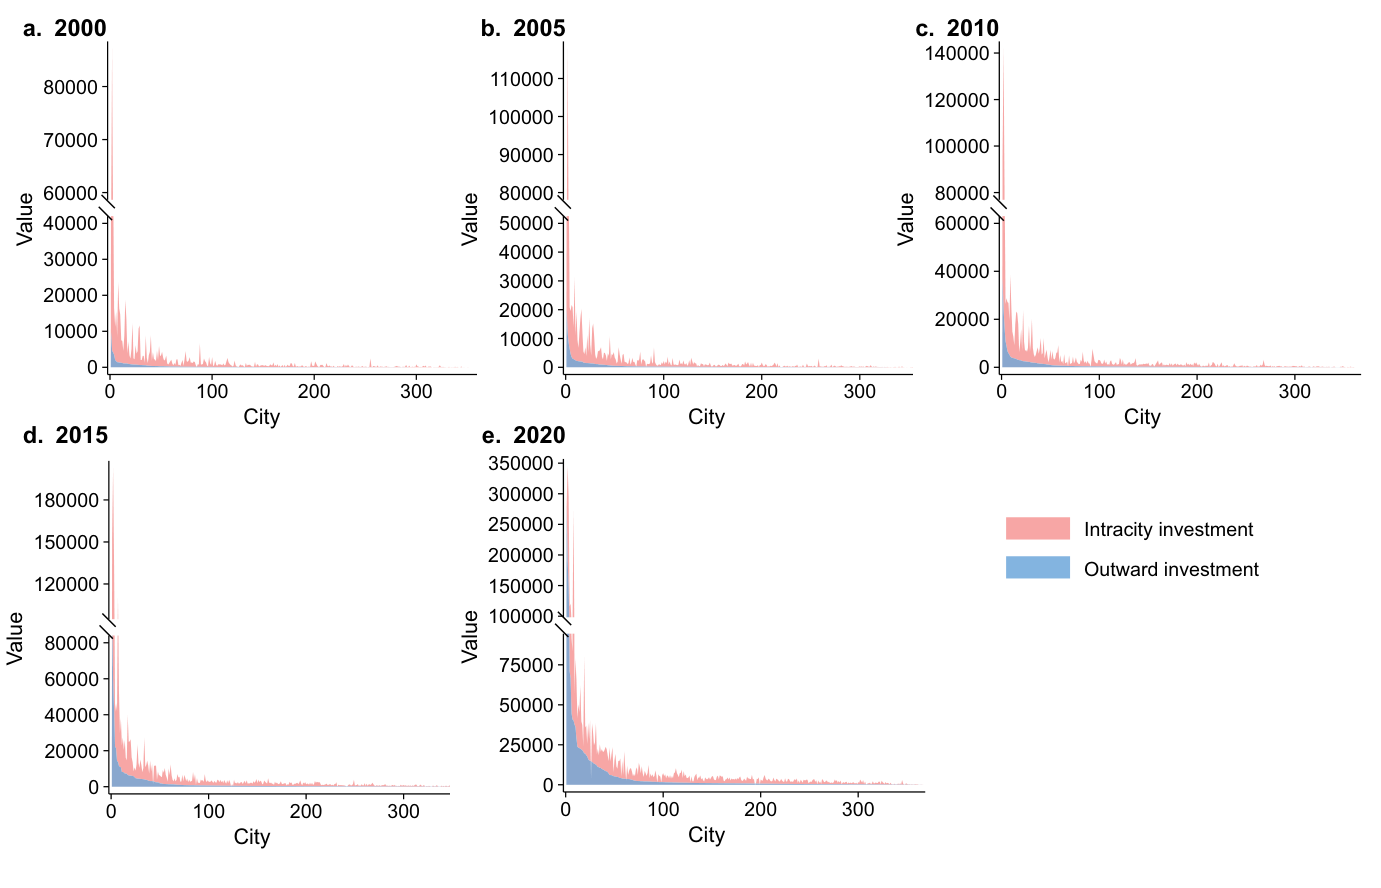
图 5|登记投资主要留在本地吗?
(a)2000 年、(b)2005 年、(c)2010 年、(d)2015 年、(e)2020 年。横轴排列城市,纵轴为投资频次,红色为同城、蓝色为对外;不同面板纵轴范围不同。多数位置的同城频次更高,作者据此描述明显本地化及其随时间减弱的趋势。它不表示每座城市都有相同的本地化比例。来源:原论文 Fig. 5。
抽样核对通过,能说全部记录都正确吗?
作者在五个年份各随机抽取 100 条,共 500 条记录,由五位作者逐条查询国家企业信用信息公示系统。能够在官方系统找到的记录全部与整理数据一致,部分记录却未能在官方查询中找到。
因此,“100% 一致”的分母是查得到的那部分抽样记录,不能写成 500 条全部经官方确认,更不能当作整套上千万记录的零错误证明。第三方平台与官方系统的更新差异可能是原因之一,但单凭查不到也无法彻底判定原因。
数据公开的主体是城市聚合表,并附匿名企业记录样本,未开放所有企业微观资料。研究者可利用城市级网络检验结构,却未必能逐条回查全部原始投资关系。
与人口流动相像,验证的是哪些部分?
2020 年人口参照来自高德每日迁徙流动指数,汇总为年度城市对网络。它测的是人口移动指数,不是投资;两者理论上可能关联,所以这是一项间接验证。
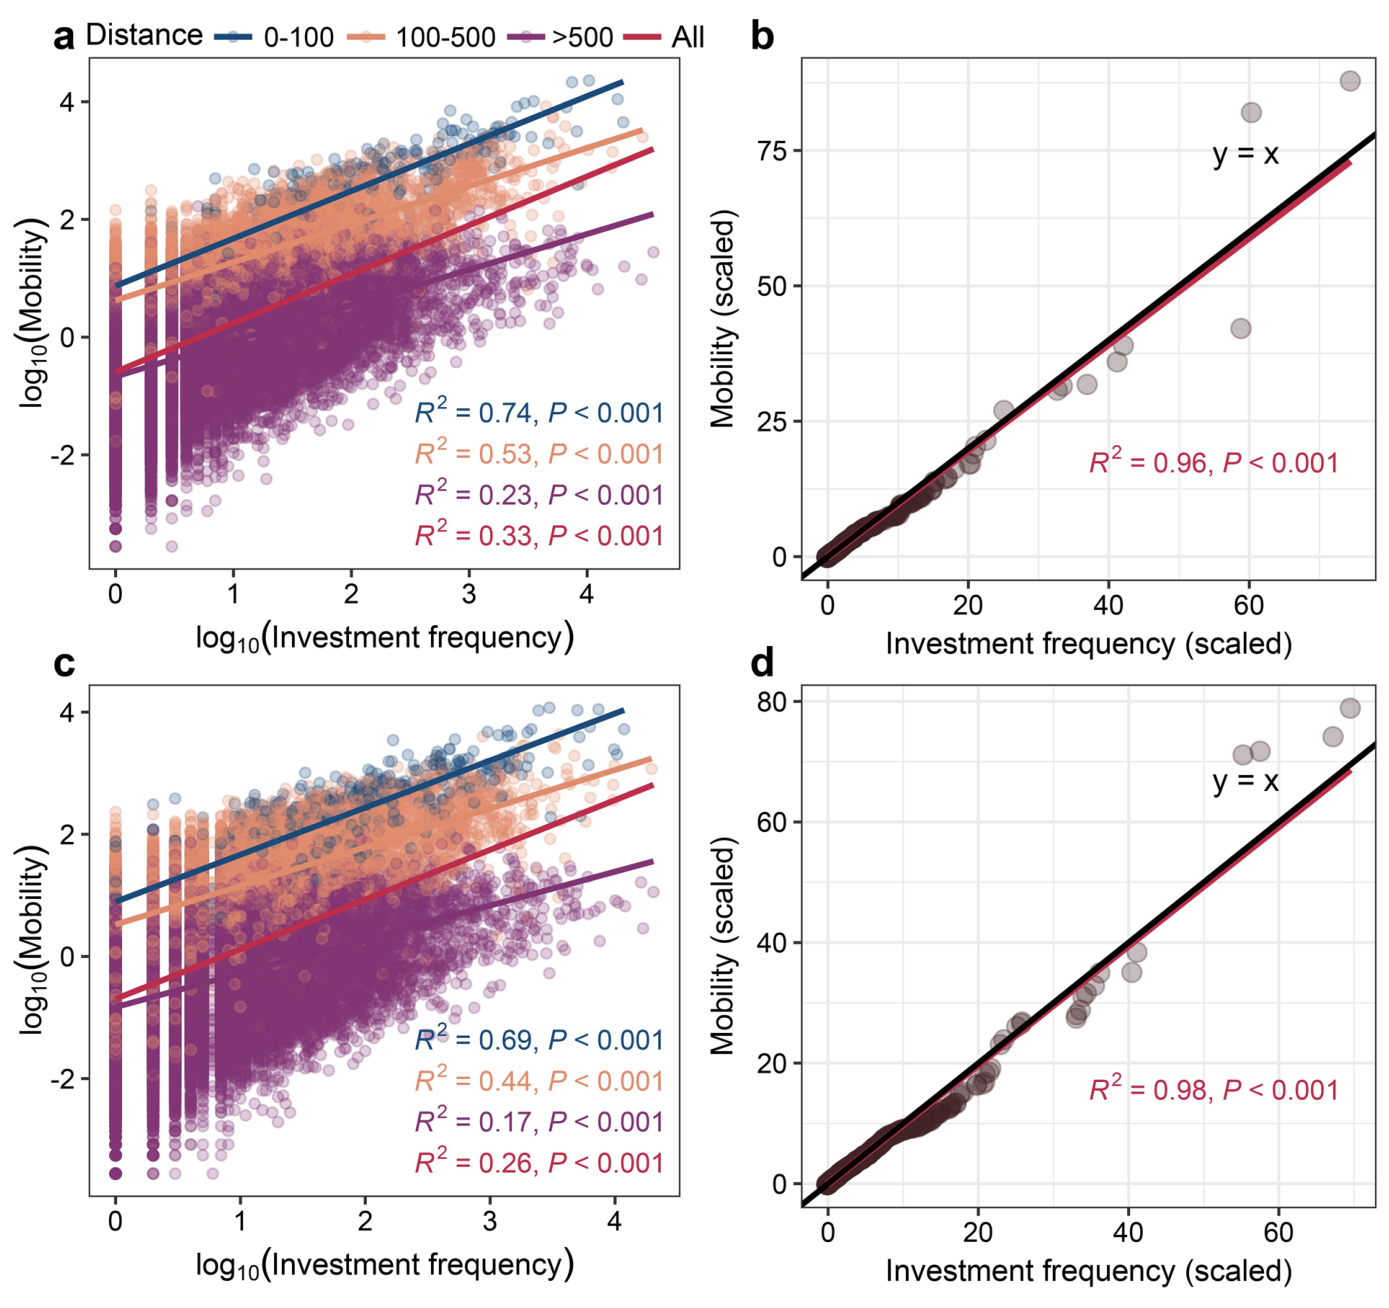
图 6|城市对对应得上,与总体分布相像,是同一个问题吗?
(a)无向网络的城市对散点:横轴为投资频次的对数,纵轴为流动指数的对数;颜色区分距离段,整体 R² 为 0.33,0–100 公里组为 0.74。
(b)无向网络的标准化分位数比较,R² 为 0.96;检验的是分布形状。
(c)有向网络的城市对散点,整体 R² 为 0.26,0–100 公里组为 0.69。
(d)有向网络的分位数比较,R² 为 0.98。分位数接近不意味着每条 A→B 联系都预测准确,更不能证明投资引起人口迁移。来源:原论文 Fig. 6。
近距离城市对的对应更强,提示两类联系在都市区域尺度上更紧密。不过,2020 年本身有特殊出行背景,而且人口参照只验证这一年,不能自动保证 2000 年也有同样拟合程度。
和引力模型、距离衰减一致,就足够说明真实吗?
经济引力模型(economic gravity model)假设两城交互随两地 GDP 增大而增强、随距离增加而减弱。这里的距离是城市中心点直线距离。作者通过粒子群优化选择参数,使模型预测与投资频次的均方根误差尽量小,再比较拟合。
这一步检验投资结构能否由经济规模和距离概括;参数正是拿这份投资数据校准的,因此它不是完全独立于数据生成过程的外部准确率测试。
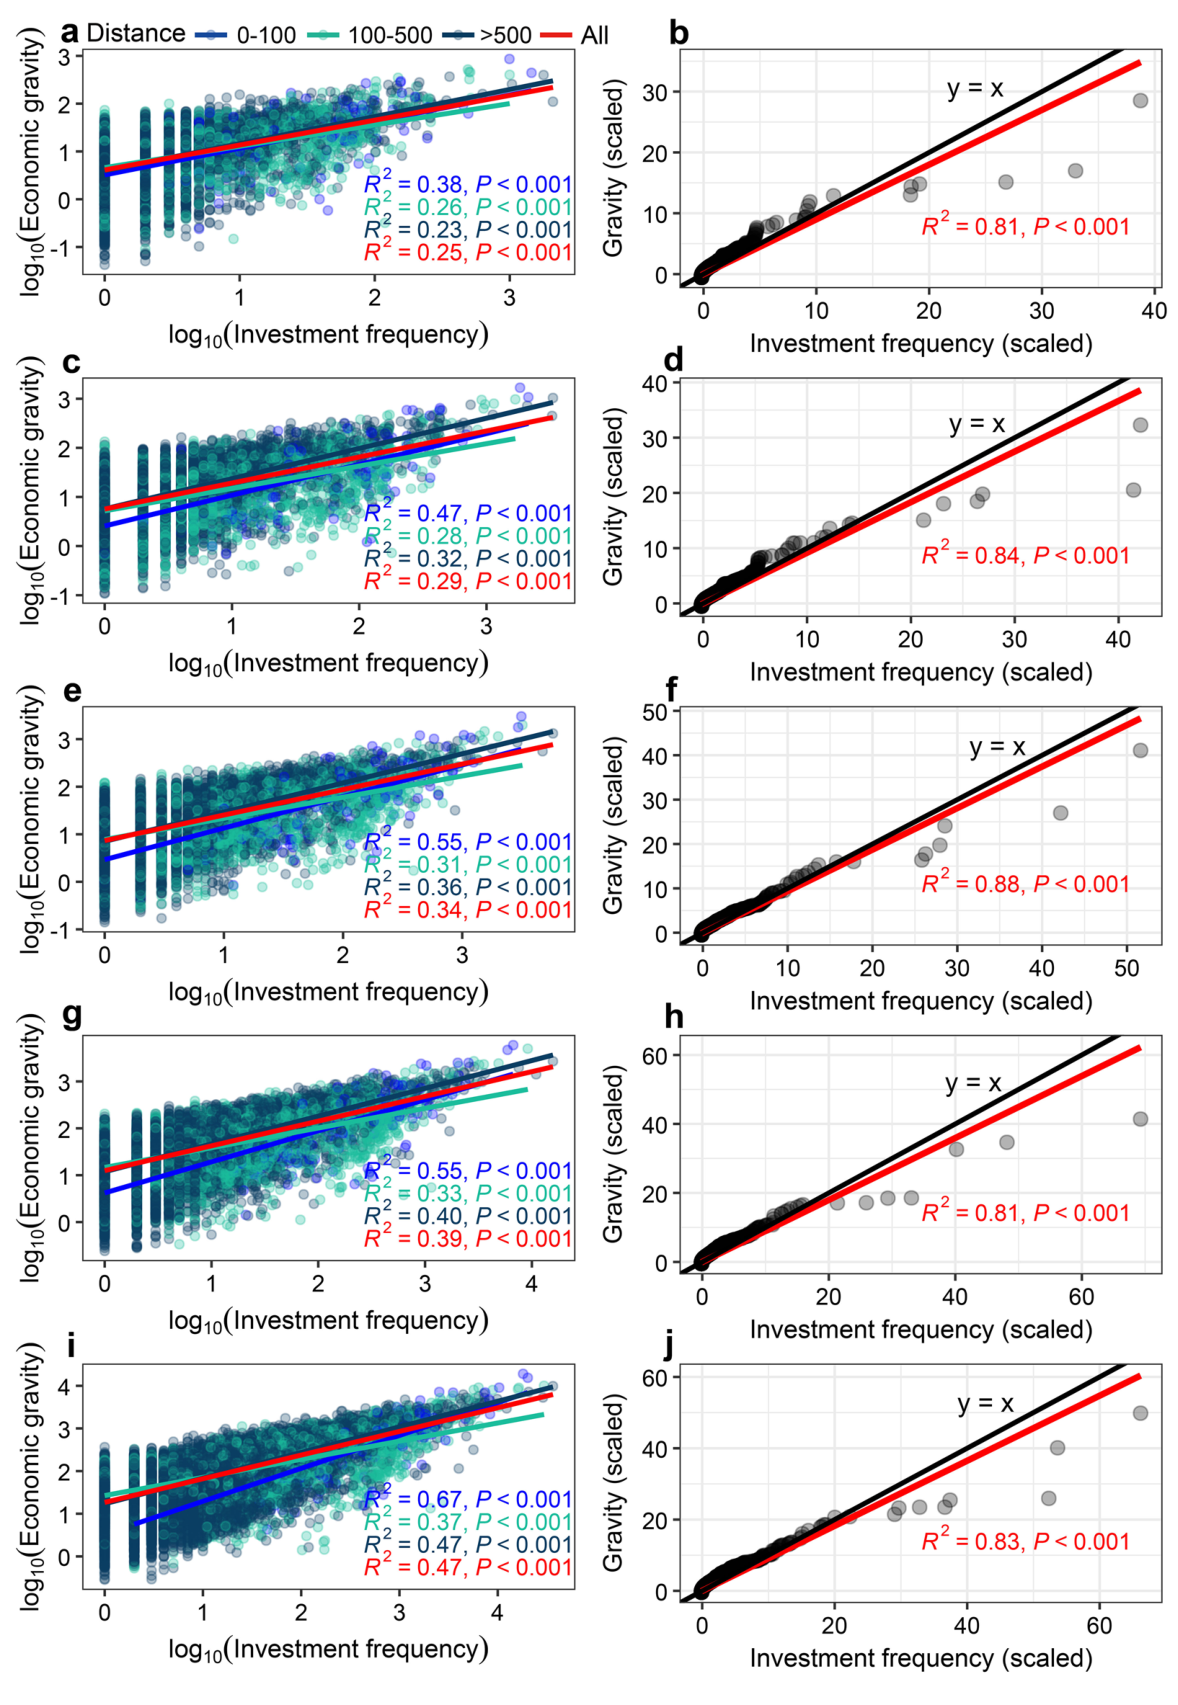
图 7|简单的规模和距离,能概括多少结构?
(a、c、e、g、i)分别为 2000、2005、2010、2015、2020 年的城市对散点。横轴是投资频次对数,纵轴是模型经济引力对数,颜色区分距离段;整体拟合 R² 从约 0.25 增至 0.47,短距离组较高。
(b、d、f、h、j)对应五年的分位数图,比较标准化后的分布,R² 都超过 0.8。右列较好的分布相似性不能替代左列城市对层面的对应。来源:原论文 Fig. 7。
原论文表 5 另列原尺度的 Pearson 相关系数,2000 年整体为 0.608、2020 年为 0.740;它与图中对数散点的 R² 不在同一个口径,不能互相替换。
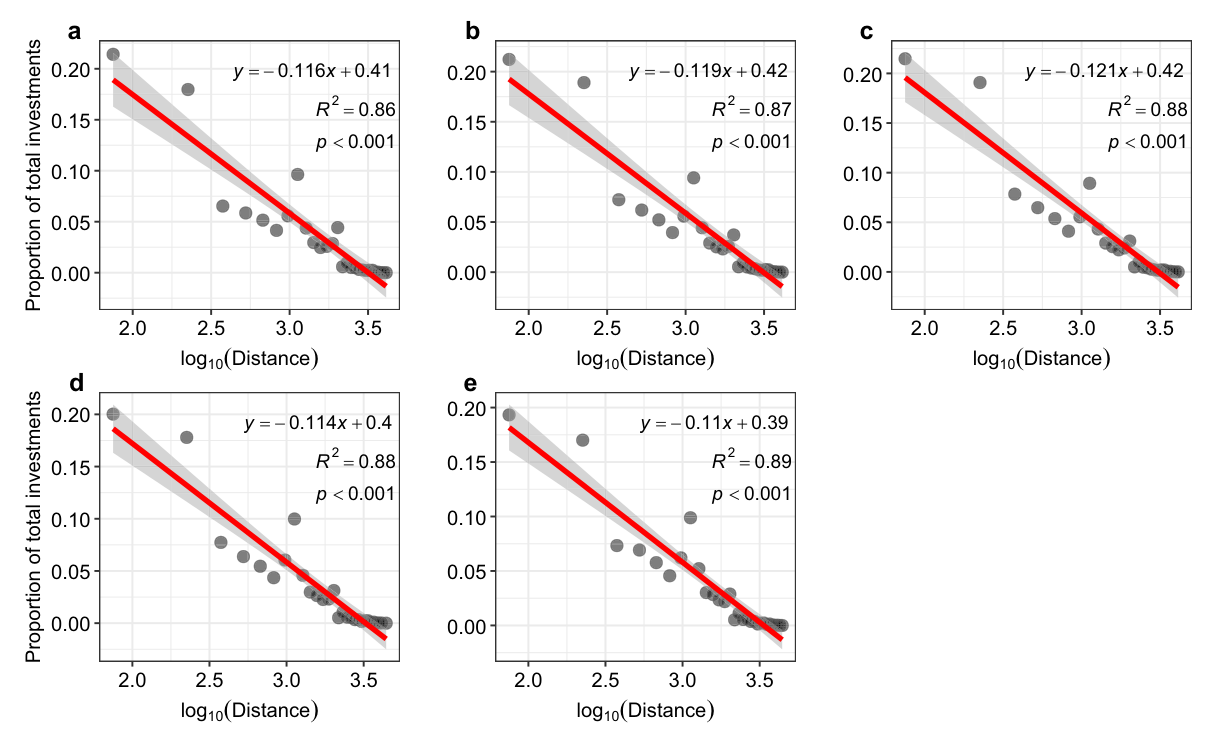
图 8|距离更远,投资关系的频次份额怎样变化?
(a)2000 年、(b)2005 年、(c)2010 年、(d)2015 年、(e)2020 年。横轴为距离的十进对数,纵轴为各距离段占总投资频次的比例,灰点和红线表现分布及拟合。五年都呈负向趋势,期末斜率绝对值略小,但中间并非逐次单调变化。来源:原论文 Fig. 8。
这张图体现的是不同距离段的总投资份额,没有进一步按每个距离段存在多少可投资城市对归一化。因而,不能直接推导成某家企业的距离偏好,更不能说“距离翻倍,一次投资的概率降低多少”。
与已有研究的比较则聚焦中心城市名单。原论文表 6 中,前二十城市的重合通常为 14–16 个。它支持主要枢纽识别相近,却不能证明弱联系、全部方向与所有年份都同样可靠。
用频次代替金额,真的看到了同一张网吗?
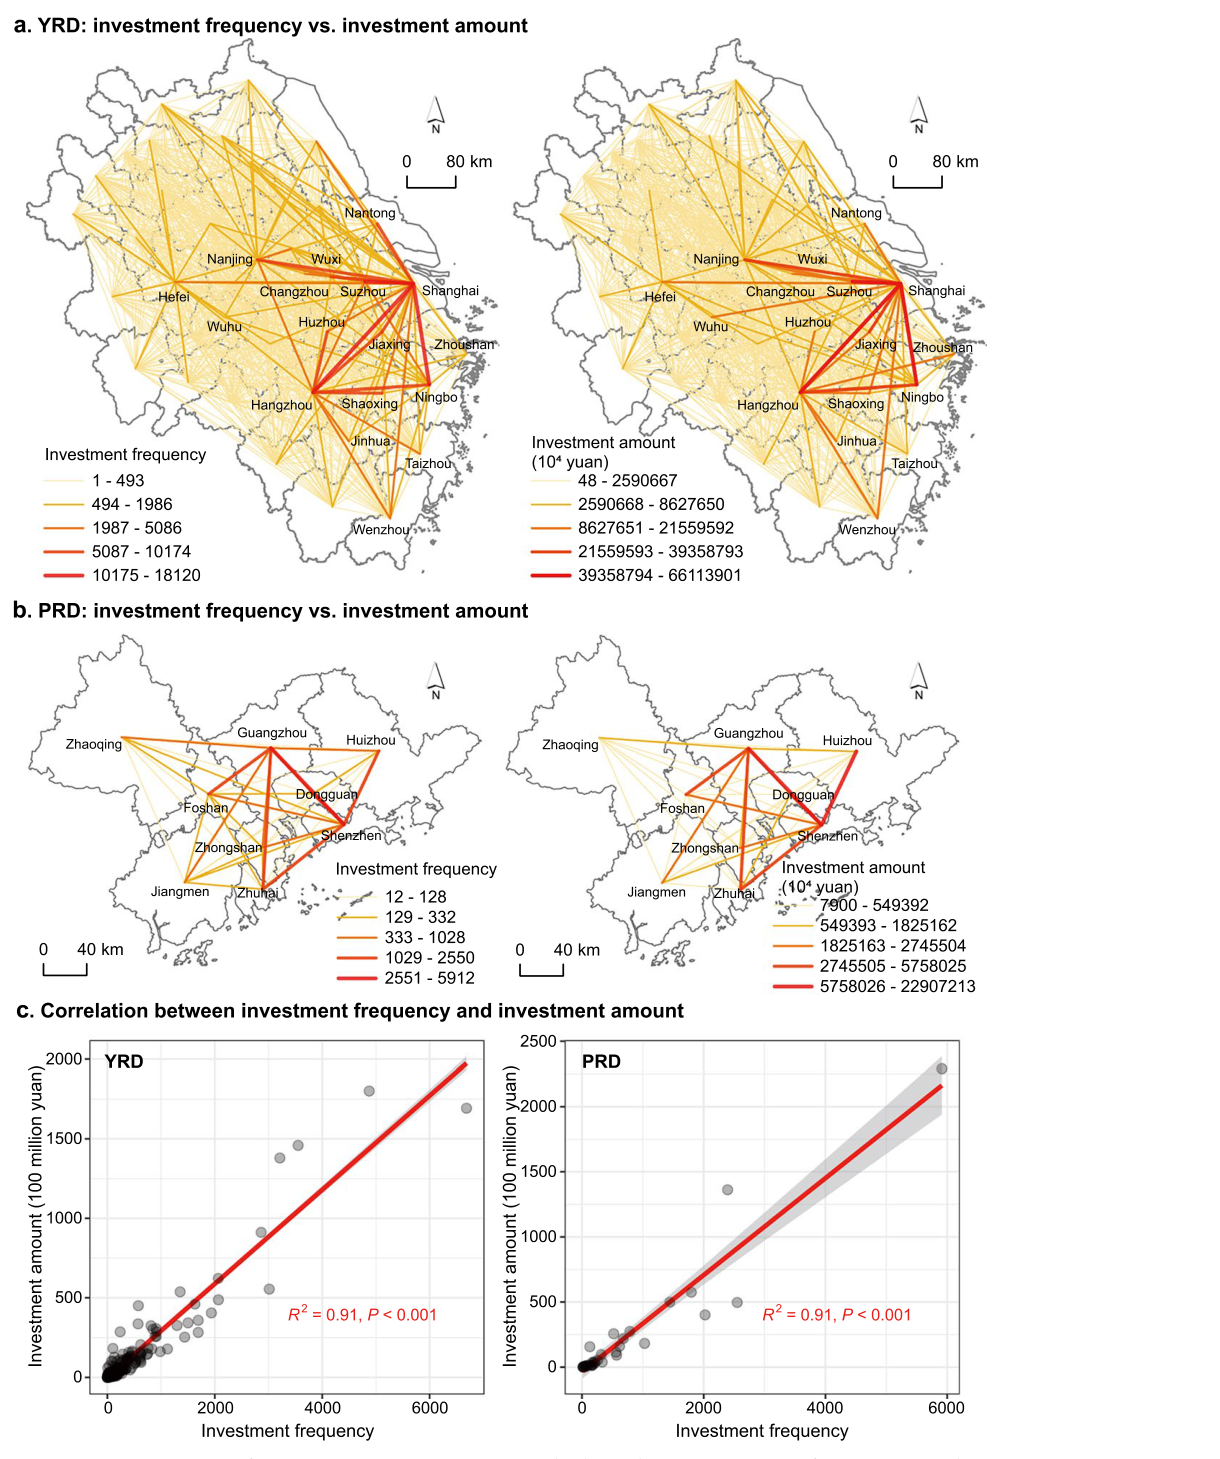
图 9|很多次小投资,与少数大投资,会不会给出不同结构?
(a)长三角 2020 年网络,左侧按频次,右侧按金额分级;两图的单位和图例不同,不能直接用同一种颜色读取相同强度。
(b)珠三角 2020 年的对应比较,同样区分频次与金额。
(c)两个区域的频次–金额散点,横轴为频次,纵轴为金额,R² 都约为 0.91。该结果说明这两个样本地区的结构较接近,不证明全国、所有年份或每笔投资的频次和金额可以互换。来源:原论文 Fig. 9。
作者选择数据较好的长三角和珠三角做这项检查,有助于理解权重选择;但早年金额缺失较多的地区并未因此得到同等验证。如果问题本身就是资金规模、某类融资或单笔交易金额,这套频次网络不能直接回答。
另一个限制是注册地与实际控制地可能不同。投资机构有时在其他城市设立专门实体,再由实体投资企业。原论文表 7 将“机构→实体”“实体→被投资者”“机构→最终被投资者”分为三层,同城比例分别为 53.6%、28.7%、26.2%。样本中这类情况在总体网络频次中占比较小,但若集中于少数城市,仍可能明显改变局部解释,不能只凭全国占比就认定每个城市不受影响。
怎样复用,才能保住这份数据的含义?
原论文表 2–4 对应三类公开表:有向城市对、无向城市对和节点指标。表内含行政区代码、中英文名称、中心点坐标、距离、年份和投资频次;节点表还提供三项指标及排名。数据附有包含同城投资的版本、城市信息、人口流动、GDP 和代码。
复用时至少应固定四个选择:使用有向还是无向,是否包含同城关系,选哪一个五年时点,以及权重是频次还是自行另取的金额。代码字段比城市名字更适合连接其他资料;若其他资料使用不同年份行政边界,还要处理区划变化。
地图上的直线连接只是城市间关系的表达,不是资金经过的实际线路。观察到联系增长也可能与企业登记覆盖、存续和历史信息完整程度有关;在研究具体政策时,仍要另外建立对照和识别设计。
一句话总结
这套数据把企业投资关系转成可研究的城市网络,最适合回答谁与谁联系更密切,而不能把登记频次直接当成资金流量或因果机制。
核心来源
- Shu, T., Yang, S., Yu, T., et al. (2025). An intercity investment network dataset of China based on the enterprise registration records (2000–2020). Scientific Data, 12, 369. DOI: 10.1038/s41597-025-04658-w。全部九张原图来自该论文。
- Figshare 数据与代码:正文中的公开表复算对应本仓库的有向、无向 Excel,核对日期为 2026 年 10 月 25 日;论文表数与文件数已分别说明。
作者介绍
- Tianheng Shu:共同第一作者,署名清华大学建筑学院,参与研究设计、数据处理、分析、验证与写作。
- Shuo Yang:共同第一作者,署名清华大学建筑学院,参与数据处理、分析、验证与写作。
- Taofang Yu:通讯作者,署名清华大学建筑学院,参与研究设计、验证与指导。
- Guangyu Cheng:署名香港大学建筑学院房地产与建设系,参与数据分析与可视化。
- Yitian Ren:署名西交利物浦大学城市规划与设计相关部门及空间分析与政策实验室,参与数据分析与可视化。
- Fangchen Shi:署名北京大学政府管理学院,参与原始数据收集与处理。
- Ben Derudder:署名鲁汶大学、根特大学及哥白尼大学相关研究机构,参与数据验证。
- Xia Liao:通讯作者,署名中国科学院地理科学与资源研究所,参与研究设计、数据处理、验证、指导与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
城市网络的“中心”取决于我们数什么。按频次,频繁参与许多中小交易的城市可能突出;按金额,一笔巨额交易就可能改变排序;按最终控制地,又可能把注册在政策优惠地区的关系重新归回其他城市。几种地图不一致,不一定意味着其中只有一张是真的,而是它们分别刻画了经济组织的不同层次。
一个后续检验可以把频次、可用金额与控制机构位置并列,观察中心城市和区域社群对权重与定位规则是否稳定。对稳定的部分可以更有把握地讨论结构,对高度敏感的城市则应回到企业关系解释。这样,开放数据的意义不仅是让更多人画出同一幅网络,也包括让不同解释能够被复算和比较。