一片将被水库淹没的村庄,人口地图为什么数不齐人?
论文名片|Josias Láng-Ritter、Marko Keskinen、Henrikki Tenkanen,Global gridded population datasets systematically underrepresent rural population,Nature Communications 16, 2170(2025)。原论文。
要估计洪水会影响多少人,常见方法是把危险范围叠到人口网格上,再把格内人数相加。但地图中一块颜色很淡的土地,可能真的人少,也可能只是村庄没有被可靠识别。后一种情况会把数据误差带进救灾、医疗和基础设施的需求判断。
这篇论文找到了一种特殊的外部参照:大坝建设时报告的搬迁人数,以及建成后水库覆盖的范围。把蓄水前的人口地图与这些记录比较,就能检验地图有没有在这些农村地区漏分人口。研究发现明显的局部低估,但不能把这一结果直接外推成全球总人口漏算了多少。
先说结论
- 研究选出 35 个国家的 307 个水库影响区,评估人口地图参考年份 1975—2010 年。它不是全球农村的随机代表样本,也没有检验 2015、2020 年及之后的人口层。
- 五类产品在各自可用样本上的总量偏差均为负,从 WorldPop 的 −53.4%到 GHS-POP 的 −83.8%;不同产品的样本数和年份并不一致。
- 2000 年共有的 33 个地区提供同年比较,显示同一地点在不同产品中的估计有时相差多个数量级。
- 去掉中国样本、改变参考年份等检验仍提示低估风险,但具体幅度和产品排序会变化。局部空间分配误差不等于全国或全球人口总量漏计。
五张地图画的是同一个地方,为何差这么远?
原文以越南 Na Hang 水库附近为例,展示 2000 年五种人口图。该水库在 2008 年建成,记录搬迁 4000 人。各图对应相同地理位置,却给出不同的人口分布:有的较平滑,有的依赖聚落识别,把人集中在少数格。
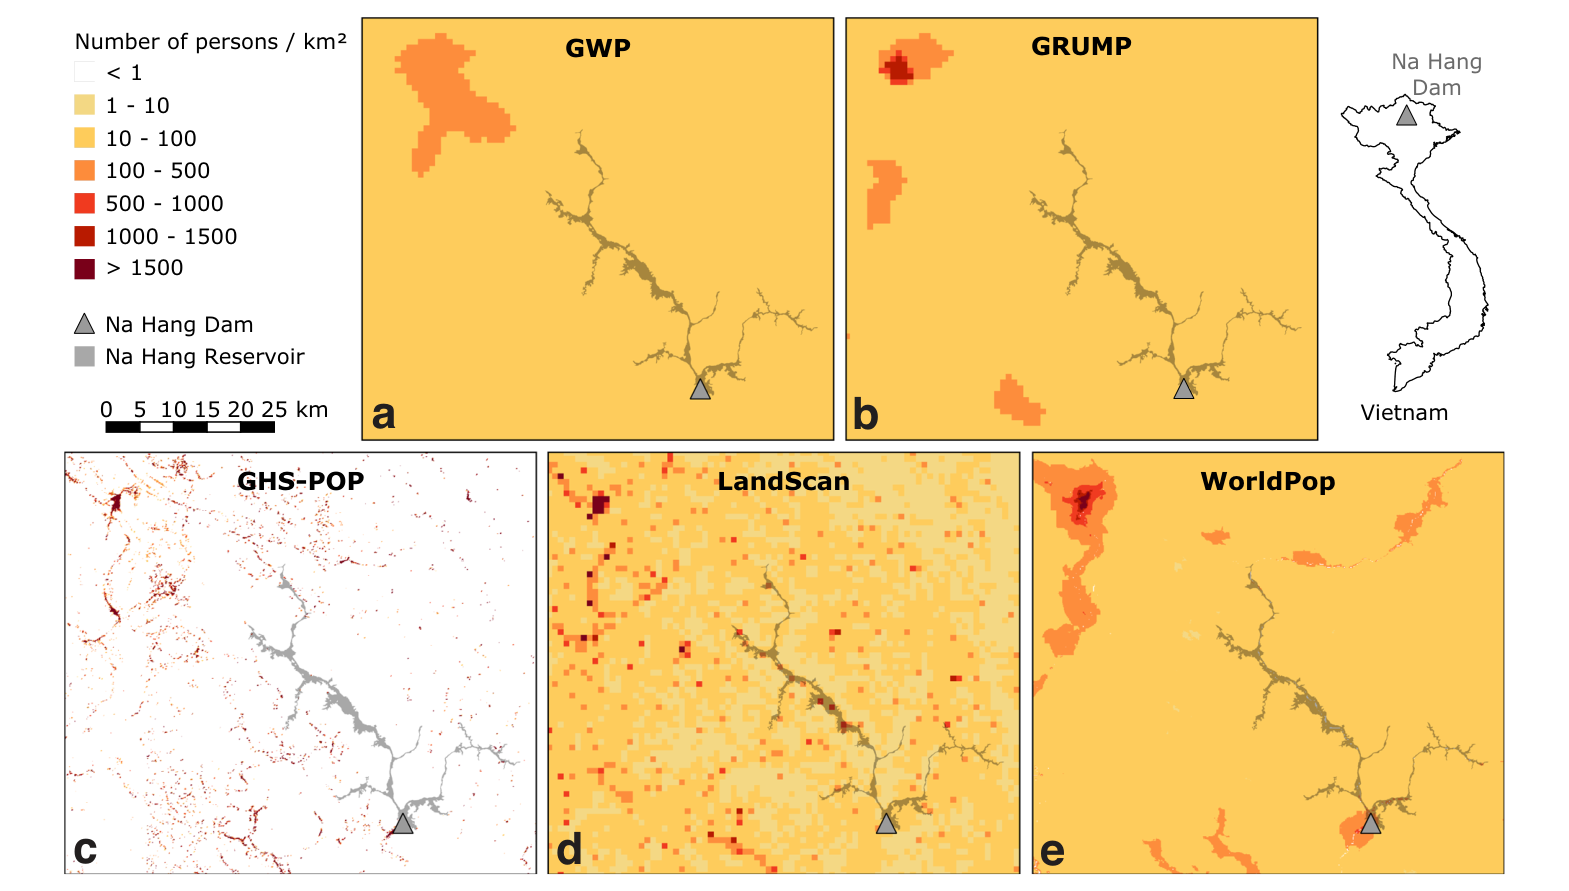
图 1|同一片将被淹没的土地,人口图是否讲着同一个故事?
(a)GWP,原论文采用这一缩写指 Gridded Population of the World,通常也称 GPW;(b)GRUMP;(c)GHS-POP;(d)LandScan;(e)WorldPop。颜色均表示每平方公里人口,灰色多边形为后来的水库,三角符号为坝址。共同图例使空间差异可见,但视觉差异本身不能判断谁对,需要外部人口参照。来源:原论文 Fig. 1。
表 1 说明纳入产品的空间与时间区别:GWP、GRUMP、LandScan 主要采用约 1 公里网格,GHS-POP、WorldPop 采用约 100 米网格。研究选择能匹配历史验证期的五类产品,WorldPop 使用非约束版本;对于可选产品,正文使用经联合国全国人口总量调整的版本。未纳入的 HYDE、HRSL、Kontur 是因分辨率、时段或地理覆盖不满足这项设计,不能据此认定它们更好或更差。
大坝搬迁记录,为什么能用来查人口图?
人口图通常把普查行政区总量重新分配到网格。如果再用相同普查区总量验证,就可能只证明模型遵守了输入约束,无法检验县内村庄是否被分对。
水库淹没区通常跨越或切开行政区,搬迁记录又来自大坝项目报告,因此提供另一种范围和计数来源。研究从 ICOLD 大坝记录取得搬迁人数、最大库区面积和完工年份,再与 GeoDAR 水库多边形匹配。
筛选要求包括:有搬迁数据,水面面积大于一平方公里,1980 年及以后建成,影响区人口密度低于每平方公里 1500 人。研究还排除跨国水坝和原地已有库区的改建等模糊案例,最终得到 307 个区域,面积合计约 22,489 平方公里。
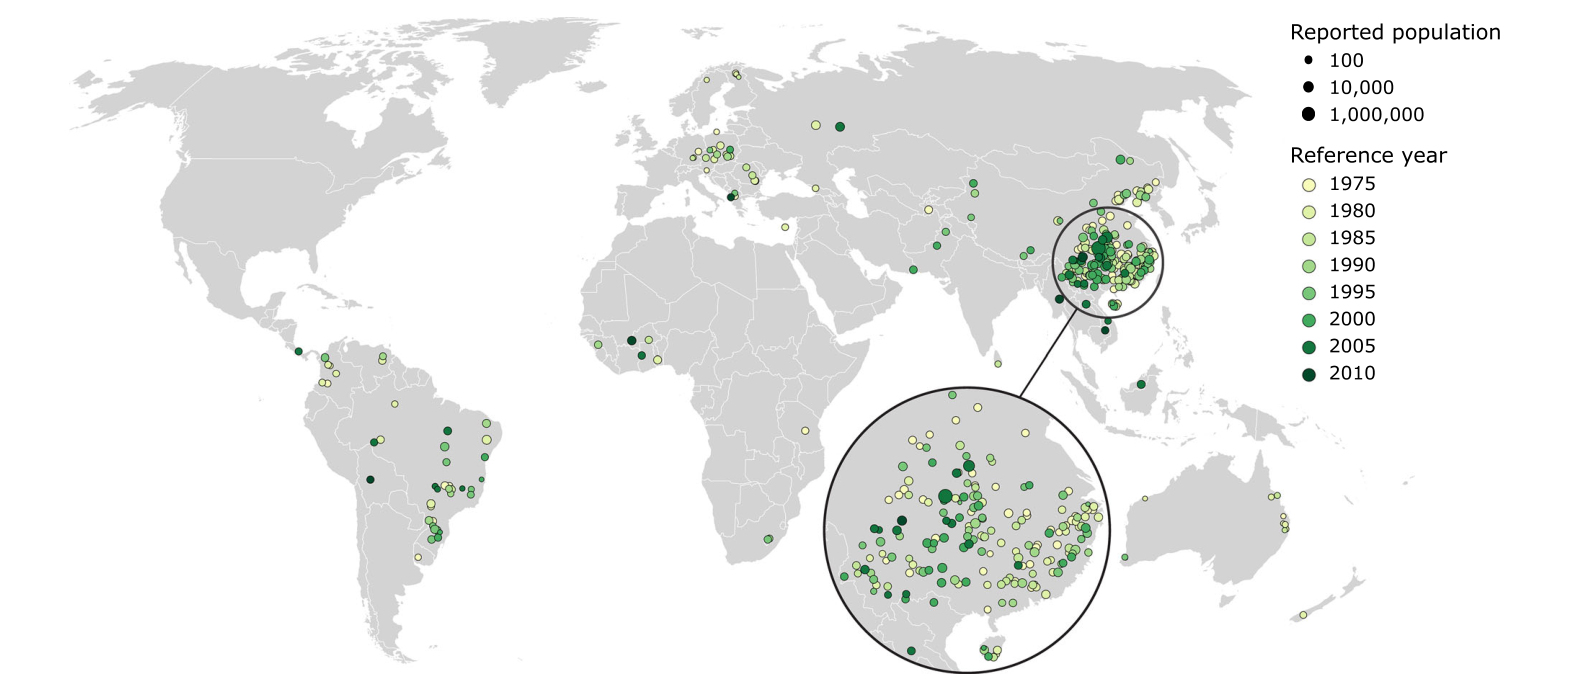
图 2|验证样本分布在哪里?
本图没有字母子图。圆大小对应报告人口,颜色对应人口地图参考年。中国有 203 个库区,巴西有 30 个,其他多数国家较少,北美没有样本。点遍布多个地区,并不意味着构成统计代表性的全球农村样本。来源:原论文 Fig. 2。
时间也必须对齐。水坝完工时居民通常已迁出,不能拿完工后人口与搬迁前人数比较。主分析选取完工前 5—9 年的五年整数间隔人口层,尽量对应搬迁前状态。具体搬迁可能早于或晚于这个统一窗口,所以它是一条工作假设,而非每个项目都已查明的搬迁日期。
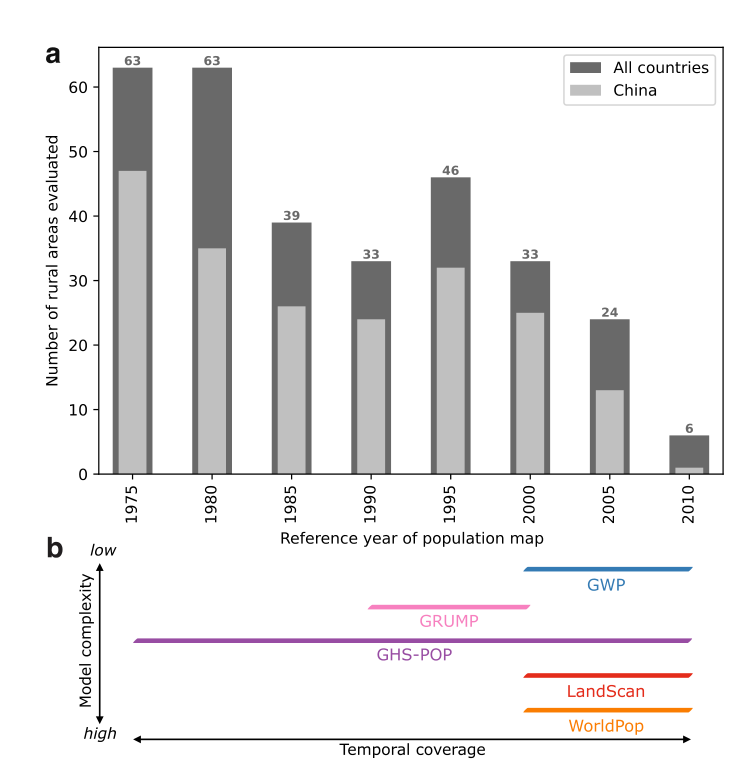
图 3|比较时是否真的用了同一时期、同一批地方?
(a)各参考年份的样本数,深浅区分全部国家与中国;晚近年份可用验证样本更少。
(b)各产品的时间覆盖与大致模型复杂程度。只有 2000 年同时被五种产品覆盖,因此同年共同样本比较与跨年全样本比较要分开看。来源:原论文 Fig. 3。
库区边界少画了一部分,会不会制造低估?
研究将原网格人口均匀细分到 10 米格,再累加中心落在水库多边形内的格。这个细分主要改善边界截取,并没有凭空创造 10 米人口信息;原格内部的人口仍被假设均匀分布。
卫星提取的水面又可能低于最大蓄水范围。研究比较 6095 个库区的几何面积与 ICOLD 报告面积,排除极端面积比后,得到多边形面积平均偏低 18.8%,于是把每个库区提取人口统一乘以约 1.23。
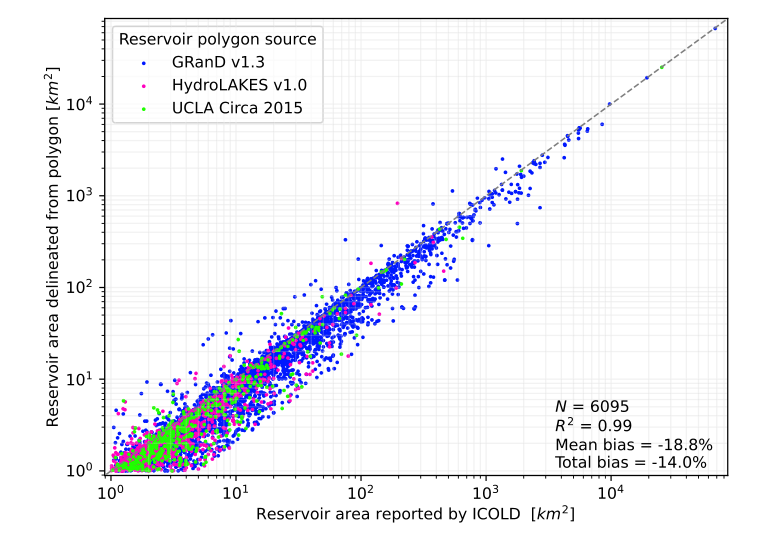
图 9|人口计算的空间边界,本身差了多少?
本图没有字母子图。横轴为 ICOLD 报告库区面积,纵轴为三类来源多边形面积,均为对数尺度;颜色区分 GRanD、HydroLAKES 与 UCLA Circa 2015 来源,虚线为一比一。总体几何面积偏小是统一人口修正系数的依据,但不能证明每个库区都应补同样比例。来源:原论文 Fig. 9。
这道修正已经提高了人口图估计,使低估幅度比不修正时减轻。不过它还假设缺失部分与已画部分人口密度相同。岸边村庄可能恰好集中在遗漏区域,也可能相反,因此平均面积修正不能替代逐项目的边界核对。
低估一半,分母到底是什么?
总量偏差的定义是:全部预测人口之和减去全部报告人口之和,再除以报告人口之和。−53.4%意味着在 WorldPop 所含样本中,预测总量约为报告总量的 46.6%;不是每个地方都漏掉 53.4%,也不是全球农村人口有 53.4%从普查中消失。
另一指标为对称平均绝对百分比误差(sMAPE)。本文逐点计算预测与报告的绝对差,除以二者之和,再取平均,取值在 0—1;它衡量相对差异而不区分高估低估,且采用了没有乘 2 的定义。它不同于用报告人口作分母的普通百分比误差。
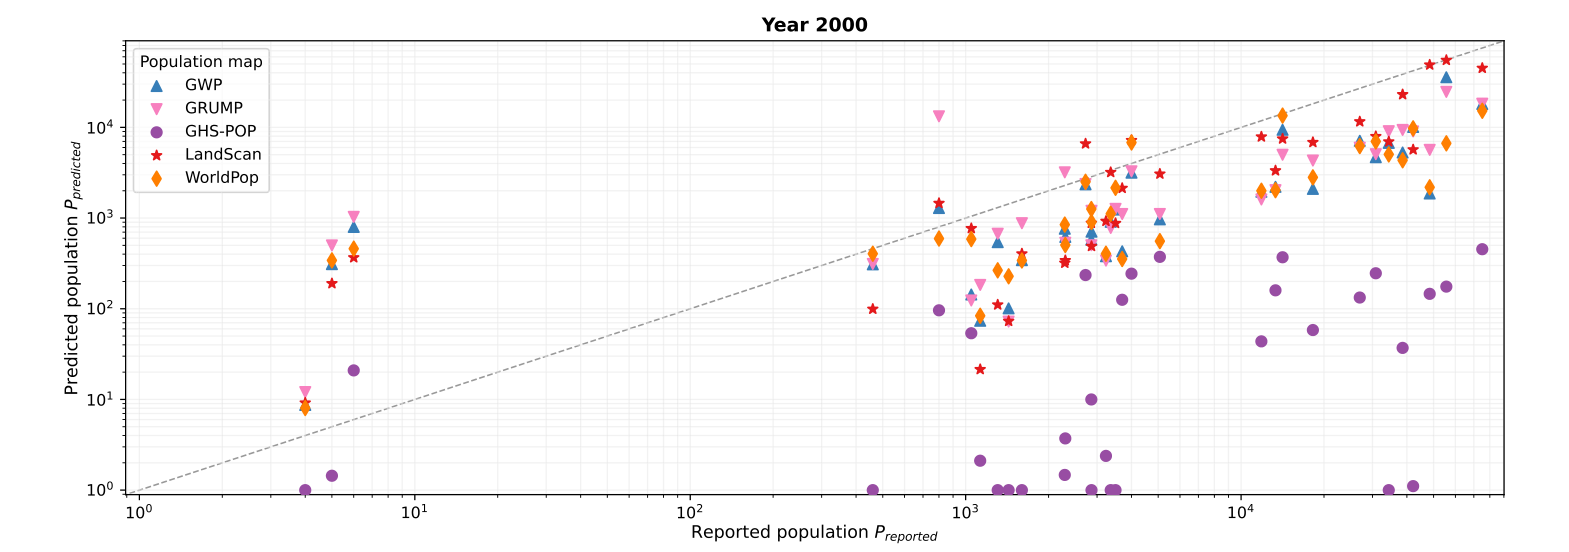
图 4|控制参考年份后,产品之间仍有明显差异吗?
本图没有字母子图。横轴为报告人口,纵轴为产品预测人口,均为对数尺度;一组竖直排列的五个点对应同一库区,虚线为一比一。33 个共同地区中,多数预测位于虚线下方,GHS-POP 在这组地区中估计最低;同一横坐标上的竖向距离显示产品差异。来源:原论文 Fig. 4。
跨所有可用年份后,GWP、GRUMP、GHS-POP、LandScan、WorldPop 的总量偏差分别为 −65.0%、−66.9%、−83.8%、−68.4%、−53.4%。图 5 中样本数分别为 63、112、307、63、63。尤其 GHS-POP 覆盖更多早期年份,不能把这组总体排序完全归因于算法差别;图 4 的共同样本才更接近控制时期的产品比较。
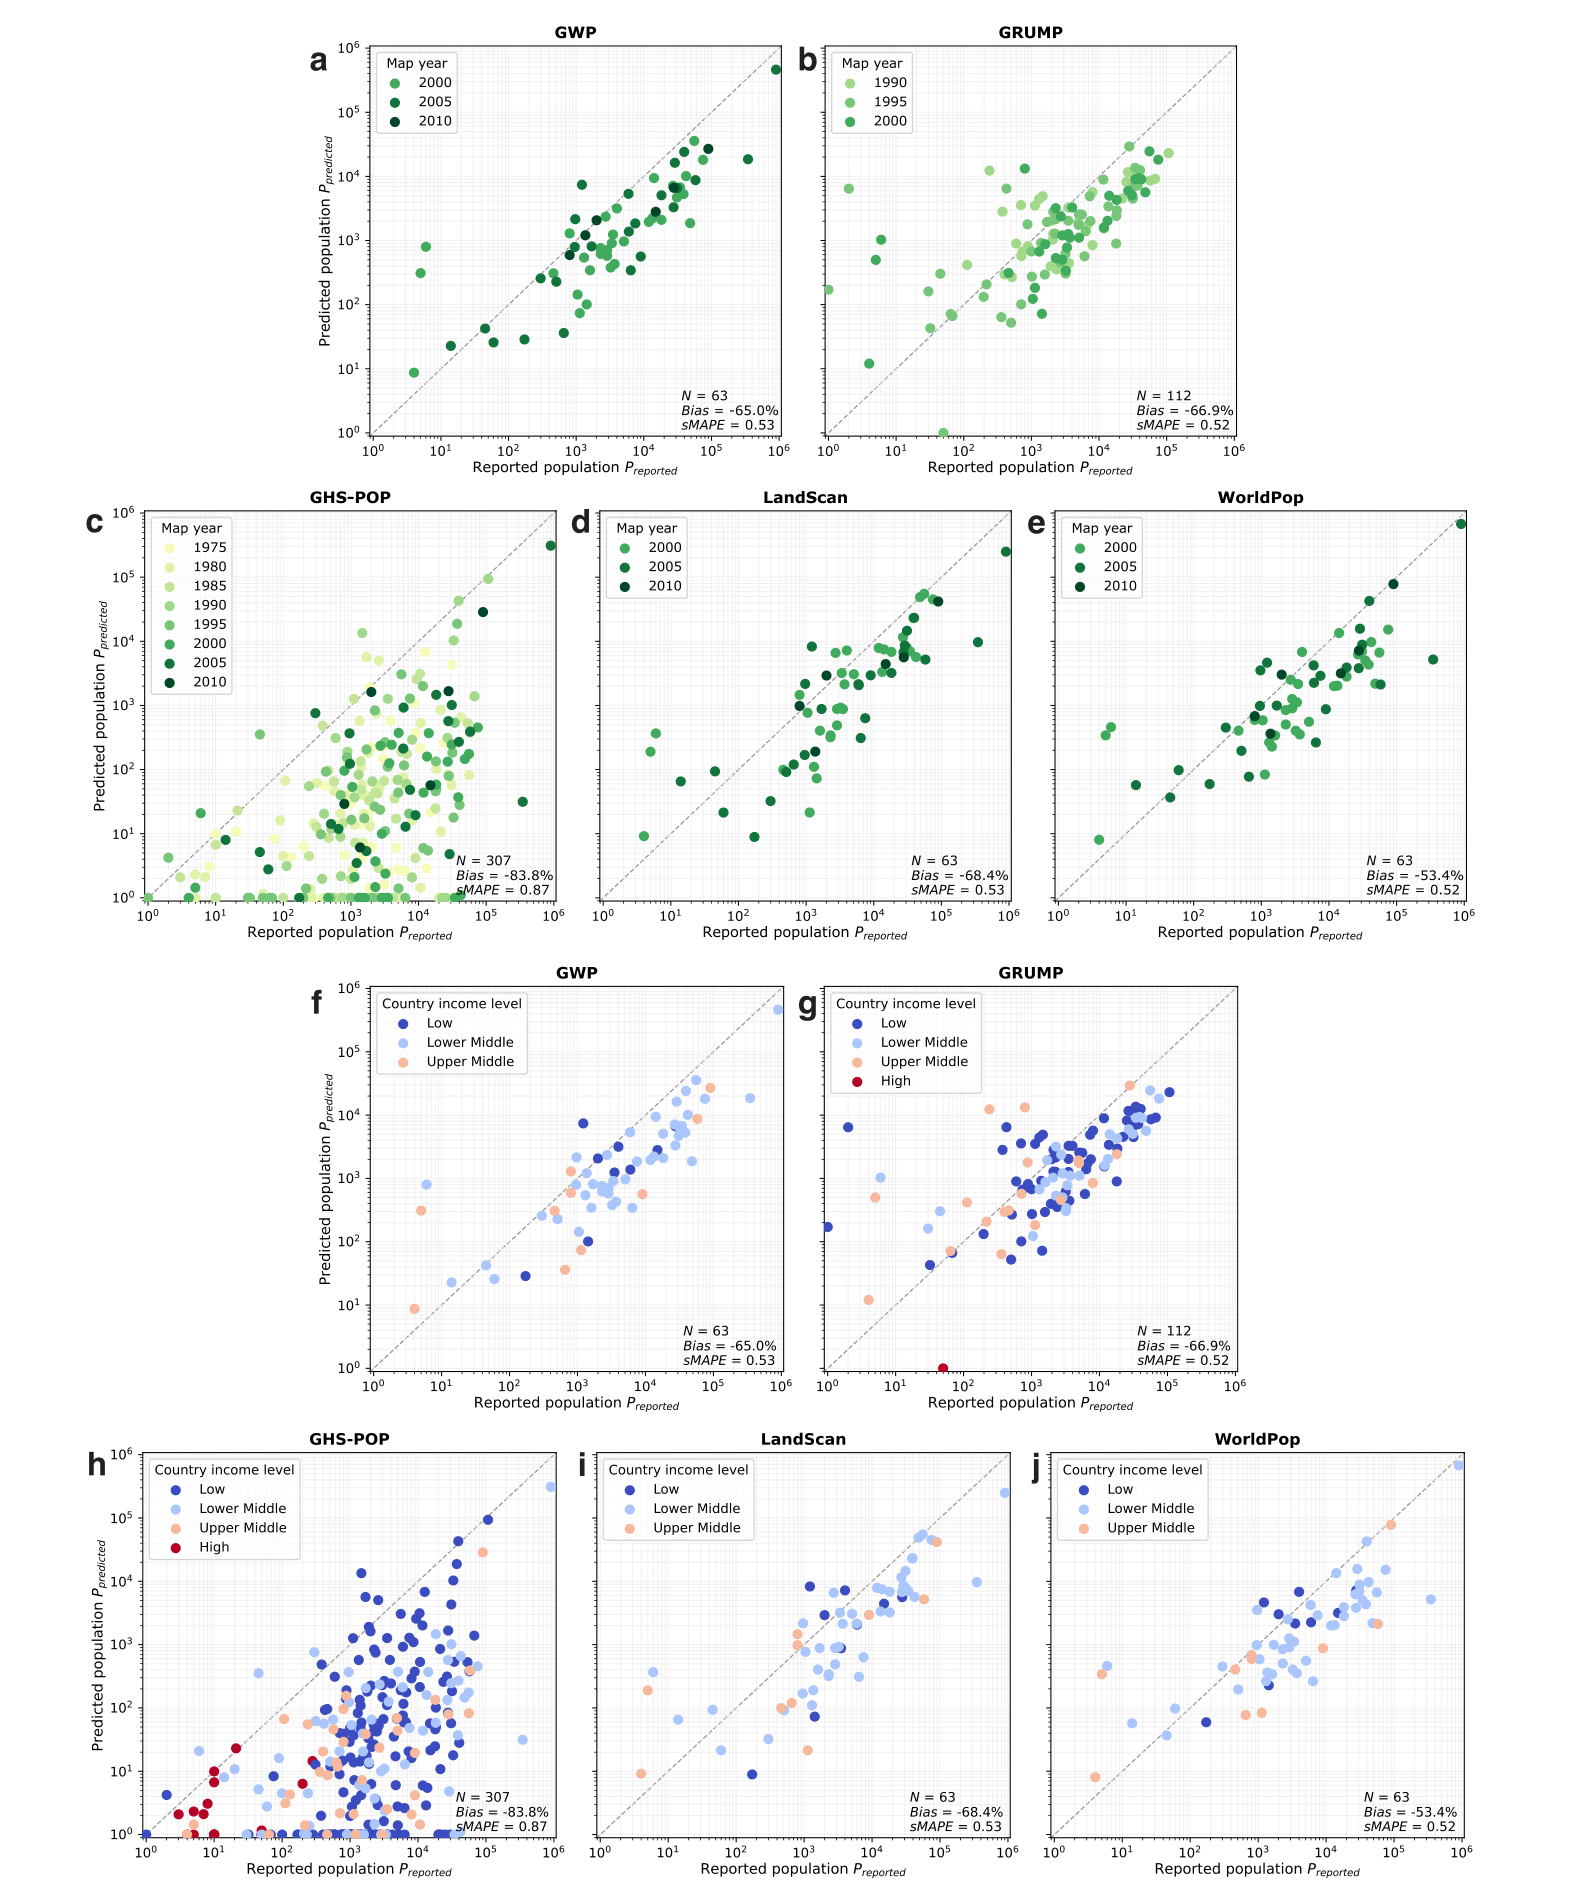
图 5|负偏差集中在某些年份或收入组吗?
(a、f)GWP;(b、g)GRUMP;(c、h)GHS-POP;(d、i)LandScan;(e、j)WorldPop。各图横轴为报告人口、纵轴为预测人口,虚线为一比一,均采用对数坐标。
(a—e)点色区分参考年份;(f—j)点色区分国家收入组。每点是一处在相应产品中可比较的库区,面板内给出该产品的 N、偏差和 sMAPE。大量点位于一比一下方,但每种产品的可用年份与样本量不同。来源:原论文 Fig. 5。
年份更近、国家更富,估计就更可靠吗?
WorldPop 的偏差从 2000 年约 −80%减轻至 2010 年约 −32%,但其他产品没有显示同样清晰的偏差趋势。年份间比较也不是在同一批不变地区上追踪质量,样本与项目背景会变化。
收入比较为了减少时期混杂,只分析参考年份 2000—2010 年的 63 个区域。原样本中高收入国家的 22 个案例都在 2000 年以前,因此这项较晚时期比较主要覆盖低、中低和中高收入组,不能据此断言高收入国家农村同样失准或收入永远没有作用。
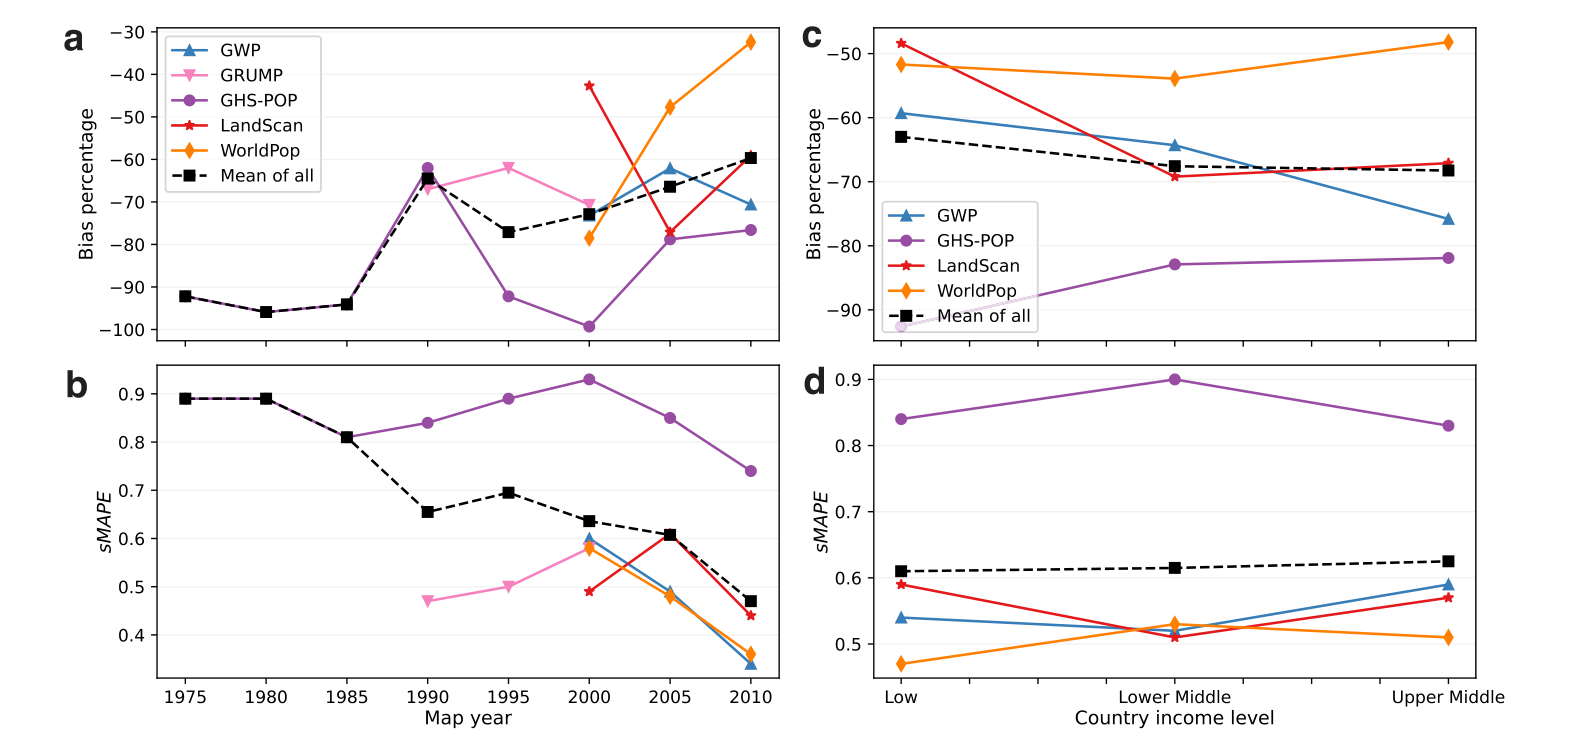
图 6|两个常见解释,是否得到支持?
(a)各参考年份的总量偏差;(b)各参考年份的 sMAPE,数值越接近零越好。
(c)2000—2010 年样本按国家收入组的偏差;(d)相同分组的 sMAPE。黑虚线表示产品均值,其他颜色对应各产品;样本中的组间差异不足以支持简单的收入越高就越准规律,但也不证明所有收入组在统计上相同。来源:原论文 Fig. 6。
一张国家地图,不能替代每个国家的验证规模
中国、巴西等样本相对多的国家,在各可比产品上都呈负偏差。一些接近零或为正的国家仅有一两个项目,可能被特定地点主导。全国涂色必须与项目数、参考年份和产品可用性一起读。
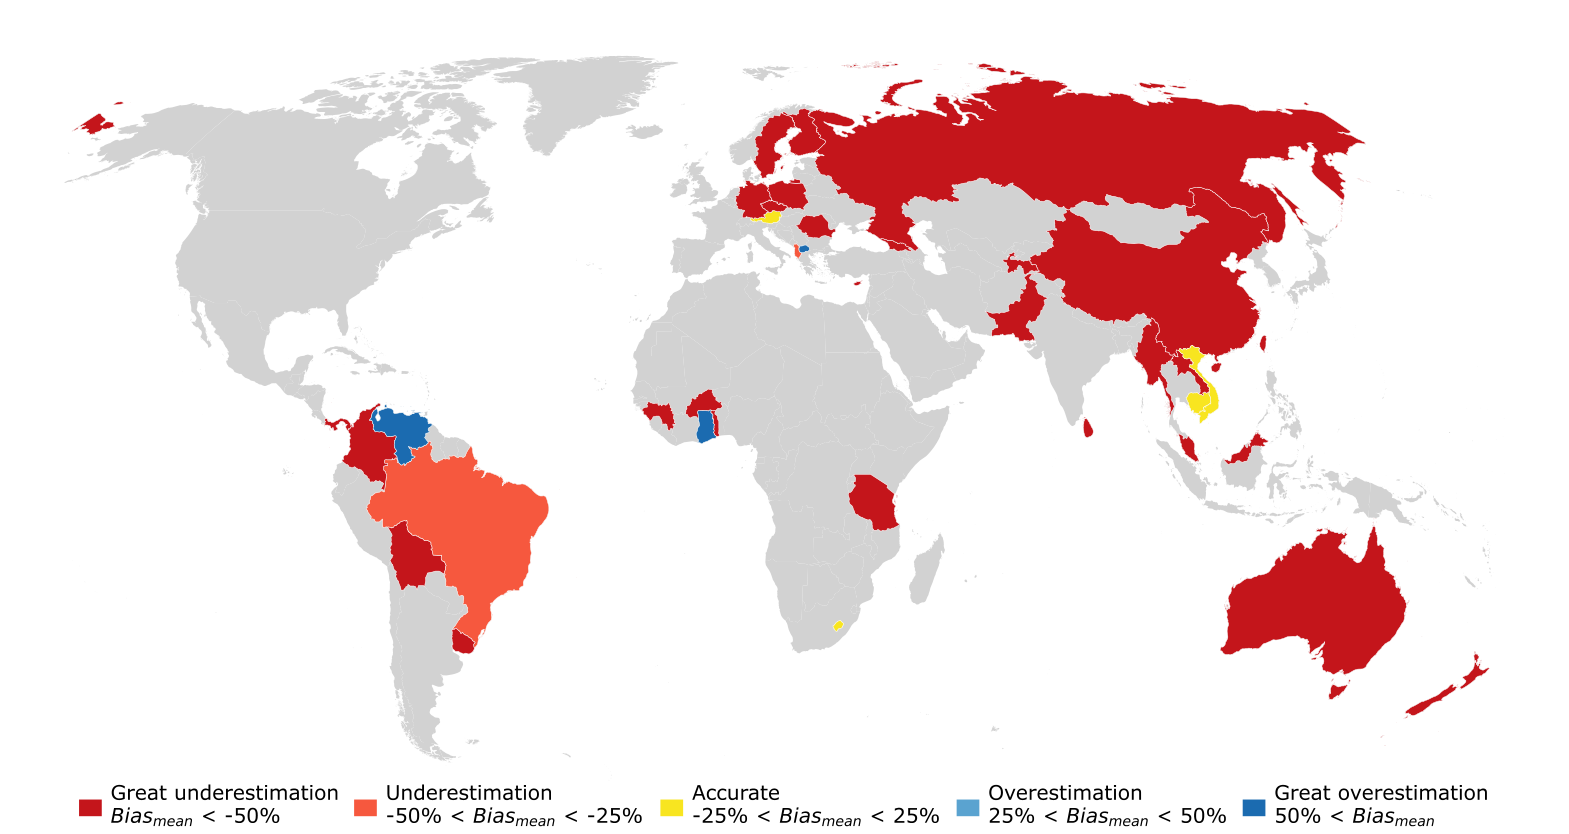
图 7|哪些国家的被检验库区呈现低估?
本图没有字母子图。颜色表示该国可用产品偏差的平均,红色为低估,蓝色为高估,黄色较接近零,灰色表示未纳入。不同国家未必拥有同样五种产品或同样年份,因此颜色不能直接当成国家普查完整率。来源:原论文 Fig. 7。
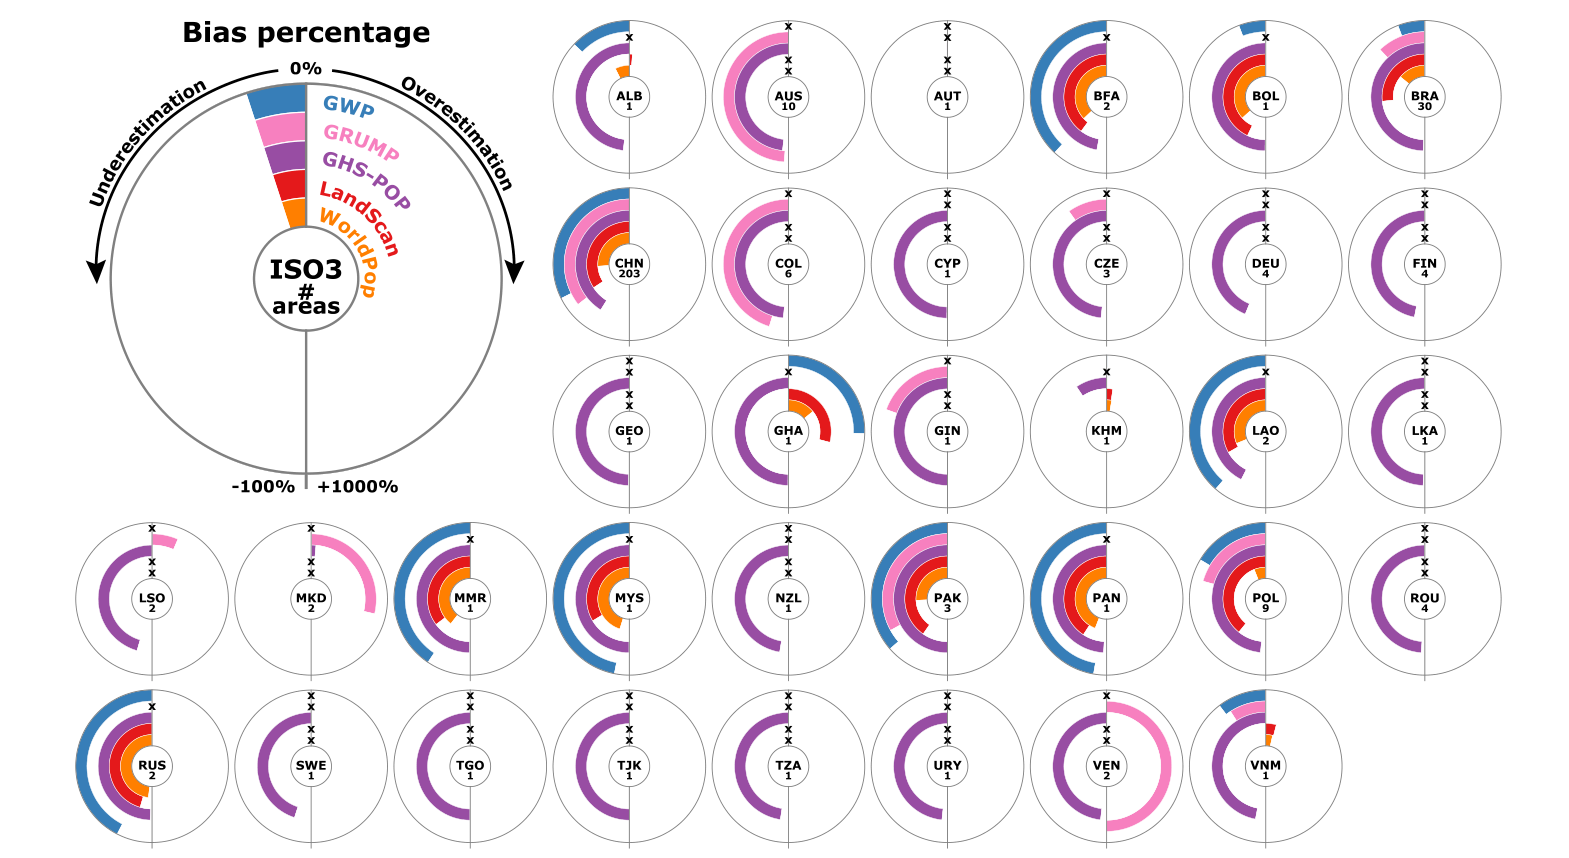
图 8|国家平均背后,各产品和样本数怎样不同?
本图没有字母子图。每个小圆对应一个国家,中心为 ISO3 国家代码及库区总样本数;各色圆弧对应五种人口产品,左右方向区分低估与高估,叉号表示缺乏可比参考年份。左上示意解释圆弧读法;样本很少的国家即使弧线很长,也不足以推出全国农村同等幅度偏差。来源:原论文 Fig. 8。
稳健性检验保住了什么,又改变了什么?
补充图 3、4 比较 WorldPop 分辨率与联合国总量调整,未消除负偏差。更有分量的是补充图 5:去掉中国后,GRUMP 偏差由 −66.9%变为 −12.2%,WorldPop 则由 −53.4%变为 −71.2%。补充图 7 将参照提前到完工前 10—14 年,LandScan 偏差由 −68.4%变为 −41.9%。这些结果仍有低估,却说明幅度和排序受样本与时间影响。补充材料
从局部漏分,到全球漏计,还隔着什么证据?
原论文提出,普查遗漏可能是多产品共同低估的来源之一;遥感难以识别分散村落、建筑掩膜过严、辅助数据不足也可能造成空间分配偏差。但这项设计没有把普查总量不足、网格重分配错误、库区边界误差与搬迁时间不齐分别识别出来,因而不能用一个局部偏差率直接修正全球总人口。
2026 年 Koebe 等人的回应预印本也对搬迁时间、统一面积修正与样本代表性提出质疑,并强调局部错分不能推出全球人口漏计。它是后续学术争论的一部分,不是已撤回原论文或已完成最终裁决的证据。回应预印本
此外,搬迁人数本身可能是估计、登记范围也可能不完全一致;样本集中在水库影响区,不是所有农村地形和生计类型;最新验证年份仅到 2010 年,无法据此宣布当前版本仍保持同等偏差。若把原论文的政策风险讨论写成过去医疗或救灾政策已经造成某一确定损失,也超过本文实际测量。
最稳妥的实际启示是,在目标地区做外部验证,并对不同人口层、空间边界和时间匹配做敏感性分析。一个较少偏差的总体结果,也不能保证某个村庄恰好被估对。
一句话总结
这些历史库区样本揭示了农村人口网格的严重局部低估风险,但风险幅度依赖样本、时空匹配与产品版本,不能直接改写成全球人口漏计比例。
核心来源
- Láng-Ritter, J., Keskinen, M. & Tenkanen, H.(2025)原论文,Nature Communications 16, 2170。本文图 1—9 均源自原论文。
- 原研究数据与代码归档 · 代码仓库。
- Koebe, T. et al.(2026)相关回应预印本,用于区分原论文发现与后续质疑。
作者介绍
- Josias Láng-Ritter:署名阿尔托大学建成环境系 Water and Development Research Group 及 GIScience for Sustainability Transitions Lab,为通讯作者;提出研究构思、开发分析与可视化代码、撰写初稿。
- Marko Keskinen:署名阿尔托大学上述水与发展研究组,参与研究构思、正式分析及稿件修改。
- Henrikki Tenkanen:署名阿尔托大学上述 GIScience 实验室,参与研究构思、正式分析及稿件修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一项服务规划最怕的,可能不只是人数算少,而是人口被放错到另一处。即使县级总人口完全正确,把山谷村庄的人分到县城,也可能让附近道路或医疗点看起来没有需求。因此,验证应同时区分总量有没有错、位置有没有错,以及错误发生在哪种空间尺度。
可以选取已有村级名册的区域,分别检查村内人口、村周围一定缓冲区人口与整个乡镇人口。如果误差随范围扩大而快速消失,主要问题可能是局部错分;若在更大独立区域仍持续偏低,才更接近总量不足。这样的多尺度诊断能帮助决定应该改人口输入、改空间分配,还是先修正验证边界。