住在同一座城市,为什么不同经济群体仍很少共享活动空间?
论文名片|Yuyang Wu、Yao Yao、Shuliang Ren、Shiyi Zhang、Qingfeng Guan,How do urban services facilities affect social segregation among people of different economic levels? A case study of Shenzhen city,Environment and Planning B: Urban Analytics and City Science,2023,50(6):1502–1517,2022 年 11 月 17 日首次在线发表。论文原文。本文是基于手机位置、房价与设施分布的观察研究。
想象两个人住在同一座城市,每天都通勤、购物,却几乎不进入对方经常活动的地方。把居住小区画在地图上,能看见一部分分隔,但工作与服务设施也可能让原本住得很远的人进入同一片空间。哪些社区更容易容纳不同经济群体?这与当地有哪些设施有关吗?
这篇深圳研究试图从共同使用城市空间的可能性理解社会隔离。它发现,不同经济群体组合、一天中的时段,以及社区所在区域,对应着不同的设施关联。不过,论文测量的是社区尺度的共在代理,既没有直接记录面对面交流,也没有通过干预证明设施改变了隔离。
先说结论
- 研究用居住社区平均房价代理社会经济地位,再分析高、中、低三组用户在社区中的出现模式;分组不等于直接测量个人收入。
- 高与低经济组的共同出现指标总体较弱;白天的指标平均约为夜间的 1.4–1.7 倍。这里比较的是模型指标,不是实测交谈次数。
- 九组地理加权回归的调整后 R² 为约 0.626–0.816,设施数量与该指标有较强空间关联,但关系随地区和群体组合变化。
- 企业、交通和医疗设施的平均系数为正,不代表新增任何一处此类设施都能因果地促进交流;同一类商业设施也可能在不同社区呈相反关联。
数据看到的是谁,经济地位又从哪里来?
研究把深圳划为 781 个社区单元,并使用 5,943 个手机基站的数据。数据来自 2012 年一个工作日的 24 小时主动位置记录,即不要求用户拨打或接听电话,也按小时采集基站位置;正文报告用户数为 1,046.3 万。
这比只在通话时定位更利于观察日内变化,但基站位置仍然近似用户位置。研究还把基站记录重采样到社区,因此分析单元是社区,不是同一间商店或同一个座位。
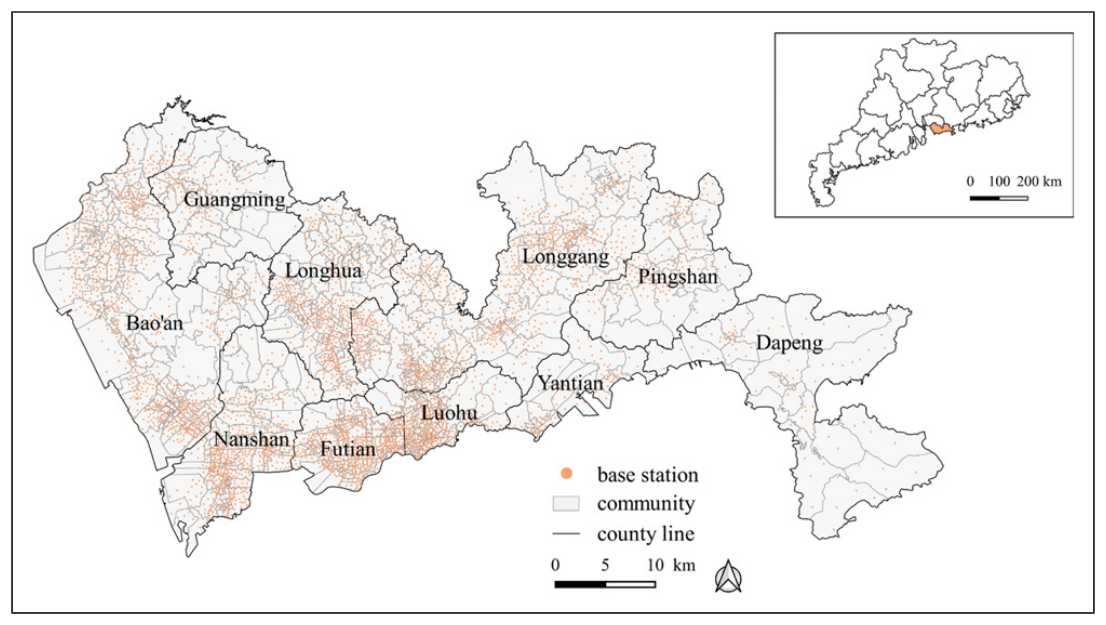
图 1|所谓同一片活动空间,有多大?
这张图没有字母子图。橙点为基站,浅色多边形为社区,线条为区域边界,右上角标出深圳在广东的位置。基站密度与社区面积在城市中并不均匀;把记录归入同一社区,不能据此判断两个人距离足够近或确实见面。来源:原论文 Fig. 1。
居住地由凌晨 2–5 时出现次数最多的社区推断,再将该社区的平均房价赋给用户,作为社会经济地位(socioeconomic status,SES)的代理。三组按经济总量划分原则形成,不能当作各含三分之一人口的收入分位组。租客、合租者、宿舍住户与业主也可能拥有相似居住地却收入差异很大。
原文还有一处应保留的数据口径差异:补表 S1 的三组人数相加为 1,268.5786 万,与正文的 1,046.3 万不一致。现有正文与补表未清楚解释两者关系,因此不能据此计算可靠的样本分组人口占比。这不改变指标的定义,却限制对人口覆盖的精确理解。
两个群体都去过某个社区,就叫发生了互动吗?
论文先计算每组对某个社区的出现概率:对组内每位有效用户,求其在该时段内出现在该社区的比例,再对用户取平均。随后在用户活动相互独立的假设下,把 A、B 两组的概率相乘:
社区的聚集能力 = A 组出现概率 × B 组出现概率。
作者将其称为 gathering capacity。它反映两组共享该社区活动空间的可能性,用组内归一化减少直接比较人数的影响;它不是从一对真实用户的同步接触记录中统计出来的。
这一区别很关键。白天时段覆盖 7–18 时,两组即便在这个时段内先后来过,也未必同时在场。社区也可能大到包含许多互不接触的场所。指标高,说明进一步研究跨群体接触有了空间基础;不能直接写成居民建立了友谊或发生了交流。
另一方面,指标低也可能因为两组都很少去这个社区,而不仅是相互回避。没有同时对照当地活动总量和一个混合基线,就不应把每块浅色区域都自动解释成两组之间存在强排斥。
哪两组最难共享空间,白天又改变了什么?
研究分别计算高–中(H-M)、高–低(H-L)、中–低(M-L)三种组合,并区分夜间 1–7 时、白天 7–18 时、晚间 18–1 时,得到九张空间分布图。
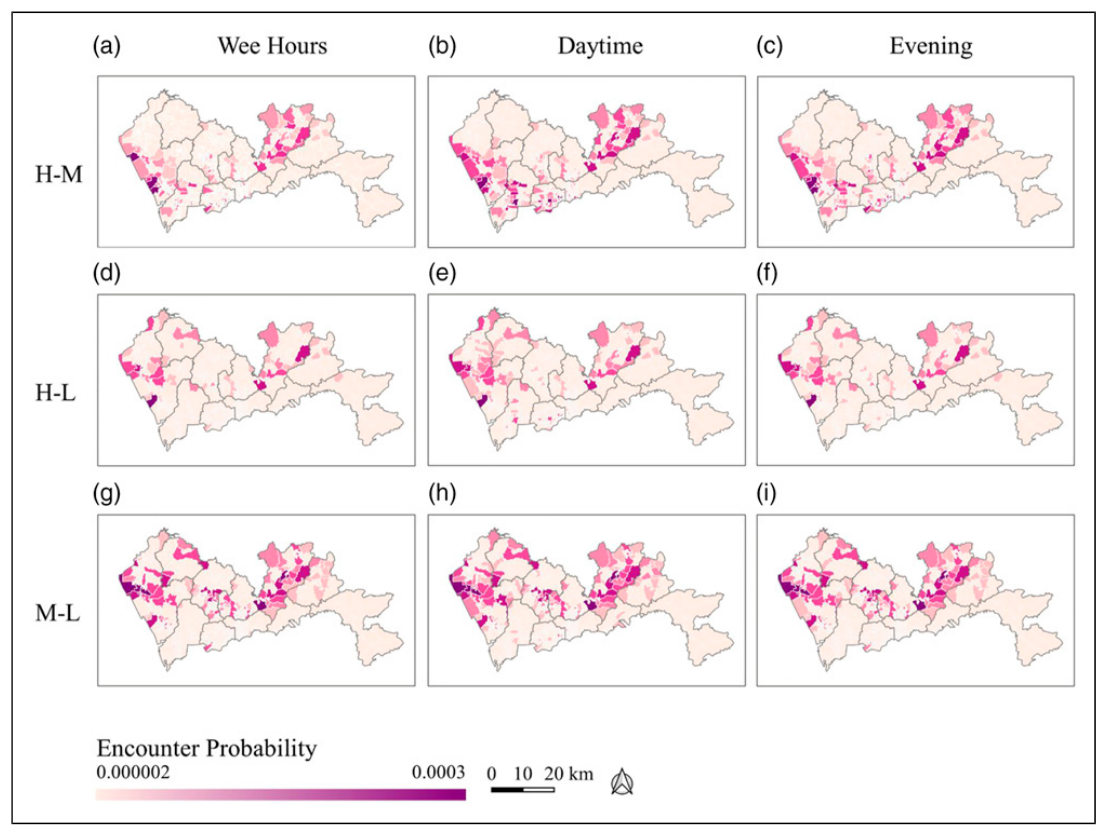
图 2|经济群体之间的空间联系,怎样随一天变化?
(a、b、c)高–中组合,依次为夜间、白天和晚间;南山、福田等区域的部分社区呈较高值。
(d、e、f)高–低组合,同样依次为三个时段。整体上深色社区较少、分布范围较小,是论文认为高低经济群体空间分隔较强的主要依据。
(g、h、i)中–低组合,依次为三个时段;宝安、龙岗以及部分龙华、光明社区的值较高。
所有面板使用从浅粉到紫色的指标刻度,颜色越深,两个组的出现概率乘积越大;共同刻度便于比较。它呈现的是聚合共在可能性,没有测量实际交流质量。来源:原论文 Fig. 2。
作者描述,高技术产业区的指标整体较强,约为其他区域的四倍;多数社区白天强于夜间,平均约为 1.4–1.7 倍。这些是样本工作日中的描述性比较,并不证明工作活动必然消除隔离。它也提醒我们,单看住在哪里,可能遗漏白天在工作和服务空间中的跨群体联系。
同样是设施多,为什么有的地方更容易混合?
研究使用 2012 年百度兴趣点(point of interest,POI)数据,分为餐饮、企业、购物、交通、金融保险、科教、体育休闲、医疗和酒店度假九类。回归中的自变量是各社区的设施数量,因变量是对应群体与时段的聚集能力。设施数量表达存在多少处地点,不能自动代表容量、价格或服务质量。
地理加权回归(geographically weighted regression,GWR)允许系数随位置变化,避免假设同一种设施在全城作用相同。九组模型的调整后 R² 都超过 0.6,说明这些变量能拟合相当一部分空间差异;该拟合程度本身不能识别因果。
原论文表 2 汇总全部九类设施在九组模型中的平均系数。企业、交通和医疗的平均系数都为正;科教为负,部分其他类别则随群体或时段改变方向。餐饮与购物尤其不能用一个全城结论概括。表中星号标的是蒙特卡洛检验结果,应与局部图中 p<0.05 的筛选区别,也不能把平均系数的正负直接当成某种设施对每位居民的真实效应。
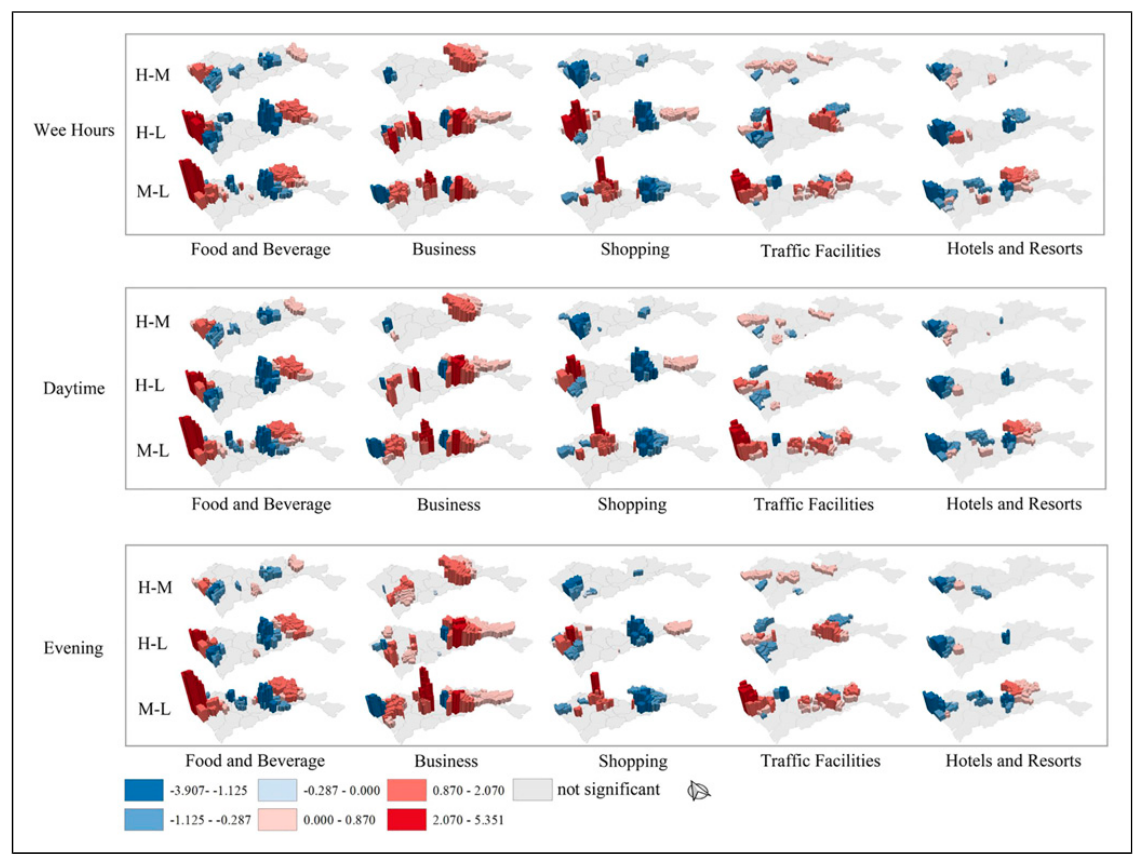
图 3|同一种设施,在哪些群体和地区对应不同关系?
原图没有字母标号。上、中、下三个大框分别为夜间、白天和晚间;每框的三行依次为 H-M、H-L、M-L,五列依次为餐饮、企业、购物、交通、酒店度假设施。红色为正系数,蓝色为负系数,灰色为未达到局部显著性门槛的社区;颜色和柱高表现系数大小,不能读成设施数量。
餐饮列:三个时段、不同组对之间差异明显,显示餐饮数量与聚集的联系取决于具体位置和群体。
企业列:宝安、龙岗等区域多呈正向关联,部分远离中心的社区也出现较强关系。
购物列:同一地区的不同组对也可能不同,例如宝安的 H-M 可呈负向,H-L 可呈正向;龙华的 M-L 可呈正向。商业空间多,并不保证每两组人都更容易共享。
交通列:部分宝安、龙岗社区呈正向关联,M-L 的联系尤其值得关注,但图中没有检验新增交通设施后的行为变化。
酒店度假列:总体平均偏负,局部却存在正向社区,说明不能用全城平均替代具体地点判断。五列、三组与三个时段共同覆盖图中的全部局部比较。来源:原论文 Fig. 3。
图中显著的社区较多集中于研究所划定的高技术产业区。作者把这与区域发展阶段和设施结构的可调整程度联系起来;中心区更成熟、郊区人口与用地条件不同,是他们提出的解释。由于并未随机改变这些条件,解释仍需与观测关联区分。
规划能从这项研究学到什么,又不能跳过什么?
研究支持一个有价值的提问方式:设施规划应关心吸引的是哪些群体、发生在什么时段,而不是只数全城增加了多少服务点。即使某设施与高聚集指标有关,也需要检验价格门槛、可达性与使用规则,判断不同人是否真正可以进入。
作者据此提出,在不同区域配置企业、交通及商业服务,并留意房价上涨挤出原居民的风险。这些属于规划建议,研究并没有通过设施建设前后的追踪或对照试验证明建议实施后的效果。
至少有四条边界不能省略。第一,只有一个工作日,不能据此认定周末、节假日和其他年份完全一致。第二,基站误差、社区划分与面积差异可能产生可变空间单元问题(modifiable areal unit problem,MAUP),换一种边界可能改变统计关系。第三,房价只是经济代理,并非个人收入或消费能力。第四,设施、就业、交通、人口活动和房价可能共同变化,GWR 允许空间差异,却不会自动排除这些混杂。
补充材料还列出了变量方差膨胀因子等检查,帮助评估自变量之间的相关程度;这种共线性检查也不能替代遗漏变量控制或因果设计。更好的模型拟合与真实促进人际交流,仍是两项不同的证据任务。
一句话总结
深圳这项研究把社会隔离从住址带到日常活动空间,但它揭示的是经济代理群体共在与设施的空间关联,距离证明设施让人真正交流还有一步。
核心来源
- Wu, Y., Yao, Y., Ren, S., Zhang, S., & Guan, Q. (2023). How do urban services facilities affect social segregation among people of different economic levels? A case study of Shenzhen city. Environment and Planning B: Urban Analytics and City Science, 50(6), 1502–1517. DOI: 10.1177/23998083221140415。三张主图均来自该论文。
- 官方补充材料:经济分组、样本说明与共线性检查。
作者介绍
- Yuyang Wu:第一作者,论文署名中国地质大学(武汉)地理与信息工程学院。
- Yao Yao:通讯作者,署名中国地质大学(武汉)及东京大学空间信息科学研究中心;论文简介列出的方向包括地理空间大数据分析与计算城市科学。
- Shuliang Ren:署名中国地质大学(武汉);论文简介列出的方向为地理空间大数据挖掘与地理信息系统。
- Shiyi Zhang:署名中国地质大学(武汉);论文简介列出的方向为地理空间数据挖掘与计算城市科学。
- Qingfeng Guan:署名中国地质大学(武汉)及国家地理信息系统工程技术研究中心;论文简介列出的方向包括高性能空间智能计算与城市计算。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
把两组人带到同一片空间,可能是有意义交流的前提,也可能只是让他们平行地使用不同楼层、不同价格区间或不同时段。若把共同出现本身设为规划目标,甚至可能把原本不愿进入某空间的人流增加当成成功,而忽视使用体验和实际受益。
一个更具体的后续研究,可以在设施改造前后同时测三件事:跨群体共在是否增加,实际接触是否增加,原居民使用成本是否上升。再与未改造的相似地区比较,才能判断看似更混合的空间究竟扩大了公共机会,还是只改变了地图上的人流颜色。