没有全国手机轨迹,能为一亿多人合成一个普通工作日吗?
论文名片|Takehiro Kashiyama、Yanbo Pang、Yoshihide Sekimoto、Takahiro Yabe,Pseudo-PFLOW: Development of nationwide synthetic open dataset for people movement based on limited travel survey and open statistical data,2022 年预印本。SSRN 原文 · arXiv:2205.00657。下文解读的是这份 24 页预印本。
假设你要模拟一座小城的日常交通,却没有当地居民的连续手机轨迹。人口普查告诉你住了多少人、多少人跨城上班,学校资料告诉你学区在哪里,但购物、就医和回家的行程仍然是空白。能否把这些分散的统计资料接起来,为每个模拟居民安排一天?
Pseudo-PFLOW 就是在做这件事。它把有限都市圈的出行调查与全国统计、建筑及交通网络结合,合成约 1.3 亿人的典型工作日活动。这里的每一个人都是模型里的合成个体,路线也不是从真实手机里逐条恢复的历史。
先说结论
- 数据覆盖日本全国,活动时序主要从 2008 年东京都市圈出行调查学习,活动地点则尽量用全国人口、通勤、就业和学校统计约束。
- 与手机估计人口相比,中午的拟合随尺度细化而下降:行政区尺度的 R² 约为 0.98,1 公里网格约为 0.81,500 米网格约为 0.61。作者因此更谨慎地把 1 公里尺度视作实用边界。
- 跨都市圈验证有成功也有短板:东骏河都市圈通勤 OD 的 R² 低于 0.5,通勤总量只有调查量的 83%,并不是全部地区、全部目的都达到相同质量。
- 标题里的开放要结合使用条件理解。按文中发布方式,研究者需要提出共同研究申请;合成轨迹也不能替代某天的真实人流或突发事件观测。
先给谁安排一天?
模型先把普查中按区域汇总的家庭数据下分到建筑,生成有居住位置、年龄、性别等属性的合成居民,再按就业、学龄和年龄等条件分配角色。合成家庭和建筑坐标让模拟可以从具体位置出发,但并不意味着研究者知道某位真实居民住在哪栋楼。
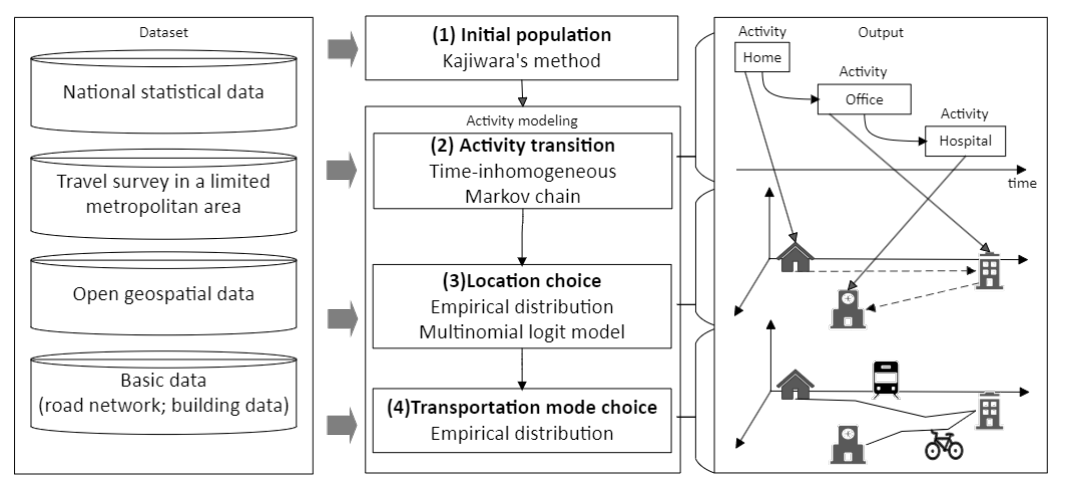
图 1|从统计资料到一天的轨迹,需要补上哪些环节?
图中没有字母子图。左侧列出全国统计、有限地区出行调查、开放地理数据及路网和建筑资料;中间依次生成初始人口、活动转换、活动地点和交通方式;右侧把活动安排转成空间移动。四步分别解决谁出行、何时做什么、去哪以及怎样去。来源:原论文 Fig. 1。
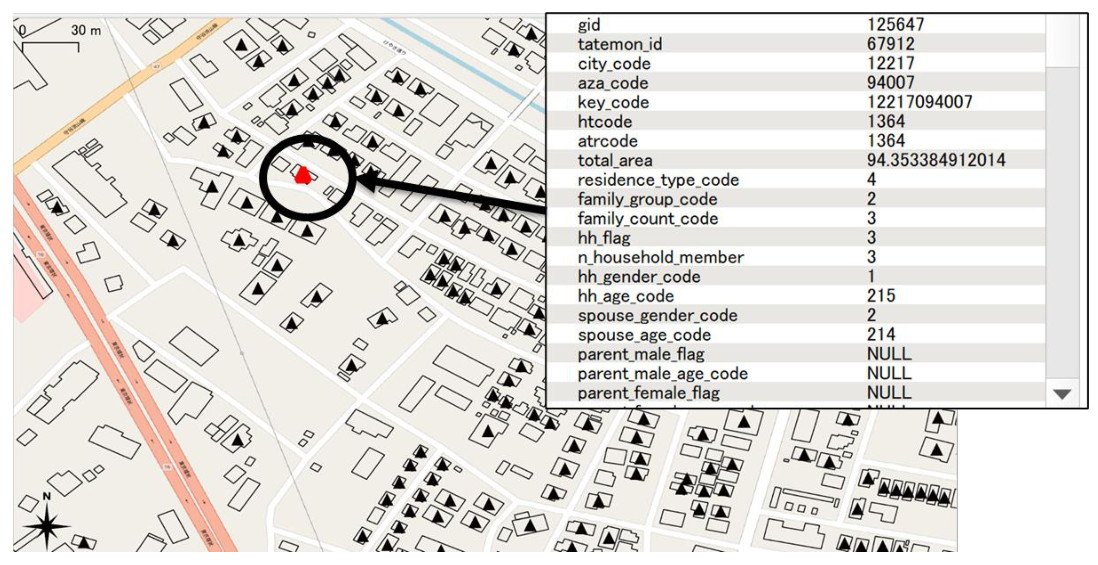
图 2|建筑坐标和人口属性怎样接起来?
图中没有字母子图。圆圈指出一个合成家庭的居住建筑,右侧展示关联的家庭与个体字段。这是模型生成的人口记录示例,不能当作真实家庭档案。来源:原论文 Fig. 2。
原论文表 1 对比了出行调查、普查、基站、GPS 和交通系统等既有数据:调查有活动目的,但覆盖有限;普查覆盖广,但主要记录特定出行;手机轨迹敏感,公开数据也常受地区或抽样范围限制。研究的目标因而是组合这些资料的长处,而不是声称找到一种能完整观测所有人的新传感器。
为什么一个都市圈学到的作息,敢拿到别处用?
跨地区迁移最怕把东京特有的生活方式当成全国规律。作者把东京、近畿和东骏河三个规模及结构不同的都市圈放在一起,比较移动模体、外出比例和出行目的比例。
移动模体(mobility motif)把到访地点看成节点,把地点间出行看成有向边,保留一天活动的简单网络形状。例如家与工作地之间往返,和中途访问第三个地点,会形成不同结构。这个比较保留活动组合,却不要求不同城市的具体地名一致。
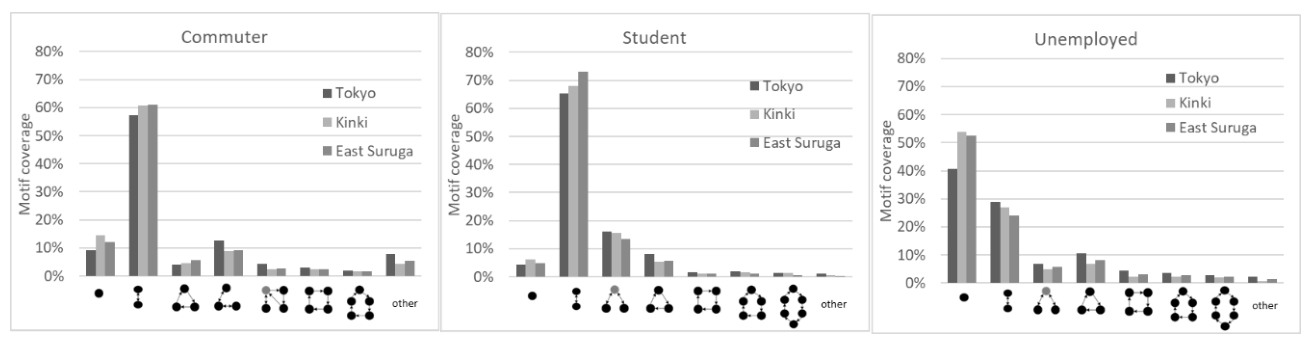
图 3|相同角色在不同都市圈,会形成相似的活动链吗?
原图没有字母标号。左、中、右三个面板依次为通勤者、学生和非就业者;横轴为模体类别,纵轴为该类别比例,灰度区分三个都市圈。角色之间差异明显,同一角色的都市圈分布较接近;这支持有限范围内的迁移尝试,不能证明所有地区的行为完全相同。来源:原论文 Fig. 3。
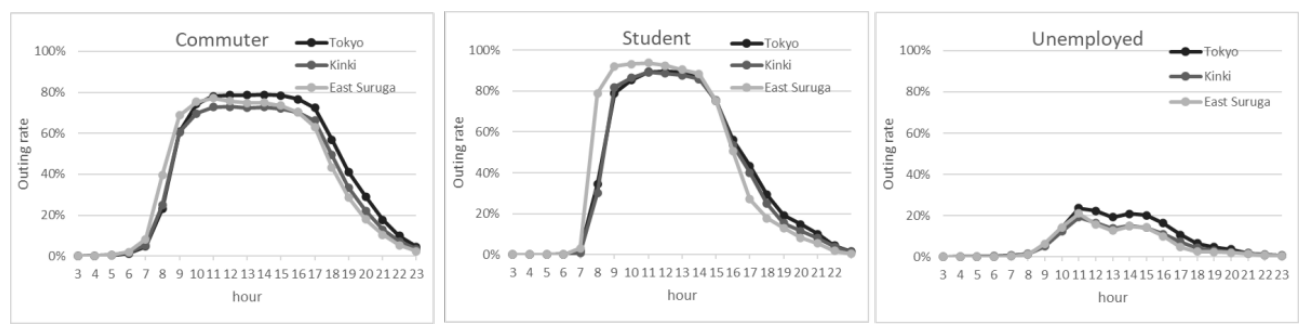
图 4|相似的活动链,时间安排也相似吗?
原图没有字母标号。左、中、右仍对应通勤者、学生和非就业者,横轴为小时,纵轴为外出比例,不同线条对应都市圈。同一角色的日变化曲线较接近,但曲线展示的是群体比例,不能说明每个人在同一时刻出门。来源:原论文 Fig. 4。
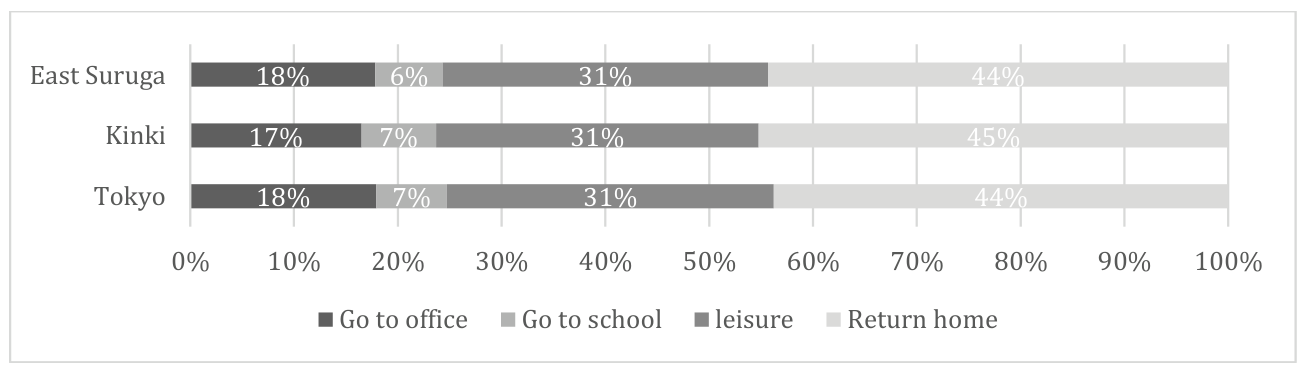
图 5|全国模型要保留怎样的出行目的组合?
图中没有字母子图。三条横向堆叠条分别为东骏河、近畿和东京,颜色区分上班、上学、私人活动及回家。私人活动约占 31%,回家约占 44%–45%,通勤和通学占比也相近;这是几类出行的构成比例,不是居民中有多少人外出。来源:原论文 Fig. 5。
作者据此选择用东京调查学习活动时序,并将其他都市圈的调查留作验证。三地相似是这一选择的依据,但样本比较不等于对整个日本所有群体作了等价性检验;更不能据此认定其他国家也能直接使用同一组参数。
一天先做什么,再做什么,怎样由模型决定?
时变马尔可夫链(time-inhomogeneous Markov chain)让下一时刻的活动取决于当前活动和一天中的时刻。模型设置八种状态:在家、工作、上学、购物、外食、就医、其他私人活动以及业务活动。留在同一状态表示活动持续,切换状态表示产生新活动。
转移概率按角色、性别和老年/非老年等属性分别设定。它能表达不同群体的作息差异,但并没有还原某个真实人的偏好或完整历史,也没有在模型里自动加入所有家庭成员之间的协调。
活动地点分两级选择,尽量让有全国统计的内容由当地数据决定。通勤先按普查中的市町村 OD(起讫点流量)选目的城市,再按就业人数选择网格,最后按建筑面积分配建筑;同城通勤加入距离阻力。小学和初中可利用学区与学校位置,高中以上则依赖更粗的目的地统计和学校分配。
私人活动没有同样完整的全国 OD,研究用东京调查建立多项 Logit(multinomial logit)模型。其选择变量包括城市间距离、性别、是否超过 65 岁、目的城市人口密度和企业密度,并按城市规模分别估计参数。活动目的还决定使用哪类行业就业人数为地点分配权重,例如就医对应医疗行业。
原论文表 2–4 分别登记了数据来源、不同角色各步骤采用的数据,以及地点选择变量。需要保留一个实际条件:模型使用了商业建筑数据,也依赖可申请用于研究的出行调查;文中提出建筑可用 OpenStreetMap 替代,却没有因此把本次完整实现变成无条件可取得的纯开放数据方案。
活动之间,走哪条路、坐什么车?
交通方式按全国城市交通特性调查中的方式分担比例,结合个人属性、距离与目的进行概率分配。铁路行程再拆成到站、站间和离站三段;起终点附近没有符合条件的车站时,排除铁路选项。通勤去程与返程使用相同交通方式。
路径采用最短时间算法,路段速度依类型预设,例如高速公路 100 公里/小时、一般道路 30 公里/小时、铁路 60 公里/小时。它们是生成路线的模型设定,不是每条道路的即时实测速率,不能把生成结果解释成包含真实拥堵和精确列车时刻表的交通运行实况。
研究使用 100 个虚拟 CPU 和 160 GB 内存的计算实例,约十天生成全国数据。这说明全国合成的计算规模;计算完成并不等于所有个体路线都已经逐条验证。
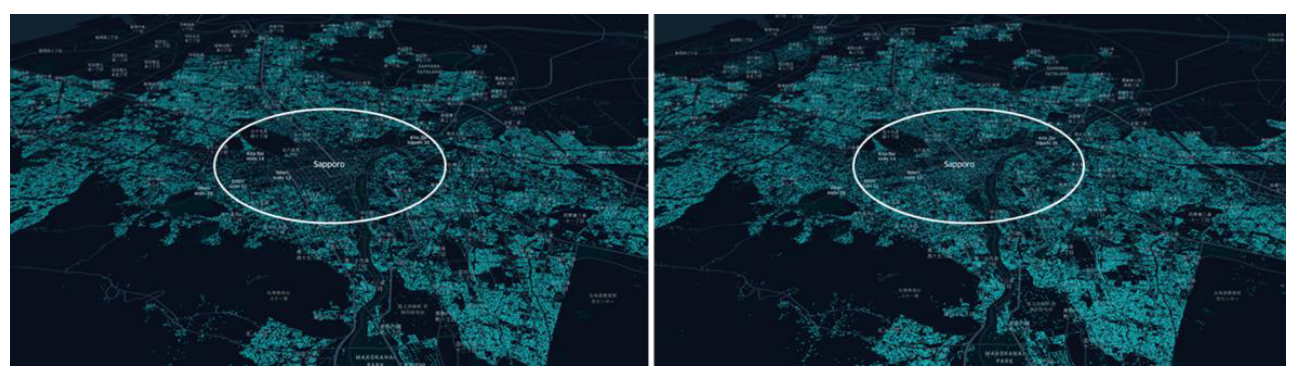
图 6|合成活动能表现中心区一天中的变化吗?
原图没有字母标号。左图为清晨六点,右图按正文说明为中午十二点,点表示合成个体位置,圆圈突出中心区。原英文图注将右图误写为 12 a.m.,这里按正文的昼间描述理解。图像展示模型产生的分布变化,没有直接观测每个点代表的人。来源:原论文 Fig. 6。
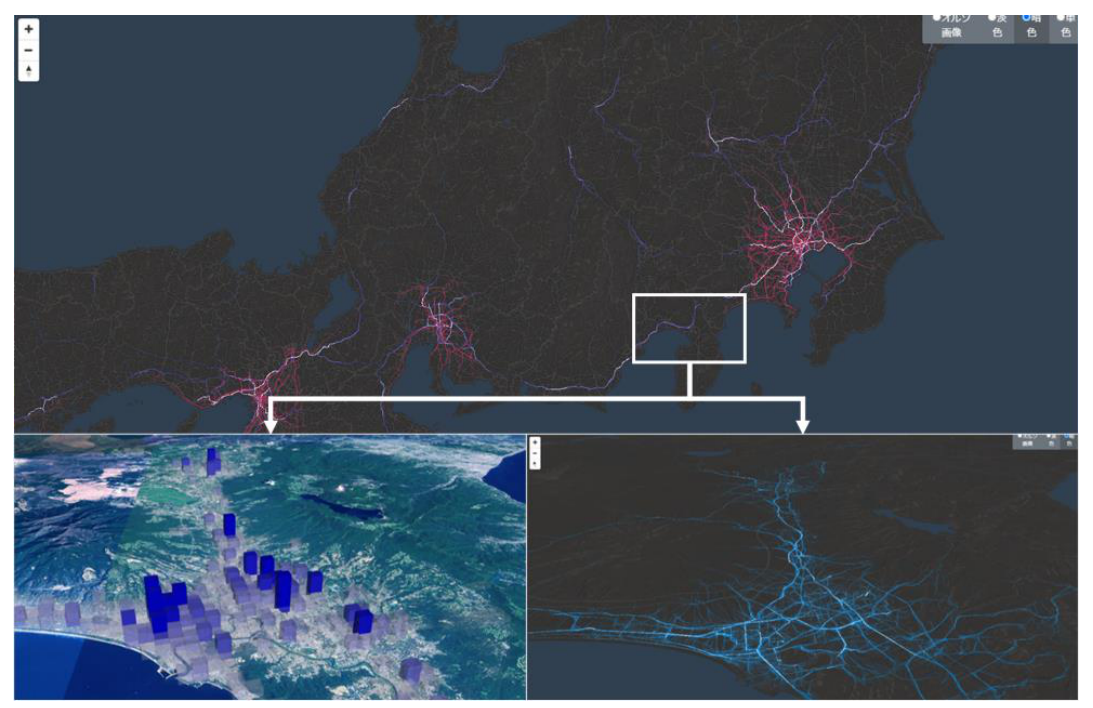
图 7|同一批合成轨迹可以怎样汇总?
原图没有字母标号。上方是较大区域的路网连接流量;下方左侧是东骏河区域的 1 公里网格人口,右侧是连接流量。人口图和流量图分别回答某时某地有多少合成人口、连接上出现多少合成通行,不能互相替代。来源:原论文 Fig. 7。
用什么资料判断这个普通工作日像不像?
全国生成不等于全国独立验证。人口分布比较使用富山县和静冈县的手机估计人口;出行量使用东京、近畿和东骏河的调查,东京结果也承担对模型拟合程度的检查,近畿和东骏河更能检验跨都市圈迁移。
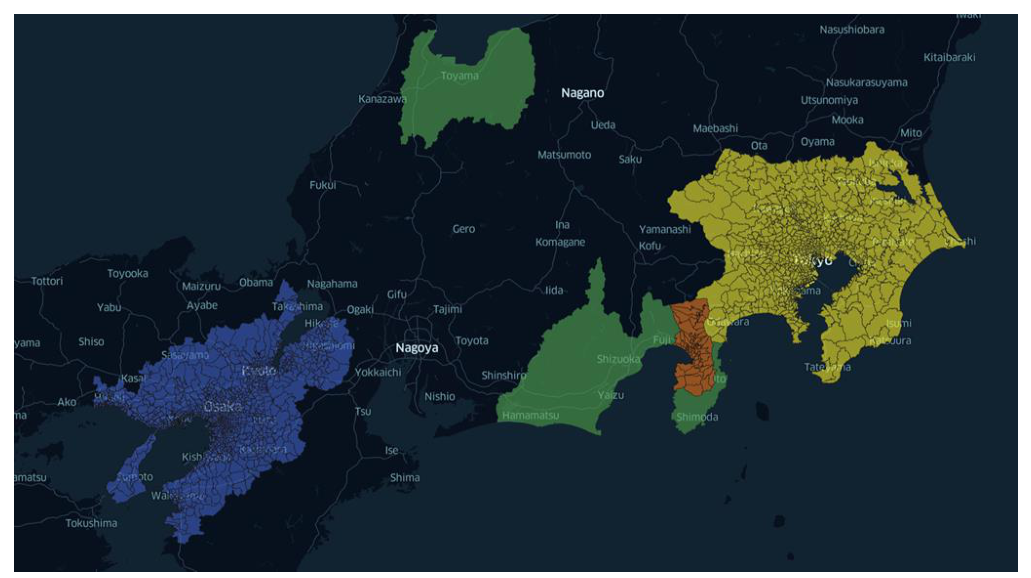
图 8|哪些地方提供模型,哪些地方提供检验?
图中没有字母子图。黄色是东京调查区域,蓝色是近畿,橙色是东骏河;绿色的富山与静冈用于人口分布验证。颜色区分数据用途,不能把地图中所有区域都当作有同样独立验证资料。来源:原论文 Fig. 8。
手机参照本身也不是无误差的人口真值。它由基站用户数量分配并扩样得到,空间分配和覆盖都会影响结果。为检查这一点,作者在清晨六点把手机人口和合成人口分别与普查比较。
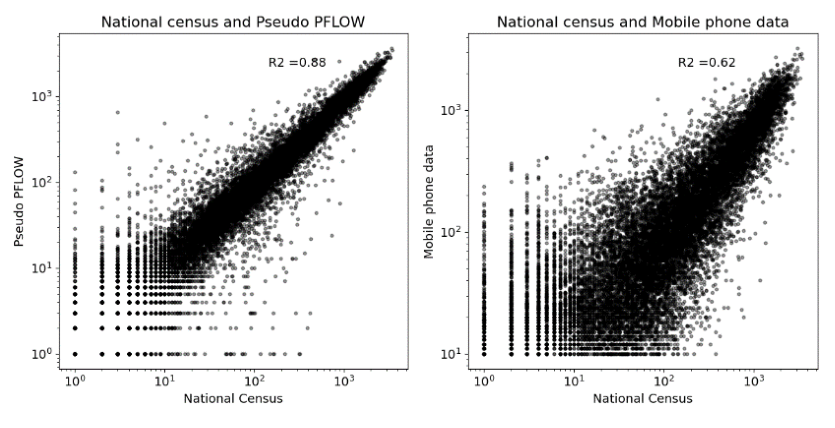
图 9|参照数据自己有多大偏差?
原图没有字母标号。按图内标题和纵轴,左图是普查与 Pseudo-PFLOW 的比较,R² 约为 0.88;右图是普查与手机估计人口,R² 约为 0.62。两图横轴都是普查人口,点为区域人口比较,坐标采用对数尺度。原英文图注把左右顺序写反,这里以图内标签及正文为准。合成人口本就使用普查生成,因此左图较好主要验证下分和一致性,不能视作完全独立的预测验证。来源:原论文 Fig. 9。
行政区很像,能否直接缩小到每个街区?
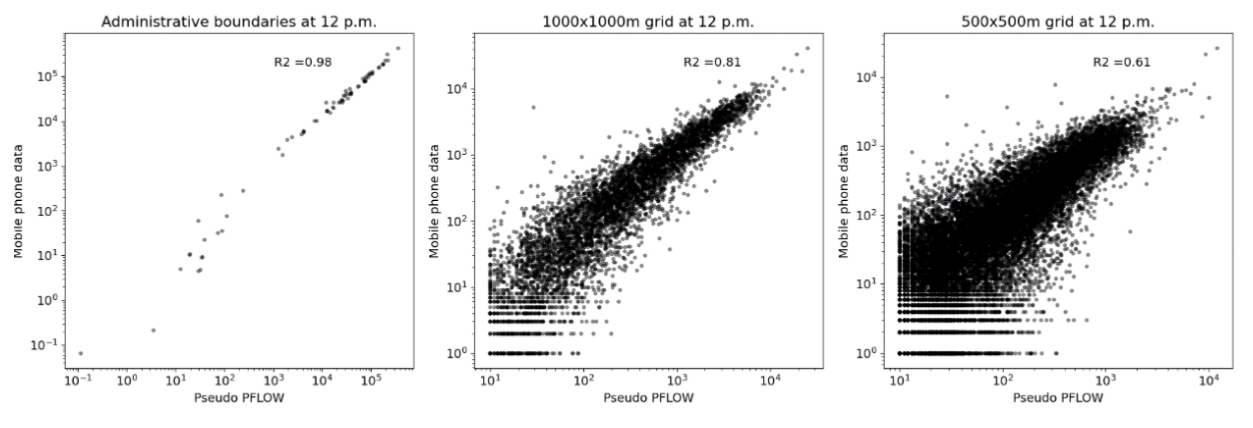
图 10|空间尺度缩小后,误差怎样显露?
原图没有字母标号。左、中、右分别为行政区、1 公里网格和 500 米网格;横轴为合成人口,纵轴为手机估计人口,对数坐标上的散点分别得到约 0.98、0.81 和 0.61 的 R²。越细的网格越分散,说明大区域总量接近不能保证微小区域也准确。来源:原论文 Fig. 10。
R² 是分布拟合程度的指标,不是“有 61% 的人被正确定位”。作者综合细网格散点与手机参照的不确定性,认为更谨慎的实际使用边界是约 1 公里网格。建筑尺度生成有助于模拟操作,不等于建筑尺度精度经过了同等验证。
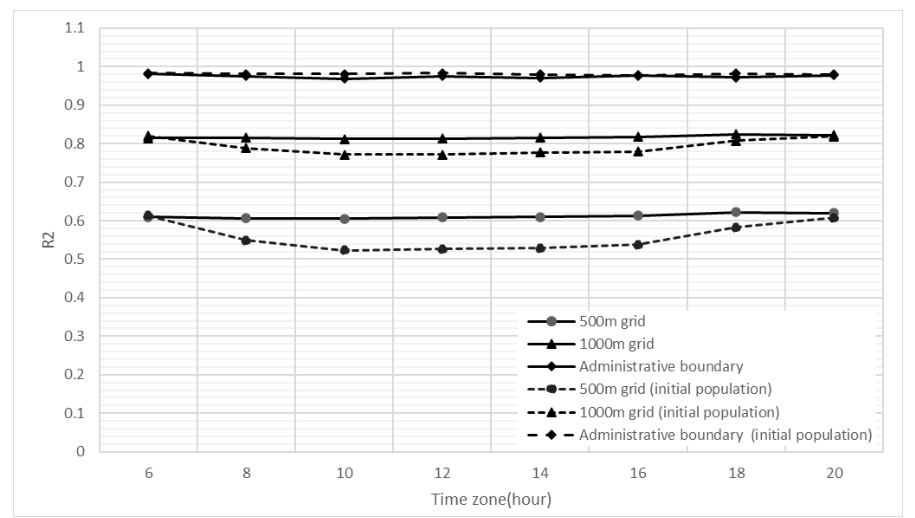
图 11|模型真的移动了人口,还是只复制清晨分布?
图中没有字母子图。横轴为六点至二十点,纵轴为 R²;三种尺度各有动态合成人口和固定清晨六点人口的对照曲线。细尺度下,固定初始人口在白天的拟合变差,动态模型较稳定,说明活动模型捕捉了部分日变化。这仍是聚合人口证据,不是逐个人验证行程。来源:原论文 Fig. 11。
人口落在对的地方,出行联系也对吗?
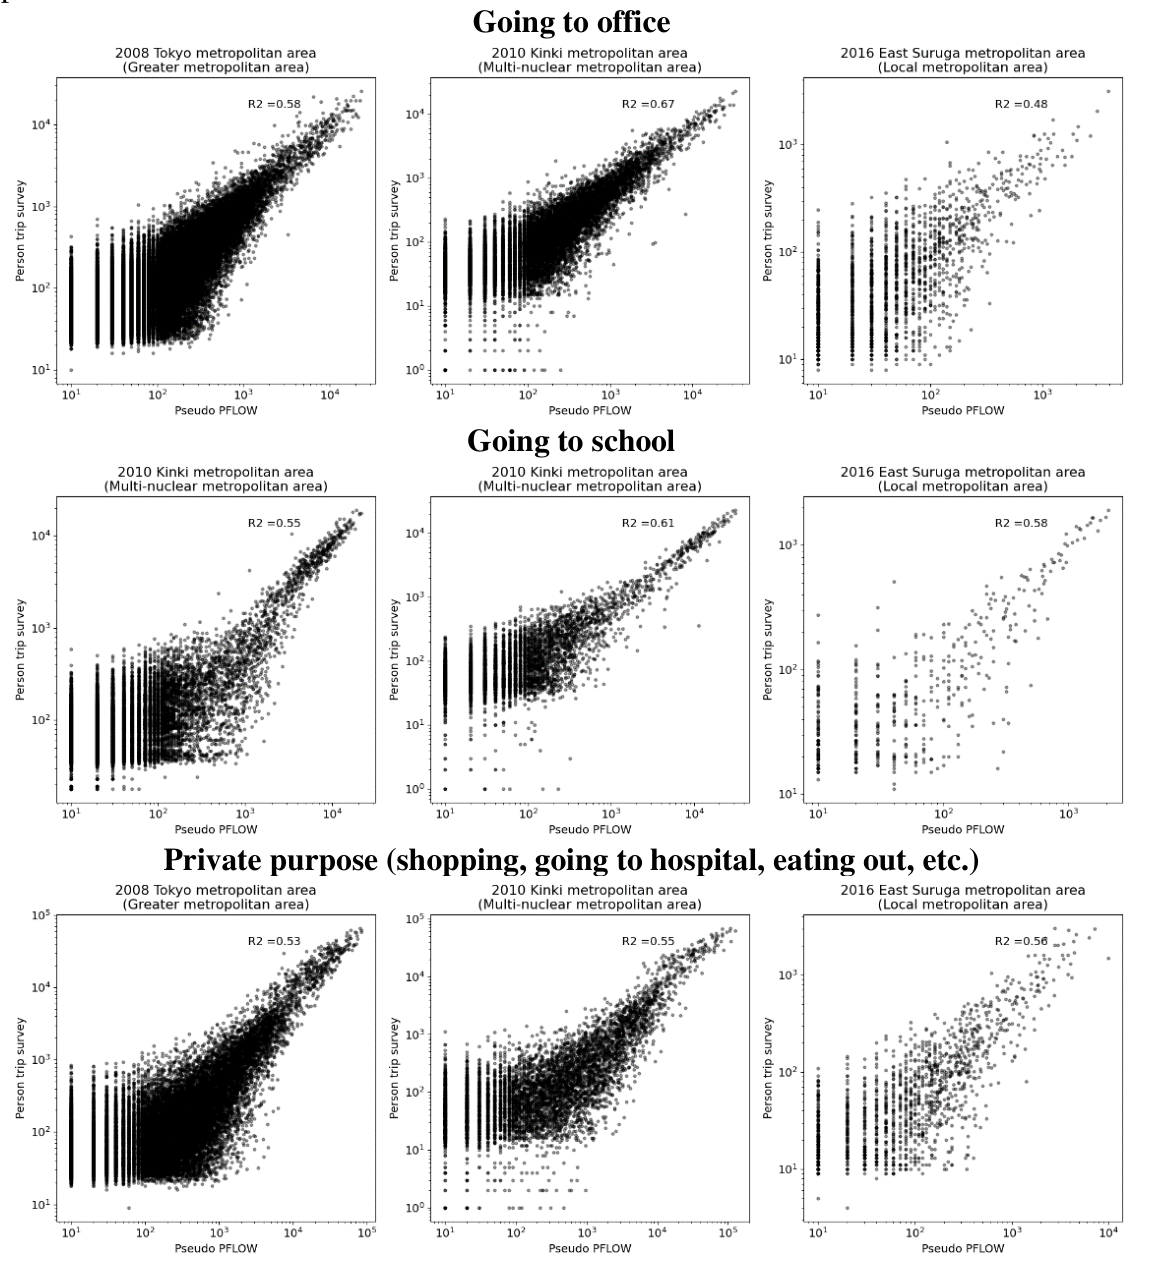
图 12|哪一种出行较难迁移到其他城市?
原图没有字母标号。上、中、下三行分别是通勤、通学和私人目的;每行三幅面板用于比较三个都市圈。横轴为合成出行量,纵轴为调查出行量,使用对数尺度。
上行:东京与近畿的拟合较好,东骏河通勤 R² 约为 0.48,显露出地方都市圈的短板。
中行:通学总体也有较强对应,较大流量的联系更贴近;学区约束有助于义务教育出行,高中以上的目的地分配仍更粗。原图中第一幅通学面板的都市圈文字标记与三列比较布局不一致,因此不据该标签推导额外地区结论。
下行:私人目的在三个都市圈均达到 0.5 以上的 R²,支持对这一组外部地区的迁移尝试;它不意味着购物、就医等每一个子目的都已单独达到同样精度。来源:原论文 Fig. 12。
作者认为东骏河行政区域较大,普查 OD 下分到具体地点时误差可能更大。这是一种合理的误差解释,尚未通过更细调查被完全确认。
再看总量,会看到散点图以外的信息。原论文表 5 的覆盖率定义为合成日出行量除以调查日出行量;100% 表示总量相等,不是准确率。
| 出行目的 | 东京 | 近畿 | 东骏河 |
|---|---|---|---|
| 上班 | 95% | 105% | 83% |
| 上学 | 104% | 113% | 102% |
| 私人活动 | 96% | 106% | 90% |
| 回家 | 93% | 97% | 84% |
近畿通学多估约 13%,东骏河通勤少估约 17%、回家少估约 16%。这些误差提醒我们:即使大多数分布拟合看起来不错,具体出行类别的总量仍可能偏离,不能只用摘要里的总体“R² 超过 0.5”概括全部情形。
怎样使用这份数据,才不会让合成变成事实?
它适合提供典型工作日的活动与空间联系底图,帮助缺乏连续轨迹的研究开展初步模拟。它不代表某个真实日期,也不包含旅游等非日常活动;自然灾害、疫情冲击或大规模临时活动后的行为更不能直接从这个普通日推断。
数据包含人口与家庭属性,但角色分类、概率规则、建筑面积权重和预设速度都是生成假设。作者对日本社会背景差异较小的解释,也是迁移方法的前提判断,不是本文已充分测量和排除的所有群体异质性。
按预印本描述,研究者经由东京大学 CSIS 的 JoRAS 共同研究申请取得数据,提供内容包括合成个体轨迹、网格与连接聚合结果以及模型参数。因此,应分别核对版本、申请条件与使用尺度,不能只因标题有 open 就把它当作可以无条件用于任何场景的公开观测记录。
一句话总结
Pseudo-PFLOW 用有限调查和全国统计补出了一幅可用的典型日移动图景,而聚合验证、地区差异与生成假设共同决定它能被用到多细、用来回答什么。
核心来源
- Kashiyama, T., Pang, Y., Sekimoto, Y., & Yabe, T. (2022). Pseudo-PFLOW: Development of nationwide synthetic open dataset for people movement based on limited travel survey and open statistical data. 预印本,DOI: 10.2139/ssrn.4098791,arXiv:2205.00657。全部主图和表内数值来自该版本。
作者介绍
- Takehiro Kashiyama:本文第一作者及通讯作者,署名东京大学生产技术研究所;稿件另列现址为大阪经济大学经济学部。贡献声明包括方法、数据整理和验证。
- Yanbo Pang:署名东京大学空间信息科学研究中心,贡献声明包括研究实施、方法和验证。
- Yoshihide Sekimoto:署名东京大学空间信息科学研究中心,贡献声明包括研究构思和指导。
- Takahiro Yabe:署名麻省理工学院数据、系统与社会研究所,贡献声明包括研究实施与写作审阅。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
合成数据可以把没有被观测的人填进模型,但“填进去”有两种不同含义:让总体数量符合统计约束,以及让不同人的行动差异得到合理表达。前者通常更容易检验,后者却可能决定具体群体的服务需求。例如,全城就医出行总量相同,仍可能对应老年人集中跨城就诊,或大多数人在附近诊所就医两种不同图景。
因此,用合成轨迹比较设施方案时,可以不只生成一个普通日,而是针对较弱的地点选择环节生成多组合理参数情景。如果某个选址方案在多种情景下都改善可达性,其结论会比只在单一合成世界里表现优良更稳健。此时合成数据的价值,是支持对不确定性的检验,而不是把没有观测的细节伪装成已知。